Controller Manager:控制器与协调机制
Kubernetes Controller Manager(KCM) 统一运行和管理 Kubernetes 的一组内置控制器,负责工作负载、节点、服务发现、存储、身份凭据和资源清理等任务。各控制器持续观察相关对象,根据当前状态与管理目标之间的差异执行调整。
KCM 负责控制器的注册、启动和退出,并提供客户端、共享缓存等依赖。各控制器在此基础上运行各自的协调逻辑,通过对象状态的变化相互协作。
架构
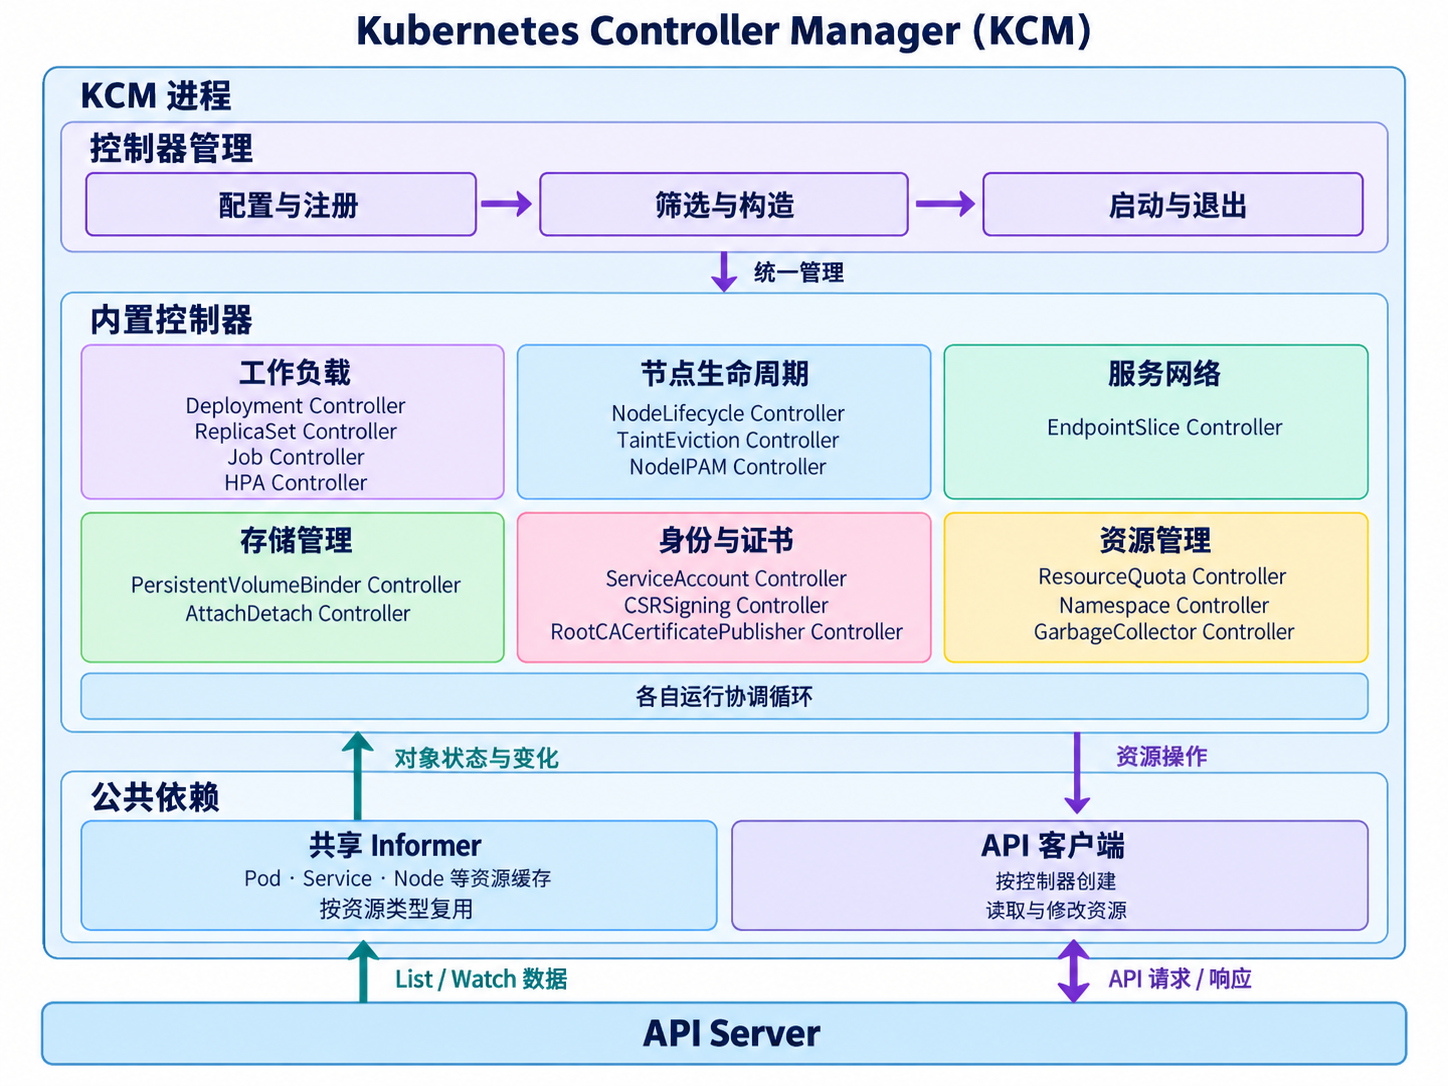
图:KCM 架构。
- 控制器管理:KCM 将多个内置控制器组织在同一个进程中,负责控制器注册,根据配置筛选、构造并启动控制器,统一管理它们的运行与退出。
- Informer 共享:KCM 通过共享 Informer 工厂,按资源类型提供对象缓存和变化通知。例如,Deployment、ReplicaSet 和 EndpointSlice Controller 复用同一个 Pod Informer,共享 Pod 的 List / Watch 和缓存;EndpointSlice Controller 还使用 Service Informer,维护 Service 对象的缓存。
- 执行协调:各控制器从缓存读取相关对象,根据当前状态与管理目标之间的差异,通过 client-go 提供的客户端向 API Server 提交资源修改。例如,一个受 ReplicaSet 管理、同时被 Service 选中的 Pod 被删除后,ReplicaSet Controller 检查是否需要补齐副本,EndpointSlice Controller 则更新服务后端。资源变化再经 Informer 更新到缓存,触发后续协调。
协调机制
Reconcile(协调) 是控制器检查资源状态并进行调整的过程。每轮协调中,控制器读取相关资源的当前状态,判断是否符合期望,并执行必要的修改。资源发生变化、操作失败需要重试,或到了预定的检查时间,都可以触发新一轮协调。
触发模式
常见的触发模式有两种:
- 边缘触发(Edge-triggered):根据状态的变化量执行动作,例如“增加 2 个副本”。
- 水平触发(Level-triggered):根据当前状态与目标的差距决定动作,例如“将副本数保持在 3 个”。
下图展示了扩容操作被重复处理后,两种方式如何继续响应副本数的调整。
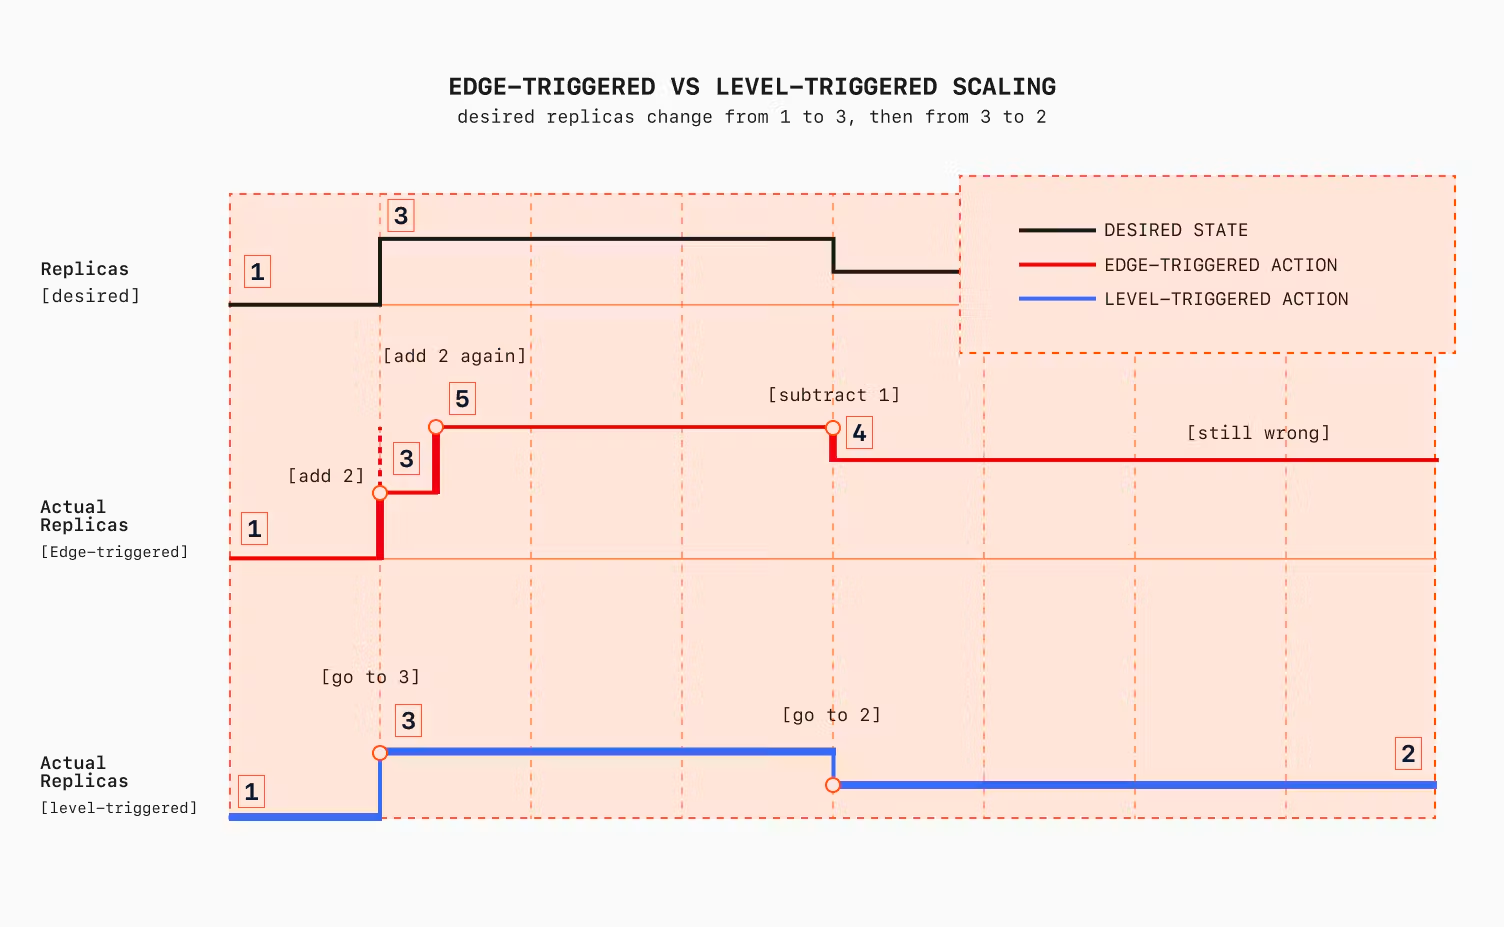
图:边缘触发与水平触发。来源:PlanetScale。
- 边缘触发(红线):用户把目标从 1 个副本改成 3 个,控制器据此执行“增加 2 个”,实际数量达到 3 个。如果重试时直接重复这条动作,又增加 2 个,实际数量就变成 5 个。之后用户把目标从 3 改成 2,控制器只按这次变化“减少 1 个”,结果还剩 4 个,之前多创建的副本仍然存在。
- 水平触发(蓝线):控制器每次处理任务,都重新检查“目标是多少、现在有多少”。第一次发现目标是 3 个、当前只有 1 个,于是补充 2 个;重试时,如果已经观察到 3 个副本,就无需再创建。之后目标改为 2 个,控制器发现当前有 3 个,只需删除 1 个,就能达到目标。
Kubernetes 控制器采用水平触发的协调方式:事件通知触发检查,控制器根据当前状态与期望状态的差距执行调整。
协调循环
下图以 Deployment 扩容为例,展示控制器如何比较期望状态与当前状态,并通过 ReplicaSet 调整 Pod 数量。
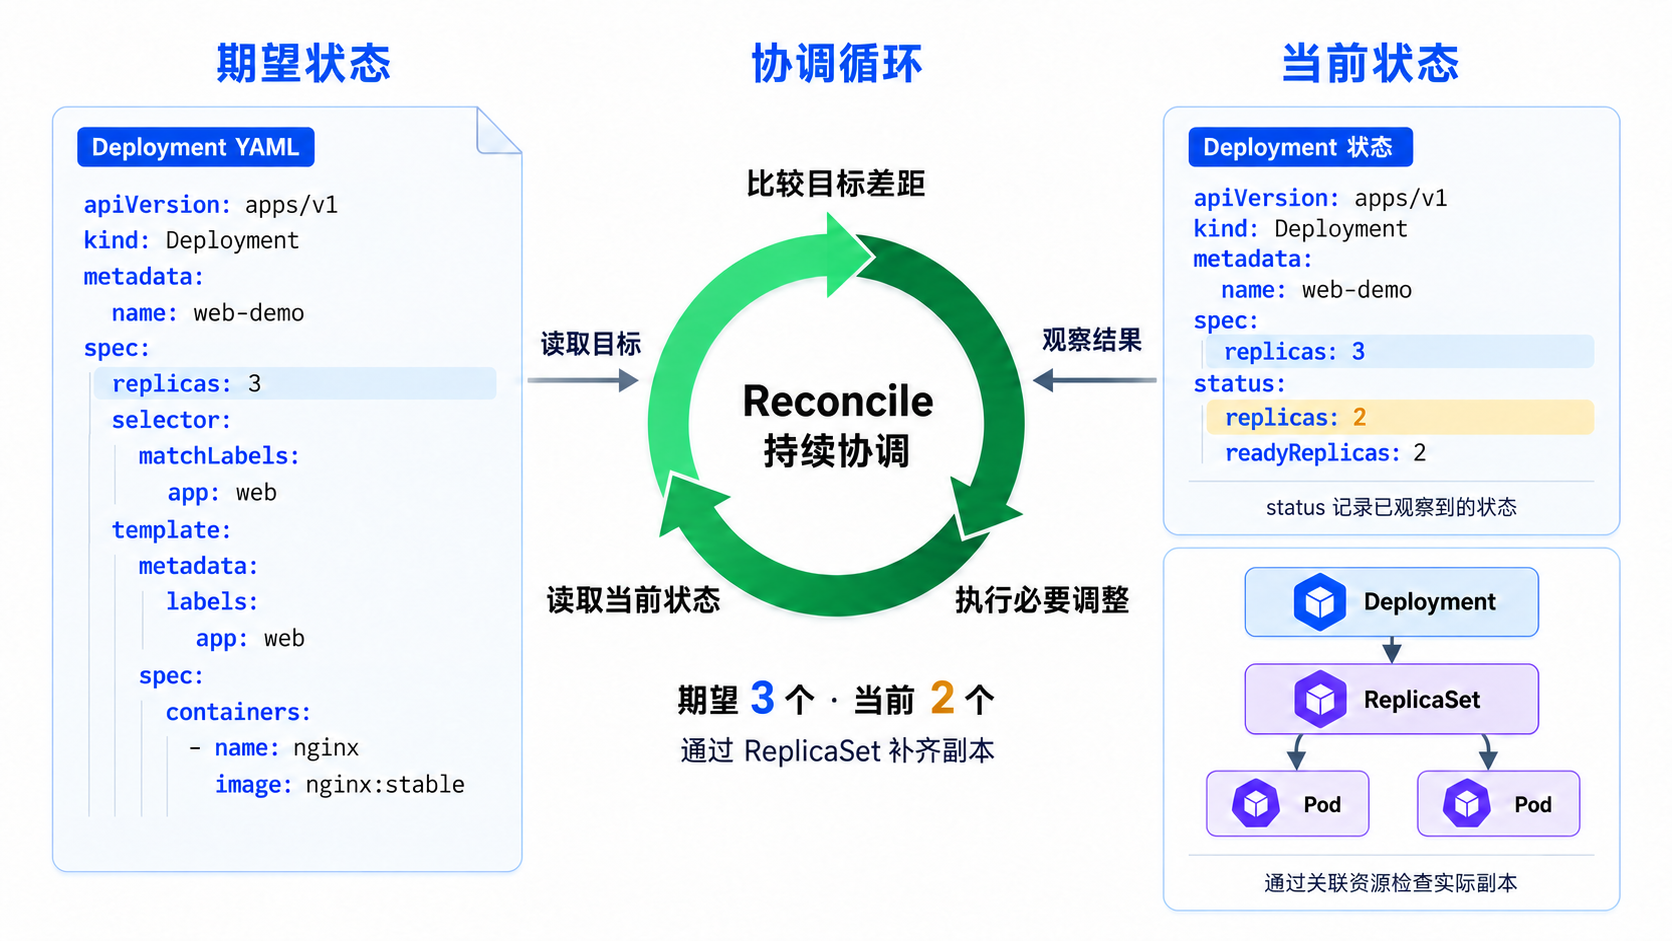
图:Deployment 协调循环。
- 读取与比较:左侧 Deployment 的
spec.replicas: 3声明期望三个副本,右侧status.replicas: 2和readyReplicas: 2表示最近观察到两个副本,且都已就绪。status是状态记录,控制器还会读取关联资源来判断需要执行的动作。 - 副本调整:Deployment Controller 将目标副本数落实到关联的 ReplicaSet。ReplicaSet Controller 读取它管理的 Pod,在目标为三个、当前只有两个且允许继续创建时,补充一个 Pod。
- 状态反馈:新 Pod 创建后,还需要调度、启动和就绪检查。相关控制器继续观察变化并更新状态,Deployment 的副本数和就绪副本数随之反映扩容进度;遇到临时失败时,可以退避后重试。
内置控制器
KCM 提供了多种内置控制器,负责工作负载、节点、服务发现、网络、存储和身份凭据等方面的管理,以及资源清理。
控制器清单
下表按职责分类,列出了常见的 KCM 内置控制器。点击控制器名称可查看对应的源码实现。
| 控制器 | 主要职责 |
|---|---|
| Deployment Controller | 为 Pod 和 ReplicaSet 提供声明式更新,支持滚动更新、回滚和扩缩容 |
| ReplicaSet Controller | 维护一组 Pod 副本,使其数量与 ReplicaSet 中声明的期望值保持一致 |
| StatefulSet Controller | 管理有状态应用的 Pod,保留稳定的网络标识和持久存储,按策略执行部署、扩缩容和更新 |
| DaemonSet Controller | 确保所有或指定的一组节点运行一份 Pod 副本,常用于日志采集、监控和网络组件 |
| Job Controller | 管理运行至完成的任务,创建 Pod、跟踪成功次数,并按策略重试失败任务 |
| CronJob Controller | 按周期性计划创建 Job,并管理任务的并发执行和历史 Job 的保留 |
| TTLAfterFinished Controller | 在配置的保留时间到期后,删除已成功或失败结束的 Job,并级联清理其 Pod |
| HorizontalPodAutoscaler(HPA)Controller | 根据 CPU、内存或其他指标,自动调整 Deployment、StatefulSet 等工作负载的副本数 |
| Disruption Controller | 根据 Pod 干扰预算(PDB)的可用性要求和 Pod 就绪情况,计算允许驱逐的数量,供 Eviction API 检查 |
| 控制器 | 主要职责 |
|---|---|
| NodeLifecycle Controller | 监测节点状态和心跳,在节点失联时更新健康状态,并根据节点状况维护污点 |
| TaintEviction Controller | 删除无法容忍节点 NoExecute 污点的 Pod;设置了容忍时长的 Pod 在到期后删除 |
| NodeIPAM Controller | 从集群的 Pod 地址范围中为各节点分配地址段,记录为 Node 的 PodCIDR |
| 控制器 | 主要职责 |
|---|---|
| EndpointSlice Controller | 为带选择器的 Service 维护 EndpointSlice,记录后端 Pod 的地址、端口和就绪等状态 |
| 控制器 | 主要职责 |
|---|---|
| PersistentVolumeBinder Controller | 按 PVC 的存储需求匹配 PV,维护绑定关系,并协调卷的动态创建与回收 |
| AttachDetach Controller | 根据 Pod 的用卷需求,将卷 Attach 到对应节点,并在不再需要且满足条件时执行 Detach |
| VolumeExpand Controller | 为 PVC 补充负责扩容的驱动注解 |
| PVProtection Controller | 保护仍与 PVC 绑定的 PV,解除绑定后移除删除保护 |
| PVCProtection Controller | 保护仍被 Pod 使用的 PVC,不再使用后移除删除保护 |
| VolumeAttributesClassProtection Controller | 保护仍被 PV 或 PVC 引用的 VolumeAttributesClass,引用解除后移除删除保护 |
| EphemeralVolume Controller | 为 Pod 中的通用临时卷创建 PVC,并将其所有者设为该 Pod,使 PVC 随 Pod 删除而被回收 |
| 控制器 | 主要职责 |
|---|---|
| ServiceAccount Controller | 为各命名空间创建并维护名为 default 的 ServiceAccount |
| ServiceAccountToken Controller | 为 ServiceAccount 的令牌 Secret 填充令牌等数据,并在 ServiceAccount 删除后清理关联 Secret |
| CSRApproving Controller | 识别 kubelet 客户端证书请求,对通过授权检查的 CSR 自动批准 |
| CSRSigning Controller | 使用配置的 CA 证书和私钥,为已批准且符合签发规则的 CSR 签发证书 |
| CSRCleaner Controller | 清理超过保留期限的 CSR,以及所签发证书已经过期的 CSR |
| RootCACertificatePublisher Controller | 在各命名空间维护 kube-root-ca.crt ConfigMap,供客户端验证 API Server 证书 |
| KubeAPIServerClusterTrustBundlePublisher Controller | 将验证 API Server 服务端证书所需的 CA 证书发布为 ClusterTrustBundle |
| ClusterRoleAggregation Controller | 按 aggregationRule 选择其他 ClusterRole,将其权限规则合并到目标 ClusterRole |
| BootstrapSigner Controller | 使用 Bootstrap Token 为 cluster-info ConfigMap 中的集群信息生成签名,供新节点校验 |
| TokenCleaner Controller | 删除已过期的 Bootstrap Token Secret |
| 控制器 | 主要职责 |
|---|---|
| ResourceQuota Controller | 统计命名空间中的资源用量,并更新 ResourceQuota 的配额状态 |
| Namespace Controller | 清理待删除命名空间中的资源,清理完成后解除命名空间的删除保护 |
| GarbageCollector Controller | 根据 ownerReferences 跟踪对象依赖,按删除传播策略回收依赖对象或解除所有权关系 |
| PodGarbageCollector Controller | 清理超过保留数量的已结束 Pod,以及节点已不存在等情况下遗留的 Pod |
工作负载
工作负载相关的控制器负责管理应用的 Pod,处理副本调整、应用更新和任务执行。不同类型的控制器适用于无状态应用、有状态应用、节点常驻组件和批处理任务等场景。
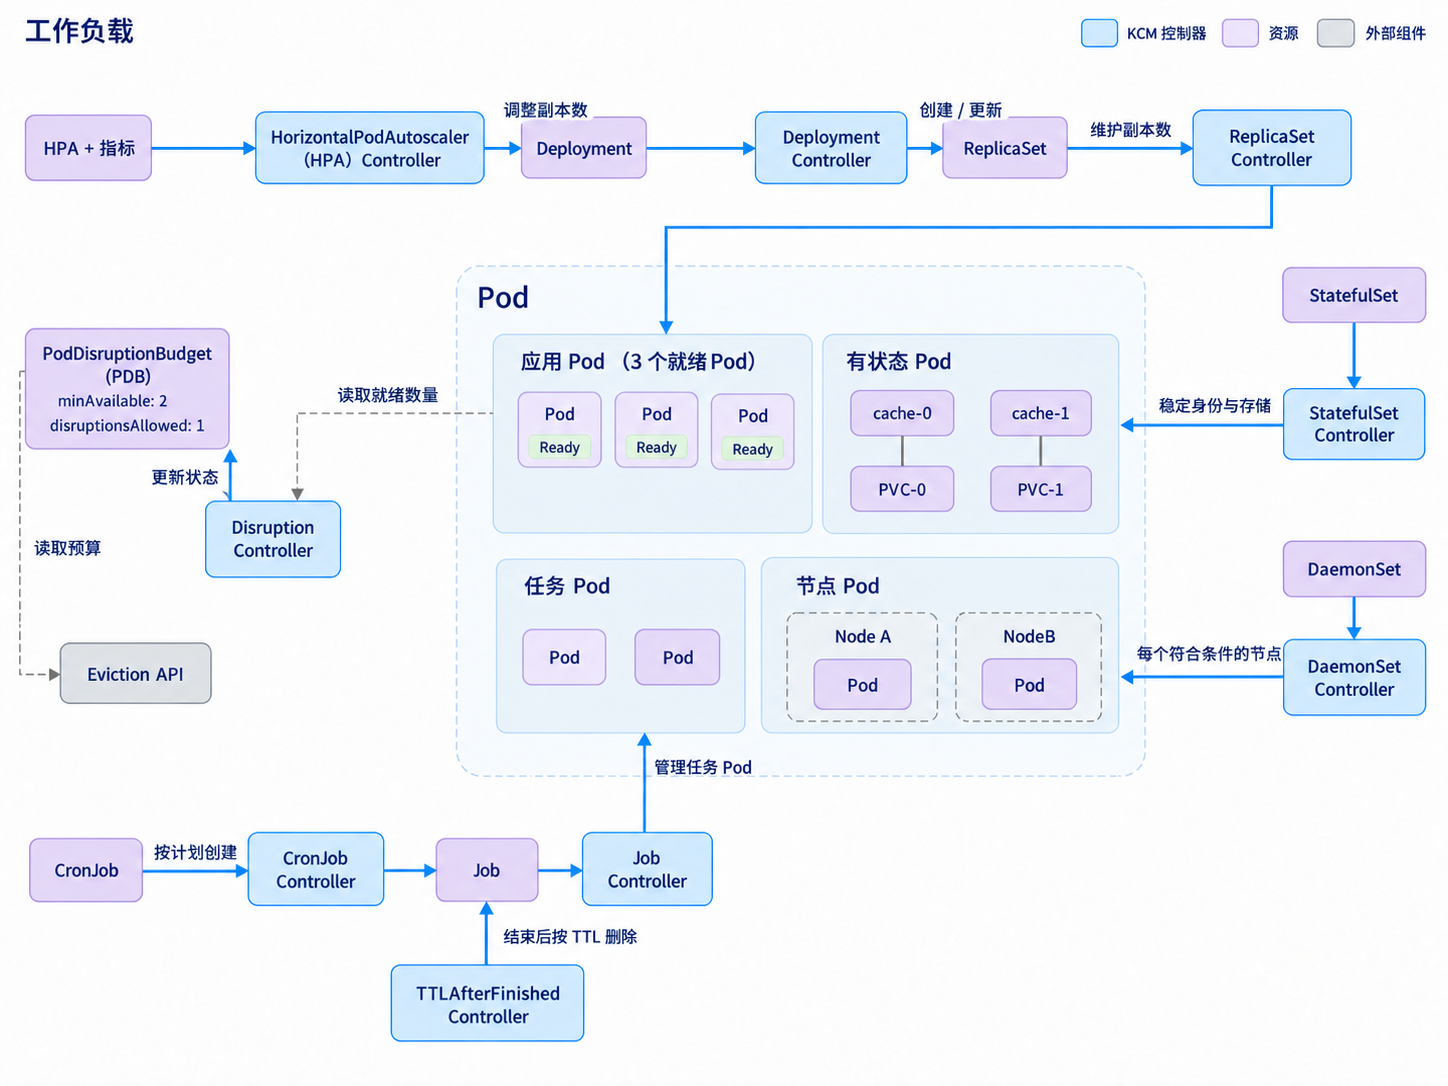
图:工作负载相关的控制器。
Deployment 和 ReplicaSet
Deployment Controller 根据 Deployment 声明的期望状态管理 ReplicaSet,支持应用的滚动更新、回滚和扩缩容。ReplicaSet Controller 管理一组 Pod 副本,使实际数量与 ReplicaSet 中声明的期望值保持一致。例如,将 Deployment 的副本数从 2 改为 3 后,Deployment Controller 会更新 ReplicaSet 的期望副本数,再由 ReplicaSet Controller 根据当前状态调整 Pod 数量,使其达到期望的 3 个副本。
Deployment 示例
这份配置声明两个 Nginx 副本。Deployment Controller 会根据 Pod 模板创建 ReplicaSet,再由 ReplicaSet Controller 管理 Pod。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  labels:
    app: web
spec:
  replicas: 2 # 期望维护两个 Pod 副本
  # 选择器与 Pod 模板中的标签对应。
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.28-alpine
          ports:
            - name: http
              containerPort: 80
replicas:期望的 Pod 数量。2表示维持两个副本,改为3则表示期望三个副本。selector与template.metadata.labels:选择器匹配 Pod 模板中的app: web标签,使控制器能够识别自己管理的 Pod。template:定义 Pod 中的容器配置,这里使用 Nginx 镜像。
StatefulSet
StatefulSet Controller 为 Pod 维护稳定的序号、网络标识和存储关联。Elasticsearch 这类集群应用可以通过稳定的 DNS 名称发现其他节点,并使用各自的数据卷保存数据。例如,es-1 重建后,Pod IP 可能变化,但仍会挂载 PVC data-es-1 对应的数据卷。
Elasticsearch 集群示例
示例通过 Headless Service 和 StatefulSet 定义三个 Elasticsearch 节点。各节点使用稳定的 DNS 名称发现彼此,通过 9300 端口通信,并分别使用独立的 PVC 保存数据。配置用于隔离的学习环境,关闭 Elasticsearch 的安全功能,并禁用 mmap。
apiVersion: v1
kind: Service
metadata:
  name: es
spec:
  clusterIP: None # Headless Service,为 Pod 提供独立的 DNS 记录
  publishNotReadyAddresses: true # 节点尚未就绪时也发布地址,供集群成员发现彼此
  selector:
    app: elasticsearch
  ports:
    - name: transport
      port: 9300 # Elasticsearch 节点间通信
      targetPort: transport
    - name: http
      port: 9200
      targetPort: http
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: es
spec:
  serviceName: es # 关联上面的 Headless Service
  replicas: 3
  podManagementPolicy: Parallel # 并行创建节点,避免首个节点等待其他节点组网
  selector:
    matchLabels:
      app: elasticsearch
  template:
    metadata:
      labels:
        app: elasticsearch
    spec:
      securityContext:
        fsGroup: 1000 # 让容器中的 Elasticsearch 进程可以写入数据卷
      containers:
        - name: elasticsearch
          image: docker.elastic.co/elasticsearch/elasticsearch:9.5.5
          env:
            - name: cluster.name
              value: search-demo
            - name: node.name
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name # 使用 Pod 名称作为 Elasticsearch 节点名称
            - name: node.roles
              value: master,data,ingest
            - name: discovery.seed_hosts
              value: es-0.es,es-1.es,es-2.es
            - name: cluster.initial_master_nodes
              value: es-0,es-1,es-2 # 仅首次组建集群使用,组建成功后移除此配置
            - name: xpack.security.enabled
              value: "false" # 仅用于隔离的学习环境,关闭认证等安全功能
            - name: node.store.allow_mmap
              value: "false" # 示例禁用 mmap,无需修改宿主机的虚拟内存参数
            - name: ES_JAVA_OPTS
              value: "-Xms1g -Xmx1g"
          ports:
            - name: transport
              containerPort: 9300
            - name: http
              containerPort: 9200
          resources:
            requests:
              cpu: 500m
              memory: 2Gi
            limits:
              memory: 2Gi
          readinessProbe:
            httpGet:
              path: /_cluster/health?wait_for_status=yellow&timeout=1s
              port: http
            initialDelaySeconds: 10
            periodSeconds: 10
            timeoutSeconds: 3
          volumeMounts:
            - name: data
              mountPath: /usr/share/elasticsearch/data # 保存当前节点的数据与集群元数据
  # 为每个 Pod 分别申请 PVC,省略存储类时使用默认 StorageClass。
  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 10Gi
clusterIP: None与serviceName: es:将 StatefulSet 的网络标识关联到 Headless Service。在同一命名空间内,三个节点的 DNS 名称分别为es-0.es、es-1.es和es-2.es。node.name与discovery.seed_hosts:使用 Pod 名称标识 Elasticsearch 节点,并将上述 DNS 名称作为发现其他节点的入口。Elasticsearch 通过这些地址联系集群成员,完成节点发现与组网;具体配置见官方的节点发现设置。cluster.initial_master_nodes:列出首次选举时参与投票的节点名称,与node.name一致。集群首次组建成功后,应从配置中移除这一项,后续重启和加入节点时保留discovery.seed_hosts;这是 Elasticsearch 的集群引导要求。podManagementPolicy: Parallel:并行创建三个 Pod,避免第一个节点等待其他节点加入集群,而后续 Pod 又在等待第一个节点就绪。publishNotReadyAddresses: true:让尚未就绪的 Pod 也有 DNS 记录,使节点在组网阶段就能通过名称找到彼此。volumeClaimTemplates与volumeMounts:为每个 Pod 申请独立的 10 GiB 存储,生成data-es-0、data-es-1和data-es-2,分别挂载到各节点的/usr/share/elasticsearch/data。这里省略了storageClassName,由集群的默认 StorageClass 提供存储。
DaemonSet
DaemonSet Controller 在符合条件的节点上维护指定 Pod,常用于日志采集或节点监控。新节点加入且满足选择条件时,控制器为它创建 Pod。节点标签或 Pod 状态变化后,控制器会重新检查哪些节点需要运行这些 Pod。
DaemonSet 示例
示例通过自定义节点标签选择运行范围,并在符合条件的节点上维护常驻 Pod。
apiVersion: apps/v1
kind: DaemonSet # 在每个符合条件的节点上维护一个 Pod
metadata:
  name: node-agent
spec:
  selector:
    matchLabels:
      app: node-agent
  template:
    metadata:
      labels:
        app: node-agent
    spec:
      nodeSelector:
        example.com/node-agent: enabled
      containers:
        - name: agent
          image: busybox:1.37
          command: ["sh", "-c", "while true; do date; sleep 60; done"]
nodeSelector:匹配节点上的自定义标签example.com/node-agent: enabled。template:定义节点上的 Pod 配置,示例容器每隔 60 秒打印一次时间。
Job 和 CronJob
Job Controller 管理任务 Pod,按照完成次数、并行度和重试规则推进任务。CronJob Controller 按计划创建 Job,例如每小时启动一次数据处理,并按配置处理并发执行和历史记录。
Job 和 CronJob 示例
这份配置包含一次性 Job 和每小时执行的 CronJob,两者都打印时间和 report complete 后退出。前者创建后即可执行,后者在计划时间创建 Job。
apiVersion: batch/v1
kind: Job
metadata:
  name: report-once
spec:
  completions: 1 # 需要一个 Pod 成功完成
  parallelism: 1 # 同时运行的任务 Pod 数量
  backoffLimit: 2 # 失败重试上限
  template:
    spec:
      restartPolicy: Never # 容器失败后,由 Job Controller 创建新的 Pod 重试
      containers:
        - name: report
          image: busybox:1.37
          command: ["sh", "-c", "date; echo report complete"]
---
apiVersion: batch/v1
kind: CronJob
metadata:
  name: report-hourly
spec:
  schedule: "0 * * * *" # 每小时整点创建 Job
  timeZone: Etc/UTC # 按 UTC 时区解释调度时间
  concurrencyPolicy: Forbid # 前一个任务未结束时跳过本次执行
  successfulJobsHistoryLimit: 1 # 保留一个成功的历史 Job
  failedJobsHistoryLimit: 1 # 保留一个失败的历史 Job
  jobTemplate: # CronJob 创建 Job 时使用的模板
    spec:
      backoffLimit: 2
      template:
        spec:
          restartPolicy: Never
          containers:
            - name: report
              image: busybox:1.37
              command: ["sh", "-c", "date; echo report complete"]
completions与parallelism:一次性 Job 需要一个 Pod 成功完成,同时最多运行一个任务 Pod。backoffLimit与restartPolicy:失败重试上限为2;Never表示容器失败后由 Job Controller 创建新的 Pod 重试。schedule与timeZone:按 UTC 时区,每小时整点创建一次 Job。jobTemplate:CronJob 创建 Job 时使用的模板,其中的template再定义任务 Pod。concurrencyPolicy: Forbid:同一 CronJob 的前一个任务还在运行时,跳过本次执行。successfulJobsHistoryLimit与failedJobsHistoryLimit:分别保留一个成功和一个失败的历史 Job。
TTLAfterFinished
TTLAfterFinished Controller 按 Job 的 spec.ttlSecondsAfterFinished 清理已结束的任务,包括成功(Complete)和失败(Failed)的 Job。例如,设置为 300,表示 Job 结束 300 秒后可以被清理,删除时还会级联回收关联 Pod。
Job 自动清理示例
示例通过 ttlSecondsAfterFinished 声明 Job 结束后的保留时长,任务内容是一条打印语句。
apiVersion: batch/v1
kind: Job
metadata:
  name: report-ttl
spec:
  # 从 Job 进入 Complete 或 Failed 状态后开始计时。
  ttlSecondsAfterFinished: 300 # 结束 300 秒后可被清理
  backoffLimit: 2
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: report
          image: busybox:1.37
          command: ["sh", "-c", "echo report complete"]
ttlSecondsAfterFinished: 300:从 Job 进入Complete或Failed状态后开始计时,300 秒后可以被清理。
HorizontalPodAutoscaler(HPA)
HorizontalPodAutoscaler(HPA)Controller 根据资源、自定义或外部指标计算目标副本数,并遵守配置的上下限和扩缩容策略。它通过目标资源的 scale 子资源提交副本调整。例如,HPA 将 Deployment 的目标从 2 改为 3 后,Deployment 和 ReplicaSet Controller 继续完成实际的副本创建。
HPA 示例
示例同时定义 web Deployment 和对应的 HPA,初始副本数设为 2,之后由 HPA 根据 CPU 利用率在 2 到 5 之间调整。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.28-alpine
          ports:
            - name: http
              containerPort: 80
          resources:
            requests:
              cpu: 100m
---
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: web
spec:
  scaleTargetRef: # 指向同一命名空间中的 web Deployment
    apiVersion: apps/v1
    kind: Deployment
    name: web
  minReplicas: 2 # 副本数下限
  maxReplicas: 5 # 副本数上限
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 60 # 目标为 CPU 请求量的 60%
scaleTargetRef:指定要调整的 Deployment 为同一命名空间中的web。resources.requests.cpu:Deployment 的容器配置了100mCPU 请求,作为 HPA 计算 CPU 利用率的基准。minReplicas与maxReplicas:副本数的下限为2,上限为5。metrics:使用 Pod 的 CPU 资源指标,由metrics.k8s.ioAPI 提供,通常通过 Metrics Server 采集。averageUtilization: 60:目标 CPU 利用率为请求量的 60%。示例中每个容器请求100mCPU,因此目标相当于平均每个 Pod 使用约60mCPU。
Pod 干扰预算(PDB)
节点维护或升级时,PDB 用于在 kubectl drain 等主动驱逐操作中保留足够的可用副本。Disruption Controller 根据 PDB 的要求和所选 Pod 的就绪情况,计算允许驱逐的数量并写入 PDB 状态,供 API Server 处理 Eviction API 请求时检查。
PDB 示例
Deployment web 声明三个副本,Pod 使用 app: web 标签:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  labels:
    app: web
spec:
  replicas: 3 # 期望维护三个 Pod 副本
  # 选择器与 Pod 模板中的标签对应。
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.28-alpine
          ports:
            - name: http
              containerPort: 80
PDB 通过标签选择这些 Pod,要求主动驱逐后至少保留两个可用副本:
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: web
spec:
  minAvailable: 2 # 主动驱逐后至少保留两个可用副本
  selector:
    matchLabels:
      app: web # 选择带有此标签的 Pod
selector:通过app: web标签选择 Pod,与 Deployment 的 Pod 模板标签一致。minAvailable: 2:要求主动驱逐后至少保留两个可用副本。
Disruption Controller 将允许驱逐的数量写入 status.disruptionsAllowed。假设三个 Pod 都已就绪,且没有尚未完成的驱逐请求,状态部分可以表示为:
节点生命周期
节点生命周期相关的控制器负责监测节点健康、维护节点状态,处理节点异常时的 Pod 驱逐,并为节点分配 Pod 地址段。
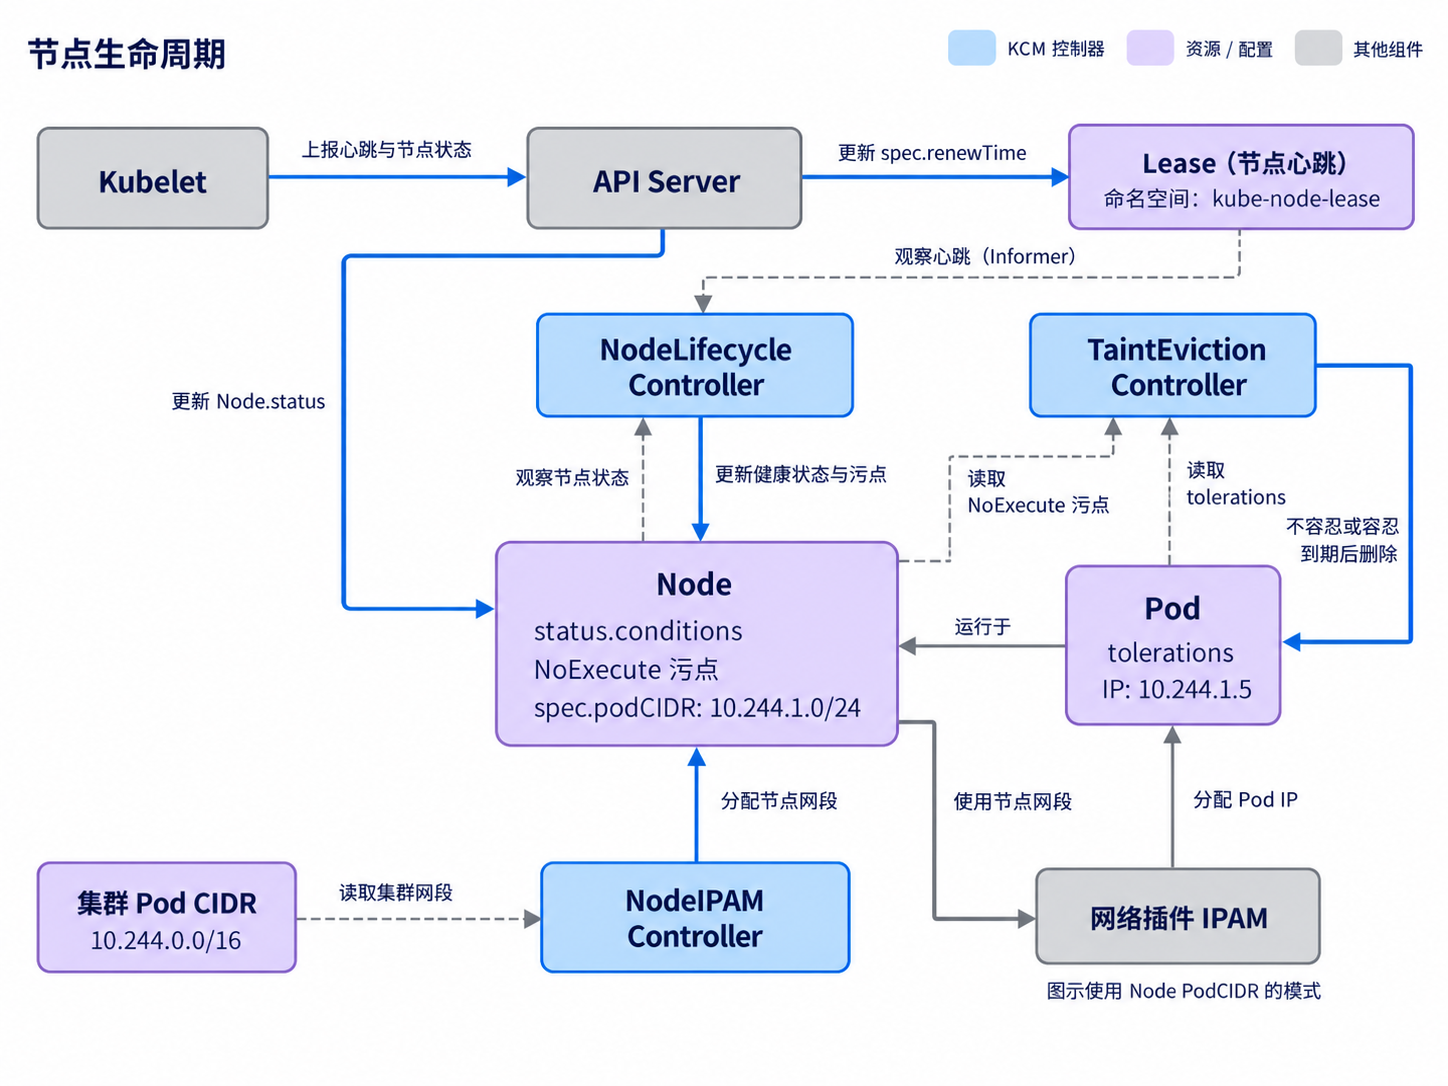
图:节点生命周期相关的控制器。
节点健康
每个节点在 kube-node-lease 命名空间中都有一个与节点同名的 Lease,Kubelet 定期通过 API Server 更新其 spec.renewTime,完成节点心跳上报。Kubelet 也会上报 Node 状态,NodeLifecycle Controller 结合 Node 状态和 Lease 的续约情况判断节点是否健康。节点报告未就绪或心跳长时间未更新时,控制器会维护相应的节点状态和污点;节点恢复后再更新这些状态与污点。
节点健康示例
示例展示 worker-1 的 Node 状态和对应的 Lease。Node 状态由 Kubelet 与相关控制器维护,Lease 的续约时间由 Kubelet 更新。
apiVersion: v1
kind: Node
metadata:
  name: worker-1
status:
  conditions:
    - type: Ready
      status: "True" # 节点报告就绪
---
apiVersion: coordination.k8s.io/v1
kind: Lease
metadata:
  name: worker-1 # 与 Node 名称一致
  namespace: kube-node-lease
spec:
  holderIdentity: worker-1
  renewTime: "2026-01-01T00:00:00.000000Z" # 示例时间,Kubelet 持续更新此字段
Node.status.conditions:Ready条件的status: "True"表示节点报告就绪。控制器还会结合心跳更新情况判断节点健康。Lease.metadata:Lease 与 Node 同名,位于kube-node-lease命名空间。holderIdentity:标识 Lease 的持有者,这里使用节点名worker-1。renewTime:记录最近一次续约时间,Kubelet 通过 API Server 持续更新这个字段。
污点驱逐
TaintEviction Controller 根据节点的 NoExecute 污点和 Pod 的容忍配置,决定是否以及何时删除 Pod。例如,Pod 对节点不可达的容忍时长设为 60 秒,超过这段时间后便会被安排删除。若污点在到期前移除,控制器可以取消尚未执行的删除任务。
污点驱逐示例
worker-1 失联后,NodeLifecycle Controller 会为节点添加 node.kubernetes.io/unreachable 污点,效果为 NoExecute。示例中的 web Pod 设置了 tolerationSeconds: 60,表示可以容忍这个污点 60 秒。若容忍时间到期时污点仍然存在,TaintEviction Controller 会向 API Server 发起删除该 Pod 的请求。
apiVersion: v1
kind: Node
metadata:
  name: worker-1
spec:
  taints:
    - key: node.kubernetes.io/unreachable
      effect: NoExecute
---
apiVersion: v1
kind: Pod
metadata:
  name: web
spec:
  nodeName: worker-1 # 表示 Pod 已绑定到该节点
  tolerations:
    - key: node.kubernetes.io/unreachable
      operator: Exists
      effect: NoExecute
      tolerationSeconds: 60 # 容忍该污点 60 秒
  containers:
    - name: nginx
      image: nginx:1.28-alpine
Node.spec.taints:node.kubernetes.io/unreachable表示节点不可达,NoExecute会触发对节点上已有 Pod 的容忍检查。Pod.spec.nodeName:表示这个 Pod 已绑定到worker-1,因此会受到该节点污点的影响。tolerations:key和effect与节点污点对应;operator: Exists表示按键匹配,无需指定污点值。tolerationSeconds: 60:允许 Pod 在该污点出现后继续留在节点上 60 秒;污点持续存在且容忍时间到期后,控制器安排删除 Pod。
节点地址分配
NodeIPAM Controller 为节点分配 Pod 使用的 IP 地址段。例如,从集群的 10.244.0.0/16 中,为两个节点分别分配 10.244.1.0/24 和 10.244.2.0/24,写入各自 Node 对象的 spec.podCIDR 字段。使用这些地址段的网络插件,再从中为 Pod 分配具体 IP。
地址段也可以由网络插件自行管理。例如,Calico CNI 默认使用 calico-ipam,Cilium 的通用 Helm 安装默认使用 cluster-pool;这两种模式下,Pod 地址分配不依赖 NodeIPAM。
节点地址分配示例
示例记录 NodeIPAM 分配后的两个 Node 对象,各自的 /24 网段都属于集群的 10.244.0.0/16。
apiVersion: v1
kind: Node
metadata:
  name: worker-1
spec:
  podCIDR: 10.244.1.0/24
---
apiVersion: v1
kind: Node
metadata:
  name: worker-2
spec:
  podCIDR: 10.244.2.0/24
spec.podCIDR:Node 对象中记录 Pod 地址段的字段。worker-1与worker-2分别使用10.244.1.0/24和10.244.2.0/24,两个地址段互不重叠。- Pod IP 分配:使用节点地址段的网络插件可以从
worker-1的网段中分配10.244.1.5给某个 Pod,具体地址由网络插件的 IPAM 机制管理。
服务网络
服务网络相关的控制器负责维护 Service 的后端信息。Service 为应用提供稳定的访问入口,后端可以是集群内的 Pod,也可以是集群外的服务。
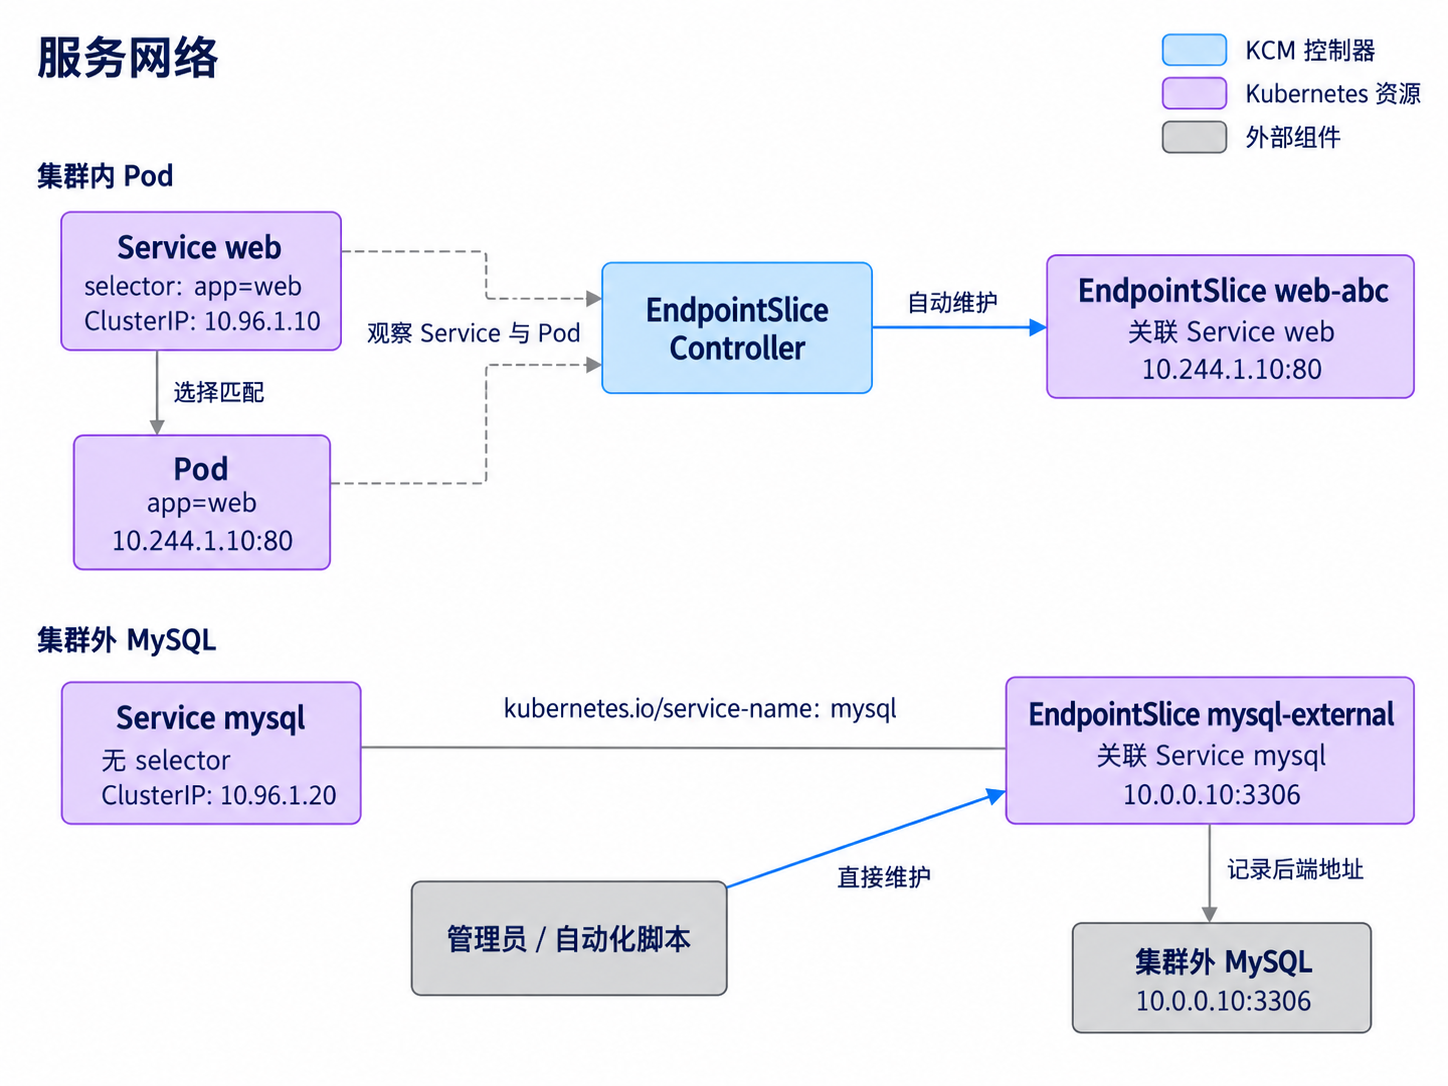
图:Service 后端维护。
服务端点(EndpointSlice)
EndpointSlice 记录 Service 后端的地址、端口和就绪状态。早期的 Endpoints 将同一个 Service 的后端集中保存在一个对象中,后端变化时需要向监听方发送整个对象,后端越多,更新开销越大。EndpointSlice 将后端拆分到多个较小的对象中,只更新发生变化的分片,减少传输和处理开销,并支持 IPv4/IPv6 双栈。
-
集群内 Pod
EndpointSlice Controller 为带选择器的 Service 自动创建并更新 EndpointSlice。例如,
webService 通过app=web选择 Pod,控制器将这些 Pod 的地址、端口和就绪状态写入 EndpointSlice。Pod 新增、删除或就绪状态变化后,控制器更新后端记录,供 kube-proxy 等组件配置流量转发。集群内 Pod 示例
示例创建一个
webService,为前面webDeployment 管理的 Pod 提供访问入口。examples/chapter-01/04-kube-controller-manager/service-network/service-web.yamlapiVersion: v1 kind: Service metadata: name: web spec: type: ClusterIP # 匹配同命名空间中 web Deployment 管理的 Pod。 selector: app: web ports: - name: http protocol: TCP port: 80 targetPort: http # 对应 Pod 模板中名为 http 的容器端口type: ClusterIP:提供集群内部的访问入口,ClusterIP 地址由集群分配。selector:通过app: web标签匹配同命名空间中的 Pod,与前面 Deployment 的 Pod 标签对应。port: 80:指定 Service 的访问端口,同命名空间中的应用可以通过web:80访问。targetPort: http:对应 Pod 模板中名为http的容器端口,实际端口为80。
-
集群外 MySQL
对于集群外的数据库,可以创建不带
selector的 Service,由管理员或自动化脚本直接维护对应的 EndpointSlice。例如,mysqlService 关联的 EndpointSlice 记录外部地址10.0.0.10:3306,同命名空间中的应用通过mysql:3306访问数据库。外部地址变化后,维护者更新 EndpointSlice,应用继续使用原来的 Service 名称。集群外 MySQL 示例
示例创建一个
mysqlService 和一个mysql-externalEndpointSlice,为集群外的 MySQL 提供集群内的访问入口。examples/chapter-01/04-kube-controller-manager/service-network/service-mysql-external.yamlapiVersion: v1 kind: Service metadata: name: mysql spec: type: ClusterIP # 后端是集群外的数据库,不配置 selector。 ports: - name: mysql protocol: TCP port: 3306 targetPort: 3306 --- apiVersion: discovery.k8s.io/v1 kind: EndpointSlice metadata: name: mysql-external labels: # 关联同命名空间中的 mysql Service。 kubernetes.io/service-name: mysql addressType: IPv4 ports: - name: mysql # 与 Service 的端口名称一致 protocol: TCP port: 3306 endpoints: - addresses: - "10.0.0.10" # 替换为集群网络能够访问的数据库地址 conditions: ready: true # 后端就绪状态由管理员或脚本维护selector:Service 省略此字段,后端地址由配套的 EndpointSlice 指定。kubernetes.io/service-name: mysql:将 EndpointSlice 关联到mysqlService,两者应位于同一命名空间。ports:Service 与 EndpointSlice 的端口名称均为mysql,协议均为TCP。Service 的访问端口和 EndpointSlice 记录的后端端口均为3306。endpoints[].addresses:记录后端 IP,将10.0.0.10替换为集群网络能够访问的 MySQL 地址。endpoints[].conditions.ready: true:声明该后端可以接收流量,就绪状态也由管理员或脚本维护。
相关配置要求见 Service 的无选择器用法。
存储管理
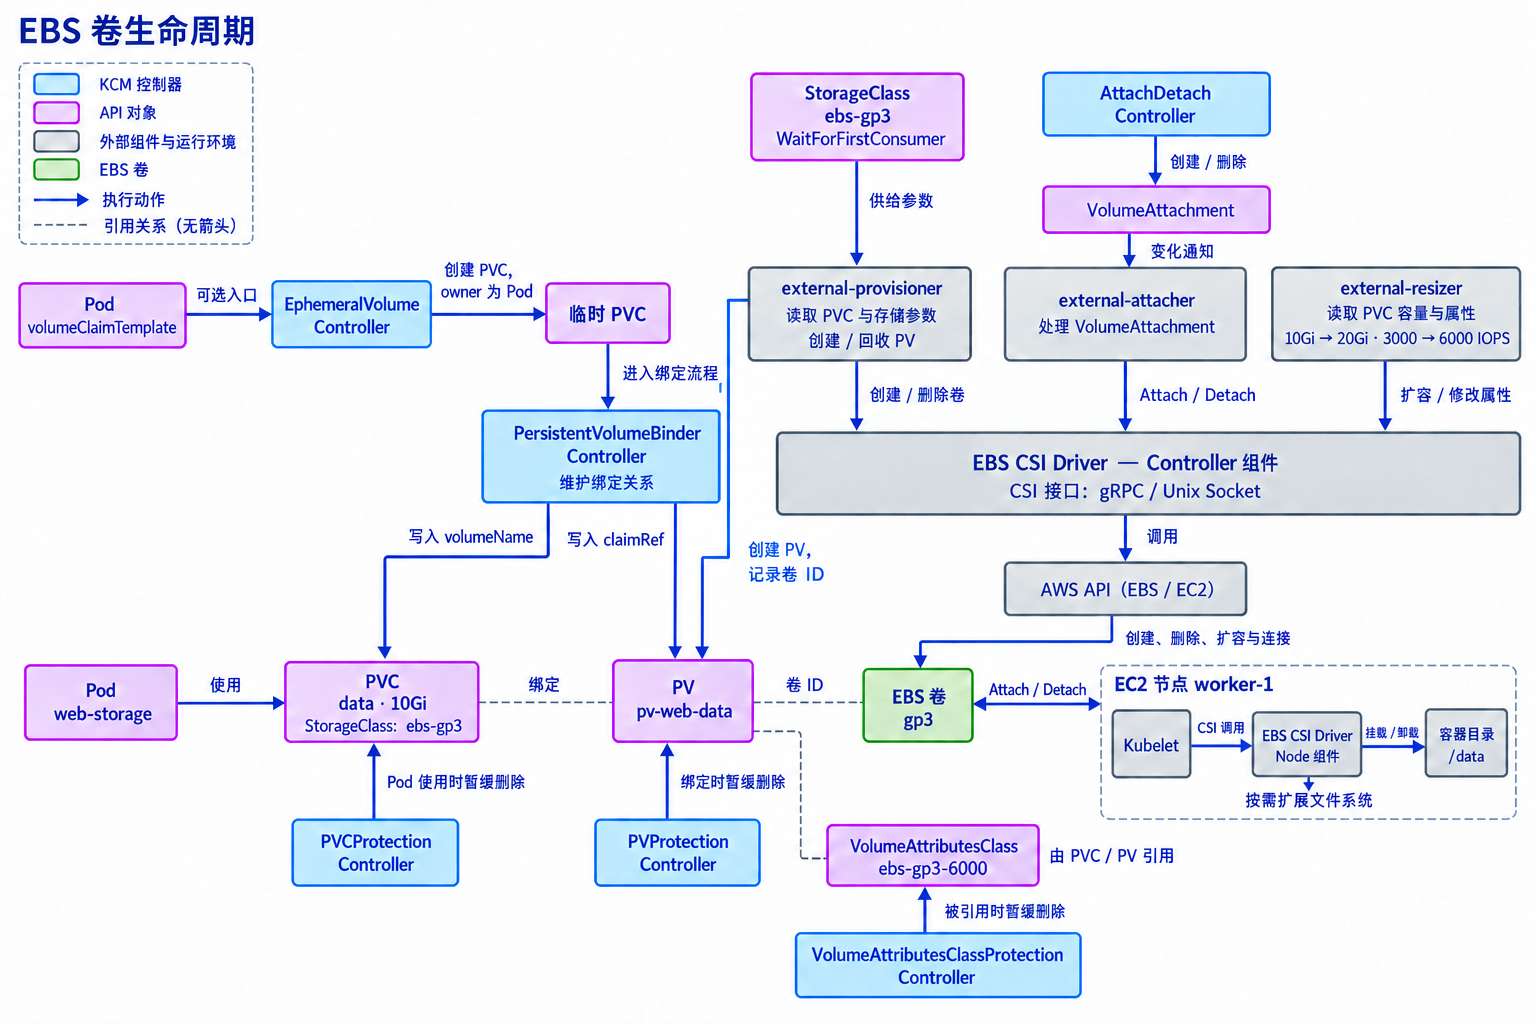
图:EBS 卷生命周期。
KCM 中的存储控制器负责 PV/PVC 绑定、卷的 Attach / Detach 协调、临时 PVC 创建和删除保护。在图中的 EBS 场景下,它们与以下组件配合管理卷的生命周期:
- CSI 辅助容器:external-provisioner、external-attacher 和 external-resizer 观察 PVC、VolumeAttachment 等 Kubernetes 对象,通过 CSI 接口向驱动发起请求,与驱动之间使用 Unix Socket 通信。
- EBS CSI Driver 的 Controller 组件:通过 Deployment
ebs-csi-controller运行,与上述辅助容器部署在同一个 Pod 中。它接收辅助容器的请求,调用 AWS API 创建、删除或扩容 EBS 卷,执行 Attach / Detach,以及调整 IOPS 等卷属性。部署方式与职责分工见 EBS CSI Driver 设计文档。 - EBS CSI Driver 的 Node 组件:通过 DaemonSet
ebs-csi-node运行,在符合部署条件的节点上各运行一个 Pod。它接受所在节点 Kubelet 的 CSI 调用,完成卷的挂载、卸载及必要的文件系统扩容,使容器能够访问卷中的数据。
PV/PVC 绑定
PersistentVolumeBinder Controller 根据 PVC 声明的容量、访问模式和 StorageClass 等条件匹配 PV,并维护二者的绑定关系。使用 EBS 动态供给时,处理过程如下:
- 创建 EBS 卷:external-provisioner 读取 PVC 和 StorageClass,调用 EBS CSI Driver 的 Controller 组件,由后者通过 AWS API 创建 EBS 卷。
- 创建 PV:卷创建成功后,external-provisioner 创建对应的 PV,在其中记录 EBS 卷 ID。
- 绑定 PV/PVC:PersistentVolumeBinder Controller 完成 PV 与 PVC 的绑定,使 PVC 的
spec.volumeName指向 PV,PV 的spec.claimRef指向 PVC。
PV/PVC 绑定示例
示例使用 Amazon EBS CSI Driver,为 data PVC 动态申请一个 10Gi 的 gp3 卷,供 web-storage Pod 使用。这里假设 Pod 运行在 AWS EC2 节点上,驱动已安装并获得创建和管理 EBS 卷所需的 AWS 权限。
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ebs-gp3
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  csi.storage.k8s.io/fstype: ext4
volumeBindingMode: WaitForFirstConsumer # 根据 Pod 的调度需求选择可用区
allowVolumeExpansion: true
reclaimPolicy: Delete
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: data
  namespace: default
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: ebs-gp3
  resources:
    requests:
      storage: 10Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: web-storage
  namespace: default
spec:
  containers:
    - name: nginx
      image: nginx:1.28-alpine
      volumeMounts:
        - name: data
          mountPath: /usr/share/nginx/html
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: data
provisioner: ebs.csi.aws.com:指定 Amazon EBS CSI Driver,由配套的 external-provisioner 调用 EBS CSI Driver 的 Controller 组件创建 EBS 卷。parameters:type: gp3选择 EBS 卷类型,csi.storage.k8s.io/fstype: ext4指定文件系统类型。storageClassName: ebs-gp3:PVC 引用这个 StorageClass,采用其中定义的卷创建方式。- 容量与访问模式:PVC 申请
10Gi,使用ReadWriteOnce,表示卷可以由一个节点以读写方式挂载。 volumeBindingMode: WaitForFirstConsumer:等待使用该 PVC 的 Pod 进入调度流程,再结合调度需求选择可用区并创建 EBS 卷,使卷与目标节点位于同一可用区。claimName: data:Pod 使用同命名空间中的dataPVC。卷完成 Attach 后,Kubelet 调用 EBS CSI Driver 的 Node 组件完成挂载,容器通过mountPath指定的目录访问数据。allowVolumeExpansion: true:允许后续增大 PVC 的容量请求,卷扩容示例会继续使用这个配置。reclaimPolicy: Delete:PVC 删除并满足回收条件后,由存储组件回收对应 PV 和底层 EBS 卷。
动态生成的 PV 会记录 CSI 驱动名和 AWS 返回的 EBS 卷 ID。绑定完成后,PVC 的 spec.volumeName 指向该 PV,PV 的 spec.claimRef 指向 PVC,两者的绑定状态更新为 Bound。
下面以绑定到 default/data 的 pv-web-data 为例,展示绑定后的 PV 结构,claimRef 记录这份 PVC 的名称、命名空间和 UID。
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-web-data
spec:
  capacity:
    storage: 10Gi
  volumeMode: Filesystem
  accessModes:
    - ReadWriteOnce
  storageClassName: ebs-gp3
  persistentVolumeReclaimPolicy: Delete
  claimRef: # 指向 default 命名空间中的 data PVC
    apiVersion: v1
    kind: PersistentVolumeClaim
    name: data
    namespace: default
    uid: c8d74a62-5f31-4a9d-8e06-b92c713af540
  csi:
    driver: ebs.csi.aws.com
    volumeHandle: vol-0c7a4d9e2b6f81305 # AWS 中这块 EBS 卷的标识
    fsType: ext4
  nodeAffinity: # 使用该卷的节点须与 EBS 卷位于同一可用区
    required:
      nodeSelectorTerms:
        - matchExpressions:
            - key: topology.kubernetes.io/zone
              operator: In
              values:
                - us-east-1a
status:
  phase: Bound
spec.claimRef:name: data和namespace: default指向绑定的 PVC,uid标识这份具体对象,避免与以后重新创建的同名 PVC 混淆。它与 PVC 的spec.volumeName: pv-web-data共同记录双方的绑定关系。spec.csi:driver指定处理该卷的 EBS CSI Driver,volumeHandle标识实际的 EBS 卷,fsType指定使用 ext4 文件系统。spec.nodeAffinity:要求使用该卷的节点位于us-east-1a,与 EBS 卷处于同一可用区。status.phase: Bound:表示这个 PV 已绑定到claimRef指向的 PVC。
Attach / Detach
Pod 使用图中的 EBS 文件系统卷时,需要先将卷 Attach 到对应的 EC2 实例,再由节点侧完成挂载。相关组件的分工如下:
- Attach:AttachDetach Controller 根据 Pod 使用的卷和所在节点创建 VolumeAttachment。external-attacher 观察到该对象后,调用 EBS CSI Driver 的 Controller 组件,由它通过 AWS API 将 EBS 卷 Attach 到对应的 EC2 实例。
- 挂载:Attach 完成后,Kubelet 调用 EBS CSI Driver 的 Node 组件,将卷挂载到供 Pod 使用的路径,容器通过配置的
mountPath访问数据。 - 卸载:Pod 退出后,Kubelet 调用 EBS CSI Driver 的 Node 组件,卸载供该 Pod 使用的卷。
- Detach:节点不再需要该卷且满足 Detach 条件时,AttachDetach Controller 请求删除对应的 VolumeAttachment,external-attacher 再调用 EBS CSI Driver 的 Controller 组件执行 Detach。
Attach 示例
web-storage Pod 调度到 worker-1 后,AttachDetach Controller 创建 VolumeAttachment,记录 PV pv-web-data 与该节点的对应关系。随 EBS CSI Driver 部署的 external-attacher 监听该对象,调用 EBS CSI Driver 的 Controller 组件将 EBS 卷 Attach 到对应的 EC2 实例,使卷以块设备形式出现在节点上。
apiVersion: storage.k8s.io/v1
kind: VolumeAttachment
metadata:
  name: ebs-attachment-demo
spec:
  attacher: ebs.csi.aws.com
  source:
    persistentVolumeName: pv-web-data
  nodeName: worker-1
status:
  attached: true # external-attacher 写回的 Attach 结果
nodeName: worker-1:指向 Pod 已调度到的节点,表示需要将 EBS 卷 Attach 到这个节点。attacher: ebs.csi.aws.com:标识负责处理该卷的 CSI 驱动,external-attacher 据此筛选需要处理的 VolumeAttachment。source.persistentVolumeName: pv-web-data:引用dataPVC 绑定的 PV,驱动通过 PV 中的spec.csi.volumeHandle找到对应的 EBS 卷。status.attached: true:由 external-attacher 写回,表示 Attach 已完成。Kubelet 还要调用 EBS CSI Driver 的 Node 组件完成挂载,容器才能通过mountPath指定的路径访问数据。
卷扩容
增加 PVC 的容量请求后,图中的 EBS 文件系统卷需要完成两部分扩容:
- 卷容量:external-resizer 观察到 PVC 的变化,调用 EBS CSI Driver 的 Controller 组件,通过 AWS API 扩大 EBS 卷,再更新 PV 的容量。
- 文件系统:Kubelet 调用 EBS CSI Driver 的 Node 组件完成文件系统扩容,让容器能够使用新增空间。
卷扩容示例
将 data PVC 的容量请求从 10Gi 改为 20Gi,继续使用前面的 ebs-gp3 StorageClass 和原有 EBS 卷。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: data
  namespace: default
spec:
  storageClassName: ebs-gp3
  volumeName: pv-web-data
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 20Gi # 从原来的 10Gi 调整为 20Gi
status:
  phase: Bound
  capacity:
    storage: 10Gi # 状态仍记录扩容前的容量
storageClassName: ebs-gp3:复用前面定义的 StorageClass,其中的allowVolumeExpansion: true允许提高容量请求。volumeName:继续指向原有 PV,这次调整是在原 EBS 卷上扩容。spec.resources.requests.storage: 20Gi:声明扩容后的目标容量,external-resizer 调用 EBS CSI Driver 的 Controller 组件扩大 EBS 卷。status.capacity.storage: 10Gi:PVC 中记录的容量仍为10Gi;扩容完成后,会更新为20Gi。
删除保护
存储对象仍被使用或引用时,需要暂缓删除,避免影响应用的数据访问或丢失仍在使用的配置。以下控制器分别维护相应对象的删除保护:
- PVCProtection Controller:保护仍被 Pod 使用的 PVC。
- PVProtection Controller:保护仍与 PVC 绑定的 PV。
- VolumeAttributesClassProtection Controller:保护仍被 PV 或 PVC 引用的 VolumeAttributesClass。它是可选的卷属性配置对象,保存 IOPS 等参数,PVC 通过
spec.volumeAttributesClassName按名称引用它。
对象收到删除请求后,这些控制器通过 finalizer 暂缓删除,相关使用或引用关系解除后,再移除各自负责的标记。
删除保护示例
data PVC 通过 volumeAttributesClassName 引用 ebs-gp3-6000 属性配置,由 external-resizer 调用 EBS CSI Driver 的 Controller 组件将原有卷的 IOPS 从 3000 提高到 6000。YAML 展示调整后的状态,以及 PVC、PV 和 VolumeAttributesClass 的删除保护。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: data
  namespace: default
  uid: c8d74a62-5f31-4a9d-8e06-b92c713af540
  finalizers:
    - kubernetes.io/pvc-protection # 仍被 Pod 使用时暂缓删除
spec:
  volumeName: pv-web-data
  storageClassName: ebs-gp3
  volumeAttributesClassName: ebs-gp3-6000 # 可选:引用期望的卷属性配置
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 20Gi
status:
  phase: Bound
  capacity:
    storage: 20Gi
  currentVolumeAttributesClassName: ebs-gp3-6000 # 已生效的属性配置
---
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-web-data
  finalizers:
    - kubernetes.io/pv-protection # 仍与 PVC 绑定时暂缓删除
spec:
  capacity:
    storage: 20Gi
  accessModes:
    - ReadWriteOnce
  storageClassName: ebs-gp3
  persistentVolumeReclaimPolicy: Delete
  volumeAttributesClassName: ebs-gp3-6000 # 记录卷已应用的属性配置
  claimRef: # 记录绑定的 PVC
    apiVersion: v1
    kind: PersistentVolumeClaim
    name: data
    namespace: default
    uid: c8d74a62-5f31-4a9d-8e06-b92c713af540
  csi:
    driver: ebs.csi.aws.com
    volumeHandle: vol-0c7a4d9e2b6f81305
    fsType: ext4
status:
  phase: Bound
---
apiVersion: storage.k8s.io/v1
kind: VolumeAttributesClass
metadata:
  name: ebs-gp3-6000
  finalizers:
    - kubernetes.io/vac-protection # 仍被 PV 或 PVC 引用时暂缓删除
driverName: ebs.csi.aws.com
parameters:
  type: gp3
  iops: "6000" # 为卷配置 6000 IOPS
- PVC 的
spec.volumeAttributesClassName:可选字段,指定期望使用的 VolumeAttributesClass 名称。这里的ebs-gp3-6000对应 VolumeAttributesClass 的metadata.name。 driverName与parameters:指定由ebs.csi.aws.com处理这组属性,卷类型为gp3,目标为6000IOPS;具体参数见 EBS CSI Driver 卷参数。- PVC 的
status.currentVolumeAttributesClassName:记录当前已生效的卷属性配置。PV 的spec.volumeAttributesClassName也记录卷已应用的配置。 metadata.finalizers:三个保护标记分别在 PVC 仍被 Pod 使用、PV 仍与 PVC 绑定、VolumeAttributesClass 仍被 PV 或 PVC 引用时暂缓删除;对应关系解除后,由各保护控制器移除自己的标记。
通用临时卷
通用临时卷 适合报表生成、数据处理等任务存放中间文件。EphemeralVolume Controller 根据 Pod 中的 volumeClaimTemplate 创建 PVC,并通过 ownerReferences 将 Pod 设为所有者,因此 Pod 删除后,关联 PVC 也会被垃圾回收机制清理。
手动创建、再通过 claimName 引用的普通 PVC,默认没有这份所有权关系,删除 Pod 后仍会保留,可供后续 Pod 使用。
通用临时卷示例
report Pod 通过 ebs-gp3 StorageClass 申请 1Gi 临时存储,挂载到 /scratch,用于存放任务产生的文件。
apiVersion: v1
kind: Pod
metadata:
  name: report
spec:
  restartPolicy: Never
  containers:
    - name: report
      image: busybox:1.37
      command: ["sh", "-c", "date > /scratch/report.txt"]
      volumeMounts:
        - name: scratch
          mountPath: /scratch
  volumes:
    - name: scratch
      ephemeral:
        volumeClaimTemplate: # 控制器据此创建 report-scratch PVC
          spec:
            storageClassName: ebs-gp3
            accessModes:
              - ReadWriteOnce
            resources:
              requests:
                storage: 1Gi
volumeClaimTemplate:定义 PVC 的存储类型、访问模式和容量。控制器据此创建report-scratchPVC,并自动设置指向reportPod 的ownerReferences。
假设 report Pod 的 UID 为 a4f8392b-6e75-4c10-9d2a-83b7f16ce508,控制器生成的 PVC 如下。名称由 Pod 名称 report 和卷名 scratch 组成,spec 来自上述 volumeClaimTemplate。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: report-scratch
  namespace: default
  ownerReferences: # EphemeralVolume Controller 设置的所有者引用
    - apiVersion: v1
      kind: Pod
      name: report
      uid: a4f8392b-6e75-4c10-9d2a-83b7f16ce508 # API Server 为 report Pod 分配的 UID
      controller: true
      blockOwnerDeletion: true
spec:
  storageClassName: ebs-gp3
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 1Gi
身份与证书
身份与证书相关的控制器负责管理身份凭据、权限规则和证书,为应用访问集群、节点加入集群提供所需的凭据与信任信息。
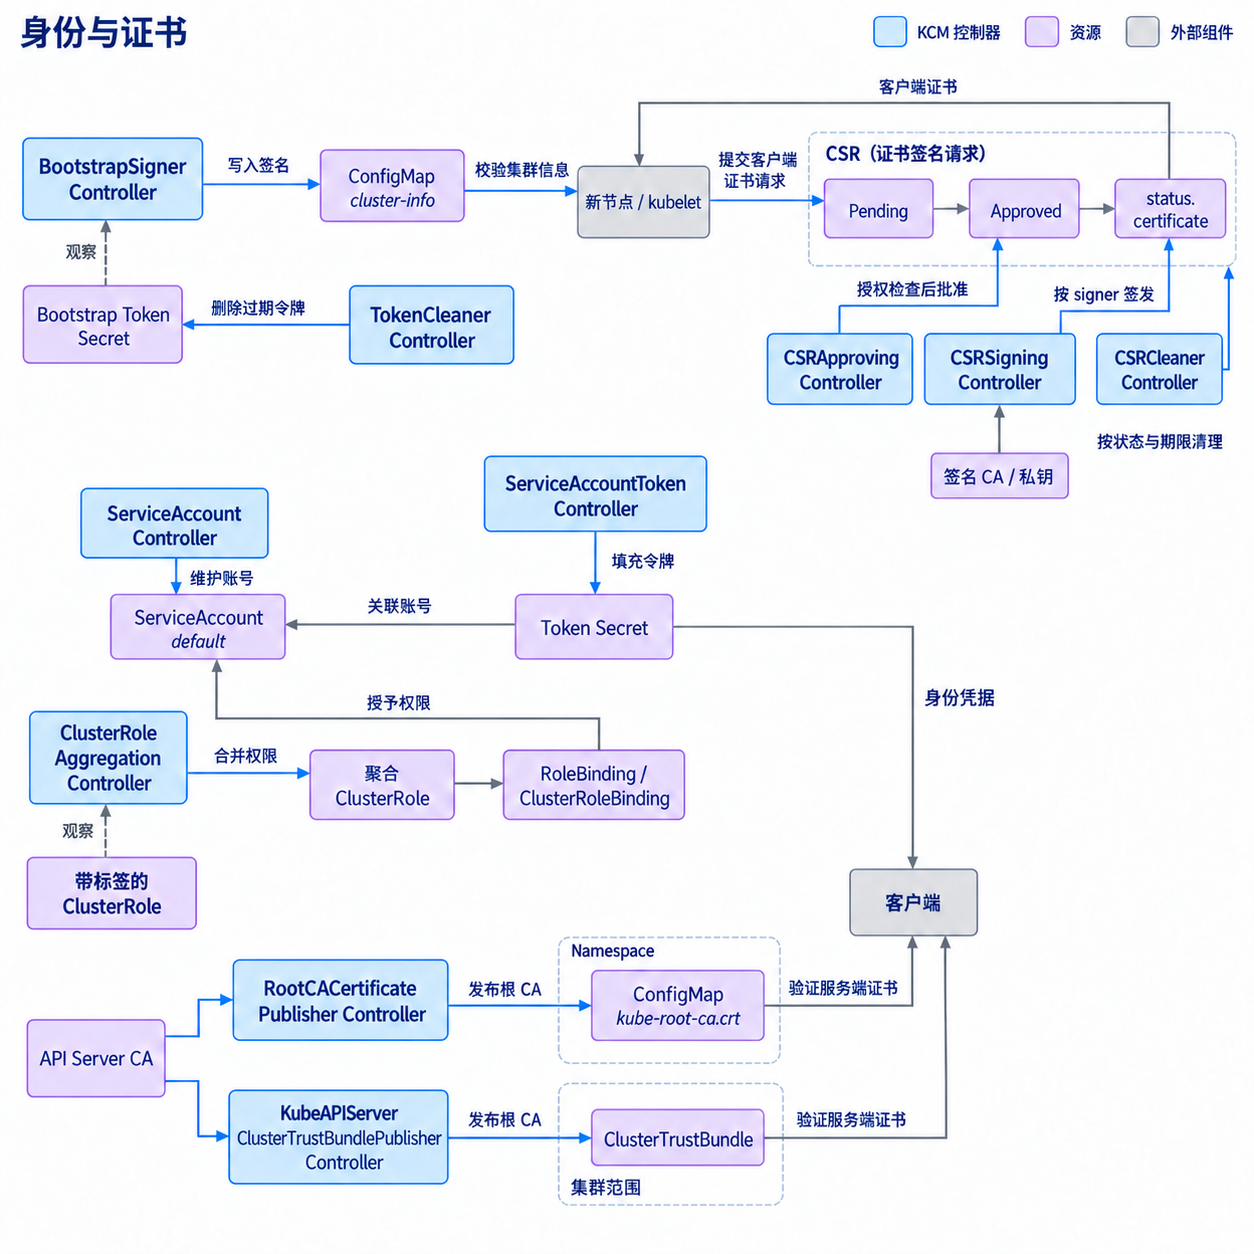
图:身份与证书相关的控制器。
服务账号
应用需要访问 Kubernetes API 时,可以使用 ServiceAccount 向 API Server 表明身份。
- ServiceAccount Controller:确保各活动命名空间中存在
default账号。 - ServiceAccountToken Controller:为显式创建并关联到默认或自定义 ServiceAccount 的令牌 Secret 填充令牌等数据,并在账号删除后清理关联 Secret。
创建令牌 Secret 时,需要指定 kubernetes.io/service-account-token 类型,并通过注解关联已有的 ServiceAccount。ServiceAccountToken Controller 确认账号存在后,使用 KCM 配置的私钥签发包含账号身份的 JWT,写入 Secret 的 data.token。这个字段在 YAML 中以 Base64 编码表示。
服务账号示例
下面展示 default 命名空间中的 default ServiceAccount,以及控制器填充后的令牌 Secret。令牌使用演示密钥签名,用于说明数据格式;实际访问集群时使用该集群签发的令牌。
apiVersion: v1
kind: ServiceAccount
metadata:
  name: default
  namespace: default
  uid: ad8371b2-6c45-49e8-9a03-f28d7c0165be
---
apiVersion: v1
kind: Secret
metadata:
  name: default-token-demo
  namespace: default
  annotations:
    kubernetes.io/service-account.name: default
    kubernetes.io/service-account.uid: ad8371b2-6c45-49e8-9a03-f28d7c0165be
type: kubernetes.io/service-account-token
data:
  namespace: ZGVmYXVsdA==
  # 演示密钥签名的完整 JWT,经 Base64 编码
  token: |-
    ZXlKaGJHY2lPaUpTVXpJMU5pSXNJbXRwWkNJNkltRlJZWFJhVkd4R2RGOW5PRlEwYjFGelVVWTRWVFJPVkU1UVQz
    aHJXVU0zY0RoVmRGSXpXRzVDU0ZFaUxDSjBlWEFpT2lKS1YxUWlmUS5leUpwYzNNaU9pSnJkV0psY201bGRHVnpM
    M05sY25acFkyVmhZMk52ZFc1MElpd2ljM1ZpSWpvaWMzbHpkR1Z0T25ObGNuWnBZMlZoWTJOdmRXNTBPbVJsWm1G
    MWJIUTZaR1ZtWVhWc2RDSXNJbXQxWW1WeWJtVjBaWE11YVc4dmMyVnlkbWxqWldGalkyOTFiblF2Ym1GdFpYTndZ
    V05sSWpvaVpHVm1ZWFZzZENJc0ltdDFZbVZ5Ym1WMFpYTXVhVzh2YzJWeWRtbGpaV0ZqWTI5MWJuUXZjMlZqY21W
    MExtNWhiV1VpT2lKa1pXWmhkV3gwTFhSdmEyVnVMV1JsYlc4aUxDSnJkV0psY201bGRHVnpMbWx2TDNObGNuWnBZ
    MlZoWTJOdmRXNTBMM05sY25acFkyVXRZV05qYjNWdWRDNXVZVzFsSWpvaVpHVm1ZWFZzZENJc0ltdDFZbVZ5Ym1W
    MFpYTXVhVzh2YzJWeWRtbGpaV0ZqWTI5MWJuUXZjMlZ5ZG1salpTMWhZMk52ZFc1MExuVnBaQ0k2SW1Ga09ETTNN
    V0l5TFRaak5EVXRORGxsT0MwNVlUQXpMV1l5T0dRM1l6QXhOalZpWlNKOS5tTmZpc2phVzdpdmlnNWpQYWVwVFlR
    czI5QXR5cGl3QlZWcjBkTnVaVHY2dHdyanhwNFVxU2ZsdkFKOGpoc1JYNmZoQkZOWXRQRHFOZzZCZktUam9CSmQ3
    NTFTeW1wMHRGdm1VZ1ZOakJvZjNmSnVmX0U2a1c3RzNQVnBQcEs0S1JIU0FIQUxxVE9KWUliQ1g4a3E4Q1B3dmww
    NG84TlByQlpFeTV1alhKNWtIWmo5U3R6ZnJYZUE3aFREU0puN2dsWDBLV3E5Sl9yeE1NZnRoQVJHU09oVWY5NEc1
    ekRCMWFxeWVfSnhtSXNFWVZzX1BHSkxSbFU4OW4zWkZVZ21BcUREaEo0V1dwTi1iMDJmYkVDZzBTeUhJbGZEMmty
    MHdRRy1NejRoT0xfeWtmWmdxQTBXa3pNRWJYTzdZYXM0cjhjSzNJbjl3WktaUVloQ1poZjZ3Z2c=
ServiceAccount.metadata.name:这里的default是账号名称,namespace表示它所属的命名空间。type: kubernetes.io/service-account-token:说明这个 Secret 用于保存 ServiceAccount 令牌。kubernetes.io/service-account.name:指定关联同命名空间中的哪个 ServiceAccount,既可以是default,也可以是自定义账号。data.token:控制器生成的 JWT,包含system:serviceaccount:default:default这一账号身份;创建 Secret 时无需手工填写。data.namespace与账号 UID:控制器写入命名空间,并通过kubernetes.io/service-account.uid注解记录关联账号的唯一标识。
Pod 使用 Secret 令牌
api-client-secret 将同命名空间中的 default-token-demo Secret 挂载为文件,读取令牌后请求 Pod 列表。HTTPS 使用的 CA 来自 kube-root-ca.crt ConfigMap,账号的读取权限由后面的 app-reader RoleBinding 授予。
apiVersion: v1
kind: Pod
metadata:
  name: api-client-secret
  namespace: default
spec:
  serviceAccountName: default
  automountServiceAccountToken: false
  restartPolicy: Never
  containers:
    - name: client
      image: curlimages/curl:8.14.1
      command: ["sh", "-c"]
      args:
        - >-
          curl --fail
          --cacert /var/run/api-ca/ca.crt
          --header "Authorization: Bearer $(cat /var/run/api-token/token)"
          https://kubernetes.default.svc/api/v1/namespaces/default/pods
      volumeMounts:
        - name: api-token
          mountPath: /var/run/api-token
          readOnly: true
        - name: api-ca
          mountPath: /var/run/api-ca
          readOnly: true
  volumes:
    - name: api-token
      secret:
        secretName: default-token-demo
        items:
          - key: token
            path: token
    - name: api-ca
      configMap:
        name: kube-root-ca.crt
        items:
          - key: ca.crt
            path: ca.crt
automountServiceAccountToken: false:关闭默认令牌卷的自动注入,使用显式挂载的 Secret。secret.secretName与items:选择default-token-demo的token字段。Kubelet 将令牌内容写入挂载目录下的token文件,应用读到的是 JWT,无需再次进行 Base64 解码。具体挂载方式见 Secret 卷。Authorization: Bearer:应用把令牌放入请求头,API Server 使用对应公钥验证签名并校验账号等信息,识别调用者身份;请求能否读取 Pod,还取决于 RBAC 授权。--cacert:指定验证 API Server 服务端证书所用的 CA 文件,相关内容见后面的“根证书分发”。
权限聚合
应用的权限分散在多个 ClusterRole 中时,可以通过角色聚合统一授权。ClusterRoleAggregation Controller 按 aggregationRule 的标签选择器收集角色,并持续更新聚合角色的 rules。
权限聚合示例
pod-reader 和 configmap-reader 分别提供 Pod 和 ConfigMap 的读取权限,两者通过相同标签归入 app-reader。下面的 app-reader.rules 展示控制器聚合后的结果,RoleBinding 将这些权限授予前面的默认服务账号。
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: app-reader
aggregationRule:
  clusterRoleSelectors:
    - matchLabels:
        example.com/aggregate-to-app-reader: "true"
rules: # 聚合后的结果,由控制器写入
  - apiGroups: [""]
    resources: ["pods"]
    verbs: ["get", "list", "watch"]
  - apiGroups: [""]
    resources: ["configmaps"]
    verbs: ["get", "list", "watch"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: pod-reader
  labels:
    example.com/aggregate-to-app-reader: "true"
rules:
  - apiGroups: [""]
    resources: ["pods"]
    verbs: ["get", "list", "watch"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: configmap-reader
  labels:
    example.com/aggregate-to-app-reader: "true"
rules:
  - apiGroups: [""]
    resources: ["configmaps"]
    verbs: ["get", "list", "watch"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: app-reader
  namespace: default
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: app-reader
subjects:
  - kind: ServiceAccount
    name: default
    namespace: default
aggregationRule:匹配带有example.com/aggregate-to-app-reader: "true"标签的 ClusterRole。- 来源角色的
rules:pod-reader允许读取 Pod,configmap-reader允许读取 ConfigMap,操作均为get、list和watch。 app-reader.rules:包含上述两组权限,由控制器计算并写入。需要调整权限时,修改来源角色的规则或标签,控制器会更新聚合结果。RoleBinding:将app-reader授予default命名空间中的defaultServiceAccount,权限范围限定为该命名空间中的 Pod 和 ConfigMap。
根证书分发
应用通过 HTTPS 访问 Kubernetes API 时,需要使用 CA 证书验证 API Server 的服务端证书。相关控制器通过两种资源分发这些 CA 内容:
- RootCACertificatePublisher Controller:在各命名空间自动创建并维护
kube-root-ca.crtConfigMap,CA 内容保存在data["ca.crt"]中,用户通常无需手动准备。Pod 默认注入的 API 访问卷从同命名空间的这个 ConfigMap 读取 CA,供应用验证服务端证书。 - KubeAPIServerClusterTrustBundlePublisher Controller:将用于验证 API Server 服务端证书的 CA 内容发布为 ClusterTrustBundle,保存在
spec.trustBundle中。ClusterTrustBundle 是独立的、集群范围的 API 对象,不同命名空间的 Pod 可以引用同一份配置。Kubelet 通过clusterTrustBundle投射卷将证书写入容器中的文件,并随配置变化更新。
ClusterTrustBundle 及其投射功能自 Kubernetes 1.37 起默认启用。KCM 自动发布 API Server 的 CA,用户无需手动创建对应的 ClusterTrustBundle;Pod 使用它时仍需显式配置投射卷,默认 API 访问卷继续使用 ConfigMap。
默认 API 访问卷
ConfigMap 保存 CA 证书,Pod 的默认 API 访问卷将证书与令牌挂载到容器中。以下 Pod 结构包含 ServiceAccount 准入插件自动注入的卷和挂载配置。
# 默认配置下,由 RootCACertificatePublisher Controller 在各命名空间自动创建并维护。
# 用户通常无需手动创建这份 ConfigMap 或填写其中的 CA 证书。
apiVersion: v1
kind: ConfigMap
metadata:
  name: kube-root-ca.crt
  namespace: default
data:
  ca.crt: |
    <pem-ca-certificate>
---
# 以下展示默认 API 访问卷注入后的 Pod 结构,卷和挂载配置通常由准入插件自动添加。
apiVersion: v1
kind: Pod
metadata:
  name: api-client-configmap
  namespace: default
spec:
  serviceAccountName: default
  restartPolicy: Never
  containers:
    - name: client
      image: curlimages/curl:8.14.1
      command: ["sh", "-c"]
      args:
        - >-
          curl --fail
          --cacert /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
          --header "Authorization: Bearer $(cat /var/run/secrets/kubernetes.io/serviceaccount/token)"
          https://kubernetes.default.svc/api/v1/namespaces/default/pods
      volumeMounts:
        - name: kube-api-access-m7r2p
          mountPath: /var/run/secrets/kubernetes.io/serviceaccount
          readOnly: true
  volumes:
    - name: kube-api-access-m7r2p # ServiceAccount 准入插件自动注入的卷
      projected:
        sources:
          - serviceAccountToken:
              path: token
          - configMap:
              name: kube-root-ca.crt
              items:
                - key: ca.crt
                  path: ca.crt
          - downwardAPI:
              items:
                - path: namespace
                  fieldRef:
                    apiVersion: v1
                    fieldPath: metadata.namespace
configMap.name与items:引用同命名空间的kube-root-ca.crt,将data["ca.crt"]写入卷中的ca.crt文件。projected.sources:将 CA、ServiceAccount 令牌和命名空间组合到同一个卷,挂载到/var/run/secrets/kubernetes.io/serviceaccount。--cacert与Authorization:应用用 CA 验证 API Server,用令牌表明账号身份;访问权限由 RBAC 决定。
ClusterTrustBundle 投射卷
Pod 在投射卷中按名称引用 KCM 发布的 ClusterTrustBundle,Kubelet 将其中的 CA 写入 ca.crt 并随证书变化更新。应用读取这个文件验证 API Server,再携带账号令牌发起请求。
# 保存 API Server CA 的 ClusterTrustBundle 由 KubeAPIServerClusterTrustBundlePublisher Controller 自动创建并维护。
# ClusterTrustBundle 及其投射功能自 Kubernetes 1.37 起默认启用,用户无需手动创建该对象。
apiVersion: certificates.k8s.io/v1beta1
kind: ClusterTrustBundle
metadata:
  name: kubernetes.io:kube-apiserver-serving:demo # 名称示意,Pod 引用时使用集群实际生成的名称
spec:
  signerName: kubernetes.io/kube-apiserver-serving
  trustBundle: |
    <pem-ca-certificate>
---
# Pod 仍需显式配置投射卷,由 Kubelet 将 CA 写入容器中的文件。
apiVersion: v1
kind: Pod
metadata:
  name: api-client-trustbundle
  namespace: default
spec:
  serviceAccountName: default
  automountServiceAccountToken: false # 改为显式配置 API 访问卷
  restartPolicy: Never
  containers:
    - name: client
      image: curlimages/curl:8.14.1
      command: ["sh", "-c"]
      args:
        - >-
          curl --fail
          --cacert /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
          --header "Authorization: Bearer $(cat /var/run/secrets/kubernetes.io/serviceaccount/token)"
          https://kubernetes.default.svc/api/v1/namespaces/default/pods
      volumeMounts:
        - name: api-access
          mountPath: /var/run/secrets/kubernetes.io/serviceaccount
          readOnly: true
  volumes:
    - name: api-access
      projected:
        sources:
          - serviceAccountToken:
              path: token
          - clusterTrustBundle:
              name: kubernetes.io:kube-apiserver-serving:demo
              path: ca.crt
spec.trustBundle与clusterTrustBundle.name:前者保存 PEM 格式的 CA,后者指定 Pod 引用哪个 ClusterTrustBundle,并通过path: ca.crt确定文件名。automountServiceAccountToken: false:关闭默认卷的自动注入,使用显式配置的投射卷。serviceAccountToken:同时投射账号令牌,由 Kubelet 获取和更新,供应用请求认证使用。
节点引导令牌
新节点通过 kubeadm 加入已有集群时,尚未持有客户端证书,可以先使用 Bootstrap Token 完成初始认证并申请 Kubelet 客户端证书。
- BootstrapSigner Controller:使用令牌为
cluster-infoConfigMap 中的 API Server 地址和 CA 信息生成签名,供新节点在集群发现时校验。 - TokenCleaner Controller:清理已过期的 Bootstrap Token Secret。
节点引导令牌示例
为 worker-1 准备引导令牌 abcdef.0123456789abcdef,对应的 Secret 保存在 kube-system 命名空间。BootstrapSigner Controller 使用它为 kube-public 中的 cluster-info 生成签名,worker-1 据此校验集群连接信息。YAML 中的 CA 数据和签名使用占位值。
apiVersion: v1
kind: Secret
metadata:
  name: bootstrap-token-abcdef
  namespace: kube-system
type: bootstrap.kubernetes.io/token
stringData:
  token-id: abcdef
  token-secret: "0123456789abcdef" # 示例令牌值
  expiration: "2030-01-01T00:00:00Z"
  usage-bootstrap-authentication: "true"
  usage-bootstrap-signing: "true"
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: cluster-info
  namespace: kube-public
data:
  kubeconfig: |
    apiVersion: v1
    kind: Config
    clusters:
      - name: demo
        cluster:
          server: https://api.example.com:6443
          certificate-authority-data: <base64-ca-certificate>
    contexts: []
    current-context: ""
    users: []
  jws-kubeconfig-abcdef: "<detached-jws-signature>" # 签名控制器写入
- Secret 名称与类型:名称使用
bootstrap-token-<token-id>,位于kube-system,类型为bootstrap.kubernetes.io/token。 usage-bootstrap-authentication:允许令牌用于引导认证;API Server 的 Bootstrap Token 认证功能需要相应启用。usage-bootstrap-signing:允许 BootstrapSigner Controller 使用该令牌对集群发现信息签名,结果写入jws-kubeconfig-abcdef,其中的后缀对应token-id。cluster-info.data.kubeconfig:包含 API Server 地址和 CA 信息,新节点使用令牌校验签名后读取这些内容。expiration:声明令牌到期时间。启用 TokenCleaner Controller 后,它会清理过期的引导令牌 Secret。
证书请求
具有相应权限的用户和组件都可以通过 CertificateSigningRequest(CSR)申请证书,例如用户访问 API Server 的客户端证书。请求中的 spec.signerName 指定负责签发的 signer。
- CSRApproving Controller:仅自动审批
kubernetes.io/kube-apiserver-client-kubelet对应的 Kubelet 客户端证书请求,涵盖首次申请和证书轮换。请求仍需符合身份、用途等识别规则,并通过自动审批所需的授权检查。 - CSRSigning Controller:处理 KCM 内置 signer 对应的请求,使用配置的 CA 证书和私钥,为已批准且符合签发规则的 CSR 签发证书,并写入
status.certificate。 - CSRCleaner Controller:按请求状态、保留期限和证书有效期清理历史 CSR。
Kubelet 证书请求示例
以 worker-1 的 Kubelet 客户端证书请求 worker-1-client 为例,下面展示审批和签发完成后的对象结构。request 和 certificate 使用占位值,实际内容是经过 Base64 编码的 PEM 证书请求和证书。
apiVersion: certificates.k8s.io/v1
kind: CertificateSigningRequest
metadata:
  name: worker-1-client
spec:
  request: "<base64-encoded-pem-csr>"
  signerName: kubernetes.io/kube-apiserver-client-kubelet
  usages:
    - digital signature
    - key encipherment
    - client auth
status:
  conditions:
    - type: Approved # 审批控制器通过授权检查后写入
      status: "True"
      reason: AutoApproved
  certificate: "<base64-encoded-pem-certificate>" # 签发控制器写入
request:包含公钥及申请的身份。这个 signer 要求请求中的组织为system:nodes,通用名称为system:node:worker-1。signerName:指定负责签发的 signer。这里的kubernetes.io/kube-apiserver-client-kubelet用于 Kubelet 客户端证书;普通用户申请访问 API Server 的客户端证书时,可使用kubernetes.io/kube-apiserver-client。usages:声明证书的用途。这里的digital signature、key encipherment和client auth分别表示数字签名、密钥加密和客户端认证,允许的组合由 signer 的规则决定。status.conditions:type: Approved且status: "True"表示请求已获批准,由审批流程写入;自动审批还要求请求符合识别规则,并通过请求者的授权检查。status.certificate:CSRSigning Controller 签发后写入证书,Kubelet 取得证书后配合对应私钥进行认证。CSRCleaner Controller 后续根据请求状态及证书有效期等条件清理这个 CSR 对象。
资源管理
资源管理相关的控制器负责统计命名空间的资源用量,并处理命名空间删除、依赖对象回收和残留资源清理。
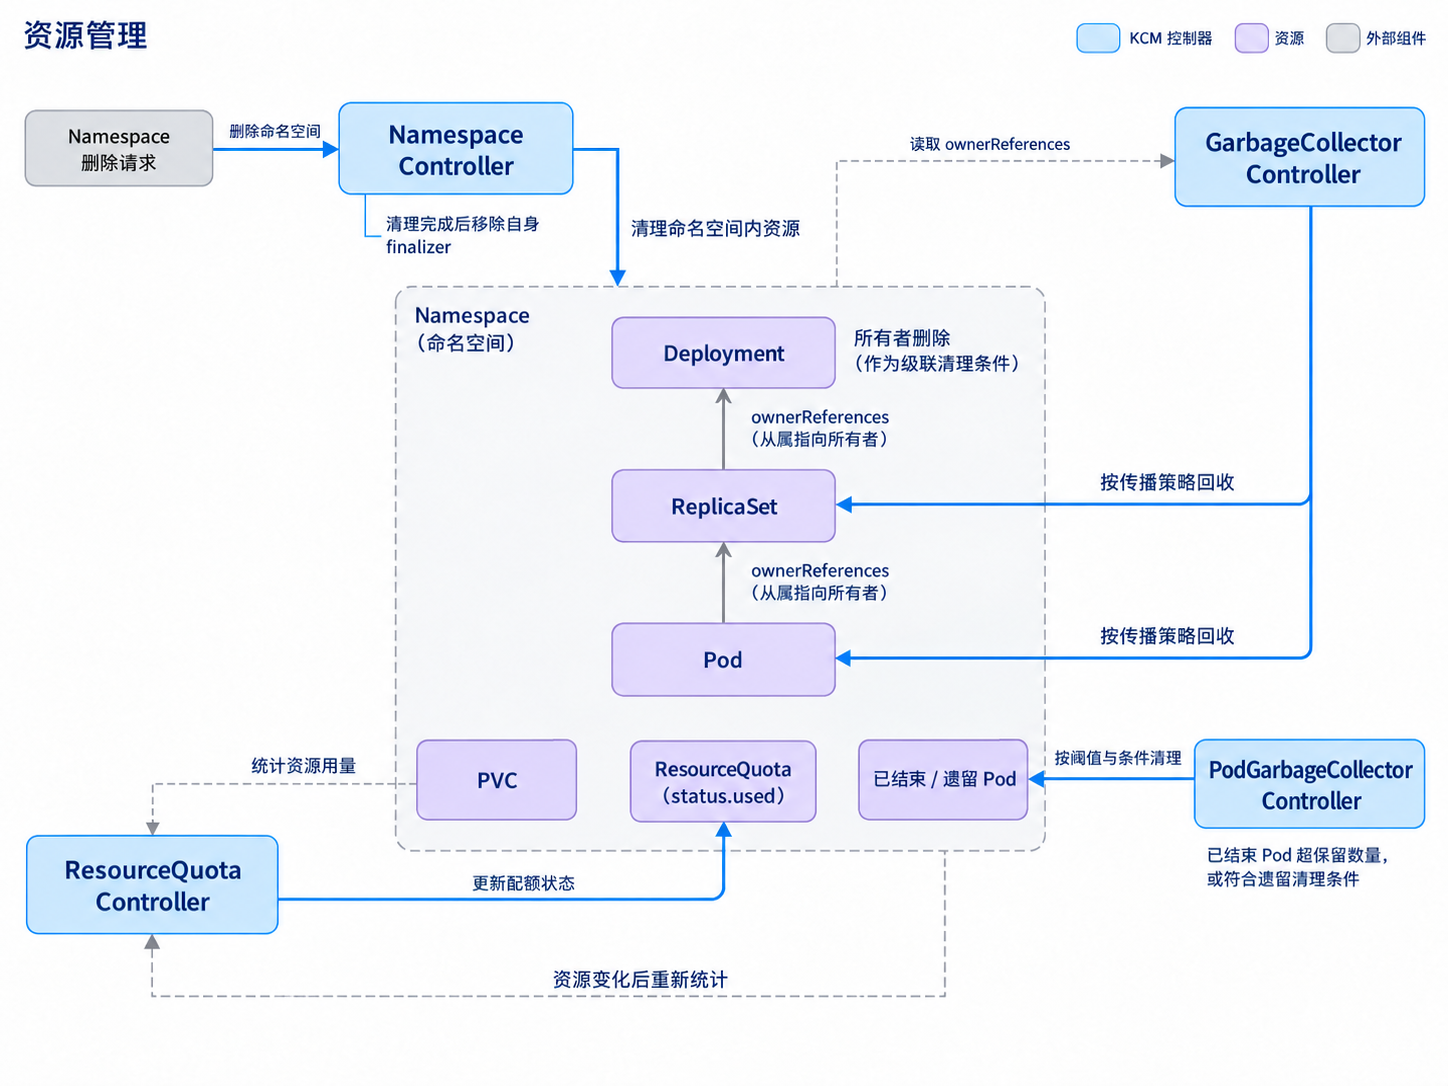
图:资源管理相关的控制器。
配额统计
ResourceQuota Controller 重新计算命名空间的资源用量,并更新 ResourceQuota 状态。例如,删除一个 PVC 后,配额中记录的 PVC 数量也需要更新。新请求是否超过配额由准入逻辑检查,控制器负责持续校正用量记录。
配额统计示例
示例限制一个命名空间中的 Pod 数量、PVC 数量和存储申请总量。status 展示配额已经完成一次用量统计后的示例值。
apiVersion: v1
kind: ResourceQuota
metadata:
  name: app-quota
  namespace: default
spec:
  hard:
    pods: "10"
    persistentvolumeclaims: "4"
    requests.storage: 40Gi
status:
  hard:
    pods: "10"
    persistentvolumeclaims: "4"
    requests.storage: 40Gi
  used: # 示例中的已统计用量
    pods: "3"
    persistentvolumeclaims: "1"
    requests.storage: 10Gi
spec.hard:声明配额上限,这里允许最多10个未结束的 Pod、4个 PVC,以及总计40Gi的存储申请。requests.storage:统计 PVC 请求的容量总和,反映存储申请额度,而非卷中已写入文件的大小。status.hard与status.used:分别记录当前执行的上限和已统计的用量。示例中使用了3个 Pod、1个 PVC 和10Gi存储额度。- 用量变化:删除这个 PVC 后,ResourceQuota Controller 会重新计算 PVC 数量和存储申请量,并更新状态;新建资源时则由准入逻辑检查额度。
命名空间删除
Namespace Controller 在命名空间收到删除请求后,查找并清理其中的各类资源。若某个对象还带有等待清理的 finalizer,命名空间可能继续停留在 Terminating 状态。资源清理完成后,控制器再移除自己负责的命名空间 finalizer。
命名空间删除示例
retiring-app 已收到删除请求,但其中的 app-config ConfigMap 还在等待清理。示例中的删除时间、finalizer 和 status 用于表示这一过程中的对象状态。
apiVersion: v1
kind: Namespace
metadata:
  name: retiring-app
  deletionTimestamp: "2030-01-01T00:00:00Z" # 删除请求被接受的示例时间
spec:
  finalizers:
    - kubernetes
status:
  phase: Terminating
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: app-config
  namespace: retiring-app
  deletionTimestamp: "2030-01-01T00:00:01Z"
  finalizers:
    - example.com/cleanup # 等待示例清理控制器完成处理
data:
  mode: demo
deletionTimestamp:由 API Server 在接受删除请求后设置,表示对象已进入删除流程。Namespace.spec.finalizers:kubernetes表示需要等待 Namespace Controller 清理命名空间内的资源。命名空间的这个字段位于spec下。ConfigMap.metadata.finalizers:example.com/cleanup代表示例中的清理控制器。该控制器完成自己的清理工作并移除它后,ConfigMap 才能被删除。status.phase: Terminating:表示命名空间正在删除。Namespace Controller 确认内部资源清理完成后,再移除自己负责的 finalizer,完成命名空间删除。
依赖对象回收
GarbageCollector Controller 根据 ownerReferences 跟踪对象之间的依赖关系,按删除传播策略回收依赖对象或解除所有权关系。例如,级联删除 Deployment 时,关联的 ReplicaSet 和 Pod 也会进入清理流程。删除顺序和完成时间取决于传播策略,以及相关对象是否还有等待处理的 finalizer。
依赖对象回收示例
以前台删除 ReplicaSet 为例,下面展示 gc-web 已进入删除流程、关联 Pod 尚未清理时的状态。Pod 的所有者引用由 ReplicaSet Controller 创建 Pod 时填写。
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: gc-web
  namespace: default
  uid: b863ae7a-365d-407b-a55c-dcbe1a30bc7c
  deletionTimestamp: "2030-01-01T00:00:00Z"
  finalizers:
    - foregroundDeletion # 前台删除请求使对象进入此状态
spec:
  replicas: 1
  selector:
    matchLabels:
      app: gc-web
  template:
    metadata:
      labels:
        app: gc-web
    spec:
      containers:
        - name: nginx
          image: nginx:1.28-alpine
---
apiVersion: v1
kind: Pod
metadata:
  name: gc-web-demo
  namespace: default
  labels:
    app: gc-web
  ownerReferences:
    - apiVersion: apps/v1
      kind: ReplicaSet
      name: gc-web
      uid: b863ae7a-365d-407b-a55c-dcbe1a30bc7c
      controller: true
      blockOwnerDeletion: true
spec:
  containers:
    - name: nginx
      image: nginx:1.28-alpine
ownerReferences:Pod 指向同命名空间中的gc-webReplicaSet,UID 与该 ReplicaSet 的metadata.uid一致,用于识别具体的对象实例。controller: true:标记负责管理该 Pod 的所有者,这里是 ReplicaSet。foregroundDeletion:前台删除请求使 API Server 为 ReplicaSet 设置这个 finalizer,垃圾回收控制器先处理需要回收的依赖对象。blockOwnerDeletion: true:在这次前台删除中,该 Pod 会阻止 ReplicaSet 提前完成删除;待相关依赖清理完成,垃圾回收控制器再结束所有者的删除流程。
Pod 清理
Pod 运行结束后,容器已经停止,但 Pod 对象仍可能保留在集群中。PodGarbageCollector Controller 会在以下情况下清理 Pod 对象:
- 已结束的 Pod 数量过多:集群中
Succeeded和FailedPod 的总数超过--terminated-pod-gc-threshold时,清理超出的部分。 - 所属节点已删除:Pod 仍绑定到已经不存在的 Node,控制器确认节点已删除后,清理遗留对象。
- 尚未调度就收到删除请求:Pod 已进入删除流程,但还没有绑定节点,控制器将其清理。
- 节点停机后遗留的 Pod:管理员确认节点已关机后,可添加
node.kubernetes.io/out-of-service污点,将其标记为停止服务。PodGarbageCollector Controller 会清理该非就绪节点上已经进入删除流程的 Pod。
对象生命周期
Kubernetes 中的对象会经历创建、维护和删除,并与其他对象建立关联。例如,删除 Deployment 时,还需要决定其 ReplicaSet 和 Pod 如何清理或保留。相关机制包括:
- 对象所有权:通过
ownerReferences在依赖对象上记录它属于哪个对象。例如,Pod 的引用指向 ReplicaSet,ReplicaSet 的引用再指向 Deployment,形成逐级归属关系。 - Finalizer:让对象在删除前等待必要的检查或清理。例如,PVC 仍被 Pod 使用时,删除保护标记会让它继续保留;控制器确认不再使用后,才移除标记,让删除继续。
- 删除传播:决定删除所有者时,依赖对象是随之回收还是保留,以及清理的先后顺序。例如,删除 Deployment 时,可以选择一并回收 ReplicaSet 和 Pod,也可以保留它们。
- 垃圾回收:GarbageCollector 跟踪所有者引用,执行删除传播策略要求的回收或解除引用。例如,后台删除 Deployment 后,它会发现 ReplicaSet 的所有者已不存在,进而回收 ReplicaSet 及其 Pod。
对象所有权
Deployment Controller 创建 ReplicaSet 时,会将 Deployment 写入 ReplicaSet 的 ownerReferences;ReplicaSet Controller 创建 Pod 时,再将 ReplicaSet 写入 Pod 的 ownerReferences。每条引用指向直接所有者,形成 Deployment → ReplicaSet → Pod 的逐级归属关系。
下图展示了控制器创建资源的过程,以及依赖对象指向所有者的引用。
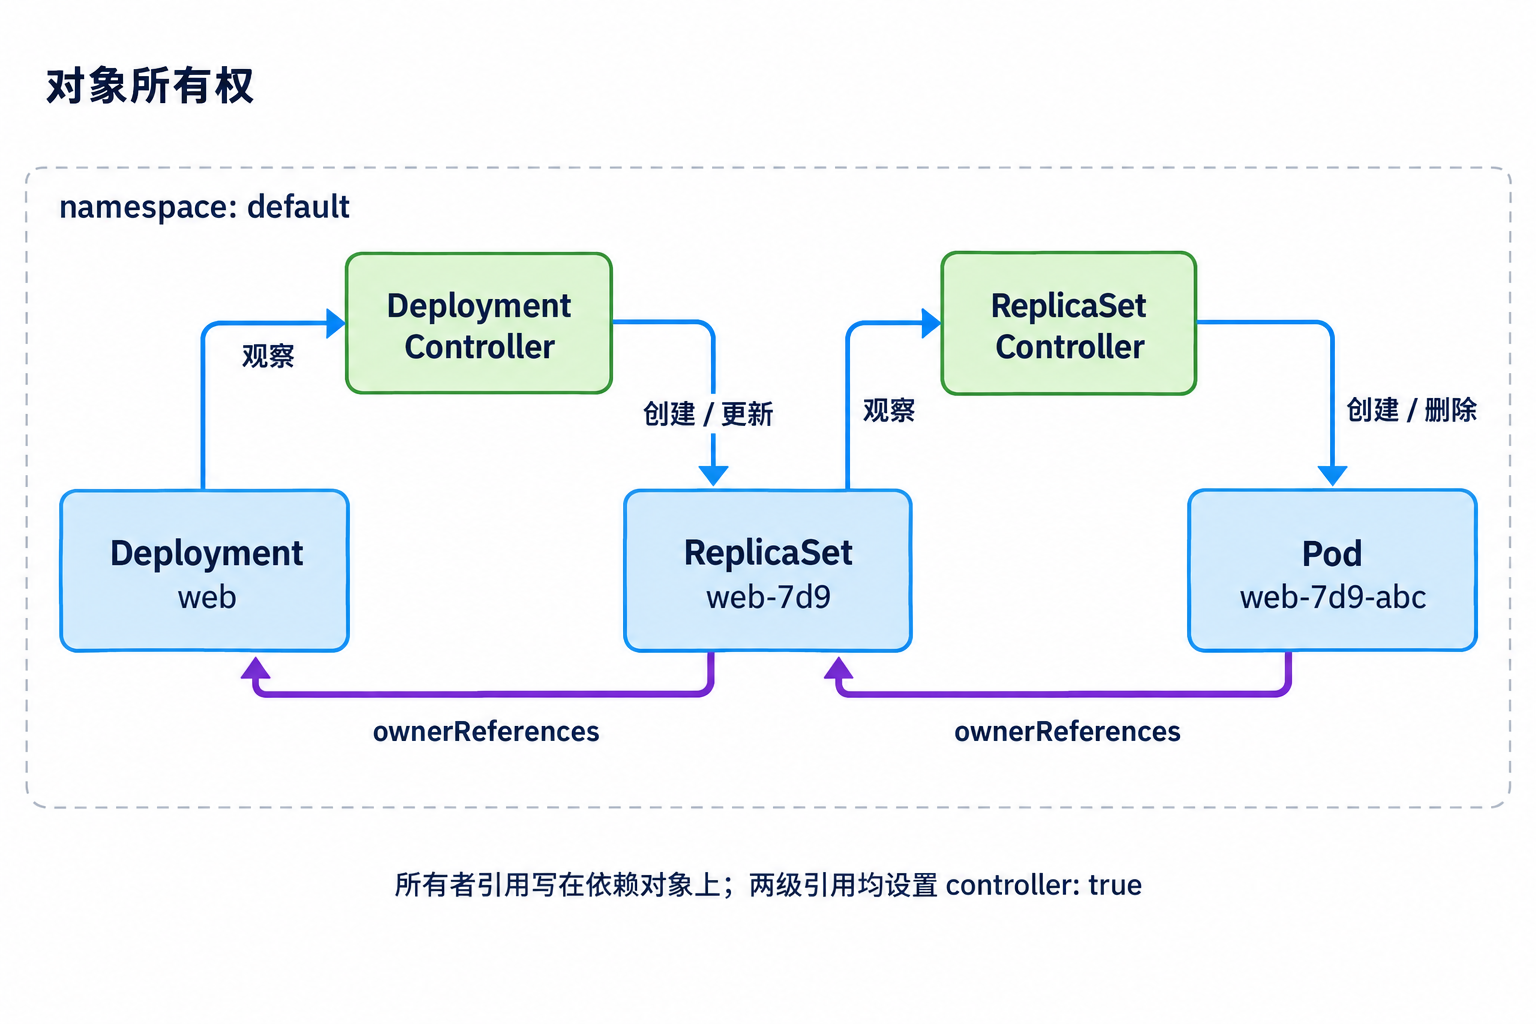
图:Deployment、ReplicaSet 与 Pod 的所有权。
Deployment 配置
下面的 Deployment 声明两个 Pod 副本。selector.matchLabels 与 Pod 模板中的 labels 对应,控制器据此查找匹配对象。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  namespace: default
  labels:
    app: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.28-alpine
          ports:
            - name: http
              containerPort: 80
配置生效后,Deployment Controller 会创建 ReplicaSet,再由 ReplicaSet Controller 按模板创建 Pod,使副本数达到 2。
生成后的对象
API Server 为每个对象分配唯一的 UID。控制器创建依赖对象时,会将所有者的名称、UID 等信息写入 ownerReferences,记录对象归属。
# Deployment 声明两个副本。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  namespace: default
  uid: b4c851bc-ace0-403a-b7da-a7850cc33a42 # Deployment web 的 UID
  labels:
    app: web
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.28-alpine
          ports:
            - name: http
              containerPort: 80
......
---
# ReplicaSet 的直接所有者是 Deployment。
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: web-7d9
  namespace: default
  uid: 81ea0914-2af3-4cff-8d24-9ee3a363480f # ReplicaSet web-7d9 的 UID
  labels:
    app: web
    pod-template-hash: 7d9
  ownerReferences:
    - apiVersion: apps/v1
      kind: Deployment
      name: web
      uid: b4c851bc-ace0-403a-b7da-a7850cc33a42 # 引用上面 Deployment 的 UID
      controller: true
      blockOwnerDeletion: true
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web
      pod-template-hash: 7d9
  template:
    metadata:
      labels:
        app: web
        pod-template-hash: 7d9
    spec:
      containers:
        - name: nginx
          image: nginx:1.28-alpine
          ports:
            - name: http
              containerPort: 80
......
---
# 这里展示其中一个 Pod,其直接所有者是 ReplicaSet。
apiVersion: v1
kind: Pod
metadata:
  name: web-7d9-abc
  namespace: default
  uid: 7c7d15a2-6ddd-49fd-9be5-6114e337f5fc # Pod web-7d9-abc 的 UID
  labels:
    app: web
    pod-template-hash: 7d9
  ownerReferences:
    - apiVersion: apps/v1
      kind: ReplicaSet
      name: web-7d9
      uid: 81ea0914-2af3-4cff-8d24-9ee3a363480f # 引用上面 ReplicaSet 的 UID
      controller: true
      blockOwnerDeletion: true
spec:
  containers:
    - name: nginx
      image: nginx:1.28-alpine
      ports:
        - name: http
          containerPort: 80
......
ownerReferences 中几个字段的作用分别是:
apiVersion、kind、name:标识所有者的 API 版本、资源类型和名称。Pod 的这条引用指向 ReplicaSetweb-7d9。uid:标识具体的对象实例。同名 ReplicaSet 删除后重新创建,会获得新的 UID;旧引用仍然指向原来的对象。blockOwnerDeletion: true:前台删除所有者时,需要先清理这个依赖对象。例如,Pod 在指向 ReplicaSet 的引用中设置此字段后,只要该 Pod 已被 GarbageCollector 观察到,前台删除 ReplicaSet 时就会等待这个 Pod 删除完成。
Finalizer
有些对象在删除前需要完成清理,或者等待其他资源停止使用它。Finalizer 将这些要求记录在 metadata.finalizers 中,由对应控制器检查条件、执行处理,并在完成后移除自己负责的标记。
API Server 收到带有 Finalizer 的对象的删除请求后,会设置 metadata.deletionTimestamp,并保留对象。全部 Finalizer 清空,且其他删除条件满足后,对象才会最终移除。这个过程见官方的 Finalizers 说明。
下图以 PVC 删除保护为例,展示对象从收到删除请求到最终移除的过程。
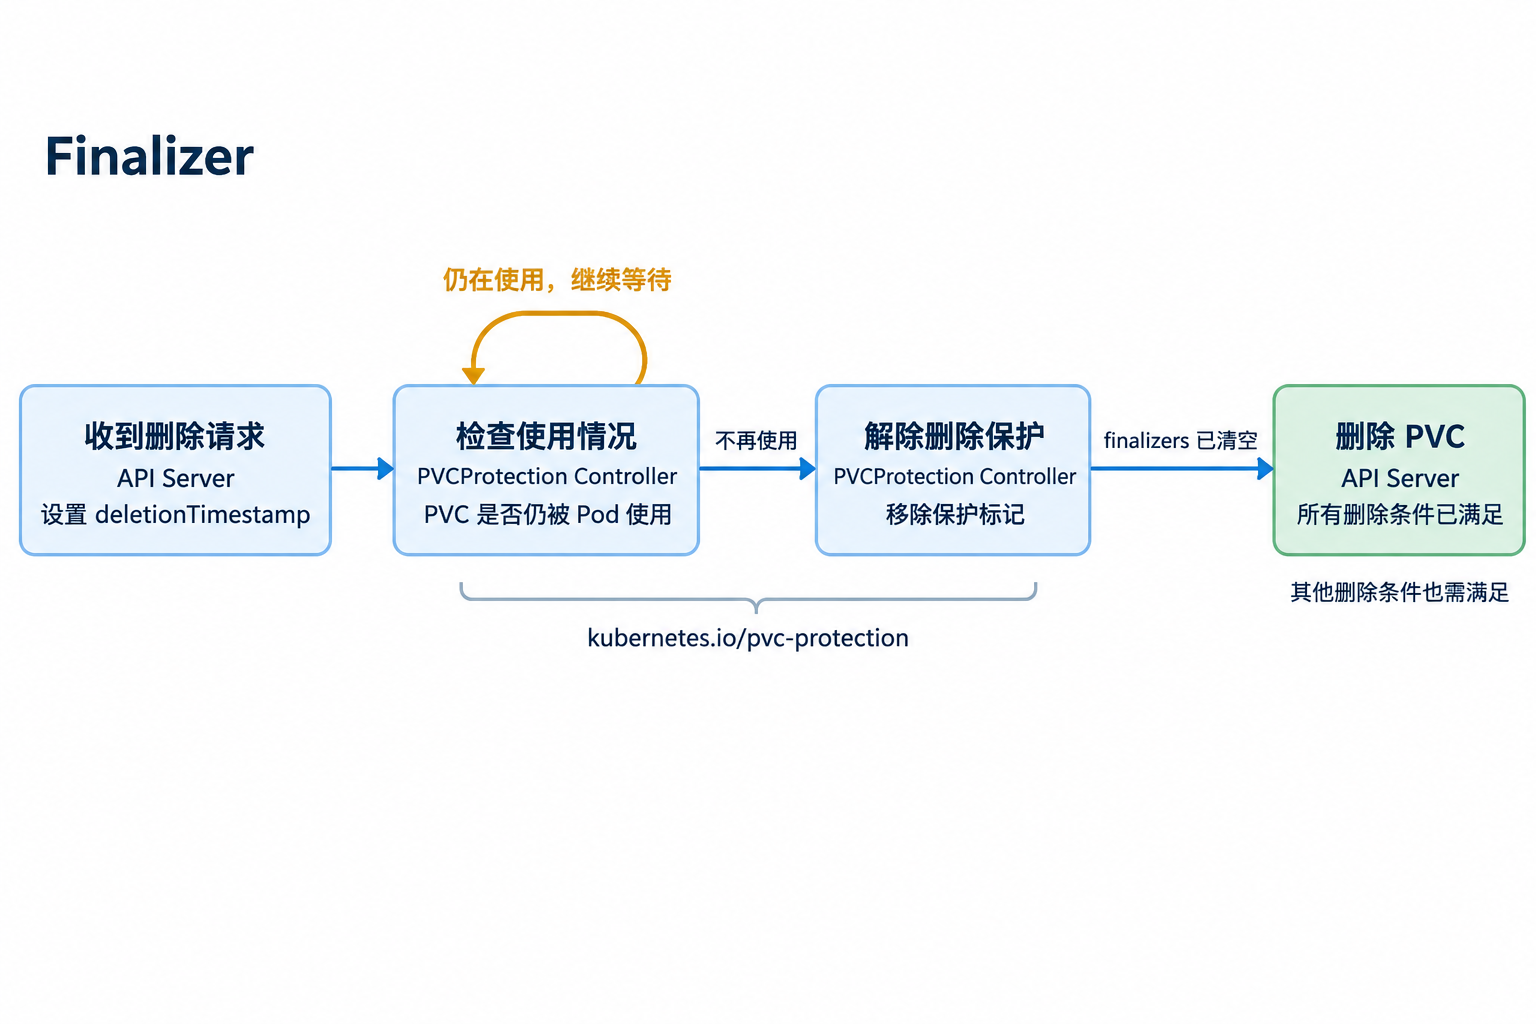
图:PVC 删除保护。
删除中的 PVC
Pod cache-reader 已将 PVC model-cache 挂载到容器的 /cache。以下示例中,PVC 已收到删除请求,但 Pod 仍在运行并使用这个卷。
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: model-cache
  namespace: default
  uid: 42ded98e-f9a4-4f17-8603-bace54969110 # PVC model-cache 的 UID
  deletionTimestamp: "2026-01-01T10:00:00Z" # API Server 标记删除的时间,Z 表示 UTC
  finalizers:
    - kubernetes.io/pvc-protection # PVC 仍被 Pod 使用时保留的删除保护标记
spec:
  accessModes:
    - ReadWriteOnce
  volumeMode: Filesystem
  storageClassName: ""
  resources:
    requests:
      storage: 1Gi
  volumeName: model-cache-pv
status:
  phase: Bound # 仍与 PV model-cache-pv 绑定
  accessModes:
    - ReadWriteOnce
  capacity:
    storage: 1Gi
使用 PVC 的 Pod
Pod 通过 volumes 引用同命名空间中的 PVC,再通过 volumeMounts 将卷挂载到容器内。下面的 claimName: model-cache 对应上面的 PVC。
apiVersion: v1
kind: Pod
metadata:
  name: cache-reader
  namespace: default
  uid: 6b92a419-0e5e-4016-8c05-721eda9baf7d # Pod cache-reader 的 UID
spec:
  nodeName: worker-1
  containers:
    - name: reader
      image: busybox:1.37
      command: ["sleep", "3600"]
      volumeMounts:
        - name: cache
          mountPath: /cache
  volumes:
    - name: cache
      persistentVolumeClaim:
        claimName: model-cache # 引用 default 命名空间中的 PVC
  restartPolicy: Always
PVC 的删除状态与绑定状态分别记录在不同字段中:
deletionTimestamp:表示对象已经收到删除请求,进入删除过程。finalizers:列出仍需满足的清理条件。只要kubernetes.io/pvc-protection还在,PVC 就会继续保留。status:记录 PVC 的绑定阶段、实际访问模式和容量。这里的phase: Bound表示 PVC 仍与 PV 绑定,可以与deletionTimestamp同时存在。
kubectl get pvc 的 STATUS 列会显示 Terminating,这是根据 deletionTimestamp 生成的显示状态;YAML 中的 status.phase 此时仍可为 Bound。这项判断见 PVC 状态输出的源码。
PVCProtection Controller 确认没有 Pod 继续使用这个 PVC 后,会移除 kubernetes.io/pvc-protection。如果还有其他 Finalizer,对应控制器也需要完成各自的处理。Finalizer 保存的是标记名称,具体检查与清理由控制器实现。
PVC 对象删除后,PV 和底层存储如何处理,还取决于卷的回收策略。相关行为见存储对象使用保护和卷回收策略。
删除传播
删除传播策略决定删除所有者时,如何处理它拥有的对象。这里以 Deployment、ReplicaSet 和 Pod 为例,比较三种删除传播策略。
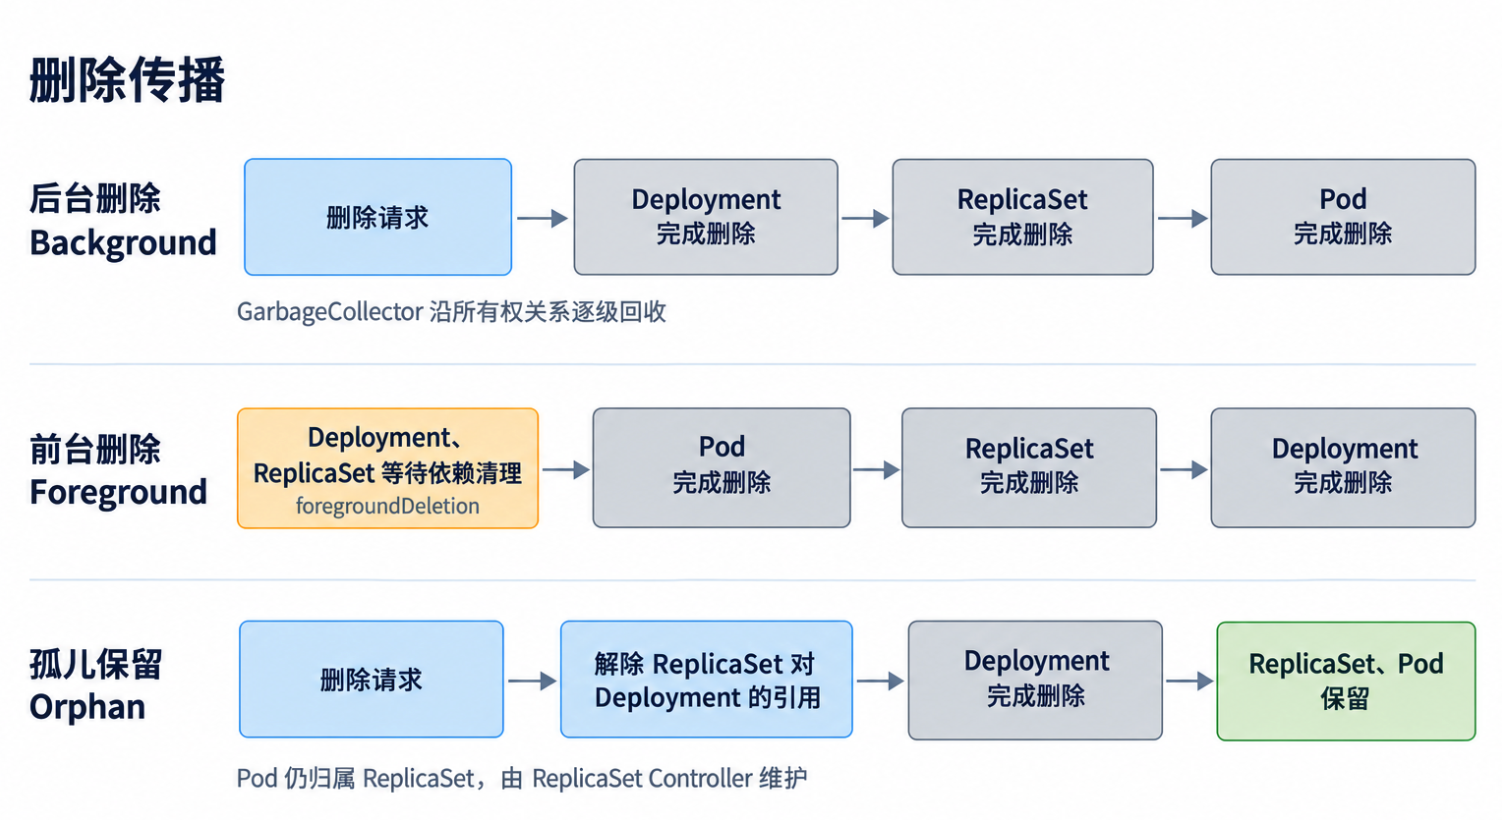
图:删除传播策略。
kubectl delete 通过 --cascade 参数选择删除传播策略,支持 background、foreground 和 orphan,默认使用 background。
后台删除(Background)
使用后台删除策略删除 Deployment:
Deployment 满足自身删除条件后先被移除。GarbageCollector 发现 ReplicaSet 引用的 Deployment 已经不存在,便发起 ReplicaSet 的删除;ReplicaSet 被移除后,其 Pod 再进入回收流程。因此,Deployment 已经查不到时,ReplicaSet 或 Pod 仍可能在等待清理。
前台删除(Foreground)
使用前台删除策略,让 Deployment 等待阻塞其删除的依赖对象:
Deployment 先进入删除状态,并由删除流程加入 foregroundDeletion Finalizer。等待期间,其元数据可以表示为:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  namespace: default
  uid: b4c851bc-ace0-403a-b7da-a7850cc33a42 # 正在删除的 Deployment web 的 UID
  deletionTimestamp: "<deletion-time>"
  finalizers:
    - foregroundDeletion
GarbageCollector 会将仍拥有 Pod 的 ReplicaSet 也纳入前台删除流程。依赖对象的 ownerReferences 中,blockOwnerDeletion: true 表示所有者需要等待它清理完成。在这个例子中:
- Pod 引用 ReplicaSet:Pod 的这条引用设置为
blockOwnerDeletion: true,ReplicaSet 就需要等待该 Pod 删除完成。 - ReplicaSet 引用 Deployment:ReplicaSet 的这条引用也设置为
blockOwnerDeletion: true,Deployment 就需要等待该 ReplicaSet 删除完成。
这些等待只针对 GarbageCollector 已观察到的依赖对象。当某个所有者不再有阻塞删除的依赖对象时,GarbageCollector 会移除它的 foregroundDeletion 标记;其余 Finalizer、宽限期等条件也满足后,该对象才会最终删除。详细规则见官方的前台级联删除说明。
孤儿保留(Orphan)
删除 Deployment,并保留其 ReplicaSet 和 Pod:
GarbageCollector 从 ReplicaSet 中移除指向 Deployment 的所有者引用,再允许 Deployment 完成删除。这个例子中,ReplicaSet 原本只有这一条引用,所以其 ownerReferences 清空;Pod 中指向 ReplicaSet 的引用保持不变。这里成为孤儿对象的是 ReplicaSet,Pod 仍有自己的所有者。
# ReplicaSet 与 Deployment 的所有权关系已经解除。
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: web-7d9
  namespace: default
  uid: 81ea0914-2af3-4cff-8d24-9ee3a363480f # 保留下来的 ReplicaSet web-7d9 的 UID
  ownerReferences: []
---
# Pod 仍然归属于原来的 ReplicaSet。
apiVersion: v1
kind: Pod
metadata:
  name: web-7d9-abc
  namespace: default
  uid: 7c7d15a2-6ddd-49fd-9be5-6114e337f5fc # 保留下来的 Pod web-7d9-abc 的 UID
  ownerReferences:
    - apiVersion: apps/v1
      kind: ReplicaSet
      name: web-7d9
      uid: 81ea0914-2af3-4cff-8d24-9ee3a363480f # 仍然引用原 ReplicaSet 的 UID
      controller: true
      blockOwnerDeletion: true
核心源码
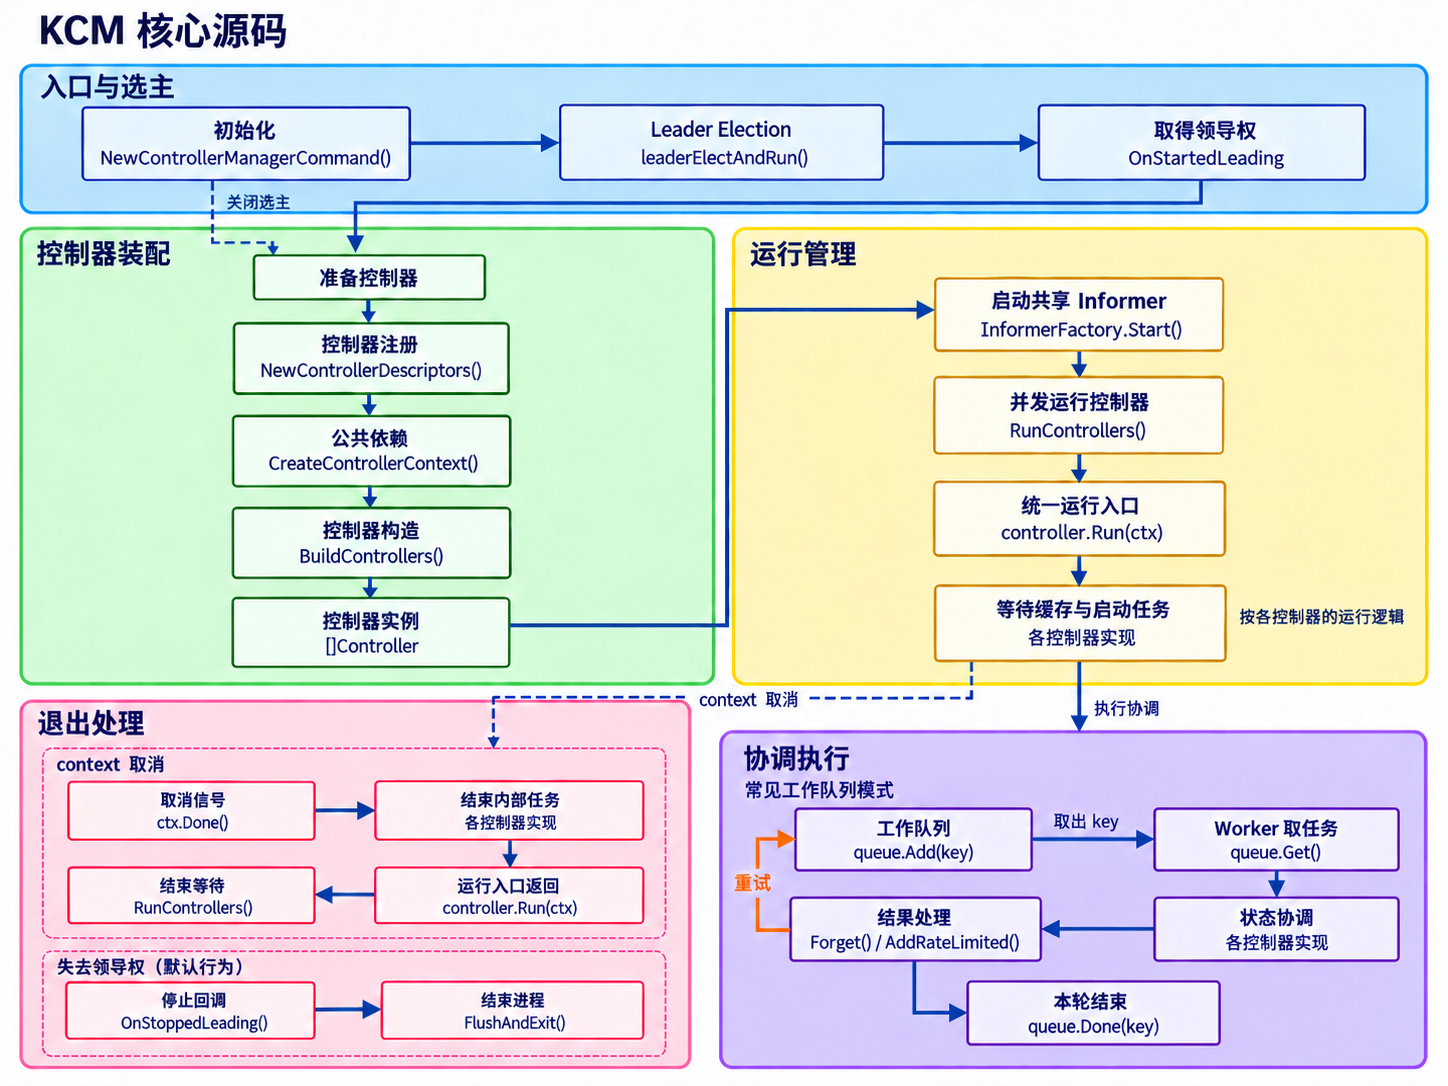
图:KCM 核心源码。
KCM 完成进程初始化后,取得控制器注册表、准备公共依赖,再构造并运行控制器。各控制器在自己的运行逻辑中处理资源变化,并在收到取消信号后结束任务。
- 入口与选主:KCM 读取并校验配置。启用 Leader Election 时,实例取得领导权后,才进入控制器的构造和启动流程。
- 控制器装配:
NewControllerDescriptors()返回控制器注册表,CreateControllerContext()准备客户端、共享 Informer 工厂等依赖,随后BuildControllers()筛选注册项并调用构造函数,生成[]Controller实例列表。 - 运行管理:构造完成后,KCM 启动共享 Informer,通过
RunControllers()并发调用各控制器的Run(ctx)。各控制器在自己的运行入口中等待所需依赖就绪,再启动内部处理任务。 - 协调执行:常见控制器通过工作队列组织协调。事件处理函数将对象标识入队,Worker 取出任务后执行协调、处理结果,并通过
queue.Done(key)结束本轮处理;协调逻辑和重试策略由各控制器实现。 - 退出处理:context 被取消后,各控制器结束内部任务,KCM 等待它们的运行入口返回。内部清理由各控制器实现;默认配置下,失去领导权会直接结束进程。
KCM 的启动与管理代码位于 cmd/kube-controller-manager/,内置控制器的实现位于 pkg/controller/。下面列出主要管理文件和几个常见控制器的源码入口:
cmd/kube-controller-manager/
├── controller-manager.go                 # 进程入口
└── app/
    ├── options/options.go                # 配置校验与客户端配置
    ├── controller_descriptor.go          # 控制器描述与注册
    ├── controllermanager.go              # 公共依赖、构造、运行与退出
    ├── discovery.go                      # EndpointSlice Controller 构造入口
    └── controller_utils.go               # 统一运行接口的适配

pkg/controller/
├── deployment/
│   └── deployment_controller.go         # Deployment 更新与副本管理
├── nodelifecycle/
│   └── node_lifecycle_controller.go     # 节点健康状态与污点管理
├── endpointslice/
│   └── endpointslice_controller.go      # 事件、队列、Worker 与协调入口
├── volume/persistentvolume/
│   └── pv_controller.go                 # PV/PVC 绑定与卷回收
├── serviceaccount/
│   └── serviceaccounts_controller.go    # 默认 ServiceAccount 的创建与维护
└── garbagecollector/
    └── garbagecollector.go              # 对象依赖跟踪与垃圾回收

staging/src/k8s.io/
├── client-go/tools/leaderelection/
│   └── leaderelection.go                 # 租约获取与续约
└── endpointslice/
    └── reconciler.go                     # EndpointSlice 差异计算与资源修改
初始化
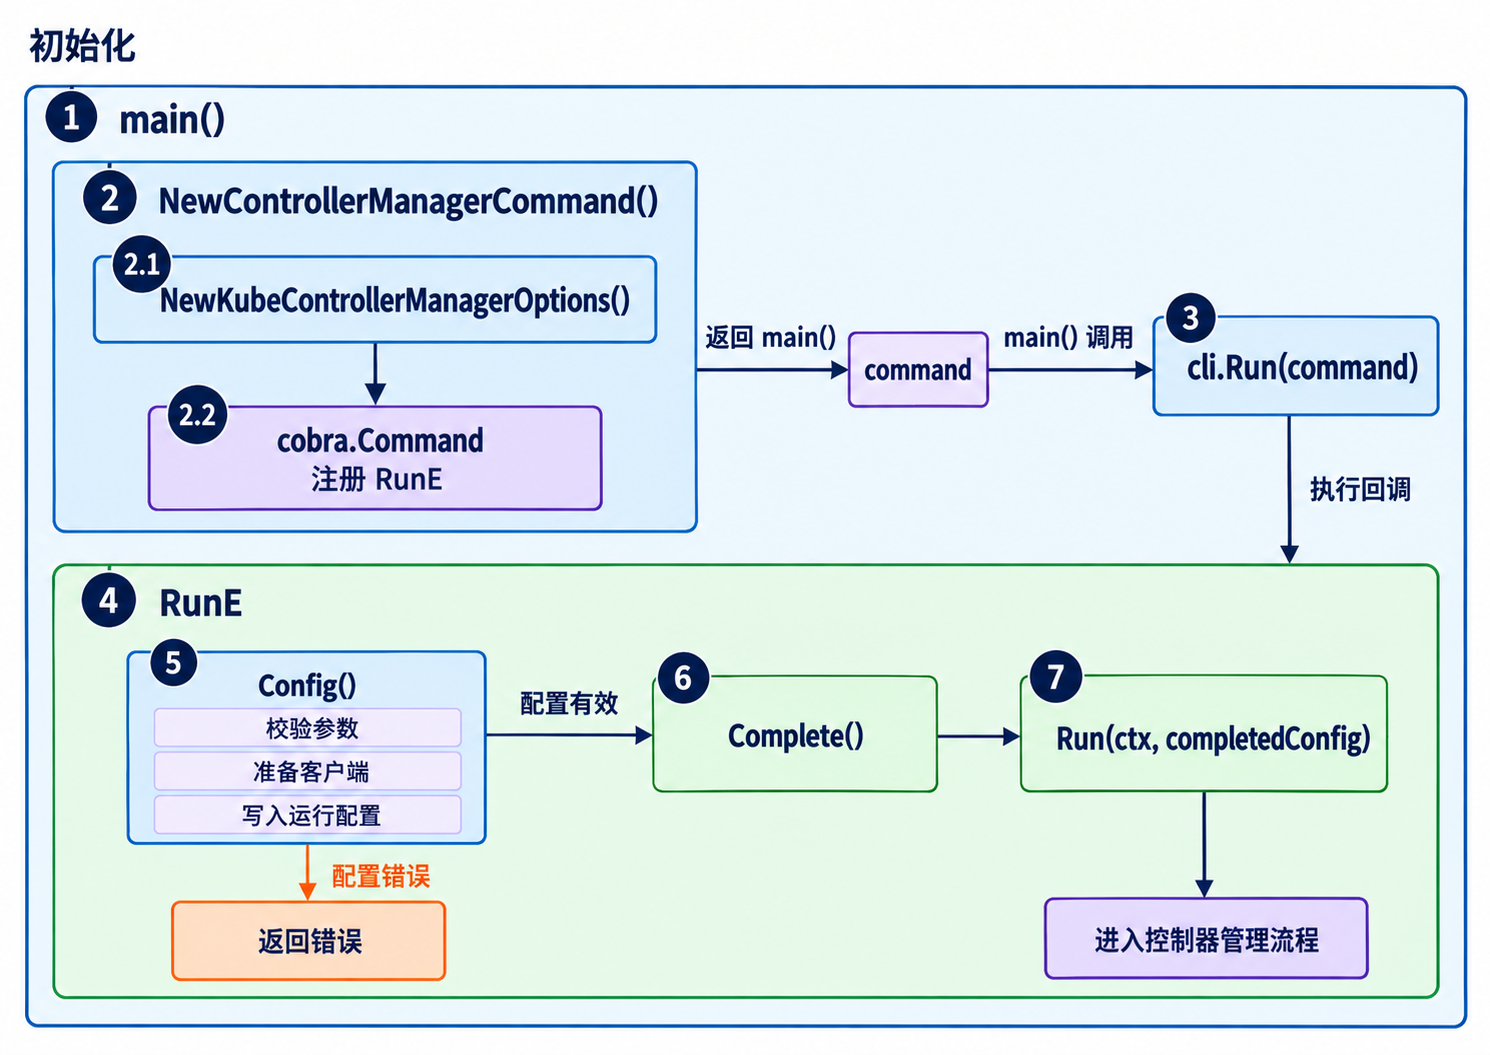
图:初始化调用关系。
KCM 启动时先创建命令对象,再解析命令行参数、校验配置,并准备访问 API Server 的客户端。配置有效后,才进入控制器管理流程。
main():进程入口,先调用NewControllerManagerCommand()创建命令对象,再交给cli.Run(command)执行。NewControllerManagerCommand():创建命令对象,注册命令行参数和执行回调:- 2.1
NewKubeControllerManagerOptions():创建配置选项并填入默认值。这些默认值可以通过对应的命令行参数覆盖。 - 2.2
cobra.Command:创建命令对象,注册RunE启动回调。命令构造完成后,返回给main()。
- 2.1
cli.Run(command):执行main()传入的命令,由命令框架解析参数、执行前置检查,再调用RunE。RunE:在参数解析和前置检查完成后执行。日志配置或Config()返回错误时,终止后续启动,并将错误交回命令框架。- 5
Config():校验参数,创建客户端和事件记录器,并将选项写入运行配置。控制器别名也在此过程中转换为规范名称,例如将endpointslice转换为endpointslice-controller。 - 6
Complete():将Config包装为运行入口要求的CompletedConfig,底层仍使用同一份配置。 - 7
Run():组织选主、公共依赖、控制器构造和启动;后文的RunControllers()负责并发运行已构造的控制器实例。
- 5
进程入口
main() 先调用 NewControllerManagerCommand() 创建命令对象,再交给 cli.Run(command) 执行。
func main() {
    command := app.NewControllerManagerCommand()
    code := cli.Run(command)
    os.Exit(code)
}
命令构造
NewControllerManagerCommand() 创建配置选项并注册 RunE。命令执行时,RunE 通过以下调用准备配置并启动控制器管理流程:
Config():校验配置选项,准备 API 客户端和事件记录器,生成运行所需的Config对象。Complete():将Config包装为运行入口要求的CompletedConfig,底层仍使用同一份配置。Run():KCM 的运行入口,负责准备客户端和共享 Informer 等依赖,创建并运行控制器。启用 Leader Election 时,取得领导权后才开始这些工作。
下面保留选项创建、配置准备和运行入口的关键调用:
func NewControllerManagerCommand() *cobra.Command {
    s, err := options.NewKubeControllerManagerOptions()
    if err != nil {
        klog.Background().Error(err, "Unable to initialize command options")
        klog.FlushAndExit(klog.ExitFlushTimeout, 1)
    }

    cmd := &cobra.Command{
        Use: kubeControllerManager,
        ...
        RunE: func(cmd *cobra.Command, args []string) error {
            ...
            ctx := context.Background()
            // 校验选项,准备客户端和事件记录器,生成运行配置。
            c, err := s.Config(ctx, KnownControllers(), ControllersDisabledByDefault(), ControllerAliases())
            if err != nil {
                return err
            }

            ...
            // Complete() 包装配置,Run() 启动控制器管理流程。
            return Run(ctx, c.Complete())
        },
        ...
    }

    ...
    return cmd
}
配置准备
Config() 将命令行选项转换为运行所需的配置。它先调用 Validate() 检查参数,再构造 API 客户端和事件记录器,最后通过 ApplyTo() 写入各控制器的配置;控制器别名的转换也由这条调用路径完成。下面省略服务端证书、客户端请求参数和指标设置,保留配置的生成过程:
func (s KubeControllerManagerOptions) Config(ctx context.Context, allControllers []string, disabledByDefaultControllers []string, controllerAliases map[string]string) (*kubecontrollerconfig.Config, error) {
    // 校验控制器名称和配置参数。
    // allControllers:全部已注册控制器的规范名称。
    // disabledByDefaultControllers:默认关闭、需要显式启用的控制器名称。
    // controllerAliases:别名到规范名称的映射,例如 endpointslice → endpointslice-controller。
    if err := s.Validate(allControllers, disabledByDefaultControllers, controllerAliases); err != nil {
        return nil, err
    }

    ...
    // 生成连接配置,再用它创建 API 客户端。
    kubeconfig, err := clientcmd.BuildConfigFromFlags(s.Master, s.Generic.ClientConnection.Kubeconfig)
    if err != nil {
        return nil, err
    }
    ...

    client, err := clientset.NewForConfig(restclient.AddUserAgent(kubeconfig, KubeControllerManagerUserAgent))
    if err != nil {
        return nil, err
    }

    // 广播器分发 Event,记录器生成带有 KCM 来源标识的 Event。
    eventBroadcaster := record.NewBroadcaster(record.WithContext(ctx))
    eventRecorder := eventBroadcaster.NewRecorder(clientgokubescheme.Scheme, v1.EventSource{Component: KubeControllerManagerUserAgent})

    c := &kubecontrollerconfig.Config{
        Client:           client,
        Kubeconfig:       kubeconfig,
        EventBroadcaster: eventBroadcaster,
        EventRecorder:    eventRecorder,
        ...
    }
    // 写入各项配置,并将控制器别名转换为规范名称。
    if err := s.ApplyTo(c, allControllers, disabledByDefaultControllers, controllerAliases); err != nil {
        return nil, err
    }

    ...
    return c, nil
}
配置封装
配置准备完成后,Complete() 将原来的 *Config 指针包入 CompletedConfig,供 Run() 使用。两者共享同一份配置,类型变化用于区分配置准备与运行阶段。
type completedConfig struct {
    *Config
}

type CompletedConfig struct {
    *completedConfig
}

func (c *Config) Complete() *CompletedConfig {
    // 保存原 Config 指针,复用同一份配置。
    cc := completedConfig{c}

    return &CompletedConfig{&cc}
}
Leader Election
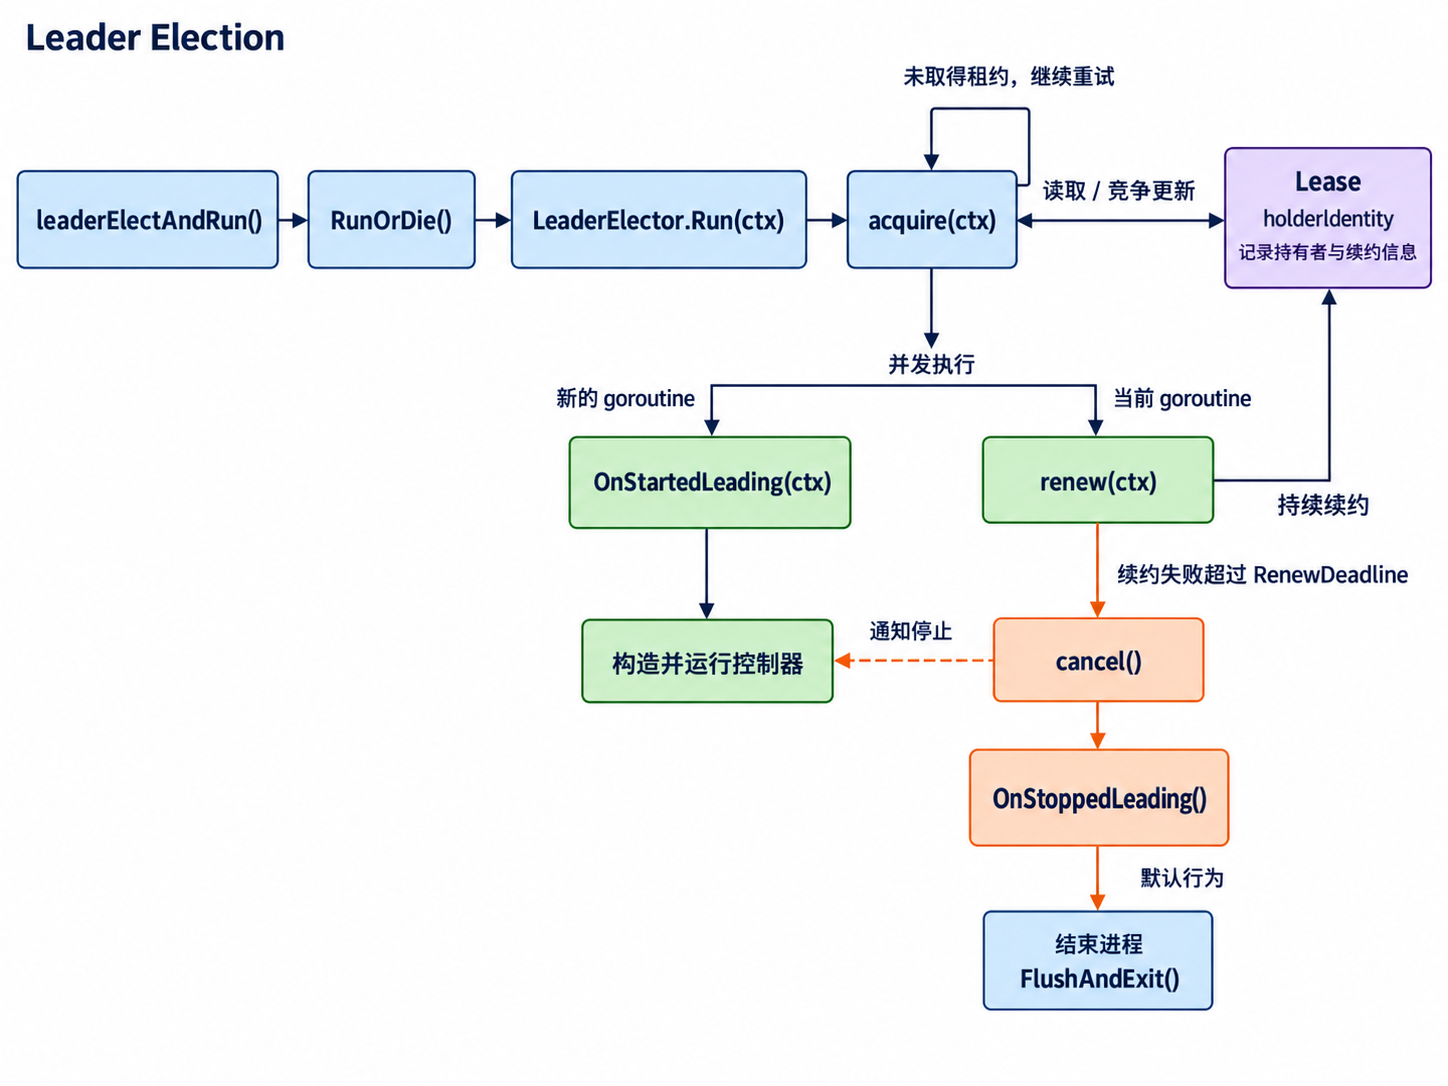
图:Leader Election 与控制器启动。
启用 Leader Election 时,多个 KCM 实例竞争同一份 Lease,由取得领导权的实例构造并运行控制器。关闭选主时,KCM 直接进入控制器初始化过程。
- 获取领导权:
acquire()尝试取得租约,未取得时继续重试。 - 并发运行:取得租约后,
OnStartedLeading在新的 goroutine 中准备并运行控制器,当前 goroutine 通过renew()持续续约。 - 失去领导权:续约失败超过允许的窗口后,取消控制器 context,再执行
OnStoppedLeading;默认回调会结束进程。
租约配置
KCM 默认使用 kube-system 命名空间中的 kube-controller-manager Lease,这两个默认值在 NewKubeControllerManagerOptions() 中设置。leaderElectAndRun() 读取租约位置和当前实例身份,创建资源锁,再将 LeaderElectionConfig 定义的租约参数和回调传给 RunOrDie()。
func leaderElectAndRun(ctx context.Context, c *config.CompletedConfig, lockIdentity string,
    electionChecker *leaderelection.HealthzAdaptor, resourceLock string, leaseName string,
    callbacks leaderelection.LeaderCallbacks) {
    logger := klog.FromContext(ctx)

    // 根据租约的命名空间、名称和当前实例身份创建资源锁。
    rl, err := resourcelock.NewFromKubeconfig(resourceLock,
        c.ComponentConfig.Generic.LeaderElection.ResourceNamespace, // 默认 kube-system。
        leaseName, // 调用方传入 ResourceName,默认 kube-controller-manager。
        resourcelock.ResourceLockConfig{
            Identity:      lockIdentity, // 获取或续约时用于填充 holderIdentity。
            EventRecorder: c.EventRecorder,
        },
        c.Kubeconfig,
        c.ComponentConfig.Generic.LeaderElection.RenewDeadline.Duration)
    if err != nil {
        logger.Error(err, "Error creating lock")
        klog.FlushAndExit(klog.ExitFlushTimeout, 1)
    }

    // 将资源锁、租约参数和回调交给选主循环,开始获取租约和续约。
    leaderelection.RunOrDie(ctx, leaderelection.LeaderElectionConfig{
        // 用于读取和更新 Lease 的资源锁。
        Lock: rl,
        // 其他候选实例判断租约过期的等待时间,默认 15 秒。
        // 从最后一次观察到租约更新起,超过这段时间仍无新更新,才可尝试接管。
        LeaseDuration: c.ComponentConfig.Generic.LeaderElection.LeaseDuration.Duration,
        // 当前 leader 尝试完成一次续约的时间上限,默认 10 秒。
        // 在此期间可以多次重试;到期仍未续约成功,就放弃领导权。
        RenewDeadline: c.ComponentConfig.Generic.LeaderElection.RenewDeadline.Duration,
        // 两次获取租约或续约尝试之间的等待时间,默认 2 秒。
        // 获取租约时会额外加入随机等待,错开各候选实例的尝试时机。
        RetryPeriod: c.ComponentConfig.Generic.LeaderElection.RetryPeriod.Duration,
        // 取得或失去领导权时,执行 KCM 注册的回调。
        Callbacks: callbacks,
        ...
    })
}
获取租约
候选实例读取 Lease,并在满足获取条件时尝试更新持有者。更新携带对象的 resourceVersion;发生竞争冲突时,实例会重新读取后再尝试。
取得租约后,LeaderElector.Run() 在新的 goroutine 中执行 OnStartedLeading。KCM 通过这个回调准备公共依赖、构造并运行控制器。控制器的处理循环会持续运行,因此回调与当前 goroutine 中的 renew() 并发执行,让实例在运行控制器的同时持续续约:
func (le *LeaderElector) Run(ctx context.Context) {
    defer runtime.HandleCrashWithContext(ctx)
    defer le.config.Callbacks.OnStoppedLeading()

    if !le.acquire(ctx) {
        return // context 已取消。
    }
    ctx, cancel := context.WithCancel(ctx)
    defer cancel()
    go le.config.Callbacks.OnStartedLeading(ctx)
    le.renew(ctx)
}
KCM 在 Run() 中注册 OnStartedLeading 和 OnStoppedLeading 两个回调。取得领导权后,OnStartedLeading 通过 NewControllerDescriptors() 把各内置控制器的名称与构造函数、启用条件等信息关联起来,保存到注册表中。随后,局部的 run 函数准备公共依赖,并调用 BuildControllers() 根据配置筛选注册项、调用对应的构造函数创建实例,再启动控制器运行。
选主停止时执行 OnStoppedLeading。未启用 ControllerManagerReleaseLeaderElectionLockOnExit 特性时,回调通过 FlushAndExit() 刷新日志并结束进程。
func Run(ctx context.Context, c *config.CompletedConfig) error {
    ...

    var wg sync.WaitGroup
    wg.Go(func() {
        leaderElectAndRun(ctx, c, id, electionChecker,
            c.ComponentConfig.Generic.LeaderElection.ResourceLock,
            c.ComponentConfig.Generic.LeaderElection.ResourceName,
            leaderelection.LeaderCallbacks{
                OnStartedLeading: startedLeading(func(ctx context.Context) error {
                    // 将控制器名称与构造函数、启用条件等信息汇总到注册表。
                    controllerDescriptors := NewControllerDescriptors()
                    ...
                    controllerDescriptors[names.ServiceAccountTokenController] = saTokenControllerDescriptor
                    // run() 准备公共依赖,调用 BuildControllers() 筛选并构造控制器。
                    // 随后启动共享 Informer,并运行控制器。
                    return run(ctx, controllerDescriptors)
                }),
                OnStoppedLeading: func() {
                    logger.Error(nil, "leaderelection lost/stopped")
                    // 未启用退出时释放选主锁的特性时,直接结束进程。
                    if !utilfeature.DefaultFeatureGate.Enabled(cmfeatures.ControllerManagerReleaseLeaderElectionLockOnExit) {
                        // 刷新日志后以非零状态退出,不等待控制器清理完成。
                        klog.FlushAndExit(klog.ExitFlushTimeout, 1)
                    }
                },
            })
    })

    ...
    wg.Wait()
    return utilerrors.NewAggregate(errs)
}
run 函数中的依赖准备、控制器构造和启动顺序见控制器运行。
续约与停止
leader 续约成功后,等待 RetryPeriod 再发起下一轮;续约失败时,在 RenewDeadline 限定的窗口内继续重试。例如,RetryPeriod=2s、RenewDeadline=10s 表示按约 2 秒的间隔尝试续约,若一轮续约在 10 秒内始终未成功,就停止续约。
renew() 的外层循环控制续约周期,内层轮询控制失败后的重试间隔和时间上限。
续约超时后,cancel() 结束循环;renew() 返回后,LeaderElector.Run() 取消控制器的 context,并调用 OnStoppedLeading。KCM 默认在该回调中退出进程,详见退出处理。
func (le *LeaderElector) renew(ctx context.Context) {
    defer le.config.Lock.RecordEvent("stopped leading")
    ctx, cancel := context.WithCancel(ctx)
    defer cancel()
    logger := klog.FromContext(ctx)

    wait.UntilWithContext(ctx, func(ctx context.Context) {
        err := wait.PollUntilContextTimeout(
            ctx,
            le.config.RetryPeriod,   // 重试间隔,默认 2 秒。
            le.config.RenewDeadline, // 本轮续约的时间上限,默认 10 秒。
            true,                   // 本轮立即尝试第一次续约。
            func(ctx context.Context) (done bool, err error) {
                if err := ctx.Err(); err != nil {
                    return false, err
                }
                if !le.config.Coordinated {
                    return le.tryAcquireOrRenew(ctx), nil
                } else {
                    return le.tryCoordinatedRenew(ctx), nil
                }
            },
        )
        // ... 更新状态并记录日志。
        if err == nil {
            return // 续约成功,等待 RetryPeriod 后进入下一轮。
        }
        // ... 更新指标并记录续约失败。
        cancel() // 超时或 context 被取消,结束续约循环。
    }, le.config.RetryPeriod)

    if le.config.ReleaseOnCancel {
        le.release(logger)
    }
}
公共依赖
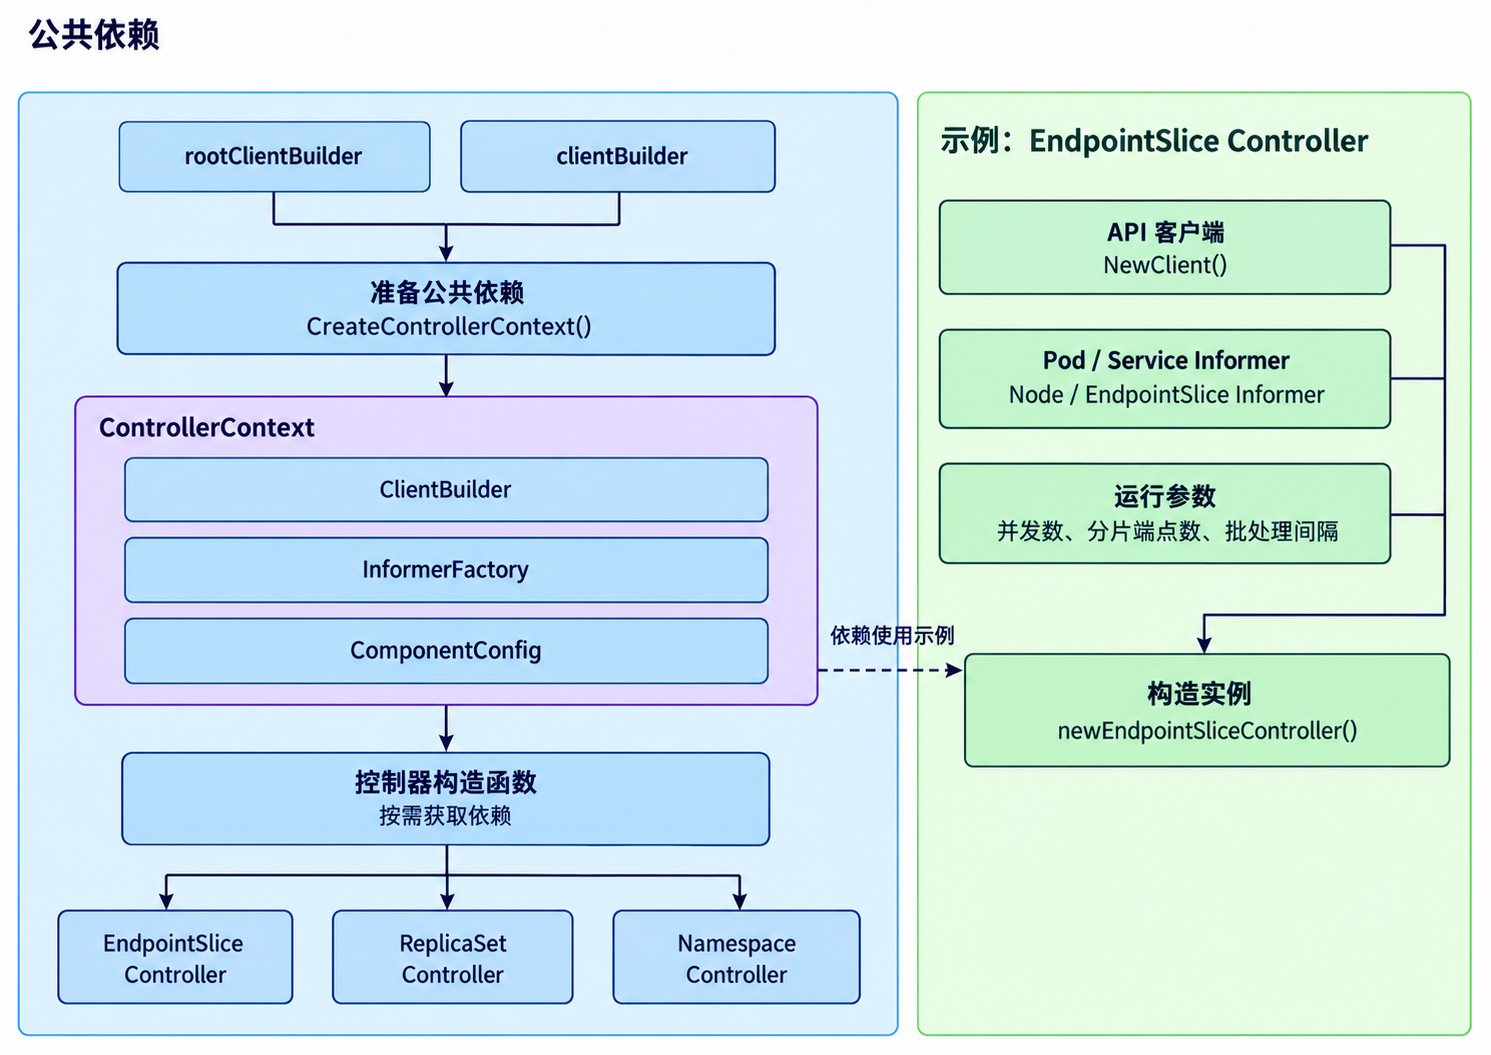
图:公共依赖与 ControllerContext。
KCM 将客户端构造器、共享 Informer 工厂和运行配置放入 ControllerContext,传给各控制器的构造函数。控制器从中取得所需依赖,再建立自己的事件处理和协调逻辑。
ClientBuilder:为控制器创建 API 客户端,ControllerContext.NewClient()通过它取得客户端。InformerFactory:按资源类型复用 Informer。例如,EndpointSlice 和 ReplicaSet Controller 可以取得同一个 Pod Informer,各自注册事件处理函数。这里创建工厂,构造完成后的启动过程见控制器运行。ComponentConfig:提供各控制器的运行参数,构造函数读取对应的配置部分。
ControllerContext 保存这些依赖,对应图中的三个字段:
type ControllerContext struct {
    ClientBuilder   clientbuilder.ControllerClientBuilder
    InformerFactory informers.SharedInformerFactory
    ...
    ComponentConfig kubectrlmgrconfig.KubeControllerManagerConfiguration
    ...
}
CreateControllerContext() 通过 rootClientBuilder 为共享 Informer 创建 API 客户端,再用这个客户端创建共享工厂。传入的 clientBuilder 和运行配置也会一并放入 ControllerContext,供后续控制器构造使用:
func CreateControllerContext(ctx context.Context, s *config.CompletedConfig, rootClientBuilder, clientBuilder clientbuilder.ControllerClientBuilder) (ControllerContext, error) {
    ...
    // 为共享 Informer 创建访问 API Server 的客户端。
    versionedClient, err := rootClientBuilder.Client("shared-informers")
    if err != nil {
        return ControllerContext{}, fmt.Errorf("failed to create Kubernetes client for %q: %w", "shared-informers", err)
    }

    ...
    // 创建共享工厂,供各控制器按资源类型取得 Informer。
    sharedInformers := informers.NewSharedInformerFactoryWithOptions(
        versionedClient,
        ResyncPeriod(s)(),
        ...
    )

    ...
    // 将客户端构造器、共享工厂和运行配置放入公共上下文。
    controllerContext := ControllerContext{
        ClientBuilder:   clientBuilder,
        InformerFactory: sharedInformers,
        ...
        ComponentConfig: s.ComponentConfig,
        ...
    }

    ...
    return controllerContext, nil
}
控制器在构造时通过 ControllerContext 获取 API 客户端、共享 Informer 和运行配置,具体用法见控制器注册。
控制器注册
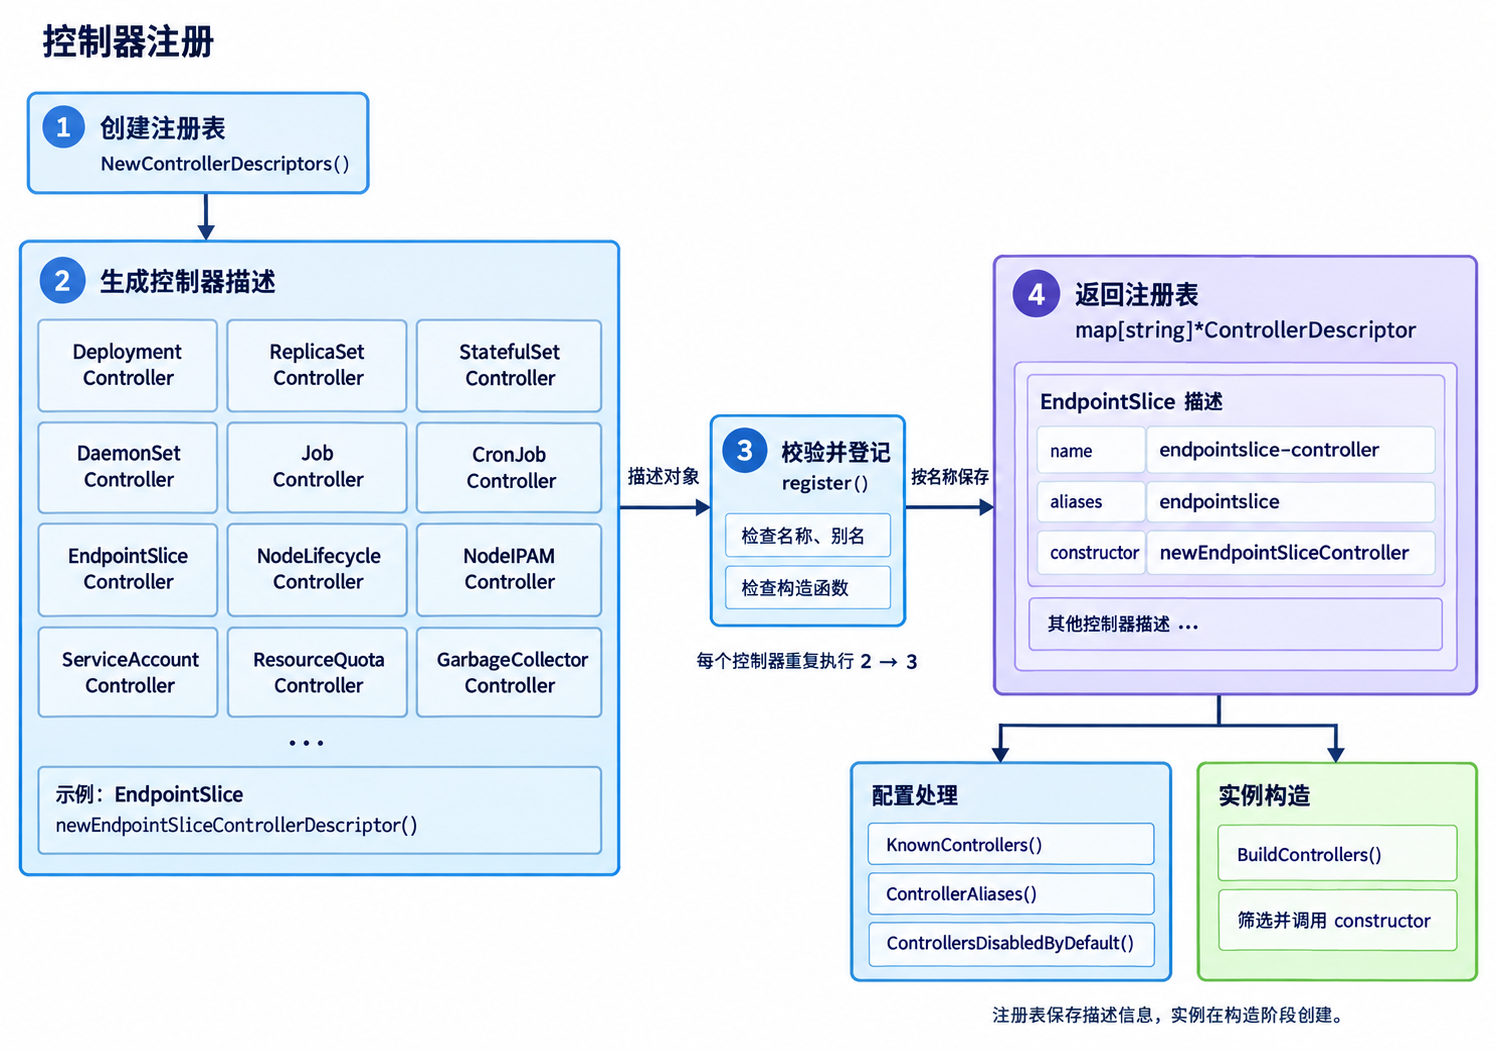
图:控制器注册表。
KCM 通过注册表保存各控制器的名称、构造函数和启用条件,供配置处理和实例构造使用。图中 2、3 会对各控制器重复执行,编号表示注册流程,不代表控制器的启动顺序。
- 创建注册表:
NewControllerDescriptors()创建空的map[string]*ControllerDescriptor,并定义内部的register()函数。 - 生成控制器描述:Deployment、ReplicaSet 等控制器各自通过描述函数提供名称、别名、构造函数和启用条件。例如,
newEndpointSliceControllerDescriptor()返回 EndpointSlice Controller 的描述对象。 - 校验并登记:
register()检查描述对象、名称和构造函数是否有效,以及名称、别名是否重复,再以规范名称为键保存描述对象。 - 返回注册表:所有描述登记完成,并检查别名与规范名称是否冲突后,返回注册表。图中展开了 EndpointSlice 的一个条目:
name是规范名称,aliases是别名,constructor指向创建实例的函数。
注册表中的信息用于图下方的两个分支:
- 配置处理:
KnownControllers()、ControllerAliases()和ControllersDisabledByDefault()分别提取控制器名称、别名映射和默认关闭列表,供命令行帮助与配置校验使用。 - 实例构造:
BuildControllers()根据配置筛选控制器,并通过描述对象调用对应的constructor创建实例。
ControllerDescriptor 保存一个控制器的描述,constructor 指向创建实例的函数:
type ControllerConstructor func(ctx context.Context, controllerContext ControllerContext, controllerName string) (Controller, error)

type ControllerDescriptor struct {
    name                      string
    constructor               ControllerConstructor
    requiredFeatureGates      []featuregate.Feature
    aliases                   []string
    isDisabledByDefault       bool
    isCloudProviderController bool
    requiresSpecialHandling   bool
}
NewControllerDescriptors() 调用 register,将各内置控制器的描述加入 map[string]*ControllerDescriptor。register 检查描述信息是否完整、名称和别名是否重复,再以规范名称为键保存描述对象:
func NewControllerDescriptors() map[string]*ControllerDescriptor {
    controllers := map[string]*ControllerDescriptor{}
    ...

    register := func(controllerDesc *ControllerDescriptor) {
        ...
        name := controllerDesc.Name()
        ...
        if _, found := controllers[name]; found {
            panic(fmt.Sprintf("controller name %q was registered twice", name))
        }
        ...
        // 按规范名称保存描述对象,其中包含构造函数和启用条件。
        controllers[name] = controllerDesc
    }

    ...
    register(newEndpointSliceControllerDescriptor())
    ...
    // 清理符合回收条件的 Pod。
    register(newPodGarbageCollectorControllerDescriptor())
    register(newResourceQuotaControllerDescriptor())
    register(newNamespaceControllerDescriptor())
    register(newServiceAccountControllerDescriptor())
    register(newGarbageCollectorControllerDescriptor())
    register(newDaemonSetControllerDescriptor())
    ...
    // 维护 ReplicaSet 声明的 Pod 副本数。
    register(newReplicaSetControllerDescriptor())
    ...

    return controllers
}
示例:EndpointSlice Controller
newEndpointSliceControllerDescriptor() 返回描述对象,其中 name 是 endpointslice-controller,constructor 指向 newEndpointSliceController()。register() 将描述存入注册表,后续构造阶段再调用这个构造函数,准备客户端和 Informer,创建控制器实例并封装运行回调:
func newEndpointSliceControllerDescriptor() *ControllerDescriptor {
    return &ControllerDescriptor{
        name:        names.EndpointSliceController,
        aliases:     []string{"endpointslice"},
        constructor: newEndpointSliceController,
    }
}

func newEndpointSliceController(ctx context.Context, controllerContext ControllerContext, controllerName string) (Controller, error) {
    // 创建供 EndpointSlice Controller 访问 API Server 的客户端。
    client, err := controllerContext.NewClient("endpointslice-controller")
    if err != nil {
        return nil, err
    }

    // 传入共享 Informer、分片大小、客户端和更新批处理间隔。
    esc := endpointslicecontroller.NewController(
        ctx,
        controllerContext.InformerFactory.Core().V1().Pods(),
        controllerContext.InformerFactory.Core().V1().Services(),
        controllerContext.InformerFactory.Core().V1().Nodes(),
        controllerContext.InformerFactory.Discovery().V1().EndpointSlices(),
        controllerContext.ComponentConfig.EndpointSliceController.MaxEndpointsPerSlice,
        client,
        controllerContext.ComponentConfig.EndpointSliceController.EndpointUpdatesBatchPeriod.Duration,
    )

    // 保存运行回调;KCM 启动控制器时,再按配置的并发数执行 esc.Run()。
    return newControllerLoop(func(ctx context.Context) {
        esc.Run(ctx, int(controllerContext.ComponentConfig.EndpointSliceController.ConcurrentServiceEndpointSyncs))
    }, controllerName), nil
}
控制器构造
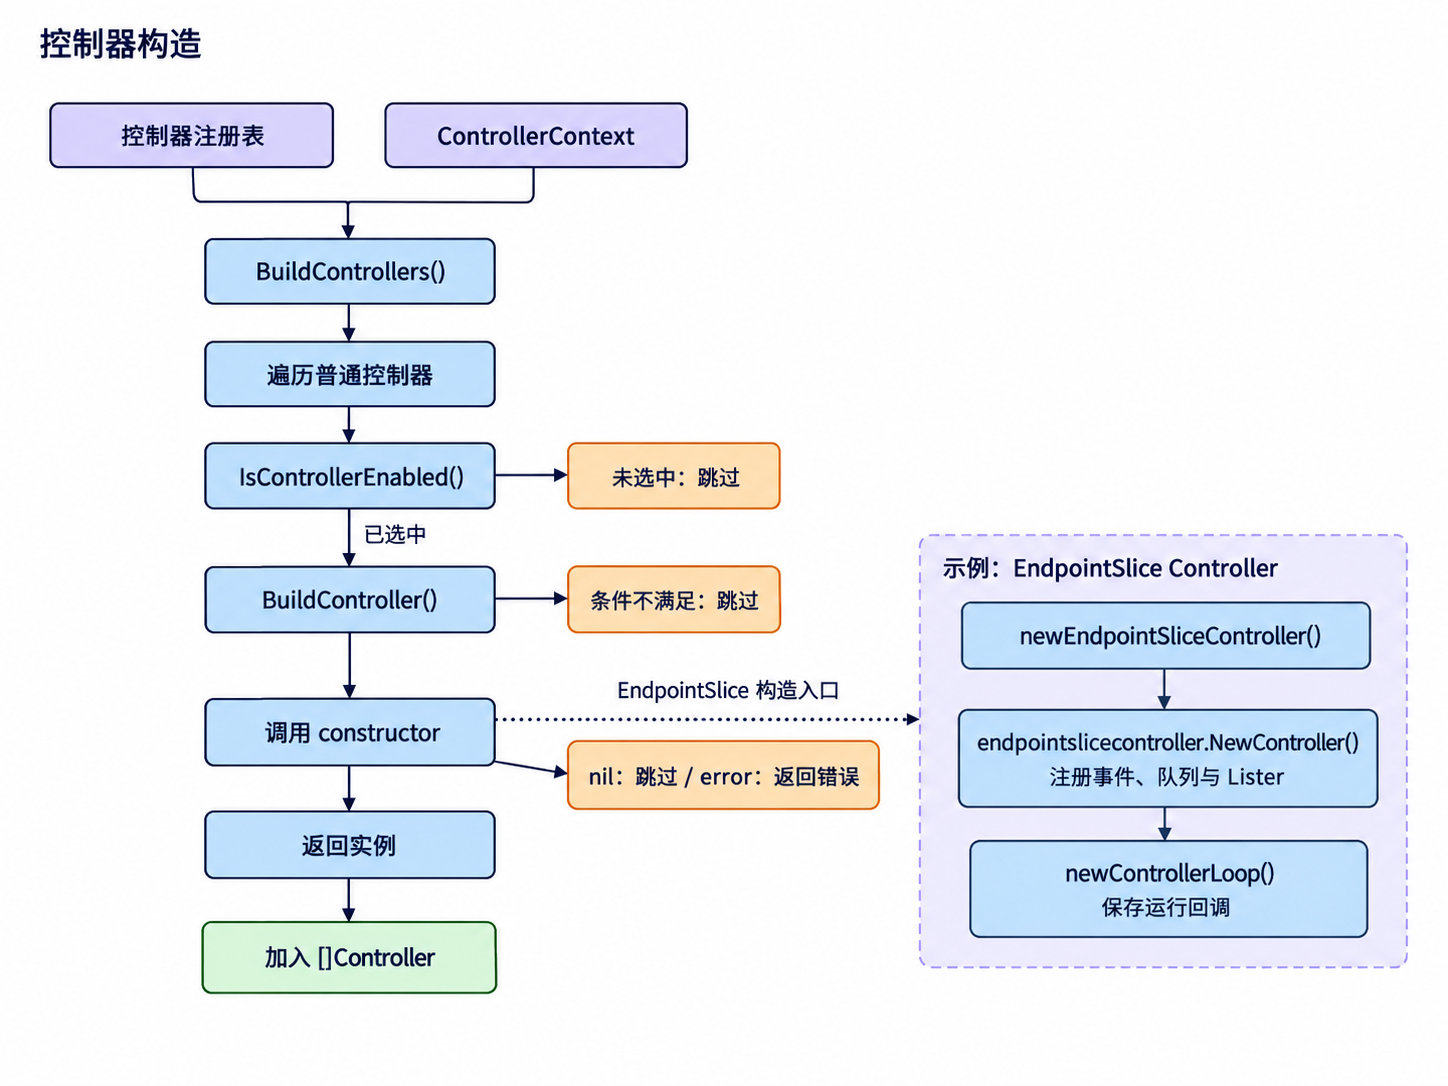
图:控制器构造。
控制器构造阶段根据配置筛选控制器,并创建实现 Controller 接口的实例。图中左侧是普通控制器的处理流程,右侧以 EndpointSlice Controller 为例,展开构造函数内部的调用。
BuildControllers():接收控制器注册表和ControllerContext,遍历普通控制器的描述对象,逐个进行筛选和构造。IsControllerEnabled():根据--controllers配置和控制器的默认启用情况,判断当前注册项是否被选中;未选中的直接跳过。BuildController():继续检查 Feature Gate 等启用条件。条件满足后,调用描述对象中登记的constructor;条件不满足时跳过。- 调用
constructor:以右侧的 EndpointSlice Controller 为例,newEndpointSliceController()取得客户端、Informer 和运行参数,再调用endpointslicecontroller.NewController()创建队列、注册事件处理函数并保存 Lister。 newControllerLoop():EndpointSlice 构造函数用它保存控制器名称和esc.Run()的运行回调,返回实现Controller接口的对象。KCM 在后续运行阶段执行这个回调。- 加入
[]Controller:构造成功的实例追加到controllers列表,供后续统一运行。返回nil, nil时跳过当前控制器;返回错误时,BuildControllers()结束构造并将错误交给调用方。
筛选与收集
BuildControllers() 筛选出配置启用的控制器,再调用局部函数 buildController()。该函数通过描述对象的 BuildController() 方法创建实例,并将构造成功的实例加入控制器列表。
func BuildControllers(ctx context.Context, controllerCtx ControllerContext, controllerDescriptors map[string]*ControllerDescriptor,
    unsecuredMux *mux.PathRecorderMux, healthzHandler HealthCheckAdder) ([]Controller, error) {
    // ... 日志初始化。
    var (
        controllers []Controller
        // ... 健康检查列表。
    )

    buildController := func(controllerDesc *ControllerDescriptor) error {
        // ... 取得控制器名称,用于日志和健康检查。
        ctrl, err := controllerDesc.BuildController(ctx, controllerCtx)
        if err != nil {
            // ... 记录构造失败的日志。
            return err
        }
        if ctrl == nil {
            // ... 记录跳过该控制器的日志。
            return nil
        }

        // ... 准备健康检查和调试接口。
        controllers = append(controllers, ctrl)
        // ... 记录健康检查器。
        return nil
    }

    ...

    for _, controllerDesc := range controllerDescriptors {
        if controllerDesc.RequiresSpecialHandling() {
            continue
        }
        if !controllerCtx.IsControllerEnabled(controllerDesc) {
            // ... 记录未启用的控制器。
            continue
        }
        if err := buildController(controllerDesc); err != nil {
            return nil, err
        }
    }

    // ... 注册健康检查。
    return controllers, nil
}
实例创建
ControllerDescriptor.BuildController() 检查 Feature Gate 等启用条件,满足后调用注册时保存的构造函数。最后一行中的两组括号分别完成以下操作:
GetControllerConstructor():返回描述对象保存的r.constructor函数,具体实现见GetControllerConstructor()源码。(ctx, controllerCtx, controllerName):调用刚取得的函数,传入 context、公共依赖和控制器名称,返回控制器实例或错误。
func (r *ControllerDescriptor) BuildController(ctx context.Context, controllerCtx ControllerContext) (Controller, error) {
    ...
    controllerName := r.Name()
    ...
    // 先取得 constructor,再传入参数调用它。
    return r.GetControllerConstructor()(ctx, controllerCtx, controllerName)
}
EndpointSlice 的 constructor 指向 newEndpointSliceController(),因此这里调用的就是该函数,具体实现见控制器注册。
控制器运行
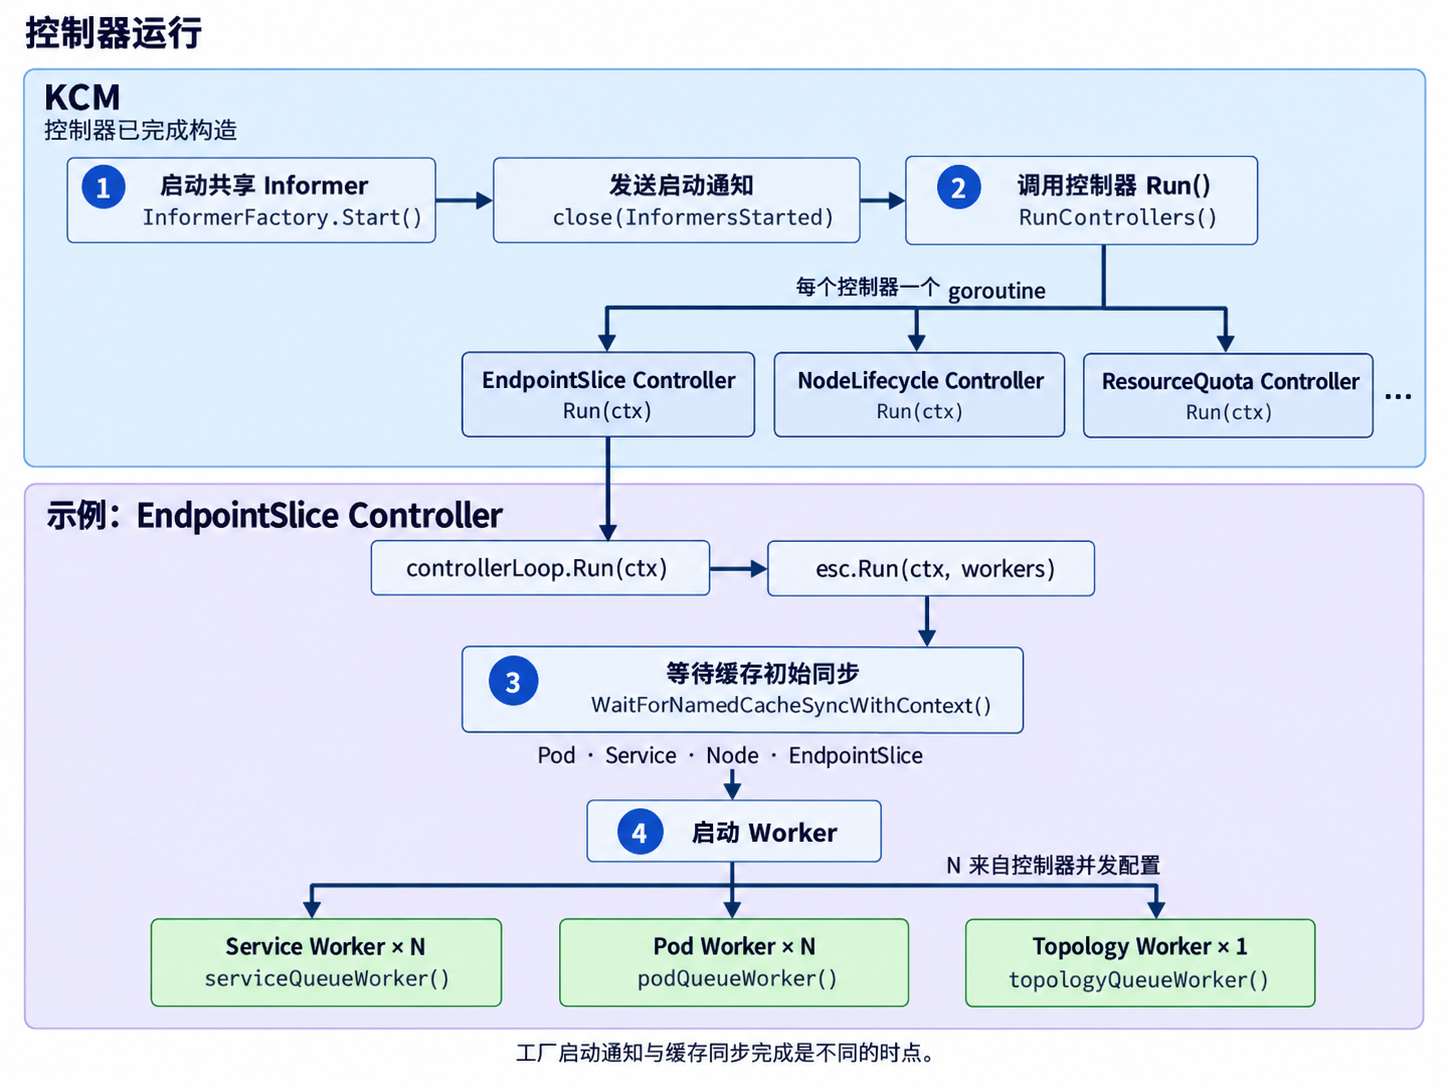
图:Informer 启动与控制器运行。
控制器构造完成后,KCM 启动共享 Informer,再调用各控制器的运行入口。图中前两个环节由 KCM 组织,后两个以 EndpointSlice Controller 为例,展示控制器内部的启动过程。
- 启动共享 Informer:
InformerFactory.Start()启动构造阶段已请求的 Informer,开始加载对象并接收变化。随后关闭InformersStarted发送启动通知,此时缓存仍可能在加载初始数据。 - 调用控制器 Run():
RunControllers()为每个实例启动一个 goroutine,调用controller.Run(ctx),各控制器进入自己的运行逻辑。 - 等待缓存初始同步:EndpointSlice Controller 在
esc.Run()中等待 Pod、Service、Node 和 EndpointSlice 四类缓存完成初始同步。 - 启动 Worker:缓存就绪后,EndpointSlice Controller 启动 Service、Pod 和 Topology 三类 Worker,分别处理对应队列中的任务。
启动共享 Informer
Run() 中的局部 run 函数接收控制器注册表,依次准备公共依赖、构造控制器、启动 Informer,最后调用 RunControllers()。控制器在构造时取得所需的 Informer 并注册事件处理函数,因此工厂要在构造完成后启动。
func Run(ctx context.Context, c *config.CompletedConfig) error {
    ...
    clientBuilder, rootClientBuilder := createClientBuilders(c)
    ...

    run := func(ctx context.Context, controllerDescriptors map[string]*ControllerDescriptor) error {
        controllerContext, err := CreateControllerContext(ctx, c, rootClientBuilder, clientBuilder)
        if err != nil {
            ...
            return err
        }

        controllers, err := BuildControllers(ctx, controllerContext, controllerDescriptors, unsecuredMux, healthzHandler)
        if err != nil {
            ...
            return err
        }

        // 控制器已取得所需 Informer,此时启动共享工厂。
        stopCh := ctx.Done()
        controllerContext.InformerFactory.Start(stopCh)
        defer controllerContext.InformerFactory.Shutdown()
        controllerContext.ObjectOrMetadataInformerFactory.Start(stopCh)
        // 通知工厂已启动;缓存初始同步由各控制器在 Run() 中等待。
        close(controllerContext.InformersStarted)

        if len(controllers) > 0 {
            if !RunControllers(ctx, controllerContext, controllers, ControllerStartJitter, c.ControllerShutdownTimeout) {
                return errors.New("controller shutdown timeout reached")
            }
        } else {
            <-ctx.Done()
        }
        return nil
    }

    ...
    wg.Wait()
    return utilerrors.NewAggregate(errs)
}
调用控制器 Run()
KCM 通过 Controller 接口取得控制器名称并调用运行入口。Run() 在工作期间保持阻塞,并在返回前结束内部 goroutine:
type Controller interface {
    Name() string
    Run(context.Context)
}
RunControllers() 遍历实例列表,为每个控制器启动 goroutine,再通过 WaitGroup 等待所有运行入口返回。各控制器并发运行,列表中的先后位置不代表就绪顺序。
func RunControllers(ctx context.Context, controllerCtx ControllerContext, controllers []Controller,
    controllerStartJitterMaxFactor float64, shutdownTimeout time.Duration) bool {
    ...
    terminatedCh := make(chan struct{})
    go func() {
        defer close(terminatedCh)
        var wg sync.WaitGroup
        wg.Add(len(controllers))
        for _, controller := range controllers {
            go func() {
                defer wg.Done()
                time.Sleep(wait.Jitter(controllerCtx.ComponentConfig.Generic.ControllerStartInterval.Duration, controllerStartJitterMaxFactor))
                ...
                // 每个实例在各自的 goroutine 中运行。
                controller.Run(ctx)
            }()
        }
        wg.Wait()
        ...
    }()

    select {
    case <-ctx.Done():
    case <-terminatedCh:
        return true
    }

    // 收到取消信号后,等待控制器返回或关闭超时。
    var shutdownCh <-chan time.Time
    if shutdownTimeout > 0 {
        shutdownCh = time.After(shutdownTimeout)
    }
    select {
    case <-terminatedCh:
        return true
    case <-shutdownCh:
        ...
        return false
    }
}
等待缓存初始同步
EndpointSlice Controller 经 controllerLoop.Run() 执行构造时保存的回调,进入 esc.Run(ctx, workers)。它调用 WaitForNamedCacheSyncWithContext(),等待 Pod、Service、Node 和 EndpointSlice 四类缓存完成初始同步,再启动 Worker。
例如,Service 已进入缓存,而它选中的 Pod 尚未全部加载时,控制器还不能据此判断完整的后端集合。初始同步完成后,Informer 继续接收变化;协调时仍需考虑缓存可能暂时落后于 API Server。
启动 Worker
EndpointSlice Controller 的三类 Worker 分别处理不同来源的任务:
- Service Worker:取出 Service 标识,重新计算并更新对应的 EndpointSlice。
- Pod Worker:根据 Pod 的标签变化找到需要更新的 Service,将它们加入 Service 队列。
- Topology Worker:更新节点拓扑信息,在启用拓扑提示时检查哪些 Service 需要重新分配端点提示,并安排后续协调。
图中的 N 对应并发配置传入的 workers,分别决定 Service Worker 和 Pod Worker 的数量;Topology Worker 固定启动一个。例如,workers=2 时,会启动两个 Service Worker、两个 Pod Worker 和一个 Topology Worker。缓存等待与 Worker 启动都由 EndpointSlice Controller 的 Run() 完成:
func (c *Controller) Run(ctx context.Context, workers int) {
    defer utilruntime.HandleCrash()
    ...
    logger := klog.FromContext(ctx)
    ...

    var wg sync.WaitGroup
    defer func() {
        ...
        c.serviceQueue.ShutDown()
        c.podQueue.ShutDown()
        c.topologyQueue.ShutDown()
        wg.Wait()
    }()

    // 四类缓存完成初始同步后,才开始处理队列中的任务。
    if !cache.WaitForNamedCacheSyncWithContext(ctx, c.podsSynced, c.servicesSynced, c.endpointSlicesSynced, c.nodesSynced) {
        return
    }

    ...
    // 每轮分别启动一个 Service Worker 和一个 Pod Worker。
    for i := 0; i < workers; i++ {
        wg.Go(func() {
            wait.Until(func() { c.serviceQueueWorker(logger) }, c.workerLoopPeriod, ctx.Done())
        })
        wg.Go(func() {
            wait.Until(func() { c.podQueueWorker(logger) }, c.workerLoopPeriod, ctx.Done())
        })
    }
    ...
    // Topology Worker 固定启动一个。
    wg.Go(func() {
        wait.Until(func() { c.topologyQueueWorker(logger) }, c.workerLoopPeriod, ctx.Done())
    })
    <-ctx.Done()
}
协调执行
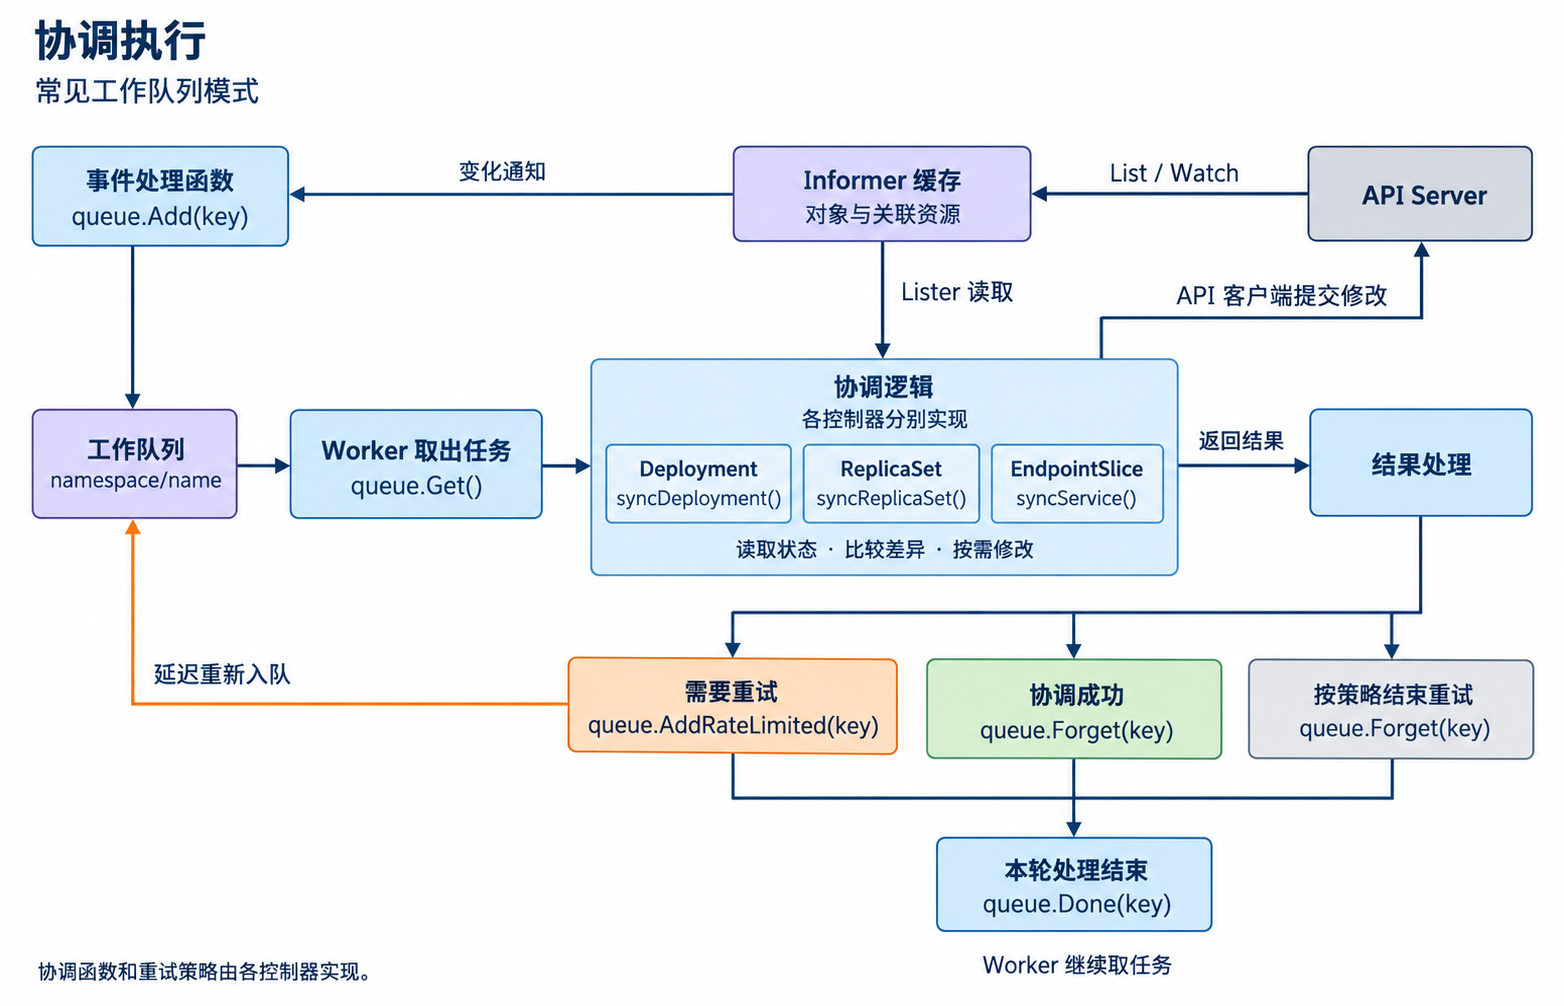
图:控制器协调流程。
Deployment、ReplicaSet、EndpointSlice 等控制器通过工作队列组织协调:事件通知安排任务,Worker 读取当前状态并执行调整。各控制器分别实现协调函数和重试策略。
- 事件入队:Informer 通过 List / Watch 更新缓存,并通知事件处理函数。事件处理函数找到需要协调的目标对象,通过
queue.Add(key)将其标识加入队列。 - 任务处理:Worker 通过
queue.Get()取出对象标识,例如namespace/name,再调用当前控制器的协调函数。 - 状态协调:协调函数通过 Lister 读取目标和关联资源,比较当前状态与管理目标,按需通过 API 客户端提交修改。对象变化再经 List / Watch 更新到缓存。
- 结果处理:协调成功时,
queue.Forget(key)清除重试记录;需要重试时,queue.AddRateLimited(key)安排延迟重新入队。具体重试策略由各控制器决定。 - 本轮结束:Worker 调用
queue.Done(key),通知队列本轮处理已结束,然后继续取出任务。
KCM 通过 Controller.Run() 管理控制器的运行,单轮协调由各控制器自己的函数处理:Deployment 使用 syncDeployment(),ReplicaSet 使用 syncReplicaSet(),EndpointSlice 使用 syncService()。
退出处理
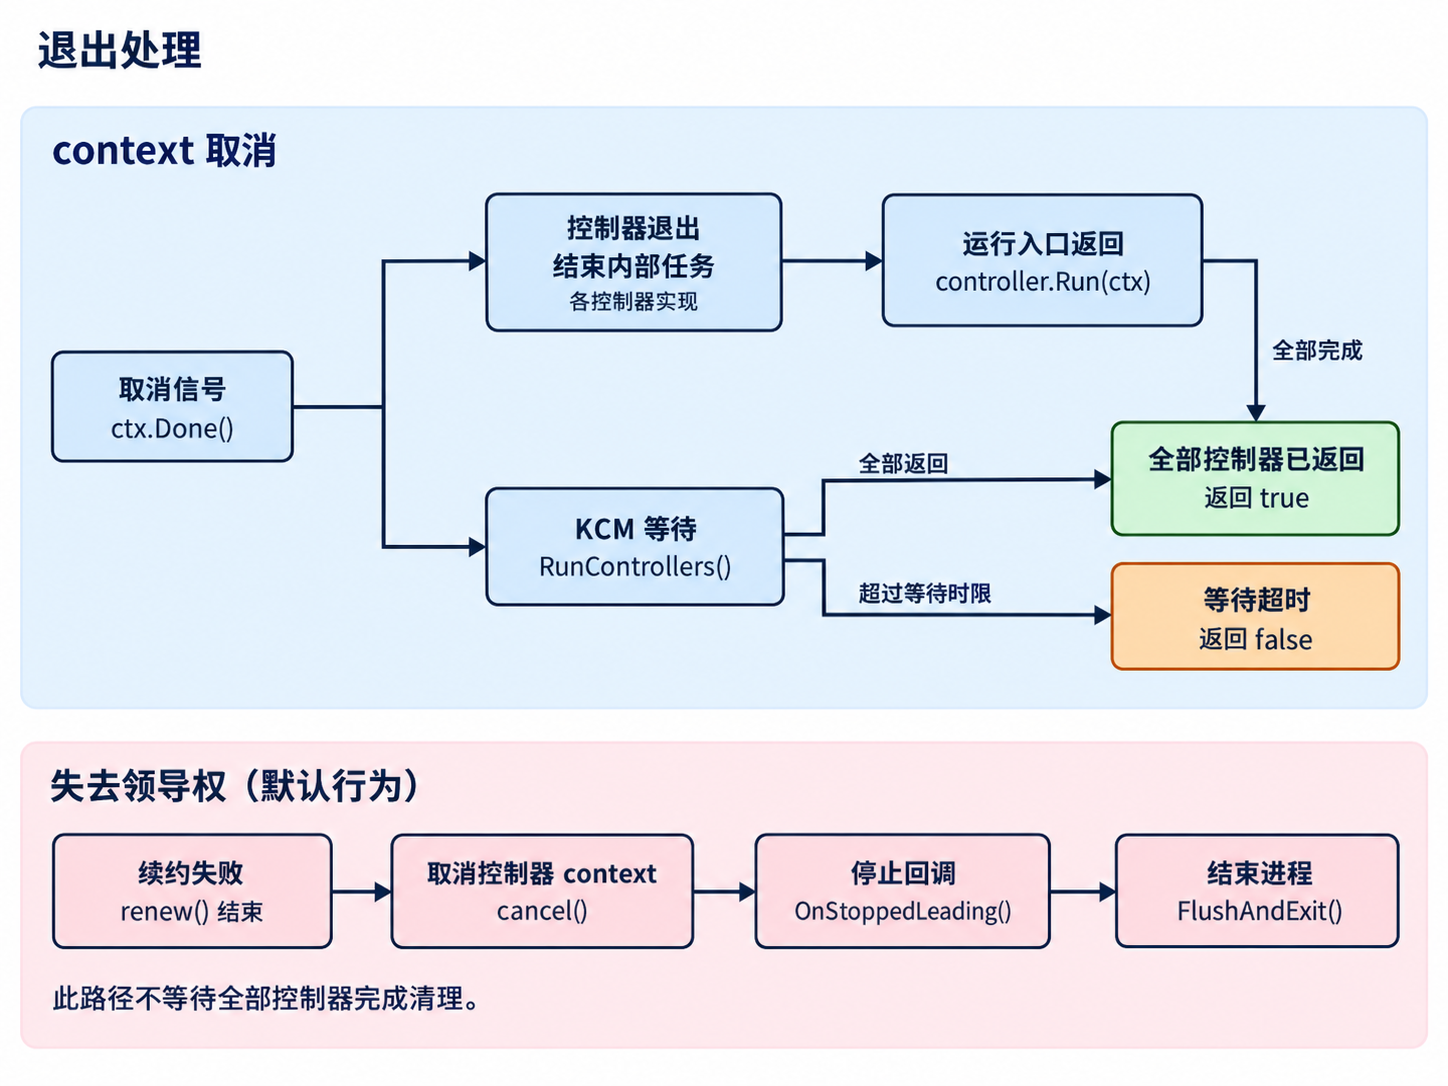
图:控制器退出流程。
context 被取消后,各控制器开始收尾,KCM 同时等待它们退出。
- 停止通知:context 被取消时,
ctx.Done()通道关闭,通知控制器结束运行。此时控制器可能仍在处理任务。 - 收尾与返回:各控制器响应停止通知,按自身实现完成清理。按照
Controller接口约定,内部 goroutine 全部结束后,Run()才应返回。 - 等待结果:
RunControllers()等待所有控制器的Run()返回。全部返回时,返回true,表示退出完成;等待超时则返回false,由调用方报告退出超时。
失去领导权时,选主逻辑同样会取消控制器的 context,但随后还会执行 OnStoppedLeading。默认回调通过 FlushAndExit() 结束进程,不等待控制器全部完成收尾,因此上述退出流程可能尚未完成,进程就已经结束。
等待控制器退出
RunControllers() 为每个控制器启动一个 goroutine,并用 WaitGroup 等待它们结束。每个 controller.Run(ctx) 返回后,对应的 goroutine 通过 defer 执行 wg.Done()。计数归零后,wg.Wait() 解除阻塞,负责等待的 goroutine 随后返回并关闭 terminatedCh,通知外层所有控制器均已退出。
正常运行时,RunControllers() 所在的 goroutine 阻塞在第一个 select,各控制器则在各自的 goroutine 中继续处理任务。此时尚未启动退出计时器,第一个 select 等待以下两种情况:
case <-ctx.Done():收到停止请求。这个分支没有return,执行后离开第一个select,继续设置退出计时器,再进入第二个select等待控制器收尾。case <-terminatedCh:所有控制器已经退出,直接return true,结束整个RunControllers()函数,后面的计时器和第二个select都不会执行。
第二个 select 只在第一个 select 选中取消分支后执行。收到停止请求时,控制器可能还在清理内部任务,因此这里继续等待 terminatedCh:通道关闭时返回 true,表示全部退出完成;退出计时器到期时返回 false,表示等待超时。shutdownTimeout 限制的是收到停止请求后的收尾等待时间,正常运行期间不计入其中。
shutdownTimeout 为 0 时,计时通道 shutdownCh 保持为 nil,第二个 select 的超时分支不会触发,函数持续等待控制器全部退出。
func RunControllers(ctx context.Context, controllerCtx ControllerContext, controllers []Controller,
    controllerStartJitterMaxFactor float64, shutdownTimeout time.Duration) bool {
    ...
    terminatedCh := make(chan struct{})
    go func() {
        // 全部控制器返回后,关闭通道,通知外层结束等待。
        defer close(terminatedCh)
        var wg sync.WaitGroup
        wg.Add(len(controllers))
        for _, controller := range controllers {
            go func() {
                // 控制器运行入口返回后,完成当前 goroutine 的计数。
                defer wg.Done()
                ...
                controller.Run(ctx)
            }()
        }
        wg.Wait()
        ...
    }()

    // 正常运行时停在这里等待,各控制器在其他 goroutine 中继续运行。
    select {
    case <-ctx.Done():
        // 收到停止请求;没有 return,继续设置计时器并进入第二个 select。
    case <-terminatedCh:
        // 全部控制器已退出,直接返回,不再执行第二个 select。
        return true
    }

    // 只有上面的取消分支会执行到这里,退出计时从此处开始。
    var shutdownCh <-chan time.Time
    if shutdownTimeout > 0 {
        shutdownCh = time.After(shutdownTimeout)
    }
    // 等待收尾完成或超时;shutdownCh 为 nil 时,超时分支不会触发。
    select {
    case <-terminatedCh:
        // 控制器全部退出,等待完成。
        return true
    case <-shutdownCh:
        ...
        // 等待超时,将失败结果交给调用方。
        return false
    }
}
取消控制器 context
取得领导权后,LeaderElector.Run() 创建子 context,并将它传给 OnStartedLeading,由 KCM 继续传给控制器。renew() 返回后,defer 按注册顺序反向执行:先调用 cancel() 通知控制器停止,再执行前面注册的 OnStoppedLeading 回调。
func (le *LeaderElector) Run(ctx context.Context) {
    ...
    defer le.config.Callbacks.OnStoppedLeading()

    if !le.acquire(ctx) {
        return
    }
    ctx, cancel := context.WithCancel(ctx)
    // 后注册的 defer 先执行:先取消控制器 context,再执行停止回调。
    defer cancel()
    go le.config.Callbacks.OnStartedLeading(ctx)
    // 续约循环结束后,函数返回并执行上面的 defer。
    le.renew(ctx)
}
相关资料
- Controllers
- Deployments
- ReplicaSet
- StatefulSets
- DaemonSet
- Jobs
- CronJob
- Automatic Cleanup for Finished Jobs
- Horizontal Pod Autoscaling
- Disruptions
- Specifying a Disruption Budget for your Application
- Leases
- Taints and Tolerations
- Node
- Persistent Volumes
- Storage Classes
- VolumeAttachment
- Volume Attributes Classes
- Ephemeral Volumes
- Managing Service Accounts
- Using RBAC Authorization
- Authenticating with Bootstrap Tokens
- Certificates and Certificate Signing Requests
- ClusterTrustBundle
- Resource Quotas
- Pod Lifecycle
- Service
- Owners and Dependents
- Garbage Collection
- Finalizers