Kubelet:Pod 运行与节点管理
Scheduler 将 Pod 调度到某个节点并完成绑定后,该节点上的 Kubelet 开始按照 Pod 配置准备运行环境并启动容器。
Kubelet 是运行在每个节点上的代理,负责管理 Pod 的生命周期,确保容器按照 PodSpec 中的定义运行。它协调卷挂载、设备分配和容器启停,持续监测容器运行状态,并向 API Server 上报 Pod 状态和节点状态。
整体架构
模块概览
下图展示了 Kubelet 的整体架构,包括 Pod 管理、节点资源管理和状态上报等主要模块,以及它们与 API Server、容器运行时和节点插件之间的协作关系。
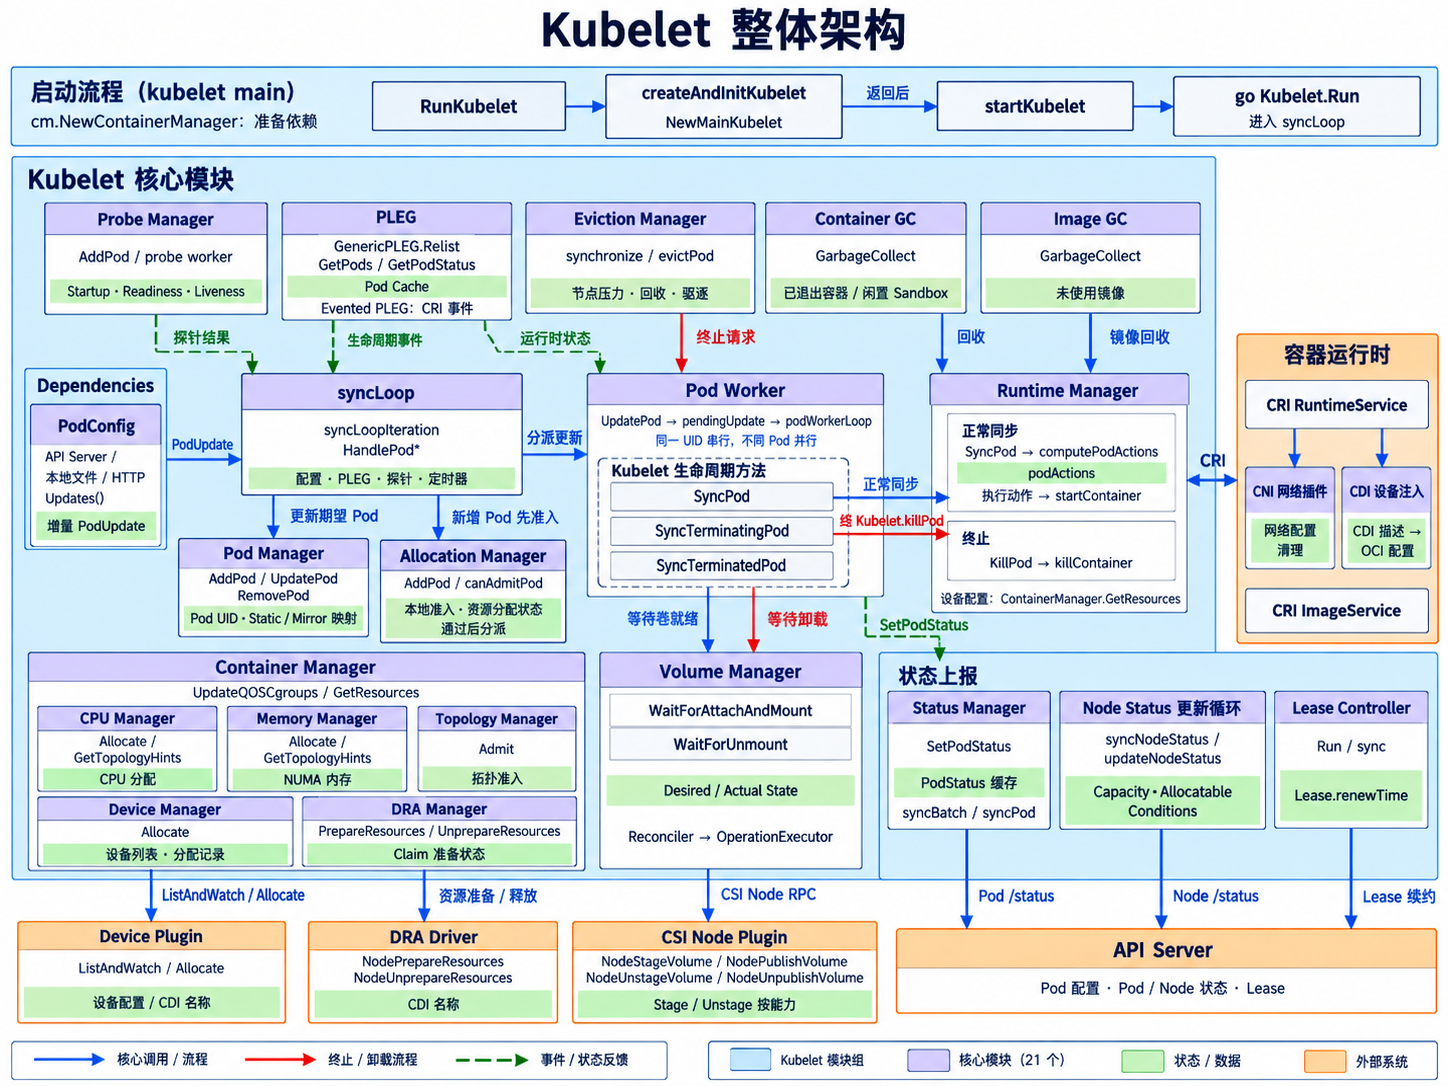
Kubelet 的主要模块及职责如下:
Pod 配置与运行
- PodConfig:合并来自不同配置源(API Server、本地文件和 HTTP)的 Pod 更新,向主循环发送增量变化。
- Pod Manager:保存本节点期望运行的 Pod,维护 UID 和名称索引,供其他模块查询。
- 事件处理:主循环通过
syncLoopIteration接收配置、PLEG、探针、设备和定时通知,调用对应的 Kubelet 方法。 - Allocation Manager:执行 Pod 的本地准入检查,记录已分配的资源,并处理资源原地调整。
- Pod Worker:串行处理同一 Pod 的同步、终止和清理任务,通过 Kubelet 调用 Runtime Manager 完成容器操作。不同 Pod 可以并行处理。
- Runtime Manager:比较 PodSpec 与实际运行状态,确定 Sandbox 和容器需要执行的动作,并通过 CRI 完成创建、启动或停止操作。
节点资源管理
- Volume Manager:维护卷的期望状态与实际挂载状态,通过后台协调完成挂载和卸载,并为 Pod 同步提供等待接口。
- Container Manager:管理节点和 Pod 的 cgroup,组织 CPU、内存、设备、拓扑及动态资源管理。
- CPU Manager:按配置策略分配 CPU,维护共享与独占 CPU 集合,并协调容器的 CPU 绑定。
- Memory Manager:按配置策略记录内存和 HugePages 的 NUMA 分配,并提供内存亲和性建议。
- Device Manager:管理 Device Plugin 提供的设备,为容器分配具体设备,保存设备路径、挂载和环境变量等运行配置。
- Topology Manager:合并 CPU Manager、Memory Manager 和 Device Manager 提供的 NUMA 亲和性建议,按策略决定拓扑准入,并协调后续资源分配。
-
DRA Manager:调用 DRA Node Plugin,为 Pod 引用的 ResourceClaim 准备资源,并在本节点不再有 Pod 使用这些资源时,调用插件完成清理。
-
Eviction Manager:观察节点压力,先回收节点资源,再按条件选择 Pod 驱逐。
- Container GC:清理符合策略的已退出容器和不再使用的 Sandbox。
- Image GC:跟踪镜像使用情况,按磁盘阈值和年龄回收未使用镜像。
Pod 状态监测与上报
- PLEG:检测 Sandbox 和容器的状态变化,更新容器运行时状态缓存(Pod Cache),并通过事件通知
syncLoop同步对应 Pod。 - Probe Manager:为配置了探针的容器运行探测 worker,保存 Startup、Readiness 和 Liveness 结果。
- Status Manager:缓存 Kubelet 计算出的 Pod 状态,并通过后台循环更新 API Server 中 Pod 对象的
status字段。
节点状态与心跳
- Node Status:由 Kubelet 计算节点容量、可分配资源和运行条件,并上报到 API Server 中 Node 对象的
status字段。 - Lease Controller:定期续约节点 Lease,让控制面观察节点是否持续保持联系。
Pod 启动流程
Scheduler 先为 Pod 选定运行节点,并通过 API Server 完成绑定。该节点上已经运行的 Kubelet 随后从 API Server 获取 Pod 配置,协调卷挂载,并调用容器运行时准备网络、创建和启动容器。
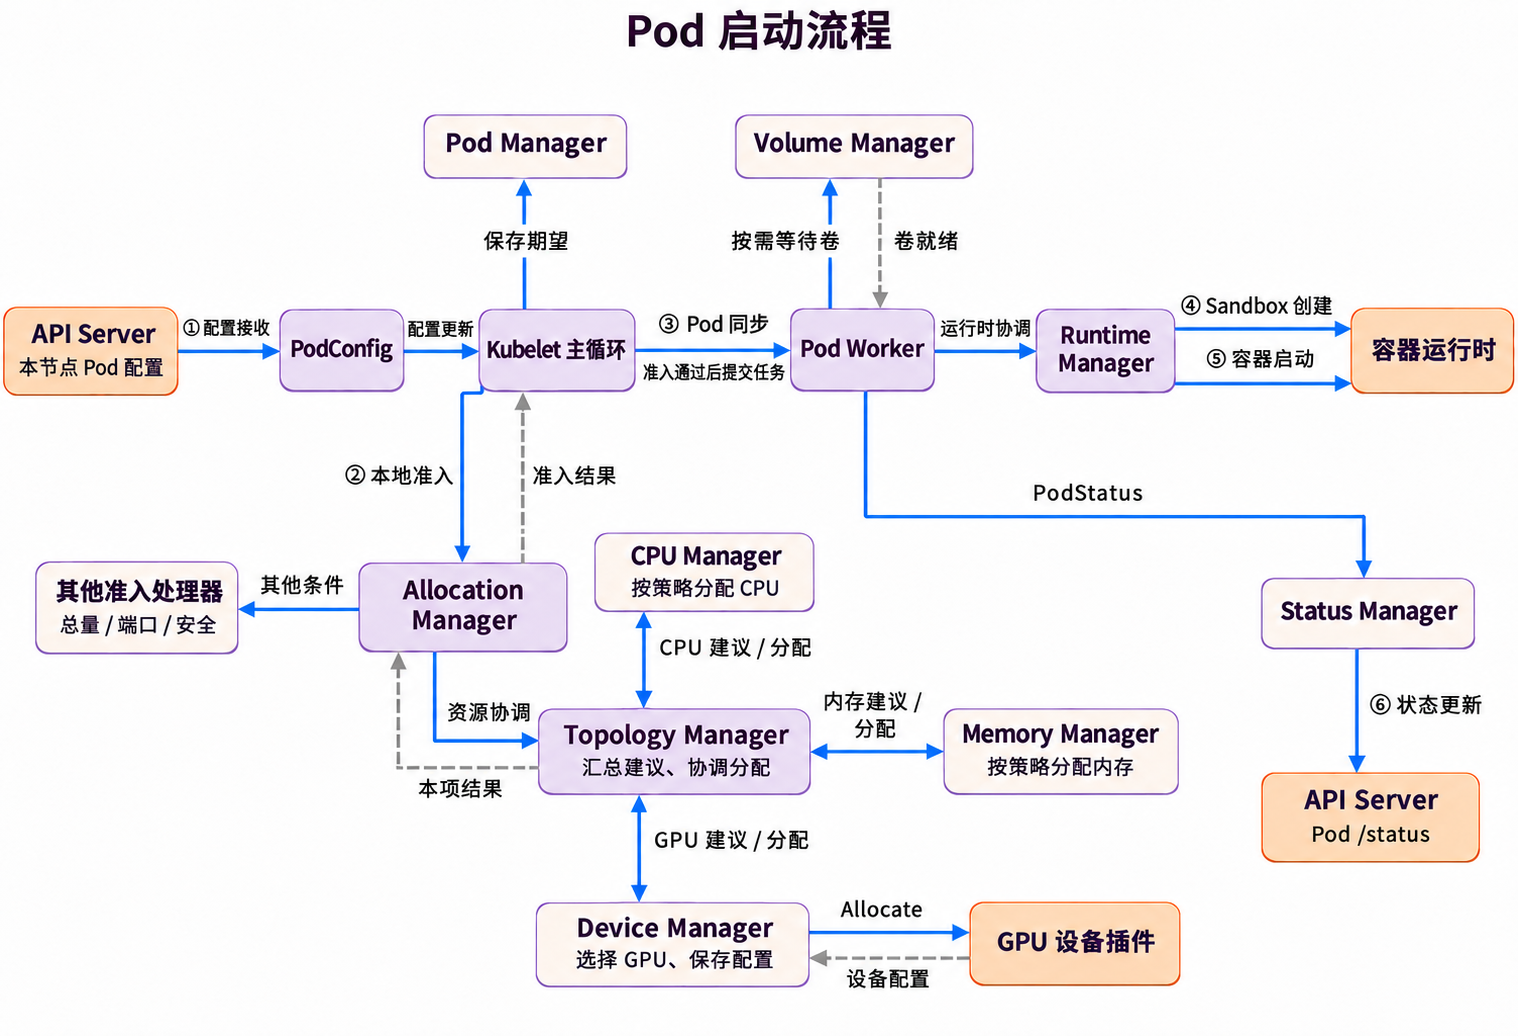
- 配置接收:PodConfig 接收 API Server 分配到本节点的 Pod 配置,交给主循环处理。处理新增 Pod 时,Kubelet 先将它保存到 Pod Manager,作为节点上的期望配置,供本地准入、卷准备和后续事件处理查询。
- 本地准入:Allocation Manager 调用 Kubelet 内部的本地准入处理器,检查本节点的资源余量、端口占用和安全限制等条件。Topology Manager 按节点配置的拓扑策略,协调 CPU、内存和设备的 NUMA 亲和性;申请 GPU 时,Device Manager 选择设备,并调用设备插件取得设备配置。
- Pod 同步:准入通过后,Pod Worker 按 Pod UID 串行处理创建请求,不同 Pod 可以并行处理。同步过程中会准备运行资源、按需等待卷就绪,再由 Runtime Manager 执行 Sandbox 和容器的创建、启动等操作。
- Sandbox 创建:Sandbox 为 Pod 提供网络等共享运行环境。在常见的 Linux 容器运行时中,通常会启动一个 pause 基础容器来维持共享命名空间。Runtime Manager 检查是否已有可用的 Sandbox,需要时通过 CRI 请求容器运行时创建,并按 Pod 配置准备网络。
- 容器启动:Runtime Manager 按需准备镜像,将挂载、设备和环境变量等信息组成容器配置,通过 CRI 创建并启动容器。配置了 Init Container 时,先按执行依赖运行,再启动业务容器。
- 状态更新:PLEG 观察 Sandbox 和容器状态,Probe Manager 按配置执行探针。Status Manager 将计算后的 PodStatus 异步发布到 API Server,运行状态变化也会触发后续 Pod 同步。
源码目录
Kubelet 的主要实现位于 pkg/kubelet/。进程入口、CSI 卷插件和共享接口代码分别位于 cmd/kubelet/、pkg/volume/csi/ 和 staging/src/k8s.io/。
cmd/kubelet/
├── kubelet.go                                 # 进程入口
└── app/server.go                              # 配置、依赖与启动
pkg/kubelet/
├── kubelet.go                                 # Kubelet、Run、syncLoop、SyncPod
├── pod_workers.go                             # Pod Worker:同步、终止与清理
├── kubelet_pods.go                            # Pod 状态计算与节点清理
├── kubelet_node_status.go                     # 节点注册与 Node Status 更新
├── runtime.go                                 # 容器运行时健康状态检查
├── types/pod_update.go                        # PodUpdate 与操作类型
├── apis/config/                               # Kubelet 配置类型与默认值
├── config/                                    # PodConfig:配置源、合并与更新通道
├── pod/                                       # Pod Manager:期望 Pod 与查询索引
├── allocation/                                # 本地准入与资源分配记录
├── lifecycle/                                 # 准入处理器与额外同步条件
├── container/
│   ├── runtime.go                             # 内部容器运行时接口与 PodStatus 类型
│   ├── cache.go                               # 容器运行时 Pod Cache
│   └── container_gc.go                        # Container GC 接口与容器运行时委托
├── kuberuntime/
│   ├── kuberuntime_manager.go                 # 操作计算与容器运行时协调
│   ├── kuberuntime_sandbox.go                 # Sandbox 创建与停止
│   ├── kuberuntime_container.go               # 容器配置、启动与停止
│   └── kuberuntime_gc.go                      # 容器、Sandbox 与日志回收
├── pleg/                                      # PLEG:容器运行时事件与缓存更新
├── prober/                                    # Probe Manager:探针执行与结果缓存
├── status/                                    # Status Manager:缓存与 API 写入
├── volumemanager/                             # Volume Manager:卷挂载与卸载协调
├── cm/
│   ├── container_manager.go                   # ContainerManager 公共接口
│   ├── container_manager_linux.go             # 组件创建与资源管理组织
│   ├── types.go                               # CgroupManager、PodContainerManager 接口
│   ├── cgroup_manager_linux.go                # cgroup 创建、更新与删除
│   ├── qos_container_manager_linux.go         # QoS 层级的 cgroup 管理
│   ├── pod_container_manager_linux.go         # 单个 Pod 的 cgroup 管理
│   ├── internal_container_lifecycle_linux.go  # 容器创建前应用 CPU、内存亲和性
│   ├── cpumanager/                            # CPU Manager
│   ├── memorymanager/                         # Memory Manager
│   ├── devicemanager/                         # Device Manager
│   ├── topologymanager/                       # Topology Manager
│   ├── dra/                                   # DRA Manager
│   └── resourceupdates/updates.go             # 资源状态变化通知
├── cadvisor/                                  # cAdvisor 接入与资源信息采集
├── nodestatus/                                # Node Status 各字段的计算
├── server/                                    # 节点 HTTP 与本地 gRPC 服务
├── pluginmanager/                             # 节点插件发现与注册
├── eviction/                                  # Eviction Manager:节点压力驱逐
└── images/
    ├── image_manager.go                       # 镜像拉取与退避
    └── image_gc_manager.go                    # Image GC:镜像回收
pkg/volume/csi/                                # CSI 卷插件与节点驱动调用
staging/src/k8s.io/
├── client-go/tools/cache/                     # Reflector 与 UndeltaStore
├── component-base/cli/run.go                  # 启动命令执行
├── component-helpers/apimachinery/lease/
│   └── controller.go                          # Lease Controller:节点 Lease 续约
├── cri-api/pkg/apis/runtime/v1/api.proto      # CRI RuntimeService 与 ImageService
├── cri-client/pkg/                            # CRI 容器运行时与镜像客户端
└── kubelet/pkg/apis/                          # Device Plugin、DRA 与本地查询 API
Kubelet 结构体
Kubelet 结构体中,与 Pod 同步、资源管理和状态更新相关的主要字段如下:
type Kubelet struct {
    podManager        kubepod.Manager
    podWorkers        PodWorkers
    podCache          kubecontainer.ROCache
    statusManager     status.Manager
    probeManager      prober.Manager
    volumeManager     volumemanager.VolumeManager
    allocationManager allocation.Manager
    containerManager  cm.ContainerManager
    containerRuntime  kubecontainer.Runtime
    runtimeService    internalapi.RuntimeService
    pleg              pleg.PodLifecycleEventGenerator
    ...
}
podManager:保存期望运行的 Pod,并提供按 UID 和名称查询的接口。podWorkers:按 Pod UID 管理同步、终止和清理任务,同一 Pod 的任务串行执行,不同 Pod 可以并行处理。podCache:缓存 Pod 在容器运行时中的状态,供 Pod Worker 执行同步任务时读取。statusManager:缓存 Pod 的 API 状态,并异步更新 API Server 中的 Pod 状态。probeManager:按 Pod 配置执行 Startup、Readiness 和 Liveness 探针,保存探测结果。volumeManager:维护卷的期望状态与实际挂载状态,协调挂载和卸载。allocationManager:执行 Pod 的本地准入检查,记录已分配的资源,并处理资源原地调整。containerManager:管理节点和 Pod 的 cgroup,协调 CPU、内存、设备、拓扑及动态资源管理。containerRuntime:Kubelet 内部的容器运行时接口,由 Runtime Manager 实现,提供 Pod 同步、容器终止和容器运行时状态查询等操作。runtimeService:CRI RuntimeService 客户端接口,用于向容器运行时发送 Sandbox、容器和运行状态相关的请求。pleg:检测 Sandbox 和容器的状态变化,更新容器运行时 Pod Cache,并通过事件通知syncLoop同步对应 Pod。
Kubelet 启动
Kubelet 启动时先加载配置,再创建管理 Pod、容器和节点资源的组件。随后,它启动卷管理、状态上报等后台任务,并进入主同步循环,持续处理 Pod 的配置变化和运行状态变化。
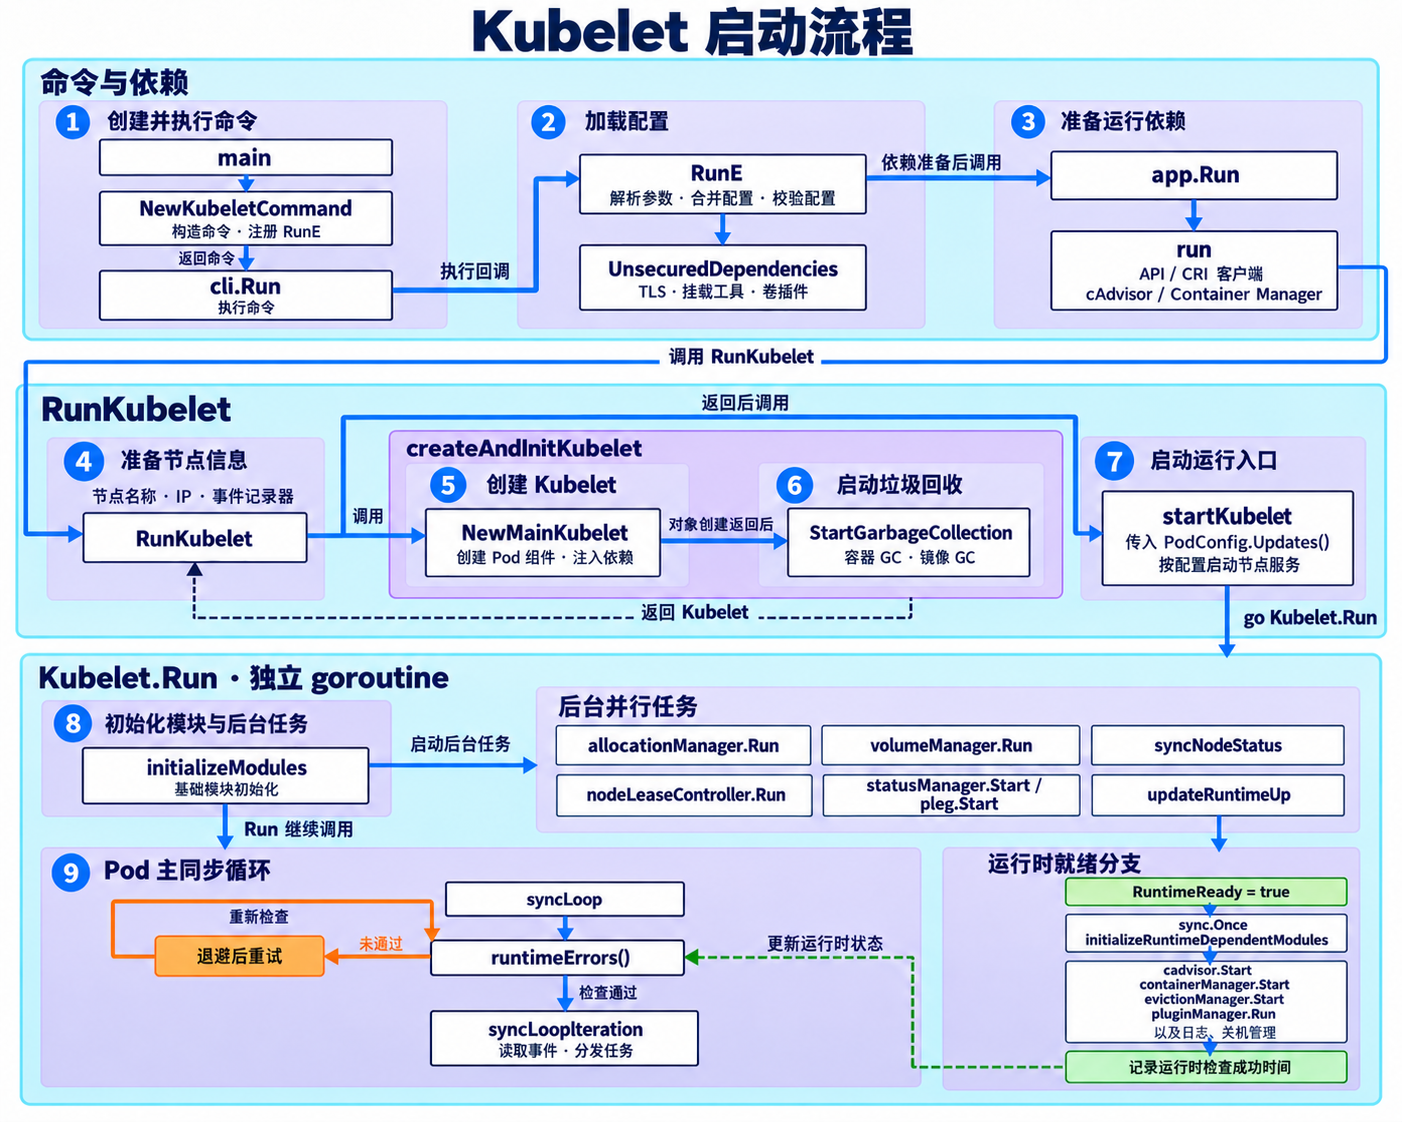
- 命令入口:
main调用NewKubeletCommand创建命令,注册参数和RunE回调。随后由cli.Run执行命令,进入配置加载流程。 - 配置加载:
RunE合并命令行、配置文件和配置目录中的设置,显式命令行参数优先。配置校验通过后,组装KubeletServer,准备 TLS、挂载工具和卷插件等基础依赖。 - 依赖准备:
app.Run调用内部run,补齐 API、CRI 客户端及认证授权,并创建 cAdvisor、Container Manager。这些对象保存在Dependencies中,供后续 Kubelet 创建和运行使用。 - 节点准备:
RunKubelet在创建 Kubelet 前,确定节点名称与 IP,准备事件记录器。 - Kubelet 创建:
NewMainKubelet接入 Pod 配置源,创建 Kubelet 和 Pod Manager、Pod Worker、Runtime Manager 等组件。此前准备的 Container Manager 等对象通过Dependencies传入。 - 垃圾回收:
StartGarbageCollection启动容器回收任务,并按配置启动镜像回收任务。 - 运行入口:
startKubelet将配置更新通道传给Kubelet.Run,在独立 goroutine 中执行,并按配置启动节点服务。 - 后台任务:
Kubelet.Run初始化基础模块,启动资源管理、状态上报、节点心跳、PLEG 和容器运行时状态刷新等后台任务。updateRuntimeUp首次确认容器运行时就绪后,还会启动 cAdvisor、Container Manager 等依赖模块。 - 主循环:
syncLoop在执行Kubelet.Run的同一 goroutine 中运行,与后台任务并行。每轮先检查容器运行时状态和 PLEG 等组件的健康情况,通过后再由syncLoopIteration接收事件并分派处理。
命令入口
Kubelet 进程从 main 开始执行。NewKubeletCommand 创建 Cobra 命令对象,设置默认参数和 RunE 回调;命令构造完成后,cli.Run 执行这个命令,进入回调中的配置加载与运行逻辑。命令结束后,main 将返回码交给 os.Exit:
func main() {
    // 创建命令对象,注册参数与运行回调。
    command := app.NewKubeletCommand(context.Background())
    // 执行命令,正常启动路径进入 RunE 回调。
    code := cli.Run(command)
    os.Exit(code)
}
配置加载
NewKubeletCommand 创建 cleanFlagSet,用于注册和解析 Kubelet 的命令行参数。命令执行时,原始参数 args 传入 RunE 回调。
RunE 按以下顺序处理配置:
- 解析参数:调用
cleanFlagSet.Parse(args),读取命令行参数,包括--config和--config-dir的路径,再用ValidateKubeletFlags校验启动参数对象kubeletFlags。 - 加载主配置:指定
--config时,调用loadConfigFile读取文件,将返回的配置对象赋给kubeletConfig。 - 合并目录配置:指定
--config-dir时,调用mergeKubeletConfigurations,将目录中的补充配置合并到当前kubeletConfig。 - 应用命令行优先级:加载了文件或目录配置时,调用
kubeletConfigFlagPrecedence重新解析原始命令行,将显式参数应用到最终配置对象。 - 校验并组装配置:调用
ValidateKubeletConfiguration校验合并后的kubeletConfig,再将它与kubeletFlags一起放入KubeletServer。 - 准备基础依赖:调用
UnsecuredDependencies,创建并返回kubeletDeps,其中包含 TLS、挂载工具和卷插件等基础依赖。 - 进入运行流程:调用
app.Run,传入kubeletServer和kubeletDeps,继续准备运行依赖并启动 Kubelet。
func NewKubeletCommand(ctx context.Context) *cobra.Command {
    cleanFlagSet := pflag.NewFlagSet(server.ComponentKubelet, pflag.ContinueOnError)
    ...
    kubeletFlags := options.NewKubeletFlags()
    kubeletConfig, err := options.NewKubeletConfiguration()
    ...
    cmd := &cobra.Command{
        Use:                server.ComponentKubelet,
        DisableFlagParsing: true,
        ...
        RunE: func(cmd *cobra.Command, args []string) error {
            // 首次解析,取得启动参数及配置文件、配置目录的位置。
            if err := cleanFlagSet.Parse(args); err != nil {
                ...
            }
            ...
            // 校验 Kubelet 启动参数是否合法。
            if err := options.ValidateKubeletFlags(kubeletFlags); err != nil {
                ...
            }
            if len(kubeletFlags.KubeletConfigFile) > 0 {
                // 使用 --config 指定的文件加载 Kubelet 配置。
                kubeletConfig, err = loadConfigFile(ctx, kubeletFlags.KubeletConfigFile)
                ...
            }
            var skippedDropinFiles []string
            if len(kubeletFlags.KubeletDropinConfigDirectory) > 0 {
                // 将 --config-dir 中的补充配置合并到当前配置。
                skippedDropinFiles, err = mergeKubeletConfigurations(kubeletConfig, kubeletFlags.KubeletDropinConfigDirectory)
                ...
            }
            if len(kubeletFlags.KubeletConfigFile) > 0 || len(kubeletFlags.KubeletDropinConfigDirectory) > 0 {
                // 重放命令行参数,确保显式参数优先于文件配置。
                if err := kubeletConfigFlagPrecedence(kubeletConfig, args); err != nil {
                    ...
                }
                ...
            }
            ...
            // 对命令行和文件合并后的配置进行最终校验。
            if err := kubeletconfigvalidation.ValidateKubeletConfiguration(kubeletConfig, utilfeature.DefaultFeatureGate); err != nil {
                ...
            }
            kubeletServer := &options.KubeletServer{
                KubeletFlags:         *kubeletFlags,
                KubeletConfiguration: *kubeletConfig,
            }
            // 使用最终配置准备基础依赖。
            kubeletDeps, err := UnsecuredDependencies(ctx, kubeletServer, utilfeature.DefaultFeatureGate)
            ...
            ctx := genericapiserver.SetupSignalContext()
            ...
            // 将最终配置与基础依赖交给运行入口。
            return Run(ctx, kubeletServer, kubeletDeps, utilfeature.DefaultFeatureGate)
        },
    }
    // 注册参数,供命令执行时的 RunE 解析。
    kubeletFlags.AddFlags(cleanFlagSet)
    options.AddKubeletConfigFlags(cleanFlagSet, kubeletConfig)
    ...
    return cmd
}
UnsecuredDependencies 主要准备以下依赖,统一放入 Dependencies:
Mounter:执行卷挂载、卸载等操作,供后续卷管理使用。Subpather:处理subPath挂载,让容器可以只挂载卷中的某个文件或子目录。VolumePlugins:收集 Kubelet 内置的卷类型处理代码,例如 emptyDir、Secret、ConfigMap 和 CSI 插件。其中,CSI 插件负责对接外部 CSI 驱动。TLSOptions:准备 Kubelet HTTPS 服务使用的证书与 TLS 配置。
API 客户端、认证授权、cAdvisor 和 Container Manager 的准备过程在依赖准备中介绍。
func UnsecuredDependencies(ctx context.Context, s *options.KubeletServer, featureGate featuregate.FeatureGate) (*kubelet.Dependencies, error) {
    // 从启动参数与 Kubelet 配置准备 TLS 选项。
    tlsOptions, err := InitializeTLS(ctx, &s.KubeletFlags, &s.KubeletConfiguration)
    ...
    mounter := mount.New(s.ExperimentalMounterPath)
    subpather := subpath.New(mounter)
    ...
    // 收集 Kubelet 内置的卷插件。
    plugins, err := ProbeVolumePlugins(ctx, featureGate)
    ...
    return &kubelet.Dependencies{
        ...
        Mounter:       mounter,
        Subpather:     subpather,
        VolumePlugins: plugins,
        TLSOptions:    tlsOptions,
    }, nil
}
依赖准备
KubeletServer 保存最终配置,Dependencies 已包含 TLS、挂载工具和卷插件等基础依赖。app.Run 完成操作系统初始化,再调用内部 run 准备运行依赖:
func Run(ctx context.Context, s *options.KubeletServer, kubeDeps *kubelet.Dependencies, featureGate featuregate.FeatureGate) error {
    // 完成操作系统相关初始化。
    if err := initForOS(ctx, s.WindowsService, s.WindowsPriorityClass); err != nil {
        ...
    }
    // 继续准备运行依赖并启动 Kubelet。
    if err := run(ctx, s, kubeDeps, featureGate); err != nil {
        ...
    }
    return nil
}
run 在 kubeDeps 中补齐以下依赖:
- API 客户端:根据 kubeconfig 创建普通、事件和心跳客户端,分别用于对象操作、事件记录和节点心跳。它们访问同一 API Server 入口,事件客户端使用独立的限流参数,心跳客户端关闭本地 QPS 限流并设置专用超时。
- 认证授权:创建
Auth,用于认证和授权访问 Kubelet 节点服务的请求。 - CRI 客户端:连接容器运行时,通过 RuntimeService 和 ImageService 操作 Sandbox、容器和镜像。
- cAdvisor:创建资源信息采集组件,提供节点机器信息及 CPU、内存、文件系统等资源统计,供节点资源计算使用。
- Container Manager:创建资源管理对象,供 Kubelet 管理 cgroup、CPU、内存和设备资源。
RunKubelet 接收 kubeDeps 后,通过 createAndInitKubelet 调用 NewMainKubelet。NewMainKubelet 将 cAdvisor、Container Manager 等依赖接入 Kubelet 实例,供资源统计和管理使用;具体字段赋值见 Kubelet 创建。
func run(ctx context.Context, s *options.KubeletServer, kubeDeps *kubelet.Dependencies, featureGate featuregate.FeatureGate) (err error) {
    ...
    standaloneMode := true
    if len(s.KubeConfig) > 0 {
        standaloneMode = false
    }
    ...
    hostName, err := nodeutil.GetHostname(s.HostnameOverride)
    ...
    nodeName := types.NodeName(hostName)
    switch {
    case standaloneMode:
        ...
    case kubeDeps.KubeClient == nil, kubeDeps.EventClient == nil, kubeDeps.HeartbeatClient == nil:
        // 根据 kubeconfig 准备访问 API Server 的客户端配置。
        clientConfig, onHeartbeatFailure, err := buildKubeletClientConfig(ctx, s, kubeDeps.TracerProvider, nodeName)
        ...
        // 创建普通客户端,用于读取和更新 API 对象。
        kubeDeps.KubeClient, err = clientset.NewForConfig(clientConfig)
        ...
        eventClientConfig := *clientConfig
        // 为事件请求设置独立的速率和突发上限。
        eventClientConfig.QPS = float32(s.EventRecordQPS)
        eventClientConfig.Burst = int(s.EventBurst)
        // 创建事件客户端,用于向 API Server 记录 Kubernetes Event。
        kubeDeps.EventClient, err = v1core.NewForConfig(&eventClientConfig)
        ...
        heartbeatClientConfig := *clientConfig
        // 请求超时取节点状态更新周期与 Lease 时长中的较小值。
        heartbeatClientConfig.Timeout = s.KubeletConfiguration.NodeStatusUpdateFrequency.Duration
        leaseTimeout := time.Duration(s.KubeletConfiguration.NodeLeaseDurationSeconds) * time.Second
        if heartbeatClientConfig.Timeout > leaseTimeout {
            heartbeatClientConfig.Timeout = leaseTimeout
        }
        // 关闭心跳客户端的本地 QPS 限流。
        heartbeatClientConfig.QPS = float32(-1)
        // 创建心跳客户端,用于节点状态上报和 Lease 续约。
        kubeDeps.HeartbeatClient, err = clientset.NewForConfig(&heartbeatClientConfig)
        ...
    }
    if kubeDeps.Auth == nil {
        // 准备 Kubelet 节点服务使用的认证与授权组件。
        auth, runAuthenticatorCAReload, err := BuildAuth(nodeName, kubeDeps.KubeClient, s.KubeletConfiguration)
        ...
        kubeDeps.Auth = auth
        runAuthenticatorCAReload(ctx.Done())
    }
    // 创建容器运行时和镜像服务的 CRI 客户端。
    if err := kubelet.PreInitRuntimeService(ctx, &s.KubeletConfiguration, kubeDeps); err != nil {
        ...
    }
    // 通过 CRI 查询容器运行时的 cgroup driver 设置。
    if err := getCgroupDriverFromCRI(ctx, s, kubeDeps); err != nil {
        ...
    }
    ...
    if kubeDeps.CAdvisorInterface == nil {
        imageFsInfoProvider := cadvisor.NewImageFsInfoProvider(s.ContainerRuntimeEndpoint)
        // 创建提供机器信息和资源统计的 cAdvisor 实例。
        kubeDeps.CAdvisorInterface, err = cadvisor.New(klog.FromContext(ctx), imageFsInfoProvider, s.RootDirectory, ...)
        ...
    }
    makeEventRecorder(ctx, kubeDeps, nodeName)
    if kubeDeps.ContainerManager == nil {
        ...
        // 使用已准备的挂载工具和 cAdvisor 构造 Container Manager。
        kubeDeps.ContainerManager, err = cm.NewContainerManager(
            ctx, kubeDeps.Mounter, kubeDeps.CAdvisorInterface,
            cm.NodeConfig{NodeName: nodeName, ...},
            s.FailSwapOn, kubeDeps.Recorder, kubeDeps.KubeClient,
        )
        ...
    }
    // 将配置和依赖交给 RunKubelet,继续创建 Kubelet 实例。
    if err := RunKubelet(ctx, s, kubeDeps); err != nil {
        ...
    }
    ...
}
PreInitRuntimeService 创建 RuntimeService 和 ImageService 客户端,分别保存到 RemoteRuntimeService 和 RemoteImageService。镜像服务地址未单独配置时,使用容器运行时地址:
func PreInitRuntimeService(ctx context.Context, kubeCfg *kubeletconfiginternal.KubeletConfiguration, kubeDeps *Dependencies) error {
    remoteImageEndpoint := kubeCfg.ImageServiceEndpoint
    if remoteImageEndpoint == "" && kubeCfg.ContainerRuntimeEndpoint != "" {
        remoteImageEndpoint = kubeCfg.ContainerRuntimeEndpoint
    }
    var err error
    ...
    // 连接配置中的容器运行时地址。
    if kubeDeps.RemoteRuntimeService, err = remote.NewRemoteRuntimeService(ctx, kubeCfg.ContainerRuntimeEndpoint, ...); err != nil {
        ...
    }
    // 使用选定的镜像服务地址创建客户端。
    if kubeDeps.RemoteImageService, err = remote.NewRemoteImageService(ctx, remoteImageEndpoint, ...); err != nil {
        ...
    }
    ...
    return nil
}
节点准备
RunKubelet 先取得主机名并转换为 nodeName,用它准备事件记录器,再解析 --node-ip 得到 nodeIPs。随后调用 createAndInitKubelet 创建对象并启动垃圾回收,再将 Kubelet 实例和 PodConfig 传给 startKubelet,由后者启动 Kubelet.Run 和节点服务。
func RunKubelet(ctx context.Context, kubeServer *options.KubeletServer, kubeDeps *kubelet.Dependencies) error {
    ...
    // 确定节点名称,供后续注册和对象创建使用。
    hostname, err := nodeutil.GetHostname(kubeServer.HostnameOverride)
    if err != nil {
        return err
    }
    nodeName := types.NodeName(hostname)
    makeEventRecorder(ctx, kubeDeps, nodeName)

    // 解析节点 IP。
    nodeIPs, invalidNodeIps, err := nodeutil.ParseNodeIPArgument(kubeServer.NodeIP, kubeServer.CloudProvider)
    if err != nil {
        ...
    }
    ...

    // 创建 Kubelet,并启动垃圾回收任务。
    k, err := createAndInitKubelet(
        ctx, kubeServer, kubeDeps,
        hostname, nodeName, nodeIPs,
    )
    if err != nil {
        return fmt.Errorf("failed to create kubelet: %w", err)
    }

    // 确认已具备 Pod 配置源,供运行入口使用。
    if kubeDeps.PodConfig == nil {
        return fmt.Errorf("failed to create kubelet, pod source config was nil")
    }
    podCfg := kubeDeps.PodConfig
    ...

    // 启动 Kubelet.Run 与节点服务。
    startKubelet(
        ctx, k, podCfg,
        &kubeServer.KubeletConfiguration,
        kubeDeps, kubeServer.EnableServer,
    )
    ...
    return nil
}
Kubelet 创建
createAndInitKubelet 使用配置、依赖和节点信息创建 Kubelet,随后记录启动事件并启动垃圾回收。NewMainKubelet 返回具体的 *Kubelet 对象,createAndInitKubelet 以 kubelet.Bootstrap 接口类型将它交回启动流程。
Bootstrap 接口
Bootstrap 是启动代码调用 Kubelet 的接口,包含记录启动事件、启动垃圾回收、运行 Kubelet 和启动节点服务等方法:
type Bootstrap interface {
    ...
    // 记录 Kubelet 启动事件。
    BirthCry()
    // 启动容器与镜像垃圾回收任务。
    StartGarbageCollection(ctx context.Context)
    // 节点主服务。
    ListenAndServe(ctx context.Context, ...)
    // 只读 HTTP 服务。
    ListenAndServeReadOnly(ctx context.Context, ...)
    // 本地资源分配查询服务。
    ListenAndServePodResources(ctx context.Context)
    // 本地 Pod 查询与变化订阅服务。
    ListenAndServePods(ctx context.Context)
    // 启动后台任务并进入主同步循环。
    Run(ctx context.Context, updates <-chan kubetypes.PodUpdate)
}
ListenAndServe:默认启用,由enableServer配置控制。启动 Kubelet 主服务,使用配置的 TLS 和认证授权机制,提供日志、容器调试和资源统计等接口。例如,执行kubectl logs或kubectl exec时,请求经过 API Server 转发到节点上的这个服务。ListenAndServeReadOnly:提供独立的只读 HTTP 接口,用于查询节点和 Pod 的 CPU、内存等资源统计,不执行认证授权检查。默认关闭。ListenAndServePodResources:默认启用。启动本地 gRPC 资源查询服务,提供容器已分配的独占 CPU、内存及设备信息。例如,DCGM Exporter 通过它查询 GPU 与 Pod、容器的分配关系,为 GPU 指标补充对应信息。ListenAndServePods:默认关闭,开启PodsAPI功能开关后启用。启动本地 gRPC Pod 信息服务,支持查询本机 Pod 对象和状态、订阅 Pod 变化。接入WatchPods的节点组件可以持续接收 Pod 新增、更新和删除事件,维护本机 Pod 信息缓存。
构造参数
createAndInitKubelet 将最终运行配置、已创建的依赖和节点信息传给 NewMainKubelet:
ctx:初始化调用的上下文,供日志和下游组件调用使用。kubeCfg:调用时传入&kubeServer.KubeletConfiguration,包含同步周期、DNS 和资源管理设置等最终配置。kubeDeps:已经创建的 API、CRI 客户端,以及 cAdvisor、Container Manager 等组件,准备过程见依赖准备。hostname:Kubelet 使用的主机名,保存在实例中,参与节点地址生成。nodeName:Kubernetes 中 Node 对象的名称,用于查询本节点对象,以及筛选分配到本节点的 Pod。nodeIPs:解析--node-ip得到的节点地址列表,用于节点地址上报和 Pod DNS 配置,来源见节点准备。
func createAndInitKubelet(
    ctx context.Context,
    kubeServer *options.KubeletServer,
    kubeDeps *kubelet.Dependencies,
    hostname string,
    nodeName types.NodeName,
    nodeIPs []net.IP,
) (k kubelet.Bootstrap, err error) {
    // 将最终配置、已创建依赖和节点信息传给构造函数。
    k, err = kubelet.NewMainKubelet(
        ctx,
        &kubeServer.KubeletConfiguration,
        kubeDeps,
        &kubeServer.ContainerRuntimeOptions,
        hostname,
        nodeName,
        nodeIPs,
        ...
    )
    if err != nil {
        return nil, err
    }
    // 通过 Bootstrap 接口记录启动事件。
    k.BirthCry()
    // 启动垃圾回收,再将同一个 Kubelet 对象交回调用方。
    k.StartGarbageCollection(ctx)
    return k, nil
}
NewMainKubelet 在尚未提供 PodConfig 时,调用 makePodSourceConfig 创建它并接入配置来源,具体过程在 PodConfig 中展开。随后用配置、节点信息和已创建的依赖初始化 Kubelet 结构体,例如同步周期、节点名称与 IP,以及 cAdvisor、Container Manager 等组件。cAdvisor 创建时已准备好机器信息,构造 Kubelet 时即可读取并缓存:
func NewMainKubelet(
    ctx context.Context,
    kubeCfg *kubeletconfiginternal.KubeletConfiguration,
    kubeDeps *Dependencies,
    ...
    hostname string,
    nodeName types.NodeName,
    nodeIPs []net.IP,
    ...
) (*Kubelet, error) {
    ...
    // 尚未提供 PodConfig 时,创建对象并接入配置来源。
    if kubeDeps.PodConfig == nil {
        var err error
        // 创建 PodConfig,并按配置接入 API Server、本地文件和 HTTP 来源。
        kubeDeps.PodConfig, err = makePodSourceConfig(ctx, kubeCfg, kubeDeps, nodeName, nodeHasSynced)
        if err != nil {
            return nil, err
        }
    }
    ...
    klet := &Kubelet{
        // 保存主机名与 Node 对象名称。
        hostname: hostname,
        nodeName: nodeName,
        ...
        // 同步周期来自最终配置。
        resyncInterval: kubeCfg.SyncFrequency.Duration,
        ...
        // 接入已经创建的 cAdvisor 实例。
        cadvisor: kubeDeps.CAdvisorInterface,
        ...
        // 接入资源管理对象,并保存节点 IP。
        containerManager: kubeDeps.ContainerManager,
        nodeIPs: nodeIPs,
        ...
    }
    // 读取并缓存机器信息,供资源统计和节点状态生成使用。
    machineInfo, err := klet.cadvisor.MachineInfo()
    if err != nil {
        return nil, err
    }
    ...
    klet.setCachedMachineInfo(machineInfo)
    ...
    return klet, nil
}
垃圾回收
createAndInitKubelet 创建 Kubelet 后,调用 StartGarbageCollection 启动容器和镜像的周期回收任务。这个调用返回后,createAndInitKubelet 将 Kubelet 交回 RunKubelet,后者再调用 startKubelet 进入运行阶段。后台任务启动后独立执行,启动函数返回时,首轮垃圾回收可能尚未完成。
容器回收循环始终启动。是否启动周期镜像回收任务,由两个配置项决定:
ImageGCHighThresholdPercent:按磁盘使用率回收镜像的高阈值。例如,设为85表示镜像文件系统使用率达到85%时触发空间回收。ImageMaximumGCAge:镜像允许连续未使用的最长时间。代码通过.Duration读取这个时长,0表示关闭按未使用时长回收。
只有高阈值配置为 100,且最大未使用时长配置为 0 时,StartGarbageCollection 才提前返回,跳过镜像回收循环的启动。默认配置为 85 和 0,周期任务仍会启动,并按磁盘使用率决定是否回收镜像。
容器回收与镜像回收的间隔常量分别为 1 分钟和 5 分钟:
func (kl *Kubelet) StartGarbageCollection(ctx context.Context) {
    ...
    // 启动容器回收循环。
    go wait.Until(func() {
        if err := kl.containerGC.GarbageCollect(ctx); err != nil {
            ...
        }
        ...
    }, ContainerGCPeriod, wait.NeverStop)

    // 高阈值设为 100%,且关闭按未使用时长回收时,不启动周期镜像回收。
    if kl.kubeletConfiguration.ImageGCHighThresholdPercent == 100 && kl.kubeletConfiguration.ImageMaximumGCAge.Duration == 0 {
        ...
        // 容器回收已启动,直接返回以跳过后面的镜像回收循环。
        return
    }
    ...
    beganGC := time.Now()
    // 镜像回收使用独立的周期循环。
    go wait.Until(func() {
        if err := kl.imageManager.GarbageCollect(ctx, beganGC); err != nil {
            ...
        }
        ...
    }, ImageGCPeriod, wait.NeverStop)
}
具体的容器保留、Sandbox 清理和镜像候选策略分别由 Container GC 与 Image GC 介绍。
运行入口
startKubelet 通过 Bootstrap 接口调用前面创建的 Kubelet,分别发起执行循环与节点服务:
- 执行循环:PodConfig 将 API Server 中的 Pod 更新,以及本地文件和 HTTP 配置源中的 Static Pod 更新,整理为
PodUpdate消息输出。k.Run接收podCfg.Updates()提供的更新通道,启动后台任务,再进入主循环处理配置更新及其他事件。 - 节点主服务:
enableServer为true时调用ListenAndServe,kubeCfg提供监听地址与端口,kubeDeps提供 TLS、认证授权和追踪配置。 - 只读服务:
ReadOnlyPort大于零时调用ListenAndServeReadOnly,监听配置的地址与只读端口;端口设为0时关闭这个入口。 - 资源查询服务:调用
ListenAndServePodResources,由方法内部检查KubeletPodResourcesGet开关,再创建本地端点并提供服务。 - Pod 查询服务:调用
ListenAndServePods,由方法内部检查PodsAPI开关,开启后才提供服务;该开关默认关闭。
podCfg.Updates() 返回配置更新通道的接收端,其创建过程见配置通道。五个启动方法分别通过 go 调用,在各自 goroutine 中执行:
func startKubelet(
    ctx context.Context,
    k kubelet.Bootstrap,
    podCfg *config.PodConfig,
    kubeCfg *kubeletconfiginternal.KubeletConfiguration,
    kubeDeps *kubelet.Dependencies,
    enableServer bool,
) {
    // 启动 Kubelet 后台任务与主循环,传入 Pod 配置更新通道。
    go k.Run(ctx, podCfg.Updates())

    // 按开关启动节点主服务,传入监听配置、TLS 与认证授权对象。
    if enableServer {
        go k.ListenAndServe(ctx, kubeCfg, kubeDeps.TLSConfig, kubeDeps.Auth, kubeDeps.TracerProvider)
    }
    // 只读端口大于零时,启动只读 HTTP 服务。
    if kubeCfg.ReadOnlyPort > 0 {
        go k.ListenAndServeReadOnly(ctx, netutils.ParseIPSloppy(kubeCfg.Address), uint(kubeCfg.ReadOnlyPort), kubeDeps.TracerProvider)
    }

    // 调用本地资源查询服务的启动方法。
    go k.ListenAndServePodResources(ctx)
    // 调用本地 Pod 查询与变化订阅服务的启动方法。
    go k.ListenAndServePods(ctx)
}
后台任务
Kubelet.Run 是 Kubelet 实例的运行方法,由 startKubelet 中的 go k.Run(ctx, podCfg.Updates()) 启动。
- 模块初始化:
initializeModules准备数据目录、注册指标,并启动资源统计等基础组件。初始化失败时退出进程。 - 资源调整:
allocationManager.Run启动 Allocation Manager 的后台重试任务,周期检查暂时无法获准的 Pod 资源调整请求,并重新尝试分配。 - 卷管理:
volumeManager.Run启动 Volume Manager 的期望卷状态维护和挂载协调任务,根据 Pod 的卷需求与节点上的实际状态,处理挂载和卸载。 - 节点状态与心跳:已配置 API 客户端时,启动 Node Status 上报和 Lease 续约。
fastStatusUpdateOnce还负责启动初期的一次性快速状态更新。 - 容器运行时检查:后台周期调用
updateRuntimeUp,通过 CRI 查询 containerd、CRI-O 等容器运行时服务是否就绪。确认就绪后记录成功检查时间,供主循环判断能否继续处理事件。 - Pod 状态发布:
statusManager.Start在具备 API 客户端时启动后台同步任务,把 Status Manager 缓存的 Pod 状态发布到 API Server。 - 生命周期事件:
pleg.Start启动 Sandbox 和容器状态采集,更新 Pod Cache 并产生生命周期事件。 - 主循环:在当前 goroutine 中调用
syncLoop,持续接收并处理配置更新及其他事件。updates提供配置更新通道,kl提供事件处理方法。
func (kl *Kubelet) Run(ctx context.Context, updates <-chan kubetypes.PodUpdate) {
    ...
    // 初始化基础模块,失败时退出进程。
    if err := kl.initializeModules(ctx); err != nil {
        ...
        os.Exit(1)
    }
    ...
    if kl.allocationManager != nil {
        // 启动待处理资源调整请求的周期重试。
        kl.allocationManager.Run(ctx)
    }
    // 启动卷状态维护与挂载、卸载协调任务。
    go kl.volumeManager.Run(ctx, kl.sourcesReady)

    if kl.kubeClient != nil {
        go func() {
            // 本协程首次计算节点状态前,先刷新容器运行时状态。
            kl.updateRuntimeUp(ctx)
            // 周期计算并上报 Node 状态。
            wait.JitterUntil(func() { kl.syncNodeStatus(ctx) }, kl.nodeStatusUpdateFrequency, 0.04, true, wait.NeverStop)
        }()
        // 执行启动初期的一次性快速状态更新。
        go kl.fastStatusUpdateOnce()
        // 启动节点 Lease 续约。
        go kl.nodeLeaseController.Run(context.Background())
        ...
    }
    // 独立刷新容器运行时状态,间隔参数为 5 秒。
    go wait.UntilWithContext(ctx, kl.updateRuntimeUp, 5*time.Second)
    ...
    // 启动 Pod 状态发布任务。
    kl.statusManager.Start(ctx)
    ...
    // 启动容器运行时状态采集和生命周期事件通知。
    kl.pleg.Start()
    if utilfeature.DefaultFeatureGate.Enabled(features.EventedPLEG) {
        // 启动 CRI 容器事件流处理。
        kl.eventedPleg.Start()
    }
    ...
    // 在当前协程进入主循环。
    kl.syncLoop(ctx, updates, kl)
}
allocationManager.Run、statusManager.Start 和 pleg.Start 在各自方法内部启动 goroutine 后返回,后台工作与后续的主循环并行运行。
首次确认容器运行时就绪后,updateRuntimeUp 调用 initializeRuntimeDependentModules,启动 cAdvisor、Container Manager、Eviction Manager 和插件监听等依赖模块,再记录成功刷新的时间。
func (kl *Kubelet) updateRuntimeUp(ctx context.Context) {
    ...
    s, err := kl.containerRuntime.Status(ctx)
    if err != nil {
        ...
        return
    }
    if s == nil {
        ...
        return
    }
    ...
    runtimeReady := s.GetRuntimeCondition(kubecontainer.RuntimeReady)
    if runtimeReady == nil || !runtimeReady.Status {
        ...
        return
    }
    ...
    // 首次确认容器运行时就绪后,初始化依赖容器运行时的模块。
    kl.oneTimeInitializer.Do(func() {
        kl.initializeRuntimeDependentModules(ctx)
    })
    // 每次成功刷新都更新时间,供主循环检查。
    kl.runtimeState.setRuntimeSync(kl.clock.Now())
}
oneTimeInitializer.Do 保证依赖模块只初始化一次。updateRuntimeUp 每次检查成功后,都会调用 setRuntimeSync 记录当前时间,供主循环判断距离上次成功检查是否超过允许间隔。
主循环
syncLoop 创建同步检查与节点清理定时器,并取得 PLEG 事件通道。syncTicker 每秒触发一次待同步任务检查。housekeepingTicker 每两秒发出信号,由 Kubelet 检查节点上的 Pod,并清理残留资源。plegCh 接收容器运行时生命周期事件。
外层 for 持续执行运行检查与事件处理。每轮先调用 runtimeErrors,检查本地容器运行时状态记录和 PLEG 等组件的健康情况;返回错误时等待后重试,返回 nil 时才调用 syncLoopIteration,等待一个就绪事件,再调用对应的 Kubelet 方法处理。具体的事件接收与分派过程见事件处理。
func (kl *Kubelet) syncLoop(ctx context.Context, updates <-chan kubetypes.PodUpdate, handler SyncHandler) {
    ...
    // 创建待同步任务和节点清理的定时通道。
    syncTicker := time.NewTicker(time.Second)
    defer syncTicker.Stop()
    housekeepingTicker := time.NewTicker(housekeepingPeriod)
    defer housekeepingTicker.Stop()
    plegCh := kl.pleg.Watch()
    const (
        base   = 100 * time.Millisecond
        max    = 5 * time.Second
        factor = 2
    )
    duration := base
    ...
    for {
        // 每轮先检查运行条件,失败时退避重试。
        if err := kl.runtimeState.runtimeErrors(); err != nil {
            ...
            time.Sleep(duration)
            duration = time.Duration(math.Min(float64(max), factor*float64(duration)))
            continue
        }
        duration = base
        ...
        // 调用一轮事件接收与处理。
        if !kl.syncLoopIteration(ctx, updates, handler, syncTicker.C, housekeepingTicker.C, plegCh) {
            break
        }
        ...
    }
}
Pod 配置与运行
下图展示了 Pod 从配置接收到运行、终止和清理的主要调用关系:
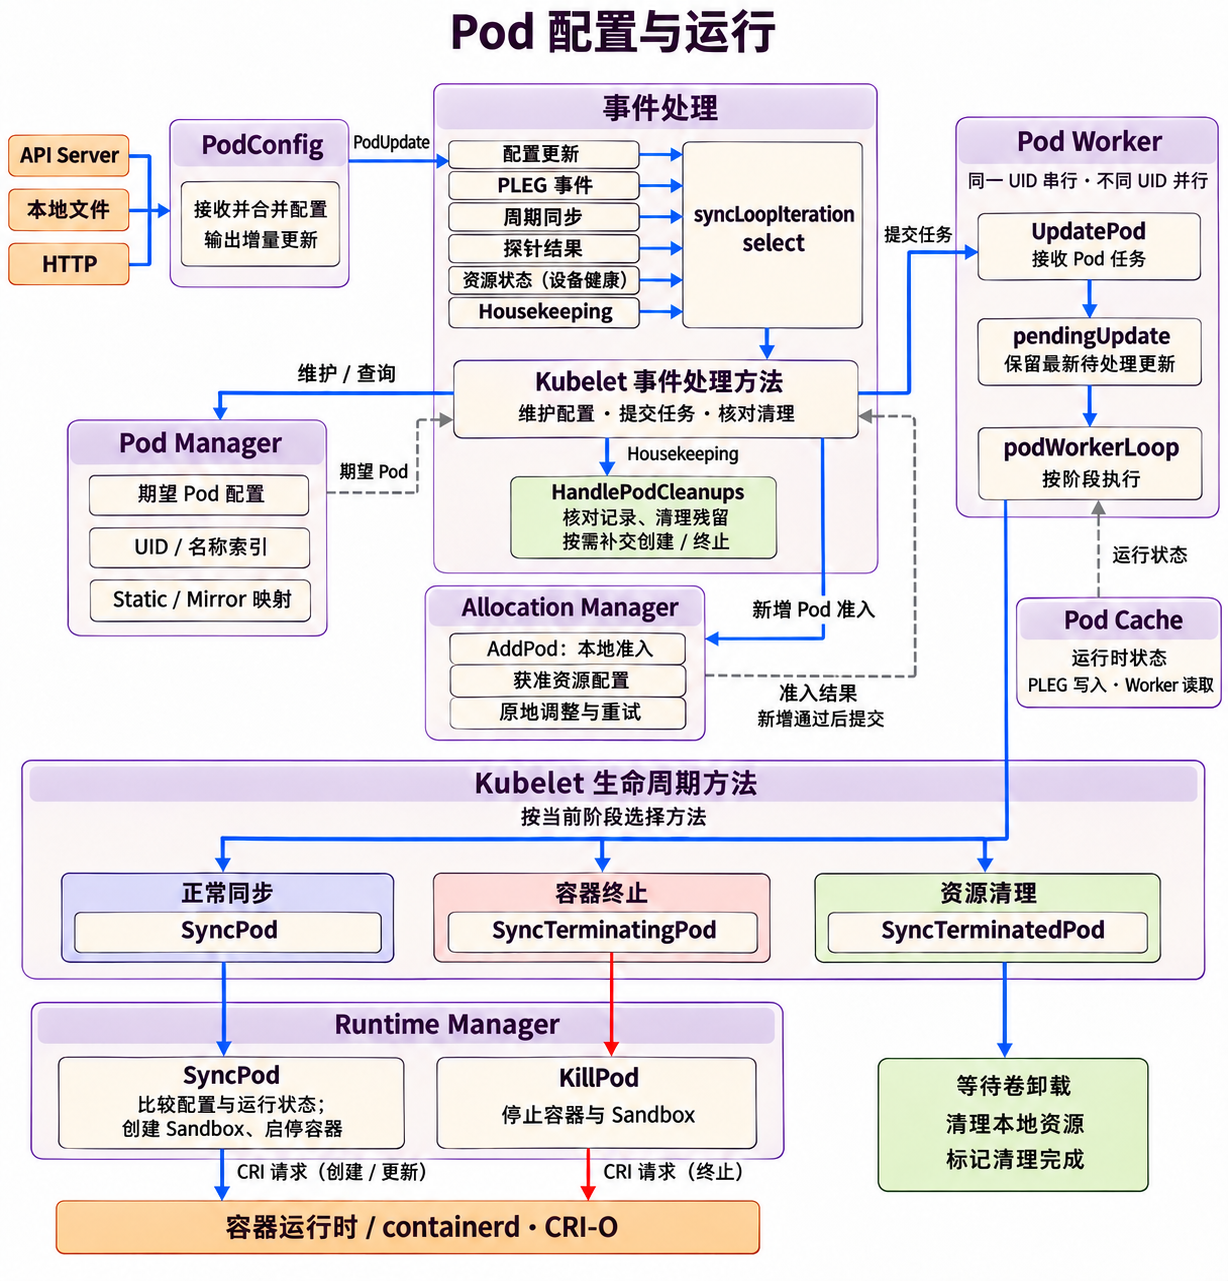
- PodConfig:统一接收 API Server、本地文件和 HTTP 提供的 Pod 配置,跟踪配置变化。将新增、更新和移除等变化通知 Kubelet 主循环
syncLoop,由syncLoopIteration接收并分派处理。 - Pod Manager:提供期望 Pod 及其配置的查询,帮助事件处理、Volume Manager 等模块找到目标 Pod。随配置变化维护这些记录,为 Pod 运行和资源清理提供依据。
- 事件处理:处理六类事件:配置更新、PLEG 事件、周期同步、探针结果、资源状态、Housekeeping。根据这些通知安排 Pod 的创建、同步或终止任务,并执行 Pod 与资源清理。
- Allocation Manager:负责 Pod 的本地准入,检查节点资源和运行条件是否满足要求。保存已批准的资源配置,并管理 Pod 运行中的资源调整。
- Pod Worker:组织每个 Pod 的同步、终止和清理任务,处理连续更新与失败重试。同一 Pod 的任务串行执行,不同 Pod 可以并行处理。
- Runtime Manager:根据 Pod 配置和当前运行状态,确定哪些容器需要创建、重启或停止。通过 CRI 将这些操作交给 containerd、CRI-O 等容器运行时执行。
PodConfig
PodConfig 接收 API Server、本地文件和 HTTP 提供的 Pod 配置,比较各来源的新旧 Pod 集合,将变化封装为 PodUpdate。这些通知通过输出通道进入 Kubelet 的主循环 syncLoop,由 syncLoopIteration 接收并调用对应的事件处理方法。
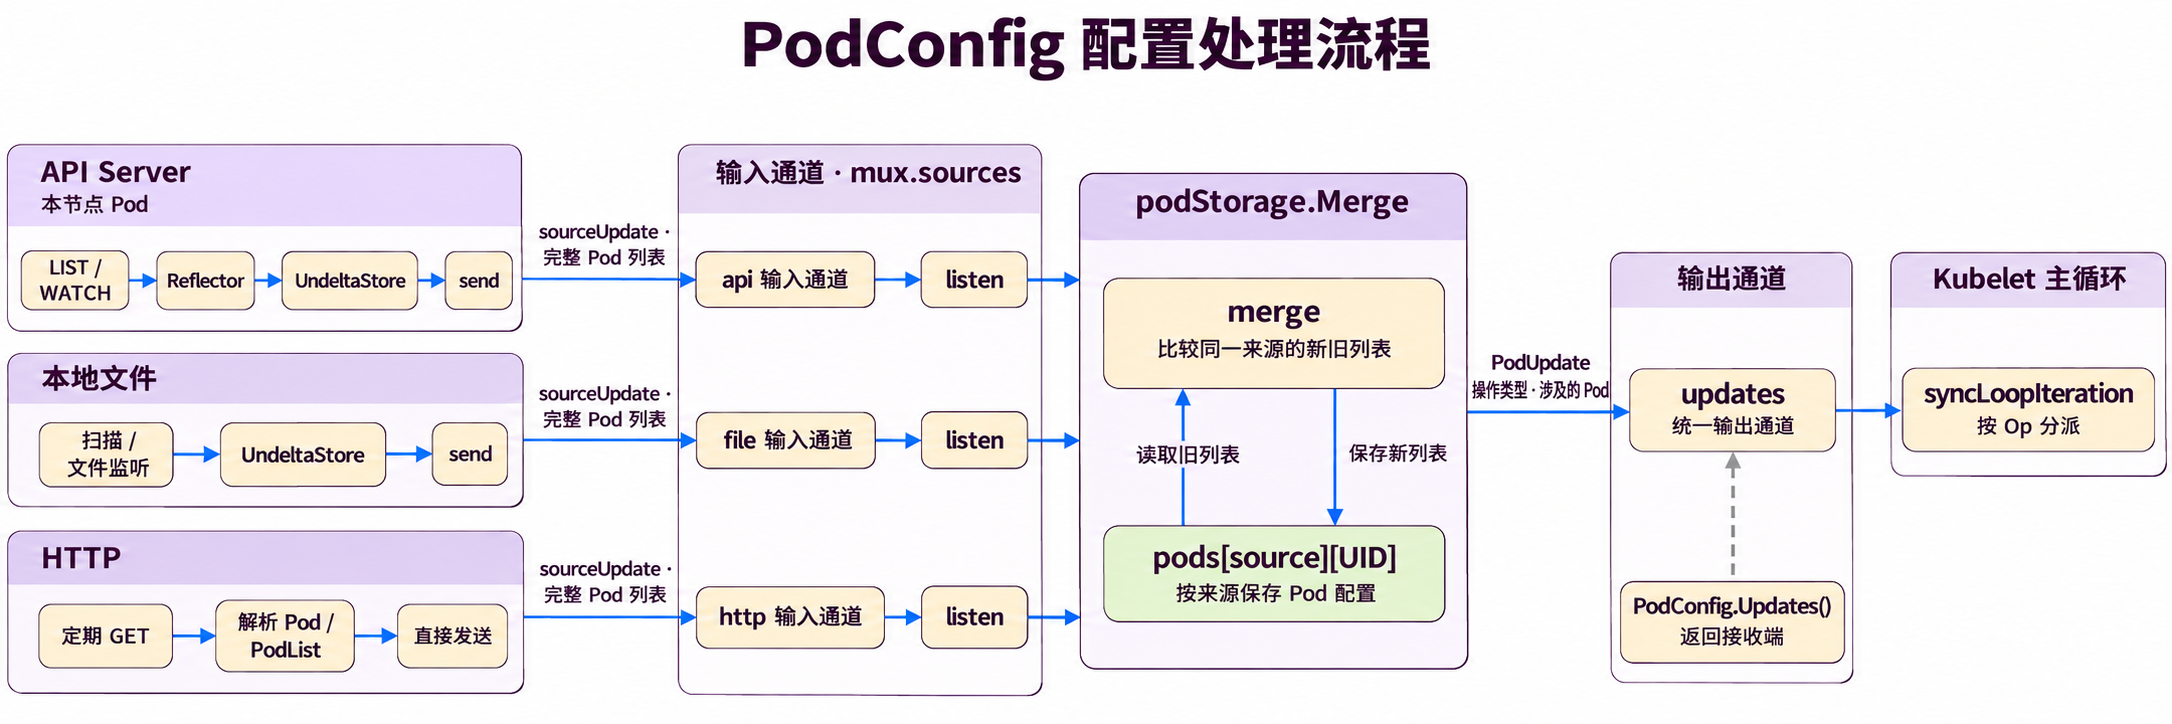
- 配置通道:每个已启用的来源通过独立输入通道提交完整 Pod 列表。统一输出通道发送带操作类型的变化通知,由 Kubelet 主循环接收并分派处理。
- 配置来源:API Server、本地文件和 HTTP 分别读取配置,将各自当前的完整 Pod 列表封装为
sourceUpdate,写入对应的输入通道。 - 增量更新:
podStorage按 UID 比较同一来源的新旧列表,生成新增、更新、请求删除、移除或状态协调通知。每条PodUpdate携带同一来源、同一种操作涉及的 Pod 列表,并标明操作类型。
PodConfig 的主要字段如下:
pods:指向podStorage,保存各来源的 Pod 配置,并比较新旧配置。mux:指向mux,管理各来源的输入通道,接收消息后交给podStorage处理。updates:统一输出通道,传递比较后生成的PodUpdate,供 Kubelet 主循环读取。sources:记录已配置的 Pod 配置来源名称,例如api、file和http。
type PodConfig struct {
    // 保存各来源的 Pod 配置,并计算变化。
    pods *podStorage
    // 管理各来源的输入通道,将消息交给 podStorage。
    mux *mux

    // 向 Kubelet 发送 Pod 配置变化通知的统一输出通道。
    updates chan kubetypes.PodUpdate

    // 记录已配置的来源名称,读写由 sourcesLock 保护。
    sourcesLock sync.Mutex
    sources     sets.Set[string]
}

type mux struct {
    // 接收来源消息并计算变化,此处由 podStorage 实现。
    merger merger

    // 保护来源名称与输入通道的对应表。
    sourceLock sync.RWMutex
    // 按来源名保存输入通道,消息类型为 sourceUpdate。
    sources map[string]chan sourceUpdate
}

type podStorage struct {
    // 保护 Pod 配置的读写。
    podLock sync.RWMutex
    // 外层按配置来源分组,内层按 Pod UID 保存 Pod 对象指针。
    // s.pods
    // ├── "api"
    // │   ├── "uid-web"   → Pod{Name: "web", Namespace: "default", ...}
    // │   └── "uid-cache" → Pod{Name: "cache", Namespace: "default", ...}
    // └── "file"
    //     └── "uid-agent" → Pod{Name: "agent", Namespace: "kube-system", ...}
    pods map[string]map[types.UID]*v1.Pod

    // 串行执行差异计算与通知发送。
    updateLock sync.Mutex
    // 将增量更新写入统一的 PodUpdate 输出通道。
    updates chan<- kubetypes.PodUpdate

    // 记录已提交初始配置的来源。
    sourcesSeenLock sync.RWMutex
    sourcesSeen     sets.Set[string]
    ...
}
Kubelet 构造期间,NewMainKubelet 在需要创建 PodConfig 时调用 makePodSourceConfig。它先调用 NewPodConfig 创建对象,再调用已启用来源的读取函数。这些函数在内部启动后台 goroutine,持续读取或监听 Pod 配置:
- 本地文件:
NewSourceFile读取指定文件或目录中的 Pod 配置,通过周期扫描和文件监听跟踪后续变化。 - HTTP:
NewSourceURL在后台按周期请求指定 URL,解析其中的 Pod 配置并提交变化后的完整列表。 - API Server:
NewSourceApiserver等待节点信息同步完成,再启动 Reflector,查询分配到本节点的 Pod 列表并监听后续变化。
每个启用的来源通过 cfg.Channel(ctx, source) 取得输入通道,用于向 PodConfig 提交完整 Pod 列表:
func makePodSourceConfig(ctx context.Context, kubeCfg *kubeletconfiginternal.KubeletConfiguration, kubeDeps *Dependencies, nodeName types.NodeName, nodeHasSynced func() bool) (*config.PodConfig, error) {
    ...
    // 创建 PodConfig,初始化 updates、podStorage 和 mux。
    cfg := config.NewPodConfig(kubeDeps.Recorder, kubeDeps.PodStartupLatencyTracker)

    // 本地路径中的 Pod 配置提交到 file 通道。
    if kubeCfg.StaticPodPath != "" {
        ...
        config.NewSourceFile(logger, kubeCfg.StaticPodPath, nodeName, kubeCfg.FileCheckFrequency.Duration, cfg.Channel(ctx, kubetypes.FileSource))
    }
    // HTTP 获取的 Pod 配置提交到 http 通道。
    if kubeCfg.StaticPodURL != "" {
        ...
        config.NewSourceURL(logger, kubeCfg.StaticPodURL, manifestURLHeader, nodeName, kubeCfg.HTTPCheckFrequency.Duration, cfg.Channel(ctx, kubetypes.HTTPSource))
    }
    // 分配到本节点的 Pod 配置提交到 api 通道。
    if kubeDeps.KubeClient != nil {
        ...
        config.NewSourceApiserver(logger, kubeDeps.KubeClient, nodeName, nodeHasSynced, cfg.Channel(ctx, kubetypes.ApiserverSource))
    }
    return cfg, nil
}
NewPodConfig 完成以下初始化:
updates:统一输出通道,消息类型为PodUpdate。它被保存到 PodConfig 的updates字段中,Kubelet 通过Updates()取得接收端。podStorage:保存各来源的 Pod 配置,比较新旧配置,并将生成的变化通知写入同一个updates通道。这里创建的实例保存在局部变量storage中。mux:管理各来源的输入通道,接收sourceUpdate消息。newMux(storage)将上述podStorage实例交给它,收到消息后调用这个实例的Merge方法,比较同一来源的新旧 Pod 配置,并将新增、更新、移除等变化封装为PodUpdate写入输出通道。
func NewPodConfig(recorder record.EventRecorderLogger, startupSLIObserver podStartupSLIObserver) *PodConfig {
    // 创建统一的 PodUpdate 输出通道。
    updates := make(chan kubetypes.PodUpdate, 50)
    // 将同一个输出通道交给 podStorage 写入。
    storage := newPodStorage(updates, recorder, startupSLIObserver)
    podConfig := &PodConfig{
        pods: storage,
        // mux 将来源消息交给这个 podStorage 处理。
        mux: newMux(storage),
        // 保存输出通道,供 Updates() 返回接收端。
        updates: updates,
        ...
    }
    return podConfig
}
配置通道
PodConfig 通过输入通道接收各来源的完整 Pod 列表,比较配置后,通过输出通道把变化通知 Kubelet。
输入通道
每个已启用的来源通过各自的输入通道向 PodConfig 提交完整 Pod 列表。listen 接收这些列表后,调用 podStorage.Merge 处理。
输入消息 sourceUpdate 只携带该来源当前的完整 Pod 列表:
Channel 根据来源名称取得输入通道。chan<- sourceUpdate 表示调用方只能向其中发送消息:
func (c *PodConfig) Channel(ctx context.Context, source string) chan<- sourceUpdate {
    ...
    c.sources.Insert(source)
    // 取得此来源的输入通道,调用方只能向其中发送消息。
    return c.mux.ChannelWithContext(ctx, source)
}
ChannelWithContext 为每个来源准备输入通道,并安排消息接收:
- 取得通道:按来源名查找
m.sources[source],已有通道就直接返回,否则创建并保存。例如,m.sources["api"]保存 API Server 来源的输入通道。 - 启动监听:将来源名和通道一起传给
listen,再把同一条通道交给对应的来源读取函数:NewSourceApiserver、NewSourceFile或NewSourceURL。来源读取逻辑向通道发送完整 Pod 列表,listen负责接收。 - 比较配置:
listen收到sourceUpdate后,将来源名和消息传给podStorage.Merge,比较该来源的新旧 Pod 配置,生成变化通知并写入输出通道。
func (m *mux) ChannelWithContext(ctx context.Context, source string) chan sourceUpdate {
    ...
    channel, exists := m.sources[source]
    if exists {
        return channel
    }
    // 创建输入通道,以来源名 source 为键保存。
    newChannel := make(chan sourceUpdate)
    m.sources[source] = newChannel
    // 将来源名和通道一起传给 listen,再返回通道供来源写入。
    go wait.Until(func() { m.listen(ctx, source, newChannel) }, 0, ctx.Done())
    return newChannel
}

func (m *mux) listen(ctx context.Context, source string, listenChannel <-chan sourceUpdate) {
    ...
    // 读取此来源发送的完整 Pod 列表。
    for update := range listenChannel {
        // 将启动时传入的来源名和本次消息一起交给 podStorage。
        if err := m.merger.Merge(ctx, source, update); err != nil {
            ...
        }
    }
}
输出通道
PodConfig 将比较后生成的变化通知写入统一输出通道,由 Kubelet 主循环接收并分派处理。
输出消息 PodUpdate 携带变化涉及的 Pod、操作类型 Op 和来源名称 Source。例如,API Server 来源新增一个 Pod 时,输出消息的 Pods 包含这个 Pod,Op 为 ADD,Source 为 api:
type PodUpdate struct {
    Pods   []*v1.Pod
    Op     PodOperation
    Source string
}
podStorage.updates 与 PodConfig.updates 引用同一条输出通道:前者写入变化通知,后者供 Updates() 返回接收端。
Updates() 返回统一输出通道的接收端,<-chan 表示调用方只能从中接收消息:
func (c *PodConfig) Updates() <-chan kubetypes.PodUpdate {
    // 返回统一输出通道的接收端。
    return c.updates
}
启动时,startKubelet 将 podCfg.Updates() 传给 Kubelet.Run,调用代码见运行入口。通道随后传入主循环,由事件处理中的 syncLoopIteration 读取 PodUpdate,并按 Op 选择处理方法。
配置来源
各配置源通过各自的输入通道提交当前的完整 Pod 列表。API Server 来源提供分配到本节点的 Pod,本地文件来源提供指定路径中的 Pod,HTTP 来源提供指定 URL 返回的 Pod。
API Server
API Server 来源通过 LIST/WATCH 跟踪分配到本节点的 Pod。字段选择器使用 spec.nodeName 限定节点,查询覆盖所有命名空间;例如节点 worker-01 对应 spec.nodeName=worker-01。
NewSourceApiserver 在后台等待节点信息同步完成,再启动 Reflector 获取 Pod 列表并持续处理 WATCH 事件。这里涉及以下对象和回调:
ListWatch:client-go 中的结构体,保存查询 Pod 列表和监听 Pod 变化的函数。NewListWatchFromClient创建它的实例,赋给下面代码中的lw,供 Reflector 调用。Reflector:执行 LIST/WATCH,先取得本节点的 Pod 列表,再将后续新增、修改和删除事件应用到本地 UndeltaStore。UndeltaStore:在内存中保存该来源当前的全部 Pod 对象。每次执行新增、更新、删除或替换操作后,将当前完整列表交给send。send:注册在 UndeltaStore 中的回调函数。存储完成新增、更新、删除或全量替换后,调用它,将当前完整 Pod 列表写入 PodConfig 的输入通道。
func NewSourceApiserver(logger klog.Logger, c clientset.Interface, nodeName types.NodeName, nodeHasSynced func() bool, updates chan<- sourceUpdate) {
    // 创建 ListWatch 实例 lw,只关注分配到本节点的 Pod。
    lw := cache.NewListWatchFromClient(c.CoreV1().RESTClient(), "pods", metav1.NamespaceAll, fields.OneTermEqualSelector("spec.nodeName", string(nodeName)))
    ...
    // 在后台等待节点信息同步,然后创建 Pod 的 Reflector。
    go func() {
        for {
            // 节点信息已同步,可以开始读取本节点的 Pod。
            if nodeHasSynced() {
                ...
                break
            }
            time.Sleep(WaitForAPIServerSyncPeriod)
            ...
        }
        ...
        newSourceApiserverFromLW(lw, updates)
    }()
}

func newSourceApiserverFromLW(lw cache.ListerWatcher, updates chan<- sourceUpdate) {
    send := func(objs []interface{}) {
        var pods []*v1.Pod
        for _, o := range objs {
            pods = append(pods, o.(*v1.Pod))
        }
        // 将该来源当前的完整 Pod 列表提交给 PodConfig。
        updates <- sourceUpdate{Pods: pods}
    }
    // Reflector 通过 lw 读取 Pod,将结果写入指定存储。
    r := cache.NewReflector(
        lw, &v1.Pod{},
        // 存储更新后调用 send,提交完整列表。
        cache.NewUndeltaStore(send, cache.MetaNamespaceKeyFunc),
        0,
    )
    // 启动后台查询和 WATCH 事件处理。
    go r.Run(wait.NeverStop)
}
例如,本地存储已有 {A, B},Reflector 随后收到 C 新增的通知,就向存储加入 C。UndeltaStore 再把完整的 {A, B, C} 交给 send,由它提交给 PodConfig。
NewUndeltaStore(send, ...) 将 send 保存为 PushFunc。新增、更新、删除或全量替换成功后,UndeltaStore 都会调用 Store.List(),取出该来源当前保存的全部 Pod 对象,交给 send。
send 将存储更新后的完整列表写入 PodConfig 的输入通道,之后才由 podStorage.Merge 比较新旧列表,生成变化通知。
以 Add 为例,先保存新增对象,再通过回调提交完整列表:
func (u *UndeltaStore) Add(obj interface{}) error {
    // 先将新增对象保存到此来源的本地存储。
    if err := u.Store.Add(obj); err != nil {
        return err
    }
    // 取出更新后此来源的全部对象,调用注册的 send 回调。
    u.PushFunc(u.Store.List())
    return nil
}
本地文件
本地文件来源读取单个 manifest 或目录中的 manifest,其中定义的 Pod 属于 Static Pod。文件监听和周期扫描跟踪配置变化,扫描间隔由 fileCheckFrequency 控制,默认为 20s。
在 Kubelet 配置中设置 staticPodPath,即可指定读取路径。修改此配置后需要重启 Kubelet;之后修改路径内的 manifest,由文件监听或周期扫描发现。
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
staticPodPath: /etc/kubernetes/manifests
fileCheckFrequency: 20s
NewSourceFile 先调用小写的 newSourceFile 创建 sourceFile 对象,再调用它的 run 方法启动文件扫描和监听。newSourceFile 创建此来源自己的 UndeltaStore,保存扫描或监听得到的 Pod;存储变化后,send 回调将完整列表提交给 PodConfig:
func NewSourceFile(logger klog.Logger, path string, nodeName types.NodeName, period time.Duration, updates chan<- sourceUpdate) {
    ...
    // 创建文件来源的读取对象,保存输入通道。
    config := newSourceFile(path, nodeName, period, updates)
    ...
    // 启动文件扫描和监听。
    config.run(logger)
}

func newSourceFile(path string, nodeName types.NodeName, period time.Duration, updates chan<- sourceUpdate) *sourceFile {
    send := func(objs []interface{}) {
        var pods []*v1.Pod
        for _, o := range objs {
            pods = append(pods, o.(*v1.Pod))
        }
        // 提交文件来源的完整 Pod 集合。
        updates <- sourceUpdate{Pods: pods}
    }
    // 文件扫描和监听更新此存储,存储操作后回调 send。
    store := cache.NewUndeltaStore(send, cache.MetaNamespaceKeyFunc)
    return &sourceFile{
        ...
        store: store,
        ...
    }
}
sourceFile.run 启动后台循环:先调用 listConfig 立即扫描一次,再通过 select 等待周期扫描信号或文件变化事件。listConfig 读取路径中的 Pod 列表,consumeWatchEvent 处理发生变化的文件;读取结果更新到存储后,由 send 提交完整列表。
func (s *sourceFile) run(logger klog.Logger) {
    // 按 fileCheckFrequency 传入的周期生成扫描信号。
    listTicker := time.NewTicker(s.period)

    // 在后台执行首次扫描,并持续接收定时信号和文件事件。
    go func() {
        // 启动后立即读取一次路径中的 Pod 配置。
        if err := s.listConfig(logger); err != nil {
            ...
        }
        for {
            select {
            // 定时重新扫描文件或目录。
            case <-listTicker.C:
                if err := s.listConfig(logger); err != nil {
                    ...
                }
            // 收到文件变化事件,读取或移除对应的 Pod 配置。
            case e := <-s.watchEvents:
                if err := s.consumeWatchEvent(logger, e); err != nil {
                    ...
                }
            }
        }
    }()

    // 启动文件监听,将变化通知写入 watchEvents。
    s.startWatch(logger)
}
HTTP
HTTP 来源定期从 staticPodURL 获取 YAML 或 JSON 格式的 Pod、PodList,其中的 Pod 同样属于 Static Pod。拉取间隔由 httpCheckFrequency 控制,默认为 20s。
HTTP 响应解析后即可得到该来源的完整 Pod 列表;API Server 和本地文件的监听事件通常只涉及单个 Pod,需通过 UndeltaStore 维护完整列表后再提交。
在 Kubelet 配置中设置 URL 后重启 Kubelet,后续 manifest 更新通过定期拉取发现:
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
staticPodURL: https://config.example.com/nodes/worker-01.yaml
httpCheckFrequency: 20s
NewSourceURL 创建读取对象,并通过 go wait.Until(...) 启动后台循环。首次立即执行 run,每轮完成后等待 httpCheckFrequency 指定的时长,再执行下一轮;run 调用 extractFromURL 完成一次拉取和提交:
func NewSourceURL(logger klog.Logger, url string, header http.Header, nodeName types.NodeName, period time.Duration, updates chan<- sourceUpdate) {
    config := &sourceURL{
        url:     url,
        updates: updates,
        ...
    }
    ...
    // 启动后台循环,首次立即执行,之后每轮完成后等待 period。
    go wait.Until(func() { config.run(logger) }, period, wait.NeverStop)
}

func (s *sourceURL) run(logger klog.Logger) {
    // 执行一次 HTTP 拉取、解析和列表提交。
    if err := s.extractFromURL(logger); err != nil {
        ...
    } else {
        ...
    }
}
extractFromURL 取得响应内容后,先检查内容是否变化,再尝试解析单个 Pod 或 PodList。解析成功后,将结果作为该来源的完整集合提交。
func (s *sourceURL) extractFromURL(logger klog.Logger) error {
    ...
    // 响应内容未变时,跳过重复解析和提交。
    if bytes.Equal(data, s.data) {
        return nil
    }
    s.data = data

    parsed, pod, singlePodErr := tryDecodeSinglePod(logger, data, s.applyDefaults)
    if parsed {
        if singlePodErr != nil {
            return singlePodErr
        }
        // 单个 Pod 也按完整集合提交。
        s.updates <- sourceUpdate{Pods: []*v1.Pod{pod}}
        return nil
    }

    parsed, podList, multiPodErr := tryDecodePodList(logger, data, s.applyDefaults)
    if parsed {
        if multiPodErr != nil {
            return multiPodErr
        }
        ...
        // 将 PodList 的全部条目提交给 PodConfig。
        s.updates <- sourceUpdate{Pods: pods}
        return nil
    }
    ...
}
合法的空 PodList 表示该来源当前没有 Pod,会使原集合中的 Pod 被识别为移除。
增量更新
listen 收到完整 Pod 列表后,调用 podStorage.Merge。它先通过内部的 s.merge 按 UID 比较同一来源的新旧配置、保存新集合,再将生成的 PodUpdate 写入输出通道。比较结果分为五类:
- 新增(
ADD):新列表中出现旧列表没有的 UID。 - 更新(
UPDATE):已有 UID 的配置发生变化,且新对象没有设置deletionTimestamp。 - 请求删除(
DELETE):已有 UID 的配置发生变化,且新对象带有deletionTimestamp。 - 移除(
REMOVE):旧列表中的 UID 已从新列表中消失。 - 状态协调(
RECONCILE):配置相同,但Status不同,需要 Kubelet 检查并更新 Pod 状态。
func (s *podStorage) Merge(ctx context.Context, source string, update sourceUpdate) error {
    // 一次差异计算与通知发送串行完成。
    s.updateLock.Lock()
    defer s.updateLock.Unlock()
    seenBefore := s.sourcesSeen.Has(source)
    // 比较此来源的新旧配置,生成五类 PodUpdate。
    adds, updates, deletes, removes, reconciles := s.merge(ctx, source, update)
    firstSet := !seenBefore && s.sourcesSeen.Has(source)

    // 将移除和新增通知写入统一输出通道。
    if len(removes.Pods) > 0 {
        s.updates <- *removes
    }
    if len(adds.Pods) > 0 {
        s.updates <- *adds
    }
    ...
    // 首次收到此来源配置且没有这些变化时,发送空 ADD。
    if firstSet && len(adds.Pods) == 0 && len(updates.Pods) == 0 && len(deletes.Pods) == 0 {
        s.updates <- *adds
    }
    ...
    return nil
}
Pod Manager
Pod Manager 保存 Kubelet 已接收的期望 Pod,并提供查询接口。事件处理方法维护这些记录,主循环、状态发布和资源管理等模块按需查询。
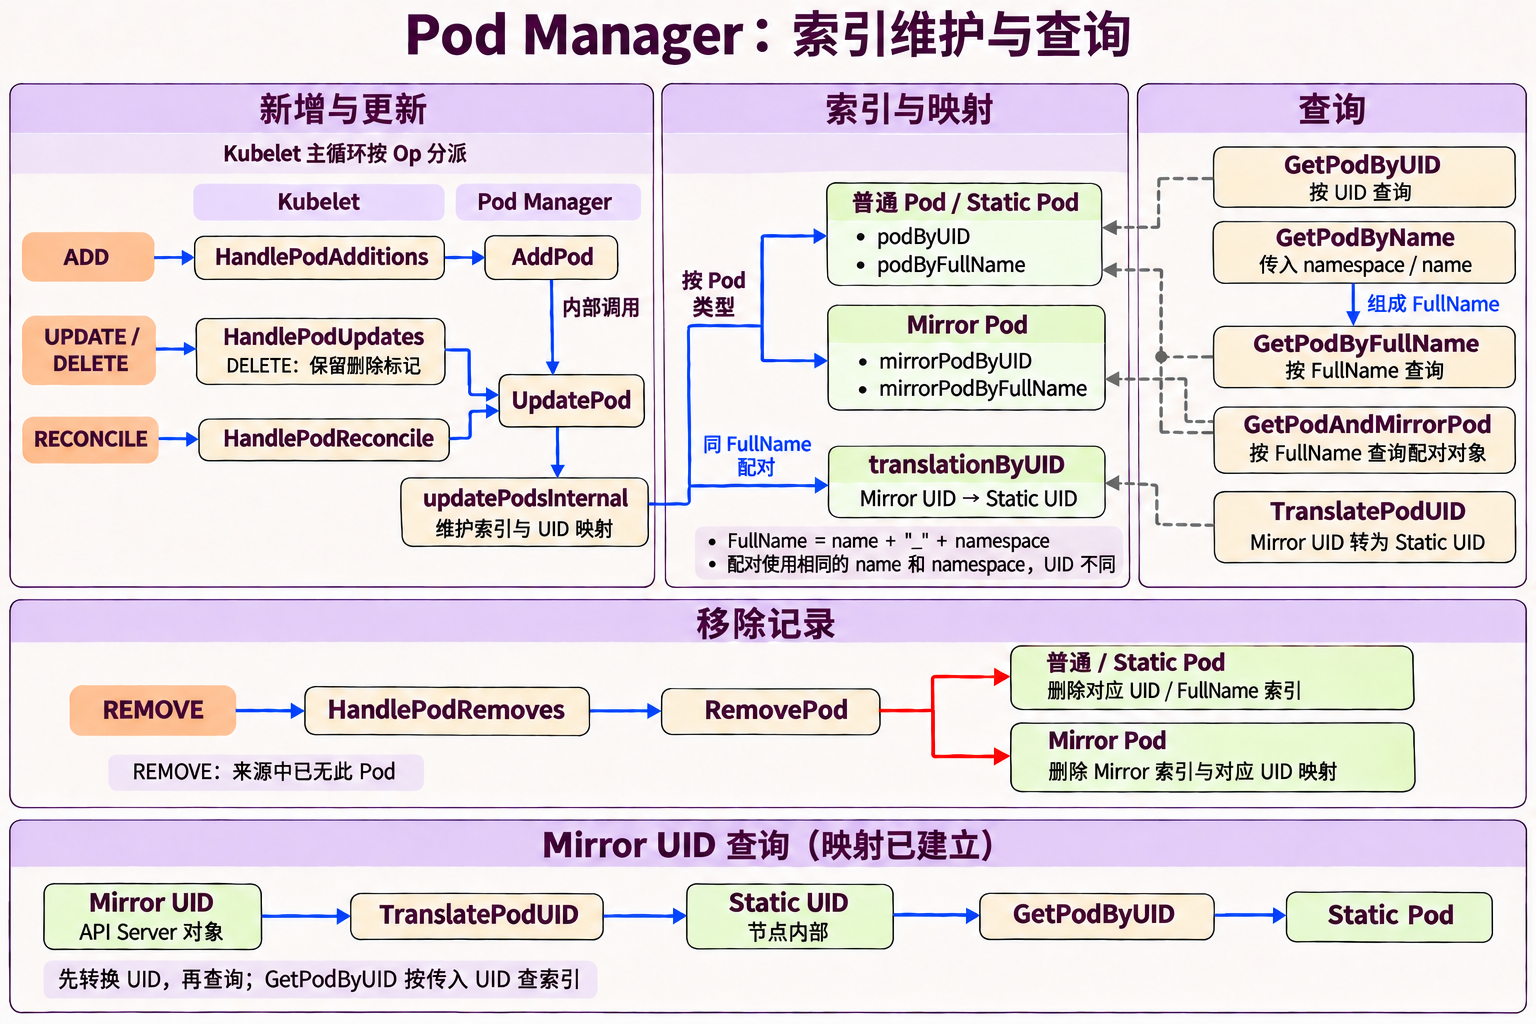
管理接口
Kubelet 通过 Manager 接口 访问这些记录。接口中的方法用于维护记录、查询 Pod,以及处理 Static Pod 与 Mirror Pod 的配对和 UID 转换:
type Manager interface {
    // 按 FullName、命名空间和名称或 UID 查询非 Mirror Pod。
    GetPodByFullName(podFullName string) (*v1.Pod, bool)
    GetPodByName(namespace, name string) (*v1.Pod, bool)
    GetPodByUID(types.UID) (*v1.Pod, bool)
    ...
    // 按传入 Pod 的名称和命名空间查找配对对象。
    // 传入 Static Pod 时查找 Mirror Pod,传入 Mirror Pod 时查找 Static Pod。
    GetPodAndMirrorPod(*v1.Pod) (pod, mirrorPod *v1.Pod, wasMirror bool)

    // 获取普通 Pod 和 Static Pod 的集合。
    GetPods() []*v1.Pod
    ...
    // 新增、更新和移除 Pod 记录。
    AddPod(pod *v1.Pod)
    UpdatePod(pod *v1.Pod)
    RemovePod(pod *v1.Pod)

    // 将 Mirror UID 转换为对应的 Static UID。
    TranslatePodUID(uid types.UID) kubetypes.ResolvedPodUID
    ...
}
索引结构
Pod Manager 的 Manager 接口由 basicManager 实现。它分别通过 Pod 的 UID 和 FullName 建立索引,两个索引指向同一个 Pod 对象。以 API Server 创建的普通 Pod default/web 为例:
- UID 索引:
podByUID["7c8f3a2e-6d91-4b70-9e25-13a6d08f4c92"]。API Server 创建对象时,通过FillObjectMetaSystemFields生成 UUID 并写入metadata.uid,用于区分不同的 Pod 实例。 - FullName 索引:
podByFullName["web_default"]。GetPodFullName使用name + "_" + namespace拼接名称和命名空间,供持有这两个信息的调用方查询。
普通 Pod 和 Static Pod 共用一组索引,Mirror Pod 单独保存;所有索引和 UID 映射由同一个读写锁保护。
type basicManager struct {
    lock sync.RWMutex

    // 普通 Pod 和 Static Pod 的索引。
    podByUID      map[kubetypes.ResolvedPodUID]*v1.Pod
    podByFullName map[string]*v1.Pod

    // Mirror Pod 的索引。
    mirrorPodByUID      map[kubetypes.MirrorPodUID]*v1.Pod
    mirrorPodByFullName map[string]*v1.Pod

    // Mirror UID 到 Static UID 的映射。
    translationByUID map[kubetypes.MirrorPodUID]kubetypes.ResolvedPodUID
}
配置维护与查询
Pod Manager 通过以下方法维护本地记录、查询 Pod 和查找配对对象:
- 新增和更新:
HandlePodAdditions调用AddPod;HandlePodUpdates和HandlePodReconcile调用UpdatePod。AddPod内部也调用UpdatePod,共用索引维护路径。 - 索引维护:
updatePodsInternal按 Pod 类型更新 UID 和 FullName 索引,并记录 Static Pod 与 Mirror Pod 的 UID 映射。 - 普通 Pod 与 Static Pod 查询:
GetPodByUID按 UID 查询;GetPodByName将名称和命名空间组成 FullName,交给GetPodByFullName查询。这三个方法返回 Pod 和是否找到的结果,GetPods则返回全部普通 Pod 与 Static Pod。 - 配对查询:
GetPodAndMirrorPod接收 Pod 对象,按名称和命名空间查找配对。传入 Static Pod 时查找 Mirror Pod,传入 Mirror Pod 时查找 Static Pod。 - 移除记录:
HandlePodRemoves调用RemovePod清理对应索引;移除 Mirror Pod 时,同时删除它的 UID 映射。
新增与更新
UpdatePod 加锁后调用 updatePodsInternal。普通 Pod 与 Static Pod 写入 podByUID、podByFullName,Mirror Pod 写入独立索引;同 FullName 的两个对象都已存在时,记录 UID 映射:
func (pm *basicManager) AddPod(pod *v1.Pod) {
    // 新增 Pod 复用 UpdatePod 维护索引。
    pm.UpdatePod(pod)
}

func (pm *basicManager) UpdatePod(pod *v1.Pod) {
    pm.lock.Lock()
    defer pm.lock.Unlock()

    // 在持有写锁时更新索引与 UID 映射。
    pm.updatePodsInternal(pod)
}

func (pm *basicManager) updatePodsInternal(pods ...*v1.Pod) {
    for _, pod := range pods {
        // 用“名称_命名空间”查找 Static Pod 与 Mirror Pod 的配对对象。
        podFullName := kubecontainer.GetPodFullName(pod)

        if kubetypes.IsMirrorPod(pod) {
            mirrorPodUID := kubetypes.MirrorPodUID(pod.UID)
            // 按 Mirror Pod 自身的 UID 和 FullName 保存对象。
            pm.mirrorPodByUID[mirrorPodUID] = pod
            pm.mirrorPodByFullName[podFullName] = pod

            // Mirror Pod 后到达时,查找同 FullName 的已保存 Static Pod。
            // 找到后建立 Mirror UID 到 Static UID 的映射。
            if p, ok := pm.podByFullName[podFullName]; ok {
                pm.translationByUID[mirrorPodUID] = kubetypes.ResolvedPodUID(p.UID)
            }
        } else {
            resolvedPodUID := kubetypes.ResolvedPodUID(pod.UID)
            ...
            // 非 Mirror Pod 进入此分支,普通 Pod 和 Static Pod 共用这组索引。
            pm.podByUID[resolvedPodUID] = pod
            pm.podByFullName[podFullName] = pod

            // Static Pod 到达后,找到对应的 Mirror Pod 时建立 UID 映射。
            if mirror, ok := pm.mirrorPodByFullName[podFullName]; ok {
                pm.translationByUID[kubetypes.MirrorPodUID(mirror.UID)] = resolvedPodUID
            }
        }
    }
}
普通 Pod 与 Static Pod 查询
GetPodByUID 和 GetPodByFullName 直接读取普通 Pod 与 Static Pod 的索引。GetPodByName 复用 FullName 查询,GetPods 返回这组索引中的全部 Pod:
func (pm *basicManager) GetPodByUID(uid types.UID) (*v1.Pod, bool) {
    pm.lock.RLock()
    defer pm.lock.RUnlock()

    // 按 UID 读取普通 Pod 或 Static Pod,并返回是否找到。
    pod, ok := pm.podByUID[kubetypes.ResolvedPodUID(uid)]
    return pod, ok
}

func (pm *basicManager) GetPodByName(namespace, name string) (*v1.Pod, bool) {
    // 将名称和命名空间组成 FullName,再复用 FullName 查询。
    podFullName := kubecontainer.BuildPodFullName(name, namespace)
    return pm.GetPodByFullName(podFullName)
}

func (pm *basicManager) GetPodByFullName(podFullName string) (*v1.Pod, bool) {
    pm.lock.RLock()
    defer pm.lock.RUnlock()

    // 从普通 Pod 与 Static Pod 共用的 FullName 索引中查找。
    pod, ok := pm.podByFullName[podFullName]
    return pod, ok
}

func (pm *basicManager) GetPods() []*v1.Pod {
    pm.lock.RLock()
    defer pm.lock.RUnlock()

    // 将 UID 索引中的全部普通 Pod 和 Static Pod 转为列表。
    return podsMapToPods(pm.podByUID)
}
配对查询
GetPodAndMirrorPod 直接按 FullName 查找另一方,返回 pod、mirrorPod 和 wasMirror。wasMirror 表示输入对象是否为 Mirror Pod;配对对象不存在时,对应的返回值为 nil。传入普通 Pod 时,通常没有对应的 Mirror Pod:
func (pm *basicManager) GetPodAndMirrorPod(aPod *v1.Pod) (pod, mirrorPod *v1.Pod, wasMirror bool) {
    pm.lock.RLock()
    defer pm.lock.RUnlock()

    // 用传入对象的名称和命名空间生成配对查询键。
    fullName := kubecontainer.GetPodFullName(aPod)
    if kubetypes.IsMirrorPod(aPod) {
        // 输入是 Mirror Pod:查找 Static Pod,并标记 wasMirror 为 true。
        return pm.podByFullName[fullName], aPod, true
    }
    // 输入是普通 Pod 或 Static Pod:保留输入,查找对应 Mirror Pod。
    return aPod, pm.mirrorPodByFullName[fullName], false
}
移除记录
RemovePod 根据传入对象的类型清理索引和映射记录。配置来源中移除普通 Pod 或 Static Pod 时,清理普通索引;移除 Mirror Pod 时,清理 Mirror 索引及它的 UID 映射:
func (pm *basicManager) RemovePod(pod *v1.Pod) {
    ...
    pm.lock.Lock()
    defer pm.lock.Unlock()
    podFullName := kubecontainer.GetPodFullName(pod)

    if kubetypes.IsMirrorPod(pod) {
        mirrorPodUID := kubetypes.MirrorPodUID(pod.UID)
        // 移除 Mirror Pod 的两组索引及对应 UID 映射。
        delete(pm.mirrorPodByUID, mirrorPodUID)
        delete(pm.mirrorPodByFullName, podFullName)
        delete(pm.translationByUID, mirrorPodUID)
    } else {
        // 移除普通 Pod 或 Static Pod 的两组索引。
        delete(pm.podByUID, kubetypes.ResolvedPodUID(pod.UID))
        delete(pm.podByFullName, podFullName)
    }
}
Static Pod 与 Mirror Pod
Static Pod 是由指定节点上的 Kubelet 直接管理的 Pod。Kubelet 从本地文件或 HTTP 配置源读取它的 manifest,在本节点创建和维护容器,无需 Scheduler 调度。
Mirror Pod 是 Kubelet 为 Static Pod 在 API Server 中创建的 Pod 对象,用于展示该 Static Pod 的配置和运行状态,供 kubectl get pods 等命令查询。它对应节点上已有的 Static Pod,不会另外启动一组容器。
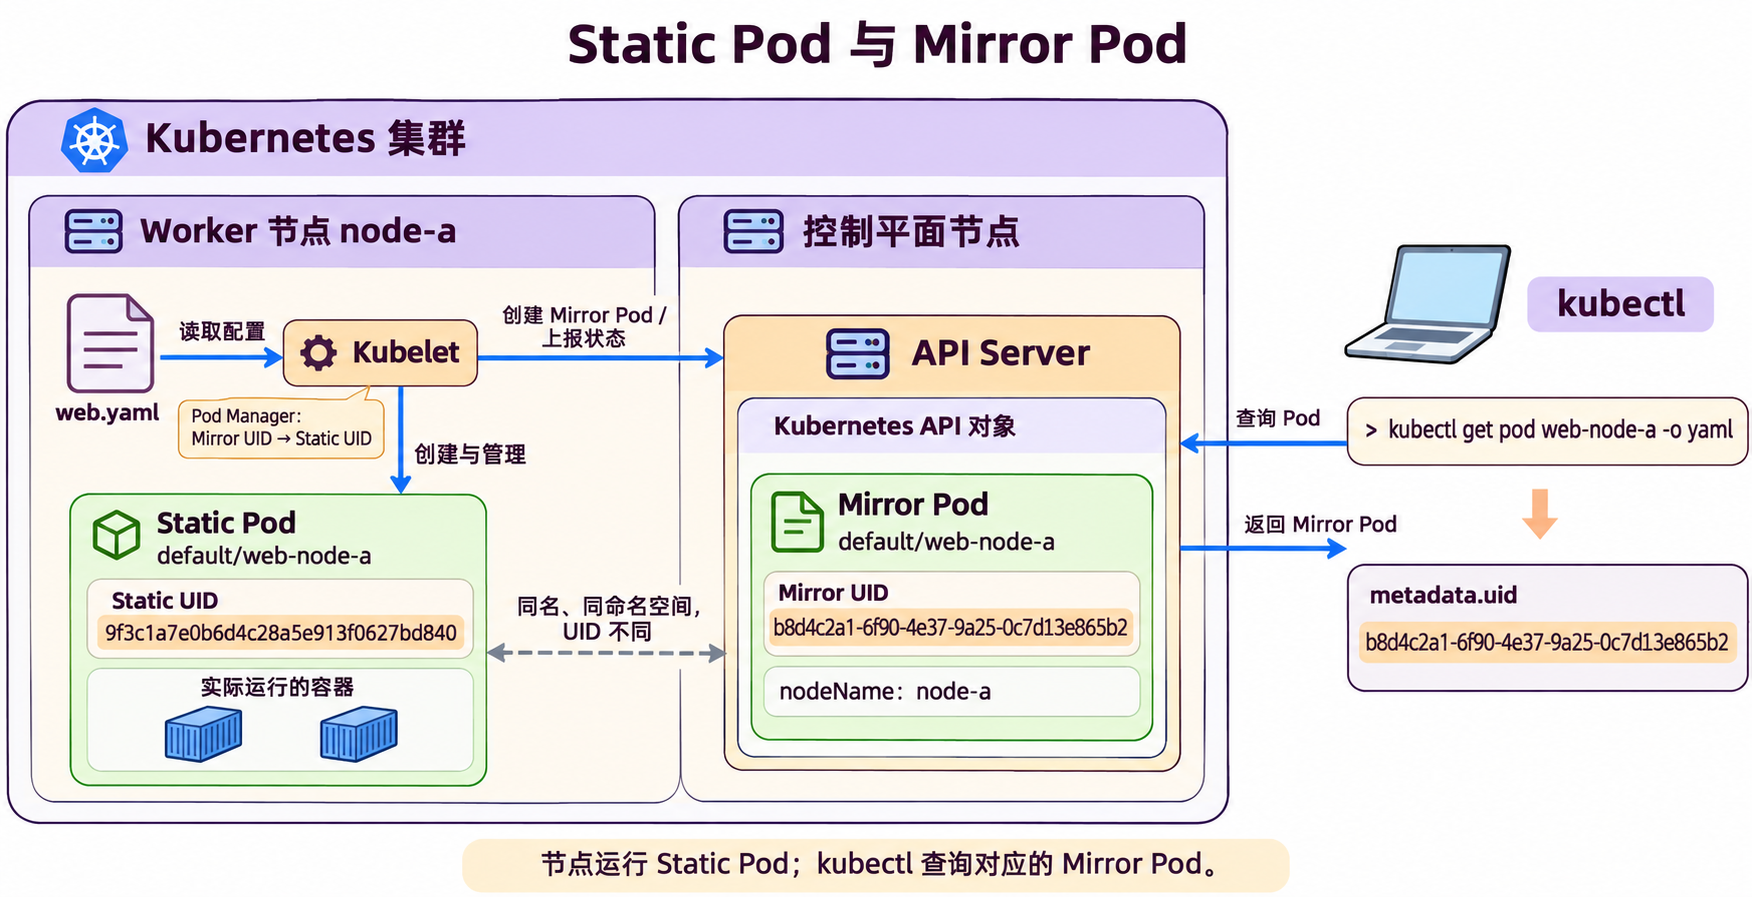
通过 kubectl get pod 查询其 metadata.uid 时,得到的是 API Server 中 Mirror Pod 的 UID,与节点上 Static Pod 的 UID 不同。 两者名称和命名空间相同,Pod Manager 据此建立 Mirror UID 到 Static UID 的映射。根据 Mirror UID 查询节点上的 Static Pod 时,先通过 TranslatePodUID 转换为 Static UID,再调用 GetPodByUID 查询对应的 Pod。
通过 kubectl delete pod 删除 Mirror Pod,只会删除 API Server 中的对象,节点上的 Static Pod 仍会运行。只要 Static Pod 仍存在,Kubelet 就会在后续同步中通过 tryReconcileMirrorPods 尝试重建 Mirror Pod。
事件处理
Kubelet 的 syncLoopIteration 接收配置更新、运行状态变化和定时信号。各分支调用对应方法,维护期望配置,发起 Pod 的创建、同步或终止请求,并清理残留资源。
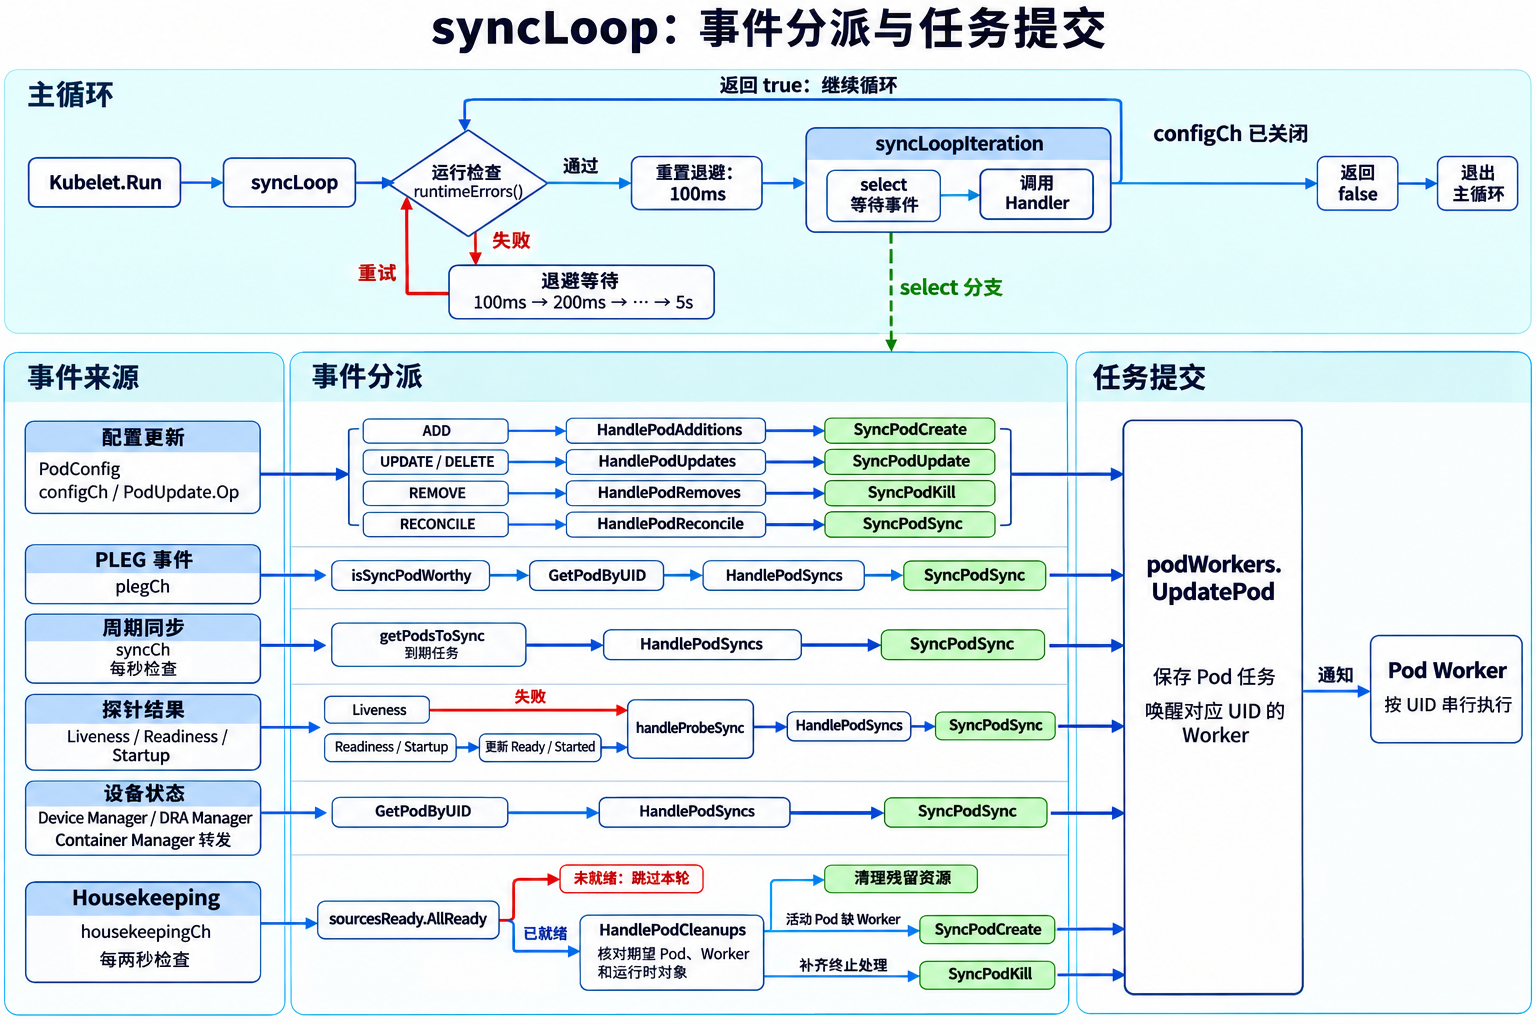
- 配置更新:PodConfig 将配置变化写入
configCh,syncLoopIteration按操作类型选择处理方法。 - PLEG 事件:PLEG 通过
plegCh通知受影响的 Pod UID 和事件类型,syncLoopIteration查询期望配置后请求 Pod 同步。 - 周期同步:每秒检查哪些 Pod 已到下一次同步或失败重试的时间,再请求同步。
- 探针结果:根据探测结果更新容器的 Ready、Started 状态,并按探针类型请求 Pod 同步。
- 资源状态:Container Manager 将设备健康通知转发到统一通道,
syncLoopIteration根据受影响的 Pod UID 请求同步。 - Housekeeping:定期核对 Pod 配置、Pod Worker 记录和容器运行时对象,清理残留资源,并补交必要的创建或终止请求。
Kubelet 通过 SyncHandler 接口提供配置处理、Pod 同步和节点清理方法:
type SyncHandler interface {
    HandlePodAdditions(ctx context.Context, pods []*v1.Pod)
    HandlePodUpdates(ctx context.Context, pods []*v1.Pod)
    HandlePodRemoves(ctx context.Context, pods []*v1.Pod)
    HandlePodReconcile(ctx context.Context, pods []*v1.Pod)
    HandlePodSyncs(ctx context.Context, pods []*v1.Pod)
    HandlePodCleanups(ctx context.Context) error
}
syncLoopIteration 通过 select 读取各通道的通知。configCh、plegCh、syncCh 和 housekeepingCh 由参数传入,探针和资源状态通知从各 Manager 的 Updates() 获取。配置更新按 PodUpdate.Op 选择处理方法,其余分支根据通知内容请求 Pod 同步或执行节点清理:
func (kl *Kubelet) syncLoopIteration(
    ctx context.Context,
    configCh <-chan kubetypes.PodUpdate,
    handler SyncHandler,
    syncCh <-chan time.Time,
    housekeepingCh <-chan time.Time,
    plegCh <-chan *pleg.PodLifecycleEvent,
) bool {
    logger := klog.FromContext(ctx)
    select {
    case u, open := <-configCh:
        if !open {
            ...
            return false
        }
        // 配置更新按操作类型选择对应的处理方法。
        switch u.Op {
        case kubetypes.ADD:
            handler.HandlePodAdditions(ctx, u.Pods)
        case kubetypes.UPDATE:
            handler.HandlePodUpdates(ctx, u.Pods)
        case kubetypes.REMOVE:
            handler.HandlePodRemoves(ctx, u.Pods)
        case kubetypes.RECONCILE:
            handler.HandlePodReconcile(ctx, u.Pods)
        case kubetypes.DELETE:
            handler.HandlePodUpdates(ctx, u.Pods)
        default:
            ...
        }
        kl.sourcesReady.AddSource(u.Source)

    case e := <-plegCh:
        // 根据事件中的 Pod UID,从 Pod Manager 获取期望配置。
        if isSyncPodWorthy(e) {
            if pod, ok := kl.podManager.GetPodByUID(e.ID); ok {
                handler.HandlePodSyncs(ctx, []*v1.Pod{pod})
            }
        }
        ...

    case <-syncCh:
        // 定时检查选出本轮需要同步的 Pod。
        podsToSync := kl.getPodsToSync()
        if len(podsToSync) == 0 {
            break
        }
        handler.HandlePodSyncs(ctx, podsToSync)

    case update := <-kl.livenessManager.Updates():
        // Liveness 失败时请求同步对应 Pod。
        if update.Result == proberesults.Failure {
            handleProbeSync(ctx, kl, update, handler, "liveness", "unhealthy")
        }

    case update := <-kl.readinessManager.Updates():
        ready := update.Result == proberesults.Success
        // 更新容器的 Ready 状态,再请求 Pod 同步。
        kl.statusManager.SetContainerReadiness(logger, update.PodUID, update.ContainerID, ready)
        ...
        handleProbeSync(ctx, kl, update, handler, "readiness", ...)

    case update := <-kl.startupManager.Updates():
        started := update.Result == proberesults.Success
        // 更新容器的 Started 状态,再请求 Pod 同步。
        kl.statusManager.SetContainerStartup(logger, update.PodUID, update.ContainerID, started)
        ...
        handleProbeSync(ctx, kl, update, handler, "startup", ...)

    case update := <-kl.containerManager.Updates():
        pods := []*v1.Pod{}
        // Device Manager、DRA Manager 的设备健康通知由 Container Manager 转发。
        // 根据通知中的 Pod UID,从 Pod Manager 获取受影响 Pod 的期望配置。
        for _, p := range update.PodUIDs {
            if pod, ok := kl.podManager.GetPodByUID(types.UID(p)); ok {
                pods = append(pods, pod)
            }
        }
        if len(pods) > 0 {
            handler.HandlePodSyncs(ctx, pods)
        }

    case <-housekeepingCh:
        // 配置源就绪后,核对 Pod 记录并清理资源。
        if !kl.sourcesReady.AllReady() {
            ...
        } else {
            if err := handler.HandlePodCleanups(ctx); err != nil {
                ...
            }
        }
    }
    return true
}
处理方法
下表列出了 syncLoopIteration 根据不同事件调用的处理方法,以及它们在配置维护、Pod 同步和资源清理中的主要作用。
| 方法 | 主要作用 |
|---|---|
HandlePodAdditions |
保存新增 Pod 的期望配置。新增普通 Pod 通过 Allocation Manager 的本地准入检查后,提交创建请求。 |
HandlePodUpdates |
更新期望配置并请求同步;Pod 带有删除标记时,由后续同步推进终止。 |
HandlePodRemoves |
移除期望记录及分配记录。普通 Pod 通过配置源就绪检查后,请求终止。 |
HandlePodReconcile |
处理 Pod 配置未变、但 status 字段发生变化的通知,按条件请求同步、重试资源调整或清理已退出的容器。 |
HandlePodSyncs |
遍历需要同步的 Pod,提交同步请求。 |
HandlePodCleanups |
核对期望 Pod、Pod Worker 记录和容器运行时对象,清理残留资源,并补交必要的创建或终止请求。 |
HandlePodAdditions
先将新增 Pod 的期望配置存入 Pod Manager。新增的普通 Pod 和 Static Pod 由 Allocation Manager 执行本地准入检查,正在终止或已经结束的 Pod 跳过检查。准入拒绝时记录失败状态,通过后向 Pod Worker 提交创建请求。
func (kl *Kubelet) HandlePodAdditions(ctx context.Context, pods []*v1.Pod) {
    start := kl.clock.Now()
    ...
    for _, pod := range pods {
        // 将新增 Pod 的期望配置保存到 Pod Manager。
        kl.podManager.AddPod(pod)
        ...

        // 正在终止或已经结束的 Pod 跳过本地准入检查。
        if !kl.podWorkers.IsPodTerminationRequested(pod.UID) &&
            !podutil.IsPodPhaseTerminal(pod.Status.Phase) {
            if ok, reason, message :=
                kl.allocationManager.AddPod(kl.GetActivePods(), pod); !ok {
                // 准入拒绝时,记录失败状态。
                kl.rejectPod(ctx, pod, reason, message)
                ...
                continue
            }
            ...
        }

        // 向对应 Pod Worker 提交创建请求。
        kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
            Pod:        pod,
            ...
            UpdateType: kubetypes.SyncPodCreate,
            StartTime:  start,
        })
    }
    ...
}
HandlePodUpdates
将新配置写入 Pod Manager,再向对应 Pod Worker 提交 SyncPodUpdate。请求携带当前 Pod 配置,删除标记等信息也会随配置传入,由后续同步处理。
func (kl *Kubelet) HandlePodUpdates(ctx context.Context, pods []*v1.Pod) {
    start := kl.clock.Now()
    ...
    for _, pod := range pods {
        ...

        // 更新期望配置。
        kl.podManager.UpdatePod(pod)

        ...

        // 将新配置交给对应 Pod Worker。
        kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
            Pod:        pod,
            ...
            UpdateType: kubetypes.SyncPodUpdate,
            StartTime:  start,
        })
    }
}
HandlePodRemoves
从 Pod Manager 移除期望记录,并通知 Allocation Manager 移除对应的分配记录。随后通过 deletePod 确认已收到所有已启用的 API Server、本地文件和 HTTP 来源的初始 Pod 列表,再向 Pod Worker 提交终止请求。
func (kl *Kubelet) HandlePodRemoves(ctx context.Context, pods []*v1.Pod) {
    start := kl.clock.Now()
    ...
    for _, pod := range pods {
        ...

        // 移除期望记录和对应的分配记录。
        kl.podManager.RemovePod(pod)
        kl.allocationManager.RemovePod(pod.UID)

        ...

        // 配置已移除,请求终止对应的 Pod。
        if err := kl.deletePod(ctx, pod); err != nil {
            ...
        }
    }
    ...
}

func (kl *Kubelet) deletePod(ctx context.Context, pod *v1.Pod) error {
    if pod == nil {
        return fmt.Errorf("deletePod does not allow nil pod")
    }

    // 等待各配置源提交初始信息。
    if !kl.sourcesReady.AllReady() {
        return fmt.Errorf("skipping delete because sources aren't ready yet")
    }
    ...

    // 向对应 Pod Worker 提交终止请求。
    kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
        Pod:        pod,
        UpdateType: kubetypes.SyncPodKill,
    })
    return nil
}
HandlePodReconcile
处理 Pod 配置未变、但 status 字段发生变化的通知。更新 Pod Manager 中的记录后,如果 Ready 条件需要更新,就向对应的 Pod Worker 提交同步请求。状态变化还可能触发 Allocation Manager 重试资源调整,或清理被驱逐 Pod 中已退出的容器。
func (kl *Kubelet) HandlePodReconcile(ctx context.Context, pods []*v1.Pod) {
    start := kl.clock.Now()
    ...
    for _, pod := range pods {
        ...

        // 保存包含最新 status 的 Pod 记录。
        kl.podManager.UpdatePod(pod)

        ...

        // Ready 条件需要更新时,向 Pod Worker 提交同步请求。
        if status.NeedToReconcilePodReadiness(pod) {
            kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
                Pod:        pod,
                ...
                UpdateType: kubetypes.SyncPodSync,
                StartTime:  start,
            })
        }
        ...
    }
    ...
}
HandlePodSyncs
遍历需要同步的 Pod,将当前期望配置放入 SyncPodSync 请求,交给对应的 Pod Worker。
func (kl *Kubelet) HandlePodSyncs(ctx context.Context, pods []*v1.Pod) {
    start := kl.clock.Now()
    ...
    for _, pod := range pods {
        ...

        // 为这个 Pod 提交同步请求。
        kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
            Pod:        pod,
            ...
            UpdateType: kubetypes.SyncPodSync,
            StartTime:  start,
        })
    }
}
HandlePodCleanups
HandlePodCleanups 核对节点上的 Pod 记录,清理已不再使用的资源,并补齐必要的创建或终止请求。它会对照期望配置、Pod Worker 记录和容器运行时对象,判断哪些 Pod 需要继续处理,哪些对象需要清理或终止。
- 核对记录:从 Pod Manager 取得期望配置,核对 Pod Worker 当前跟踪的 Pod。
- 查询容器运行时:刷新容器运行时缓存,取得仍有 Sandbox 或容器的 Pod 对象。
- 清理目录:对照期望配置和容器运行时对象,清理确认可移除的遗留目录。
- 恢复同步:对仍需运行、却没有 Pod Worker 记录的 Pod,提交
SyncPodCreate,并记录这个 Pod 已由 Pod Worker 接管。 - 删除收尾:Pod 带删除标记且已经结束,但没有对应 Pod Worker 和容器运行时对象时,以
Pod配置提交SyncPodKill,让 Pod Worker 完成剩余清理,再由 Status Manager 推进 API Server 中 Pod 对象的删除。 - 终止残留:容器运行时中仍有 Pod 的 Sandbox 或容器,但没有对应 Pod Worker 记录时,将容器运行时中的 Pod 对象放入
RunningPod,提交SyncPodKill,由 Pod Worker 停止残留的容器和 Sandbox。
func (kl *Kubelet) HandlePodCleanups(ctx context.Context) error {
    logger := klog.FromContext(ctx)
    ...

    // 从 Pod Manager 取得期望配置,核对 Pod Worker 当前跟踪的 Pod。
    allPods, mirrorPods, orphanedMirrorPodFullnames :=
        kl.podManager.GetPodsAndMirrorPods()
    workingPods := kl.podWorkers.SyncKnownPods(logger, allPods)
    ...

    // 刷新容器运行时缓存,取得仍有 Sandbox 或容器的 Pod 对象。
    if err := kl.runtimeCache.ForceUpdateIfOlder(ctx, kl.clock.Now()); err != nil {
        return err
    }
    runningRuntimePods, err := kl.runtimeCache.GetPods(ctx)
    if err != nil {
        return err
    }
    ...

    // 对照期望配置和容器运行时对象,清理确认可移除的遗留目录。
    err = kl.cleanupOrphanedPodDirs(logger, allPods, runningRuntimePods)
    if err != nil {
        ...
    }
    ...

    // 为仍需运行、没有 Pod Worker 记录的 Pod 提交 SyncPodCreate,恢复同步。
    activePods := kl.filterOutInactivePods(allPods)
    for _, pod := range activePods {
        if _, knownPod := workingPods[pod.UID]; knownPod {
            continue
        }
        ...
        kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
            UpdateType: kubetypes.SyncPodCreate,
            Pod:        pod,
            ...
        })

        // 将这个 Pod 的 UID 记入本轮 Pod Worker 记录,标记已接管。
        workingPods[pod.UID] = PodWorkerSync{
            ...
        }
        ...
    }
    ...

    // 对带删除标记且已结束、没有 Pod Worker 和容器运行时对象的 Pod,
    // 提交 SyncPodKill,完成剩余清理,再由 Status Manager 推进 API Server 中 Pod 对象的删除。
    for _, pod := range kl.filterTerminalPodsToDelete(
        allPods, runningRuntimePods, workingPods,
    ) {
        kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
            UpdateType: kubetypes.SyncPodKill,
            Pod:        pod,
        })
    }

    // 容器运行时中仍有 Pod 的 Sandbox 或容器、但没有 Pod Worker 记录时,
    // 将容器运行时中的 Pod 对象放入 RunningPod,提交 SyncPodKill,停止残留的容器和 Sandbox。
    for _, runningPod := range runningRuntimePods {
        _, knownPod := workingPods[runningPod.ID]
        if !knownPod {
            ...
            kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
                UpdateType: kubetypes.SyncPodKill,
                RunningPod: runningPod,
                ...
            })
            ...
        }
    }
    ...
    return nil
}
配置更新
PodConfig 比较各来源的新旧配置,将新增、更新和移除等变化封装为 PodUpdate,写入 syncLoopIteration 读取的 configCh。syncLoopIteration 按操作类型更新 Pod Manager 中的期望记录,并请求创建、同步或终止 Pod。
PLEG 事件
PLEG 发现 Sandbox 或容器状态变化后,先更新 Pod Cache,再将受影响的 Pod UID 和事件类型写入 plegCh。syncLoopIteration 筛选事件,从 Pod Manager 查询对应 Pod 的期望配置,找到配置后请求同步。
周期同步
Pod Worker 将 Pod UID 和下一次同步或重试时间记入共享的 workQueue。syncTicker 每秒通过 syncCh 提供检查信号。收到信号后,syncLoopIteration 调用 getPodsToSync,取出队列中已到执行时间的 Pod UID,与 Pod Manager 保存的完整配置匹配后,请求 Pod 同步。
探针结果
探针通过结果通道报告容器内应用的健康、就绪和启动情况。syncLoopIteration 根据 Readiness 结果更新容器的 Ready,根据 Startup 结果更新 Started,并请求 Pod 同步。Liveness 失败也会触发 Pod 同步,后续由 Runtime Manager 结合探测结果和重启策略,判断是否停止或重启容器。
资源状态
Device Manager、DRA Manager 根据 GPU、网卡等设备的健康变化,发送受影响的 Pod UID 列表,由 Container Manager 转发到统一通道。syncLoopIteration 查询对应 Pod 的期望配置并请求同步,后续同步再将设备健康信息纳入待上报状态。
Housekeeping
housekeepingCh 每两秒触发检查,syncLoopIteration 确认已收到所有已启用的 API Server、本地文件和 HTTP 来源的初始 Pod 列表后,调用 HandlePodCleanups。HandlePodCleanups 清理已不再使用的探针任务、状态缓存、目录和 cgroup 等资源。
Allocation Manager
Allocation Manager 负责 Pod 的本地准入检查,保存节点已批准的资源配置,并评估已有 Pod 的资源调整请求。Kubelet 根据检查结果向 Pod Worker 提交任务,由 Worker 调用相应方法完成资源准备、容器启动或资源调整。
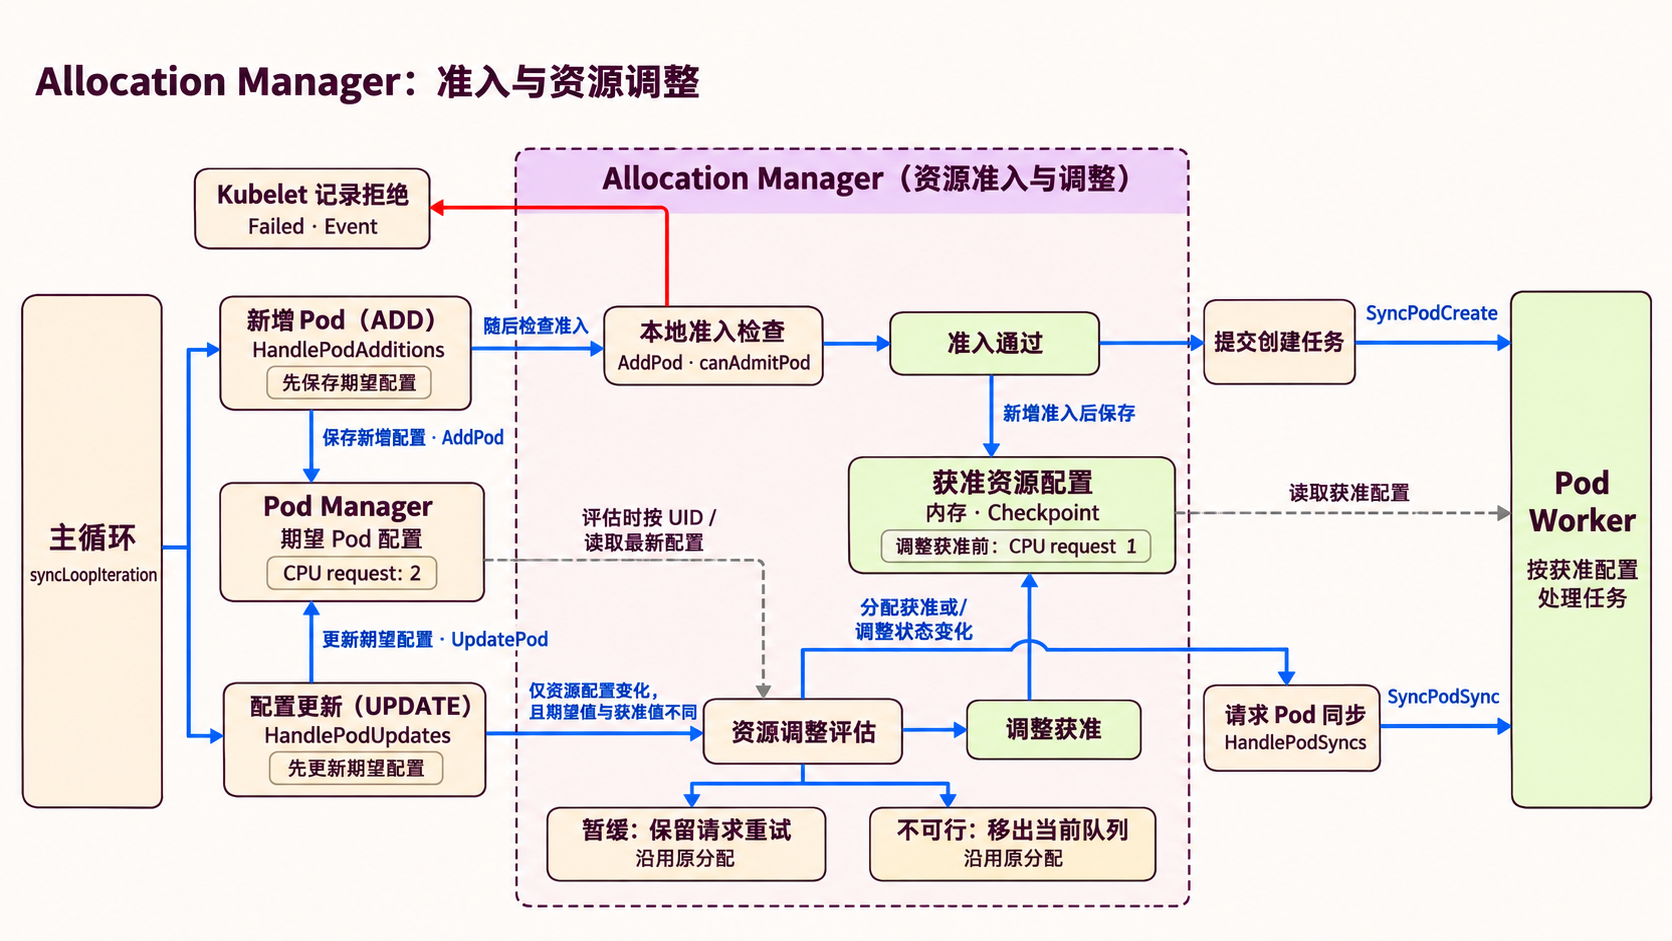
- 本地准入:检查节点当前能否接纳新增 Pod。Kubelet 根据返回结果提交创建任务,或记录拒绝原因和失败状态。
- 分配记录:保存节点已经批准的资源配置,供 Pod Worker 读取。新增准入通过和资源调整获准,都会更新这份记录。
- 原地调整:资源配置变化且期望值与获准值不同时,重新检查节点能否满足请求。获准后更新记录,暂缓或不可行时继续使用原分配。
本地准入
Scheduler 将 Pod 绑定到节点后,Kubelet 还需要检查节点当前能否接纳它。调度完成到节点处理配置之间,资源占用、设备健康状态或其他运行条件可能已经变化。
主循环收到新增配置事件 ADD 后,调用 Kubelet 的 HandlePodAdditions。该方法先将 Pod 保存到 Pod Manager,再对尚未请求终止、且未处于 Succeeded 或 Failed 终态的 Pod 调用 Allocation Manager 的 AddPod,执行本地准入检查。
UPDATE 由 HandlePodUpdates 处理,其中资源配置变化触发的准入检查在原地调整中介绍。
准入结果返回后,Kubelet 分别处理:
- 通过:调用 Pod Worker 的
UpdatePod,提交类型为SyncPodCreate的创建请求。Worker 执行任务时,再准备资源并启动容器。 - 拒绝:调用
rejectPod,记录警告事件,将 Pod 标记为Failed,并保存拒绝原因。
func (kl *Kubelet) HandlePodAdditions(ctx context.Context, pods []*v1.Pod) {
    start := kl.clock.Now()
    ...
    for _, pod := range pods {
        // 保存本次接收到的期望 Pod。
        kl.podManager.AddPod(pod)
        ...
        if !kl.podWorkers.IsPodTerminationRequested(pod.UID) && !podutil.IsPodPhaseTerminal(pod.Status.Phase) {
            // 对未请求终止、未处于终态的 Pod 执行本地准入检查。
            if ok, reason, message := kl.allocationManager.AddPod(kl.GetActivePods(), pod); !ok {
                kl.rejectPod(ctx, pod, reason, message)
                ...
                continue
            }
            ...
        }
        // 向 Pod Worker 提交创建请求。
        kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
            Pod:        pod,
            ...
            UpdateType: kubetypes.SyncPodCreate,
            StartTime:  start,
        })
    }
    ...
}
HandlePodAdditions 调用 Allocation Manager 的 AddPod,检查节点能否接纳当前 Pod。
- 资源核算:
pod是本次要检查的 Pod,allocatedPods是参与资源核算的 Pod 集合,其中已有分配记录的 Pod 采用获准资源值。canAdmitPod先排除当前 Pod,再结合其他 Pod 已占用的资源额度,判断剩余资源是否足够。 - 准入检查:
AddPod调用canAdmitPod,依次执行已注册处理器的Admit,检查资源、拓扑、安全配置和节点运行条件。任一处理器拒绝,就返回原因;全部通过才返回成功。 - 检查用途:
canAdmitPod通过Operation区分检查用途:新增 Pod 使用AddOperation,资源调整使用ResizeOperation。
例如,节点可分配 10 个 CPU,其他 Pod 已获准使用 8 个 CPU,当前 Pod 就只能在剩余的 2 个 CPU 额度内申请;其他准入条件仍需逐项检查。
func (m *manager) AddPod(activePods []*v1.Pod, pod *v1.Pod) (bool, string, string) {
    logger := klog.TODO()
    ...
    if utilfeature.DefaultFeatureGate.Enabled(features.InPlacePodVerticalScaling) {
        // 重启后已有记录时,按之前获准的资源配置检查准入。
        pod, _ = m.UpdatePodFromAllocation(pod)
    }
    // 按已有分配记录中的获准资源值,组织参与资源核算的 Pod 集合。
    allocatedPods := m.getAllocatedPods(activePods)
    // pod 是待检查对象,allocatedPods 提供核算已有资源占用的依据。
    ok, reason, message := m.canAdmitPod(logger, allocatedPods, pod, lifecycle.AddOperation)
    if ok && utilfeature.DefaultFeatureGate.Enabled(features.InPlacePodVerticalScaling) {
        // 保存这次准入获准的资源配置。
        if err := m.SetAllocatedResources(pod); err != nil {
            ...
        }
    }
    return ok, reason, message
}

func (m *manager) canAdmitPod(logger klog.Logger, allocatedPods []*v1.Pod, pod *v1.Pod, operation lifecycle.Operation) (bool, string, string) {
    // 排除当前检查的 Pod,避免重复计入它的资源。
    allocatedPods = slices.DeleteFunc(allocatedPods, func(p *v1.Pod) bool { return p.UID == pod.UID })
    // Pod 是待检查对象,OtherPods 用于核算其他 Pod 已占用的资源额度。
    attrs := &lifecycle.PodAdmitAttributes{Pod: pod, OtherPods: allocatedPods, Operation: operation}
    for _, podAdmitHandler := range m.admitHandlers {
        // 任一处理器拒绝,立即返回它给出的原因。
        if result := podAdmitHandler.Admit(attrs); !result.Admit {
            ...
            return false, result.Reason, result.Message
        }
    }
    return true, "", ""
}
分配记录
Allocation Manager 保存节点已经批准的资源配置,用户修改资源请求后,获准前仍然使用原分配。分配记录更新表示新请求已经获准,容器资源配置的实际更新在后续 Pod 同步中执行:
- 调整示例:容器的 CPU request 从
1改为2后,Pod Manager 保存的期望值已经是2。如果节点暂时无法批准,分配记录仍为1,Pod Worker 也继续采用1。 - 重启恢复:Allocation Manager 将获准资源配置写入本地检查点(Checkpoint)文件。Kubelet 重启后,从该文件恢复配置,继续处理尚未完成的调整。
- 功能开关:相关记录和调整路径由默认开启的
InPlacePodVerticalScaling功能开关控制。
PodResourceInfo 保存单个 Pod 的获准资源配置,PodResourceInfoMap 按 Pod UID 保存这些记录:
type PodResourceInfo struct {
    // 按容器名保存获准的 requests、limits。
    ContainerResources map[string]v1.ResourceRequirements
    // 保存 Pod 级资源配置,未设置时为 nil。
    PodLevelResources *v1.ResourceRequirements
}

// 按 Pod UID 保存各 Pod 的分配记录。
type PodResourceInfoMap map[types.UID]PodResourceInfo
例如,Pod UID 为 web-uid,容器名为 server,它的获准资源按以下关系保存:
PodResourceInfoMap["web-uid"]
    └── ContainerResources["server"]
            ├── Requests: cpu=1, memory=1Gi
            └── Limits:   cpu=2, memory=2Gi
Allocation Manager 的 AddPod 在准入通过后,调用 SetAllocatedResources 保存初始获准配置。已有 Pod 的资源调整获准后,也调用这个方法更新记录。
保存后的记录由 Pod Worker 读取。Kubelet 调用 Pod Worker 的 UpdatePod 提交任务时,后者会调用 Allocation Manager 的 UpdatePodFromAllocation,取得采用获准资源值的 Pod 配置:
- 读取记录:
UpdatePodFromAllocation通过状态存储的GetPodResourceInfo(pod.UID),按 UID 读取PodResourceInfoMap中对应的PodResourceInfo。 - 更新任务配置:按容器名从
ContainerResources读取已批准的 requests、limits。与传入配置不同时,复制 Pod,将副本中的资源字段替换为已批准的配置并返回;配置相同时返回原 Pod。 - 通知 PodWorker:Pod Worker 的
UpdatePod将返回的 Pod 放入pendingUpdate.Pod,再通过podUpdates通道通知对应 Worker。Worker 读取请求后,推进 Pod 同步。
例如,Pod Manager 中的期望 CPU request 为 2,分配记录中的获准值仍为 1,那么 Worker 收到的任务就采用 1;Pod Manager 继续保存期望值 2。
func (m *manager) SetAllocatedResources(pod *v1.Pod) error {
    logger := klog.TODO()
    // 将 Pod 资源转换为分配记录,交给状态存储。
    return m.allocated.SetPodResourceInfo(logger, pod.UID, allocationFromPod(pod))
}

func (m *manager) UpdatePodFromAllocation(pod *v1.Pod) (*v1.Pod, bool) {
    if pod == nil {
        return pod, false
    }
    // 状态存储按 UID 返回 PodResourceInfoMap 中对应的分配记录。
    allocated, ok := m.allocated.GetPodResourceInfo(pod.UID)
    if !ok {
        return pod, false
    }
    // 按容器名取出获准资源值,有差异时复制 Pod 并替换其资源字段。
    return updatePodFromAllocation(pod, allocated)
}
pendingUpdate 是保存待执行请求的 *UpdatePodOptions 字段。UpdatePod 先保存整份请求;启用原地资源调整时,再将采用获准资源值的 Pod 写回 pendingUpdate.Pod,最后通过通道通知 Worker:
func (p *podWorkers) UpdatePod(ctx context.Context, options UpdatePodOptions) {
    ...
    // 先保存整份请求,其中包含 Pod 配置。
    status.pendingUpdate = &options
    if utilfeature.DefaultFeatureGate.Enabled(features.InPlacePodVerticalScaling) {
        // 再将采用获准资源值的 Pod 写回请求的 Pod 字段。
        status.pendingUpdate.Pod, _ = p.allocationManager.UpdatePodFromAllocation(options.Pod)
    }
    ...
    // 通道发送通知,请求内容由 Worker 从 pendingUpdate 读取。
    select {
    case podUpdates <- struct{}{}:
    default:
    }
    ...
}
对应 Worker 收到通知后,读取并清空 pendingUpdate;正常同步时,再调用 Kubelet 的 SyncPod 处理请求,取出请求和执行任务的源码在执行循环中介绍。
原地调整
原地调整允许修改已有 Pod 中容器的 CPU、内存资源,保留原来的 Pod 对象。例如,将容器的 CPU request 从 1 增加到 2,Kubelet 收到新配置后,先判断节点能否批准,再向 Pod Worker 提交任务:
- 重启策略:
resizePolicy决定容器是否需要重启:NotRequired允许直接更新运行中的容器,RestartContainer要求重启容器后应用新值。配置方式见 Container resize policies。 - 配置接收:主循环收到配置更新后,调用
HandlePodUpdates。该方法先更新 Pod Manager,再检查资源字段是否变化、期望资源是否与获准配置不同。 - 调整评估:存在资源差异时,
HandlePodUpdates调用 Allocation Manager 的PushPendingResize,将 Pod UID 加入待调整列表,再调用RetryPendingResizes尝试评估。 - 任务提交:
HandlePodUpdates还会向 Pod Worker 提交SyncPodUpdate更新请求。调整尚未获准时,Worker 通过分配记录读取原来的获准资源值。
func (kl *Kubelet) HandlePodUpdates(ctx context.Context, pods []*v1.Pod) {
    start := kl.clock.Now()
    ...
    for _, pod := range pods {
        oldPod, _ := kl.podManager.GetPodByUID(pod.UID)
        kl.podManager.UpdatePod(pod)
        ...
        if utilfeature.DefaultFeatureGate.Enabled(features.InPlacePodVerticalScaling) {
            if recordResizeOperations(oldPod, pod) {
                _, updatedFromAllocation := kl.allocationManager.UpdatePodFromAllocation(pod)
                if updatedFromAllocation {
                    // 期望资源与获准配置不同,加入队列并尝试评估。
                    kl.allocationManager.PushPendingResize(pod.UID)
                    kl.allocationManager.RetryPendingResizes(allocation.TriggerReasonPodUpdated)
                } else {
                    kl.statusManager.ClearPodResizePendingCondition(pod.UID)
                }
            }
        }
        ...
        // 配置更新仍正常提交给 Worker。
        kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
            Pod:        pod,
            ...
            UpdateType: kubetypes.SyncPodUpdate,
            StartTime:  start,
        })
    }
    ...
}
待调整列表保存在 manager.podsWithPendingResizes 中,类型为 []types.UID,记录等待资源调整评估的 Pod UID。
type manager struct {
    ...
    // 保护待调整列表的并发访问。
    allocationMutex sync.Mutex
    // 保存等待资源调整评估的 Pod UID。
    podsWithPendingResizes []types.UID
    ...
}
PushPendingResize 检查已有 UID,再将新请求加入列表:
func (m *manager) PushPendingResize(uid types.UID) {
    ...
    m.allocationMutex.Lock()
    defer m.allocationMutex.Unlock()
    // 同一 Pod 已在列表中时,不再重复加入。
    for _, p := range m.podsWithPendingResizes {
        if p == uid {
            return
        }
    }

    // 保存本次需要调整资源的 Pod UID。
    m.podsWithPendingResizes = append(m.podsWithPendingResizes, uid)
    ...
}
配置更新和定时检查都会触发资源调整评估:
- 配置更新触发:
HandlePodUpdates先调用PushPendingResize保存 UID,再调用RetryPendingResizes。后者直接调用retryPendingResizes,在处理配置事件的当前 goroutine 中同步评估待调整请求。 - 定时触发:
Kubelet.Run调用 Allocation Manager 的Run,后者启动后台 goroutine。这个 goroutine 收到定时信号后,调用同一个retryPendingResizes,重新评估列表中保留的请求。
这两条路径检查的是节点能否批准资源调整。获准后的容器资源更新由 Pod Worker 在后续同步中推进。
定时路径的 Run 将循环放在独立 goroutine 中,定时器初始间隔为 30 秒:
func (m *manager) Run(ctx context.Context) {
    // 在后台定时检查待调整请求。
    go func() {
        logger := klog.FromContext(ctx)
        for {
            select {
            case <-m.ticker.C:
                // 定时触发与配置变化使用同一套评估逻辑。
                successfulResizes := m.retryPendingResizes(logger, triggerReasonPeriodic)
                ...
            case <-ctx.Done():
                m.ticker.Stop()
                return
            }
        }
    }()
}
每次评估前,retryPendingResizes 都检查是否已收齐所有已启用配置来源(API Server、本地文件或 HTTP)的初始 Pod 信息,避免启动期间漏算已有 Pod 的资源。未就绪时跳过本次评估,保留待调整列表,并将定时器重置为 30 秒;就绪后,才遍历列表,按 UID 查询最新的期望 Pod,逐个调用 handlePodResourcesResize 检查能否调整。
对仍有资源差异的请求,评估完成后,retryPendingResizes 根据结果处理队列:
- 获准:移出待调整队列,由 Kubelet 请求 Worker 同步。
- 暂缓:当前资源不足。 比如节点可分配 10 个 CPU,其他 Pod 已获准使用 8 个,当前 Pod 想从 1 个增加到 3 个,总需求变成 11 个。此次调整暂缓,继续使用原来的 1 个 CPU,并保留请求;其他 Pod 释放资源后再重试。
- 不可行:当前策略不支持这类调整。 比如节点采用 CPU Manager 的
static策略,一个 Guaranteed Pod 独占 2 个 CPU,想调整为 4 个;如果未开启独占 CPU 原地调整支持,即使节点有空闲 CPU,也会判定不可行。请求移出当前重试列表,继续使用原来的 2 个 CPU。 - 处理出错:保留请求,等待后续重试。
func (m *manager) RetryPendingResizes(trigger string) {
    logger := klog.TODO()
    // 直接在调用方的 goroutine 中执行评估。
    m.retryPendingResizes(logger, trigger)
}

func (m *manager) retryPendingResizes(logger klog.Logger, trigger string) []*v1.Pod {
    ...
    // 初始 Pod 信息尚未收齐时,保留请求并等待后续触发。
    if !m.sourcesReady.AllReady() {
        m.ticker.Reset(initialRetryDelay)
        return nil
    }
    // 配置源就绪后,将下一次定时检查安排在三分钟后。
    m.ticker.Reset(retryDelay)
    var newPendingResizes []types.UID
    var successfulResizes []*v1.Pod
    // 遍历待调整 UID,读取当前的期望 Pod。
    for _, uid := range m.podsWithPendingResizes {
        pod, found := m.getPodByUID(uid)
        if !found {
            ...
            continue
        }
        oldResizeStatus := m.statusManager.GetPodResizeConditions(uid)
        ...
        // 对单个 Pod 重新检查资源准入。
        resizeAllocated, err := m.handlePodResourcesResize(logger, pod)
        switch {
        case err != nil:
            // 出错时保留请求,等待后续重试。
            newPendingResizes = append(newPendingResizes, uid)
        case m.statusManager.IsPodResizeDeferred(uid):
            // 暂缓的请求继续保留在队列中。
            newPendingResizes = append(newPendingResizes, uid)
        case m.statusManager.IsPodResizeInfeasible(uid):
            // 不可行的请求不加入下一轮队列。
            ...
        default:
            // 记录已通过评估的 Pod,不再加入待调整队列。
            successfulResizes = append(successfulResizes, pod)
            ...
        }
        newResizeStatus := m.statusManager.GetPodResizeConditions(uid)
        // 分配获准或调整状态变化时,请求 Pod 同步。
        if resizeAllocated || !apiequality.Semantic.DeepEqual(oldResizeStatus, newResizeStatus) {
            m.triggerPodSync(pod)
        }
    }
    // 下一轮只保留暂缓或出错的请求。
    m.podsWithPendingResizes = newPendingResizes
    return successfulResizes
}
handlePodResourcesResize 通过 canAdmitPod 执行准入检查,操作类型为 ResizeOperation。获准后,调用 SetAllocatedResources 更新分配记录,并将调整状态设为进行中;未获准时,记录处理器返回的原因。
func (m *manager) handlePodResourcesResize(logger klog.Logger, pod *v1.Pod) (bool, error) {
    _, updated := m.UpdatePodFromAllocation(pod)
    if !updated {
        m.statusManager.ClearPodResizePendingCondition(pod.UID)
        return false, nil
    }
    // 再用同一组处理器检查这次资源调整。
    fit, reason, message := m.canAdmitPod(logger, m.getAllocatedPods(m.getActivePods()), pod, lifecycle.ResizeOperation)
    if fit {
        // 先保存获准配置,记录失败时交给外层重试。
        if err := m.SetAllocatedResources(pod); err != nil {
            return false, err
        }
        m.statusManager.ClearPodResizePendingCondition(pod.UID)
        m.statusManager.ClearPodResizeInProgressCondition(pod.UID)
        // 标记本次调整进入执行阶段。
        m.statusManager.SetPodResizeInProgressCondition(pod.UID, "", "", pod.Generation)
        ...
        return true, nil
    }
    if reason != "" {
        // 保存暂缓或不可行的原因,供状态发布和队列判断使用。
        if m.statusManager.SetPodResizePendingCondition(pod.UID, reason, message, pod.Generation) {
            ...
        }
    }
    return false, nil
}
Pod Worker
Pod Worker 负责单个 Pod 的同步、容器终止和资源清理。同一 Pod UID 的工作依次执行,不同 UID 可以并行执行。
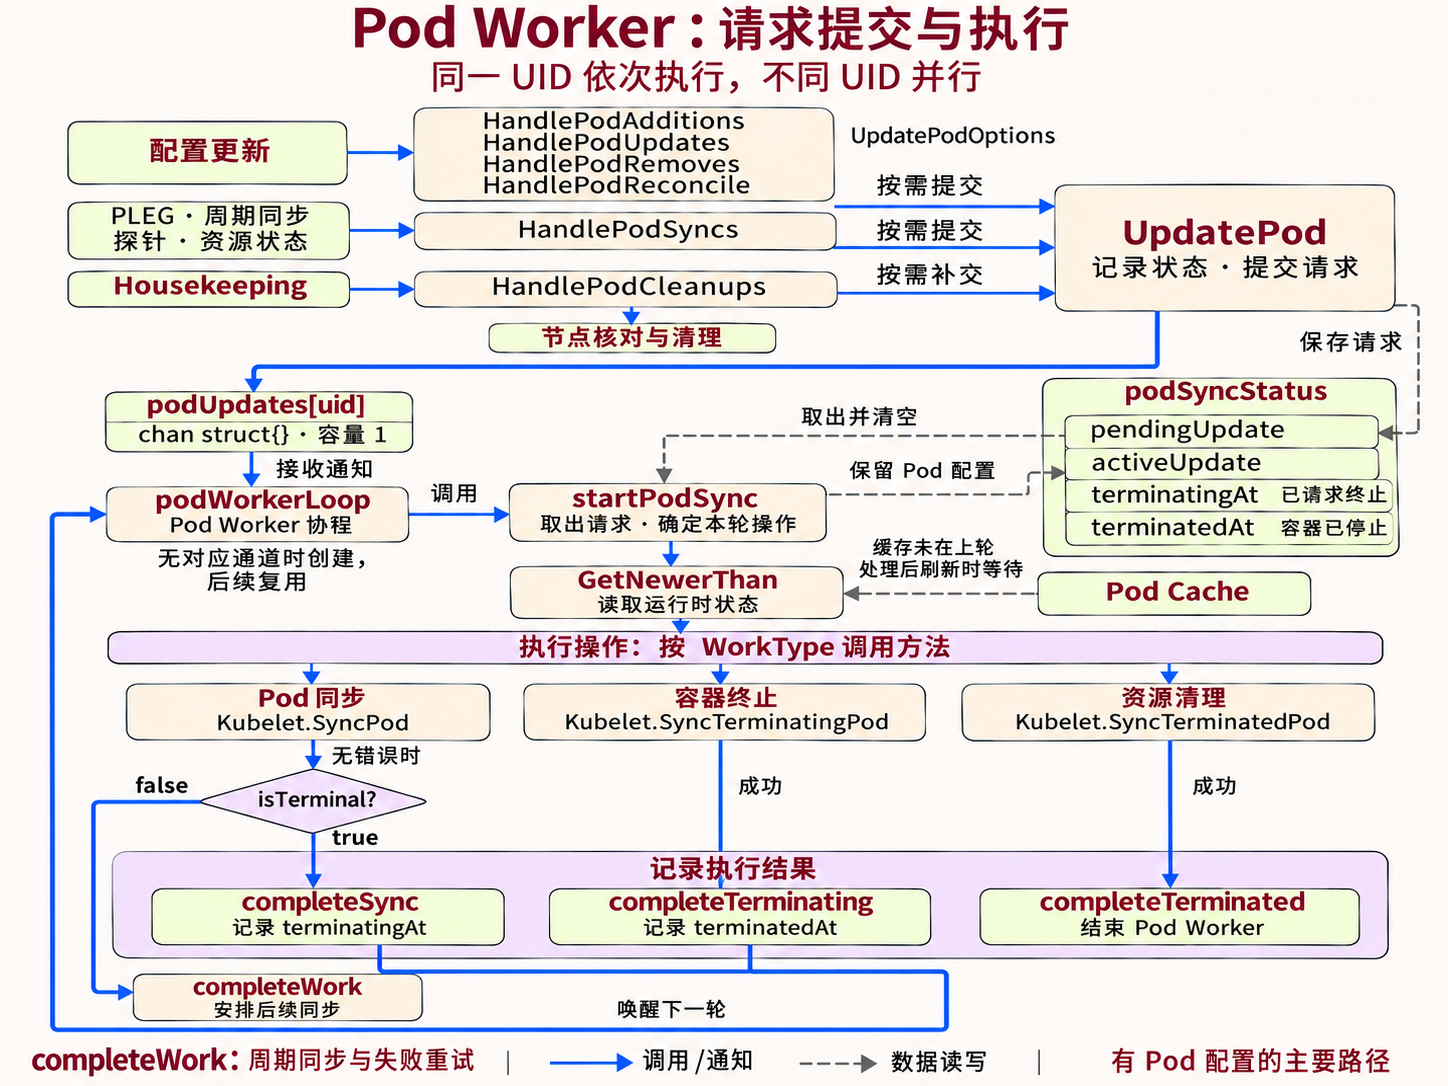
- 请求提交:各事件处理方法按需调用
UpdatePod,提交 Pod 配置和请求类型。UpdatePod保存请求,必要时创建 Pod Worker,再通过通知通道唤醒它。 - 执行循环:Pod Worker 收到通知后取出请求,读取 Pod Cache 中的容器运行时状态,按
WorkType选择本轮阶段,并根据执行结果安排后续工作。 - Pod 同步:
Kubelet.SyncPod生成 Pod 状态、准备节点资源并等待卷挂载,再由 Runtime Manager 计算和执行容器动作。 - 容器终止:
Kubelet.SyncTerminatingPod停止容器,确认退出并保存终止状态。成功后,Pod Worker 转入资源清理。 - 资源清理:
Kubelet.SyncTerminatedPod等待卷卸载,清理 Pod 的节点资源。清理成功后记录完成状态,结束对应 Pod Worker。
源码中,PodWorkers 是 Kubelet 使用的接口,podWorkers 是具体的管理结构体。它按 UID 保存各 Pod 的通知通道和处理状态,单个 Pod 的任务由对应的 podWorkerLoop 协程执行:
type PodWorkers interface {
    // 提交 Pod 的配置变化或处理请求。
    UpdatePod(ctx context.Context, options UpdatePodOptions)
    ...
}

type podWorkers struct {
    // 保护各 Pod 的处理状态与通知通道。
    podLock sync.Mutex

    // 按 Pod UID 保存通知通道,Pod Worker 收到信号后处理对应 Pod 的请求。
    podUpdates map[types.UID]chan struct{}

    // 按 Pod UID 保存 podSyncStatus 对象,记录待处理请求、
    // 已开始处理的 Pod 配置,以及请求终止和容器停止的时间。
    podSyncStatuses map[types.UID]*podSyncStatus
    ...
}
请求提交
Kubelet 主循环接收 Pod 配置更新、容器退出、探针结果等通知,也会定期检查需要同步或清理的 Pod。对应的事件处理方法再按需通过 podWorkers.UpdatePod 向 Pod Worker 提交创建、同步或终止请求。
请求通过 UpdatePodOptions 传入:
Pod:本轮处理的 Pod 配置。UpdateType:请求类型,区分创建、配置更新、普通同步和终止。
每个 Pod UID 对应的处理状态保存在 podWorkers 结构体的 podSyncStatuses 映射中,对应的值是 *podSyncStatus:
pendingUpdate:尚未取出的最新请求。Pod Worker 取出前,新请求可以替换它。activeUpdate:已经开始处理的配置与请求信息,供后续同步、终止和清理使用。terminatingAt:记录收到终止请求的时间,表示该 Pod 已请求终止。terminatedAt:记录容器终止完成的时间,表示该 Pod 的容器已停止,可以继续清理资源。
type UpdatePodOptions struct {
    // 创建、更新、普通同步或终止请求。
    UpdateType kubetypes.SyncPodType
    Pod        *v1.Pod
    ...
}

type podSyncStatus struct {
    ...
    // 保存该 Pod 最新的待处理请求;每次提交请求时更新,Pod Worker 取出后设为 nil。
    pendingUpdate *UpdatePodOptions

    // 保留该 Pod 最近已开始处理的配置;后续请求开始处理时更新,本轮结束后仍保留。
    activeUpdate *UpdatePodOptions
    ...
    // 已请求终止,以及容器终止完成的时间。
    terminatingAt time.Time
    terminatedAt  time.Time
    ...
}
UpdatePod 接收请求后,按以下顺序处理:
- 查找处理状态:按 Pod UID 从
p.podSyncStatuses查找对应的podSyncStatus,没有时创建并保存。它保存待处理请求、当前配置和执行进度。 - 记录终止请求:Pod 带有删除标记
deletionTimestamp、已进入Succeeded或Failed、收到SyncPodKill请求,或者属于容器运行时残留 Pod 时,记录terminatingAt,表示需要终止。后续startPodSync根据该记录选择容器终止操作。 - 准备通道和 Pod Worker:从
p.podUpdates[uid]取得通知通道;没有通道时,创建容量为 1 的chan struct{},再通过go启动对应的podWorkerLoop协程。该协程持续等待通道通知,收到后取出 Pod 配置和请求类型,执行Pod 同步、容器终止或资源清理。 - 保存请求并通知:先将整份请求写入
status.pendingUpdate;启用原地资源调整时,再更新请求中的Pod字段,使用获准的资源配置。完成后向通道发送空的struct{}{},唤醒 Pod Worker。
代码中的 outCh 是交给 Pod Worker 的只读接收端。正常路径中,它与局部变量 podUpdates 引用同一条通道:UpdatePod 写入通知,podWorkerLoop 接收通知。
func (p *podWorkers) UpdatePod(ctx context.Context, options UpdatePodOptions) {
    ...
    var isRuntimePod bool
    var uid types.UID
    var name, ns string
    if runningPod := options.RunningPod; runningPod != nil {
        ...
    } else {
        uid, ns, name = options.Pod.UID, options.Pod.Namespace, options.Pod.Name
    }
    ...
    p.podLock.Lock()
    defer p.podLock.Unlock()
    ...
    now := p.clock.Now()
    status, ok := p.podSyncStatuses[uid]
    if !ok {
        ...
        status = &podSyncStatus{
            ...
        }
        ...
        // 按 UID 保存这个 Pod 的处理状态。
        p.podSyncStatuses[uid] = status
    }
    ...
    pod := options.Pod
    if isRuntimePod {
        ...
    }
    ...
    var becameTerminating bool
    // 尚未请求终止时,检查本次请求是否需要终止 Pod。
    if !status.IsTerminationRequested() {
        switch {
        case isRuntimePod:
            status.deleted = true
            // 容器运行时残留 Pod 需要终止,记录终止请求时间。
            status.terminatingAt = now
            becameTerminating = true
        case pod.DeletionTimestamp != nil:
            status.deleted = true
            // Pod 已被标记删除,记录终止请求时间。
            status.terminatingAt = now
            becameTerminating = true
        case pod.Status.Phase == v1.PodFailed, pod.Status.Phase == v1.PodSucceeded:
            // Pod 已处于终态,记录终止请求时间。
            status.terminatingAt = now
            becameTerminating = true
        case options.UpdateType == kubetypes.SyncPodKill:
            ...
            // 收到显式终止请求,记录终止请求时间。
            status.terminatingAt = now
            becameTerminating = true
        }
    }
    ...
    podUpdates, exists := p.podUpdates[uid]
    if !exists {
        // 为这个 UID 创建通知通道,后续请求复用它。
        podUpdates = make(chan struct{}, 1)
        p.podUpdates[uid] = podUpdates
        ...
        var outCh <-chan struct{}
        if p.workerChannelFn != nil {
            ...
        } else {
            // 正常路径将同一通道的接收端交给 Pod Worker。
            outCh = podUpdates
        }
        // 启动独立协程,等待并处理这个 UID 的通知。
        go func() {
            ...
            p.podWorkerLoop(ctx, uid, outCh)
        }()
    }
    ...
    // 先保存整份请求,其中包含 Pod 配置。
    status.pendingUpdate = &options
    if utilfeature.DefaultFeatureGate.Enabled(features.InPlacePodVerticalScaling) {
        // 再将采用获准资源值的 Pod 写回请求的 Pod 字段。
        status.pendingUpdate.Pod, _ = p.allocationManager.UpdatePodFromAllocation(options.Pod)
    }
    ...
    status.working = true
    ...
    select {
    // 通道中只放唤醒信号。
    case podUpdates <- struct{}{}:
    default:
    }
    ...
}
执行循环
podWorkerLoop 在对应 Pod UID 的独立协程中运行,持续接收 podUpdates 通道的通知。每收到一次通知,就开始一轮处理:
- 取出请求:调用
startPodSync,从pendingUpdate取出UpdatePod保存的 Pod 配置和请求类型(创建、更新、同步或终止),并检查该 Pod 是否已请求终止、容器是否已停止,确定本轮执行阶段WorkType。 - 读取状态:通过
p.podCache.GetNewerThan读取 PLEG 维护的 Pod Cache,将结果保存到status,供本轮的阶段方法使用。要求缓存已经在上一轮处理结束后刷新过;如果还没刷新,就先等待刷新。 - 执行操作:前一个按
WorkType分支的switch调用对应的podSyncer方法,执行Pod 同步、容器终止或资源清理。 - 记录执行结果:后一个
switch先检查错误,再按本轮WorkType和方法返回值更新处理状态,决定下一轮执行什么或结束 Pod Worker。completeWork安排后续周期同步或失败重试。
func (p *podWorkers) podWorkerLoop(parentCtx context.Context, podUID types.UID, podUpdates <-chan struct{}) {
    var lastSyncTime time.Time
    // 等待这个 Pod UID 的通知,每次通知开始一轮处理。
    for range podUpdates {
        // 取出本轮请求,并检查是否允许执行。
        ctx, update, canStart, canEverStart, ok := p.startPodSync(parentCtx, podUID)
        if !ok {
            continue
        }
        logger := klog.FromContext(ctx)
        if !canEverStart {
            return
        }
        if !canStart {
            continue
        }
        ...
        var isTerminal bool
        // 读取 Pod Cache 并执行阶段方法,错误交给下方统一处理。
        err := func() error {
            var status *kubecontainer.PodStatus
            var err error
            switch {
            case update.Options.RunningPod != nil:
                ...
            default:
                // 读取上轮处理结束后重新确认过的 Pod 状态;缓存不够新时等待刷新。
                status, err = p.podCache.GetNewerThan(update.Options.Pod.UID, lastSyncTime)
                if err != nil {
                    ...
                    return err
                }
            }
            var postSync func()
            // 执行操作:按本轮 WorkType 调用对应的 podSyncer 方法。
            switch {
            case update.WorkType == TerminatedPod:
                // 容器已停止,清理节点资源。
                err = p.podSyncer.SyncTerminatedPod(ctx, update.Options.Pod, status)
            case update.WorkType == TerminatingPod:
                var gracePeriod *int64
                if opt := update.Options.KillPodOptions; opt != nil {
                    gracePeriod = opt.PodTerminationGracePeriodSecondsOverride
                }
                podStatusFn := p.acknowledgeTerminating(logger, podUID)
                if update.Options.RunningPod != nil {
                    ...
                } else {
                    // 停止容器并保存退出状态。
                    err = p.podSyncer.SyncTerminatingPod(ctx, update.Options.Pod, status, gracePeriod, podStatusFn)
                }
            default:
                // 根据 Pod 配置和运行状态执行Pod 同步。
                isTerminal, postSync, err = p.podSyncer.SyncPod(ctx, update.Options.UpdateType, update.Options.Pod, update.Options.MirrorPod, status)
            }
            lastSyncTime = p.clock.Now()
            // SyncPod 返回了 postSync 回调时,才执行这个同步后的动作。
            if postSync != nil {
                postSync()
            }
            return err
        }()

        var phaseTransition bool
        // 记录执行结果:检查错误,再按本轮未改变的 WorkType 处理完成状态。
        switch {
        ...
        // 执行失败时不标记阶段完成,后续由 completeWork 安排重试。
        case err != nil:
            ...
        case update.WorkType == TerminatedPod:
            // 清理成功,记录完成并结束 Pod Worker。
            p.completeTerminated(logger, podUID)
            ...
            return
        case update.WorkType == TerminatingPod:
            ...
            // SyncTerminatingPod 成功后,记录 terminatedAt 并通知 Pod Worker 接着清理资源。
            p.completeTerminating(logger, podUID)
            phaseTransition = true
        case isTerminal:
            // 记录 terminatingAt 并通知 Pod Worker,本轮结束后接着停止容器。
            p.completeSync(logger, podUID)
            phaseTransition = true
        }
        // 安排周期同步或失败重试;已有待处理请求时立即通知 Pod Worker。
        p.completeWork(logger, podUID, phaseTransition, err)
        ...
    }
}
startPodSync 在每轮开始时由 podWorkerLoop 调用,取出 Pod 配置,并判断本轮要执行Pod 同步、容器终止还是资源清理:
- 取出请求:从
p.podSyncStatuses[podUID]找到当前 Pod 的处理状态,将pendingUpdate中的请求取到update.Options,再清空pendingUpdate;没有请求就跳过本轮。 - 选择本轮操作:调用
status.WorkType(),容器已停止则清理资源,已请求终止则停止容器,其余情况执行Pod 同步。结果保存到update.WorkType。 - 保留 Pod 配置:调用
mergeLastUpdate,将本轮开始处理的 Pod 配置保存到activeUpdate;同一个 Pod 的配置发生变化并开始处理后,再更新这里的配置。后续需要停止容器或清理资源时,若pendingUpdate为空,就复制activeUpdate中保存的信息,准备后续请求。
func (p *podWorkers) startPodSync(parentCtx context.Context, podUID types.UID) (ctx context.Context, update podWork, canStart, canEverStart, ok bool) {
    p.podLock.Lock()
    defer p.podLock.Unlock()
    status, ok := p.podSyncStatuses[podUID]
    if !ok {
        return nil, update, false, false, false
    }
    ...
    if status.pendingUpdate == nil {
        ...
        return nil, update, false, false, false
    }
    // 选择本轮操作:Pod 同步、停止容器或清理资源。
    update.WorkType = status.WorkType()
    // 取出请求:保存到本轮的 Options,再清空待处理请求。
    update.Options = *status.pendingUpdate
    status.pendingUpdate = nil
    ...
    ctx = status.ctx
    if status.IsStarted() {
        // 已开始处理过该 Pod,保留本轮 Pod 配置后直接返回。
        status.mergeLastUpdate(update.Options)
        return ctx, update, true, true, true
    }
    ...
    // 首次开始处理这个 Pod 时,记录开始时间。
    status.startedAt = p.clock.Now()
    // 保留本轮使用的 Pod 配置,供后续请求复用。
    status.mergeLastUpdate(update.Options)
    ...
    return ctx, update, true, true, true
}

func (s *podSyncStatus) WorkType() PodWorkerState {
    // 容器已停止,下一阶段清理资源。
    if s.IsTerminated() {
        return TerminatedPod
    }
    // 已收到终止请求,下一阶段停止容器。
    if s.IsTerminationRequested() {
        return TerminatingPod
    }
    return SyncPod
}

func (s *podSyncStatus) mergeLastUpdate(other UpdatePodOptions) {
    opts := s.activeUpdate
    if opts == nil {
        opts = &UpdatePodOptions{}
        // 创建用于保留已开始处理配置的 activeUpdate。
        s.activeUpdate = opts
    }
    // 保存本轮开始处理的 Pod 配置;同一个 Pod 的配置变化并开始处理后,再更新这里。
    if opts.Pod == nil || other.RunningPod == nil {
        opts.Pod = other.Pod
    }
    ...
}
下图展示同一个 Pod 在配置更新和继续清理资源时,pendingUpdate 与 activeUpdate 的变化。
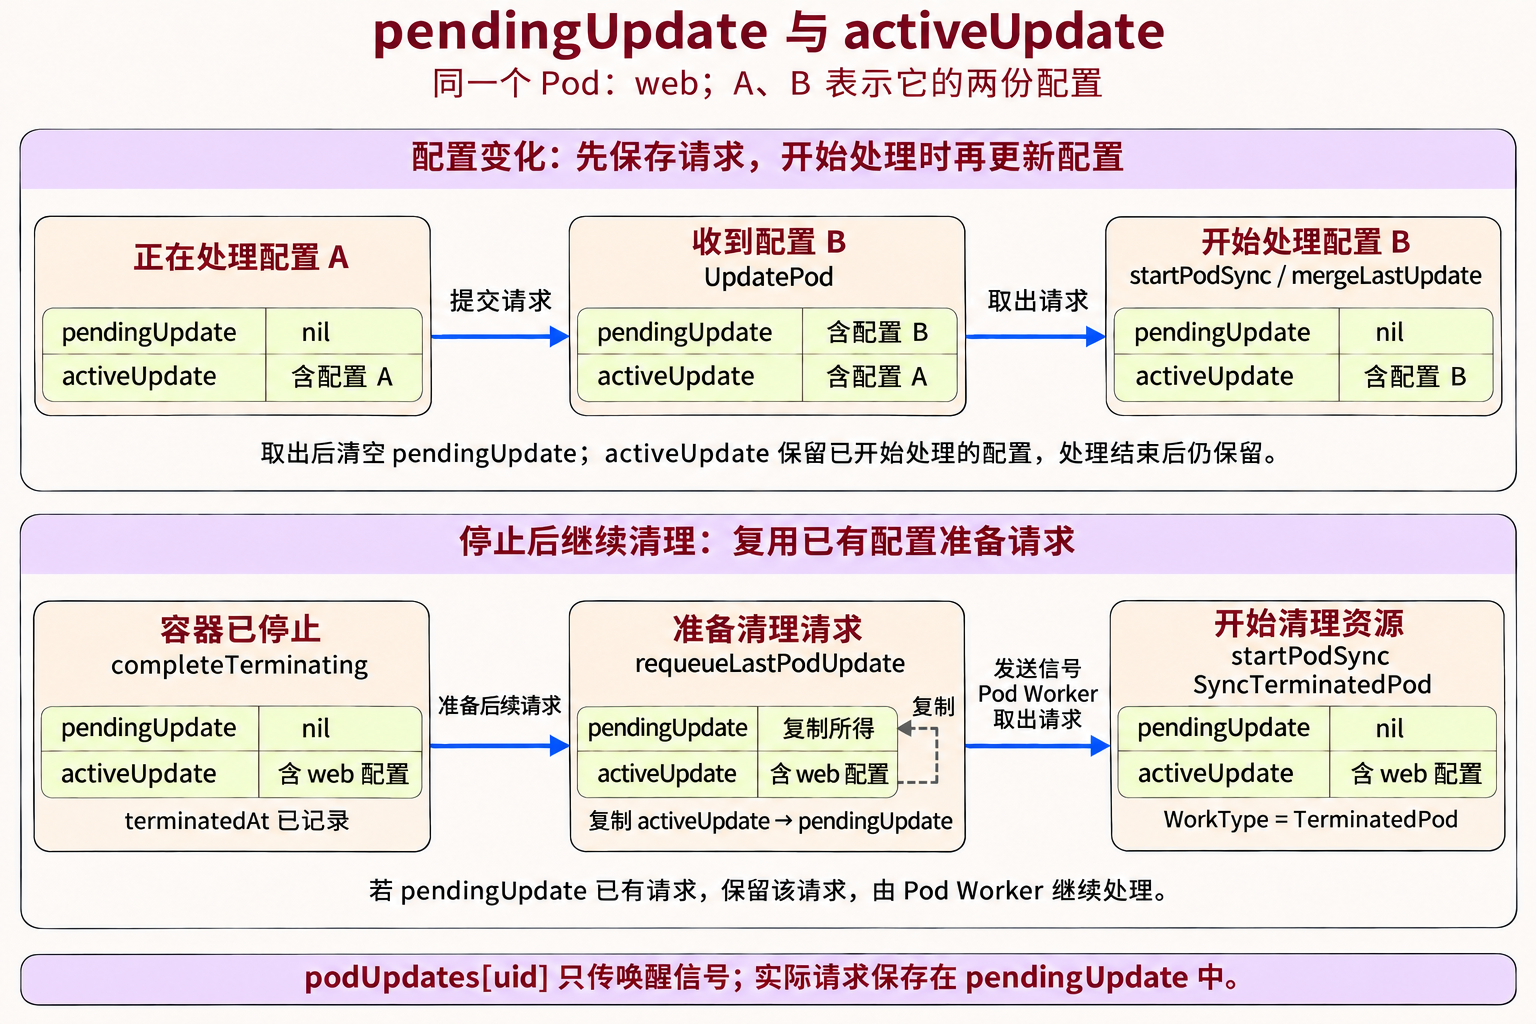
Pod 同步确认 Pod 已结束后,podWorkerLoop 调用 completeSync,通过 terminatingAt 标记该 Pod 需要终止;容器停止成功后,调用 completeTerminating,通过 terminatedAt 标记容器已全部停止,可以继续清理节点资源。
这两个方法都会调用 requeueLastPodUpdate,为同一个 Pod 准备后续请求:
- 保留已有请求:
pendingUpdate不为空,表示已经有请求等待 Pod Worker 处理,直接保留该请求并返回。 - 准备后续请求:
pendingUpdate为空时,从activeUpdate复制已保存的配置等信息,放入pendingUpdate,供 Pod Worker 继续终止或清理。复制后,activeUpdate仍然保留;如果它也为空,则直接返回。 - 通知 Pod Worker:向同一个
podUpdates[podUID]通道发送信号。podWorkerLoop收到后调用startPodSync,取出请求,并根据已记录的终止状态选择容器终止或资源清理。已有请求时,后续的completeWork会发送通知。
例如,web 的容器停止成功后,若期间没有其他请求到达,就复用 activeUpdate 准备清理请求,再通过通道通知 Pod Worker 继续处理。
func (p *podWorkers) requeueLastPodUpdate(podUID types.UID, status *podSyncStatus) {
    // 已有请求时保留它;没有已开始处理的配置时,无法准备后续请求。
    if status.pendingUpdate != nil || status.activeUpdate == nil {
        return
    }

    // 复制 activeUpdate 保存的信息,作为同一个 Pod 的后续请求。
    copied := *status.activeUpdate
    status.pendingUpdate = &copied

    // 标记这个 Pod 有请求等待处理。
    status.working = true
    select {
    // 向原来的通道发送信号,让 podWorkerLoop 继续处理。
    case p.podUpdates[podUID] <- struct{}{}:
    default:
    }
}
Pod 同步
Kubelet.SyncPod 根据 Pod 配置、容器运行时状态和探针结果,完成一轮同步。它生成 Pod 状态,检查网络、准备节点目录并等待卷挂载,再调用 Runtime Manager 执行容器操作。
这里的参数 podStatus 就是执行循环中从 Pod Cache 读取的 status,在调用 Kubelet.SyncPod 时传入。
三个返回值分别影响后续处理:
isTerminal:为false时继续 Pod 同步;为true且没有错误时,转入容器终止。postSync:本轮存在操作结果且没有错误时,返回一个请求刷新 Pod Cache 的回调;其他情况为nil。Pod Worker 在SyncPod返回后检查并调用它。err:本轮错误,交给 Pod Worker 安排后续处理。
func (kl *Kubelet) SyncPod(ctx context.Context, updateType kubetypes.SyncPodType, pod, mirrorPod *v1.Pod, podStatus *kubecontainer.PodStatus) (isTerminal bool, postSync func(), err error) {
    ...
    logger := klog.FromContext(ctx)
    ...
    // 根据 Pod 配置和 Pod Cache 提供的容器状态、退出码,生成 API 使用的 PodStatus。
    // false 表示仍需考虑重启策略,判断 Pod 是继续运行,还是进入 Succeeded / Failed。
    apiPodStatus := kl.generateAPIPodStatus(ctx, pod, podStatus, false)
    ...
    // Pod 已进入 Succeeded 或 Failed 状态时,保存状态并返回 isTerminal=true。
    // Pod Worker 收到结果后记录终止请求,接着停止容器并清理资源。
    if apiPodStatus.Phase == v1.PodSucceeded || apiPodStatus.Phase == v1.PodFailed {
        kl.statusManager.SetPodStatus(logger, pod, apiPodStatus)
        isTerminal = true
        return isTerminal, nil, nil
    }
    ...
    // 等待卷准备好,再执行后续容器动作。
    if err := kl.volumeManager.WaitForAttachAndMount(ctx, pod); err != nil {
        ...
        return false, nil, err
    }
    pullSecrets := kl.getPullSecretsForPod(logger, pod)
    kl.probeManager.AddPod(ctx, pod)
    ...
    sctx := context.WithoutCancel(ctx)
    restartingAllContainers := false
    ...
    // Runtime Manager 计算并执行容器动作。
    result := kl.containerRuntime.SyncPod(sctx, pod, podStatus, pullSecrets, kl.crashLoopBackOff, restartingAllContainers)
    ...
    err = result.Error()
    // 有操作结果且无错误时,返回刷新 Pod Cache 的回调;否则保持 nil。
    if len(result.SyncResults) > 0 && err == nil {
        postSync = func() {
            kl.RequestPodRelist(pod.UID)
        }
    }
    return false, postSync, err
}
容器终止
Pod Worker 确定需要停止容器后,调用 SyncTerminatingPod 完成以下处理:
- 修改 Pod 状态:先生成 Pod 状态。普通删除请求不附带
podStatusFn;节点压力驱逐请求则通过该回调,将Phase设为Failed、Reason设为Evicted。随后交给 Status Manager 保存。 - 停止容器:停止 Liveness 与 Startup 探测,再通过
killPod请求 Runtime Manager 按gracePeriod指定的终止宽限期停止容器。 - 确认退出:重新查询容器运行时,确认没有仍运行的容器,并保存退出码等终止信息。
- 完成终止:成功返回后,
podWorkerLoop调用completeTerminating记录容器已停止,下一轮执行资源清理;返回错误时,由completeWork安排重试。
func (kl *Kubelet) SyncTerminatingPod(ctx context.Context, pod *v1.Pod, podStatus *kubecontainer.PodStatus, gracePeriod *int64, podStatusFn func(*v1.PodStatus)) (err error) {
    ...
    logger := klog.FromContext(ctx)
    ...
    apiPodStatus := kl.generateAPIPodStatus(ctx, pod, podStatus, false)
    // 普通删除不附带回调;节点压力驱逐通过回调将 Phase 设为 Failed、Reason 设为 Evicted。
    if podStatusFn != nil {
        podStatusFn(&apiPodStatus)
    }
    kl.statusManager.SetPodStatus(logger, pod, apiPodStatus)
    ...
    // 停止存活与启动探测,再请求停止容器。
    kl.probeManager.StopLivenessAndStartup(pod)
    p := kubecontainer.ConvertPodStatusToRunningPod(kl.getRuntime().Type(), podStatus)
    if err := kl.killPod(ctx, pod, p, gracePeriod); err != nil {
        ...
        // 停止容器失败,返回 podWorkerLoop,由 completeWork 安排重试。
        return fmt.Errorf("error killing terminating pod: %w", err)
    }
    kl.probeManager.RemovePod(pod)
    runtimePod, err := kl.containerRuntime.GetPod(ctx, pod.UID)
    ...
    // 重新查询容器状态,保存最终退出信息。
    stoppedPodStatus, err := kl.containerRuntime.GetPodStatus(ctx, runtimePod)
    if err != nil {
        ...
        // 无法取得退出状态,返回 podWorkerLoop,由 completeWork 安排重试。
        return fmt.Errorf("unable to read pod status prior to final pod termination: %w", err)
    }
    preserveDataFromBeforeStopping(stoppedPodStatus, podStatus)
    var runningContainers []string
    ...
    for _, s := range stoppedPodStatus.ContainerStatuses {
        if s.State == kubecontainer.ContainerStateRunning {
            runningContainers = append(runningContainers, s.ID.String())
        }
        ...
    }
    // 仍有容器运行时返回错误,由 podWorkerLoop 调用 completeWork 安排重试。
    if len(runningContainers) > 0 {
        return fmt.Errorf("detected running containers after a successful KillPod, CRI violation: %v", runningContainers)
    }
    ...
    apiPodStatus = kl.generateAPIPodStatus(ctx, pod, stoppedPodStatus, true)
    kl.statusManager.SetPodStatus(logger, pod, apiPodStatus)
    ...
    // 成功返回,由 podWorkerLoop 调用 completeTerminating 记录容器已停止并安排资源清理。
    return nil
}
资源清理
容器终止完成后,Pod Worker 的状态允许后台卷管理卸载该 Pod 的卷。SyncTerminatedPod 等待卷卸载与卷路径清理完成,再按配置删除该 Pod 对应的 Linux cgroup,释放用户命名空间分配。
最后,它调用 statusManager.TerminatePod,告知 Status Manager 节点侧终止清理已经完成:
func (kl *Kubelet) SyncTerminatedPod(ctx context.Context, pod *v1.Pod, podStatus *kubecontainer.PodStatus) error {
    ...
    logger := klog.FromContext(ctx)
    ...
    // 容器停止后,等待卷管理完成卸载。
    if err := kl.volumeManager.WaitForUnmount(ctx, pod); err != nil {
        return err
    }
    ...
    if kl.cgroupsPerQOS {
        pcm := kl.containerManager.NewPodContainerManager()
        name, _ := pcm.GetPodContainerName(pod)
        // 删除该 Pod 对应的 Linux cgroup。
        if err := pcm.Destroy(logger, name); err != nil {
            return err
        }
        ...
    }
    kl.usernsManager.Release(logger, pod.UID)
    // 告知 Status Manager,节点侧终止清理已完成。
    kl.statusManager.TerminatePod(logger, pod)
    ...
    return nil
}
Runtime Manager
Runtime Manager 根据 Pod 的期望配置和当前运行状态,确定需要创建、启动或停止哪些 Sandbox 与容器,再通过 CRI 请求容器运行时执行这些操作。
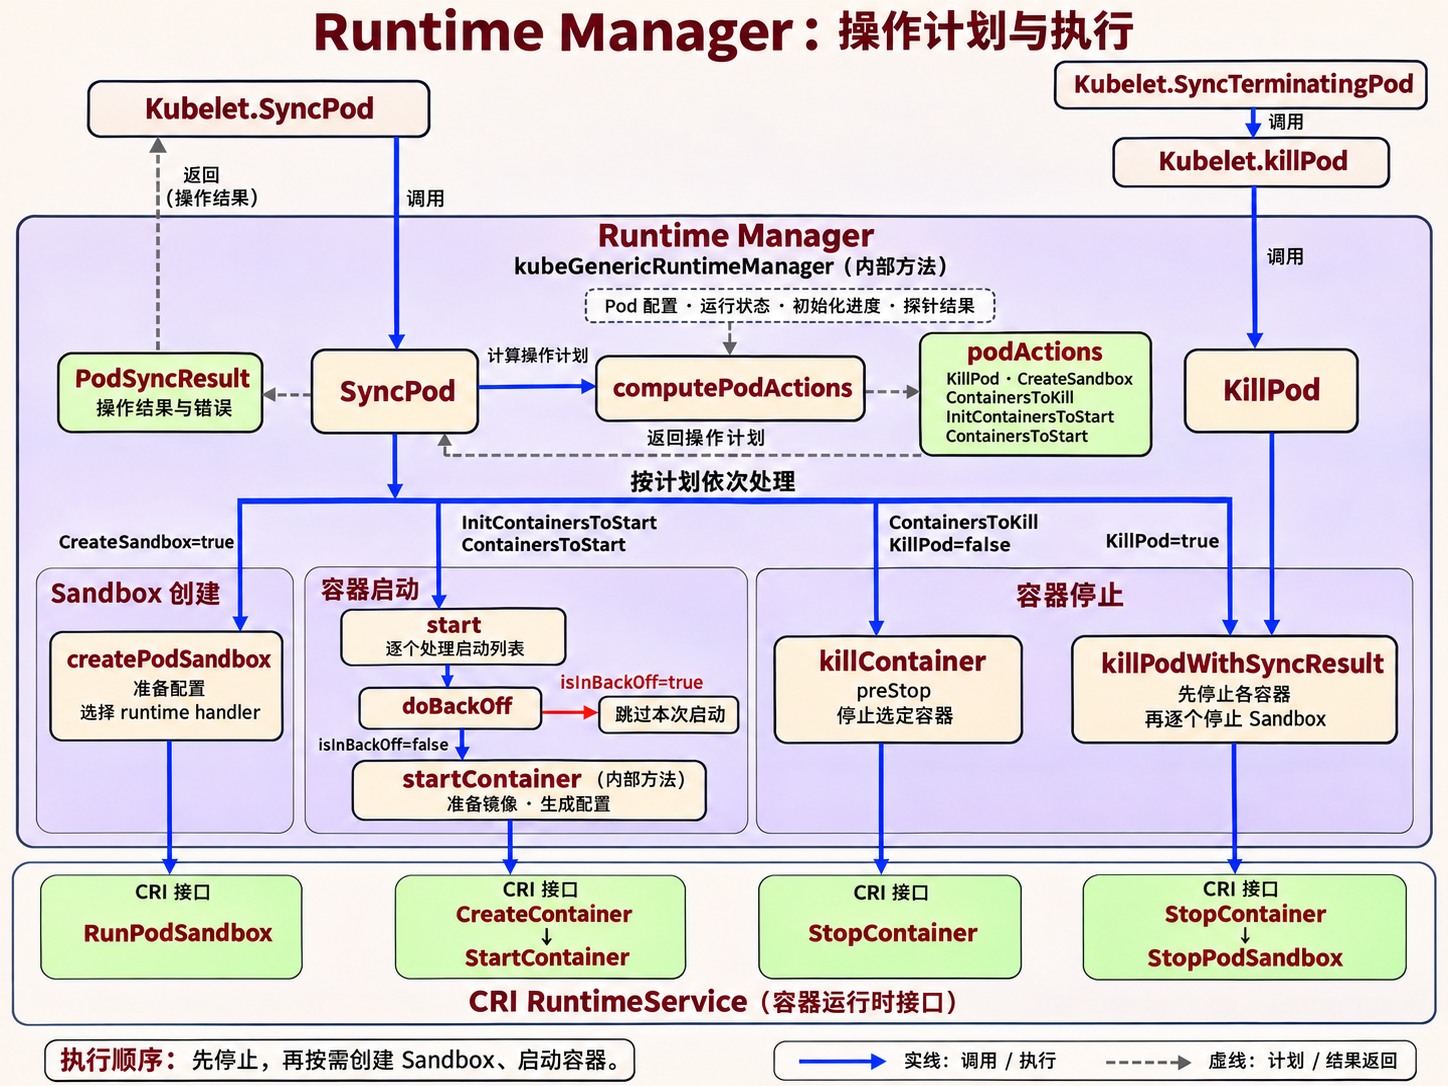
- Pod 同步:接收配置与运行状态,计算操作计划,再执行并返回结果。
- Sandbox 创建:准备 Pod 级运行环境配置,调用
RunPodSandbox。 - 容器启动:检查重启退避,准备镜像与配置,再创建和启动容器。
- 容器停止:执行
preStop、处理宽限期并停止容器;停止整个 Pod 时,还会停止 Sandbox。
Pod 同步
Pod Worker 执行同步任务时,会调用 Kubelet.SyncPod。Kubelet 完成卷挂载等准备工作后,通过 kl.containerRuntime.SyncPod 调用 kubeGenericRuntimeManager.SyncPod,由后者计算并执行操作计划。
Kubelet.SyncPod 传入的主要信息包括:
pod:期望运行的 Pod 配置,包括容器、镜像、卷和资源要求。podStatus:已观察到的 Sandbox、容器状态和 Pod IP,由 Pod Worker 从 Pod Cache 中取得。pullSecrets:通过getPullSecretsForPod获取的镜像拉取凭据。backOff:由kl.crashLoopBackOff传入的重启退避记录,用于判断当前能否再次尝试启动容器。
func (kl *Kubelet) SyncPod(
    ctx context.Context,
    updateType kubetypes.SyncPodType,
    pod, mirrorPod *v1.Pod,
    podStatus *kubecontainer.PodStatus,
) (isTerminal bool, postSync func(), err error) {
    ...
    // 获取 Pod 使用的镜像拉取凭据。
    pullSecrets := kl.getPullSecretsForPod(logger, pod)
    ...
    // 将配置、运行状态和启动控制信息交给 Runtime Manager。
    result := kl.containerRuntime.SyncPod(
        sctx, pod, podStatus, pullSecrets,
        kl.crashLoopBackOff, restartingAllContainers,
    )
    ...
}
kubeGenericRuntimeManager.SyncPod 先调用 computePodActions,比较期望配置与实际状态。computePodActions 返回 podActions 后,kubeGenericRuntimeManager.SyncPod 继续读取并执行这份计划:
- Sandbox 操作:记录是否需要停止或创建 Sandbox,以及已有 Sandbox 的 ID。
- Init Container 启动列表:
InitContainersToStart记录本轮需要启动的 Init Container 在pod.Spec.InitContainers中的索引。 - 业务容器启动列表:
ContainersToStart记录本轮需要启动的业务容器在pod.Spec.Containers中的索引。例如,1对应第二个业务容器。 - 容器停止列表:通过容器运行时分配的 ID,定位需要停止的容器实例。
type podActions struct {
    // 停止 Pod 中的容器与 Sandbox。
    KillPod bool
    // 创建新的 Sandbox。
    CreateSandbox bool
    // 已有 Sandbox 的 ID。
    SandboxID string
    // 本轮需要启动的 Init Container 在 pod.Spec.InitContainers 中的索引。
    InitContainersToStart []int
    // 本轮需要启动的业务容器在 pod.Spec.Containers 中的索引。
    ContainersToStart    []int
    // 需要停止的容器,以容器运行时分配的 ID 为键。
    ContainersToKill map[kubecontainer.ContainerID]containerToKillInfo
    ...
}
computePodActions 在局部变量 changes 中逐步填充计划,并通过 return changes 返回。调用方 kubeGenericRuntimeManager.SyncPod 将返回值保存在 podContainerChanges 中:
- Sandbox 计划:判断是否需要重建,设置
KillPod、CreateSandbox和已有 Sandbox ID;重建时还要安排所需容器的启动。 - Init Container 启动:本轮需要启动的 Init Container,其配置索引写入
InitContainersToStart。 - 业务容器启动:本轮需要启动的业务容器,其配置索引写入
ContainersToStart。 - 停止列表:仍在运行但配置变化、探针失败等条件要求替换的容器,其实例 ID 写入
ContainersToKill。需要重启时,该容器同时进入启动列表。
podActions 示例
Pod 配置
apiVersion: v1
kind: Pod
metadata:
  name: pod-actions-example
spec:
  restartPolicy: Always
  initContainers:
    # Init Container 索引 0。
    - name: init
      image: busybox:1.36
      command: ["sh", "-c", "echo init-complete"]
  containers:
    # 业务容器索引 0。
    - name: a
      image: busybox:1.36
      command: ["sh", "-c", "touch /tmp/healthy; sleep 3600"]
      livenessProbe:
        exec:
          command: ["test", "-f", "/tmp/healthy"]
        periodSeconds: 5
        failureThreshold: 3
    # 业务容器索引 1。
    - name: b
      image: busybox:1.36
      command: ["sleep", "3600"]
首次启动
Runtime Manager 将首次创建和重建 Sandbox 按同一流程处理:先停止旧容器和旧 Sandbox,再创建新 Sandbox。判断需要创建 Sandbox 时,先将 KillPod 和 CreateSandbox 都设为 true。
首次启动时,没有旧容器和旧 Sandbox,停止步骤没有对象可处理;随后创建 Sandbox,启动 init。
{
  "KillPod": true,
  "CreateSandbox": true,
  "SandboxID": "",
  "ContainersToKill": {},
  "InitContainersToStart": [0],
  "ContainersToStart": []
}
初始化完成
后续同步观察到普通 Init Container init 已成功完成,Sandbox 正常,业务容器尚未创建。本轮保留 Sandbox,安排启动 a、b。
{
  "KillPod": false,
  "CreateSandbox": false,
  "SandboxID": "sandbox-existing",
  "ContainersToKill": {},
  "InitContainersToStart": [],
  "ContainersToStart": [0, 1]
}
单容器重启
Pod 已正常运行,只有 a 的 Liveness 探针判定失败,b 和 Sandbox 正常。本轮把 a 的旧实例 ID 写入停止列表,把它的配置索引写入启动列表,先停止旧实例,再尝试启动新实例。
{
  "KillPod": false,
  "CreateSandbox": false,
  "SandboxID": "sandbox-existing",
  "ContainersToKill": {
    "container-a-old": {
      "name": "a"
    }
  },
  "InitContainersToStart": [],
  "ContainersToStart": [0]
}
Sandbox 重建
已有 Sandbox 变为非 Ready 状态,需要重建运行环境。本轮通过 KillPod=true 停止旧容器和 Sandbox,因此无需逐个填充 ContainersToKill;随后创建新 Sandbox,并从 init 重新开始初始化。计划中的 SandboxID 是旧 Sandbox 的 ID。
func (m *kubeGenericRuntimeManager) computePodActions(
    ctx context.Context,
    pod *v1.Pod,
    podStatus *kubecontainer.PodStatus,
    restartAllContainers bool,
) podActions {
    logger := klog.FromContext(ctx)
    ...
    // 判断 Sandbox 是否需要重建,初始化本轮操作计划。
    createPodSandbox, attempt, sandboxID := runtimeutil.PodSandboxChanged(pod, podStatus)
    changes := podActions{
        KillPod:           createPodSandbox,
        CreateSandbox:     createPodSandbox,
        SandboxID:         sandboxID,
        Attempt:           attempt,
        ContainersToStart: []int{},
        ContainersToKill:  make(map[kubecontainer.ContainerID]containerToKillInfo),
    }
    ...
    if createPodSandbox {
        ...
        var containersToStart []int
        ...
        // 重建运行环境时,有 Init Container 就先安排第一个。
        if len(pod.Spec.InitContainers) != 0 {
            changes.InitContainersToStart = []int{0}
            return changes
        }
        changes.ContainersToStart = containersToStart
        return changes
    }
    ...
    // 检查初始化进度,并更新本轮 Init Container 操作计划。
    hasInitialized := m.computeInitContainerActions(ctx, pod, podStatus, &changes)
    if changes.KillPod || !hasInitialized {
        return changes
    }
    ...
    keepCount := 0
    for idx, container := range pod.Spec.Containers {
        containerStatus := podStatus.FindContainerStatusByName(container.Name)
        ...
        if containerStatus == nil || containerStatus.State != kubecontainer.ContainerStateRunning {
            if kubecontainer.ShouldContainerBeRestarted(logger, &container, pod, podStatus) {
                ...
                // 将待启动容器的配置索引写入启动列表。
                changes.ContainersToStart = append(changes.ContainersToStart, idx)
                ...
            }
            continue
        }
        ...
        var message string
        var reason containerKillReason
        restart := shouldRestartOnFailure(pod)
        ...
        if _, _, changed := containerChanged(&container, containerStatus); changed {
            ...
            restart = true
        } else if liveness, found := m.livenessManager.Get(containerStatus.ID); found && liveness == proberesults.Failure {
            ...
            reason = reasonLivenessProbe
        } else if startup, found := m.startupManager.Get(containerStatus.ID); found && startup == proberesults.Failure {
            ...
            reason = reasonStartupProbe
        } else if !m.computePodResizeAction(ctx, pod, idx, false, containerStatus, &changes) {
            continue
        } else {
            // 无需替换的运行中容器保留,本轮不写入停止列表。
            keepCount++
            continue
        }

        if restart {
            ...
            // 停止后还需重启时,同时写入启动列表。
            changes.ContainersToStart = append(changes.ContainersToStart, idx)
        }
        // 将需要停止的旧容器实例写入停止列表。
        changes.ContainersToKill[containerStatus.ID] = containerToKillInfo{
            name:      containerStatus.Name,
            container: &pod.Spec.Containers[idx],
            message:   message,
            reason:    reason,
        }
        ...
    }
    if keepCount == 0 && len(changes.ContainersToStart) == 0 {
        changes.KillPod = true
        changes.InitContainersToStart = nil
    }
    ...
    // 将本轮操作计划返回给调用它的 kubeGenericRuntimeManager.SyncPod。
    return changes
}
kubeGenericRuntimeManager.SyncPod 将 computePodActions 返回的 podActions 类型操作计划保存在局部变量 podContainerChanges 中,再按计划字段依次执行:
- 停止对象:
KillPod为 true 时调用killPodWithSyncResult,停止全部容器和 Sandbox;否则遍历ContainersToKill,逐个调用killContainer,例如停止因 Liveness 探针失败而需要重启的容器。 - 准备 Sandbox:
CreateSandbox为 true 时调用createPodSandbox;已有 Sandbox 可用时,使用计划中的SandboxID。 - 启动容器:按
InitContainersToStart和ContainersToStart中的索引取得容器配置,通过内部的start调用startContainer。spec.container指向本次要启动的容器。 - 返回结果:各次操作及其错误汇集到
PodSyncResult,返回给 Kubelet。podActions用于决定本轮执行哪些操作,PodSyncResult用于记录这些操作的执行结果。
func (m *kubeGenericRuntimeManager) SyncPod(
    ctx context.Context,
    pod *v1.Pod,
    podStatus *kubecontainer.PodStatus,
    pullSecrets []v1.Secret,
    backOff *flowcontrol.Backoff,
    restartAllContainers bool,
) (result kubecontainer.PodSyncResult) {
    ...
    // 接收操作计划,后续分支读取 podContainerChanges 执行。
    podContainerChanges := m.computePodActions(ctx, pod, podStatus, restartAllContainers)
    ...
    if podContainerChanges.KillPod {
        killResult := m.killPodWithSyncResult(ctx, pod, kubecontainer.ConvertPodStatusToRunningPod(m.runtimeName, podStatus), nil)
        result.AddPodSyncResult(killResult)
        if killResult.Error() != nil {
            ...
            return
        }
        ...
    } else {
        for containerID, containerInfo := range podContainerChanges.ContainersToKill {
            ...
            if err := m.killContainer(ctx, pod, containerID, containerInfo.name, containerInfo.message, containerInfo.reason, nil, nil); err != nil {
                ...
                return
            }
        }
        ...
    }
    ...
    podSandboxID := podContainerChanges.SandboxID
    if podContainerChanges.CreateSandbox {
        var msg string
        var err error
        ...
        // Sandbox 创建成功后,才能继续启动容器。
        podSandboxID, msg, err = m.createPodSandbox(ctx, pod, podContainerChanges.Attempt)
        if err != nil {
            ...
            return
        }
        ...
    }
    ...
    start := func(ctx context.Context, typeName, metricLabel string, spec *startSpec) error {
        startContainerResult := kubecontainer.NewSyncResult(kubecontainer.StartContainer, spec.container.Name)
        result.AddSyncResult(startContainerResult)
        // 仍处于退避期时,结束本次启动尝试。
        isInBackOff, msg, err := m.doBackOff(ctx, pod, spec.container, podStatus, backOff)
        if isInBackOff {
            startContainerResult.Fail(err, msg)
            return err
        }
        ...
        // 准备镜像与配置,并通过 CRI 创建、启动容器。
        msg, err = m.startContainer(ctx, podSandboxID, podSandboxConfig, spec, pod, podStatus, pullSecrets, ...)
        if err != nil {
            ...
            startContainerResult.Fail(err, msg)
            ...
            return err
        }
        ...
        return nil
    }
    ...
    // 按初始化启动列表取得配置,交给共用的 start 函数。
    for _, idx := range podContainerChanges.InitContainersToStart {
        container := &pod.Spec.InitContainers[idx]
        if err := start(ctx, "init container", metrics.InitContainer, containerStartSpec(container)); err != nil {
            if podutil.IsRestartableInitContainer(container) {
                ...
                continue
            }
            ...
            return
        }
        ...
    }
    ...
    // 按业务容器启动列表取得配置,交给共用的 start 函数。
    for _, idx := range podContainerChanges.ContainersToStart {
        start(ctx, "container", metrics.Container, containerStartSpec(&pod.Spec.Containers[idx]))
    }
    return result
}
Sandbox 创建
Sandbox 提供 Pod 级运行环境。首次运行 Pod,或已有 Sandbox 无法继续使用时,Runtime Manager 会创建新的 Sandbox,后续容器通过 Sandbox ID 加入这个运行环境。
createPodSandbox 完成以下操作:
- 准备配置:将 Pod 配置转换为 CRI 的
PodSandboxConfig,包含元数据、DNS、命名空间和安全配置。 - 选择运行实现:将 Pod 指定的 RuntimeClass 解析为容器运行时识别的 runtime handler。
- 请求创建:通过
runtimeService.RunPodSandbox请求容器运行时创建 Sandbox,成功后返回其 ID。
func (m *kubeGenericRuntimeManager) createPodSandbox(ctx context.Context, pod *v1.Pod, attempt uint32) (string, string, error) {
    ...
    // 生成 Pod 级运行环境配置。
    podSandboxConfig, err := m.generatePodSandboxConfig(ctx, pod, attempt)
    if err != nil {
        ...
        return "", message, err
    }
    ...
    runtimeHandler := ""
    if m.runtimeClassManager != nil {
        // 解析 RuntimeClass 对应的运行实现。
        runtimeHandler, err = m.runtimeClassManager.LookupRuntimeHandler(pod.Spec.RuntimeClassName)
        if err != nil {
            ...
            return "", message, err
        }
        ...
    }
    // 请求容器运行时创建 Sandbox。
    podSandBoxID, err := m.runtimeService.RunPodSandbox(ctx, podSandboxConfig, runtimeHandler)
    if err != nil {
        ...
        return "", message, err
    }
    return podSandBoxID, "", nil
}
容器启动
Sandbox 可用后,Runtime Manager 按计划启动容器。普通 Init Container 需要执行成功,才会继续后续初始化并启动业务容器。
startContainer 接收 Sandbox ID、目标容器配置和镜像凭据,按以下顺序处理:
- 准备镜像:
imagePuller.EnsureImageExists根据镜像策略检查本地缓存,必要时拉取镜像。 - 生成配置:
generateContainerConfig汇集命令、环境变量、挂载、设备和资源限制等信息。 - 创建容器:调用 CRI
CreateContainer,取得容器实例 ID。 - 启动容器:调用 CRI
StartContainer,请求容器运行时启动这个实例。
func (m *kubeGenericRuntimeManager) startContainer(
    ctx context.Context,
    podSandboxID string,
    podSandboxConfig *runtimeapi.PodSandboxConfig,
    spec *startSpec,
    pod *v1.Pod,
    podStatus *kubecontainer.PodStatus,
    pullSecrets []v1.Secret,
    ...
) (string, error) {
    container := spec.container
    ...
    // 准备容器镜像。
    imageRef, msg, err := m.imagePuller.EnsureImageExists(ctx, ref, pod, container.Image, pullSecrets, podSandboxConfig, podRuntimeHandler, container.ImagePullPolicy)
    if err != nil {
        ...
        return msg, err
    }
    ...
    // 生成容器配置。
    containerConfig, cleanupAction, err := m.generateContainerConfig(ctx, container, pod, ...)
    ...
    if err != nil {
        ...
        return s.Message(), ErrCreateContainerConfig
    }
    ...
    // 创建容器并取得实例 ID。
    containerID, err := m.runtimeService.CreateContainer(ctx, podSandboxID, containerConfig, podSandboxConfig)
    if err != nil {
        ...
        return s.Message(), ErrCreateContainer
    }
    ...
    // 请求容器运行时启动这个容器实例。
    err = m.runtimeService.StartContainer(ctx, containerID)
    if err != nil {
        ...
        return s.Message(), kubecontainer.ErrRunContainer
    }
    ...
    return "", nil
}
容器停止
容器停止有两条调用路径:
- 停止选定容器:
SyncPod根据操作计划调用killContainer。例如 A、B、C 三个容器中,仅 A 的 Liveness 探针判定失败且重启策略允许时,停止并重建 A,保留 B、C 和正常的 Sandbox。 - 停止整个 Pod:
SyncTerminatingPod通过Kubelet.killPod → kubeGenericRuntimeManager.KillPod进入停止流程;正常同步需要重建 Sandbox 时,也会进入整 Pod 停止路径。
单个容器由 killContainer 停止。它通过 runtimeService.StopContainer 调用 CRI,请求 containerd、CRI-O 等容器运行时停止指定容器:
- 执行
preStop:配置了钩子且宽限期大于零时,在请求容器运行时停止容器之前执行。 - 等待停止顺序:整 Pod 停止时,
ordering按业务容器在前、原生 Sidecar 在后协调停止,等待受剩余宽限时间限制。 - 请求停止:
containerID.ID指定要停止的容器实例,gracePeriod指定本次请求的停止宽限时间。
func (m *kubeGenericRuntimeManager) killContainer(
    ctx context.Context,
    pod *v1.Pod,
    containerID kubecontainer.ContainerID,
    containerName string,
    message string,
    reason containerKillReason,
    gracePeriodOverride *int64,
    ordering *terminationOrdering,
) error {
    ...
    gracePeriod := setTerminationGracePeriod(ctx, pod, containerSpec, containerName, containerID, reason)
    ...
    // preStop 执行消耗的时间从宽限时间中扣除。
    if containerSpec.Lifecycle != nil && containerSpec.Lifecycle.PreStop != nil && gracePeriod > 0 {
        gracePeriod = gracePeriod - m.executePreStopHook(ctx, pod, containerID, containerSpec, gracePeriod)
    }
    if ordering != nil && gracePeriod > 0 {
        gracePeriod -= int64(ordering.waitForTurn(containerName, gracePeriod))
    }
    ...
    // 通过 CRI 请求容器运行时停止 containerID.ID 指定的容器。
    err := m.runtimeService.StopContainer(ctx, containerID.ID, gracePeriod)
    if err != nil && !crierror.IsNotFound(err) {
        ...
        return err
    }
    ...
    return nil
}
kubeGenericRuntimeManager.KillPod 通过 killPodWithSyncResult 停止整个 Pod:
- 停止容器:
killContainersWithSyncResult并发调用killContainer,等待这些调用完成并收集结果。 - 停止 Sandbox:容器停止调用完成后,再通过 CRI
StopPodSandbox请求容器运行时停止该 Pod 关联的 Sandbox。 - 返回结果:将停止操作及其错误汇总到
PodSyncResult。
停止后的容器与 Sandbox 记录由 Container GC 按保留策略删除,卷卸载等节点资源清理由 Kubelet 的终止流程继续处理。
func (m *kubeGenericRuntimeManager) killPodWithSyncResult(
    ctx context.Context,
    pod *v1.Pod,
    runningPod kubecontainer.Pod,
    gracePeriodOverride *int64,
) (result kubecontainer.PodSyncResult) {
    ...
    // 停止各容器,并等待这些调用完成。
    killContainerResults := m.killContainersWithSyncResult(ctx, pod, runningPod, gracePeriodOverride)
    for _, containerResult := range killContainerResults {
        result.AddSyncResult(containerResult)
    }
    ...
    // 容器停止调用完成后,逐个停止该 Pod 关联的 Sandbox,包括尚未回收的旧实例。
    for _, podSandbox := range runningPod.Sandboxes {
        if err := m.runtimeService.StopPodSandbox(ctx, podSandbox.ID.ID); err != nil && !crierror.IsNotFound(err) {
            ...
        }
    }
    return
}
节点资源管理
Kubelet 将 Pod 的资源需求落实为卷挂载、CPU 与内存分配、设备配置,并在 Pod 结束或节点资源紧张时回收资源。
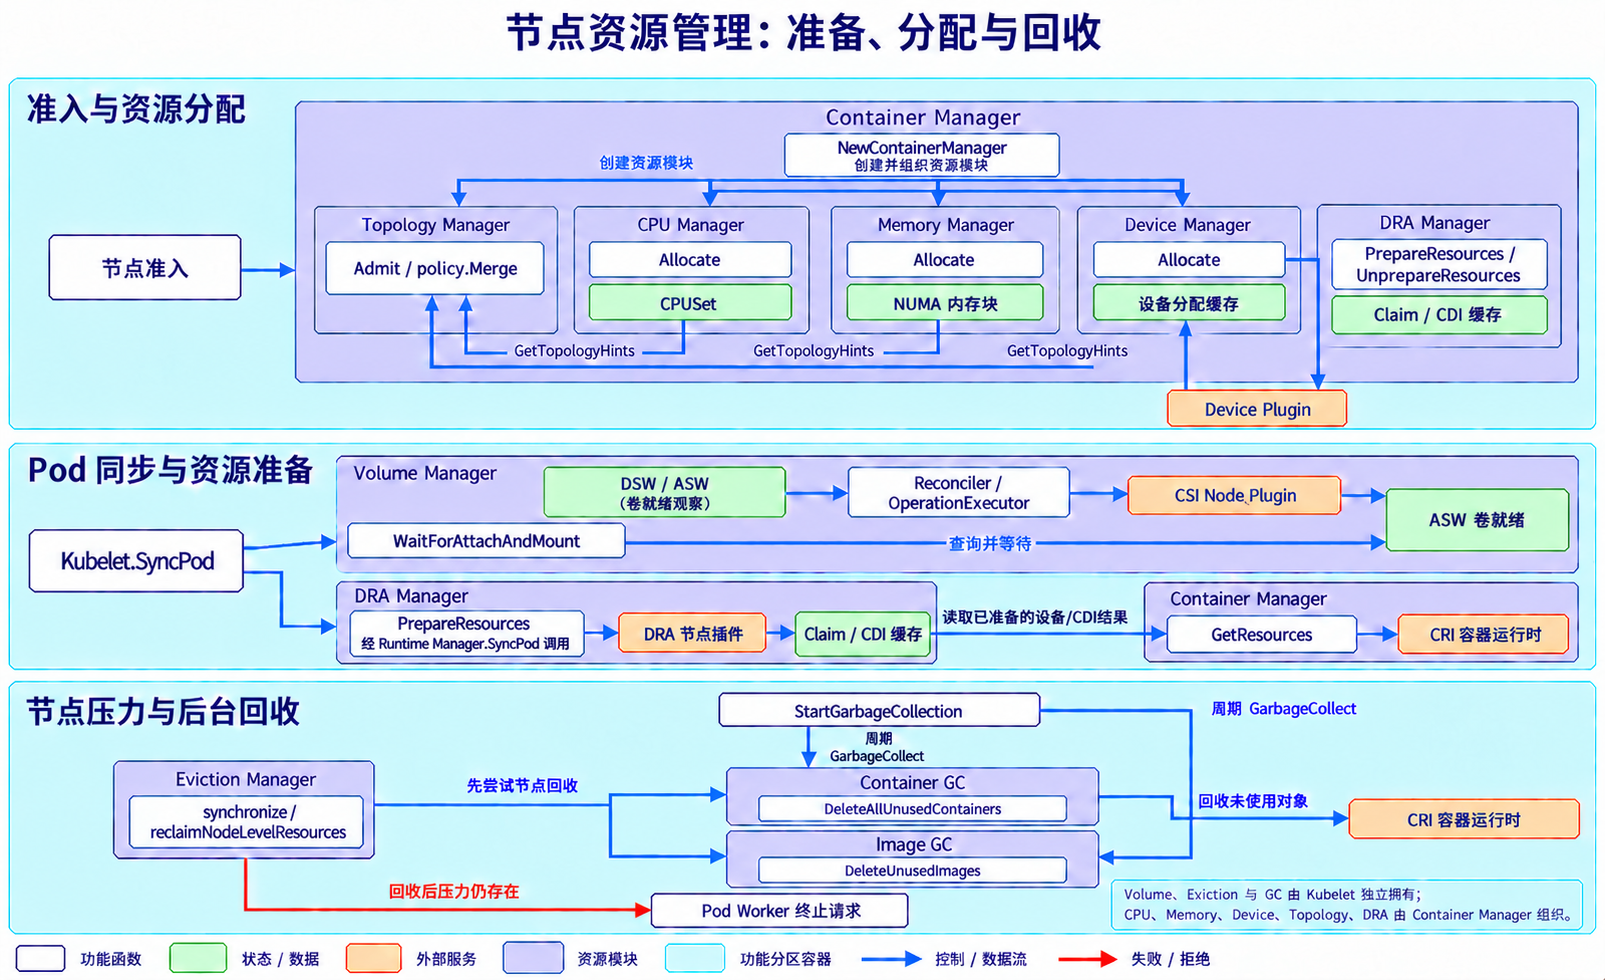
- Volume Manager:协调 Pod 所需卷的挂载与卸载。
- Container Manager:为系统预留资源,管理 Pod 的资源限制,并组织各类资源管理组件。
- CPU Manager:按策略管理共享与独占 CPU 集合,独占分配时考虑 NUMA 拓扑与亲和性要求。
- Memory Manager:管理 NUMA 内存与 HugePages 的分配额度及亲和性。
- Device Manager:对接 Device Plugin,选择具体设备并取得运行配置。
- Topology Manager:协调 CPU、内存和设备的 NUMA 亲和性,参与 Pod 准入。
- DRA Manager:对接 DRA driver,为 Pod 准备已分配的 GPU、网卡等设备,并按使用关系清理对应的节点准备状态。
- Eviction Manager:监测节点资源压力,按需回收资源或驱逐 Pod。
- Container GC:清理满足回收条件的退出容器和闲置 Sandbox。
- Image GC:按镜像年龄、磁盘占用和保留条件回收未使用镜像。
Volume Manager
Volume Manager 协调 Pod 所需卷的挂载与卸载。它记录 Pod 期望使用的卷和节点上的实际卷状态,通过后台协调调用卷插件准备挂载,并在卷不再使用时推进卸载和清理。
推理 Pod 引用的模型 PVC models-pvc 已经绑定后,节点仍需完成挂载准备。Pod 同步等待卷就绪,再将准备好的卷接入容器,应用才能通过 /models 读取模型文件。Pod 结束后,Volume Manager 卸载不再使用的挂载;模型数据仍保存在持久化存储中。
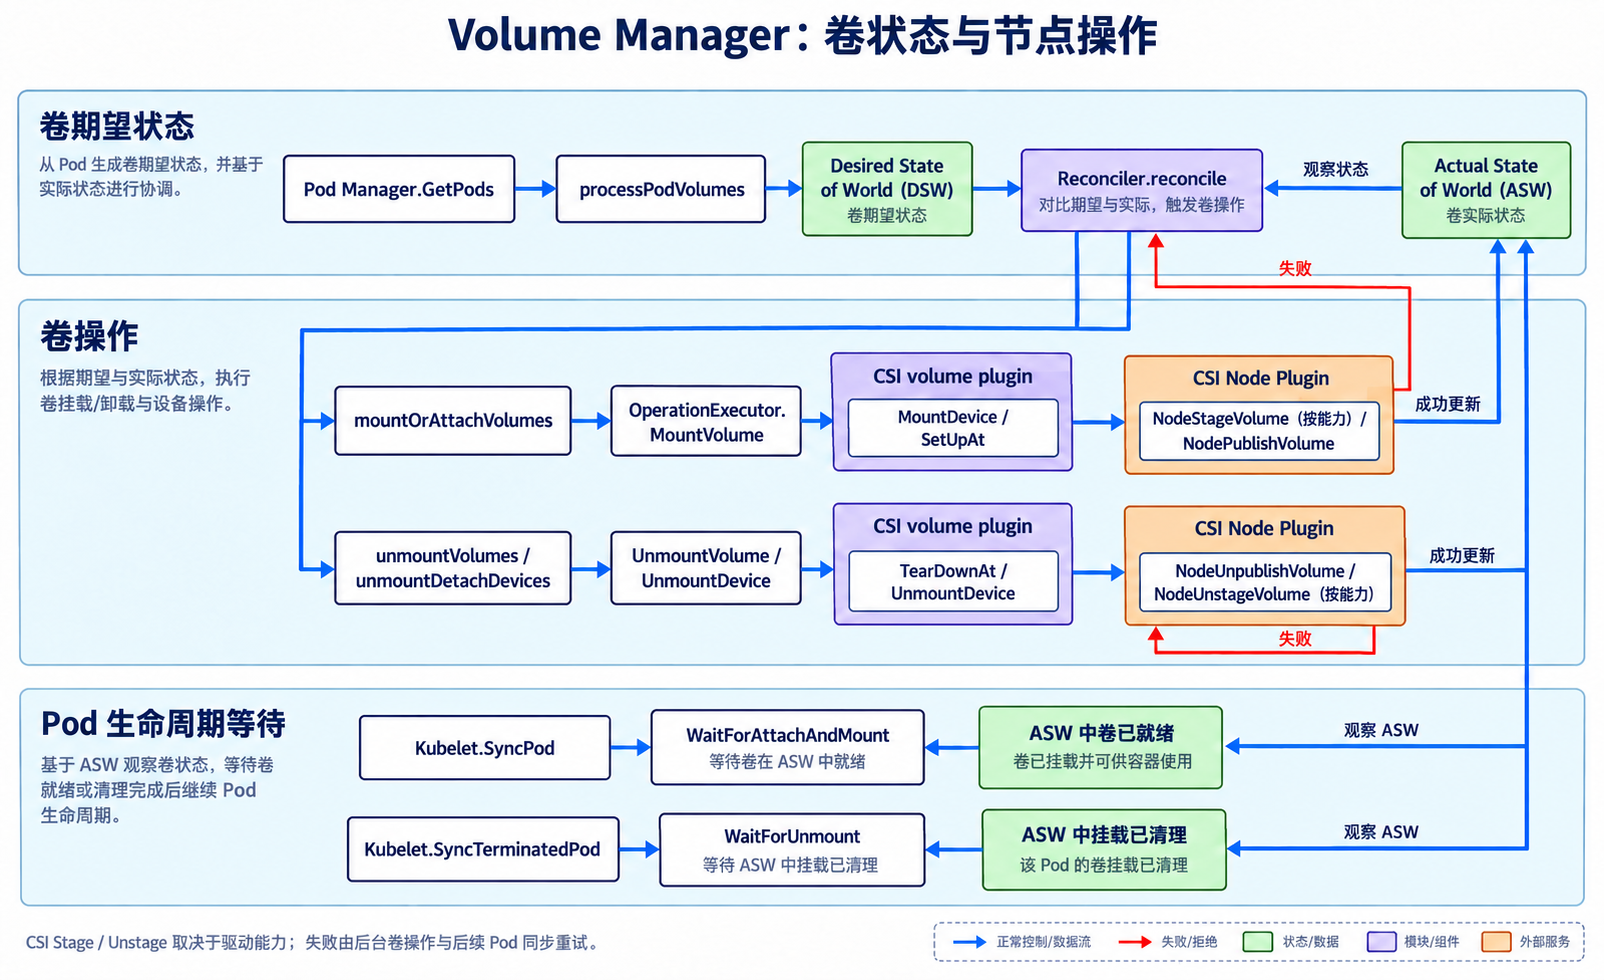
Container Manager
Container Manager 管理系统资源预留和 Pod 的资源限制,并组织 CPU、内存、设备等管理器协同工作。
- 资源预留与限制:按配置为系统进程、Kubelet 等组件预留 CPU 和内存,通过 Linux 的资源分组机制(cgroup)统计并限制 Pod 的资源使用。
- 组织资源分配:由 CPU、内存、设备等管理器按各自策略完成资源分配和设备准备。
- 提供设备配置:汇总设备路径、挂载、环境变量或 CDI 名称等信息,供 Runtime Manager 生成容器运行配置。
例如,推理 Pod 中的容器申请 CPU、设置 8Gi 内存上限,并请求一个 GPU。Runtime Manager 结合 Pod 配置与资源准备结果,通过 CRI 请求容器运行时创建并启动容器。容器运行时据此设置内存上限,并让容器使用已分配的 GPU。
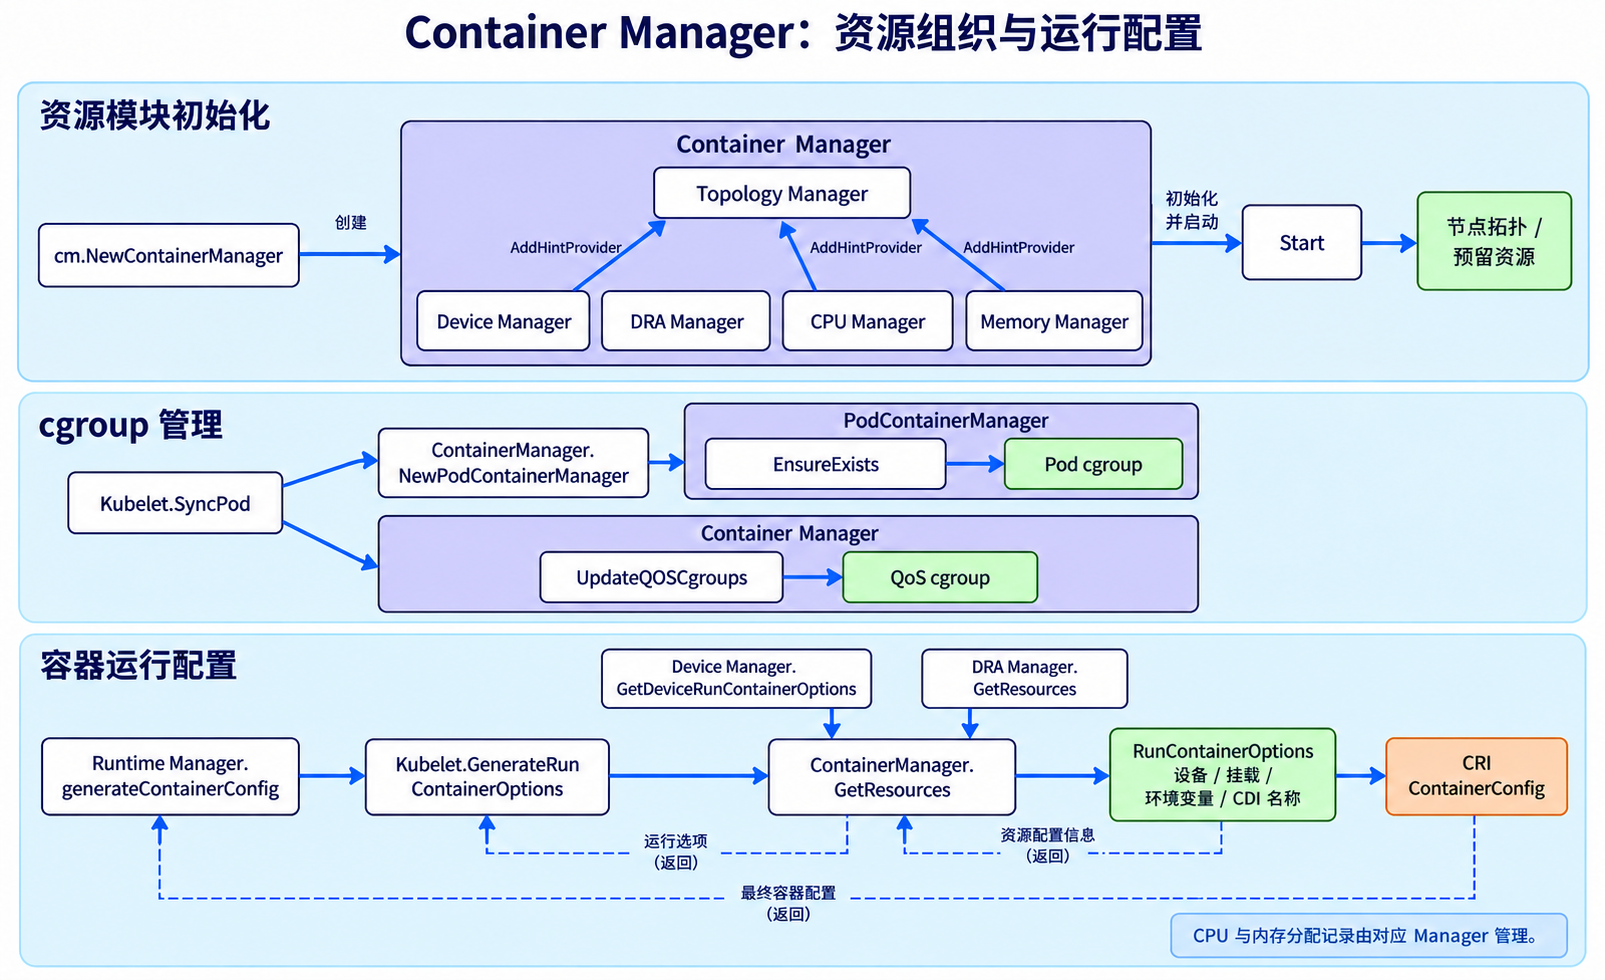
CPU Manager
CPU Manager 按节点策略管理容器可以使用的 CPU 集合。共享池可供多个容器使用;启用 static 策略后,Guaranteed Pod 中 CPU 请求为整数、满足分配条件的容器,可以获得从共享池中划出的独占 CPU 集合。
图中容器的 CPU request 和 limit 都为 4,节点有 8 个逻辑 CPU,并将其中两个严格预留给系统。分配结果分为三部分:
- CPU 0–1:严格预留给系统使用。
- CPU 2–3:留在共享池,供共享 CPU 的容器使用。
- CPU 4–7:分配给该容器,容器进程在这组逻辑 CPU 上运行。
CPU Manager 保存并持续协调这份分配结果,使容器实际使用的 CPU 集合与获准分配保持一致。图中的 CPU 编号只表示一种分配示例。
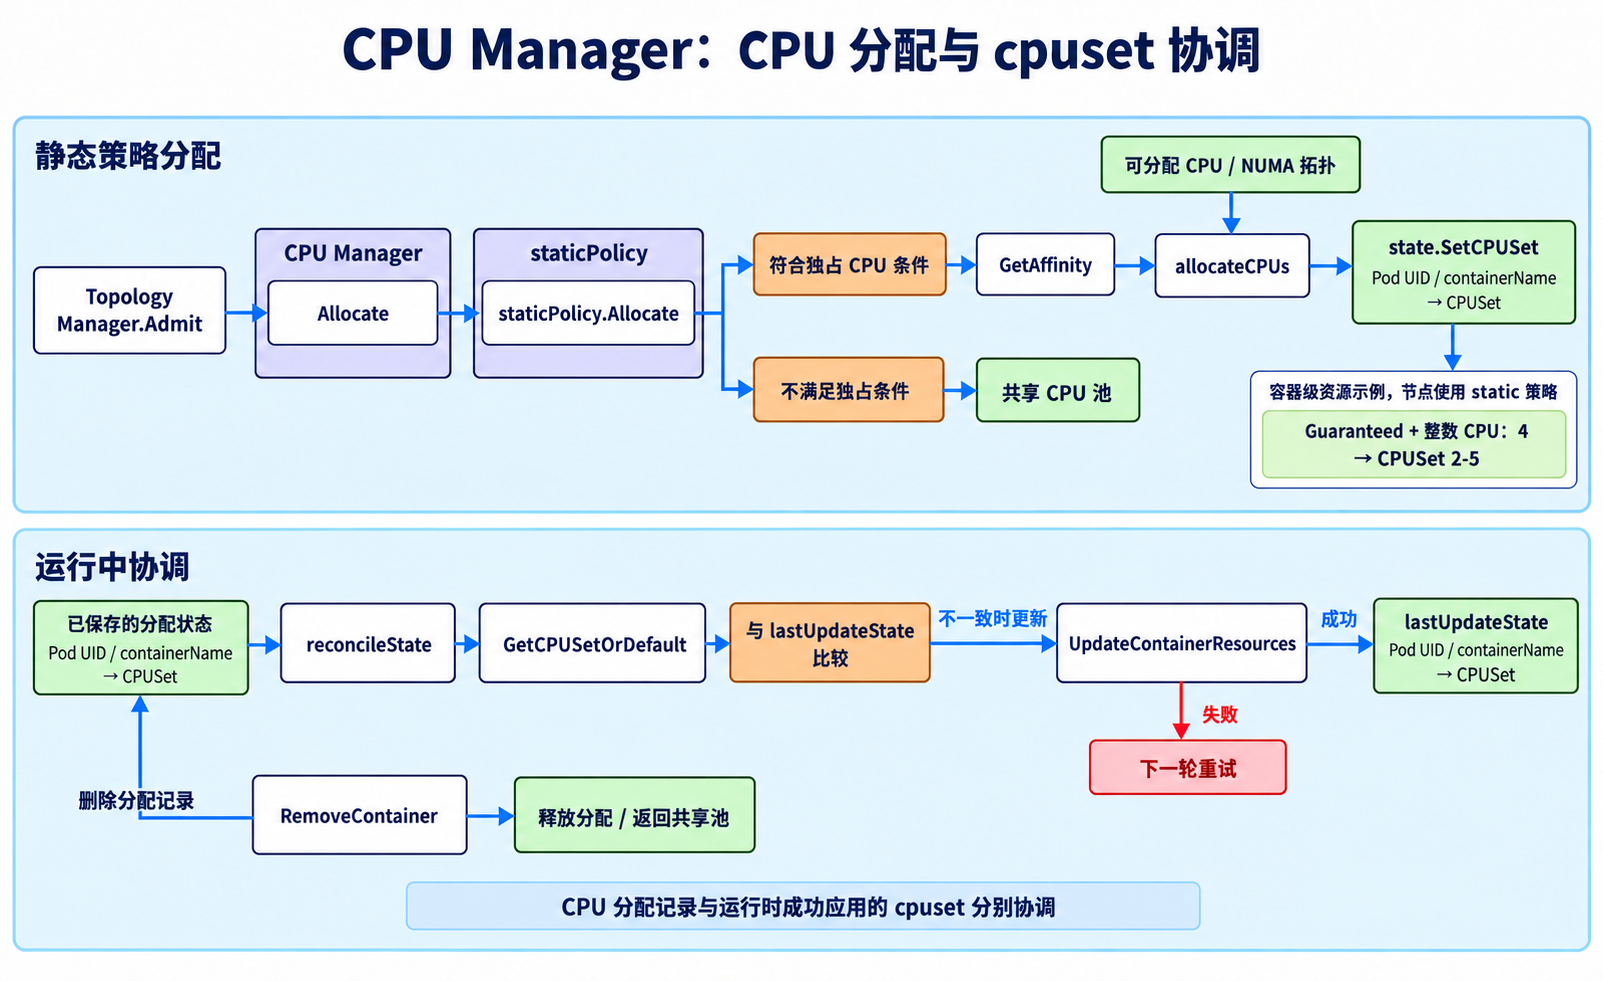
Memory Manager
Memory Manager 管理按 NUMA 节点划分的内存与 HugePages 分配额度,并配合 Topology Manager 设置容器内存亲和性。它记录各 NUMA 节点还有多少可分配额度,以及哪些额度已经分配给容器,供后续资源分配使用。
图中节点启用 static 策略,一个 Guaranteed 容器请求 8Gi 内存,拓扑协调选定 NUMA 1。Memory Manager 在 NUMA 1 的 16Gi 可分配额度中为它记录 8Gi,剩余额度变为 8Gi,并将容器的内存亲和性设为 NUMA 1。
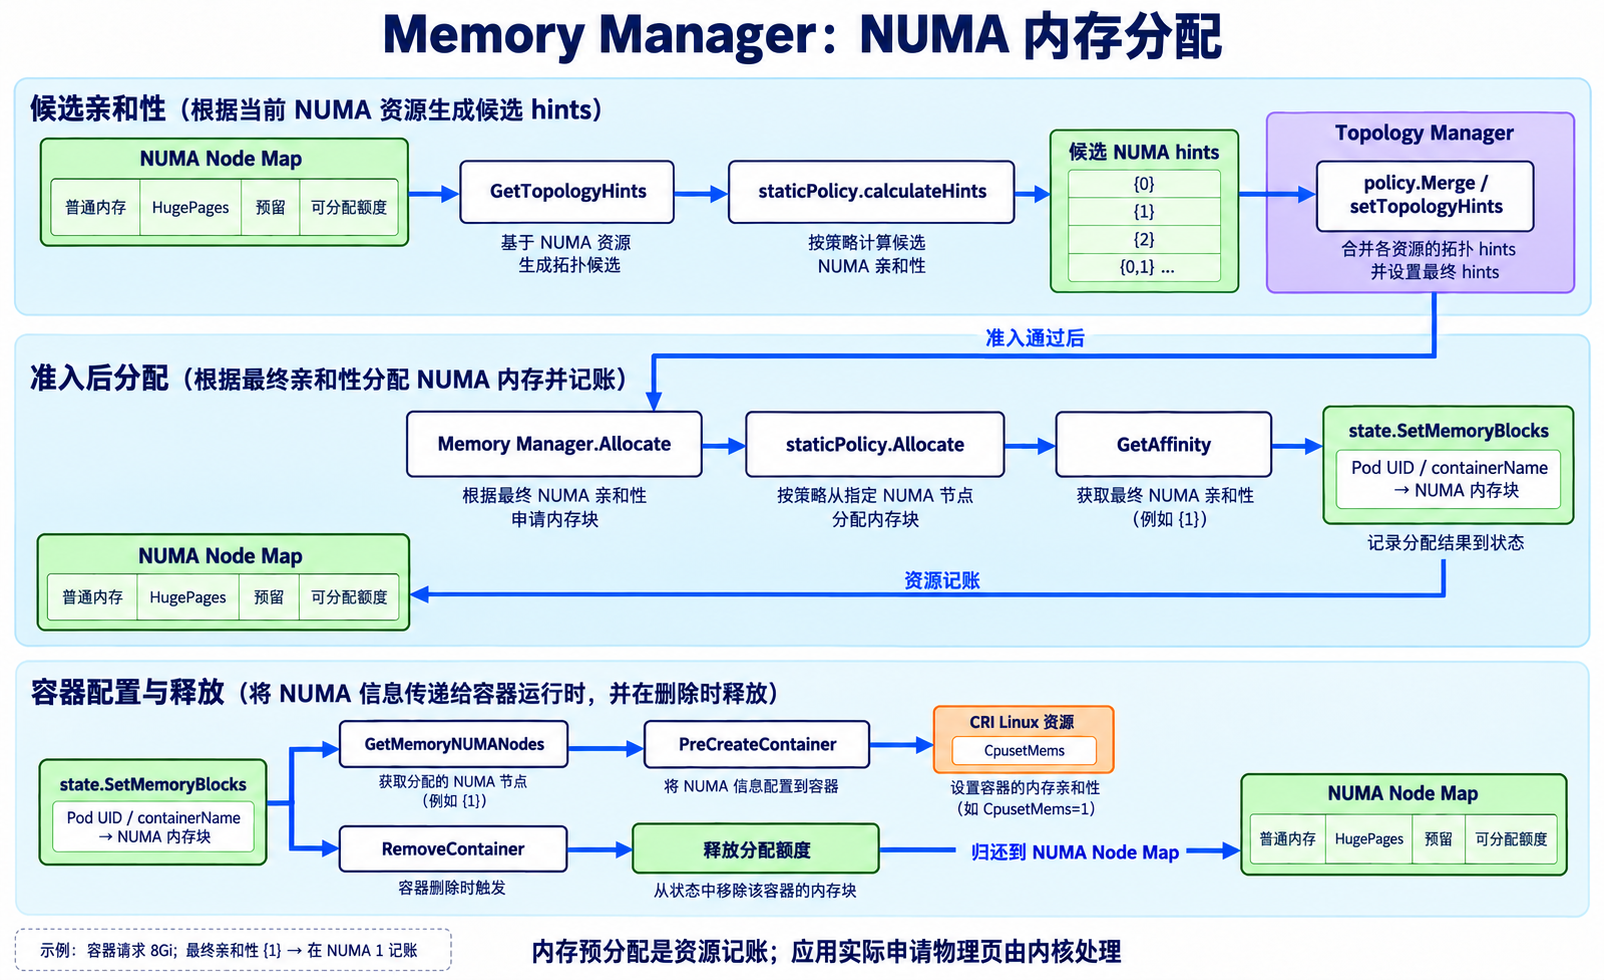
Device Manager
Device Manager 对接 Device Plugin,接收插件报告的设备列表和健康状态,同时记录设备的分配情况。Pod 申请的是设备数量,节点需要把这份请求落实到具体设备及其运行配置。
图中容器请求 nvidia.com/gpu: 1,GPU-A 健康且可用,GPU-B 已分配给其他 Pod。后续过程包括:
- 选择设备:Device Manager 为容器选定 GPU-A,并记录分配关系。
- 准备配置:Device Plugin 为 GPU-A 提供设备路径、挂载或 CDI 等运行配置,具体内容由插件决定。
- 接入容器:Kubelet 将这些配置交给容器运行时,使容器能够使用分配到的 GPU-A。
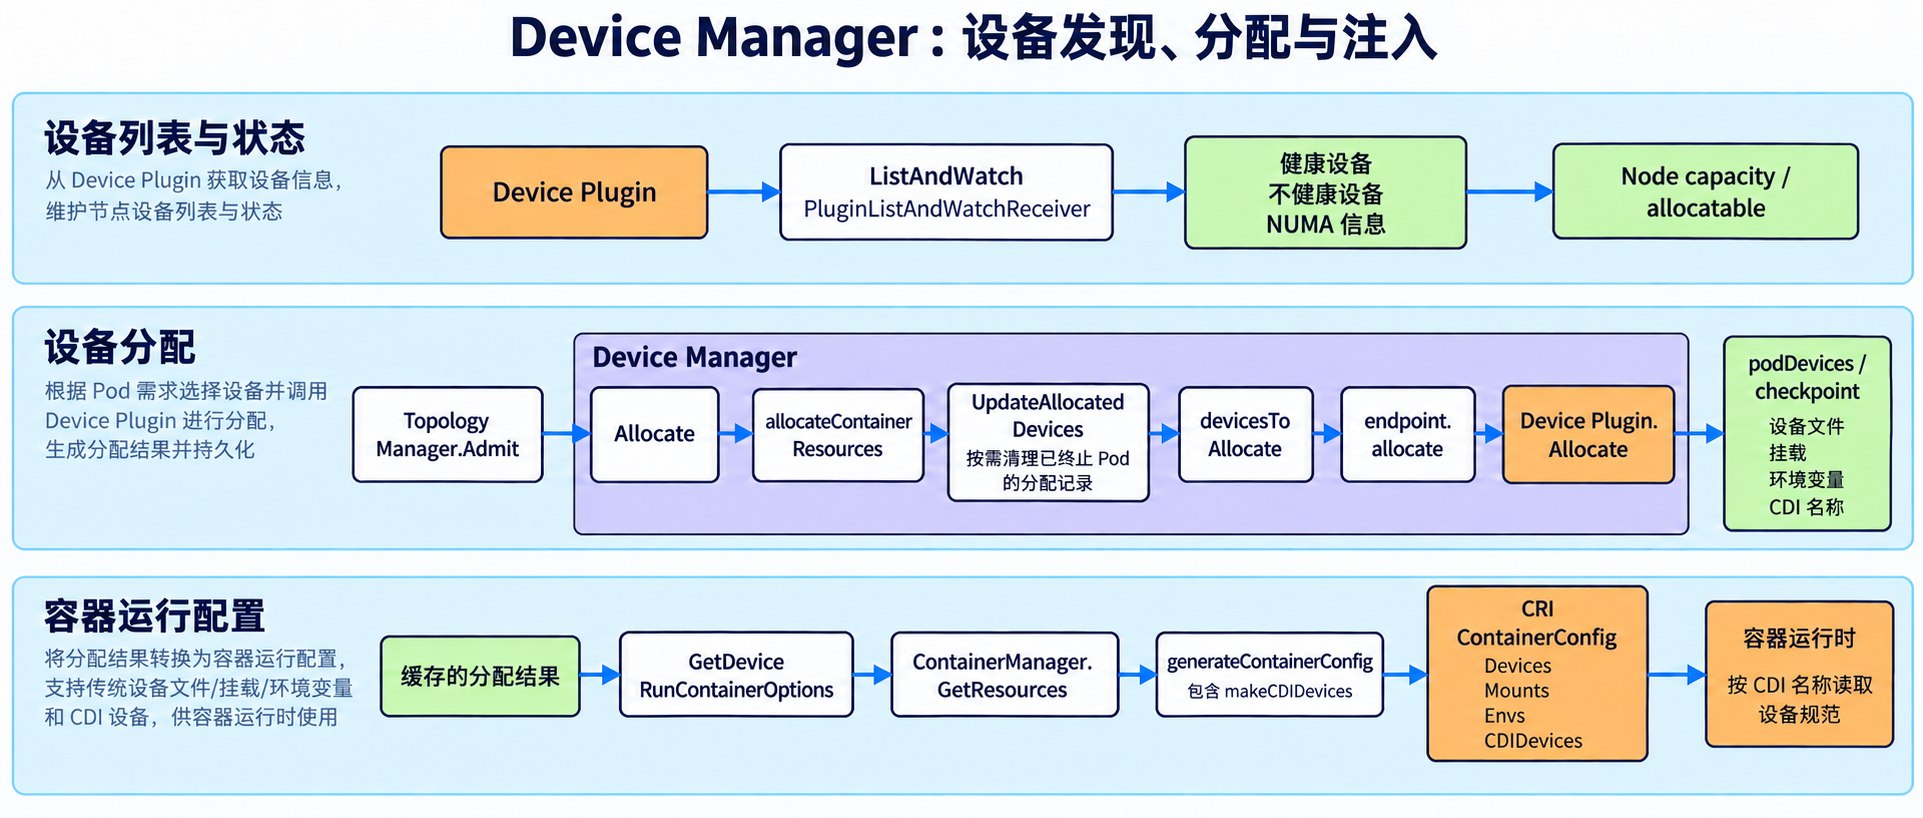
Topology Manager
Topology Manager 协调 CPU、内存和设备的 NUMA 亲和性。各资源管理器提供自己可以满足请求的位置,Topology Manager 汇集这些候选,按策略决定是否允许接纳,并确定后续分配应遵循的共同亲和性。
图中容器需要 4 个 CPU、8Gi 内存和一个 GPU,各类资源的候选位置是:
- CPU:NUMA 0 或 NUMA 1 都能满足请求。
- 内存:NUMA 0 或 NUMA 1 都有足够额度。
- GPU:可用设备位于 NUMA 1。
采用 single-numa-node 策略时,这些请求可以在 NUMA 1 上共同满足。Topology Manager 选定 NUMA 1 亲和性,再由 CPU、Memory 和 Device Manager 分别完成分配;如果找不到满足该策略的共同位置,Pod 会被拒绝准入。
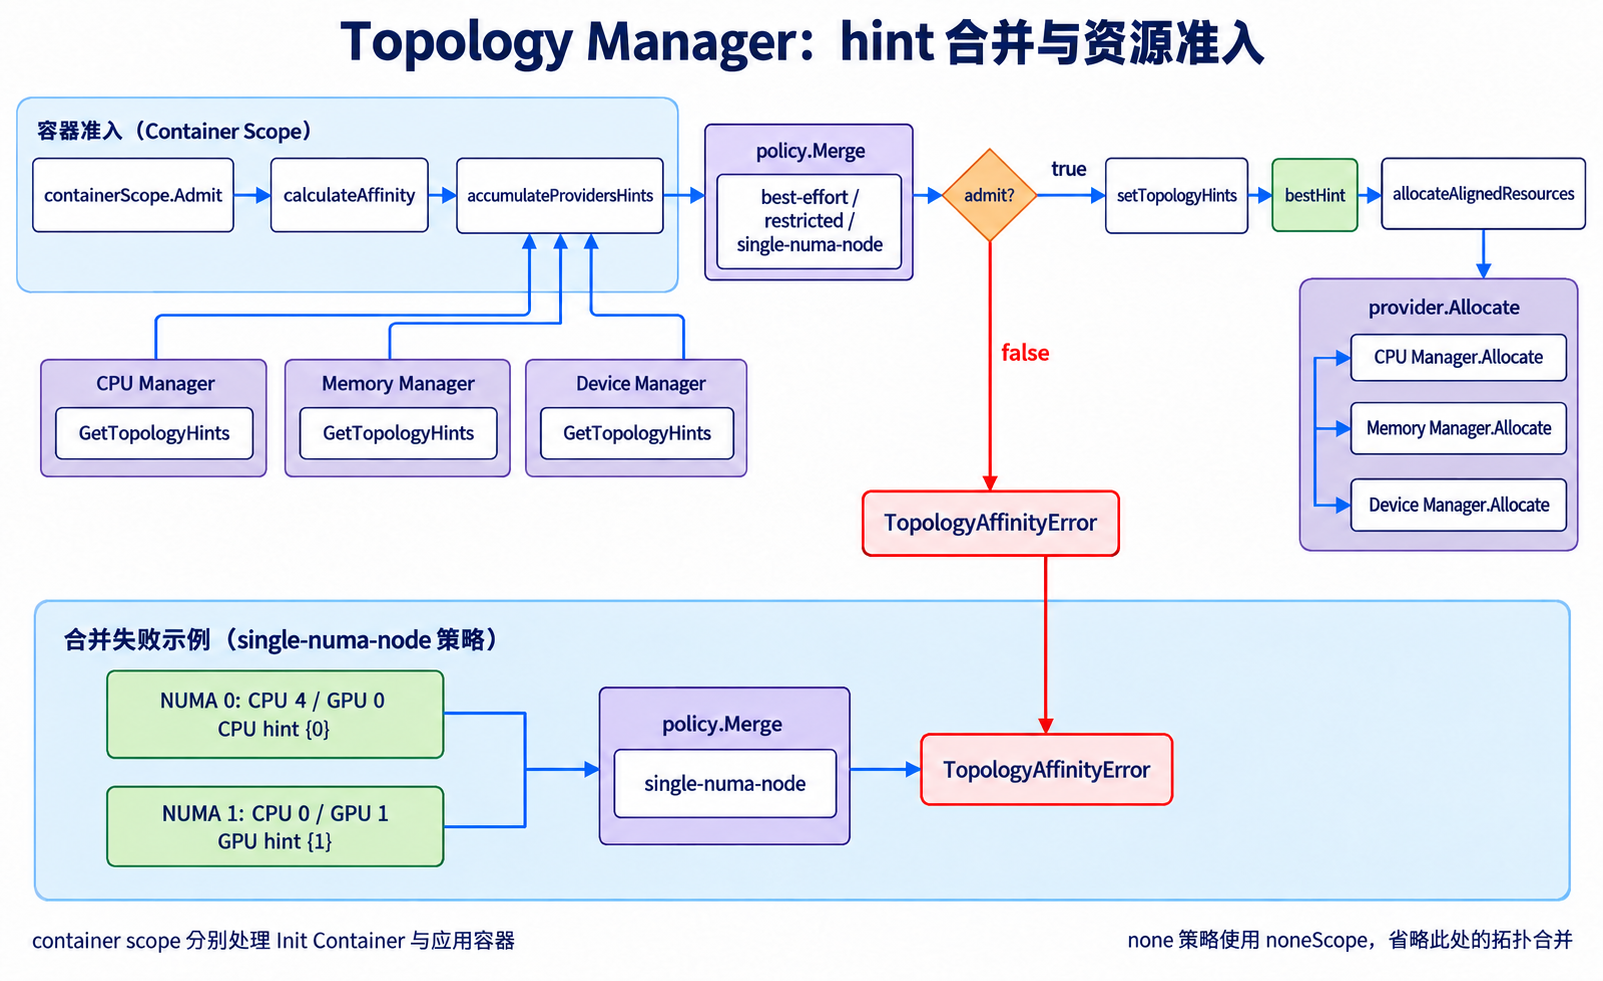
DRA Manager
Device Plugin 示例
Device Plugin 接入的设备以扩展资源名称和数量供 Pod 申请。以 NVIDIA Device Plugin 的默认整卡分配为例,节点用 nvidia.com/gpu 上报 GPU 数量,Pod 用 nodeSelector 选择 A100 节点,再通过容器的 resources.limits 申请 1 张 GPU;具体设备由目标节点的 Device Manager 选择。
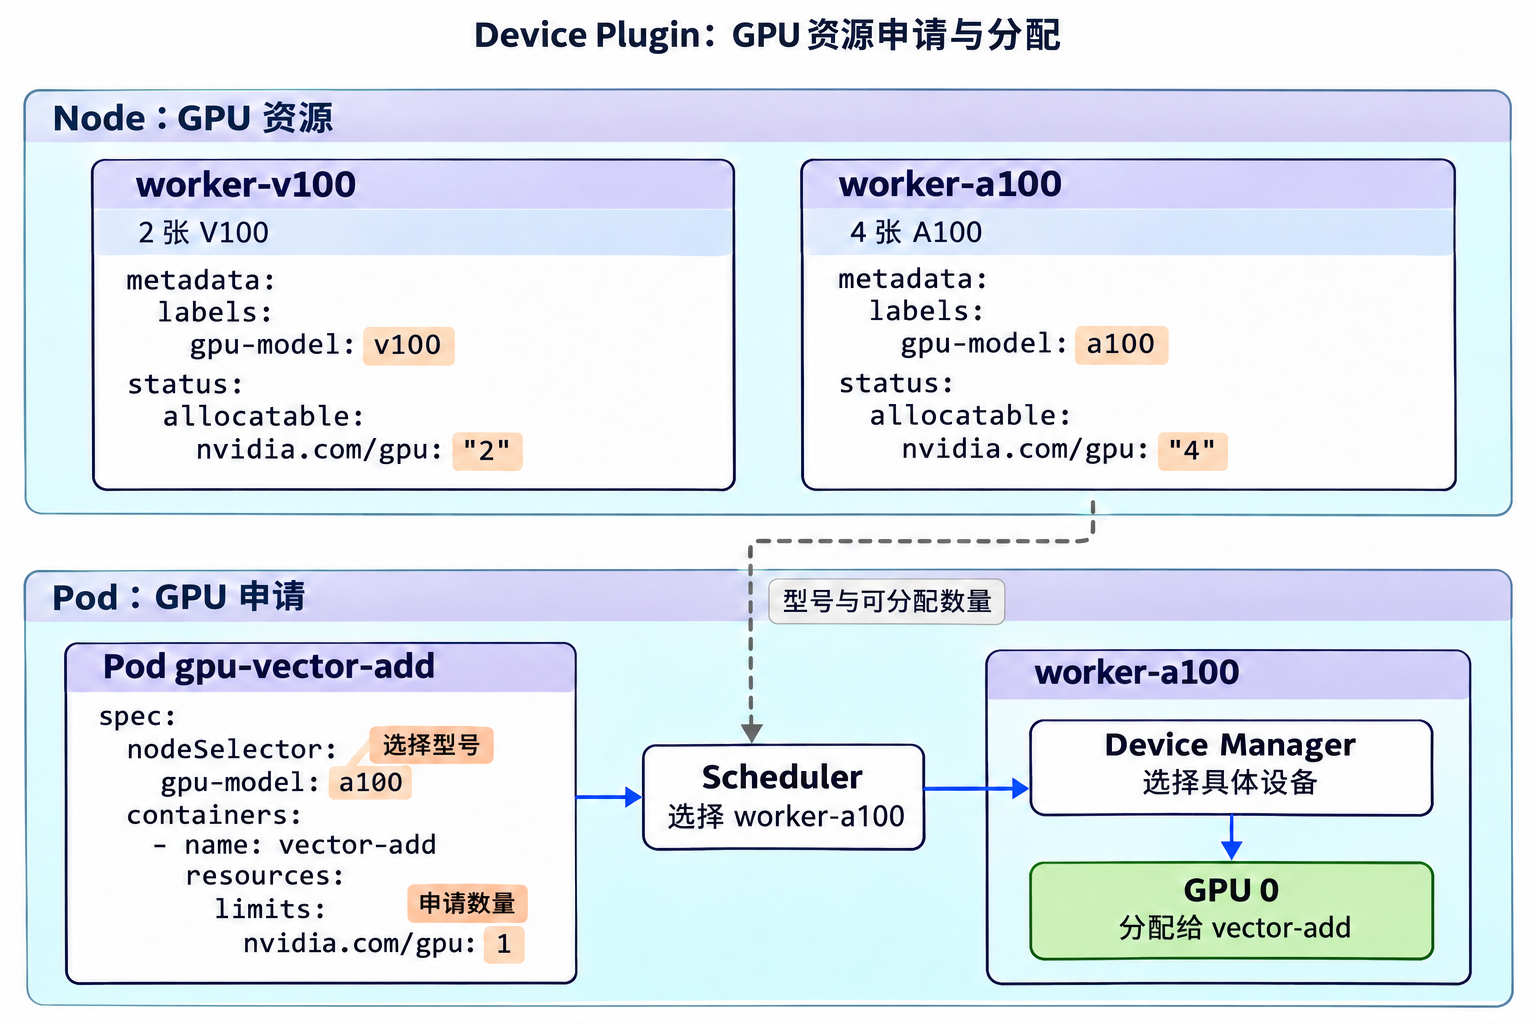
这种资源模型及 NVIDIA Device Plugin 的实现主要有以下限制:
- 整数计数:设备按整数单位申请,不能用
nvidia.com/gpu: 0.5表达半张卡,也不能用该字段直接指定显存容量。 - 属性筛选:型号、架构和显存等条件通常需要借助节点标签。节点标签筛选的是节点,无法区分同一节点上的不同 GPU。
- 共享策略预设:time-slicing、MPS 等策略和共享副本数由节点配置预设,Pod 不能在标准资源请求中单独指定共享策略。time-slicing 也不提供显存额度和故障隔离。
- 静态 MIG:先在节点上切好固定规格的 MIG 实例,再由 Device Plugin 上报。Pod 请求不会直接触发新的 MIG 切分。
- 拓扑约束有限:Device Plugin 可以报告 NUMA 位置,协助节点内分配资源。设备数量请求不能直接表达“两张 GPU 必须通过 NVLink 直连”等条件。
DRA 示例
DRA(Dynamic Resource Allocation) 将设备数量、属性条件和 driver 专用配置放在 ResourceClaim 中,Pod 及其容器通过引用 Claim 使用分配结果。DeviceClass 定义可供请求的设备类别和筛选条件。
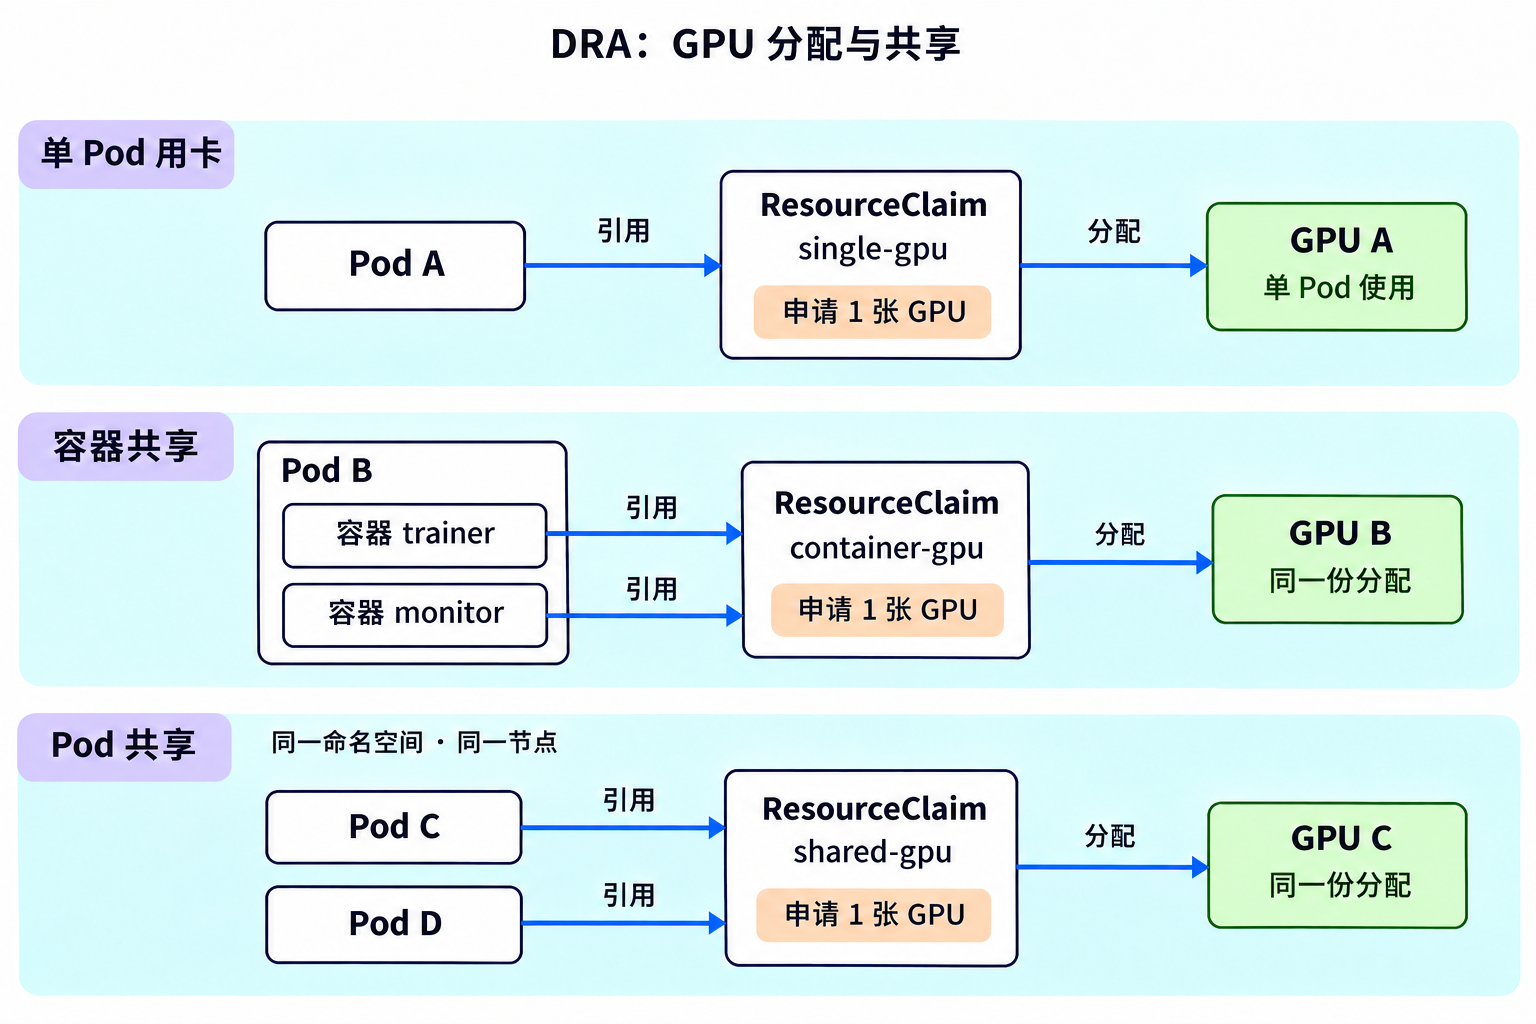
- 单 Pod 用卡:Pod A 引用
single-gpu,使用该 Claim 申请的 1 张 GPU A。 - 容器共享:Pod B 中的 trainer 和 monitor 两个容器引用同一个
container-gpuClaim,共同使用 GPU B。 - Pod 共享:Pod C 和 Pod D 的
resourceClaimName指向同一个shared-gpu,共同使用 GPU C。两个 Pod 需要位于同一命名空间;对于图中的节点本地 GPU,还需调度到同一节点。
Claim 可以通过 CEL 按型号、架构和显存等设备属性选卡。支持相应能力的 NVIDIA DRA driver 还允许按 Claim 配置 time-slicing、MPS 等共享策略和参数;在支持的 GPU 上启用动态 MIG 后,也可按 Claim 所需规格创建和回收 MIG 实例。
在节点侧,DRA Manager 对接 DRA driver,为已分配的 GPU、网卡等设备完成准备,并取得容器使用设备所需的配置。同一 Claim 仍被本节点其他 Pod 使用时,保留准备结果;最后一个本地使用者结束使用后,再请求驱动清理。
Eviction Manager
Eviction Manager 监测节点的内存、磁盘等资源压力,并判断是否需要回收资源或驱逐 Pod。回收手段随压力类型和文件系统布局而变化;选择驱逐对象时,还会考虑 Pod 优先级和资源使用情况。
图中镜像与容器共享节点文件系统,可用磁盘只有 8Gi,低于示例配置的 10Gi 硬阈值。Eviction Manager 先尝试清理未使用的容器和镜像,再检查磁盘压力是否缓解:
- 已经缓解:结束本轮处理,继续监测节点状态。
- 仍然不足:按规则选择 Pod,由 Pod Worker 执行终止,释放资源后继续检查。
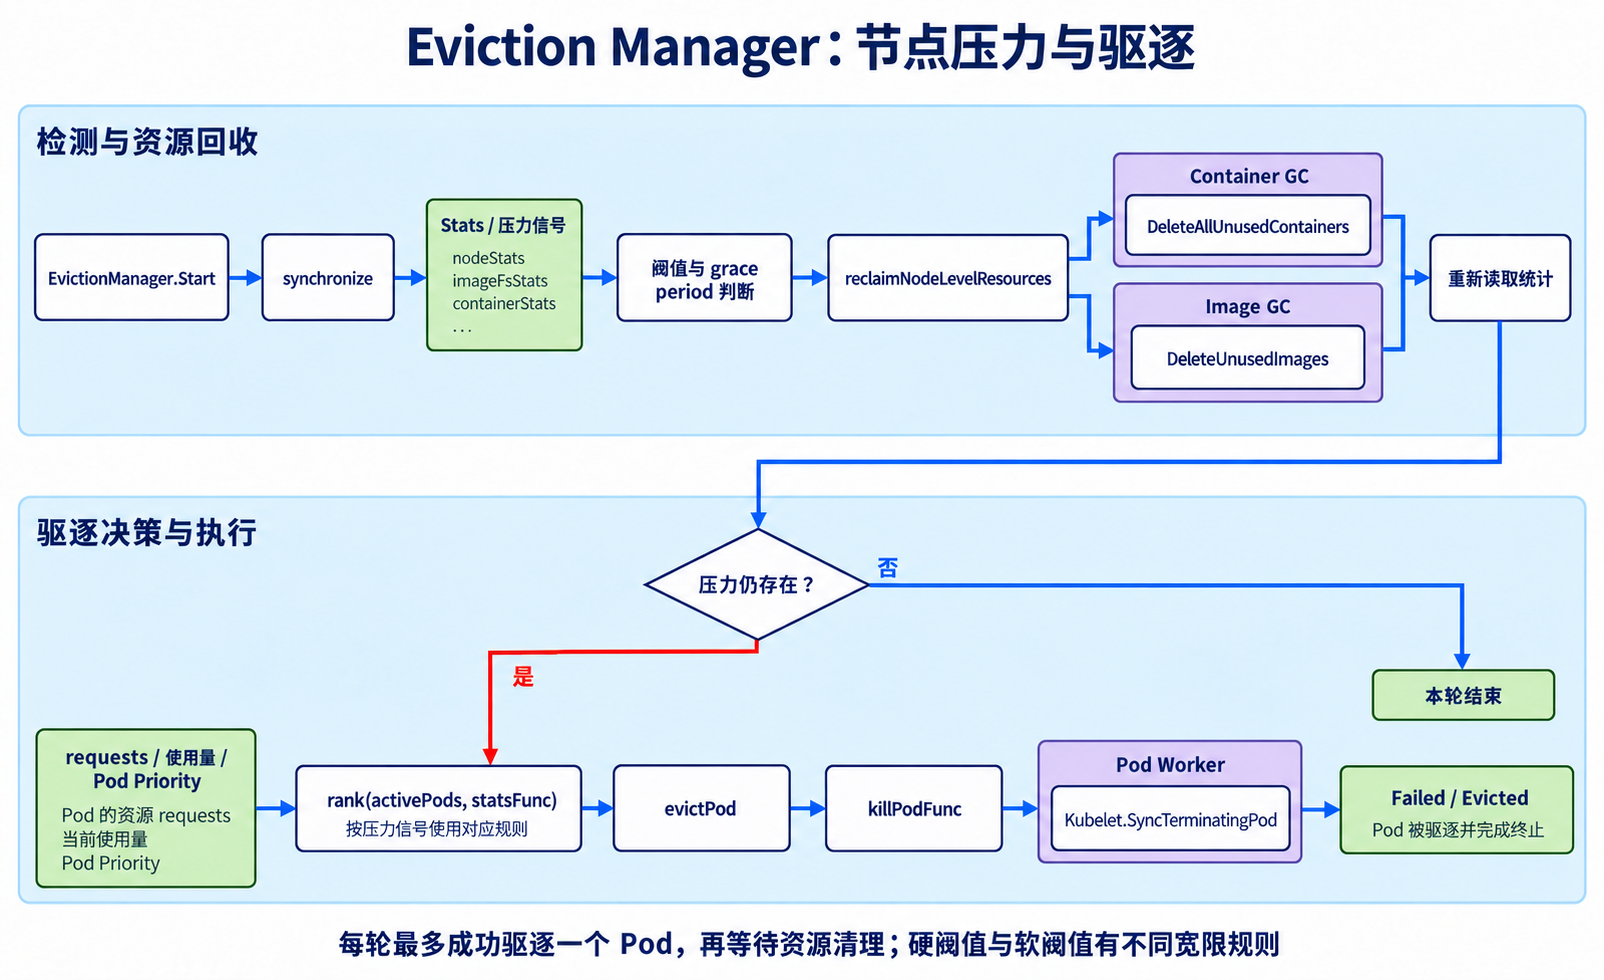
Container GC
容器重启时,容器运行时会创建新的容器实例,旧的退出实例可能暂时保留,供排障使用。Container GC 按年龄和数量等保留规则清理这些旧实例,也会按条件清理不再使用的 Sandbox。
图中同一个容器 web 留下两个退出实例,另有一个实例正在运行。假设两个退出实例均满足最小保留年龄,且本例的保留规则允许留下一个退出实例:
- 旧退出实例:超过保留数量,执行清理。
- 最近退出实例:保留,供排障查看。
- 当前运行实例:继续运行。
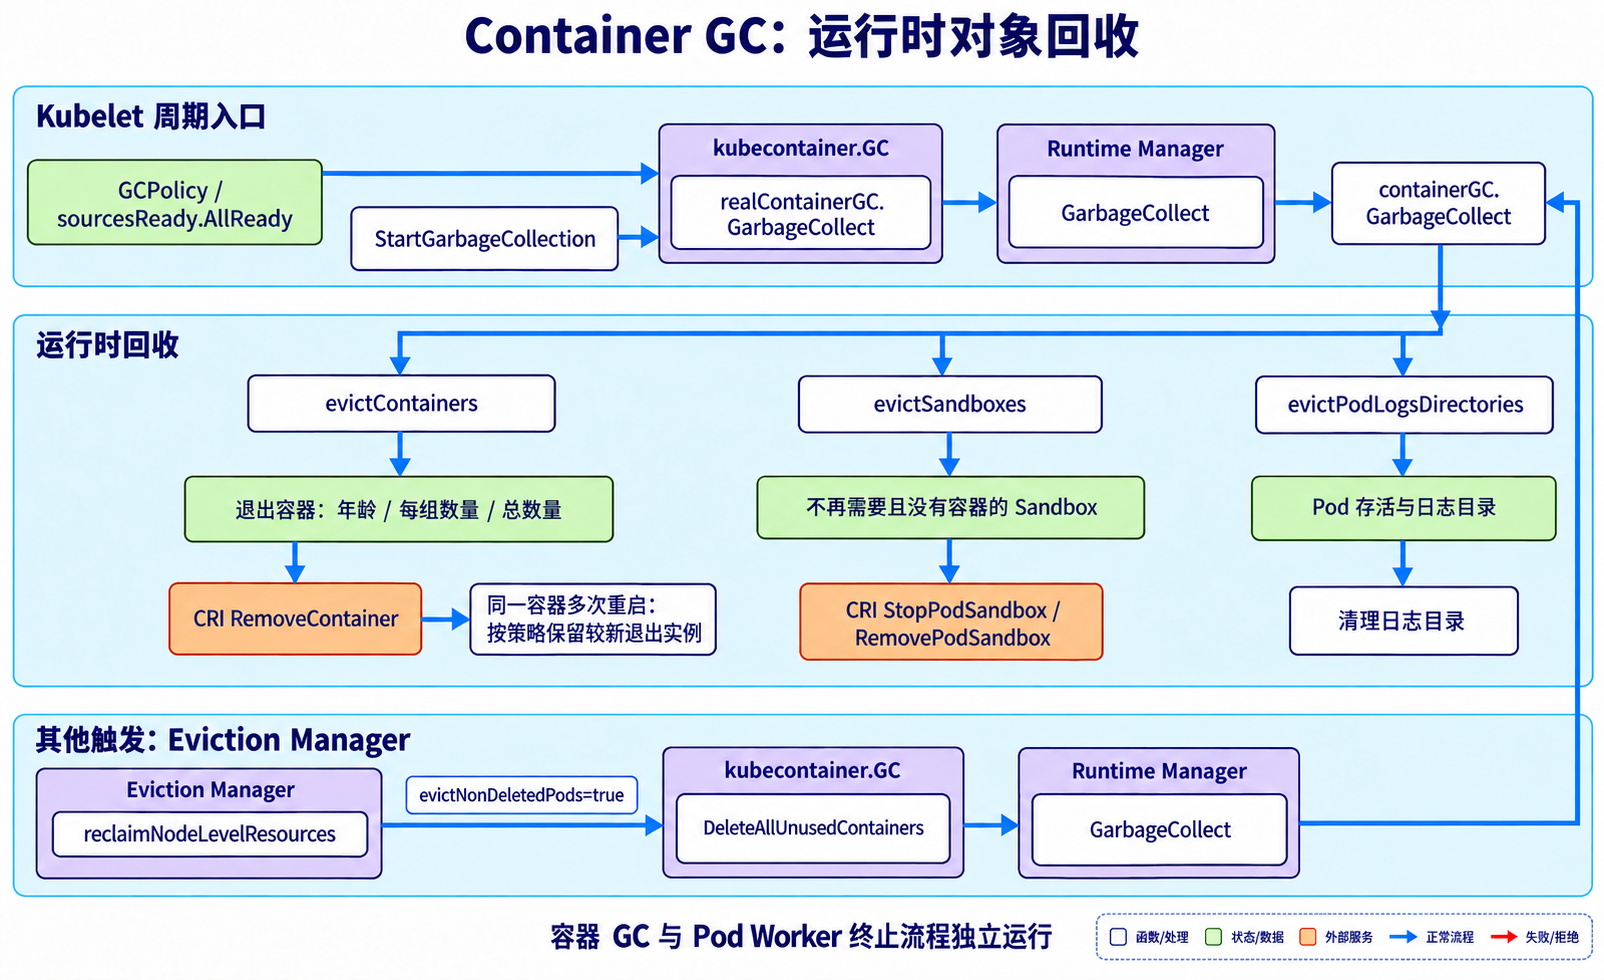
Image GC
Image GC 跟踪镜像使用情况,根据镜像年龄、磁盘占用和保留条件回收未使用镜像。按磁盘占用触发的回收由 Kubelet 配置中的两个参数控制:
imageGCHighThresholdPercent:高阈值,磁盘使用率达到该值时触发镜像回收,默认85,即85%。imageGCLowThresholdPercent:低阈值,表示本轮回收希望降到的目标使用率,默认80,即80%。Image GC 根据这个目标计算需要释放的空间。
低阈值应小于高阈值。在 Kubelet 配置文件中设置这两个字段,例如:
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
imageGCHighThresholdPercent: 85
imageGCLowThresholdPercent: 80
图中镜像文件系统容量为 100Gi,已使用 90Gi,示例高、低阈值分别为 85% 和 80%:
- 触发回收:当前占用为
90%,超过高阈值。 - 计算目标:按低阈值
80%,将占用降到80Gi及以下,需要释放至少10Gi。 - 执行清理:删除满足保留条件、可释放
10Gi的未使用旧镜像,正在使用的服务镜像继续保留。
这个例子中有足够的可回收镜像,因此能够达到目标;实际可释放空间取决于镜像的使用情况和保留条件。
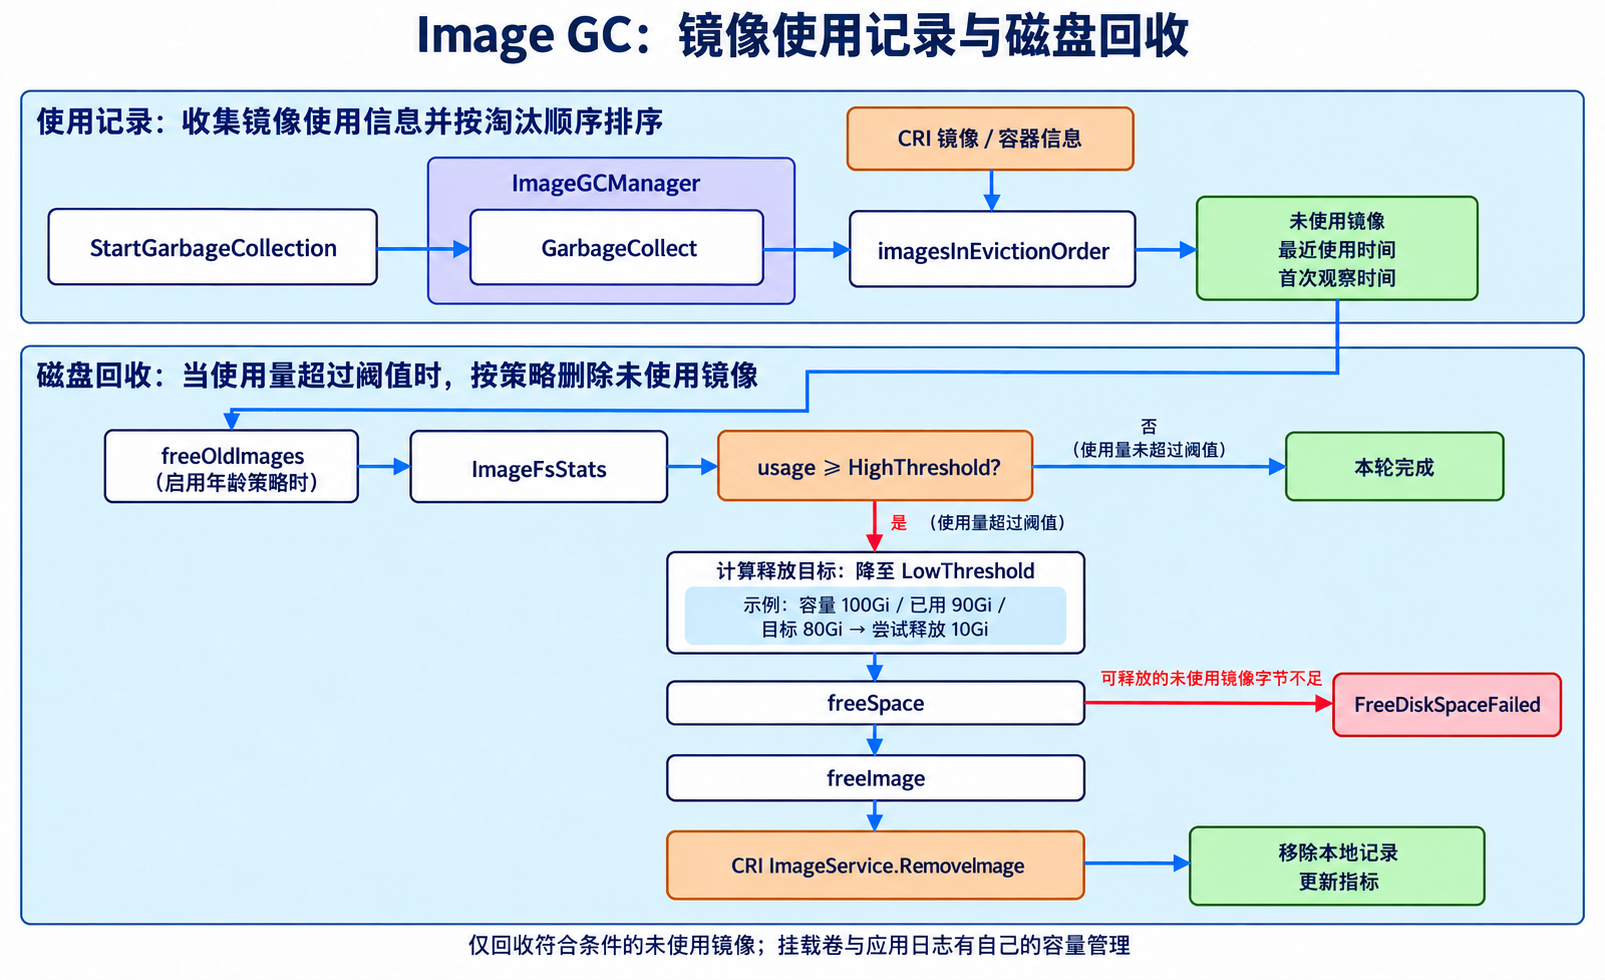
Pod 状态监测与上报
Kubelet 持续观察容器运行状态、检查应用健康,并将 Pod 状态发布到 API Server。这些工作由三个组件配合完成:
- PLEG:采集 Sandbox 和容器的运行状态,更新 Pod Cache,并通过生命周期事件请求 Pod 同步。
- Probe Manager:执行容器探针,保存探测结果,通知 Kubelet 更新状态或处理异常容器。
- Status Manager:保存 Kubelet 计算出的 PodStatus,通过后台任务更新 API Server 中的 Pod
status子资源。
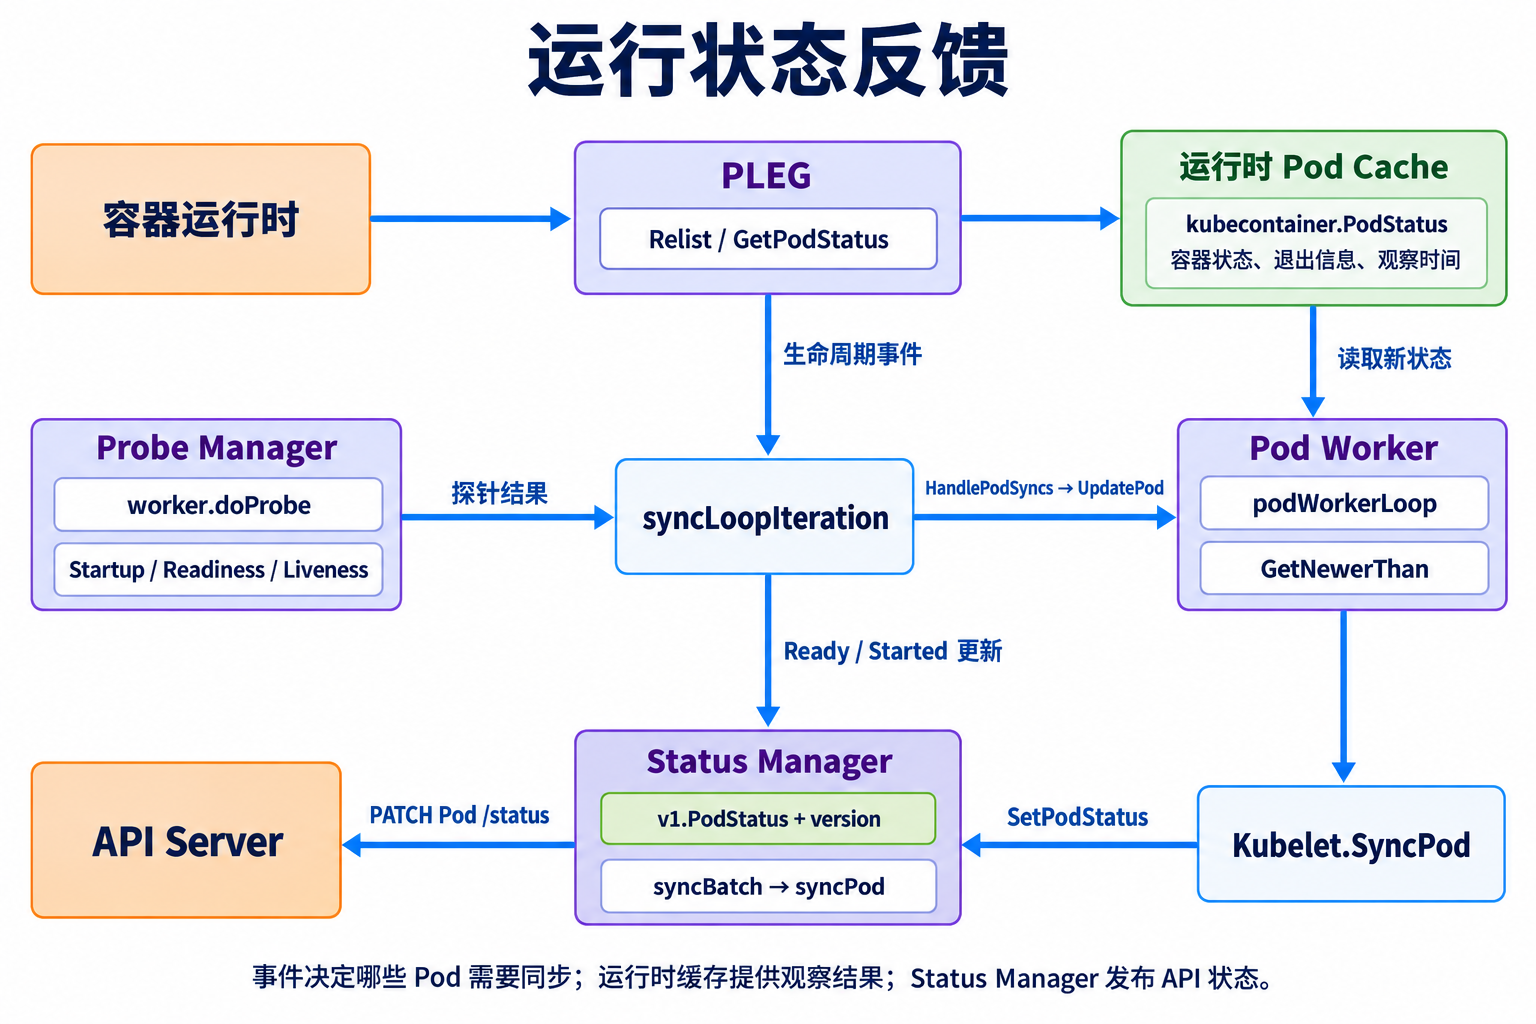
PLEG
PLEG(Pod Lifecycle Event Generator)统一观察本节点容器运行时中的 Sandbox 和容器状态,将结果写入运行状态缓存,并通过生命周期事件通知 Kubelet 处理发生变化的 Pod。
引入 PLEG 之前,各 Pod Worker 分别周期性查询容器运行时。节点上的 Pod 越多,重复查询和并发请求越多;即使没有配置或状态变化,查询仍会产生开销,给 Kubelet 和容器运行时带来压力。这是 Kubelet: Pod Lifecycle Event Generator (PLEG) 设计提案要解决的问题。
PLEG 将容器运行时状态采集集中起来,更新共享缓存,再把状态变化转换为生命周期事件。Pod Worker 从缓存读取本轮同步需要的运行状态,减少各 Worker 重复获取状态的请求。
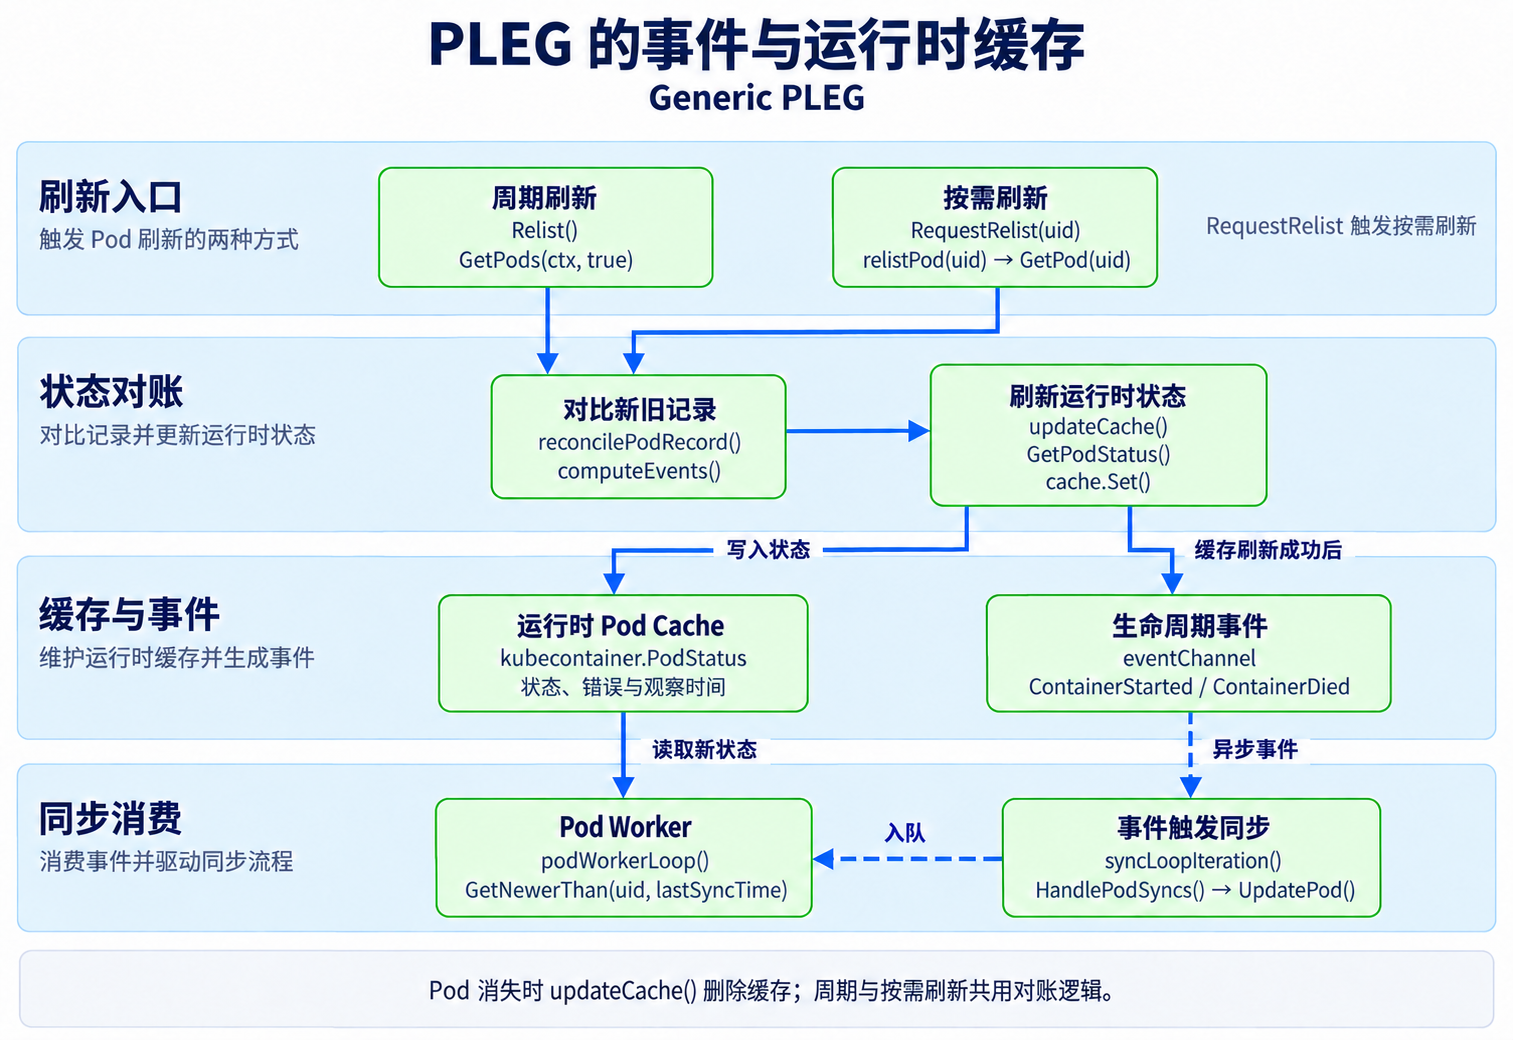
状态采集
Generic PLEG 在后台定期调用 Relist,读取节点上的 Sandbox 和容器列表,并比较新旧记录。
- 读取列表:通过 Runtime Manager 调用
GetPods(ctx, true),取得包括已退出容器在内的容器运行时对象。 - 比较状态:将新列表交给
podRecords,逐个调用reconcilePodRecord,识别容器启动、退出和移除等变化。 - 更新观察时间:完成本轮检查后,推进缓存的整体观察时间,供 Pod Worker 判断是否已有更新的观察结果。
func (g *GenericPLEG) Relist() {
    ...
    ctx := context.Background()
    ...
    timestamp := g.clock.Now()
    ...

    // 读取 Sandbox 和容器,包括已经退出的容器。
    podList, err := g.runtime.GetPods(ctx, true)
    if err != nil {
        ...
        return
    }
    g.updateRelistTime(timestamp)

    pods := kubecontainer.Pods(podList)
    ...
    // 保存本轮列表,逐个比较 Pod 的新旧记录。
    g.podRecords.setCurrent(pods)
    for pid := range g.podRecords {
        g.reconcilePodRecord(ctx, pid)
    }

    // 本轮检查完成后,推进缓存的整体观察时间。
    g.cache.UpdateTime(timestamp)
}
周期查询存在固定开销,即使容器没有变化,也要读取列表。容器刚退出时,也需要等下一轮查询才能发现。Evented PLEG 通过容器运行时主动推送通知,减少查询开销,并更及时地处理变化。
启用 EventedPLEG 且容器运行时支持 CRI 事件流后,两种采集方式配合工作:
- 事件通知:容器运行时通过
GetContainerEvents推送容器事件,Evented PLEG 将事件交给processCRIEvents处理。 - 周期核对:Generic PLEG 降低全量检查频率,继续检查容器运行时状态,补齐遗漏或无法处理的变化。
- 失败处理:事件流读取出错时,主动调用
Relist补查一次。失败次数达到上限后,停止 Evented PLEG,恢复 Generic PLEG 的常规查询频率。
例如,容器刚退出时,容器运行时可以立即发送退出事件。如果连接中断,后续全量检查仍能发现容器已经退出。Evented PLEG 的 Start 在后台运行 watchEventsChannel,接收事件并处理读取失败。
func (e *EventedPLEG) watchEventsChannel() {
    containerEventsResponseCh := make(chan *runtimeapi.ContainerEventResponse, cap(e.eventChannel))
    defer close(containerEventsResponseCh)

    go func() {
        numAttempts := 0
        for {
            // 达到失败次数上限后,恢复 Generic PLEG 的常规查询。
            if numAttempts >= e.eventedPlegMaxStreamRetries {
                if isEventedPLEGInUse() {
                    ...
                    e.Stop()
                    e.genericPleg.Stop()
                    e.Update(e.relistDuration)
                    e.genericPleg.Start()
                    break
                }
            }

            // 接收容器运行时事件,将事件写入接收通道。
            err := e.runtimeService.GetContainerEvents(
                context.Background(),
                containerEventsResponseCh,
                func(runtimeapi.RuntimeService_GetContainerEventsClient) {
                    ...
                },
            )
            if err != nil {
                ...
                // 读取失败后补查容器运行时状态,再尝试重连。
                numAttempts++
                e.Relist()
                ...
            }
        }
    }()

    if isEventedPLEGInUse() {
        e.processCRIEvents(containerEventsResponseCh)
    }
}
事件与缓存
PLEG 取得的运行状态保存在 Pod Cache,供 Pod Worker 执行同步时读取。Pod Manager 保存的期望配置也会随任务交给 Worker,两份信息共同用于判断 Pod 需要执行哪些操作。
Kubelet 的 podCache 字段引用这份缓存,底层由 cache 结构体实现。
pods:类型为map[types.UID]*data,按 Pod UID 保存运行状态记录。status:类型为*PodStatus,通过ContainerStatuses保存各容器的状态,通过SandboxStatuses保存 Sandbox 状态。err:保存读取容器运行时状态时出现的错误,供 Worker 判断本轮状态是否可用。
// cache.go 中的缓存结构。
type cache struct {
    ...
    // 按 Pod UID 保存运行状态记录。
    pods map[types.UID]*data
    ...
}

type data struct {
    // 保存 Sandbox 和容器状态。
    status *PodStatus
    // 保存读取容器运行时状态时出现的错误。
    err error
    ...
}

// runtime.go 中的容器运行时 Pod 状态。
type PodStatus struct {
    // 所属 Pod 的 UID。
    ID types.UID
    ...
    // 各容器的状态,包含运行状态、退出码等。
    ContainerStatuses []*Status
    ...
    // Pod 的 Sandbox 状态。
    SandboxStatuses []*runtimeapi.PodSandboxStatus
    ...
}
PLEG 使用 PodLifecycleEvent 向主循环传递生命周期事件。事件说明哪个 Pod 发生了什么变化,详细运行状态由 Pod Cache 提供。
ID:发生变化的 Pod UID,主循环据此查询 Pod Manager 中的期望配置。Type:事件类型,例如ContainerStarted表示容器启动,ContainerDied表示容器退出,ContainerRemoved表示容器被移除。Data:事件附加数据。在容器启动、退出和移除等事件中,保存对应的容器 ID 字符串。
type PodLifeCycleEventType string

const (
    // 容器进入运行状态。
    ContainerStarted PodLifeCycleEventType = "ContainerStarted"
    // 容器退出。
    ContainerDied PodLifeCycleEventType = "ContainerDied"
    // 容器被移除。
    ContainerRemoved PodLifeCycleEventType = "ContainerRemoved"
    // 状态变化无法由上述单一事件表达时,请求同步 Pod。
    PodSync PodLifeCycleEventType = "PodSync"
    // 容器状态变为未知。
    ContainerChanged PodLifeCycleEventType = "ContainerChanged"
)

type PodLifecycleEvent struct {
    // 发生变化的 Pod UID。
    ID types.UID
    // 生命周期事件类型。
    Type PodLifeCycleEventType
    // 事件附加数据,容器事件中保存容器 ID 字符串。
    Data interface{}
}
Relist 每轮调用 reconcilePodRecord 比较新旧状态。有状态变化或待重试标记时,它会读取详细状态、更新缓存,再发送生命周期事件。
- 读取详细状态:
updateCache通过 Runtime Manager 的GetPodStatus读取详细状态,写入 Pod Cache。 - 失败重试:读取失败时,通过
podsToReinspect.Store记录 Pod UID。下一轮Relist再次调用此方法,LoadAndDelete取出重试标记,即使没有新事件,也会继续调用updateCache读取状态。 - 发送事件:缓存更新成功后,向主循环接收的通道发送生命周期事件。
主循环收到事件后,按 Pod UID 查询期望配置,通过 HandlePodSyncs 向 Pod Worker 提交任务。Pod Worker 调用 GetNewerThan,读取上轮同步结束后刷新的容器运行时状态。缓存还未刷新时,会先等待。
func (g *GenericPLEG) reconcilePodRecord(ctx context.Context, pid types.UID) {
    oldPod := g.podRecords.getOld(pid)
    pod := g.podRecords.getCurrent(pid)
    allContainers := getContainersFromPods(oldPod, pod)

    var events []*PodLifecycleEvent
    for _, container := range allContainers {
        containerEvents := computeEvents(g.logger, oldPod, pod, &container.ID)
        events = append(events, containerEvents...)
    }
    // 取出上轮保存的重试标记,有标记时继续读取详细状态。
    _, reinspect := g.podsToReinspect.LoadAndDelete(pid)
    if len(events) == 0 && !reinspect {
        return
    }

    // 读取详细状态并更新缓存。
    status, updated, err := g.updateCache(ctx, pod, pid)
    if err != nil {
        ...
        // 读取失败时记下 Pod UID,下一轮 Relist 再次处理。
        g.podsToReinspect.Store(pid, empty)
        return
    }
    ...
    g.podRecords.update(pid)
    ...

    for i := range events {
        if events[i].Type == ContainerChanged {
            continue
        }

        // 缓存更新后,再尝试发送生命周期事件。
        select {
        case g.eventChannel <- events[i]:
        default:
            ...
        }
        ...
    }
}
健康检查
PLEG 健康检查关注状态采集是否正常推进。
- 刷新超时:Generic PLEG 的
Healthy检查最近一次成功读取全量列表的时间,超过阈值时返回健康错误。 - 事件积压:Evented PLEG 的
Healthy检查生命周期事件通道是否写满,写满时返回健康错误。
Generic PLEG 的 Healthy 使用 Relist 更新的 relistTime,判断状态刷新是否超时。
func (g *GenericPLEG) Healthy() (bool, error) {
    relistTime := g.getRelistTime()
    if relistTime.IsZero() {
        return false, fmt.Errorf("pleg has yet to be successful")
    }
    ...

    // 距最近一次成功读取列表的时间超过阈值时,返回健康错误。
    elapsed := g.clock.Since(relistTime)
    if elapsed > g.relistDuration.RelistThreshold {
        return false, fmt.Errorf(
            "pleg was last seen active %v ago; threshold is %v",
            elapsed,
            g.relistDuration.RelistThreshold,
        )
    }
    return true, nil
}
Evented PLEG 的 Healthy 比较事件通道中的通知数量与通道容量。两者相等时,说明通道已写满,返回健康错误。
func (e *EventedPLEG) Healthy() (bool, error) {
    // 事件通道已写满时,报告通知积压。
    if len(e.eventChannel) == cap(e.eventChannel) {
        return false, fmt.Errorf(
            "EventedPLEG: pleg event channel capacity is full with %v events",
            len(e.eventChannel),
        )
    }
    ...
    return true, nil
}
Probe Manager
Probe Manager 根据 Pod 中的探针配置,检查应用是否完成启动、能否接收流量以及运行是否健康。每种已配置的探针由独立的探针 Worker 执行,将结果写入对应的 Startup、Readiness 或 Liveness 探针结果缓存,再通过结果更新通道通知主循环处理。
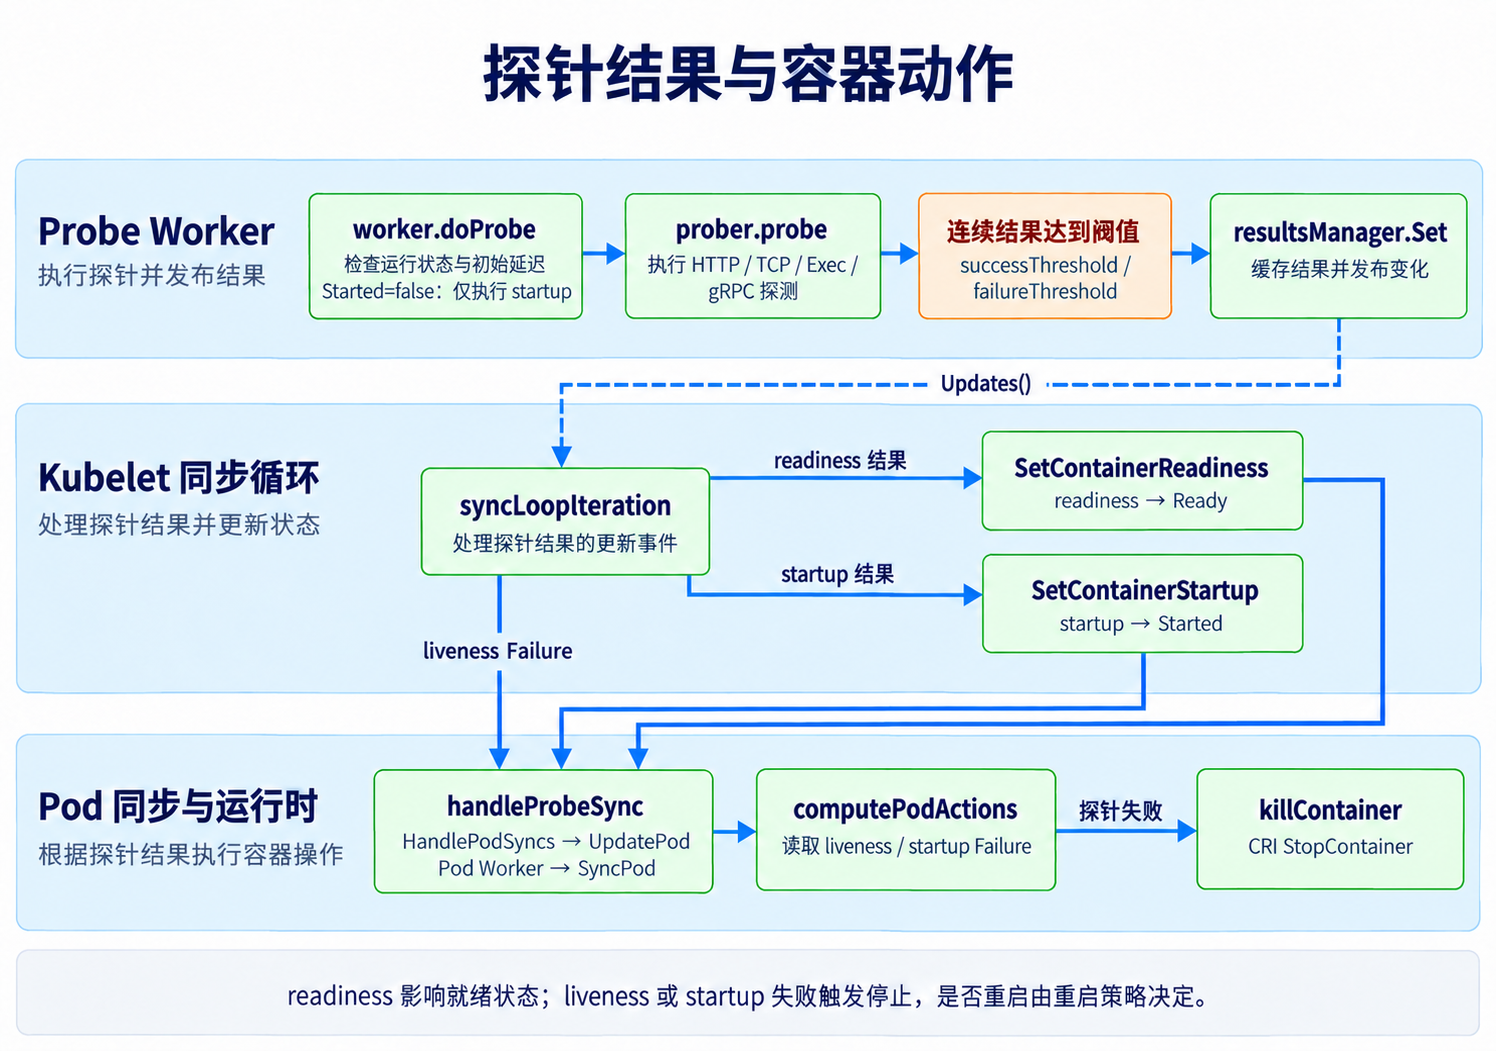
- 探针类型:Startup 检查启动是否完成,Readiness 检查能否接收流量,Liveness 检查运行是否健康。
- 探测执行:为已配置探针的容器创建 Worker,按周期执行检查,累计连续结果。
- 结果更新:达到阈值后更新缓存,并通知 Kubelet 更新状态或请求 Pod 同步。
探针类型
同一个容器可以配置三种探针。配置 Startup Probe 后,Readiness 和 Liveness 等待启动探测成功,再开始执行。
- Startup:用于模型加载、数据恢复等启动较慢的容器,为初始化预留足够时间,避免应用尚未启动完成就因 Liveness 连续失败而被反复重启。
- Readiness:判断应用当前是否能够接收业务请求。例如,依赖服务尚未就绪或应用暂时过载时,可以通过 Readiness 报告未就绪状态。
- Liveness:用于应用启动后的持续健康检查,发现死锁等需要重启才能恢复的异常。相比启动阶段较长的等待时间,Liveness 可以配置较短的失败容忍时间,以便更快处理故障。
探测执行
Pod Worker 在正常同步阶段调用 Kubelet 的 SyncPod。SyncPod 将当前 Pod 配置传给 kl.probeManager.AddPod(ctx, pod),为配置了探针的容器准备探测任务。
func (kl *Kubelet) SyncPod(ctx context.Context, updateType kubetypes.SyncPodType, pod, mirrorPod *v1.Pod, podStatus *kubecontainer.PodStatus) (isTerminal bool, postSync func(), err error) {
    ...
    // 将当前 Pod 配置交给 Probe Manager,准备探针 Worker。
    kl.probeManager.AddPod(ctx, pod)
    ...
}
Probe Manager 的 AddPod 按以下过程创建并启动探针 Worker:
- 定位 Worker:通过 Pod UID、容器名和探针类型组成的
probeKey查找探针 Worker。 - 创建 Worker:探针尚无对应 Worker 时,调用
newWorker创建实例,保存到workers。 - 后台执行:通过
go w.run(ctx)启动独立 goroutine,按探针配置运行。
下面保留 Startup 分支,Readiness 和 Liveness 使用相同的创建方式。
type probeKey struct {
    podUID        types.UID
    containerName string
    probeType     probeType
}

func (m *manager) AddPod(ctx context.Context, pod *v1.Pod) {
    m.workerLock.Lock()
    defer m.workerLock.Unlock()
    ...

    key := probeKey{podUID: pod.UID}
    for _, c := range append(pod.Spec.Containers, getRestartableInitContainers(pod)...) {
        key.containerName = c.Name

        if c.StartupProbe != nil {
            key.probeType = startup
            if _, ok := m.workers[key]; ok {
                ...
                return
            }

            // 保存探针 Worker,并在独立 goroutine 中运行。
            w := newWorker(m, startup, pod, c)
            m.workers[key] = w
            go w.run(ctx)
        }
        ...
    }
}
Kubelet 分别创建三个探针结果 Manager,供 Liveness、Readiness 和 Startup 使用。它们的接口类型都是 results.Manager,底层都使用 *manager 实现;每次调用 NewManager,都会创建独立的探针结果缓存 cache 和通知通道 updates。
type Manager interface {
    // 按容器 ID 读取探针结果。
    Get(kubecontainer.ContainerID) (Result, bool)
    // 写入探针结果,首次记录或结果变化时发送通知。
    Set(kubecontainer.ContainerID, Result, *v1.Pod)
    // 移除对应容器的探针结果。
    Remove(kubecontainer.ContainerID)
    // 返回通知通道的接收端,供主循环读取。
    Updates() <-chan Update
}

type manager struct {
    ...
    // 按容器 ID 保存当前探针的结果。
    cache map[kubecontainer.ContainerID]Result
    // 将结果变化通知主循环。
    updates chan Update
}

func NewManager() Manager {
    // 每个实例分别创建缓存和通知通道。
    return &manager{
        cache:   make(map[kubecontainer.ContainerID]Result),
        updates: make(chan Update, 20),
    }
}
AddPod 调用的 newWorker 按探针类型,将 Probe Manager 持有的一个结果 Manager 保存到 Worker 的 resultsManager 中。这些实例由 Kubelet 创建 Probe Manager 时传入,与主循环中的 kl.readinessManager、kl.startupManager、kl.livenessManager 是同一组对象。
type worker struct {
    ...
    // 通过统一接口读写当前探针对应的结果。
    resultsManager results.Manager
    ...
}

func newWorker(m *manager, probeType probeType, pod *v1.Pod, container v1.Container) *worker {
    w := &worker{
        ...
    }
    switch probeType {
    case readiness:
        w.spec = container.ReadinessProbe
        // Readiness Worker 使用 Readiness 结果 Manager。
        w.resultsManager = m.readinessManager
        ...
    case liveness:
        w.spec = container.LivenessProbe
        // Liveness Worker 使用 Liveness 结果 Manager。
        w.resultsManager = m.livenessManager
        ...
    case startup:
        w.spec = container.StartupProbe
        // Startup Worker 使用 Startup 结果 Manager。
        w.resultsManager = m.startupManager
        ...
    }
    ...
    return w
}
探针 Worker 的 run 循环按 periodSeconds 调用 doProbe。容器已经运行、初始延迟结束并满足启动检查条件后,执行 HTTP、TCP、Exec 或 gRPC 检查。
- 累计结果:连续得到相同结果时,增加
resultRun。结果变化时,从1重新计数。 - 判断阈值:未达到成功或失败阈值时,保留缓存中的已有结果。
- 写入结果:达到阈值后,调用
w.resultsManager.Set(w.containerID, result, w.pod),将容器 ID、探测结果和 Pod 交给当前探针对应的结果 Manager。
例如,Readiness 当前为 Success,要求连续失败 3 次。前两次失败仍保留 Success,第三次才写入 Failure。
func (w *worker) doProbe(ctx context.Context) (keepGoing bool) {
    ...
    result, err := w.probeManager.prober.probe(
        ctx, w.probeType, w.pod, status, w.container, w.containerID,
    )
    if err != nil {
        return true
    }
    ...

    // 累计连续相同结果,结果变化时重新计数。
    if w.lastResult == result {
        w.resultRun++
    } else {
        w.lastResult = result
        w.resultRun = 1
    }

    // 达到阈值之前,保留缓存中的已有结果。
    if (result == results.Failure && w.resultRun < int(w.spec.FailureThreshold)) ||
        (result == results.Success && w.resultRun < int(w.spec.SuccessThreshold)) {
        return true
    }

    // 将达到阈值的结果交给当前探针对应的结果 Manager。
    w.resultsManager.Set(w.containerID, result, w.pod)
    ...
    return true
}
结果更新
doProbe 调用的 Set 保存探针结果,并在首次记录或结果变化时,通过 updates 通道通知 Kubelet 主循环。Startup、Readiness 和 Liveness 各自维护探针结果缓存 cache,以容器 ID 为键。
- 比较结果:
setInternal按容器 ID 从该结果 Manager 的cache读取旧结果。首次记录或结果变化时,写入新结果并返回true;结果相同时返回false。 - 发送通知:
Set收到true后,通过updates通道发送容器 ID、探测结果和 Pod UID。Updates()返回同一通道的接收端,供主循环接收通知。
func (m *manager) Set(id kubecontainer.ContainerID, result Result, pod *v1.Pod) {
    // 首次记录或结果变化时,向主循环发送通知。
    if m.setInternal(id, result) {
        m.updates <- Update{id, result, pod.UID}
    }
}

func (m *manager) setInternal(id kubecontainer.ContainerID, result Result) bool {
    m.Lock()
    defer m.Unlock()

    // 按容器 ID 读取当前探针缓存中的旧结果。
    prev, exists := m.cache[id]
    // 首次记录或结果变化时,写入新结果并返回 true。
    if !exists || prev != result {
        m.cache[id] = result
        return true
    }

    // 结果相同时返回 false,保留原结果。
    return false
}

func (m *manager) Updates() <-chan Update {
    // 主循环从 Set 写入的同一通道接收探针通知。
    return m.updates
}
主循环的 syncLoopIteration 接收探针通知,处理状态更新和 Pod 同步请求:
- Readiness:判断应用当前能否接收请求。主循环将结果写入容器的
Ready,更新 Pod 就绪条件,再通知 Pod Worker 做一次常规同步。Readiness 失败只影响就绪状态,容器继续运行。 - Startup:判断应用是否完成启动。成功后将
Started设为true,停止当前容器的启动探测,已配置的 Readiness、Liveness 开始执行。 如果启动探测失败,主循环通知 Pod Worker,由后续同步停止当前容器,再按重启策略决定是否重建。 - Liveness:仅在结果为
Failure时,通过handleProbeSync通知 Pod Worker 同步。后续同步由 Runtime Manager 读取失败结果,停止当前容器,再按重启策略决定是否重建。
func (kl *Kubelet) syncLoopIteration(ctx context.Context, configCh <-chan kubetypes.PodUpdate, handler SyncHandler,
    syncCh <-chan time.Time, housekeepingCh <-chan time.Time, plegCh <-chan *pleg.PodLifecycleEvent) bool {
    ...
    select {
    ...
    case update := <-kl.readinessManager.Updates():
        ready := update.Result == proberesults.Success
        // 主循环将 Readiness 结果写入 Status Manager。
        kl.statusManager.SetContainerReadiness(logger, update.PodUID, update.ContainerID, ready)
        ...
        // 更新就绪状态后,再请求对应 Pod 同步。
        handleProbeSync(ctx, kl, update, handler, "readiness", status)

    case update := <-kl.startupManager.Updates():
        started := update.Result == proberesults.Success
        // 主循环将 Startup 结果写入 Status Manager。
        kl.statusManager.SetContainerStartup(logger, update.PodUID, update.ContainerID, started)
        ...
        // 更新启动状态后,再请求对应 Pod 同步。
        handleProbeSync(ctx, kl, update, handler, "startup", status)

    case update := <-kl.livenessManager.Updates():
        // Liveness 失败时,请求 Pod 同步。
        if update.Result == proberesults.Failure {
            handleProbeSync(ctx, kl, update, handler, "liveness", "unhealthy")
        }
    ...
    }
    return true
}

func handleProbeSync(ctx context.Context, kl *Kubelet, update proberesults.Update, handler SyncHandler, probe, status string) {
    ...
    // 按通知中的 Pod UID 查询最新的期望配置。
    pod, ok := kl.podManager.GetPodByUID(update.PodUID)
    if !ok {
        ...
        return
    }
    ...
    handler.HandlePodSyncs(ctx, []*v1.Pod{pod})
}

func (kl *Kubelet) HandlePodSyncs(ctx context.Context, pods []*v1.Pod) {
    ...
    for _, pod := range pods {
        ...
        // 向对应 Pod Worker 提交普通同步请求。
        kl.podWorkers.UpdatePod(ctx, UpdatePodOptions{
            Pod:        pod,
            ...
            UpdateType: kubetypes.SyncPodSync,
            ...
        })
    }
}
Status Manager
Status Manager 将准备上报的 PodStatus 保存在本地状态表 podStatuses 中,再通过后台任务更新 API Server。每条本地记录还保存节点终止处理是否完成,供删除判断使用。
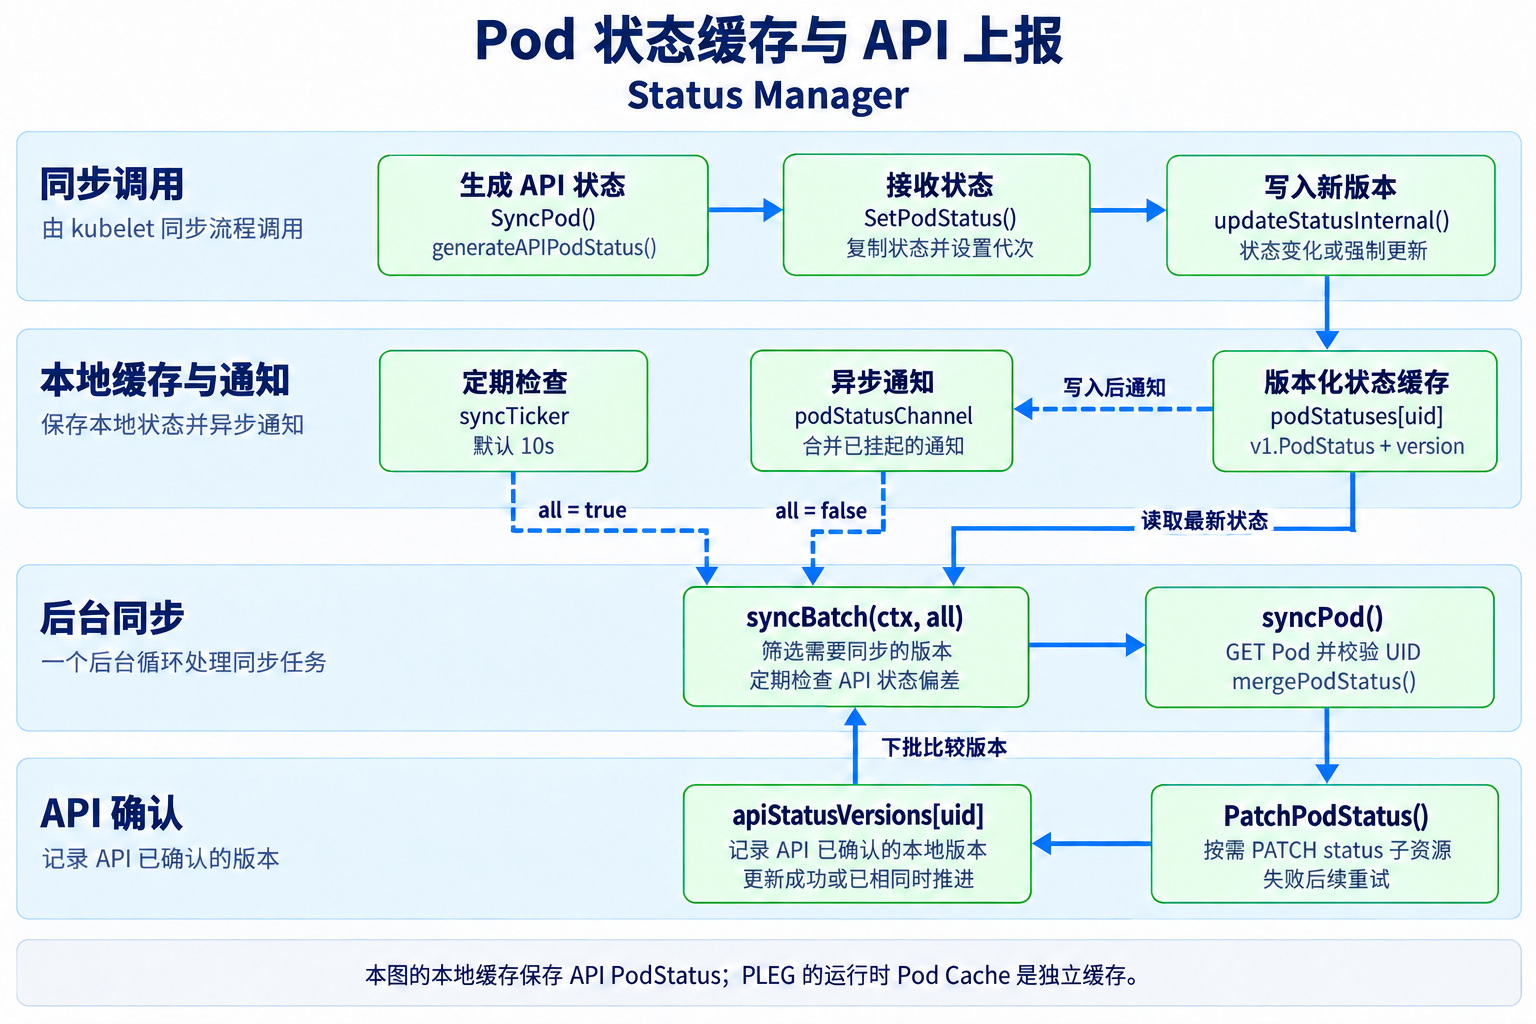
状态缓存
Pod 同步和探针结果变化通过两种入口,更新 podStatuses 中同一份 PodStatus。
- Pod 同步时提交完整状态:Kubelet 的
SyncPod根据容器运行时状态和探针结果生成 PodStatus,其中包含 Pod 整体状态和各容器状态,再通过SetPodStatus保存,供后台上报 API Server。 - 探针结果变化时更新部分字段:探针独立执行,结果可能在两次 Pod 同步之间发生变化。主循环通过
SetContainerReadiness、SetContainerStartup,更新已有 PodStatus 中对应容器的Ready、Started,再通知后台发布。Readiness 变化时,还会重新计算 Pod 的就绪条件。
func (kl *Kubelet) SyncPod(ctx context.Context, updateType kubetypes.SyncPodType, pod, mirrorPod *v1.Pod, podStatus *kubecontainer.PodStatus) (isTerminal bool, postSync func(), err error) {
    ...
    // 根据容器运行时状态和探针结果,生成完整 PodStatus。
    apiPodStatus := kl.generateAPIPodStatus(ctx, pod, podStatus, false)
    ...
    // 保存完整的 PodStatus,并通知后台发布。
    kl.statusManager.SetPodStatus(logger, pod, apiPodStatus)
    ...
}

func (kl *Kubelet) syncLoopIteration(ctx context.Context, configCh <-chan kubetypes.PodUpdate, handler SyncHandler,
    syncCh <-chan time.Time, housekeepingCh <-chan time.Time, plegCh <-chan *pleg.PodLifecycleEvent) bool {
    ...
    select {
    ...
    case update := <-kl.readinessManager.Updates():
        ready := update.Result == proberesults.Success
        // 更新已有 PodStatus 中对应容器的 Ready,并重新计算 Pod 就绪条件。
        kl.statusManager.SetContainerReadiness(logger, update.PodUID, update.ContainerID, ready)
        ...
    case update := <-kl.startupManager.Updates():
        started := update.Result == proberesults.Success
        // 更新已有 PodStatus 中对应容器的 Started。
        kl.statusManager.SetContainerStartup(logger, update.PodUID, update.ContainerID, started)
        ...
    }
    return true
}
SetPodStatus 接收 Kubelet 新计算的 PodStatus,调用 updateStatusInternal,先保存到本地状态表 podStatuses,再通知后台上报 API Server。
- 检查变化:按 Pod UID 读取旧记录,与新状态比较。已有相同状态且
forceUpdate=false时,跳过后续保存和通知;Pod 带有删除标记时,SetPodStatus会要求强制更新,即使状态相同也继续处理。 - 保存最新状态:将新 PodStatus 写入
podStatuses[pod.UID],覆盖该 Pod 的旧记录。这条记录还保存podIsFinished,表示节点上的终止清理是否完成,供删除确认使用。 - 通知后台:状态写入后,尝试向
podStatusChannel发送一个空信号,后台收到后从podStatuses读取实际状态并上报。通道已有信号时不再重复发送;新状态已经保存在表中,后台处理通知时读取最新记录。
func (m *manager) SetPodStatus(logger klog.Logger, pod *v1.Pod, status v1.PodStatus) (v1.PodStatus, bool) {
    ...
    // Pod 带删除标记时强制更新,继续推进终止与删除。
    changed, notif := m.updateStatusInternal(logger, pod, status, pod.DeletionTimestamp != nil, false)
    ...
    return m.podStatuses[pod.UID].status, changed
}

func (m *manager) updateStatusInternal(logger klog.Logger, pod *v1.Pod, status v1.PodStatus, forceUpdate, podIsFinished bool) (bool, *podStatusNotification) {
    ...
    cachedStatus, isCached := m.podStatuses[pod.UID]
    ...
    // 状态未变化且无需强制更新时,结束本次处理。
    if isCached && isPodStatusByKubeletEqual(&cachedStatus.status, &status) && !forceUpdate {
        ...
        return false, nil
    }

    // 本地记录同时保存待上报状态和节点清理完成标记。
    newStatus := versionedPodStatus{
        status:        status,
        podIsFinished: podIsFinished,
        ...
    }
    ...
    // 先将该 Pod 的最新记录写入本地状态表。
    m.podStatuses[pod.UID] = newStatus

    // 再发送空信号,通知后台从 podStatuses 读取状态。
    select {
    case m.podStatusChannel <- struct{}{}:
    default:
        // 已有待处理通知,新状态已经保存在表中。
    }
    ...
    return true, notification
}
状态发布
Kubelet.Run 调用 Status Manager 的 Start,启动独立的后台 goroutine。
- 变化触发:收到
podStatusChannel通知后,调用syncBatch(ctx, false)处理新状态。 - 定时检查:每 10 秒调用
syncBatch(ctx, true),执行一次完整检查。
const syncPeriod = 10 * time.Second

func (m *manager) Start(ctx context.Context) {
    ...
    syncTicker := time.NewTicker(syncPeriod).C

    // 状态发布在独立 goroutine 中执行。
    go wait.Forever(func() {
        for {
            select {
            case <-m.podStatusChannel:
                // 处理本地状态变化通知。
                m.syncBatch(ctx, false)
            case <-syncTicker:
                // 定时检查状态发布与删除条件。
                m.syncBatch(ctx, true)
            }
        }
    }, 0)
}
后台的 syncBatch 将本轮选中的 Pod 状态逐个交给 Status Manager 的 syncPod。PodStatus 中还包含其他组件维护的信息,发布时需要保留这些字段:
- 读取 API 状态:
syncPod先从 API Server 读取当前 Pod。代码中的pod.Status是 API 中的状态,status.status是本地准备发布的状态。 - 保留其他组件的字段:
mergePodStatus以本地状态为基础,采用 Kubelet 计算的容器状态、Ready等条件,同时保留 API 中由其他组件维护的自定义条件和资源申领状态等字段。 - 写入 API:将整理后的 PodStatus 交给
PatchPodStatus,更新 Pod 的status子资源。
PodStatus 合并示例
下面是更新后 API 中的 PodStatus 片段。已有的自定义条件保持为 True,Kubelet 维护的容器就绪条件和 Pod 就绪条件为 False。
func (m *manager) syncBatch(ctx context.Context, all bool) int {
    ...
    // 逐个发布本轮选中的 Pod 状态。
    for _, update := range updatedStatuses {
        ...
        m.syncPod(ctx, update.podUID, update.status)
    }
    return len(updatedStatuses)
}

func (m *manager) syncPod(ctx context.Context, uid types.UID, status versionedPodStatus) {
    ...
    // 读取 API 中的当前 Pod,取得其他组件已经写入的状态。
    pod, err := m.kubeClient.CoreV1().Pods(status.podNamespace).Get(ctx, status.podName, metav1.GetOptions{})
    ...
    if err != nil {
        ...
        return
    }
    ...

    // 采用本地计算的状态,同时保留 API 中其他组件负责的字段。
    mergedStatus := mergePodStatus(pod, pod.Status, status.status, m.podDeletionSafety.PodCouldHaveRunningContainers(pod))

    // 将整理后的状态写入 Pod 的 status 子资源。
    newPod, patchBytes, unchanged, err := statusutil.PatchPodStatus(
        ctx, m.kubeClient, pod.Namespace, pod.Name,
        pod.UID, pod.Status, mergedStatus,
    )
    ...
    if err != nil {
        ...
        return
    }
    ...
}
删除确认
Pod Worker 完成容器终止和节点资源清理后,通过 TerminatePod 通知 Status Manager。Status Manager 在后台发布最终状态,确认删除条件满足后,请求删除 API Server 中的 Pod 对象。
Pod Worker 调用 Kubelet 的 SyncTerminatedPod 执行节点清理:
- 等待卸载:卷卸载失败时返回,等待后续同步重试。
- 记录完成:节点清理完成后,调用
TerminatePod,将完成信息交给 Status Manager。
func (kl *Kubelet) SyncTerminatedPod(ctx context.Context, pod *v1.Pod, podStatus *kubecontainer.PodStatus) error {
    ...
    // 卷卸载成功后,才继续执行后续清理。
    if err := kl.volumeManager.WaitForUnmount(ctx, pod); err != nil {
        return err
    }
    ...
    // 节点清理完成后,记录完成信息。
    kl.statusManager.TerminatePod(logger, pod)
    ...
    return nil
}
Status Manager 的 TerminatePod 整理最终状态,再调用前面的 updateStatusInternal。最后两个参数分别是 forceUpdate 和 podIsFinished,都传入 true,强制更新本地记录并保存节点处理完成标记。
func (m *manager) TerminatePod(logger klog.Logger, pod *v1.Pod) {
    ...
    // 强制更新最终状态,并将 podIsFinished 保存为 true。
    _, notification = m.updateStatusInternal(logger, pod, status, true, true)
}
Status Manager 的后台 syncPod 发布状态后,调用 canBeDeleted 检查是否可以删除 API Server 中的 Pod 对象。
- 删除请求:确认 Pod 已设置
deletionTimestamp。 - 最终状态:确认 API 中的 phase 已进入
Succeeded或Failed。 - 处理完成:确认本地记录中的
podIsFinished为true。 - 提交删除:条件满足后,以零宽限期删除 API 对象,并通过 UID 前置条件限定目标 Pod。
func (m *manager) syncPod(ctx context.Context, uid types.UID, status versionedPodStatus) {
    ...
    // 状态发布后,检查是否满足删除条件。
    if m.canBeDeleted(logger, pod, status.status, status.podIsFinished) {
        // 使用零宽限期,并将删除请求限定到对应 Pod UID。
        deleteOptions := metav1.DeleteOptions{
            GracePeriodSeconds: new(int64),
            Preconditions: metav1.NewUIDPreconditions(string(pod.UID)),
        }
        err = m.kubeClient.CoreV1().Pods(pod.Namespace).Delete(ctx, pod.Name, deleteOptions)
        if err != nil {
            ...
            return
        }
        ...
        m.deletePodStatus(uid)
    }
}

func (m *manager) canBeDeleted(logger klog.Logger, pod *v1.Pod, status v1.PodStatus, podIsFinished bool) bool {
    // 确认已有删除请求,并排除 Mirror Pod。
    if pod.DeletionTimestamp == nil || kubetypes.IsMirrorPod(pod) {
        return false
    }
    // 确认 API 中的 phase 已进入终态。
    if !podutil.IsPodPhaseTerminal(pod.Status.Phase) {
        ...
        return false
    }
    // 确认节点上的终止处理已经完成。
    if podIsFinished {
        ...
        return true
    }
    return false
}
节点状态与心跳
Kubelet 通过 Node Status 发布节点的资源和运行条件,通过 Lease 持续上报心跳。控制面的 Node Lifecycle Controller 观察它们的更新,判断节点是否仍在联系。
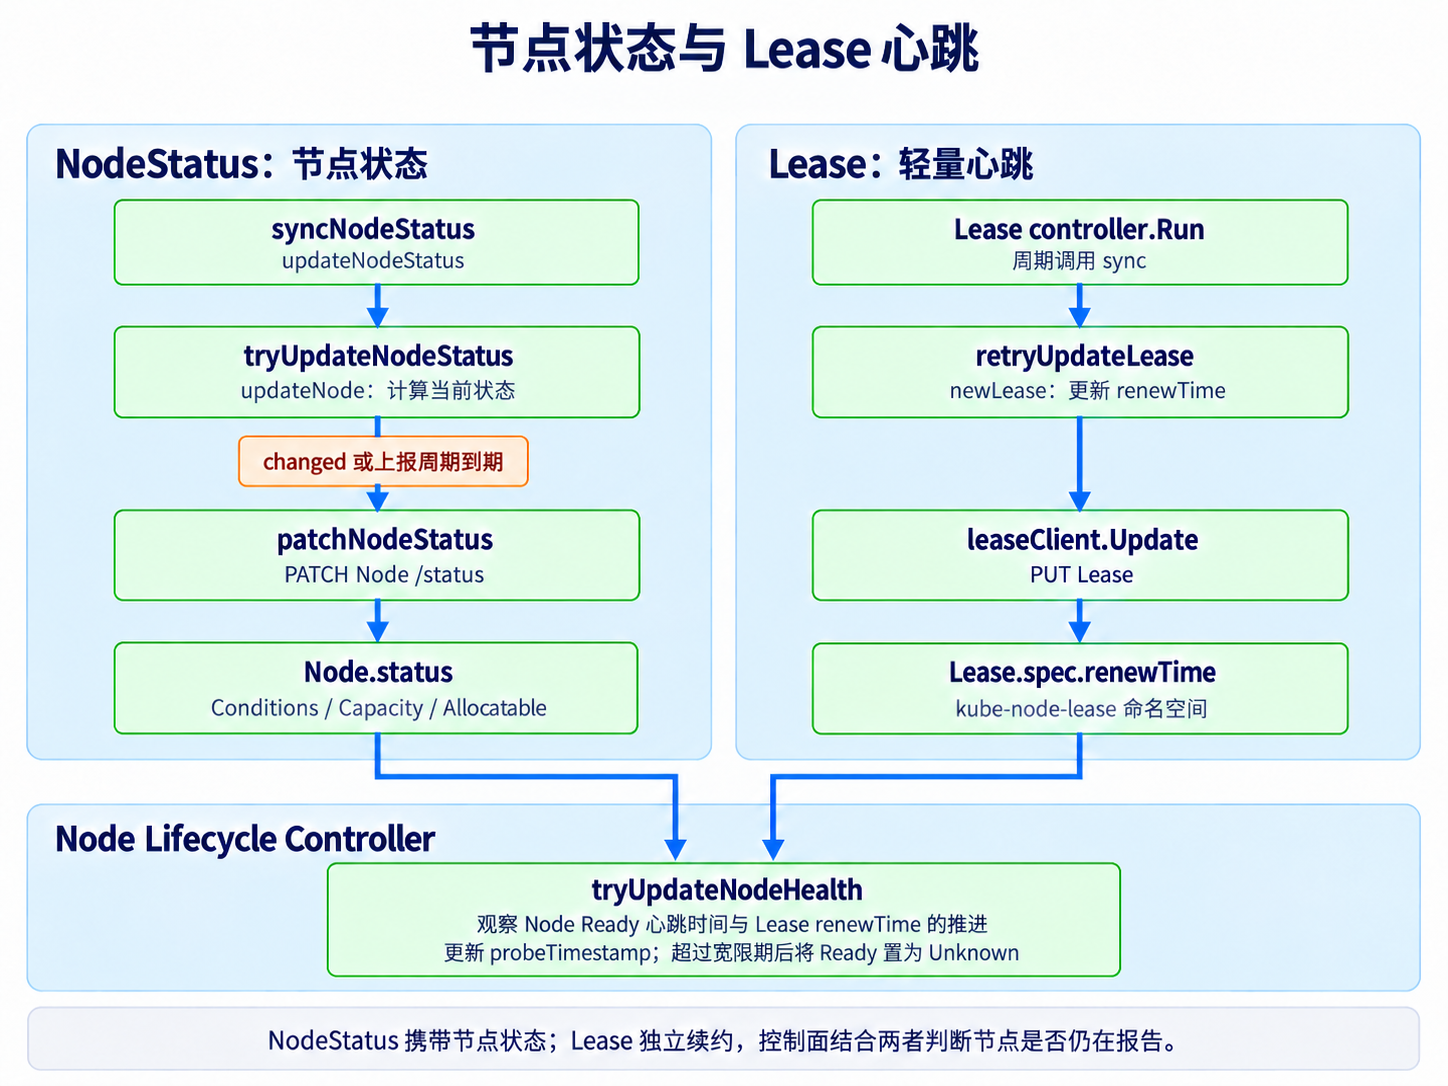
Node Status
Node 是 API Server 中表示节点的对象,包含以下两部分:
spec:保存节点网络、基础设施标识和调度相关配置。status:保存 Kubelet 及相关组件上报的资源、运行条件、地址和系统信息。
Kubelet 启动时创建或读取 Node 对象,随后周期计算状态,并在内容变化或报告周期到期时更新 status 子资源。
Node 对象示例
apiVersion: v1
kind: Node
metadata:
  name: node-1
  labels:
    kubernetes.io/arch: arm64
    kubernetes.io/os: linux
    kubernetes.io/hostname: node-1
    node-role.kubernetes.io/control-plane: ''
spec:
  podCIDR: 10.244.0.0/24
  podCIDRs:
    - 10.244.0.0/24
  providerID: kind://docker/example/node-1
status:
  capacity:
    cpu: '14'
    ephemeral-storage: '127641059328'
    memory: 45194344Ki
    pods: '110'
  allocatable:
    cpu: '14'
    ephemeral-storage: '127641059328'
    memory: 45194344Ki
    pods: '110'
  conditions:
    - type: NetworkUnavailable
      status: 'False'
      reason: CiliumIsUp
      message: Cilium is running on this node
    - type: MemoryPressure
      status: 'False'
      reason: KubeletHasSufficientMemory
      message: kubelet has sufficient memory available
    - type: DiskPressure
      status: 'False'
      reason: KubeletHasNoDiskPressure
      message: kubelet has no disk pressure
    - type: PIDPressure
      status: 'False'
      reason: KubeletHasSufficientPID
      message: kubelet has sufficient PID available
    - type: Ready
      status: 'True'
      reason: KubeletReady
      message: kubelet is posting ready status
      # Node 心跳时间,由 Kubelet 的 Ready setter 写入,Node Lifecycle Controller 通过此字段的变化识别新心跳。
      lastHeartbeatTime: '2025-01-01T12:00:00Z'
  addresses:
    - address: 192.0.2.10
      type: InternalIP
    - address: node-1
      type: Hostname
  daemonEndpoints:
    kubeletEndpoint:
      Port: 10250
  nodeInfo:
    architecture: arm64
    operatingSystem: linux
节点注册
Kubelet.Run 将节点状态更新作为后台任务启动,在独立 goroutine 中按 nodeStatusUpdateFrequency 周期调用 syncNodeStatus。启用节点注册时,syncNodeStatus 先调用 registerWithAPIServer,向 API Server 注册当前节点的 Node 对象。
注册主要包含两个步骤:
- 构造对象:
initialNode使用节点名称、标签、污点和初始状态等信息构造 Node。 - 提交注册:
tryRegisterWithAPIServer向 API Server 创建 Node。同名对象已存在时,读取已有对象并协调 Kubelet 负责的字段。
注册处理完成后,syncNodeStatus 调用 updateNodeStatus。它通过 tryUpdateNodeStatus 触发状态生成,再按状态上报中的条件决定是否写入 API Server。
func (kl *Kubelet) syncNodeStatus(ctx context.Context) {
    ...
    if kl.registerNode {
        // 向 API Server 注册当前节点的 Node 对象。
        kl.registerWithAPIServer(ctx)
    }
    // 通过 tryUpdateNodeStatus 计算状态,并按条件写入 Node.status。
    if err := kl.updateNodeStatus(ctx); err != nil {
        ...
    }
}

func (kl *Kubelet) registerWithAPIServer(ctx context.Context) {
    if kl.registrationCompleted {
        return
    }
    ...
    for {
        ...
        // 构造待注册的 Node 对象。
        node, err := kl.initialNode(ctx)
        if err != nil {
            ...
            continue
        }
        // 调用 API 创建 Node,已存在时读取并协调相关字段。
        if kl.tryRegisterWithAPIServer(ctx, node) {
            // 记录注册完成,后续调用直接返回。
            kl.registrationCompleted = true
            return
        }
    }
}
状态生成
Kubelet 从资源管理、容器运行时、卷管理等模块取得观察结果,汇总到 Node Status。主要字段包括:
- Capacity:节点的资源总量,包括 CPU、内存等资源。
- Allocatable:扣除相关预留后可供 Pod 使用的资源。例如,节点有 8 个 CPU,相关预留合计占用 2 个 CPU,可分配量为 6 个 CPU。
- Conditions:记录节点的运行条件,主要包括:
- Ready:节点是否满足运行条件。
- MemoryPressure:节点是否存在内存压力。
- DiskPressure:节点是否存在磁盘空间或 inode 压力。
- PIDPressure:节点是否存在进程 ID 资源压力。
- Addresses:节点的 IP 地址和主机名。
- NodeInfo:节点的操作系统、内核、处理器架构和容器运行时等信息。
- Images:节点上已有的容器镜像信息。
- VolumesInUse:节点当前使用的卷。
上述字段都有对应的 setter,负责将各模块的观察结果写入 Node 对象。源码中的 Setter 是函数类型,接收上下文和 Node 对象指针,返回 error。setter 无需实现接口,函数签名匹配即可:
type Setter func(ctx context.Context, node *v1.Node) error
NewMainKubelet 在构造 Kubelet 时调用 defaultNodeStatusFuncs 创建并收集 setter,将返回的函数列表保存在 klet.setNodeStatusFuncs 中。
func NewMainKubelet(...) (*Kubelet, error) {
    ...
    // 创建并收集各字段的 setter,保存到 Kubelet 对象。
    klet.setNodeStatusFuncs = klet.defaultNodeStatusFuncs()
    return klet, nil
}
defaultNodeStatusFuncs 创建并收集各字段对应的 setter:
func (kl *Kubelet) defaultNodeStatusFuncs() []func(context.Context, *v1.Node) error {
    var setters []func(ctx context.Context, n *v1.Node) error
    setters = append(setters,
        nodestatus.NodeAddress(...),
        nodestatus.MachineInfo(...),
        nodestatus.VersionInfo(...),
        ...
        nodestatus.Images(...),
        nodestatus.GoRuntime(),
        ...
    )
    setters = append(setters,
        nodestatus.MemoryPressureCondition(...),
        nodestatus.DiskPressureCondition(...),
        nodestatus.PIDPressureCondition(...),
        // 传入运行检查方法,创建 Ready 条目对应的 setter。
        nodestatus.ReadyCondition(
            kl.clock.Now, kl.runtimeState.runtimeErrors, kl.runtimeState.networkErrors,
            kl.runtimeState.storageErrors, kl.containerManager.Status,
            kl.shutdownManager.ShutdownStatus, kl.recordNodeStatusEvent,
            kl.supportLocalStorageCapacityIsolation(),
        ),
        nodestatus.VolumesInUse(...),
        ...
    )
    return setters
}
ReadyCondition 接收时钟和运行检查方法,并将它们保存在返回的 setter 中。每轮状态更新时,setNodeStatus 调用这个 setter,计算并更新 Node 的 status.conditions 中 type: Ready 的条目:
- 检查运行条件:调用运行时、网络、存储和节点关闭检查方法,并检查
status.capacity中是否缺少必要的资源信息。 - 生成 Ready 条件:检查均通过时,生成
Ready=True、reason=KubeletReady;存在错误时,生成Ready=False、reason=KubeletNotReady,并将错误写入message。本轮时间写入lastHeartbeatTime。 - 写入 Node:更新 Conditions 的 setter 按
Type匹配各自的条目。这里仅替换Type == v1.NodeReady的条目,其他条件保持原样;没有 Ready 条目时,追加到node.Status.Conditions。
例如,网络检查返回错误时,setter 会将 Ready 设为 False,并在 message 中保留错误原因。下面的 runtimeErrorsFunc、networkErrorsFunc 等参数,就是创建 setter 时传入的检查方法:
func ReadyCondition(
    nowFunc func() time.Time,
    runtimeErrorsFunc func() error,
    networkErrorsFunc func() error,
    storageErrorsFunc func() error,
    cmStatusFunc func() cm.Status,
    nodeShutdownManagerErrorsFunc func() error,
    recordEventFunc func(logger klog.Logger, eventType, event string),
    localStorageCapacityIsolation bool,
) Setter {
    // 返回符合 Setter 签名的函数,供每轮状态更新调用。
    return func(ctx context.Context, node *v1.Node) error {
        ...
        currentTime := metav1.NewTime(nowFunc())
        newNodeReadyCondition := v1.NodeCondition{
            Type:              v1.NodeReady,
            Status:            v1.ConditionTrue,
            Reason:            "KubeletReady",
            Message:           "kubelet is posting ready status",
            LastHeartbeatTime: currentTime,
        }
        // 收集运行时、网络、存储和节点关闭检查的错误。
        errs := []error{runtimeErrorsFunc(), networkErrorsFunc(), storageErrorsFunc(), nodeShutdownManagerErrorsFunc()}
        requiredCapacities := []v1.ResourceName{v1.ResourceCPU, v1.ResourceMemory, v1.ResourcePods}
        ...
        missingCapacities := []string{}
        for _, resource := range requiredCapacities {
            if _, found := node.Status.Capacity[resource]; !found {
                missingCapacities = append(missingCapacities, string(resource))
            }
        }
        // 必要的资源容量字段缺失时,也记为检查错误。
        if len(missingCapacities) > 0 {
            errs = append(errs, fmt.Errorf("missing node capacity for resources: %s", strings.Join(missingCapacities, ", ")))
        }
        // 存在检查错误时,生成 Ready=False,并记录原因。
        if aggregatedErr := errors.NewAggregate(errs); aggregatedErr != nil {
            newNodeReadyCondition = v1.NodeCondition{
                Type:              v1.NodeReady,
                Status:            v1.ConditionFalse,
                Reason:            "KubeletNotReady",
                Message:           aggregatedErr.Error(),
                LastHeartbeatTime: currentTime,
            }
        }
        ...
        readyConditionUpdated := false
        ...
        for i := range node.Status.Conditions {
            // 按 Type 匹配 Ready 条目,保留其他类型的条件。
            if node.Status.Conditions[i].Type == v1.NodeReady {
                ...
                // 替换已有的 Ready 条目。
                node.Status.Conditions[i] = newNodeReadyCondition
                readyConditionUpdated = true
                break
            }
        }
        if !readyConditionUpdated {
            ...
            // 首次生成 Ready 条目时,将它追加到 Conditions。
            node.Status.Conditions = append(node.Status.Conditions, newNodeReadyCondition)
        }
        ...
        return nil
    }
}
这些 setter 在每轮节点状态更新时执行:
- 准备对象:
tryUpdateNodeStatus调用updateNode,由updateNode复制原有 Node,得到本轮待更新的副本。 - 执行 setter:
updateNode再调用setNodeStatus,由setNodeStatus遍历kl.setNodeStatusFuncs,逐个执行 setter,将各字段的当前值写入 Node 副本。 - 返回结果:
updateNode将更新后的 Node 和变化标记changed返回给tryUpdateNodeStatus,供上报流程判断是否提交。
func (kl *Kubelet) updateNode(ctx context.Context, originalNode *v1.Node) (*v1.Node, bool) {
    ...
    // 复制原有 Node,准备本轮状态计算使用的对象。
    node := originalNode.DeepCopy()
    ...
    // 调用 setter,将各模块的观察结果填入 Node 副本。
    kl.setNodeStatus(ctx, node)
    changed := podCIDRChanged || nodeStatusHasChanged(&originalNode.Status, &node.Status) || areRequiredLabelsNotPresent
    // 返回新对象和变化标记,交给上报流程判断。
    return node, changed
}

func (kl *Kubelet) setNodeStatus(ctx context.Context, node *v1.Node) {
    ...
    for i, f := range kl.setNodeStatusFuncs {
        // 执行各 setter,将观察结果写入同一个 Node 对象。
        if err := f(ctx, node); err != nil {
            ...
        }
    }
    ...
}
状态上报
updateNodeStatus 调用 tryUpdateNodeStatus,取得原 Node 对象后,按以下步骤更新状态:
- 计算差异:
updateNode复制原对象并计算当前状态。比较 Conditions 时忽略LastHeartbeatTime的变化,避免仅更新时间戳就触发上报。 - 判断上报:状态发生变化或报告周期到期时,调用
patchNodeStatus;否则跳过本轮上报。 - 提交状态:
patchNodeStatus通过 API Server 更新 Node 的status子资源,成功后记录最近上报时间。
func (kl *Kubelet) tryUpdateNodeStatus(ctx context.Context, tryNumber int) error {
    ...
    // 计算当前状态,并判断是否发生变化。
    node, changed := kl.updateNode(ctx, originalNode)
    // 状态变化或报告周期到期时,才提交状态。
    shouldPatchNodeStatus := changed || kl.isUpdateStatusPeriodExpired()
    if !shouldPatchNodeStatus {
        ...
        return nil
    }
    ...
    // 将原对象与更新后的对象交给上报方法。
    updatedNode, err := kl.patchNodeStatus(originalNode, node)
    ...
    return err
}

func (kl *Kubelet) patchNodeStatus(originalNode, node *v1.Node) (*v1.Node, error) {
    // 通过 API Server 更新 Node 的 status 子资源。
    updatedNode, _, err := nodeutil.PatchNodeStatus(
        kl.heartbeatClient.CoreV1(), types.NodeName(kl.nodeName), originalNode, node,
    )
    if err != nil {
        return nil, err
    }
    // 只有成功写入 API,才更新最近上报时间。
    kl.lastStatusReportTime = kl.clock.Now()
    ...
    return updatedNode, nil
}
Lease
Lease 是 Kubernetes 用于协调和心跳的 API 对象。节点心跳使用 kube-node-lease 命名空间中与节点同名的 Lease,例如节点 node-1 对应 kube-node-lease/node-1。
Kubelet 定期更新 Lease 的 renewTime。
Lease 对象示例
以下示例保留主要字段:
holderIdentity:持有此 Lease 的节点名称。leaseDurationSeconds:Lease 声明的持续时长,单位为秒。renewTime:最近一次续约时间。
创建与启动
Kubelet 复用公共包 k8s.io/component-helpers/apimachinery/lease 中的 Lease 控制器实现。使用该包的组件各自创建独立实例,分别维护自己的 Lease 对象、latestLease 缓存和续约循环。
NewMainKubelet 调用 lease.NewController 为本节点创建控制器实例,传入节点名称、心跳客户端、Lease 命名空间和续约参数。Kubelet.Run 启动后台任务时,若已配置 API 客户端,就在独立 goroutine 中启动该实例的 Run 方法。
续约涉及两个参数:
nodeLeaseDurationSeconds:Lease 声明的持续时长,默认为 40 秒。renewInterval:Kubelet 按声明时长的四分之一计算续约间隔,默认约 10 秒;实际执行带少量抖动。
func NewMainKubelet(...) (*Kubelet, error) {
    ...
    // 按 Lease 声明时长计算续约间隔。
    leaseDuration := time.Duration(kubeCfg.NodeLeaseDurationSeconds) * time.Second
    renewInterval := time.Duration(float64(leaseDuration) * nodeLeaseRenewIntervalFraction)
    // 使用公共包为本节点创建独立的 Lease 控制器实例。
    klet.nodeLeaseController = lease.NewController(
        klet.clock,
        klet.heartbeatClient,
        string(klet.nodeName),
        kubeCfg.NodeLeaseDurationSeconds,
        klet.onRepeatedHeartbeatFailure,
        renewInterval,
        string(klet.nodeName),
        v1.NamespaceNodeLease,
        util.SetNodeOwnerFunc(ctx, klet.heartbeatClient, string(klet.nodeName)),
    )
    ...
}

func (kl *Kubelet) Run(ctx context.Context, updates <-chan kubetypes.PodUpdate) {
    ...
    if kl.kubeClient != nil {
        // 在独立 goroutine 中启动本节点的 Lease 续约循环。
        go kl.nodeLeaseController.Run(context.Background())
        ...
    }
    ...
}
心跳续约
Kubelet.Run 在启动后台任务时,通过独立 goroutine 执行本节点 Lease 控制器的 Run,调用代码见创建与启动。控制器随后按续约间隔调用 sync。
sync 通过以下两条路径间接调用 newLease。newLease 为创建或更新准备 Lease 对象,填写声明时长 leaseDurationSeconds 和当前续约时间 renewTime:
- 续约已有对象:
sync调用retryUpdateLease,后者调用newLease(base)复制已有对象、刷新续约内容,再通过leaseClient.Update写回 API Server。成功后,将返回对象保存到latestLease,供下一轮续约使用。 - 获取或创建对象:首次运行或续约失败时,
sync调用backoffEnsureLease,由它调用ensureLease读取 Lease。对象不存在时,ensureLease调用newLease(nil)构造对象,再通过leaseClient.Create创建;对象已存在时,返回sync继续续约。新创建的 Lease 已带续约时间,本轮无需再更新。
func (c *controller) sync(ctx context.Context) {
    ...
    if c.latestLease != nil {
        // 续约已有对象,由 retryUpdateLease 调用 newLease(base)。
        err := c.retryUpdateLease(ctx, c.latestLease)
        if err == nil {
            return
        }
        ...
    }
    // 获取或创建对象,由 backoffEnsureLease 继续调用 ensureLease。
    lease, created := c.backoffEnsureLease(ctx)
    c.latestLease = lease
    // 新建对象已带续约时间;已有对象需要提交更新。
    if !created && lease != nil {
        if err := c.retryUpdateLease(ctx, lease); err != nil {
            ...
        }
    }
}

func (c *controller) backoffEnsureLease(ctx context.Context) (*coordinationv1.Lease, bool) {
    ...
    for {
        // 实际的读取和创建操作交给 ensureLease。
        lease, created, err = c.ensureLease(ctx)
        if err == nil {
            break
        }
        ...
    }
    return lease, created
}

func (c *controller) ensureLease(ctx context.Context) (*coordinationv1.Lease, bool, error) {
    // 读取当前节点的 Lease。
    lease, err := c.leaseClient.Get(ctx, c.leaseName, metav1.GetOptions{})
    if apierrors.IsNotFound(err) {
        // Lease 不存在时,调用 newLease(nil) 构造对象和续约内容。
        leaseToCreate, err := c.newLease(nil)
        if err != nil {
            return nil, false, nil
        }
        // 将新 Lease 写入 API Server。
        lease, err := c.leaseClient.Create(ctx, leaseToCreate, metav1.CreateOptions{})
        if err != nil {
            return nil, false, err
        }
        return lease, true, nil
    } else if err != nil {
        return nil, false, err
    }
    return lease, false, nil
}

func (c *controller) retryUpdateLease(ctx context.Context, base *coordinationv1.Lease) error {
    for i := 0; i < maxUpdateRetries; i++ {
        // 调用 newLease(base),为已有 Lease 准备本轮续约内容。
        leaseToUpdate, err := c.newLease(base)
        if err != nil {
            ...
        } else {
            // 将续约内容写入 API Server。
            lease, err := c.leaseClient.Update(ctx, leaseToUpdate, metav1.UpdateOptions{})
            if err == nil {
                // 保存 API Server 返回的对象,供下一轮续约使用。
                c.latestLease = lease
                return nil
            }
            ...
        }
        ...
    }
    return fmt.Errorf("failed %d attempts to update lease", maxUpdateRetries)
}

func (c *controller) newLease(base *coordinationv1.Lease) (*coordinationv1.Lease, error) {
    var lease *coordinationv1.Lease
    if base == nil {
        // 创建时,构造新的 Lease 对象。
        lease = &coordinationv1.Lease{
            ...
        }
    } else {
        // 续约时复制已有对象,保留名称和资源版本等信息。
        lease = base.DeepCopy()
    }
    // 写入 Lease 声明的持续时长。
    lease.Spec.LeaseDurationSeconds = ptr.To(c.leaseDurationSeconds)
    // 将本轮续约时间设为当前时间。
    lease.Spec.RenewTime = &metav1.MicroTime{Time: c.clock.Now()}
    ...
    return lease, nil
}
节点心跳
kube-controller-manager 中的 Node Lifecycle Controller 通过 monitorNodeHealth 从 informer 缓存读取节点列表,逐个调用 tryUpdateNodeHealth 检查心跳。
probeTimestamp 记录最近一次观察到心跳的本地时间,Node 和 Lease 任一有新心跳都会刷新它。
- 记录 Node 心跳:比较当前与上次保存的 Ready 条件。
LastHeartbeatTime发生变化时,将probeTimestamp更新为控制器的当前时间,记录本次观察到的心跳。 - 记录 Lease 心跳:从
kube-node-lease命名空间读取与节点同名的 Lease。首次观察到该对象,或renewTime晚于上次保存的值时,同样更新probeTimestamp。 - 超时处理:两类心跳都持续未更新,且当前时间超过
probeTimestamp + gracePeriod时,将Ready、MemoryPressure、DiskPressure和PIDPressure标记为Unknown。Ready 条目发生变化(如True变为Unknown)时,调用UpdateStatus写回Node.status。
func (nc *Controller) tryUpdateNodeHealth(ctx context.Context, node *v1.Node) (time.Duration, v1.NodeCondition, *v1.NodeCondition, error) {
    nodeHealth := nc.nodeHealthMap.getDeepCopy(node.Name)
    ...
    // 从当前 Node 中取得 Ready 条件。
    _, currentReadyCondition := controllerutil.GetNodeCondition(&node.Status, v1.NodeReady)
    ...
    var savedCondition *v1.NodeCondition
    var savedLease *coordv1.Lease
    if nodeHealth != nil {
        _, savedCondition = controllerutil.GetNodeCondition(nodeHealth.status, v1.NodeReady)
        savedLease = nodeHealth.lease
    }
    ...
    if nodeHealth == nil {
        ...
    } else if savedCondition == nil && currentReadyCondition != nil {
        ...
    } else if savedCondition != nil && currentReadyCondition == nil {
        ...
    } else if savedCondition != nil && currentReadyCondition != nil && savedCondition.LastHeartbeatTime != currentReadyCondition.LastHeartbeatTime {
        ...
        nodeHealth = &nodeHealthData{
            ...
            // Ready 条件的心跳时间变化,记录本次观察的本地时间。
            probeTimestamp: nc.now(),
            ...
        }
    }

    // 从 Lease informer 缓存读取该节点的心跳对象。
    observedLease, _ := nc.leaseLister.Leases(v1.NamespaceNodeLease).Get(node.Name)
    // 首次观察到 Lease,或续约时间更新,记录本次观察的本地时间。
    if observedLease != nil &&
        (savedLease == nil || savedLease.Spec.RenewTime.Before(observedLease.Spec.RenewTime)) {
        nodeHealth.lease = observedLease
        nodeHealth.probeTimestamp = nc.now()
    }

    // 超过宽限期仍未观察到新心跳,更新节点运行条件。
    if nc.now().After(nodeHealth.probeTimestamp.Add(gracePeriod)) {
        nodeConditionTypes := []v1.NodeConditionType{
            v1.NodeReady,
            v1.NodeMemoryPressure,
            v1.NodeDiskPressure,
            v1.NodePIDPressure,
        }
        ...
        for _, nodeConditionType := range nodeConditionTypes {
            _, currentCondition := controllerutil.GetNodeCondition(&node.Status, nodeConditionType)
            if currentCondition == nil {
                ...
            } else {
                // 将已有运行条件标记为未知,并记录原因。
                if currentCondition.Status != v1.ConditionUnknown {
                    currentCondition.Status = v1.ConditionUnknown
                    currentCondition.Reason = "NodeStatusUnknown"
                    ...
                }
            }
        }
        _, currentReadyCondition = controllerutil.GetNodeCondition(&node.Status, v1.NodeReady)
        // 比较修改前后的 Ready 条目,有变化时写回 Node.status。
        if !apiequality.Semantic.DeepEqual(currentReadyCondition, &observedReadyCondition) {
            if _, err := nc.kubeClient.CoreV1().Nodes().UpdateStatus(
                ctx, node, metav1.UpdateOptions{},
            ); err != nil {
                ...
                return gracePeriod, observedReadyCondition, currentReadyCondition, err
            }
            ...
        }
    }
    return gracePeriod, observedReadyCondition, currentReadyCondition, nil
}
接口与插件
Kubelet 各模块通过不同接口与 API Server、容器运行时和节点插件交互。
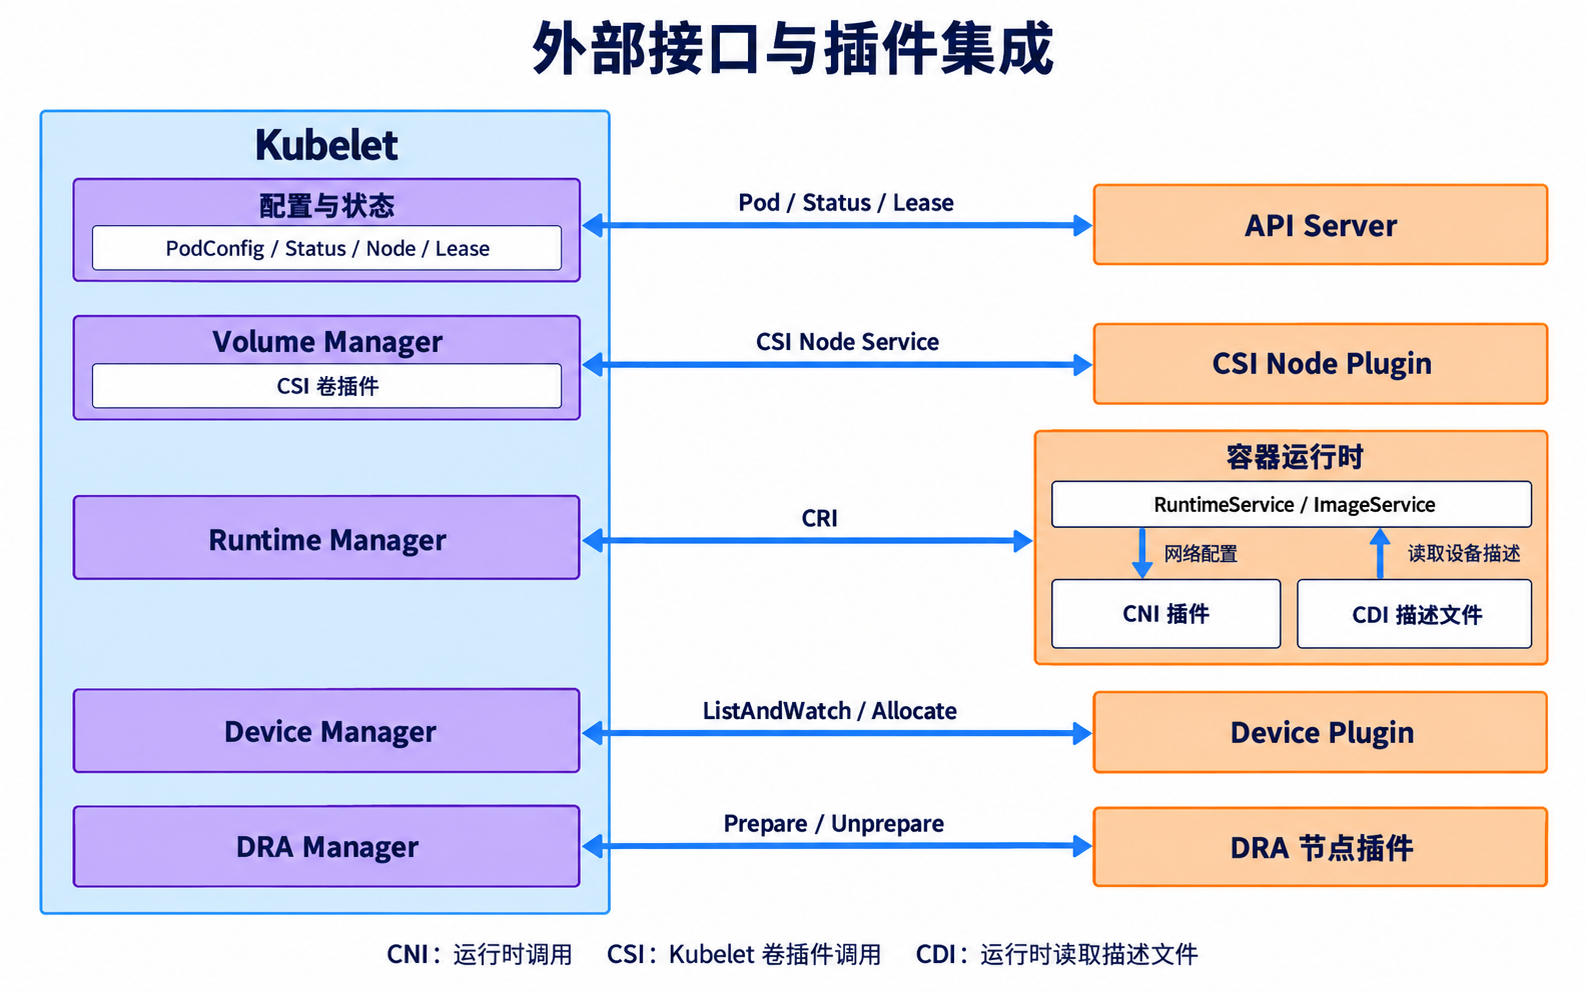
- Kubernetes API:API 配置源观察本节点的 Pod 变化并交给 PodConfig;状态管理和节点任务分别上报 Pod 状态、节点状态与心跳。
- CRI:Runtime Manager 通过 RuntimeService 管理 Sandbox 和容器;镜像管理与回收通过 ImageService 操作镜像,两组服务由容器运行时提供。
- CNI:对普通 Linux、非
hostNetworkPod,容器运行时调用 CNI 插件,完成网络接口、IP 地址和路由等资源的配置与清理。 - CSI:Volume Manager 通过 CSI 卷插件调用节点驱动,完成卷发布与卸载;容器运行时将准备好的节点路径接入容器。
- Device Plugin API:Device Manager 通过 Device Plugin 发现 GPU 等硬件设备,为容器分配具体设备,并获取容器使用设备所需的配置。
- DRA:通过
ResourceClaim描述 GPU、网卡等设备需求,按属性选择设备,并让多个容器或 Pod 引用同一份设备分配;DRA Manager 负责节点准备与清理。 - CDI:设备配置规范,描述容器使用设备所需的设备节点、挂载和环境变量。Device Plugin 或 DRA driver 返回的 CDI 设备名称经 Kubelet 和 CRI 传给支持 CDI 的容器运行时,由容器运行时读取描述文件,将相应配置加入容器的 OCI 配置。
Kubernetes API
Kubelet 通过 Kubernetes API 读取分配到本节点的 Pod 配置,并写回 Pod 状态、节点状态和心跳。配置变化进入 PodConfig,节点上的执行结果则由各自的后台任务上报。
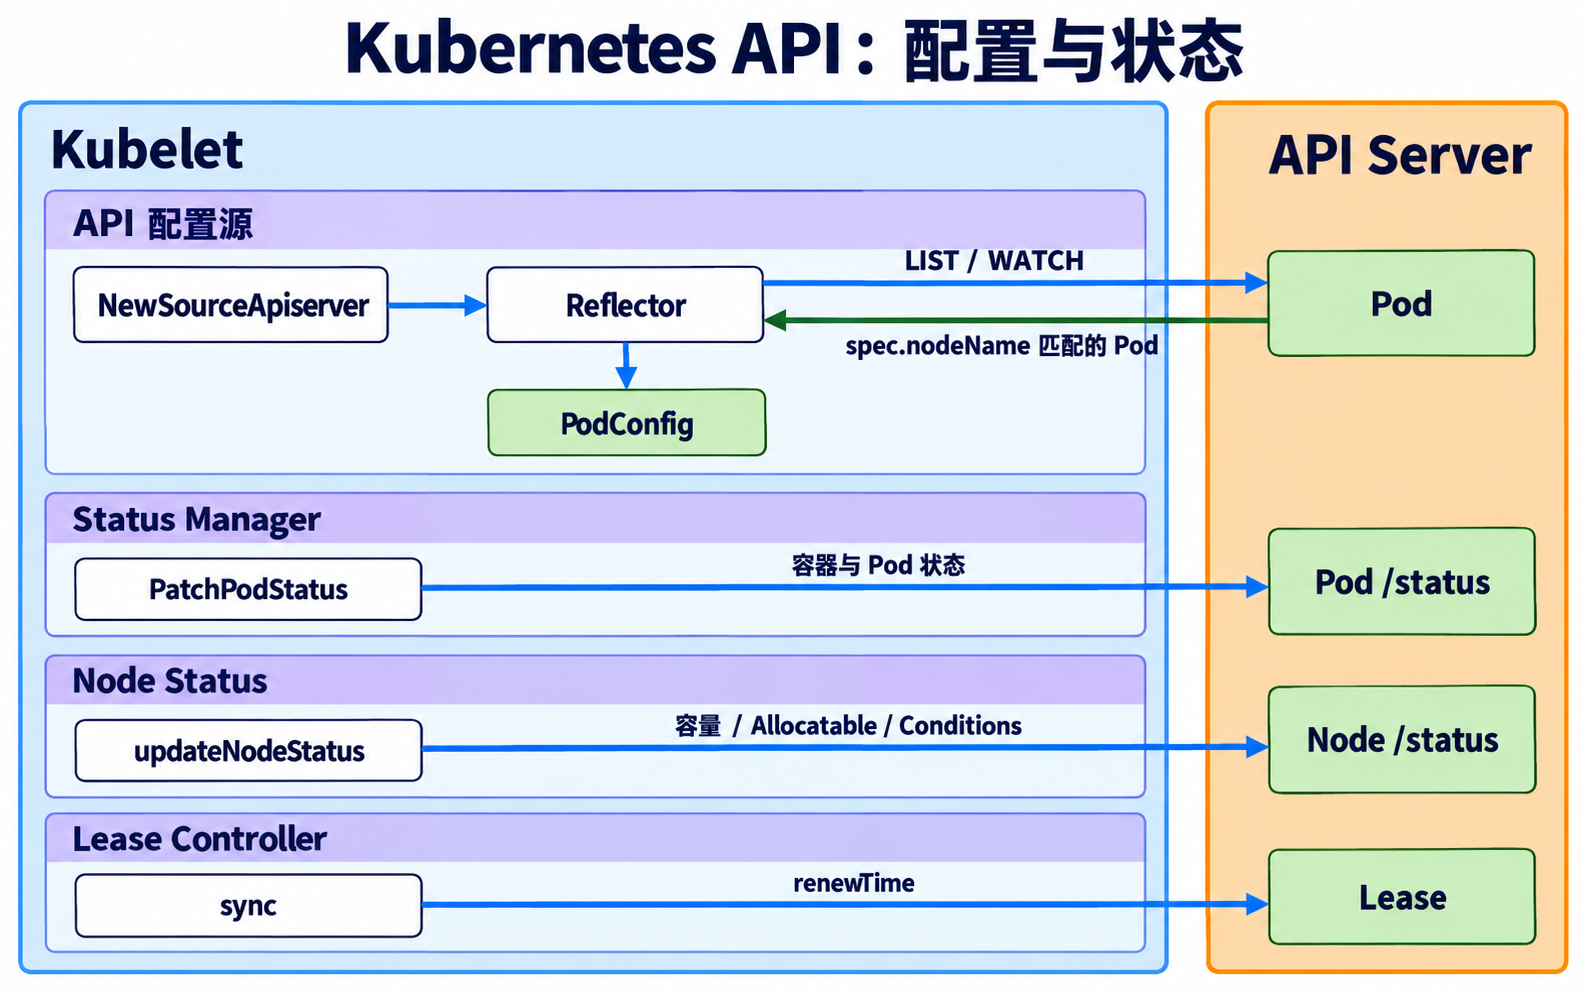
- 配置读取:API 配置源通过 LIST/WATCH 观察 Pod,并用
spec.nodeName筛选本节点的对象。例如,Pod 被绑定到worker-1后,该节点的 Kubelet 会收到它的配置,交给 PodConfig 处理。 - 状态上报:Status Manager 更新 Pod 的
status子资源,Node Status 任务更新 Node 的资源容量和运行条件。容器是否就绪属于 Pod 状态,节点容量和 Ready 条件属于节点状态。 - 心跳续约:Lease Controller 持续更新节点 Lease 的
renewTime,让控制面观察节点是否仍保持联系。
CRI
CRI(Container Runtime Interface) 是 Kubelet 与 containerd、CRI-O 等容器运行时通信的 gRPC 接口。Kubelet 通过它提交运行配置,创建和管理 Sandbox、容器,并查询容器运行时状态。
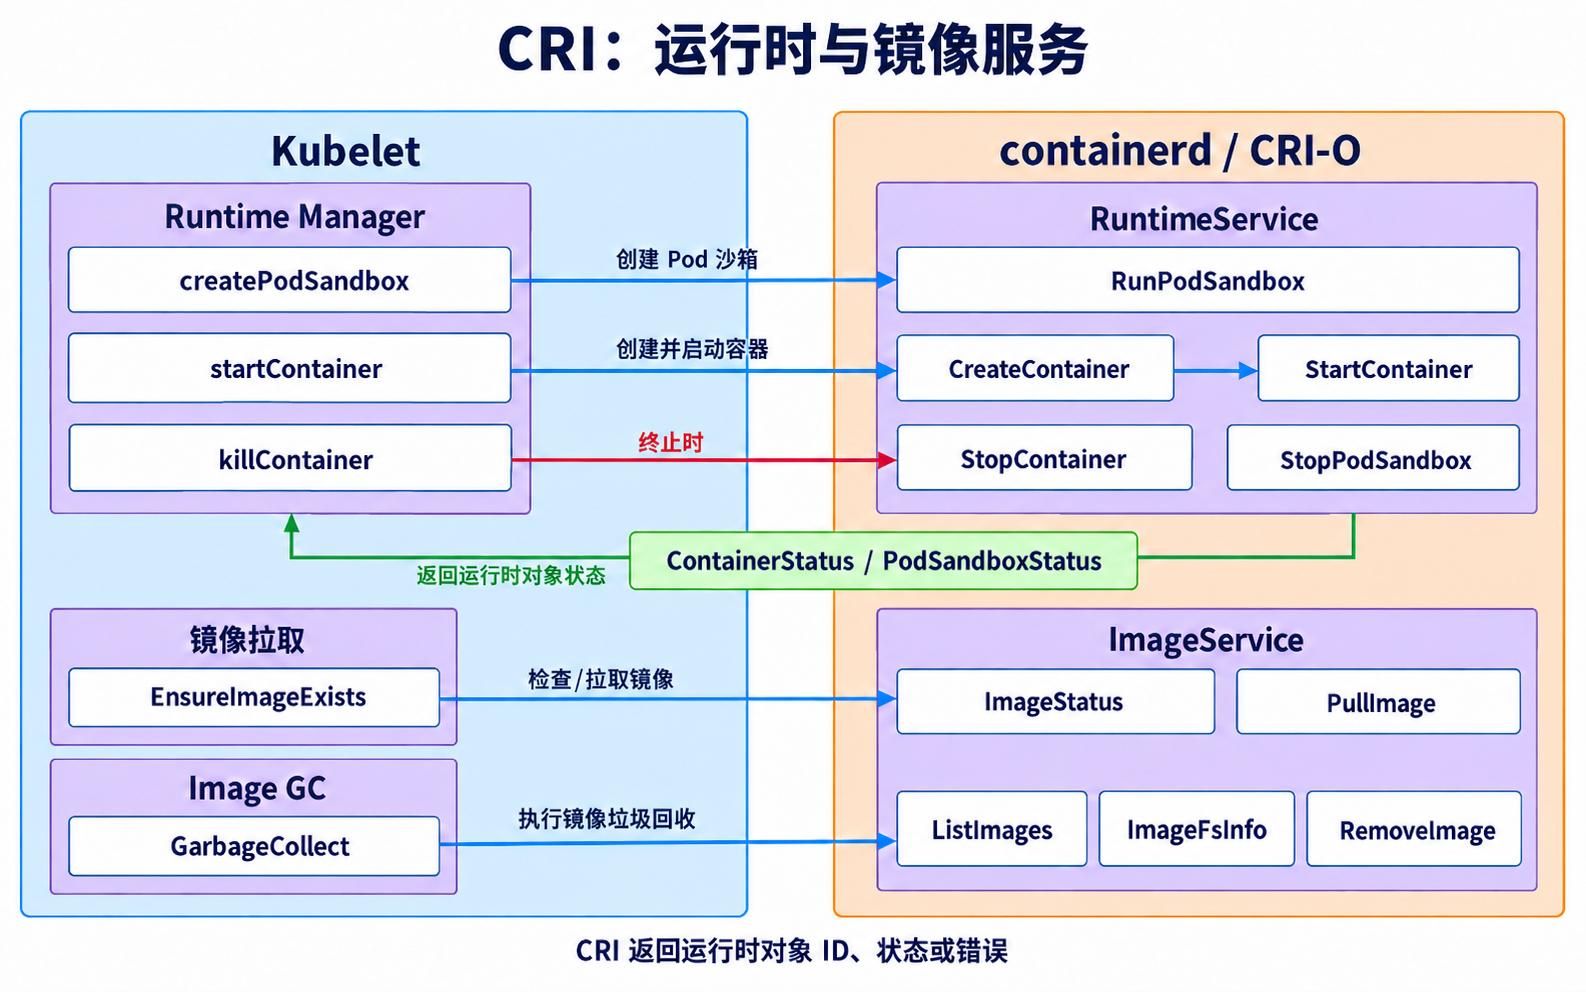
- 容器运行时服务:Runtime Manager 通过
RuntimeService管理 Sandbox 和容器。例如,RunPodSandbox接收 Pod 级配置并返回 Sandbox ID,后续的CreateContainer请求引用这个 ID,在对应的 Sandbox 中创建容器。 - 镜像服务:镜像管理模块通过
ImageService查询和拉取镜像,镜像回收任务通过该服务删除符合条件的镜像。PullImage请求携带镜像名称和所需的拉取凭据,成功后返回镜像引用,供后续容器创建使用。
CNI
CNI(Container Network Interface) 定义了容器运行时调用网络插件的执行协议。这里以 bridge 与 host-local 为例:bridge 把 Pod 接入节点上的网桥 cni0,host-local 从本节点配置的 Pod 网段分配 IP,并在本地记录地址使用情况。
示例中,节点 A、B 分别使用 10.244.1.0/24 和 10.244.2.0/24 作为 Pod 网段,节点 IP 转发和跨节点 Pod 网段路由已预先配置。
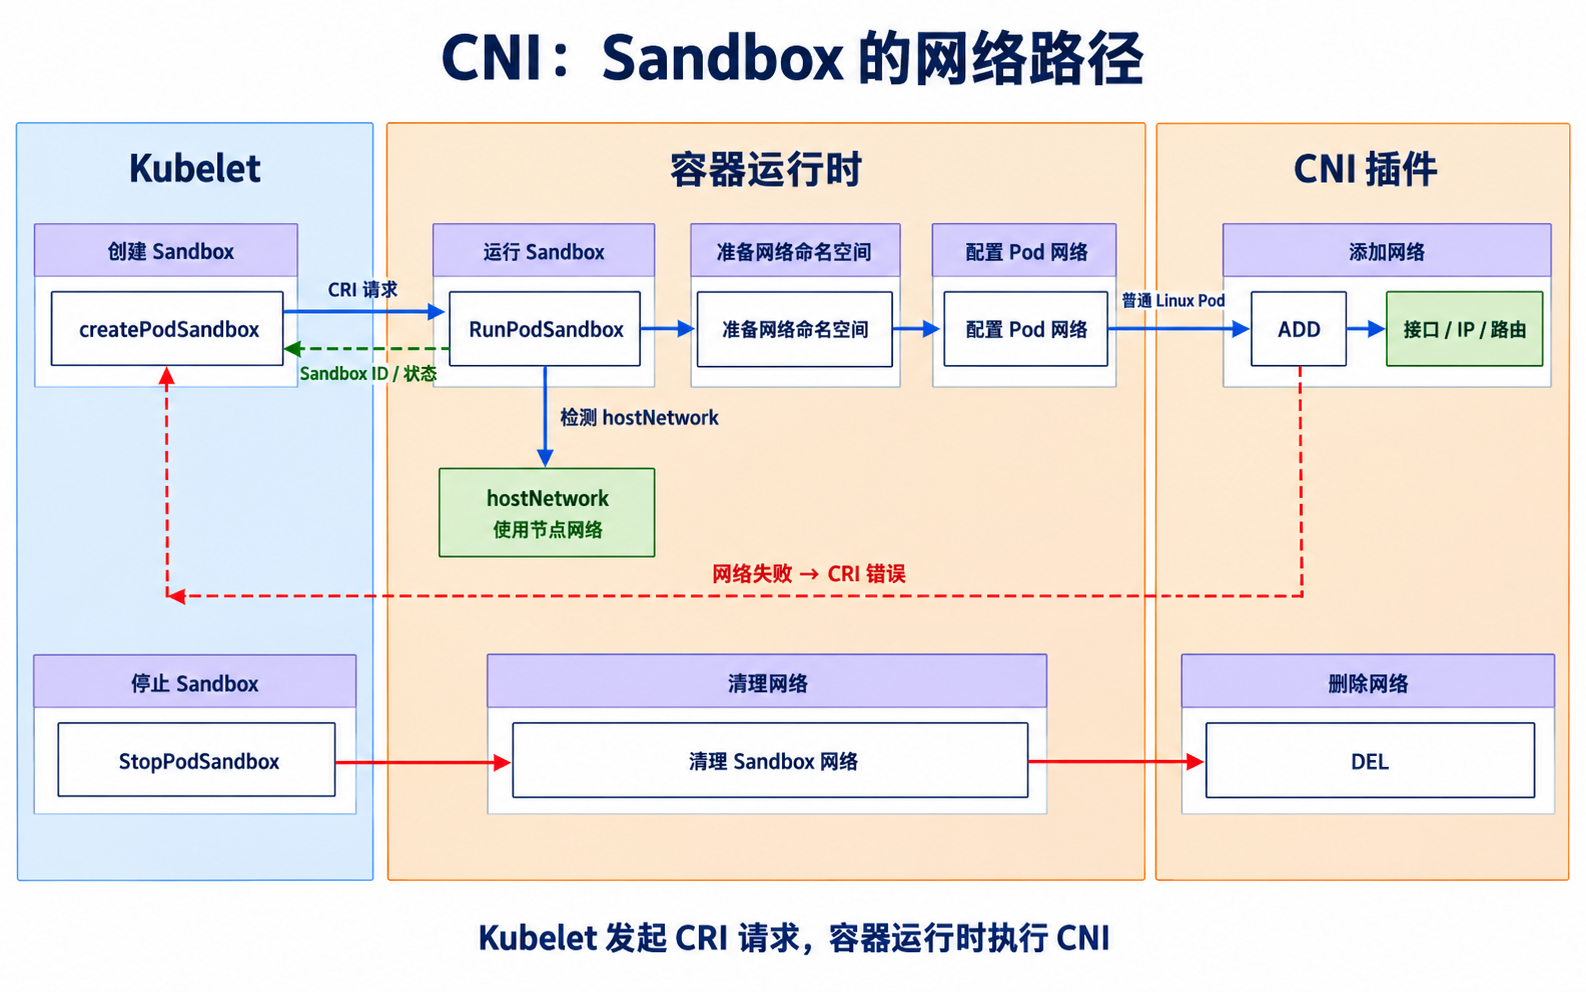
- 插件调用:创建 Pod Sandbox 时,containerd 执行节点上的
bridge插件处理ADD。bridge再调用host-local申请地址,节点 A 的 Pod A 获得10.244.1.2/24。 - 节点接入:
bridge创建一对相连的虚拟网卡(veth),将节点侧接到cni0,另一侧放入 Pod 网络命名空间并配置为eth0。Pod A 使用分配到的 IP,通过网关10.244.1.1访问其他网段。 - 跨节点通信:Pod A 访问节点 B 的 Pod B 时,流量经
cni0、节点 IP 路由和物理网卡进入底层网络,再由节点 B 转发到 Pod B。两个节点各有自己的网桥,跨节点通信保留 Pod IP,符合 Kubernetes 网络模型。 - 外部访问:Pod 访问集群外服务时,流量经过出口网关。本例在出口执行 SNAT,将源 Pod IP 转换为出口地址,并在响应返回时转换回 Pod IP。
移除 Pod 网络时,容器运行时调用插件的 DEL,清理 veth 等网络接口,host-local 释放对应的地址记录。
CSI
CSI(Container Storage Interface) 为存储驱动提供统一接口。Volume Manager 通过 CSI 卷插件调用节点上的 CSI Node Plugin,完成卷挂载与卸载。
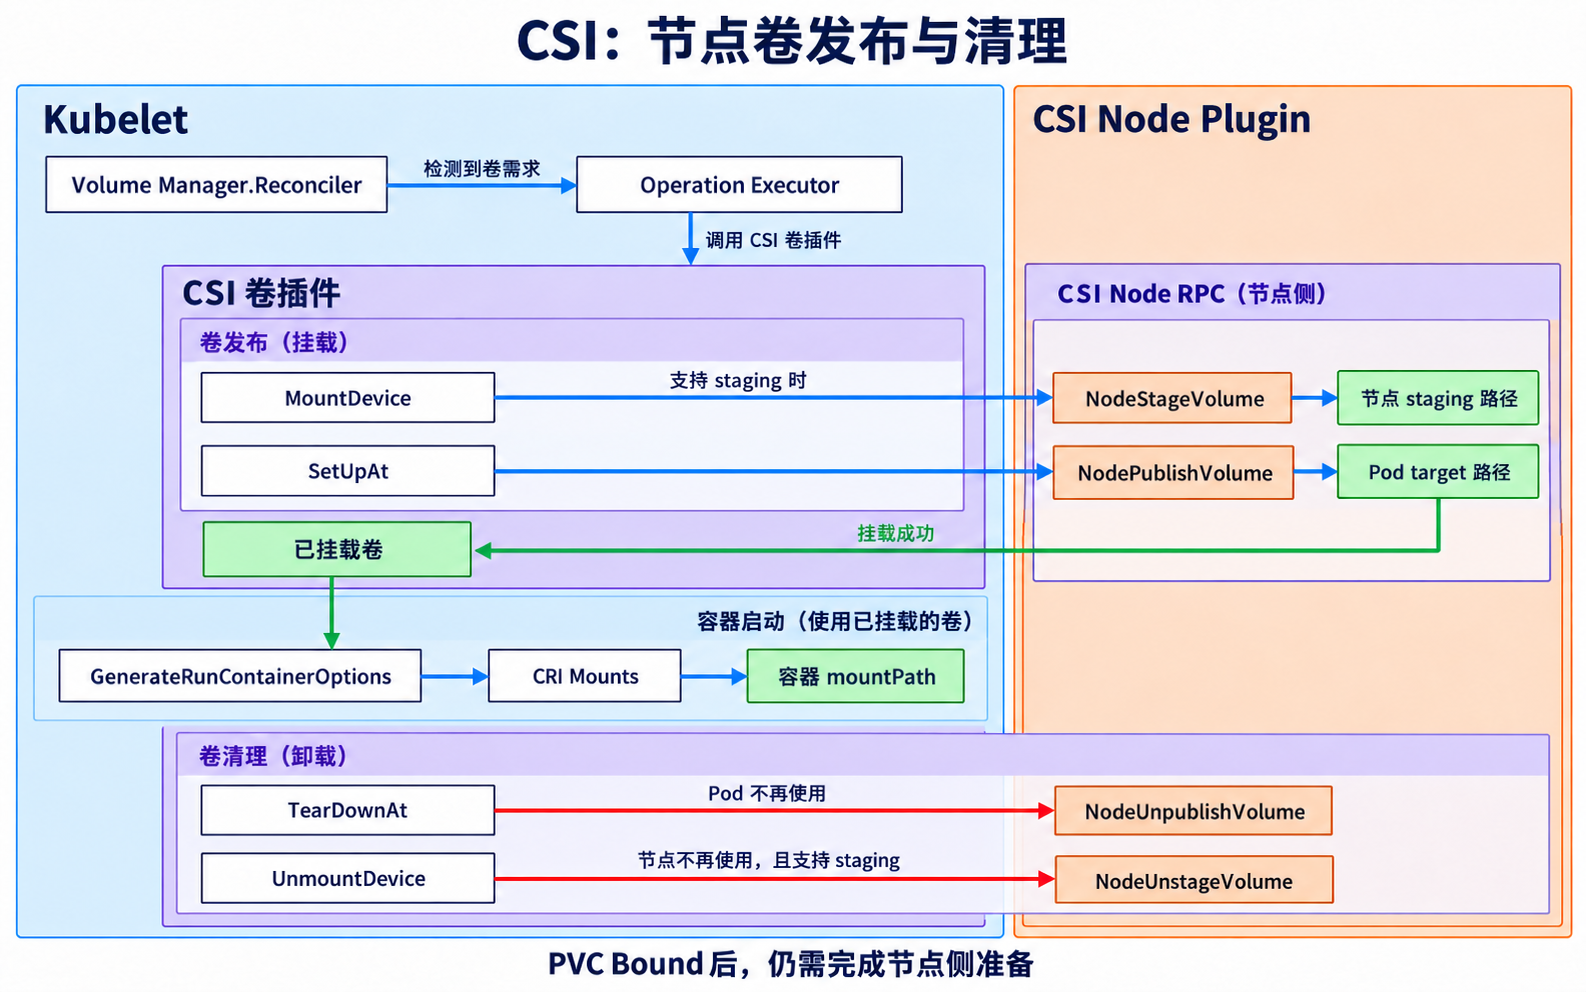
- 节点挂载(
NodeStageVolume):CSI Node Plugin 将卷挂载到节点暂存路径,为 Pod 使用卷做准备。 - Pod 挂载(
NodePublishVolume):将准备好的卷接到 Pod 在节点上的卷路径。容器运行时再将它挂入容器,例如/models,供应用访问。 - Pod 卸载(
NodeUnpublishVolume):Pod 停止使用卷后,卸载对应的 Pod 卷挂载。同一卷仍被本节点其他 Pod 使用时,节点暂存挂载继续保留。 - 节点卸载(
NodeUnstageVolume):本节点不再有 Pod 使用该卷后,卸载节点暂存挂载,卷内数据仍然保留。
Node 服务还包含以下常用接口:
NodeGetInfo、NodeGetCapabilities:分别查询节点标识、拓扑等信息,以及驱动支持的节点操作。NodeGetVolumeStats:查询卷容量、已用空间等统计信息。NodeExpandVolume:执行节点侧扩容,例如扩大卷的文件系统。
CSI 的 Controller 服务还包含卷创建、删除和卷与节点之间的附加、分离等接口。
Device Plugin API
Device Plugin API 规定 Device Plugin 如何向 Kubelet 注册、报告设备状态,以及返回容器使用设备所需的配置。以 NVIDIA Device Plugin 为例,DaemonSet 在 GPU 节点上运行 nvidia-device-plugin Pod,其中的进程通过挂载的主机目录提供 Unix socket,供该节点的 Kubelet 进行 gRPC 调用。
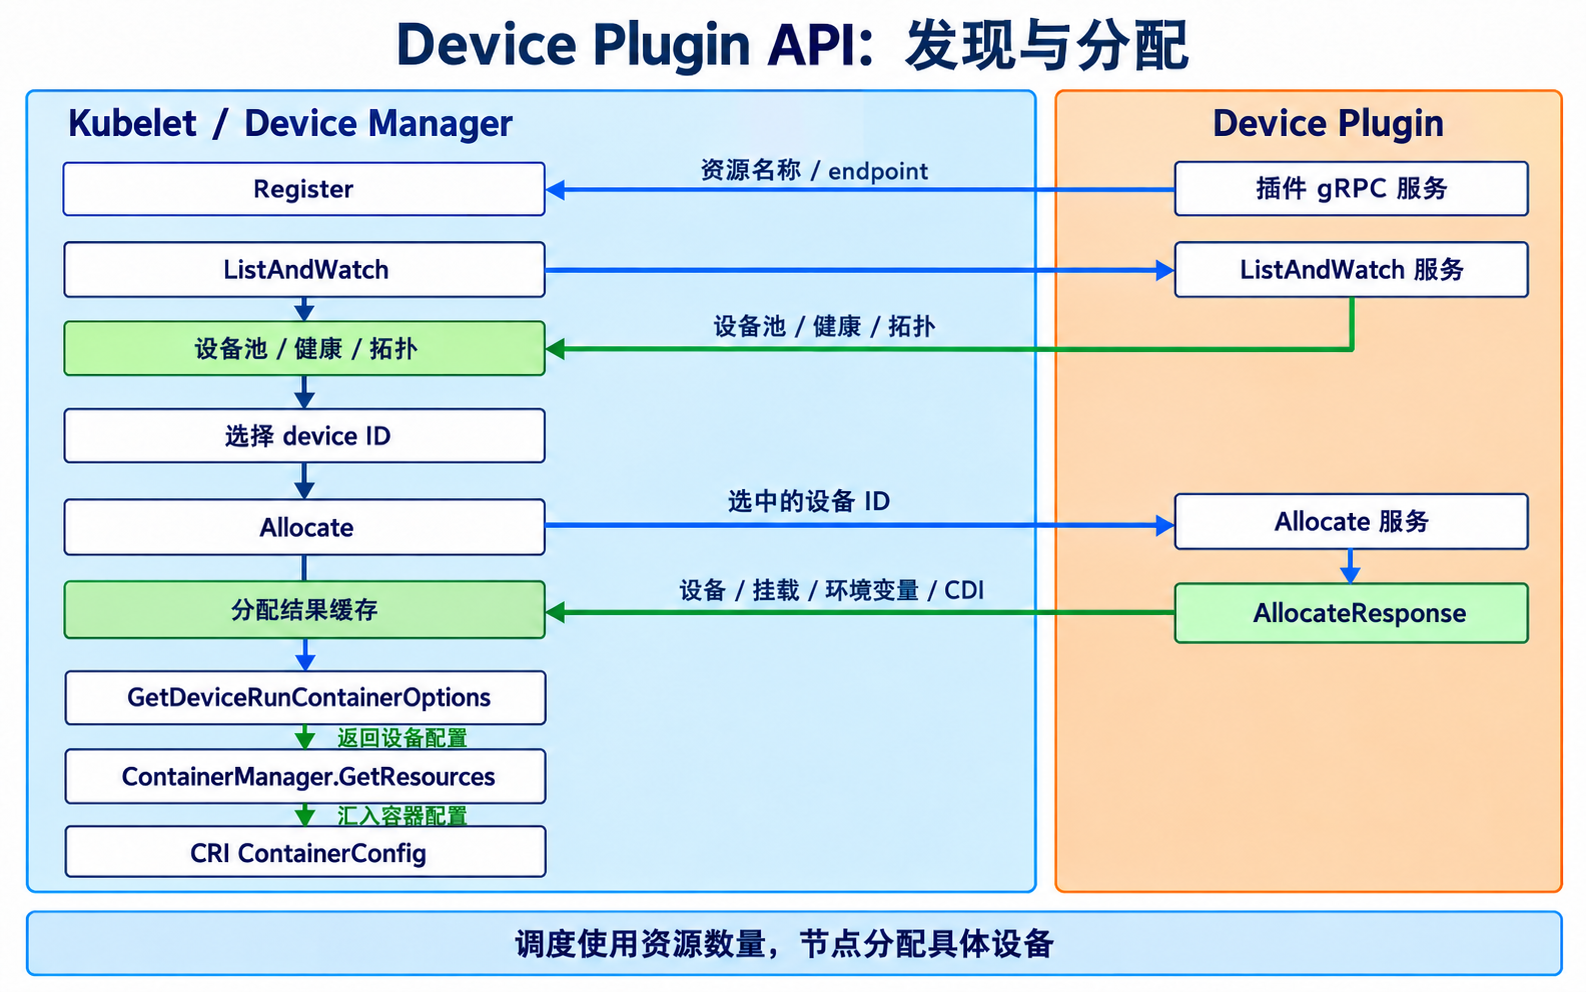
- 注册端点:Device Plugin 创建自己的服务 socket,再调用 Kubelet 的
Register,提交资源名称和服务端点。 - 报告状态:Device Manager 调用
ListAndWatch,持续接收 Device Plugin 返回的设备 ID 和健康状态列表更新。 - 返回配置:Device Manager 调用
Allocate,将已经选定的设备 ID 发送给 Device Plugin。响应可以包含设备节点、挂载、环境变量或 CDI 设备名称,供 Runtime Manager 生成 CRI 容器配置。
DRA
DRA 节点接口 连接 Kubelet 的 DRA Manager 与 DRA driver 的节点服务,通过本地 Unix socket 进行 gRPC 通信。Kubelet 发送需要处理的 Claim 标识,driver 返回资源准备或清理的结果。
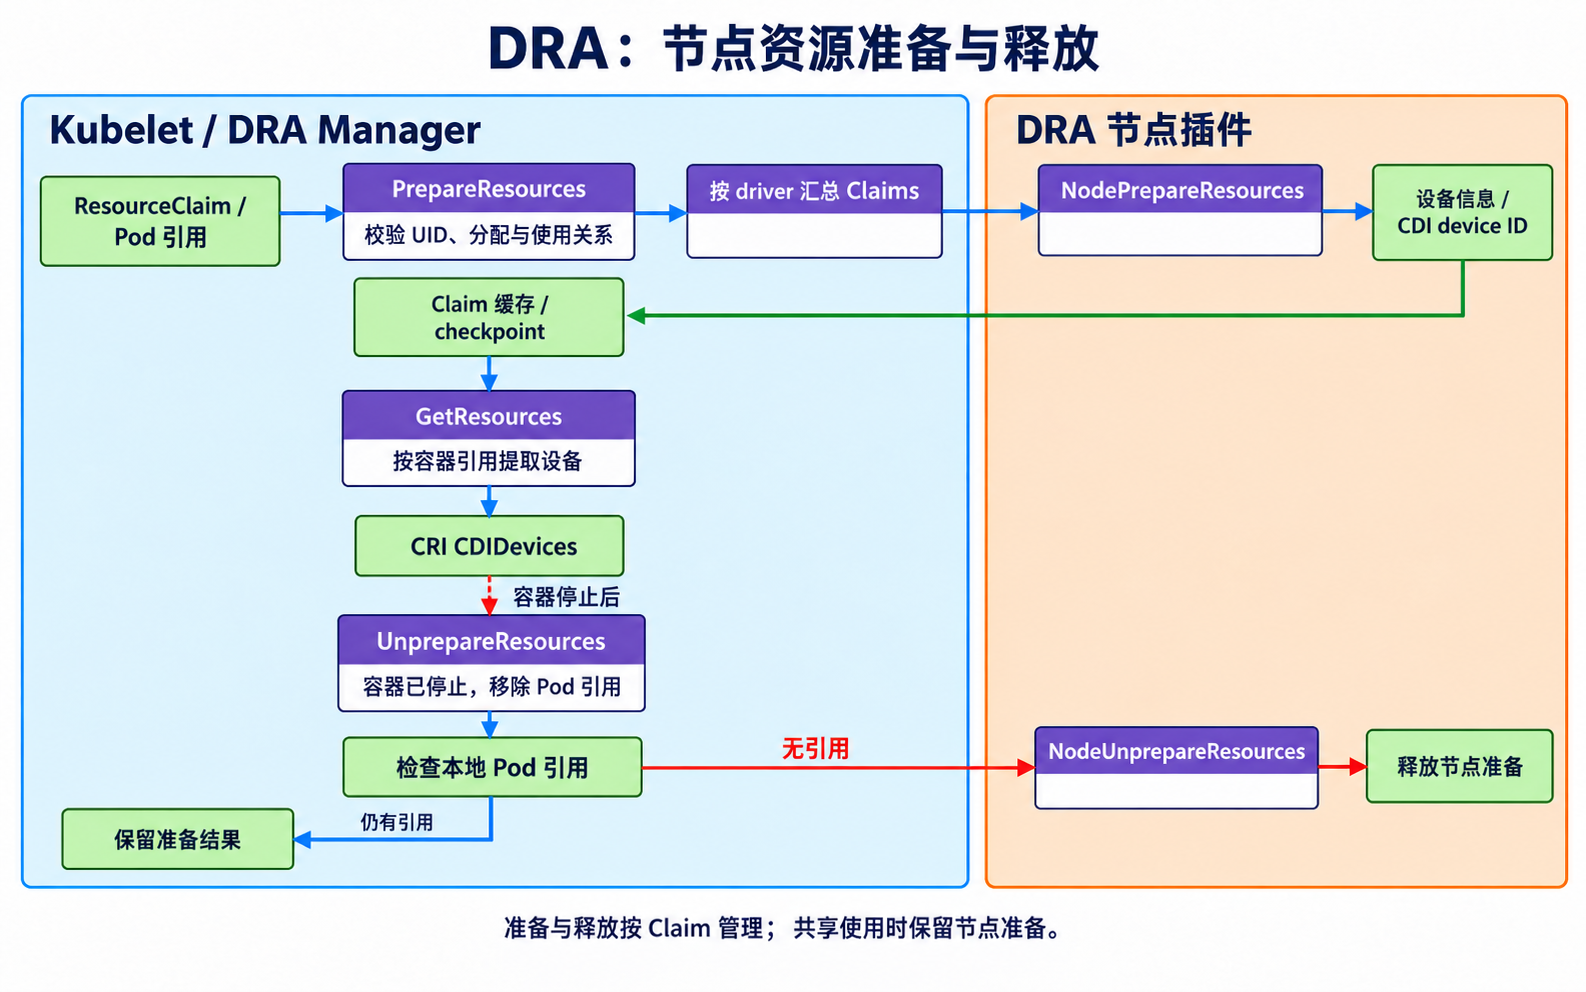
- 标识资源请求:请求携带 Claim 的命名空间、名称和 UID,DRA driver 据此找到对应的请求及已有分配结果。
- 返回准备结果:DRA Manager 调用
NodePrepareResources。DRA driver 按 Claim 返回设备信息及需要传给容器的 CDI 设备名称,Kubelet 将这些名称加入后续 CRI 容器配置。 - 返回清理结果:本节点最后一个使用该 Claim 的 Pod 结束使用后,DRA Manager 调用
NodeUnprepareResources,请求撤销对应的节点准备。DRA driver 按 Claim 返回处理结果,供 Kubelet 确认清理是否成功。
CDI
CDI(Container Device Interface) 是设备配置描述规范,用设备名称和描述文件表达容器所需的设备配置。支持 CDI 的容器运行时根据收到的名称读取描述文件,将相应修改合并到 OCI 容器启动配置。
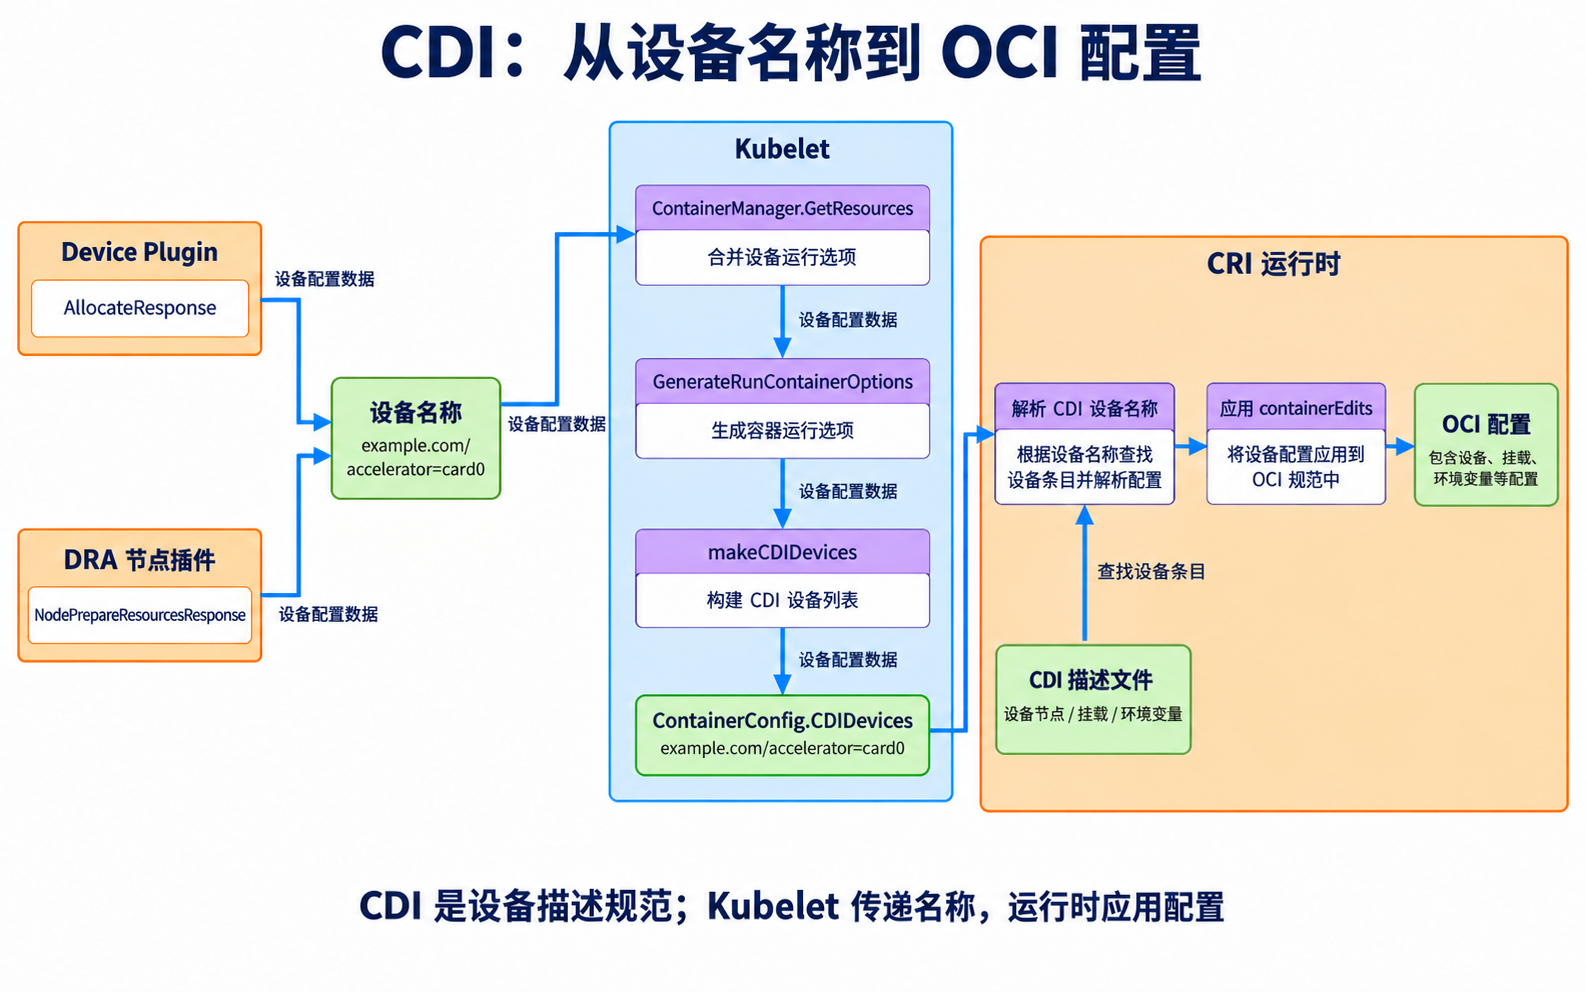
- 设备名称:Device Plugin 或 DRA Node Plugin 可以返回 CDI 名称,例如
example.com/accelerator=card0,用它标识容器需要使用的设备。 - 设备描述:节点上的 CDI 文件记录设备条目及其配置修改。示例名称中的
example.com/accelerator对应文件中的kind,card0对应设备条目的name。 - 配置注入:Kubelet 把名称放入 CRI 容器配置的
CDIDevices字段,交给容器运行时。容器运行时找到匹配的描述,把设备节点、挂载和环境变量等加入 OCI 配置,使容器能够访问对应设备。
相关资料
- kubelet
- Kubernetes Scheduler
- kubernetes/pkg/kubelet
- Kubelet Sync Loop
- Kubelet Configuration (v1beta1)
- Container Runtime Interface (CRI)
- Resource managers
- Node Status
- Pod Lifecycle
- Node-pressure Eviction
- KEP-3386: Kubelet Evented PLEG for Better Performance
- Kubernetes 源码剖析 — kubelet PLEG
- Kubernetes 源码剖析 — kubelet PodWorker
- Pod Lifecycle Event Generator: Understanding the "PLEG is not healthy" issue in Kubernetes
- Network Plugins
- Container Storage Interface (CSI)
- Device Plugins
- Container Device Interface Specification