etcd:Kubernetes 的状态存储¶
etcd 是一个强一致的分布式键值存储系统。它在 Kubernetes 中负责持久化保存资源对象及其状态,是控制面的核心存储组件。API Server 通过 Storage 层调用 etcd API,完成这些对象的读取、写入和删除。
etcd 架构¶
etcd 内部各部分承担以下职责:
- 客户端接口(gRPC API):接收客户端请求,提供键值读写、Watch、Lease 等接口。Kubernetes API Server 和
etcdctl都通过这些接口访问 etcd。 - 请求处理(etcd server):协调请求处理,将需要共识的操作交给 Raft 共识模块,并在日志提交后组织执行。
- 共识与日志复制(Raft):通过 Raft library 实现 Leader 选举和日志复制,让投票成员对日志的内容与顺序达成一致。
- 节点间通信(rafthttp):通过
rafthttp模块 在成员之间以 HTTP 传输 Raft 消息,包括心跳、日志复制和 Snapshot。 - 多版本存储(MVCC):管理 key 的当前值和历史版本,通过 revision 标识键空间的变化,支持历史读取和 Watch。
- 预写日志(WAL):将 Raft 日志和共识状态持久化到磁盘,供节点重启后恢复。
- 存储后端(Backend):保存 MVCC 管理的键值数据和 etcd 元数据,底层使用 bbolt 持久化到本地数据库文件。
下图展示了客户端请求入口、内部处理与存储模块,以及节点间的通信关系。
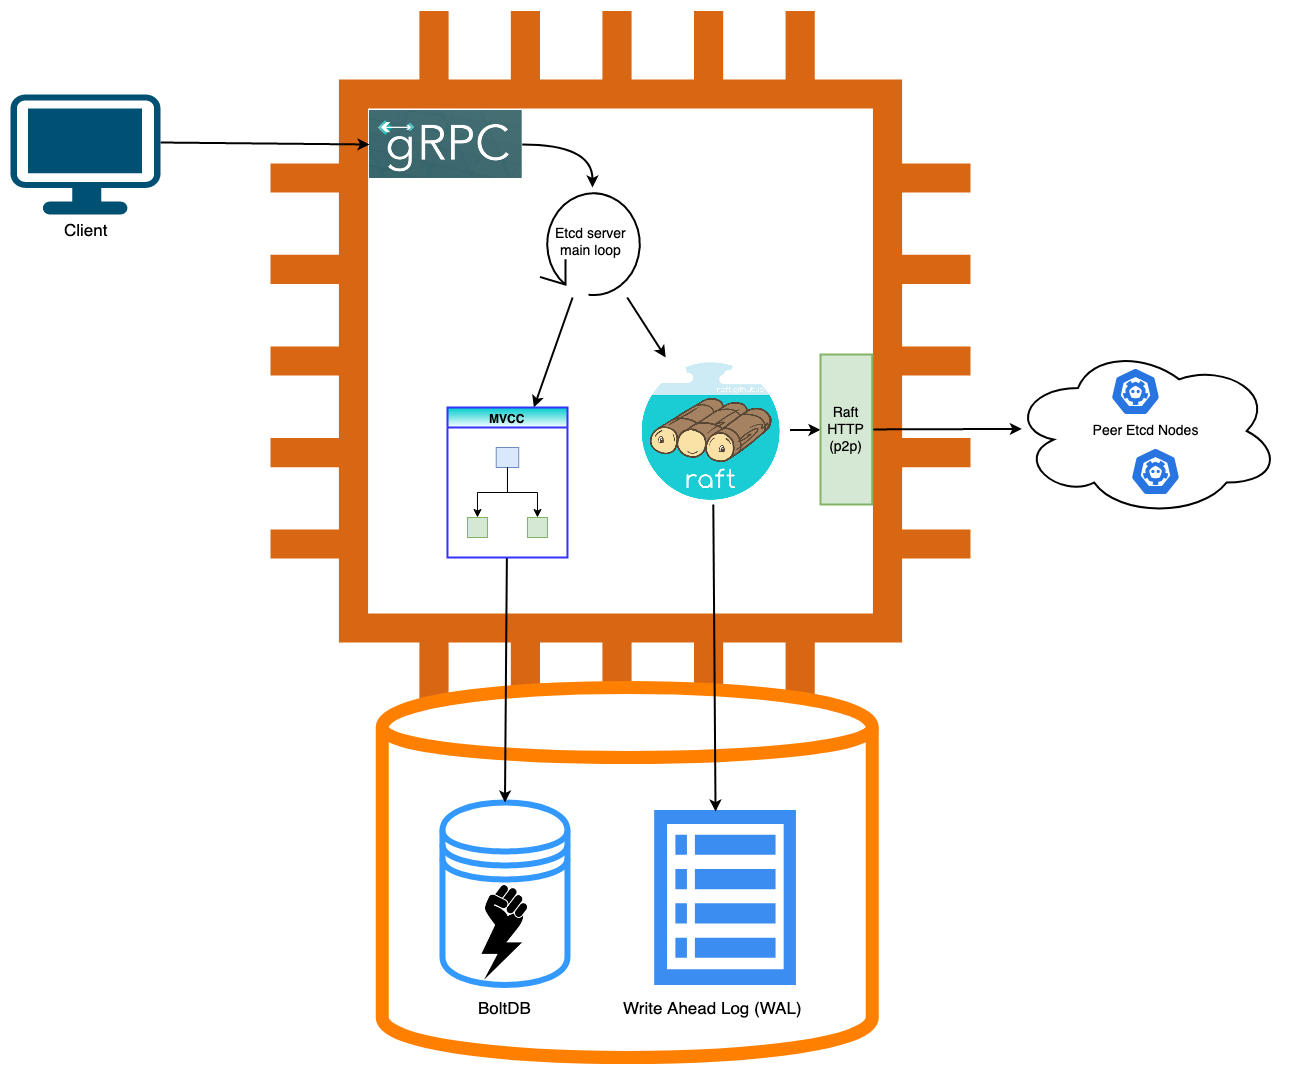
图:etcd 架构。来源:etcd etcd_internal_parts.png,Apache-2.0。

etcd 集群成员¶
etcd 的投票成员通过 Raft 共同维护一条有序日志。投票成员在运行过程中处于 Leader、Follower 或 Candidate 状态;一条日志获得多数投票成员(Quorum)确认后才能提交。
Leader、Follower 与 Candidate¶
Raft 每轮正式选举使用一个单调递增的 term,同一个 term 最多选出一个 Leader。Leader、Follower 和 Candidate 是投票成员的三种主要运行状态:
- Leader:为写入请求确定日志顺序,将日志复制给 Follower,并通过周期性心跳维持领导权。客户端可以向任意投票成员发送写入请求;Follower 收到后,会将其转发给 Leader。
- Follower:接收 Leader 的心跳和日志复制请求,将日志持久化到本机 WAL,并按提交顺序应用日志。Follower 也在选举中投票。
- Candidate:Follower 在选举超时时间内未收到 Leader 的有效心跳或日志消息时,默认先发起预投票;预投票获得多数支持后,转为 Candidate,增加 term,先给自己投票,再向其他投票成员请求选票,发起正式选举。取得多数票后成为 Leader;收到更高 term 的消息或确认有效 Leader 后退回 Follower。
Learner¶
成员变更一直是 etcd 集群运维中的难点。etcd Learner 设计文档列出了几种常见问题:
- 新成员增加 Leader 负载:新成员没有已有日志和 backend 数据,需要从 Leader 接收 Snapshot 和后续日志。持续的数据同步会占用 Leader 的网络带宽,心跳延迟或丢失可能使 Follower 触发新的选举。
- Quorum 在节点就绪前发生变化:三个投票成员加入第四个投票成员后,Quorum 会从
2增加到3。如果新进程尚未启动,原来的三个投票成员必须全部在线才能提交日志。单成员集群加入第二个投票成员时,同样会在新进程启动前把 Quorum 从1提高到2。 - 网络分区的影响被放大:四个投票成员分成
2 + 2两个分区时,两侧都无法达到 Quorum3。如果三成员集群已经有一个 Follower 失联,此时再加入第四个投票成员,也会让仍然在线的两个成员失去 Quorum。 - 配置错误可能难以撤销:错误的 peer URL、进程启动失败或网络不可达会让新投票成员一直无法工作。集群一旦失去 Quorum,删除错误成员本身也无法通过 Raft 提交。
为减轻上述成员变更造成的可用性风险,Raft §4.2.1 引入了 Learner:新成员先以非投票成员加入集群,追上 Leader 的日志后再晋升为投票成员。etcd 采用这一机制,将数据同步和获得投票资格分开处理:
- 以非投票成员加入:Learner 不参与投票,也不计入 Quorum,原有投票成员继续使用原来的票数提交日志。
- 先同步再参与选举:Leader 向 Learner 复制日志和 Snapshot,Learner 在不参加选举的情况下追赶 Leader。
- 通过检查后晋升:
etcdctl member promote检查 Learner 的日志进度。Learner 尚未追上 Leader 时,etcd 拒绝晋升请求。
使用 etcdctl member add --learner 添加新成员后,集群仍由原来的三个投票成员计算 Quorum。下图中的 Quorum 保持为 2,Learner 只接收日志和 Snapshot。
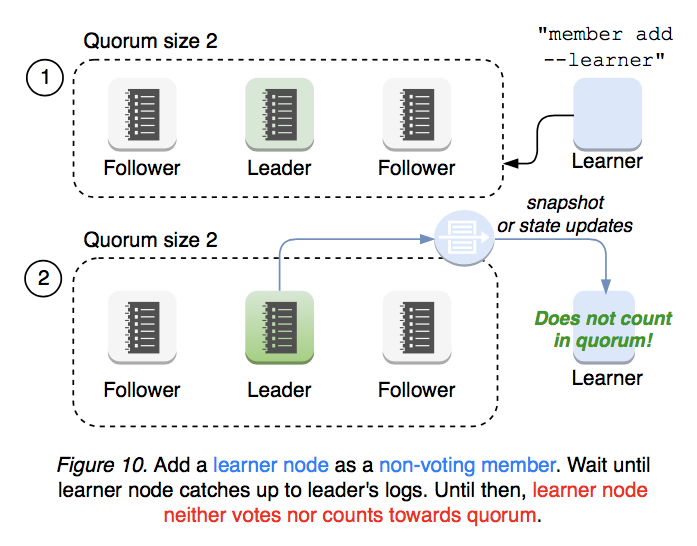
图:Learner 以非投票成员加入并同步数据。来源:etcd Learner design,Figure 10。
Learner 追上 Leader 的日志后,etcdctl member promote 将它改为投票成员。下图中的投票成员数从 3 增加到 4,Quorum 随之从 2 增加到 3。
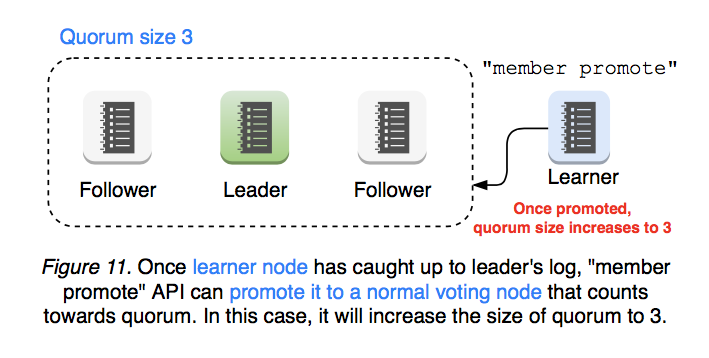
图:Learner 晋升为投票成员并计入 Quorum。来源:etcd Learner design,Figure 11。
Leader 需要向 Learner 复制日志和 Snapshot,因此会产生额外的网络流量。Learner 在晋升前不参与投票,集群能够容忍的投票成员故障数量保持不变。它解决的是成员变更的安全性,而不是读流量扩展或投票容错。
晋升之前,Learner 不参加选举,不能成为 Leader,也不处理客户端读写请求。Learner 不会自动晋升。集群运维人员确认其日志已经追上 Leader 后,需要执行 etcdctl member promote 将它晋升为投票成员。
上图用于说明晋升如何改变 Quorum,不代表推荐长期运行四个投票成员。etcd FAQ 对成员数量的说明指出,三个和四个投票成员都只能容忍一个成员故障,使用奇数个投票成员可以避免增加复制开销却不增加故障容忍能力。
kubeadm 的 Learner 加入流程
kubeadm 将新的 control-plane 节点加入 stacked etcd 时,依次完成以下操作:
-
将新成员添加为 Learner:
CreateStackedEtcdStaticPodManifestFile根据新节点的 API Endpoint 计算 etcd Peer URL,并连接现有的 stacked etcd 集群。它调用AddMemberAsLearner查询当前成员列表;如果相同的 Peer URL 尚未存在于成员列表中,kubeadm 通过 etcd gRPC API 将新成员添加为 Learner。此时成员关系中已经出现新节点,但新节点上的 etcd 进程还没有启动,Learner 不计入 Quorum。 -
启动本地 etcd:kubeadm 使用更新后的成员列表生成 etcd static Pod manifest。manifest 中的
--initial-cluster包含全部现有成员和新 Learner,--initial-cluster-state设置为existing。Kubelet 读取 manifest 后启动 etcd 容器,新成员通过 Peer URL 连接集群并开始接收 Snapshot 和 Raft 日志。kubeadm 默认等待 2 分钟确认新成员进程已经启动;超时后etcd-join阶段返回错误,但成员记录和 static Pod manifest 不会回滚。Kubelet 仍会尝试启动该 Pod,Learner 也不会改变原集群的 Quorum。 -
晋升为投票成员:新成员进程启动后,kubeadm 根据 Peer URL 找到 Learner 的成员 ID,再通过
MemberPromote请求晋升。日志尚未追上 Leader 时,etcd 拒绝请求,kubeadm 默认持续重试 2 分钟。重试超时后,etcd-join阶段返回错误;正在运行的 Learner 继续同步,但会保持非投票成员身份,也不会自动晋升。日志追平后,可以重新执行kubeadm join phase etcd-join --config join.yaml。晋升成功后,新成员开始计入 Quorum,kubeadm 将它的 Client URL 加入健康检查端点,并确认整个 etcd 集群可用。
上述等待时间由 JoinConfiguration.timeouts.etcdAPICall 设置。数据量较大或 Peer 网络较慢时,可以在执行 kubeadm join 前调大该值。
join.yaml 是自行准备的 kubeadm JoinConfiguration 文件,文件名和存放位置可以自定,--config 指定它的路径。重试 etcd-join 阶段时,复用该节点原来的加入配置。首次准备配置时,可以在当前目录生成默认模板:
模板中的地址和 Token 需要替换为实际集群的值,并补充 CA 证书哈希和 controlPlane 配置。模板生成方式见 kubeadm config print join-defaults,字段定义见 JoinConfiguration。
这套流程只适用于 kubeadm 管理的 stacked etcd。使用 External etcd 时,集群运维人员负责添加、启动和晋升成员,kubeadm 不修改外部 etcd 的成员关系。
etcd 读写与持久化¶
etcd 通过 Raft 将写入日志复制到各成员,由 MVCC 管理键值数据及其历史版本。持久化时,WAL 记录 Raft 日志和共识状态,Backend 保存应用日志后生成的键值数据及 etcd 元数据。
Raft¶
Raft 通过选举确定 Leader,由 Leader 将写请求依次记录到日志中,再复制给其他成员。当前任期的日志获得多数派确认后,Leader 推进提交位置,各成员按顺序执行已提交的操作,更新各自保存的数据。
日志中的编号和处理进度分别由以下字段表示:
term:任期编号。成员每发起一轮正式选举,就增加自己的 term;日志条目记录的是创建它的 Leader 所处的任期。index:日志条目在日志中的位置,用于确定条目的先后顺序。例如index=100表示日志的第 100 个位置,任期变化时不会从头编号。commitIndex:当前成员已确认提交到的位置。appliedIndex:本地已经执行到的位置。落后于commitIndex时,表示还有已提交的日志条目尚未执行。
下图展示了 A、B、C 三个投票成员从选举到处理 PUT hello world 的过程。
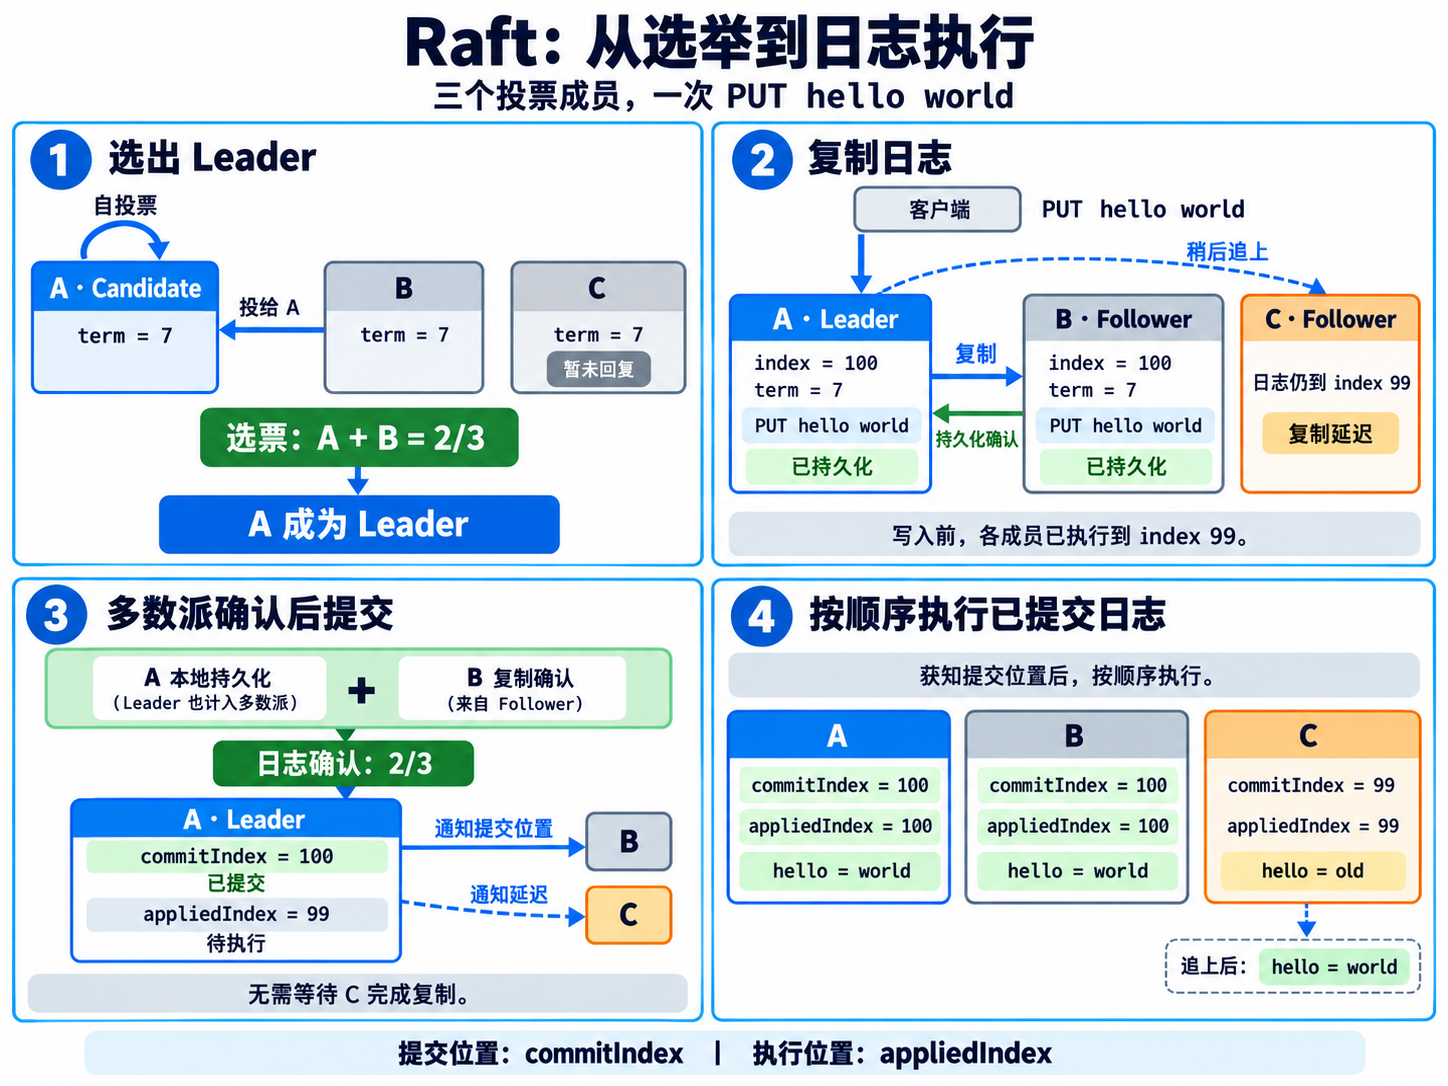
图:Raft 的选举、复制、提交与执行。
-
选出 Leader:A 在 term
7发起选举,先给自己投票,随后收到 B 的选票。C 尚未回复时,A 已获得2/3的选票,满足多数派要求,因此成为 Leader。 -
复制日志:假设本次写入前,三个成员都已执行到 index
99,hello的值为old。etcd server 将写请求作为 proposal(提案) 提交给 Raft。A 将PUT hello world记录为index=100、term=7的日志条目,写入本地 WAL,并复制给 B、C;本地 WAL 写入与复制消息发送可以并行。B 将收到的条目持久化到自己的 WAL 后,向 A 返回确认。此时尚未执行这项操作,hello仍为old;C 因复制延迟仍停在99。 -
多数派确认后提交:A 的本地持久化加上 B 的确认,满足
2/3的多数派要求。由于日志100属于当前任期,A 可以将提交位置推进到100,再通知其他成员,无需等待 C 完成复制。图中 A 此时的commitIndex=100、appliedIndex=99,表示这条日志已经提交,本地尚未执行。 -
执行已提交日志中的操作:A 执行日志
100中的PUT hello world,通过 MVCC 生成新的键值版本,写入 Backend 的 bbolt 写事务,并更新内存索引。这个过程称为应用日志(apply)。B 获知提交位置后也执行这项操作,两者的hello都变为world,appliedIndex推进到100。C 仍保存着hello=old,补齐日志并获知提交位置后,才执行这次写入。
Leader 选举¶
Raft 的投票成员有三种角色:
- Leader:接收写入提案,向其他成员复制日志,并根据复制进度推进提交位置。
- Follower:接收 Leader 的日志和心跳,在选举时投票。
- Candidate:发起选举、请求选票,取得多数票后成为 Leader。
Raft 使用两个编号描述任期和日志位置:
- term(任期):选举任期的编号。成员发起新一轮正式选举时,增加自己的 term。同一个任期最多选出一个 Leader,也可能因选票分散而没有选出 Leader。
- index(日志序号):日志条目在日志中的位置。每条日志同时记录 index 和创建它的 Leader 所处的 term。例如,
term=7、index=100表示该条目由第7任期的 Leader 创建,位于日志的第100个位置。
Leader 周期性发送心跳。Follower 在选举超时内没有收到有效 Leader 的消息时,会尝试发起选举。进入正式选举后,Candidate 增加 term,先给自己投票,再向其他投票成员请求选票。一个成员在同一任期内最多投给一个候选人;Candidate 获得多数票后成为 Leader。
多个 Candidate 同时竞选时,可能出现选票分散、无人取得多数票的情况。成员等待新的选举超时后重试,随机化超时时间用于错开竞选时机。
投票时还要检查候选人的日志是否足够新。双方比较各自最后一条日志的 term,term 相同时再比较 index:
- 候选人的最后一条日志为
term=7、index=100,本地为term=6、index=120,候选人的日志更新。 - 双方最后一条日志的 term 都是
7时,index 更大的一方日志更新。
因此,日志条目更多,并不一定表示日志更新。这项规则帮助新 Leader 保留已经提交的日志,源码见 isUpToDate。
etcd 默认还会在正式选举前执行 PreVote(预投票):先询问其他成员是否愿意支持自己,获得多数支持后再增加 term、进入正式选举。预投票阶段不增加本地任期,可以减少失联成员恢复连接后对现有 Leader 的干扰,具体实现见 PreCandidate 状态转换。
The Secret Lives of Data:Raft 的交互动画展示了角色转换、选举超时、选票分散和日志复制过程。
Quorum 与故障容忍¶
Quorum 是 Raft 作出选举、提交等决策所需的多数投票成员。在固定成员配置中,设投票成员数为 N:
Leader 本身计入多数派。Learner 只参与数据复制,不参与投票,也不计入 Quorum 的计算。
| 投票成员数 | Quorum | 可容忍故障数 |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
表中的故障容忍能力以其余成员能够正常通信为前提。N 按集群成员配置计算:成员停机或网络不可达后,在它被正式移除之前,仍然计入投票成员总数。
三个和四个投票成员都只能容忍一个成员故障,而四成员集群需要三个成员确认写入,因此 etcd 集群通常配置奇数个投票成员。
五个投票成员发生 3 + 2 网络分区时,三个成员的一侧可以维持或选出 Leader,继续提交新日志。两个成员的一侧无法组成 Quorum;即使原 Leader 留在这一侧,也无法提交新写入。
日志一致性¶
Leader 切换后,其他成员需要与新 Leader 同步日志。Raft 通过同一 index 上的 term 判断日志是否匹配:一致的部分继续保留,从第一个冲突位置开始替换后面的未提交日志。已经提交的日志必须保留,不能被覆盖。
假设日志已经提交到 index 100,之后的条目尚未提交。新 Leader 处于 term 8,旧日志保留原来的 term,新创建的条目使用 term 8。图中的 102 是新 Leader 自动追加的空日志,不包含业务操作,自身不修改 KV。
下图展示了新 Leader 的日志,以及 Follower 同步前后的变化。
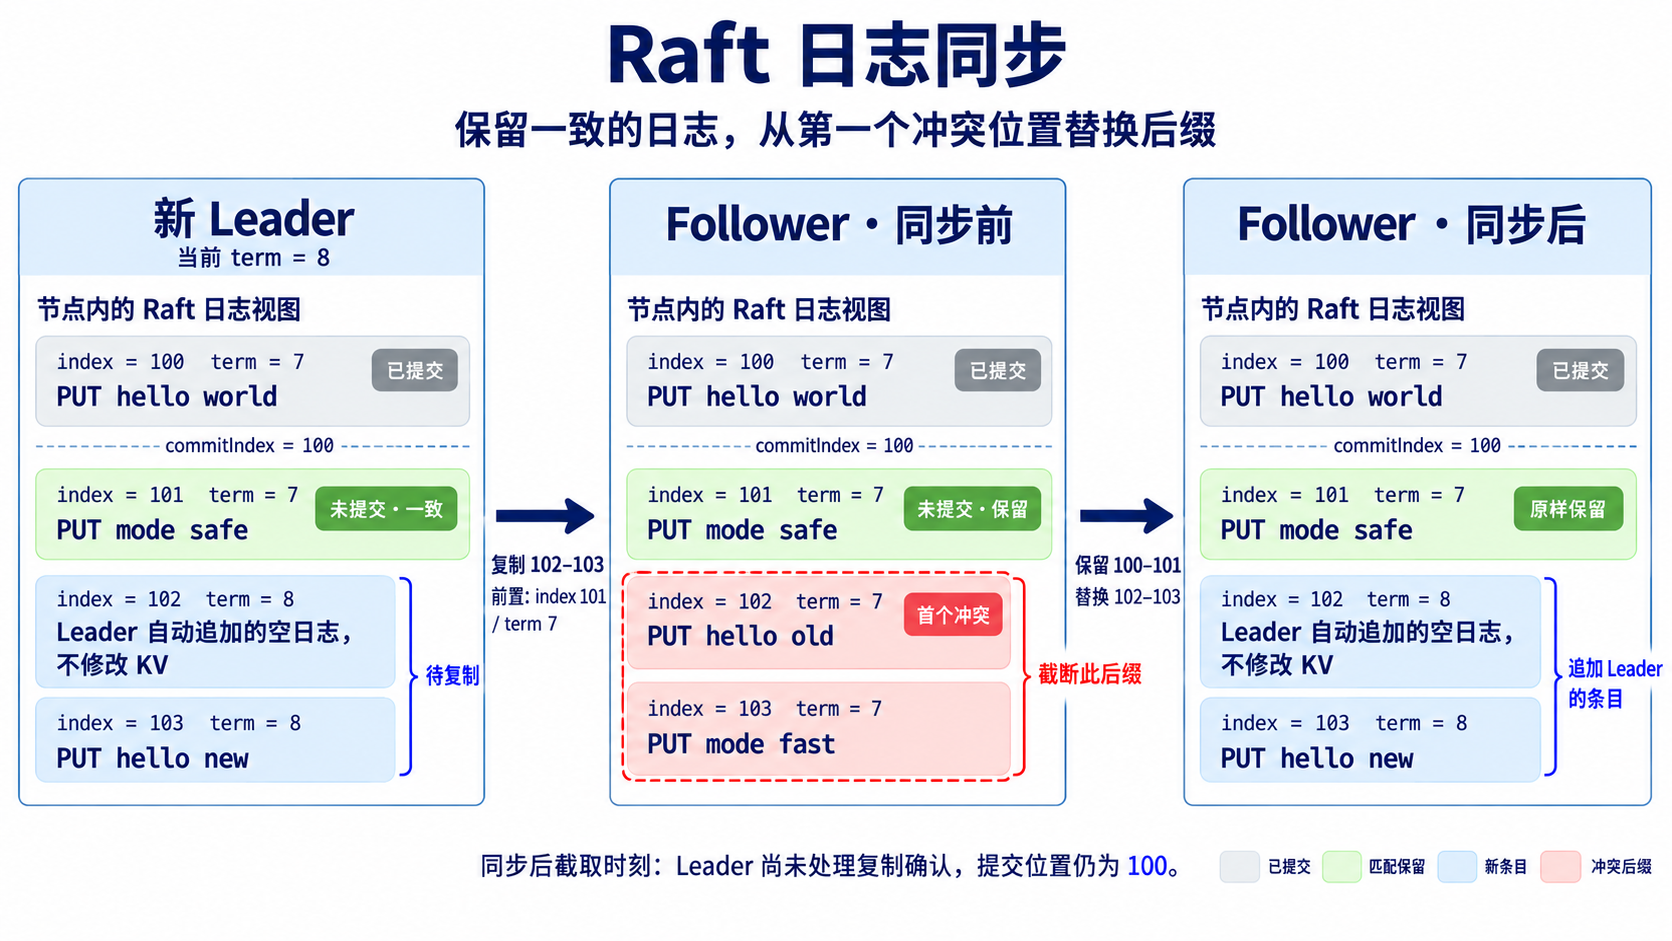
图:Raft 日志匹配与冲突替换。
-
确认衔接位置:Leader 发送日志
102、103时,附带前一条日志的index=101、term=7。Follower 检查本地对应位置是否匹配;不匹配就拒绝,Leader 调整发送起点后重试。 -
查找冲突条目:Follower 检查收到的日志。index
102在本地的 term 是7,Leader 发来的 term 是8,因此这里是第一个冲突位置。 -
替换冲突后缀:Follower 保留匹配的
100、101,截断从102开始的整个未提交后缀,再追加 Leader 发来的102、103。
MVCC 与 Revision¶
MVCC(Multi-Version Concurrency Control)为同一个 key 保存当前值和历史值。etcd 更新 key 时写入新版本,旧版本继续保留,直到 Compaction 清理相应的历史数据。客户端可以按 Revision 读取历史键值,也可以从指定 Revision 开始通过 Watch 接收变更事件。
客户端看到的 Revision 就是 main revision;etcd 内部还使用 sub revision 区分同一事务中的多项修改:
- main revision:整个集群 KV 键空间的全局版本号,也是对外返回的 revision。同一事务修改多个 key 时,这些修改共享同一个 main revision。
- sub revision:同一事务内各项修改的序号,从
0开始。例如,一次事务修改两个 key,它们的内部版本可以分别是(4, 0)和(4, 1),对外返回的 revision 都是4。
读请求和成员变更不会增加 MVCC Revision。新 Leader 当选后会自动追加一条空日志:它有 term 和 index,但不包含修改 KV 的操作,也不会增加 MVCC Revision。
| 标识 | 递增条件 | 作用 |
|---|---|---|
| Raft log index | 每条 Raft 日志(包括空日志)获得一个连续的 index | 标识日志顺序和提交进度 |
| MVCC main revision | 原子事务实际修改 KV 键空间 | 标识一次键空间变更,支持历史读取和 Watch |
| MVCC sub revision | 同一事务修改多个 key | 标识各项修改在事务内的顺序 |
索引结构¶
etcd 使用两套索引完成版本读取:内存中的 B-tree 根据 key 查找对应的 Revision,Backend 中的 B+tree 根据 Revision 查找实际的键值记录。
B 树与 B+ 树
B 树(B-tree)和 B+ 树(B+tree)都是平衡多路搜索树,一个节点可以包含多个 key,并连接多个子节点。两者的主要区别是记录的存放位置。
| 对比 | B 树 | B+ 树 |
|---|---|---|
| 非叶子节点 | 保存记录和子节点指针 | 保存用于查找的 key 和子节点指针 |
| 叶子节点 | 保存记录 | 保存全部记录 |
| 查找一条记录 | 可以在非叶子节点或叶子节点命中 | 需要到叶子节点命中 |
下图展示了同一组 key 在两种树中的分布,R30 表示 key 30 对应的记录。查找 30 时,左侧 B 树在根节点就能找到记录,右侧 B+ 树则根据根节点中的 key 继续查找,在叶子节点取得记录。
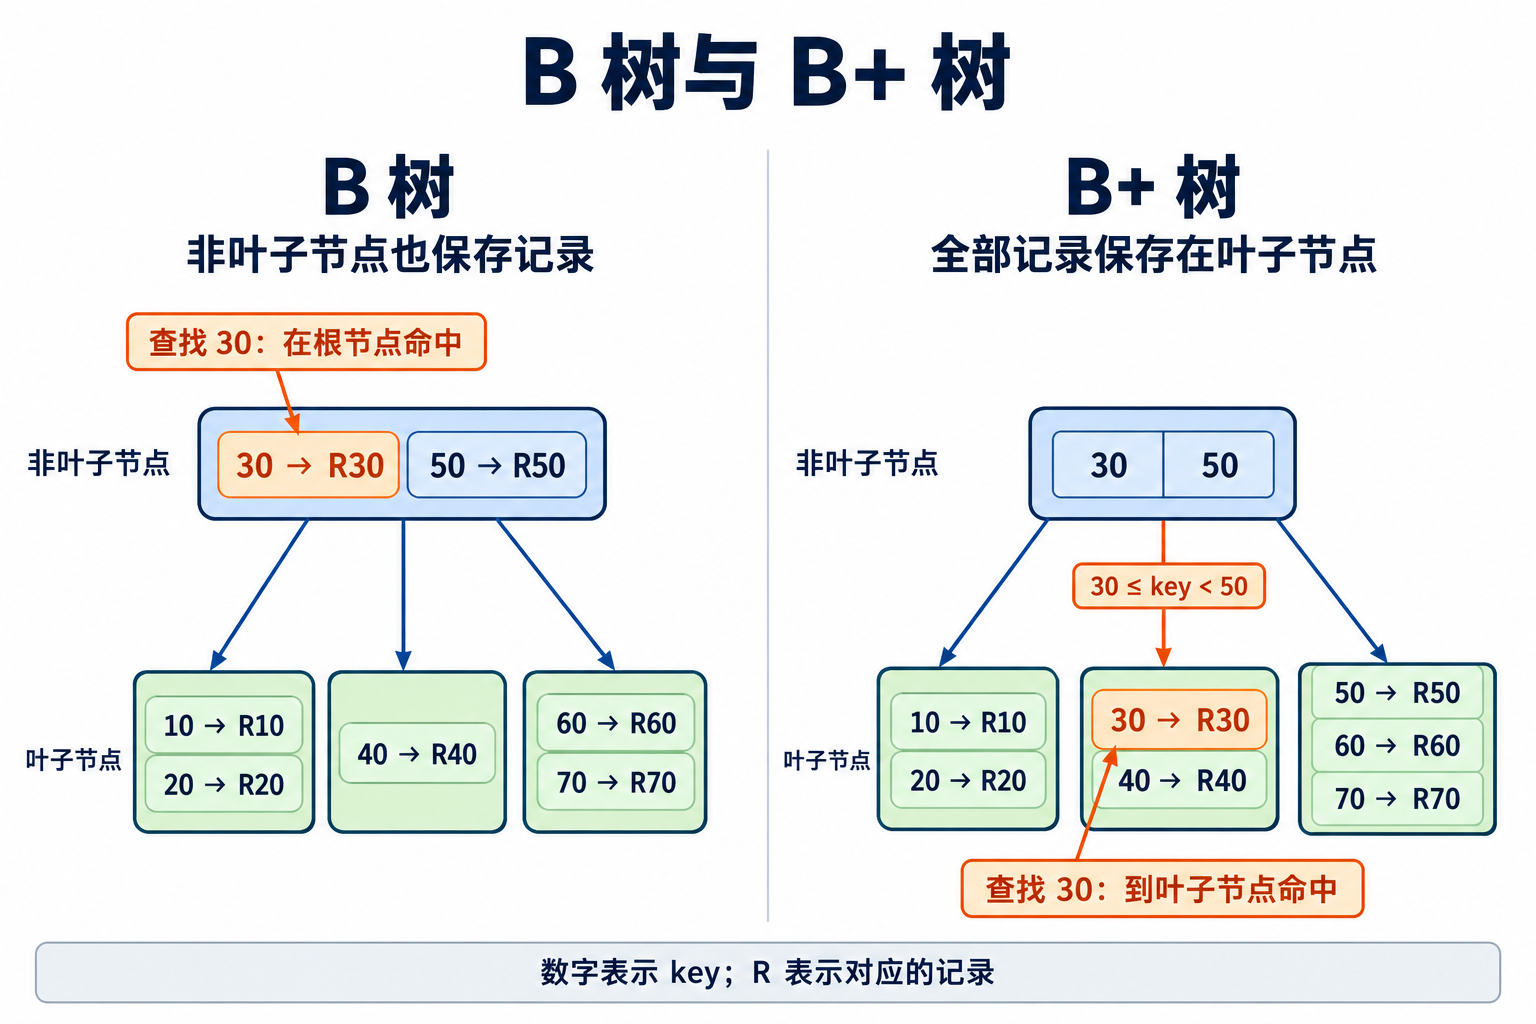
图:B 树与 B+ 树中记录的存放位置。
两种结构各有优势:
- B 树:部分单 key 查询可以在非叶子节点直接取得记录,减少向下遍历。实际查询速度还取决于节点布局和缓存访问。
- B+ 树:分支节点只保存导航信息。在 key、指针和页面大小相近的情况下,相比在分支节点中保存完整记录,通常可以容纳更多子节点,有利于降低树高和页面访问次数。记录集中在叶子层,也便于按 key 顺序进行范围扫描。
B 树适合保存轻量的内存索引条目,同时支持单 key 查询和有序遍历;B+ 树将导航信息与记录分开,更便于组织按页存储的数据。etcd 分别采用这两种结构完成内存索引和 Backend 存储。
-
内存索引(
treeIndex):treeIndex持有一棵按 key 的字节序排序的 B-tree,树中的每个条目指向一个keyIndex。keyIndex记录单个 key 的创建、更新和删除对应的 Revision,供查询时选择指定时点的有效版本。以下保留内存索引相关结构的关键字段,省略
treeIndex的锁和日志字段。其中,generation保存一代的版本信息,Revision由 Main 和 Sub 两部分组成:内存索引的关键结构type treeIndex struct { tree *btree.BTree[*keyIndex] // 按 key 排序的 B 树 } type keyIndex struct { key []byte // 键名,B-tree 按该字段的字节序排列索引条目 modified Revision // 最近一次修改的 Revision,包含 Main 和 Sub generations []generation // 各代保留的版本信息 } type generation struct { ver int64 // 这一代的版本计数,包含删除操作 created Revision // 这一代首次创建时的 Revision revs []Revision // 这一代仍保留的 Revision 列表 } type Revision struct { Main int64 // 一组原子修改共享的主版本号 Sub int64 // 这组修改中各项修改的序号,从 0 开始递增 }treeIndex.tree指向一个BTree对象,其root字段指向根节点。树节点由node表示,保存当前节点的索引条目和子节点指针:B-tree 与节点结构type BTree[T any] struct { degree int length int root *node[T] // 指向整棵树的根节点 cow *copyOnWriteContext[T] } type items[T any] []T // 保存元素的切片 type node[T any] struct { items items[T] // 当前节点保存的索引条目 children items[*node[T]] // 指向子节点的指针 cow *copyOnWriteContext[T] // 写时复制上下文 }在 etcd 中,
T是*keyIndex,因此:items:保存多个*keyIndex,按 key 排序。children:保存子节点指针,连接下一层树节点。cow:支持树克隆后的写时复制。
node表示树节点,keyIndex表示节点中保存的索引条目。 -
持久化索引(bbolt B+tree):Backend 的
keyBucket 以编码后的 Revision 为 key,以 Protobuf 序列化的KeyValue为 value。/key1保存在KeyValue.Key字段中。存储键由
BucketKey表示,包含前文的Revision和删除标记;存储值对应mvccpb.KeyValue。下面保留相关字段,省略 Protobuf 运行时字段和结构体标签:Backend 的键值结构// 编码后作为 Backend 的 key type BucketKey struct { Revision // 包含 Main 和 Sub tombstone bool // 是否为删除记录 } // Protobuf 序列化后作为 Backend 的 value type KeyValue struct { Key []byte // 键名,如 /key1 CreateRevision int64 // 当前生命周期的创建版本 ModRevision int64 // 最近一次修改的版本 Version int64 // 当前生命周期的版本计数 Value []byte // 对应的值,如 value2 Lease int64 // 绑定的 Lease ID,0 表示未绑定 }图中的
(3,0)对应Revision{Main: 3, Sub: 0},编码后用于定位记录;/key1和value2则分别保存在KeyValue.Key和KeyValue.Value中。bbolt 按存储键的字节序组织 B+tree。etcd 将 Revision 的 Main 和 Sub 按大端字节序编码为固定长度的字节序列,因此 Backend 的
keyBucket 中,记录先按 Main 排序,Main 相同时再按 Sub 排序。分支页通过下界 key 和子页地址定位下一层,叶子页保存实际记录,查找过程见 bbolt Cursor。
下图展示了 /key1 经创建、更新、删除和重新创建后,MVCC 索引中的记录。
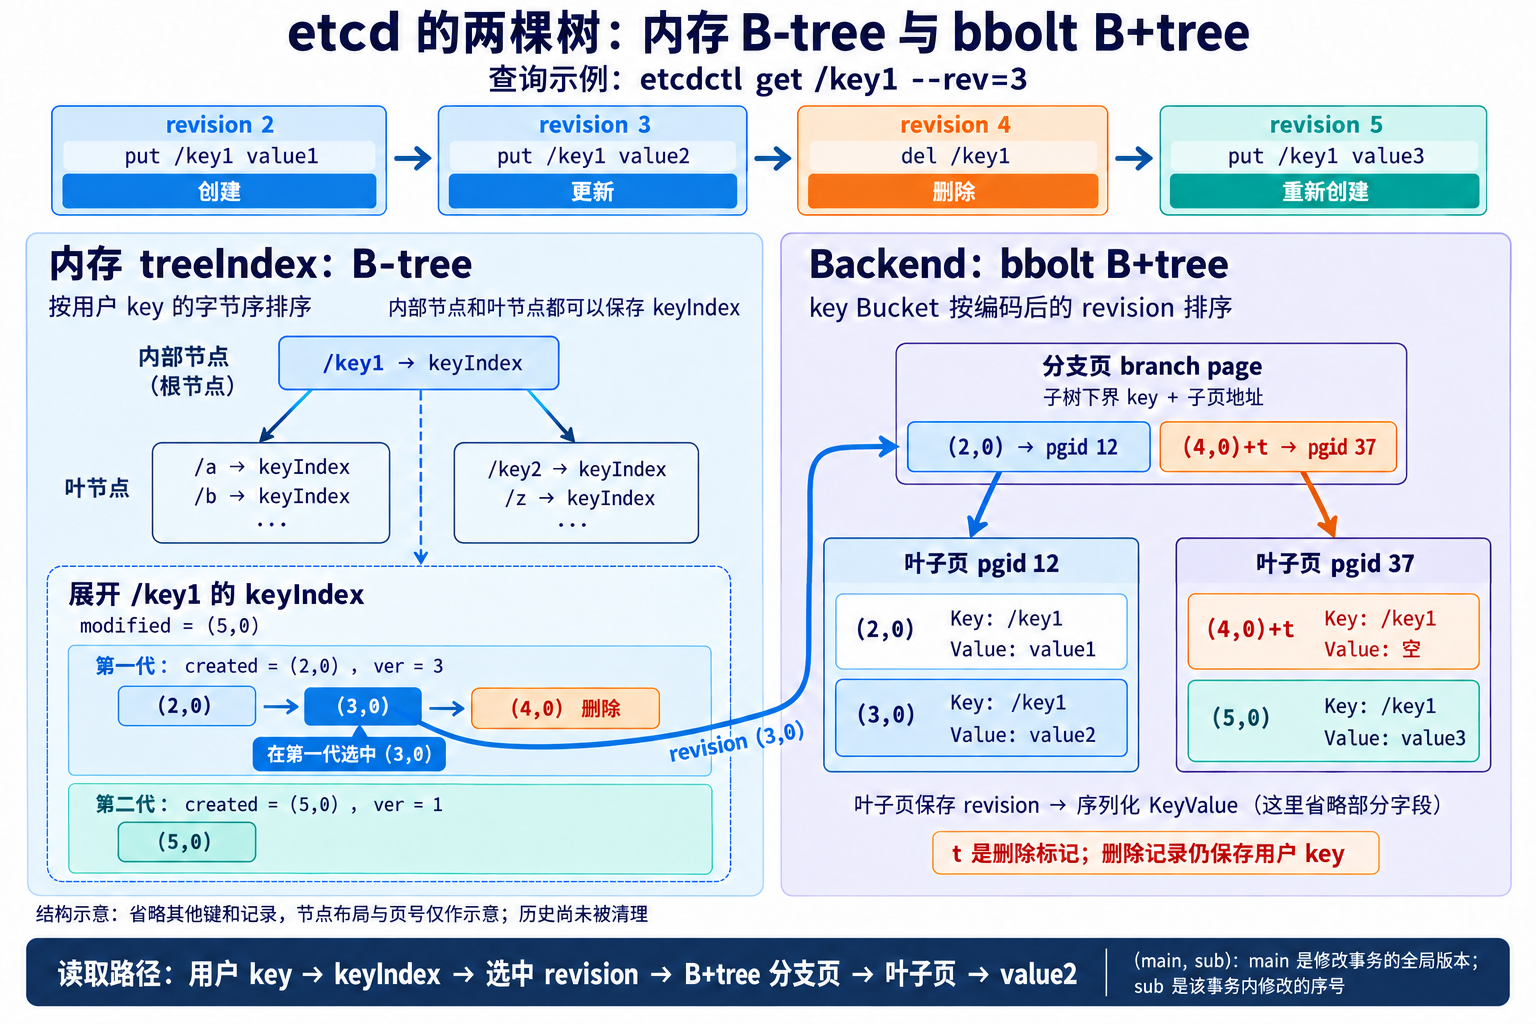
图:内存索引选择历史版本,bbolt B+tree 读取对应的键值记录。
图顶部按时间顺序展示了四次修改:/key1 在 revision 2 创建,在 3 更新,在 4 删除,在 5 重新创建。每次操作单独执行,只修改一个 key,因此内部 Revision (main, sub) 的 sub 都为 0。
索引更新
每次修改都先在右侧 Backend 的 key Bucket 中写入版本记录,再更新左侧内存索引。key 是 Bucket 的名称;这个容器以编码后的 Revision 为键,以序列化的 KeyValue 为值,保存 /key1、对应的 value 和版本信息。
- 创建(revision
2):Backend 写入(2,0)对应的value1。内存中创建/key1的keyIndex,插入按 key 排序的 B-tree;第一代的创建版本为(2,0),版本列表中只有(2,0),版本计数为1。 - 更新(revision
3):Backend 追加(3,0)对应的value2。找到同一个keyIndex,在第一代的版本列表中追加(3,0),将这一代的版本计数增至2,创建版本保持不变。 - 删除(revision
4):Backend 追加(4,0)+t,其中t是删除标记,记录保留/key1,value 为空。内存索引在第一代的版本列表末尾追加删除版本(4,0),结束这一代,并建立一个空的第二代。 - 重新创建(revision
5):Backend 追加(5,0)对应的value3。同一个keyIndex的第二代将创建版本设为(5,0),在版本列表中加入(5,0),版本计数从1开始。
版本查询
执行 etcdctl get /key1 --rev=3 时,按图中的模块依次查找:
- 左侧 B-tree:找到
keyIndex。从根节点按 key 的字节序比较,未命中时沿对应的子节点继续查找。图中的/key1就在根节点,可以直接取得它的keyIndex。 - 左下
keyIndex:选中(3,0)。第二代从 revision5开始,查询 revision3时选择第一代。再从版本列表末尾向前查找,跳过晚于3的删除版本(4,0),选中当时有效的(3,0)。 - 右侧分支页:找到叶子页。将
(3,0)编码为 Backend 的查询键。分支页保存子树的下界 key 和子页编号pgid;(3,0)位于(2,0)与(4,0)+t之间,因此沿(2,0)对应的分支进入叶子页12。图中的12、37是示意页号。 - 右下叶子页:读取记录。在页
12中找到(3,0),解码对应的KeyValue,返回/key1的value2。
版本写入¶
客户端提供 key 和 value,etcd 为每项修改分配内部 Revision (main, sub),并维护 key 的创建版本(create_revision)、最近修改版本(mod_revision)和当前生命周期内的写入次数(version)。
假设全局 revision 为 1,创建 /key1,值为 value1,这次写入得到 (2, 0)。随后一个事务先将它更新为 value2,再创建 /key2,值为 value2。这个事务将全局 revision 推进到 3,生成以下两条记录:
key      value     (main, sub)    create_revision    mod_revision    version
/key1    value2    (3, 0)         2                  3               2
/key2    value2    (3, 1)         3                  3               1
main revision:每个实际修改键空间的事务将全局 revision 增加1。两项修改属于同一事务,因此共享3。sub revision:按事务内的修改顺序从0编号。更新/key1使用0,创建/key2使用1。create_revision:记录 key 当前生命周期开始时的 main。/key1在 revision2创建,更新后仍为2;/key2在本次事务中创建,为3。mod_revision:记录 key 最近一次修改对应的 main。两个 key 都在本次事务中修改,因此均为3。version:记录 key 当前生命周期中的写入次数。/key1经历创建和更新,为2;/key2刚创建,为1。删除后重新创建时从1开始。
下图展示了 Revision 的分配过程,以及后端记录和内存索引的对应关系。
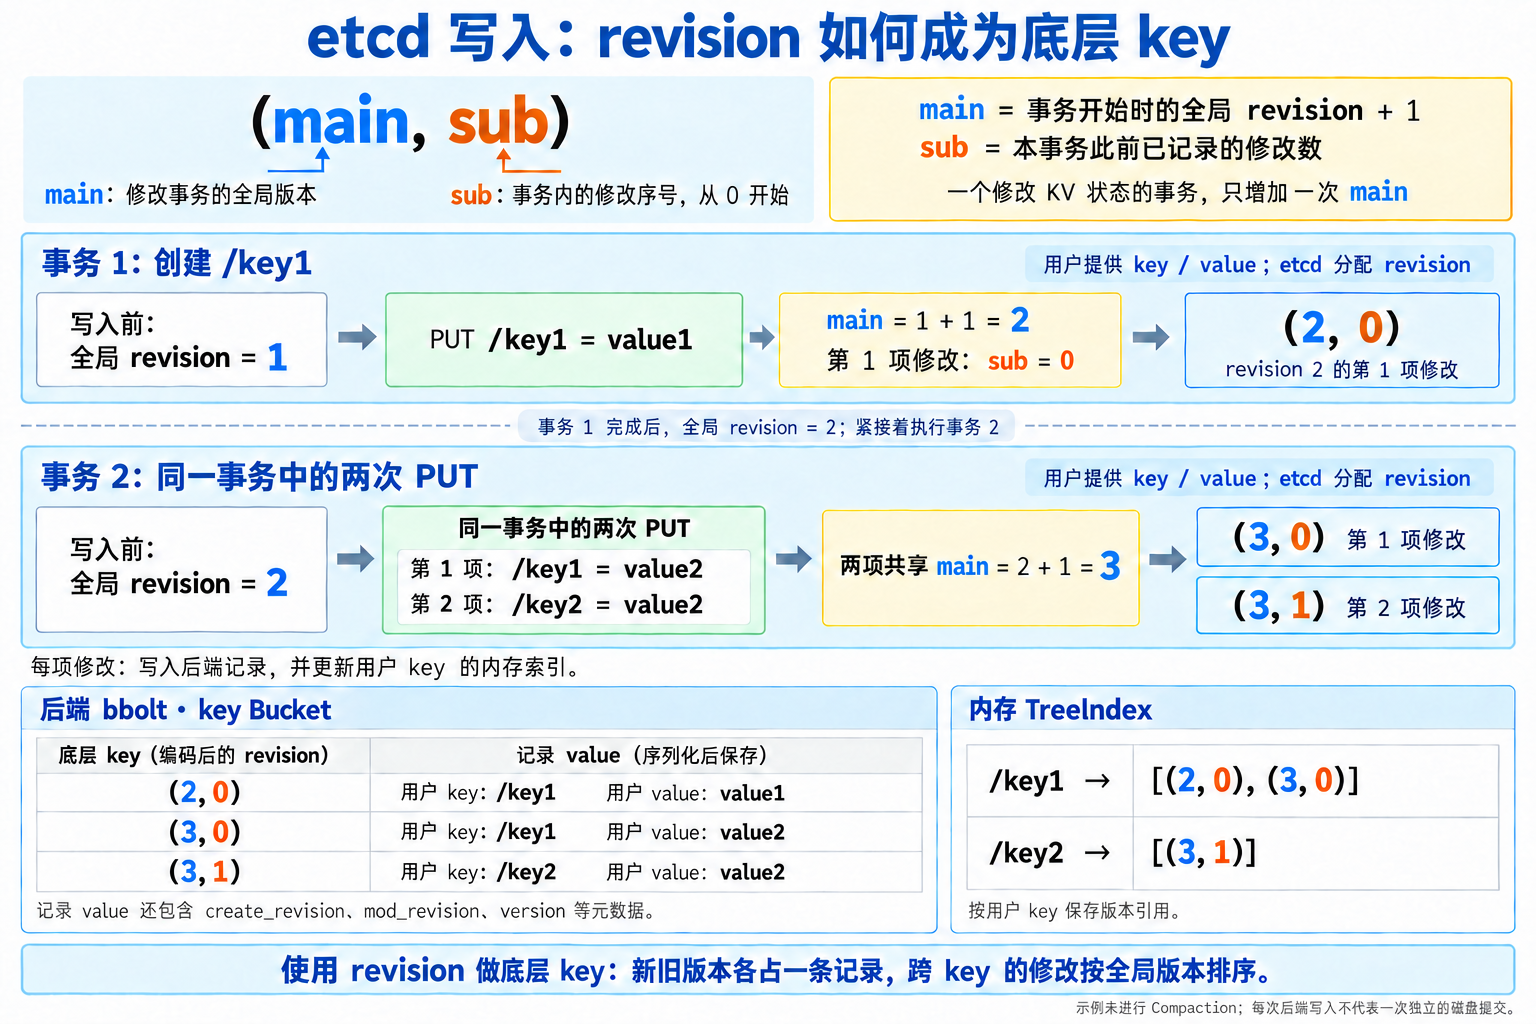
图:版本写入。
写入时,etcd 在 Backend 中追加对应 Revision 的键值记录,并更新内存 treeIndex。/key1 的旧值保存在 (2, 0),更新后的值保存在 (3, 0)。每次修改都有独立记录,按 Revision 排列后,也便于扫描跨多个 key 的历史变化。实际编码见 Revision 与 bucketKey。
版本读取¶
按 key 读取时,revision 指定要读取的键空间版本。etcd 先通过内存 treeIndex 找到该 key 在指定 revision 下有效的版本,再用对应的 (main, sub) 读取 Backend 中的记录。以图中的 /key1 为例,查询 revision 3 时选中 (3, 0),返回 value2。
Watch 补发历史时,先按 Revision 区间扫描,再匹配订阅的 key。图中从 revision 3 扫描到 (3, 0) 和 (3, 1),分别对应 /key1 和 /key2;匹配后,只向订阅 /key1 的 Watch 推送 (3, 0) 对应的事件。
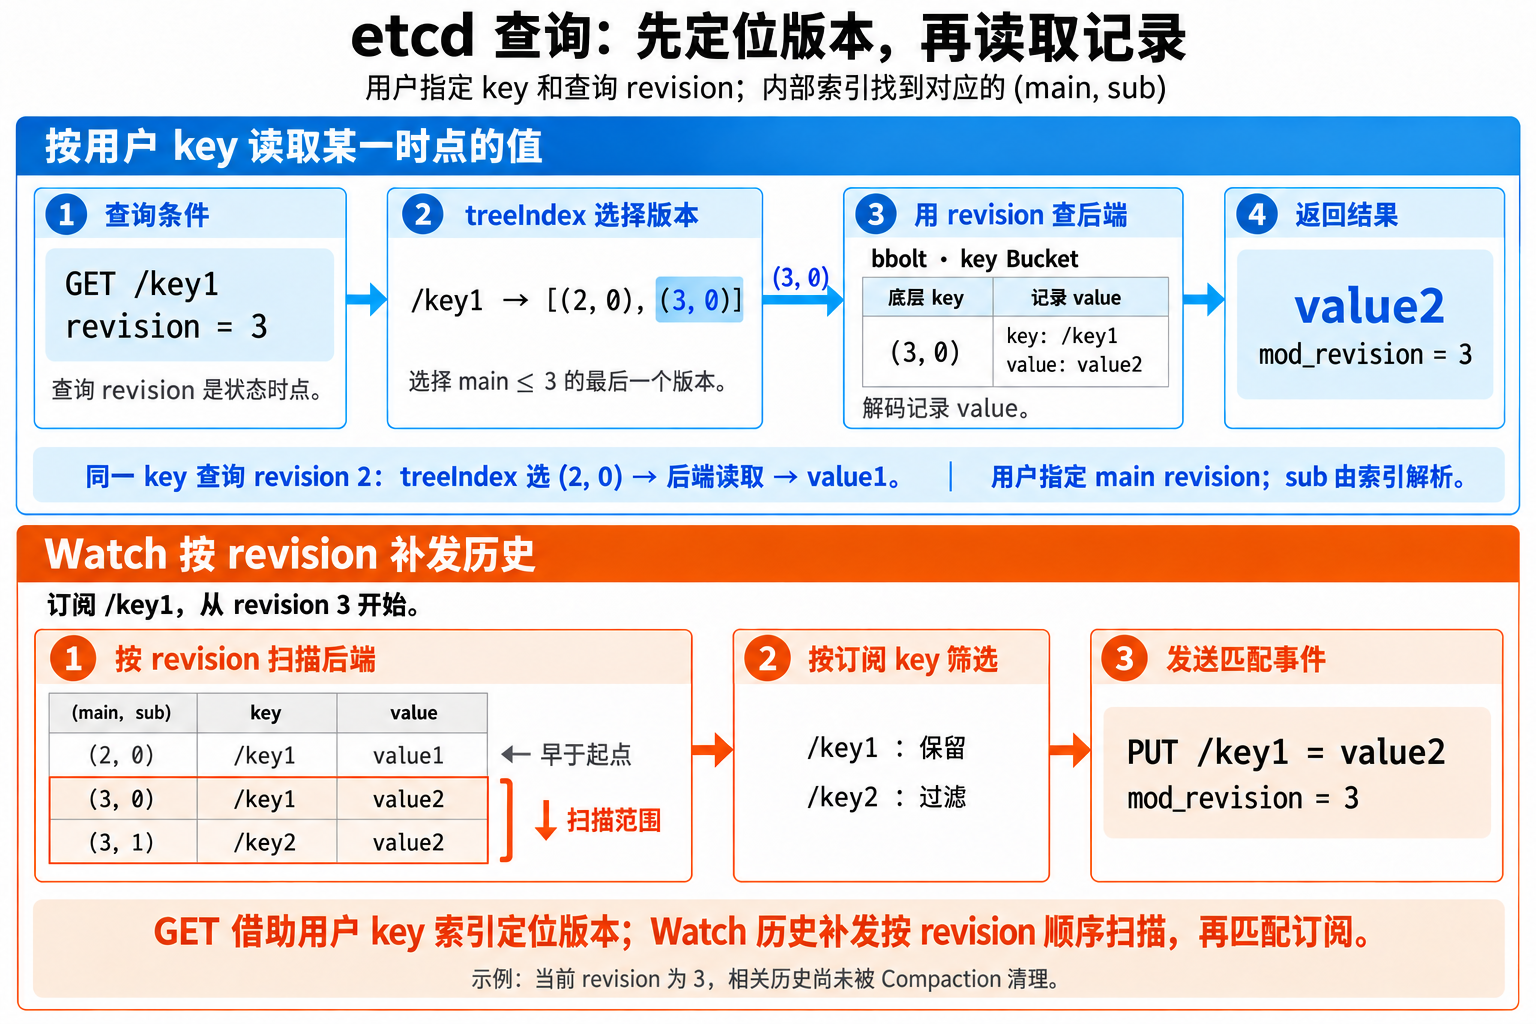
图:版本读取与 Watch 历史扫描。
持久化存储¶
etcd 通过预写日志(WAL)和基于 bbolt 的 Backend 实现数据持久化,使成员在故障重启后能够恢复 Raft 状态和键值数据:
- WAL:保存 Raft 日志,以及当前任期、投票对象和提交位置。成员重启时,etcd 读取 WAL,恢复这些 Raft 状态。
- Backend:使用 bbolt 保存操作执行后的键值数据,以及 Lease、成员关系等信息。重启恢复以这些已持久化的数据为基础,再补执行尚未写入数据库的已提交操作。
WAL¶
WAL(Write-Ahead Log,预写日志)将 Raft 日志和共识状态持久化到本地磁盘,主要保存:
- 日志条目(Entry):包含日志的 term、index 和操作内容,例如将
hello写为world。 - 共识状态(HardState):记录当前 term、本任期的投票对象,以及已提交日志的位置 commit index。
- 快照记录(Snapshot):保存快照的 term、index 和成员配置(ConfState),不包含键值数据。
Follower 收到复制的日志后,先将其持久化到 WAL,再向 Leader 返回确认。写入 WAL 的日志可能尚未提交。日志提交后,etcd 才会按日志顺序执行其中的操作,更新本地数据。
WAL 以追加方式保存记录。未提交的日志发生冲突时,替换它的新记录会追加到文件末尾;恢复时,etcd 根据这些记录重建有效的日志序列。
WAL 记录示例
下图展示 WAL 中的 Entry、HardState 和 Snapshot 记录。
图中的颜色和线型含义如下:
- 深蓝色
Snapshot metadata:WAL 中的快照元数据记录,图中标出 term 和 index。 - 浅蓝色
Entry:保存通过 Raft 复制的操作,既可能已经提交,也可能仍位于未提交的日志尾部。 - 绿色
HardState:保存当前 term、投票对象和 commit index。 - 虚线
Entry:表示被后续 Leader 的日志取代的旧条目。省略行表示图中没有逐条画出的 Entry 和 HardState。
从上往下读取这段 WAL 时间线:
-
日志写入与提交:
Entry (Term: 2, Index: 9)表示日志位置为9的条目已写入这个成员的 WAL。随后的HardState (Term: 2, Commit: 8)表示该成员记录的提交位置仍为8,此时只允许执行 index 不大于8的日志。可能是 Leader 尚未收到多数投票成员的复制确认,例如复制请求或确认消息仍在传输中。 -
被替换的旧条目:index
8及之前的日志已经提交,后续 Leader 必须保留。图中假设 Term 2 的 index9–10尚未提交,随后被新 Leader 的日志取代,因此用虚线标记。 - 新一轮选举:term 从
2增加到3。成员将新的 term 和投票状态写入HardState,commit index 仍为8。 - Term 3 的新日志尾部:
Entry (Term: 3, Index: 9)追加到 WAL,取代 Term 2 的旧 index9,同时在逻辑上截断旧的 index10。随后的HardState (Term: 3, Commit: 9)记录提交位置推进到9,新的 index10–11继续追加。
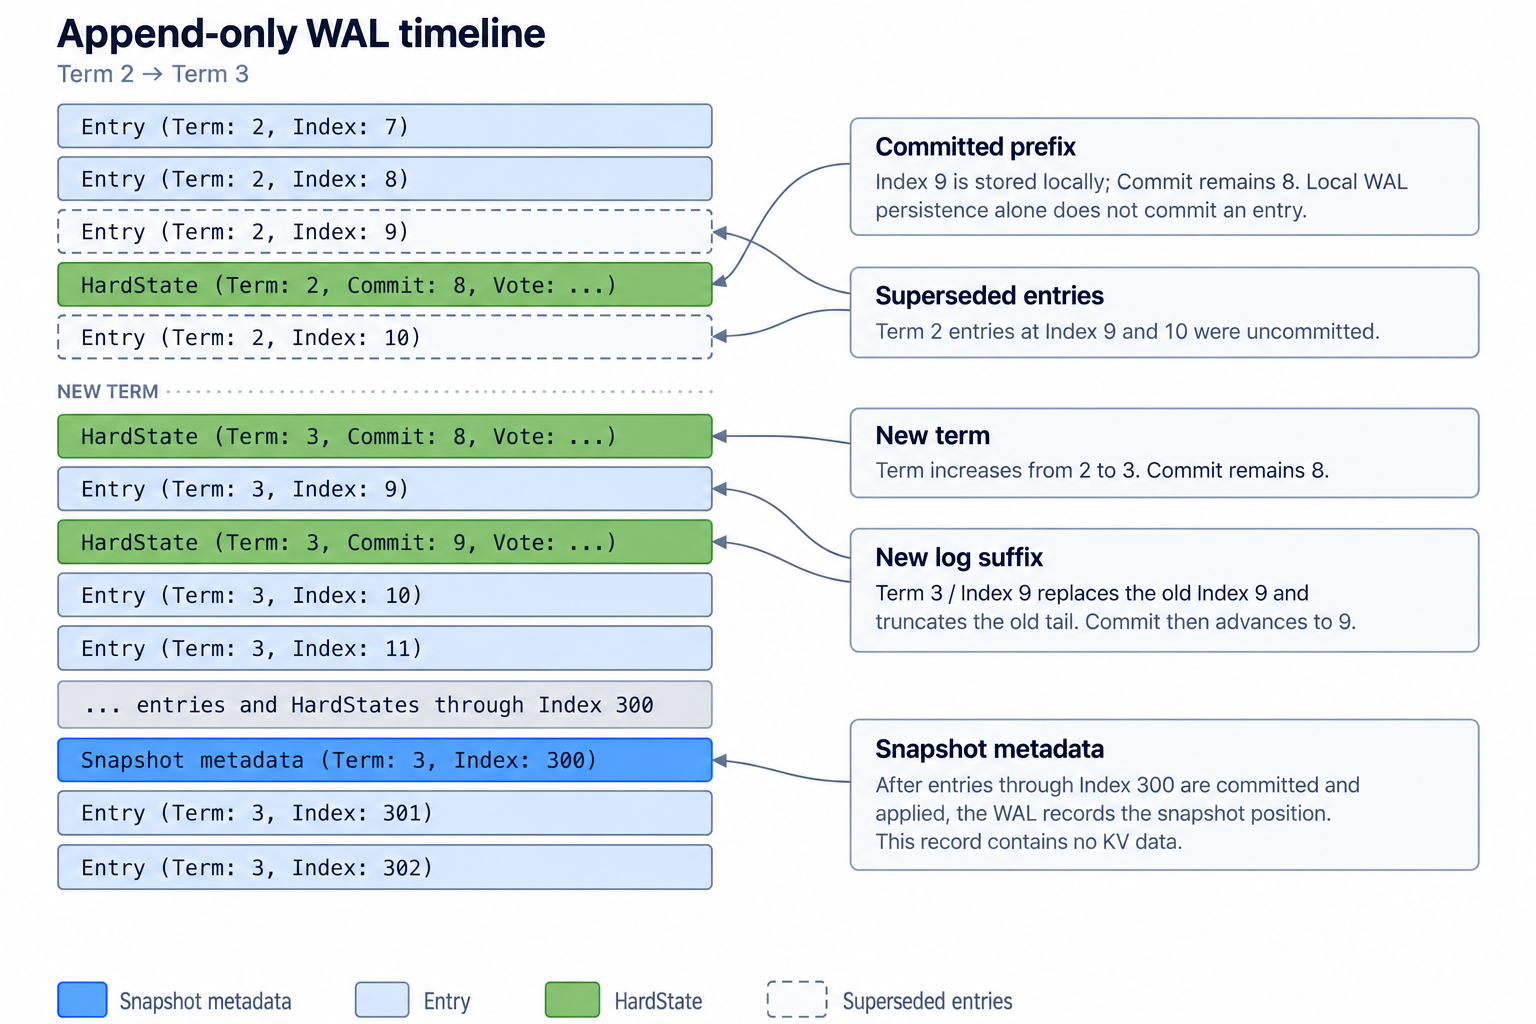
图:WAL 记录的追加过程。
Backend¶
Backend 是 MVCC 的持久化层,使用 bbolt 保存键值状态和 etcd 元数据。它将多次修改合并到一个 bbolt 写事务中提交,减少频繁提交的开销。
完成 apply 表示已执行日志中的操作,对应修改可能尚未随 bbolt 事务持久化。Backend 通过读缓冲区,让后续读取能够看到这些已应用的修改。
bbolt 的存储与事务
bbolt 是使用 Go 编写的嵌入式 KV 数据库,由 Bolt 项目发展而来。它作为库运行在应用进程内,将数据保存在单个数据库文件中。其存储和事务机制具有以下特点:
-
B+tree 与页面管理:bbolt 使用 B+tree 按 key 的字节序组织数据,支持单 key 查询和范围遍历。数据库文件由多个页面组成,freelist 记录可复用的空闲页。键的逻辑顺序与页面的物理位置并不相同,相邻 key 对应的数据页可能分布在不同文件偏移。
-
事务与写时复制:bbolt 提供可串行化的 ACID 事务。同一时间只允许一个读写事务,一个事务可以修改多个 Bucket 和 key;多个只读事务可以并发执行,各自看到一致的数据视图。写入通过写时复制(Copy-on-Write)保留旧事务需要的数据页,因此长时间运行的读事务可能延迟旧页复用,使数据库文件持续增长。事务约束见 bbolt 事务说明。
-
内存映射与缓存:bbolt 使用
mmap将数据库文件映射到进程的虚拟地址空间,由操作系统管理文件页缓存。访问已缓存的数据页时可以直接从内存读取,未缓存的页面仍需要从存储设备加载。数据库文件可以大于可用物理内存,实际读取性能取决于工作集大小和缓存命中率。具体实现见 bbolt 内存映射实现。 -
读写性能特点:bbolt 适合读密集型工作负载,有序插入通常也有较好的表现。随机插入可能涉及更多分散的页面访问和页面分裂;批量提交可以摊薄事务提交成本。SSD 有助于降低缓存未命中时的随机访问延迟,具体性能仍取决于数据规模、访问模式和硬件。性能特点见 bbolt 注意事项与限制。
持久化文件¶
etcd 默认在 --data-dir 下保存数据库、日志与快照文件。文件名中的 seq、term 和 index 均使用十六进制表示:
member/snap/db:工作数据库。这是 etcd 日常运行时持续更新的 bbolt 数据库,保存 MVCC 键值数据、Lease、成员关系和授权信息等。metaBucket 中的consistent_index随数据一起持久化,表示数据库已经包含到哪个 Raft 日志位置。member/wal/<seq>-<index>.wal:Raft 日志文件。保存 Entry、HardState 和 Snapshot 元数据记录(term、index、ConfState),以及 CRC 校验值、集群和成员标识。seq是 WAL 文件序号,index是该文件第一条 Entry 或 Snapshot 的日志位置。member/snap/<term>-<index>.snap:Raft 快照文件。保存 term、index 和成员配置等信息,不包含完整的 v3 KV 数据。Follower 通过快照追赶时,将 Leader 发来的 Raft 快照消息保存为此文件,用于恢复 Raft 状态、确定后续日志的起点。本地定期生成的 Raft 快照也使用这个格式。member/snap/<index>.snap.db:接收到的数据库快照。Follower 接收 Leader 同次发送的数据库数据流,保存为此文件,与.snap配合恢复实际数据。安装时将它重命名为member/snap/db,替换原工作数据库,再继续应用后续已提交日志。本地定期生成 Raft 快照时,数据已在db中,无需额外生成.snap.db。
WAL 可以通过 --wal-dir 指定独立目录,其他文件仍保存在 --data-dir 下。
写入流程¶
etcd 客户端可以连接任意投票成员。写入请求到达 Follower 后,etcd 将请求交给当前 Leader;客户端不需要预先查询 Leader。
日志应用¶
日志提交后,各成员按日志顺序执行其中的操作,更新本地状态机。日志的提交进度与执行进度分别由两个位置表示:
- commit index:当前成员已经确认提交到的 Raft 日志位置。
- applied index:本地状态机已经执行到的 Raft 日志位置。
例如,commit index=100、applied index=98 表示日志已经提交到 100,本地状态机还需要依次执行日志 99 和 100。各成员的应用进度可以暂时不同;处理写请求的成员在本地执行完对应操作后,才向客户端返回成功响应。
请求到达 Leader¶
下图展示了写请求直接到达 Leader 的正常路径。图中的编号从 gRPC 请求开始,经过 Raft 日志复制、提交和状态机 apply,最后返回成功响应。
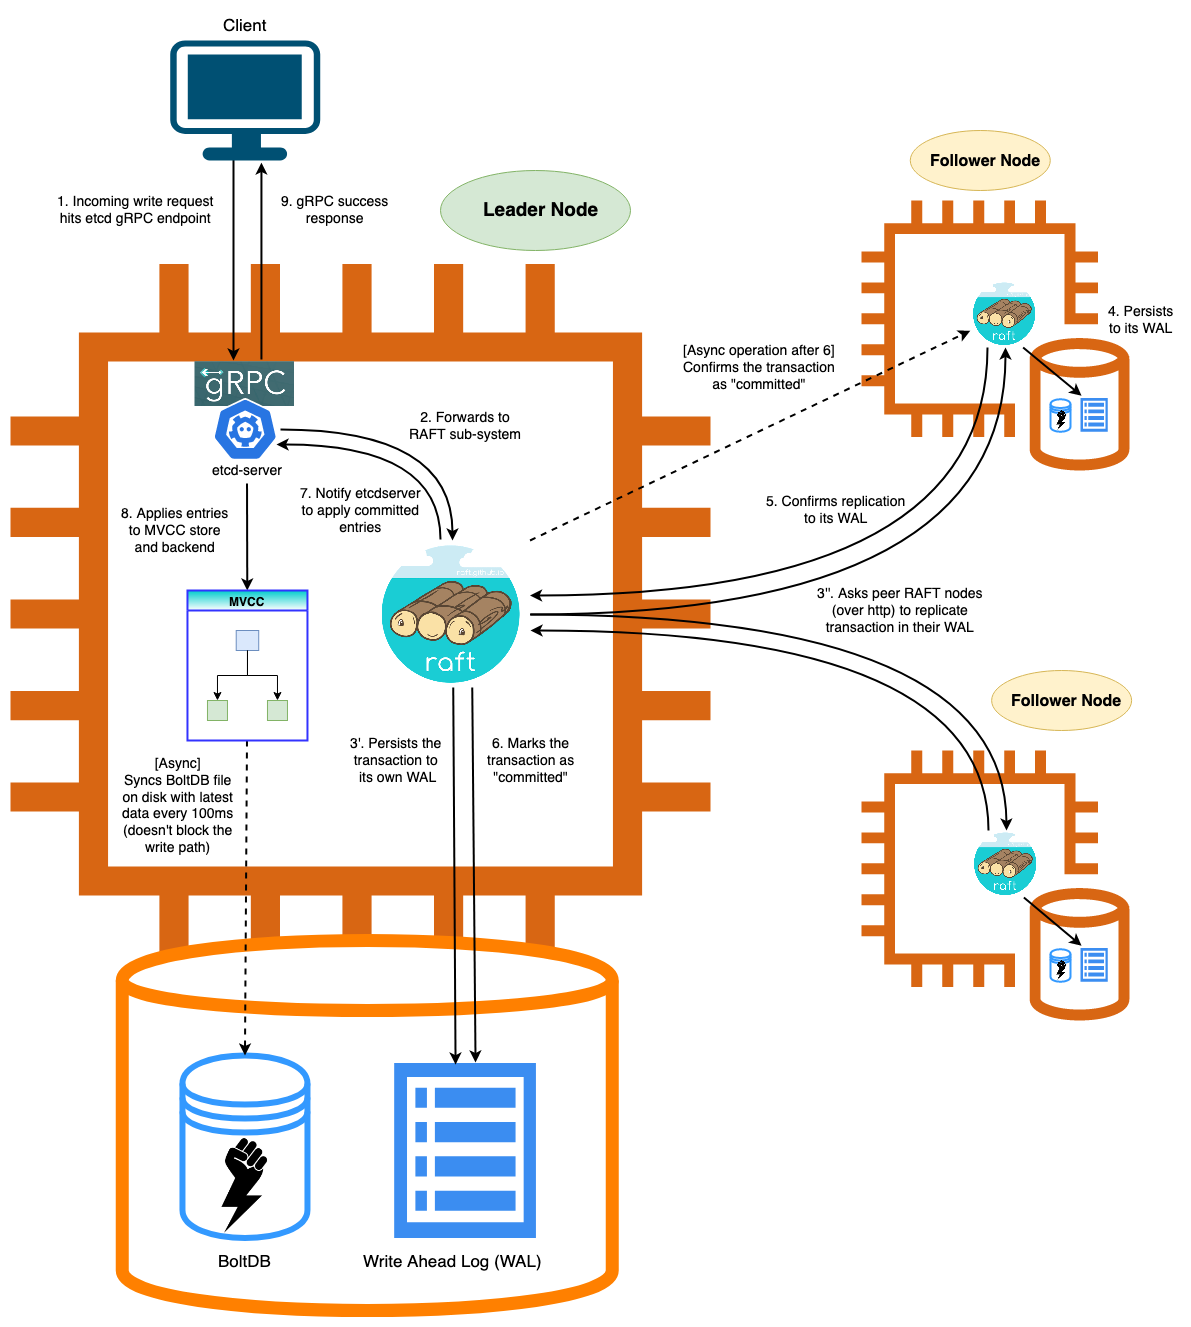
图:写请求直接到达 Leader 的处理流程。来源:etcd write_workflow_leader.png,Apache-2.0。

图中的编号表示写入的逻辑阶段。Leader 本地 WAL 写入和 Raft peer 消息发送可以并行执行,发送给各个 Follower 的复制消息也彼此独立。
- 接收请求:Leader 的 gRPC endpoint 收到写请求。
- 提交 proposal:etcd server 将请求交给本地 Raft 模块。
-
持久化与复制:Leader 并行处理本地 WAL 和成员间复制。
3':Leader 将 proposal 写入本机 WAL。3'':Leader 向各个 Follower 发送 Raft 日志复制消息。
-
Follower 写入 WAL:Follower 先将收到的日志持久化到本机 WAL。
- Follower 返回确认:Follower 完成本地 WAL 写入后向 Leader 确认复制结果。
- 提交日志:Leader 收到 Quorum 确认后推进 commit index。三投票成员集群只需要 Leader 和任意一个 Follower;新的 commit index 随后异步发送给其他 Follower。
- 通知状态机:Raft 将 committed entry 交给 etcd server 的 apply loop。
- 更新键空间:apply loop 执行写入,MVCC 分配 revision 并更新 Backend。
- 返回结果:本地 apply 完成后,etcd server 通过原 gRPC 连接返回成功响应。
请求到达 Follower¶
写请求也可以先到达 Follower。Follower 将请求交给自己的 Raft 模块,再转发给 Leader;后续的日志排序、复制和多数派提交仍由 Leader 完成。
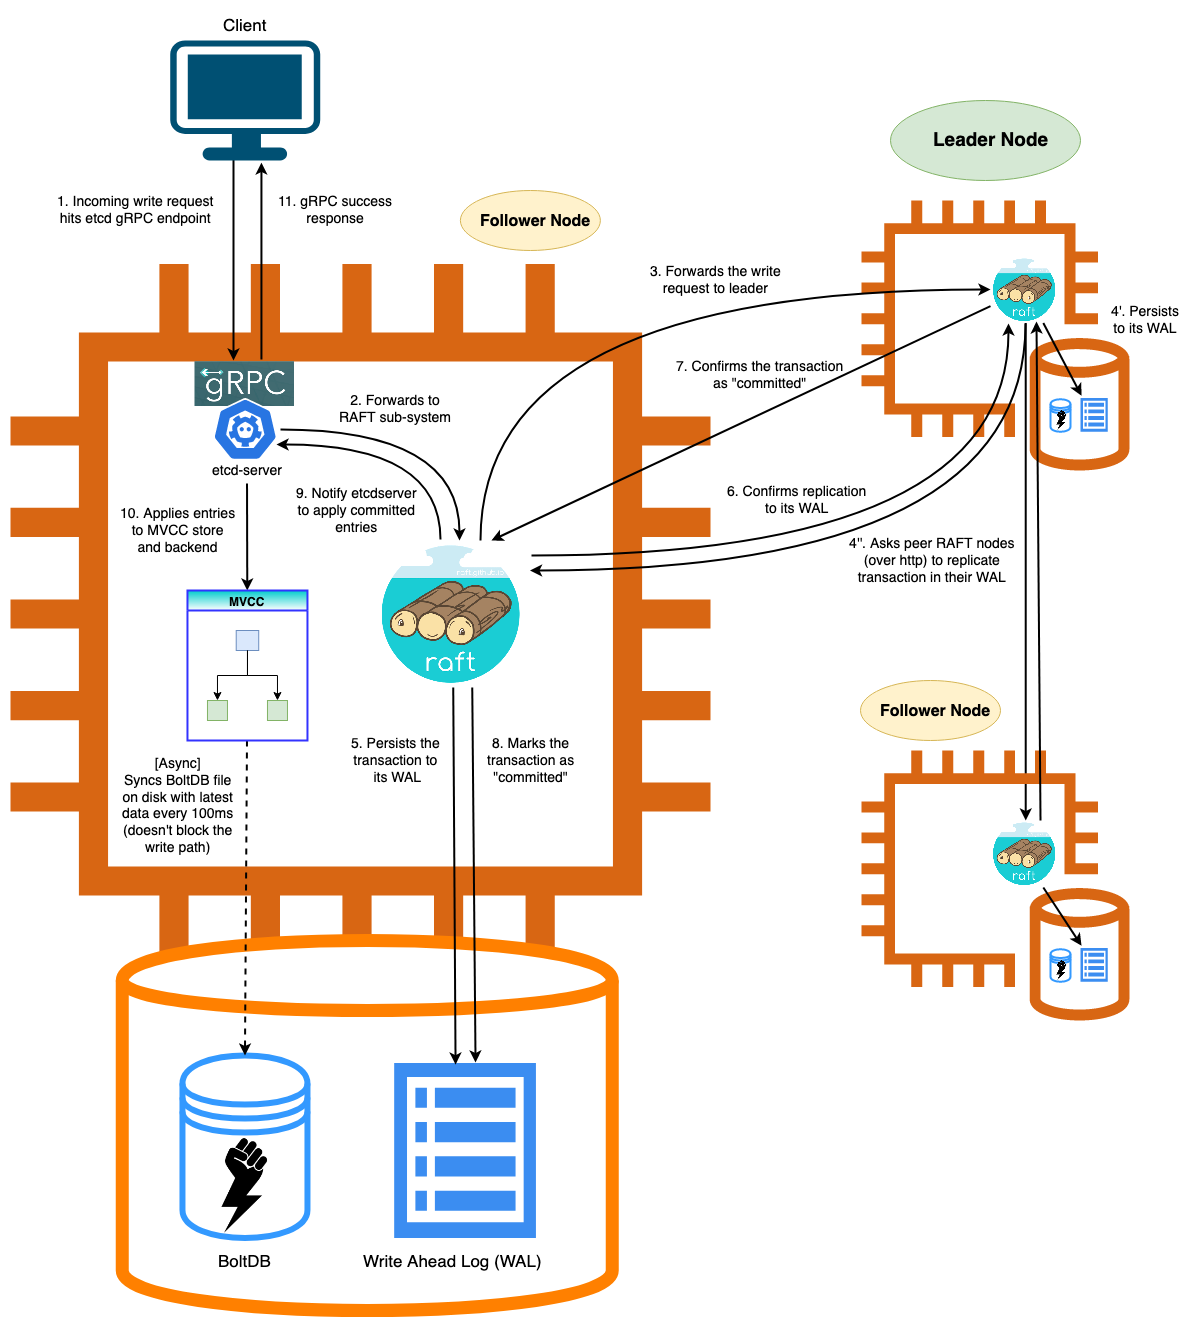
图:写请求先到达 Follower 的处理流程。来源:etcd write_workflow_follower.png,Apache-2.0。

- 接收请求:Follower 的 gRPC endpoint 收到写请求,原 gRPC handler 留在该成员等待结果。
- 提交 proposal:Follower 的 etcd server 将请求交给本地 Raft 模块。
- 转发写请求:Follower 的 Raft 模块将写请求转发给 Leader,客户端连接仍由原 Follower 处理。
-
Leader 持久化与复制:Leader 并行处理本地 WAL 和成员间复制。
4':Leader 将 proposal 写入本机 WAL。4'':Leader 向其他投票成员发送 Raft 日志复制消息。
-
原 Follower 写入 WAL:最初接收请求的 Follower 持久化这条日志。
- 原 Follower 返回确认:Follower 向 Leader 确认 WAL 写入完成。
- Leader 通知提交进度:Leader 取得 Quorum 后推进 commit index,并把新的提交位置发送给 Follower。
- Follower 标记 committed:原 Follower 更新本地 commit index。
- 通知状态机:Follower 的 Raft 模块将 committed entry 交给本地 etcd server。
- 更新键空间:本地 apply loop 更新 MVCC 和 Backend。
- 返回结果:原 Follower 完成本地 apply 后,通过最初的 gRPC 连接返回成功响应。
图中由原 Follower 的确认形成 Quorum;实际运行时,Leader 也可以先收到另一个 Follower 的确认。最初接收请求的 Follower 仍需追上 commit index 并完成本地 apply,才能向客户端返回。
读取流程¶
线性一致读可以发送到 Follower。Follower 通过 Leader 获取本次读取需要达到的 Raft 日志位置(ReadIndex),等本地日志应用进度达到该位置后,再从本地 MVCC 读取键值。
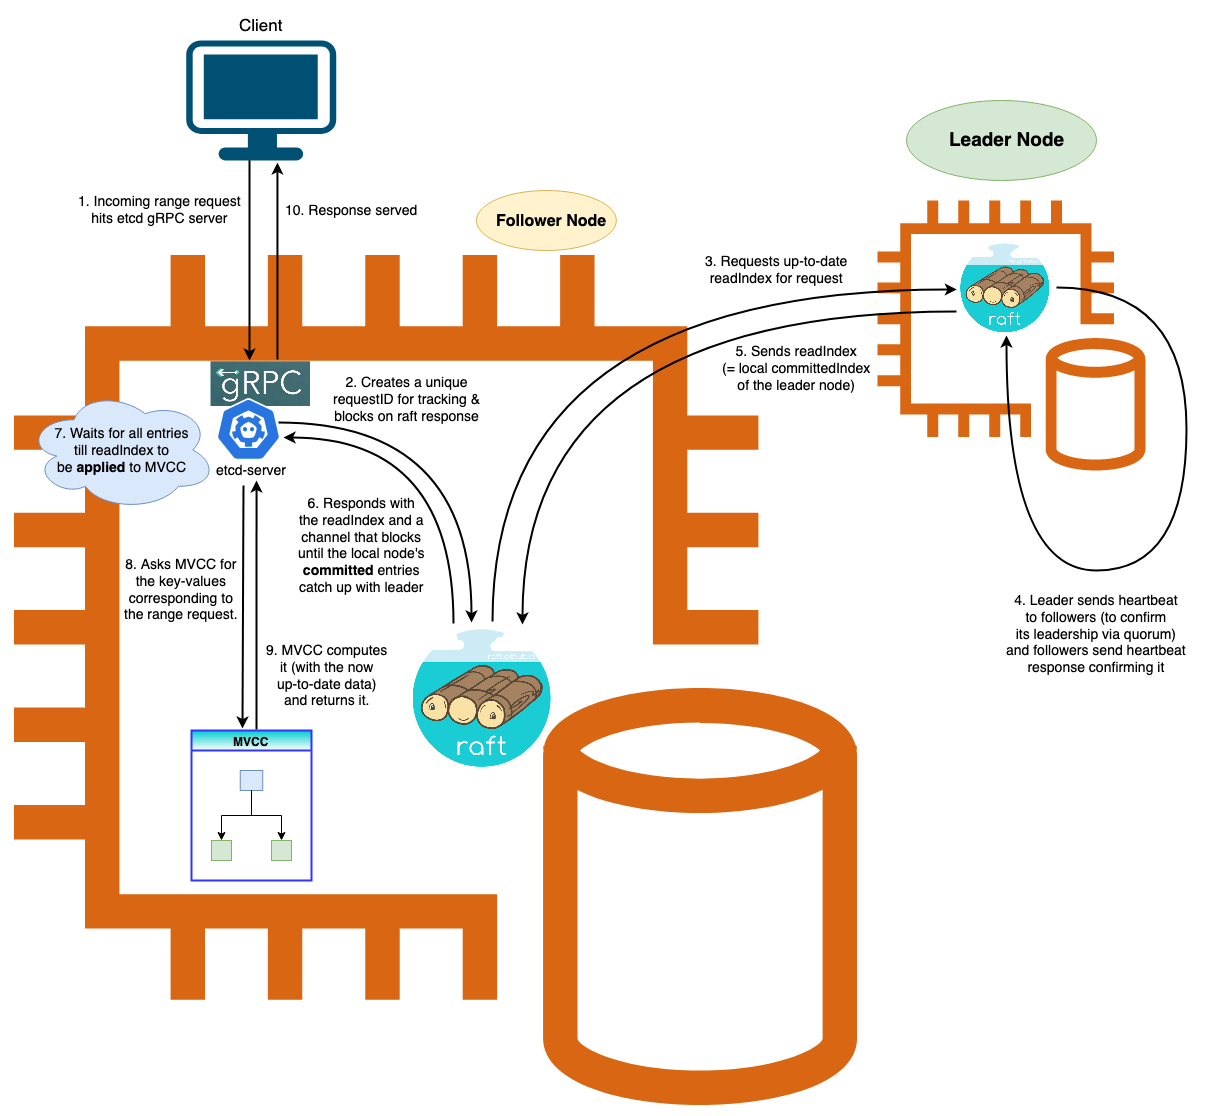
图:线性一致读到达 Follower 时的 ReadIndex 流程。来源:etcd consistent_read_workflow.png,Apache-2.0。

- 接收请求:Follower 的 gRPC endpoint 收到线性一致的
Range读请求,原 gRPC handler 留在该成员等待结果。 - 发起读取确认:Follower 的 etcd server 为 ReadIndex 请求生成唯一标识,将请求交给本地 Raft 模块,并等待确认结果。
- 请求 ReadIndex:Follower 的 Raft 模块将 ReadIndex 请求转发给 Leader。
- 确认 Leader 身份:Leader 先记录当前的 commit index,再向其他投票成员发送心跳,通过 Quorum 确认自己仍是有效 Leader。
- 返回 ReadIndex:Leader 将刚才记录的 commit index 作为 ReadIndex,返回给发起请求的 Follower。
- 通知本地 etcd server:Follower 的 Raft 模块将收到的 ReadIndex 交给本地 etcd server。
- 等待本地应用:etcd server 等待本地
appliedIndex >= ReadIndex,确保直到该位置的已提交日志都已应用到状态机。 - 读取键值:etcd server 按原始
Range请求指定的 key 或范围查询本地 MVCC。 - 返回查询结果:MVCC 完成查询,将匹配的键值返回给 etcd server。
- 响应客户端:Follower 通过最初的 gRPC 连接返回读取结果。
Watch 机制¶
etcd 的 Watch 机制 是 一种基于发布-订阅模式的事件监听机制。它允许客户端通过 gRPC 长连接实时监听指定 Key 或前缀的数据变化(如 PUT、DELETE 事件),并在数据发生变更时由服务端即时推送通知,是 Kubernetes 等分布式系统实现状态同步的核心基础。
Watch 示例¶
使用 etcdctl 向 hello 写入 world1,加上 --write-out=json 查看写入响应:
假设 hello 此前不存在,本例第一次写入的完整响应如下:
{
  "header": {
    "cluster_id": 17968645256435946676,
    "member_id": 17011376788719174056,
    "revision": 2,
    "raft_term": 2
  }
}
header 中包含四个字段:
cluster_id:etcd 集群的 ID。member_id:返回响应的 etcd 成员 ID。revision:这次写入对应的全局 revision。其他 key 的写入也会推进这个值。raft_term:响应成员当前的 Raft 任期。
这些数值以实际响应为准。后续 Watch 使用第一次写入返回的 revision,本例为 2。
再把 hello 更新为 world2:
如果中间没有其他写入,第二次写入返回的 revision 就是 3:
{
  "header": {
    "cluster_id": 17968645256435946676,
    "member_id": 17011376788719174056,
    "revision": 3,
    "raft_term": 2
  }
}
用第一次写入返回的 revision 开始监听,本例填入 --rev=2。JSON 中的 key 和 value 使用 Base64 编码,可以通过 jq 的 @base64d 解码:
etcdctl watch hello --rev=2 --write-out=json |
  jq '(.Events[]?.kv | .key, .value | strings) |= @base64d'
--rev=2 包含 revision 2 本身。虽然 hello 当前已经是 world2,Watch 仍会补发 world1 和 world2 两次写入的事件。经过 jq 解码,响应如下:
{
  "Header": {
    "cluster_id": 17968645256435946676,
    "member_id": 17011376788719174056,
    "revision": 3,
    "raft_term": 2
  },
  "Events": [
    {
      "kv": {
        "key": "hello",
        "create_revision": 2,
        "mod_revision": 2,
        "version": 1,
        "value": "world1"
      }
    },
    {
      "kv": {
        "key": "hello",
        "create_revision": 2,
        "mod_revision": 3,
        "version": 2,
        "value": "world2"
      }
    }
  ],
  "CompactRevision": 0,
  "Canceled": false,
  "Created": false,
  "CancelReason": ""
}
两条事件中的 mod_revision 分别为 2、3,对应这两次写入的全局 revision;version 则从 1 增至 2,记录 hello 在当前生命周期中的修改次数。
保持 Watch 命令运行,在另一个终端再次修改 hello:
原来的 Watch 会收到新的 PUT 事件,经 jq 解码后显示 value: "world3"。如果期间没有其他写入,这条事件的 mod_revision=4、version=3。
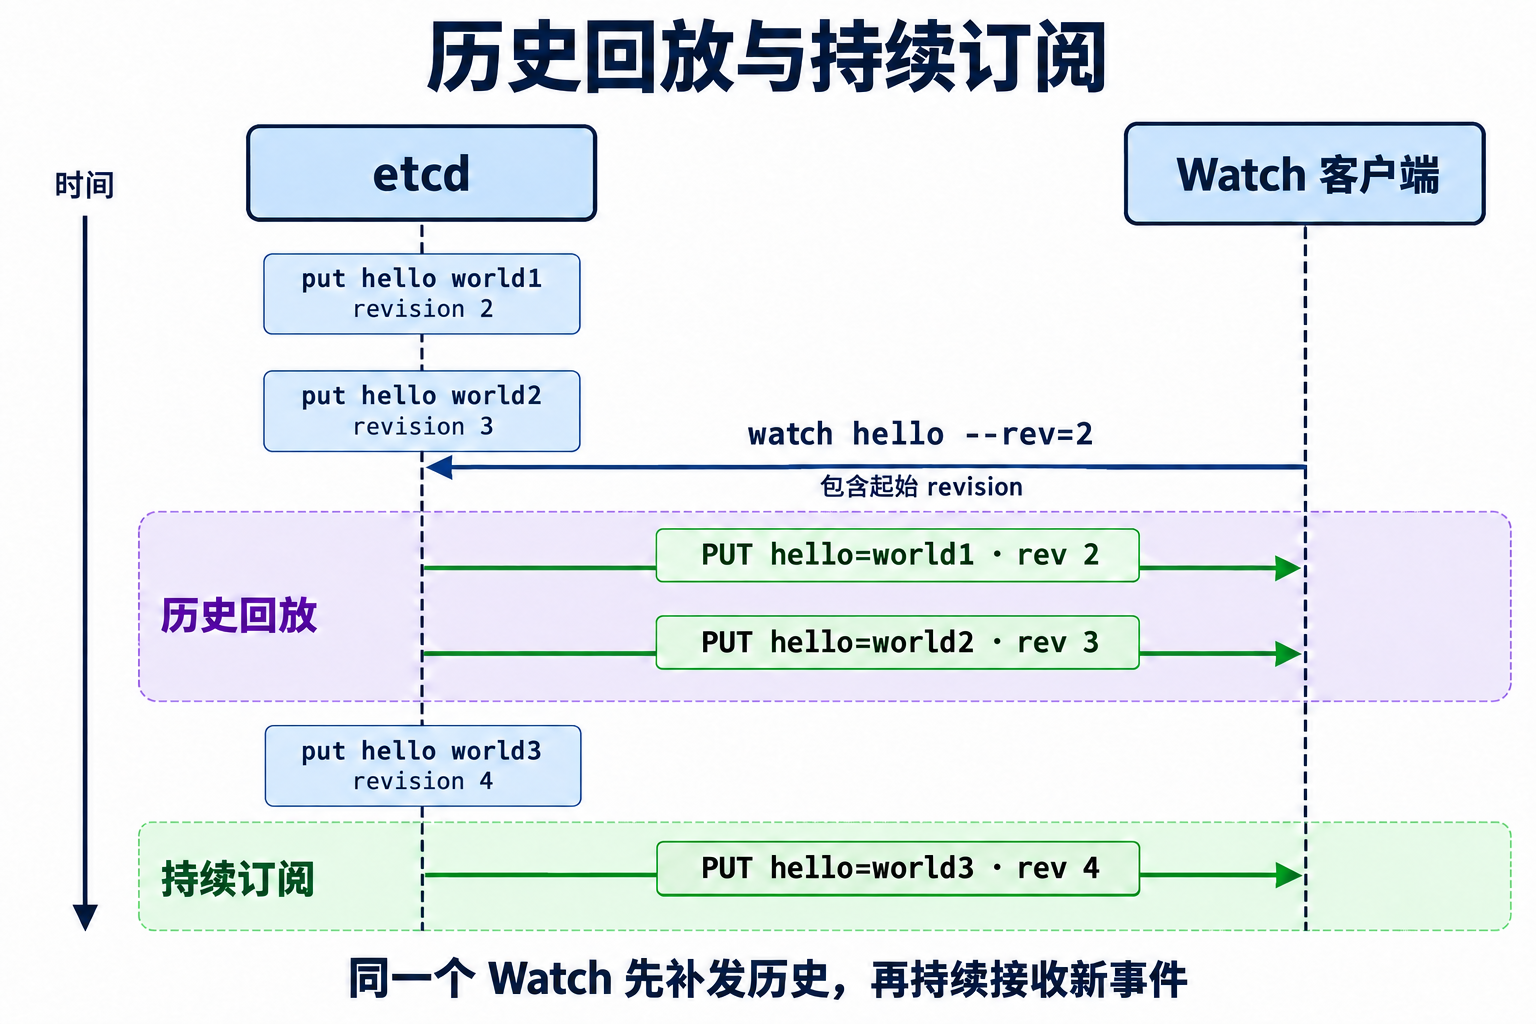
图:Watch 的历史事件回放与持续订阅。
核心源码¶
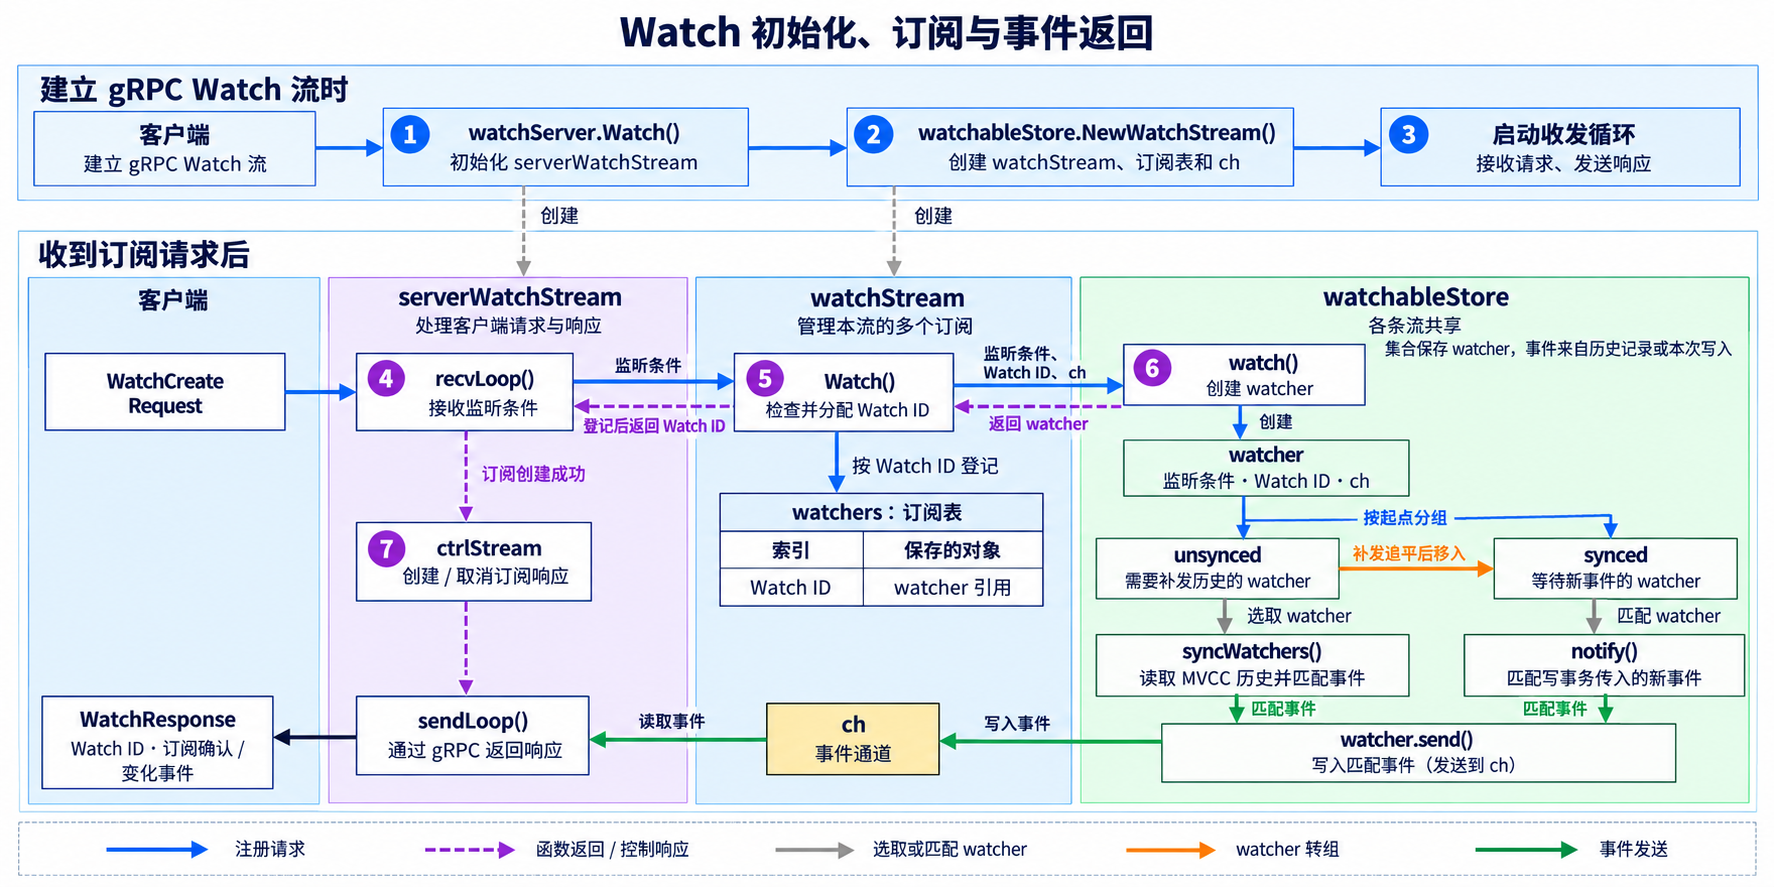
图:Watch 初始化、订阅与事件返回。
执行 etcdctl watch hello 时,客户端先打开一条 gRPC Watch 流,再在这条流上发送监听 hello 的订阅请求。建流和注册订阅属于同一次 gRPC Watch 调用,后续响应也通过这条流返回。
-
建立 gRPC Watch 流
- 保存流并准备控制通道:
watchServer.Watch()为每条流创建独立的serverWatchStream,将客户端流保存在gRPCStream,并创建ctrlStream,用于传递创建、取消订阅等控制响应。 - 准备订阅表和事件通道:调用
watchableStore.NewWatchStream()创建watchStream。它是服务端内部管理订阅的对象,包含按 Watch ID 保存订阅的watchers表和事件通道ch;创建时订阅表为空。 - 启动收发循环:
recvLoop()接收流上的客户端请求,sendLoop()向客户端发送响应。这些初始化操作每条流执行一次。
- 保存流并准备控制通道:
-
注册订阅
- 接收监听条件:客户端在流上发送
WatchRequest,其中的WatchCreateRequest指定监听的键范围和起始 revision。recvLoop()将这些条件交给watchStream.Watch()。 - 分配 Watch ID:
watchStream.Watch()检查并按需分配 ID,将监听条件、Watch ID 和本流的ch传给watchableStore.watch()。 - 创建并登记订阅:
watchableStore.watch()创建watcher,需要补发历史的加入unsynced,可以直接等待新事件的加入synced。返回后,watchStream.Watch()将其按 Watch ID 登记到watchers表。 - 返回订阅确认:注册成功后,
recvLoop()将包含 Watch ID 和Created=true的确认响应写入ctrlStream,由sendLoop()发回客户端。
一条流可以多次注册订阅,每份订阅对应一个
watcher,由 Watch ID 区分。各条流共享watchableStore;其中的unsynced和synced保存的是订阅对象,不是事件。多个客户端与 Watch 订阅
普通的
etcdctl watch hello只创建一份订阅。使用交互模式,可以在同一条流上创建多份订阅:启动后依次输入两行
watch,分别创建监听hello和world的订阅。如果另一个客户端执行etcdctl watch foo,服务端的结构如下:客户端 A:etcdctl watch -i └── gRPC Watch 流 A └── serverWatchStream A └── watchStream A └── watchers ├── Watch ID 0 → watcher:监听 hello └── Watch ID 1 → watcher:监听 world 客户端 B:etcdctl watch foo └── gRPC Watch 流 B └── serverWatchStream B └── watchStream B └── watchers └── Watch ID 0 → watcher:监听 foo每条流都有独立的订阅表,Watch ID 只需在所属流内唯一,因此不同流可以使用相同的 ID。 交互模式源码展示了同一客户端连续创建订阅的过程。
- 接收监听条件:客户端在流上发送
-
发送事件
- 匹配事件:
syncWatchers()从unsynced中选取订阅,读取 MVCC 历史记录并匹配事件;notify()接收写事务生成的新事件,从synced中查找匹配的订阅。 - 写入事件通道:
watcher.send()将包含匹配事件的响应写入所属流的ch。同一条流上的订阅共用这个通道。 - 发回客户端:
sendLoop()从ch读取响应,组装为 gRPC 响应后发给客户端。客户端根据 Watch ID 判断事件属于哪份订阅。
历史补发追平后,同一个
watcher从unsynced移入synced,后续由notify()为它匹配新事件。 - 匹配事件:
涉及的源码文件如下:
server/
├── etcdserver/api/v3rpc/
│   └── watch.go                  # 接收 Watch 请求,通过 gRPC Stream 返回响应
└── storage/mvcc/
    ├── watcher.go                # 管理同一条流中的 Watcher、Watch ID 和事件通道
    ├── watchable_store.go        # 注册订阅,分发新事件,补发历史并重试积压事件
    ├── watchable_store_txn.go    # 将本次写事务的变更转换为 PUT、DELETE 事件
    ├── watcher_group.go          # 索引单 key 和范围订阅,按 Watcher 聚合事件
    └── kvstore_txn.go            # 执行键值修改,记录事务内的 changes
订阅注册¶
流初始化
客户端建立 gRPC Watch 流后,服务端保存这条流,创建空的订阅表 watchers 和响应通道,再启动收发循环。watchers 按 Watch ID 保存这条流上的 watcher 对象,每个 watcher 代表一份订阅;收到创建订阅请求后,才会向表中添加记录。 watchServer.Watch() 初始化 serverWatchStream,其中三个主要字段分别承担以下职责:
gRPCStream:与客户端收发消息。 保存传入的stream。recvLoop()通过它的Recv()接收请求,sendLoop()通过它的Send()将订阅确认和变化事件发回客户端。watchStream:管理这条流上的订阅和事件通道。watchServer.Watch()调用ws.watchable.NewWatchStream()创建它,其中包含订阅表watchers和事件通道ch。watchers按 Watch ID 保存watcher对象;订阅匹配到的PUT、DELETE等事件写入ch,由sendLoop()读取并发送给客户端。ctrlStream:传递创建、取消订阅等控制响应。 这是服务端内部的 Go 通道。例如,订阅创建成功后,recvLoop()将包含 Watch ID 和Created=true的确认响应写入其中,sendLoop()取出后通过gRPCStream.Send()发给客户端。
ch 传递键值变化,ctrlStream 传递订阅控制响应,两者都由 sendLoop() 通过同一条 gRPC 流发送。
这三个字段的赋值和收发循环的启动代码如下:
func (ws *watchServer) Watch(stream pb.Watch_WatchServer) (err error) {
    sws := serverWatchStream{
        ...
        // 保存客户端流,供接收请求和发送响应使用。
        gRPCStream: stream,
        // 创建该流的 MVCC 订阅管理对象。
        watchStream: ws.watchable.NewWatchStream(),
        // 暂存创建和主动取消订阅的响应。
        ctrlStream: make(chan *pb.WatchResponse, ctrlStreamBufLen),
        ...
    }

    // 启动发送循环,从内部通道取出响应并通过 gRPC 发送。
    sws.wg.Add(1)
    go func() {
        sws.sendLoop()
        sws.wg.Done()
    }()

    // 启动接收循环,处理客户端请求。
    errc := make(chan error, 1)
    go func() {
        if rerr := sws.recvLoop(); rerr != nil {
            ...
            errc <- rerr
        }
    }()

    ...
    return err
}
watchableStore.NewWatchStream() 创建流对象时,watchers 还是空 map;客户端后续发送创建订阅请求时,才会创建 watcher 并登记到表中:
func (s *watchableStore) NewWatchStream() WatchStream {
    watchStreamGauge.Inc()
    return &watchStream{
        watchable: s,
        // 创建本流各份订阅共用的事件通道。
        ch:      make(chan WatchResponse, chanBufLen),
        cancels: make(map[WatchID]cancelFunc),
        // 创建空订阅表:Watch ID 对应一个 *watcher。
        watchers: make(map[WatchID]*watcher),
    }
}
watchers:订阅表。 类型为map[WatchID]*watcher。每个watcher保存一份订阅的键范围、起始 revision、事件通道等信息;注册订阅后,通过watchers[id] = w将它登记到本流的表中。例如,Watch ID 为1的订阅监听hello,watchers[1]就指向保存这份监听条件的watcher。ch:带缓冲的事件通道。这条流上的各份订阅都把匹配的事件写入这里,交给sendLoop()发送。cancels:以 Watch ID 保存取消函数。取消订阅时调用对应函数;流关闭时逐一清理订阅,再关闭ch。watchable:指向各条流共享的watchableStore,后续通过它创建订阅、匹配和分发事件。
完成 serverWatchStream 和 watchStream 的初始化后,watchServer.Watch() 启动 recvLoop() 接收客户端请求,启动 sendLoop() 发送响应。
订阅注册与分组
执行 etcdctl watch hello --rev=2 时,etcdctl 通过客户端 Watch 实现依次完成两个动作:
- 建立 Watch 流:调用 Watch RPC,建立持续收发消息的 gRPC 双向流。服务端进入
watchServer.Watch(),完成上文的流初始化。 - 发送订阅请求:通过这条流发送包含
WatchCreateRequest的请求,告诉服务端“监听hello,从全局 revision2开始接收变化”。服务端的recvLoop()接收请求,将监听条件交给watchStream.Watch()注册订阅。
WatchCreateRequest 是通过 Protocol Buffers(Protobuf)定义的订阅请求消息,用于指定监听哪些键、从哪个 revision 开始。生成的 Go 结构体包含以下字段:
type WatchCreateRequest struct {
    ...

    // 协议字段 key:监听的单个键,或范围起点。
    Key []byte `protobuf:"bytes,1,opt,name=key,proto3" json:"key,omitempty"`

    // 协议字段 range_end:范围终点。
    RangeEnd []byte `protobuf:"bytes,2,opt,name=range_end,json=rangeEnd,proto3" json:"range_end,omitempty"`

    // 协议字段 start_revision:接收事件的起始全局 revision。
    StartRevision int64 `protobuf:"varint,3,opt,name=start_revision,json=startRevision,proto3" json:"start_revision,omitempty"`

    ...
}
以 etcdctl watch hello --rev=2 为例,这三个字段分别表示:
key(Key):监听的键或范围起点。本例为hello,对应Key = []byte("hello")。range_end(RangeEnd):范围终点。本例为空,只监听hello;指定普通结束键时,按字节字典序监听[key, range_end),包含起点、不含终点。start_revision(StartRevision):接收事件的起始全局 revision,包含该版本。本例--rev=2对应StartRevision = 2,先补发仍保留的匹配历史事件,再接收新变化。省略--rev时值为0,从服务端注册订阅时的当前 revision 之后开始监听。
前缀订阅的范围
要监听所有以 hello 开头的键,可以使用 --prefix:
客户端将前缀转换为 key="hello"、range_end="hellp",服务端按 [hello, hellp) 范围匹配。按字节字典序,hello、hello/a、hello1 都落在这个范围内,hellp 本身被排除。这里的终点由客户端把末尾的 o 增加为下一个字节 p 得到,转换逻辑见 WithPrefix() 与 GetPrefixRangeEnd()。
recvLoop() 将请求中的创建订阅部分保存为 creq,再把这三个字段和事件过滤选项传给当前流的 watchStream.Watch()。这个调用返回 Watch ID,供后续响应标识订阅:
func (sws *serverWatchStream) recvLoop() error {
    for {
        // 等待客户端的下一条 WatchRequest;收到后返回已解码的请求对象。
        req, err := sws.gRPCStream.Recv()
        ...

        switch uv := req.RequestUnion.(type) {
        case *pb.WatchRequest_CreateRequest:
            ...
            // 取出创建请求中的键范围、起始 revision 等条件。
            creq := uv.CreateRequest
            ...

            // 将客户端的事件过滤选项转换为过滤函数。
            filters := FiltersFromRequest(creq)
            ...

            // 在本流的 watchStream 上注册订阅,取得 Watch ID 或注册错误。
            id, err := sws.watchStream.Watch(
                ctx,
                mvcc.WatchID(creq.WatchId), // 客户端指定的 ID,也可以请求自动分配。
                creq.Key,                 // 监听的单个键,或范围起点。
                creq.RangeEnd,            // 范围终点;单键订阅在这里为 nil。
                creq.StartRevision,       // 接收事件的起始 revision,包含该版本。
                filters...,
            )
            ...

        ...
        }
    }
}
服务端用 watcher 保存一份订阅的监听条件、Watch ID 和事件通道。watchStream.Watch() 先检查范围和 Watch ID,按需分配 ID,再把条件及本流的 ch 传给 watchableStore.watch()。创建完成后,它将返回的订阅对象登记到 watchers 表:
func (ws *watchStream) Watch(
    ctx context.Context,
    id WatchID,
    key, end []byte,
    startRev int64,
    fcs ...FilterFunc,
) (WatchID, error) {
    ...

    // 自动分配时,跳过本流订阅表中已经占用的 ID。
    if id == clientv3.AutoWatchID {
        for ws.watchers[ws.nextID] != nil {
            ws.nextID++
        }
        id = ws.nextID
        ws.nextID++
    } else if _, ok := ws.watchers[id]; ok {
        // 客户端指定的 ID 也不能与本流的已有订阅重复。
        return -1, ErrWatcherDuplicateID
    }

    // 创建 watcher 并按起点分组;ws.ch 是本流各订阅共用的事件通道。
    // 返回的 w 是 *watcher,c 是用于移除这份订阅的取消函数。
    w, c := ws.watchable.watch(key, end, startRev, id, ws.ch, fcs...)

    ...
    // 按 Watch ID 保存取消入口,供主动取消或关闭流时清理订阅。
    ws.cancels[id] = func() {
        ...
        c()
    }
    // 将新建的 watcher 登记到本流的订阅表。
    ws.watchers[id] = w
    return id, nil
}
watchableStore.watch() 创建 watcher,保存监听条件、Watch ID 和所属流的事件通道 ch。需要补发历史的订阅加入 unsynced,等待新事件的订阅加入 synced。
func (s *watchableStore) watch(
    key, end []byte,
    startRev int64,
    id WatchID,
    ch chan<- WatchResponse,
    fcs ...FilterFunc,
) (*watcher, cancelFunc) {
    wa := &watcher{
        key:      key,
        end:      end,
        startRev: startRev,
        minRev:   startRev,
        id:       id,
        // 保存所属流的事件通道,后续匹配事件通过它返回。
        ch:       ch,
        fcs:      fcs,
    }

    ...

    // 返回订阅对象和取消函数。
    return wa, func() { s.cancelWatcher(wa) }
}
返回的 wa 就是调用方接到的 w,随后通过 watchers[id] = w 登记到本流的订阅表中。
订阅确认
完成订阅登记后,recvLoop() 将订阅确认写入 ctrlStream,sendLoop() 从中取出确认,再通过 gRPC 发给客户端。
recvLoop() 创建响应 wr,填入 WatchId、Created 等字段,再通过 case sws.ctrlStream <- wr: 将这份确认写入 ctrlStream:
func (sws *serverWatchStream) recvLoop() error {
    for {
        ...
        switch uv := req.RequestUnion.(type) {
        case *pb.WatchRequest_CreateRequest:
            ...
            if err == nil {
                ...
            } else {
                // 注册失败时,响应使用无效 ID。
                id = clientv3.InvalidWatchID
            }

            // 把注册结果组织成客户端可以接收的 WatchResponse。
            wr := &pb.WatchResponse{
                Header:   sws.newResponseHeader(sws.watchStream.Rev()),
                WatchId:  int64(id),
                Created:  true,       // 标识这是创建请求的响应,失败时也为 true。
                Canceled: err != nil, // 注册失败时为 true;成功时为 false。
            }
            if err != nil {
                // 将失败原因一起返回,供客户端判断。
                wr.CancelReason = err.Error()
            }
            select {
            // 将确认响应交给内部通道,等待 sendLoop() 发送。
            case sws.ctrlStream <- wr:
            // 流已关闭时退出,避免继续等待通道接收。
            case <-sws.closec:
                return nil
            }

        ...
        }
    }
}
sendLoop() 通过 case c, ok := <-sws.ctrlStream: 取出确认响应,再调用 sws.gRPCStream.Send(c) 发给客户端。这里的 c 就是前面写入通道的 wr,两者指向同一个 WatchResponse 对象。
func (sws *serverWatchStream) sendLoop() {
    ...
    for {
        select {
        ...
        // 取出 recvLoop() 写入的控制响应。
        case c, ok := <-sws.ctrlStream:
            if !ok {
                return
            }
            ...
            // 通过客户端的 gRPC Watch 流发送响应。
            if err := sws.gRPCStream.Send(c); err != nil {
                ...
                return
            }
            ...
        ...
        }
    }
}
事件通知¶
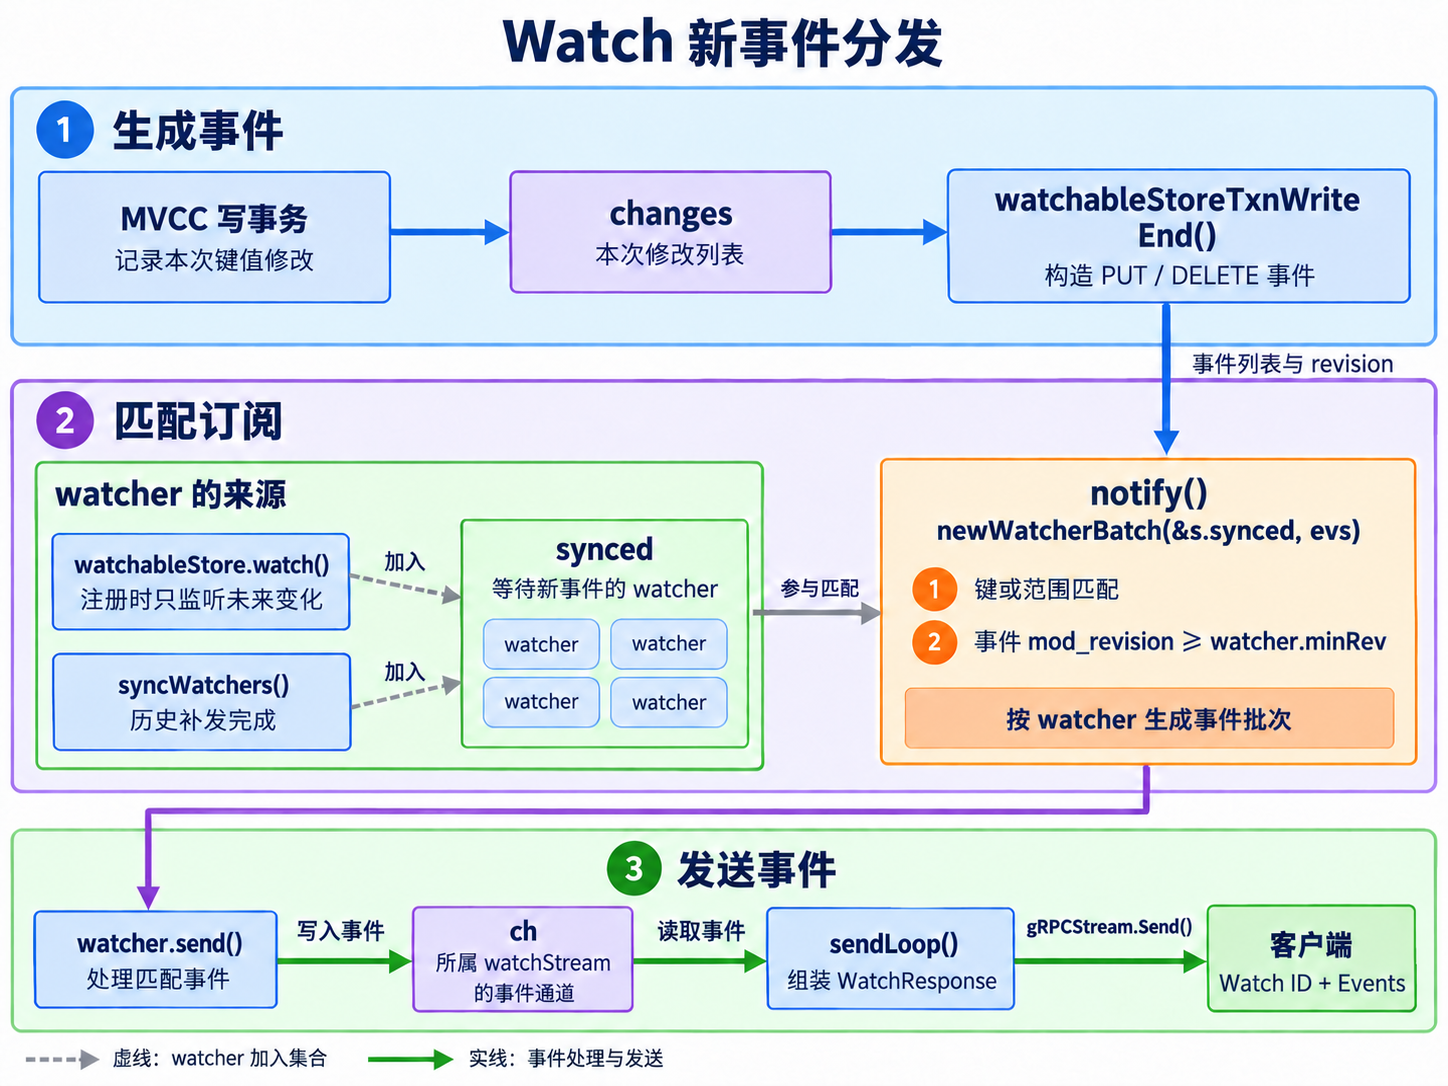
图:Watch 事件的生成与发送。
synced 中的 watcher 通过以下路径接收新事件:
- 生成事件:每次写入修改数据后,
End()将修改记录转换为PUT或DELETE事件,并交给notify()。事件携带本次修改的版本号,例如 revision6。 - 匹配订阅:
notify()在synced集合中查找等待新事件的订阅,检查两件事:修改的 key 是否在监听范围内,以及事件版本是否达到订阅要求的起点。 例如,订阅监听hello,最低接收版本minRev=5,那么hello在 revision6的修改就符合条件。匹配到的事件会按订阅整理成批次。 - 发送事件:
watcher.send()将包含事件和 Watch ID 的响应写入所属流的通道ch。sendLoop()从通道取出响应,组装为 gRPC 响应后发给客户端;Watch ID 用于区分事件属于哪份订阅。
事件生成
MVCC 执行写事务时,会将键值修改保存在 changes 中。事务结束时,watchableStoreTxnWrite.End() 为这些记录添加 PUT 或 DELETE 类型,生成事件列表 evs,再交给 notify() 匹配订阅。
代码中的三个变量分别是:
changes:本次事务的修改记录,保存修改了哪个 key、写入了什么值等信息。rev:本次修改的全局版本号,等于事务开始时的 revision 加1。同一事务中的修改共用这个版本号。evs:转换后的 Watch 事件列表,每条事件包含类型Type和键值记录Kv。
例如,当前全局 revision 为 3,一个事务执行两项修改:将 hello 更新为 world2,并删除 foo。本次修改的 revision 为 4,hello 的创建版本仍为 2。
进入 End() 时,修改记录如下。这里只展示关键字段:
changes = [
    {Key: "hello", Value: "world2", CreateRevision: 2, ModRevision: 4},
    {Key: "foo",   CreateRevision: 0, ModRevision: 0}
]
End() 根据记录中的 CreateRevision 判断事件类型:
- 非零:表示创建或更新,生成
PUT事件。 - 为零:表示删除,生成
DELETE事件,并将ModRevision补为本次版本号4。删除记录只保存 key,这里的零值不代表foo原来的创建版本。
转换后的事件如下:
evs = [
    {
        Type: PUT,
        Kv: {Key: "hello", Value: "world2", CreateRevision: 2, ModRevision: 4}
    },
    {
        Type: DELETE,
        Kv: {Key: "foo", CreateRevision: 0, ModRevision: 4}
    }
]
最后调用 notify(4, evs),其中 4 是本次修改的版本号,evs 是上面的两条事件。notify() 在 synced 中查找监听 hello、foo 或包含它们的键范围的订阅,并检查版本 4 是否达到订阅的最低接收版本 minRev。例如,监听 hello 且 minRev=4 的订阅会匹配到这条 PUT 事件,再由对应的 watcher.send() 尝试写入事件通道 ch。
对应的事件构造代码如下:
func (tw *watchableStoreTxnWrite) End() {
    // 本次事务的修改记录,包含 key、value 和版本信息。
    changes := tw.Changes()
    if len(changes) == 0 {
        // 没有修改,直接结束底层事务,无需生成 Watch 事件。
        tw.TxnWrite.End()
        return
    }

    // 本次修改使用事务开始时的 revision + 1。
    rev := tw.Rev() + 1
    evs := make([]*mvccpb.Event, len(changes))
    for i, change := range changes {
        // 将这条修改的键值记录放入事件,再确定事件类型。
        evs[i] = &mvccpb.Event{Kv: changes[i]}
        if change.CreateRevision == 0 {
            // 删除记录只保存 key,CreateRevision 保持零值。
            evs[i].Type = mvccpb.Event_DELETE
            // 为删除事件补上本次修改的 revision。
            evs[i].Kv.ModRevision = rev
        } else {
            // 创建和更新都使用 PUT,记录中已包含修改后的值和 revision。
            evs[i].Type = mvccpb.Event_PUT
        }
    }

    // 在同一把锁内完成事件通知和底层事务收尾。
    tw.s.mu.Lock()
    // 匹配订阅,并尝试将事件写入对应流的事件通道。
    tw.s.notify(rev, evs)
    // 结束底层写事务:更新存储的 currentRev,并释放事务锁。
    tw.TxnWrite.End()
    tw.s.mu.Unlock()
}
订阅匹配
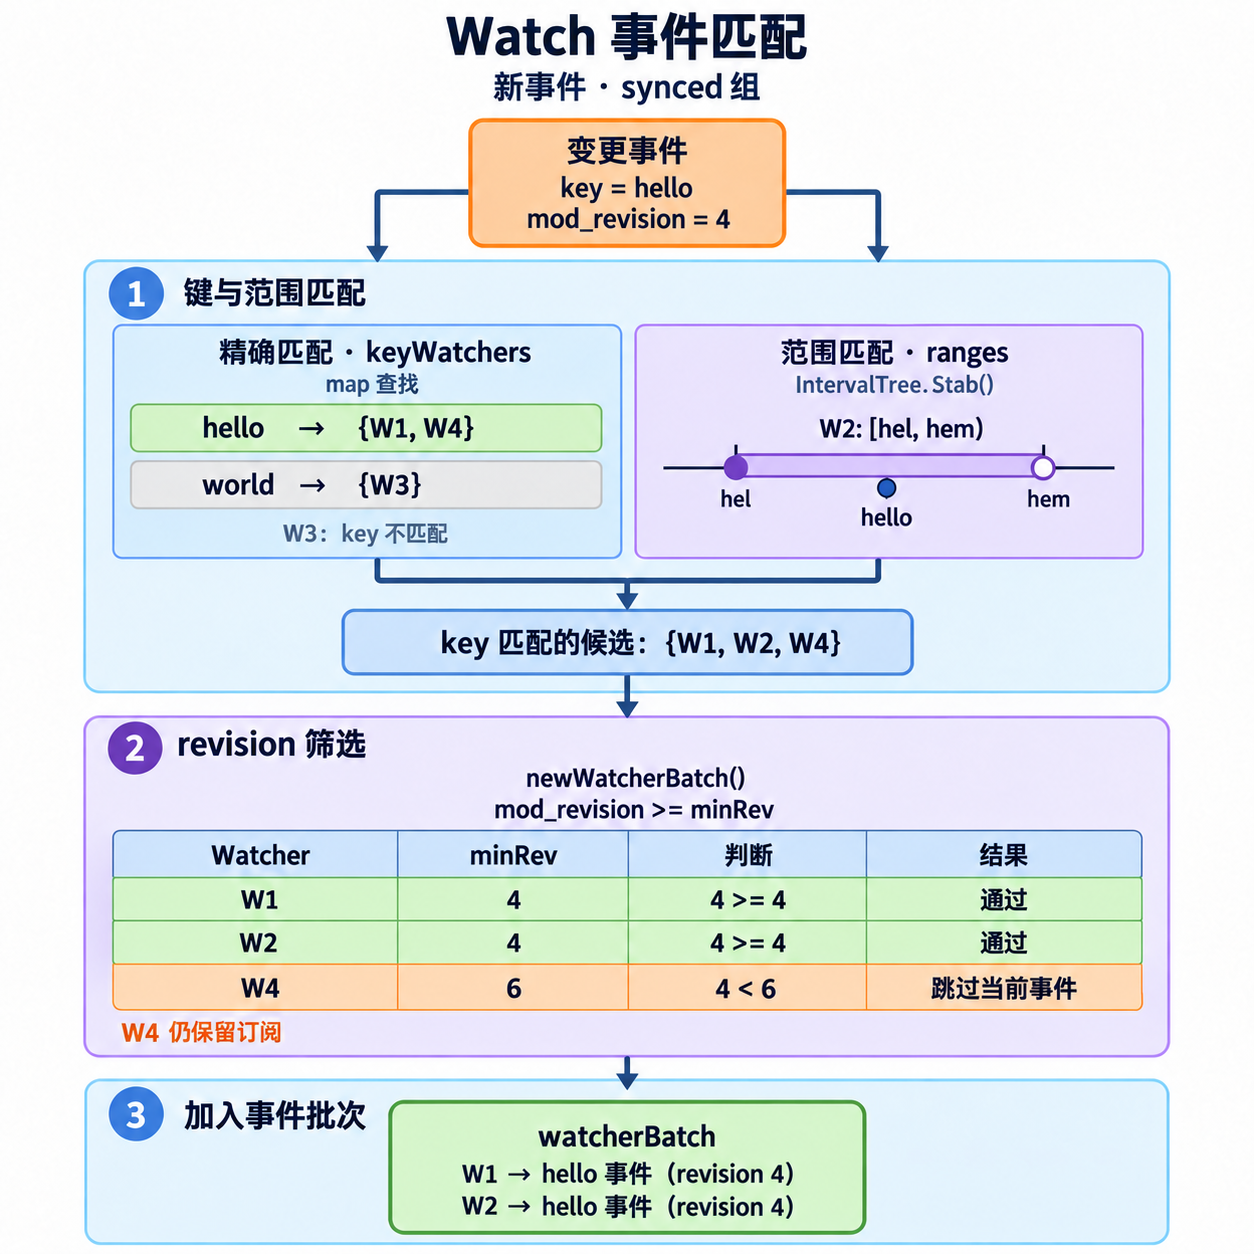
图:Watch 的键匹配与 revision 筛选。
事件需要同时满足监听范围和最低 revision,才会加入对应 watcher 的事件批次。图中 hello 在 revision 4 发生变化,synced 组中的订阅依次经过以下检查:
- 匹配键或范围:对于
hello的事件,找出监听hello或包含它的键范围的watcher,得到候选集合{W1, W2, W4}。W3 只监听world,因此不匹配。 - 检查事件版本:
minRev表示该watcher接下来接收事件的最低版本。当前事件发生在 revision4,W1、W2 的minRev=4,因此匹配;W4 的minRev=6,会跳过当前事件,继续等待版本6或之后的匹配事件。 - 加入事件批次:
watcherBatch为 W1、W2 分别记录这条事件,供后续发送。
notify() 将订阅集合 &s.synced 和事件列表 evs 传给 newWatcherBatch(),分别对应参数 wg 和 evs。
函数对每条事件进行两步检查:watcherSetByKey() 找出监听该 key 或包含它的键范围的 watcher,再检查事件版本是否达到订阅的最低接收版本 minRev。
符合条件的事件通过 wb.add() 加入对应 watcher 的批次,供 notify() 后续发送:
func newWatcherBatch(wg *watcherGroup, evs []*mvccpb.Event) watcherBatch {
    if len(wg.watchers) == 0 {
        return nil
    }

    wb := make(watcherBatch)
    for _, ev := range evs {
        // 先按事件 key 查找单键订阅和范围订阅。
        for w := range wg.watcherSetByKey(string(ev.Kv.Key)) {
            // 再检查该事件是否达到这份订阅的最低 revision。
            if ev.Kv.ModRevision >= w.minRev {
                // 两项检查都通过后,加入该 watcher 的事件批次。
                wb.add(w, &mvccpb.Event{
                    Type:   ev.Type,
                    Kv:     ev.Kv,
                    PrevKv: ev.PrevKv,
                })
            }
        }
    }
    return wb
}
历史回放也使用 newWatcherBatch() 为各个 watcher 分配事件。
事件发送
notify() 遍历匹配结果,将 Watch ID、事件批次和本次 revision 组成 MVCC WatchResponse,交给 watcher.send()。如果通道已满,watcher.send() 返回 false,由 notify() 保存批次供后续重试:
func (s *watchableStore) notify(rev int64, evs []*mvccpb.Event) {
    victim := make(watcherBatch)
    // 只匹配 synced 中的 watcher,并按 watcher 分配事件批次。
    for w, eb := range newWatcherBatch(&s.synced, evs) {
        ...
        // 过滤事件,并尝试将响应写入这个 watcher 所属流的 ch。
        if w.send(WatchResponse{WatchID: w.id, Events: eb.evs, Revision: rev}) {
            ...
        } else {
            // 通道已满,保存未发送批次,并暂时停止匹配新事件。
            w.victim = true
            victim[w] = eb
            s.synced.delete(w)
            ...
        }
        // 更新后续匹配的最低 revision;未发送的批次已另行保存。
        w.minRev = rev + 1
    }
    // 将未发送批次交给重试流程。
    s.addVictim(victim)
}
watcher.send() 先应用事件过滤条件,再通过 case w.ch <- wr: 将响应写入事件通道。w.ch 是注册订阅时传入的通道,与所属流的 watchStream.ch 是同一条通道。带 default 的 select 在通道已满时立即返回 false,避免阻塞写事务:
func (w *watcher) send(wr WatchResponse) bool {
    // 记录过滤前是否为空,以保留进度通知等空事件响应。
    progressEvent := len(wr.Events) == 0

    ...

    // 原本有事件、但全部被过滤时,无需写入通道。
    if !progressEvent && len(wr.Events) == 0 {
        return true
    }
    select {
    case w.ch <- wr:
        // 响应已进入事件通道,等待 sendLoop() 读取。
        return true
    default:
        // 通道已满,交给调用方保留未发送的事件批次并安排重试。
        return false
    }
}
sendLoop() 的 select 分别读取两个通道:
watchStream.Chan():返回事件通道ch;取出的 MVCC 响应需要转换成 gRPC 响应。ctrlStream:传递recvLoop()已构造好的订阅确认,可直接通过 gRPC 发送。
func (sws *serverWatchStream) sendLoop() {
    ...
    for {
        select {
        // 接收变化事件:Chan() 返回本流的事件通道 ch。
        case wresp, ok := <-sws.watchStream.Chan():
            if !ok {
                return
            }
            ...

            // 将 MVCC 响应转换成通过 gRPC 返回的响应。
            canceled := wresp.CompactRevision != 0
            wr := &pb.WatchResponse{
                Header:          sws.newResponseHeader(wresp.Revision),
                WatchId:         int64(wresp.WatchID),
                Events:          events,
                CompactRevision: wresp.CompactRevision,
                Canceled:        canceled,
            }

            ...
            var serr error
            if !fragmented && !ok {
                // 普通响应直接通过 gRPC 发送。
                serr = sws.gRPCStream.Send(wr)
            } else {
                ...
            }
            if serr != nil {
                ...
                return
            }
            ...

        // 接收订阅确认:c 就是 recvLoop() 写入 ctrlStream 的 wr。
        case c, ok := <-sws.ctrlStream:
            if !ok {
                return
            }
            ...
            // c 已经是 gRPC 响应,直接通过同一条流发送。
            if err := sws.gRPCStream.Send(c); err != nil {
                ...
                return
            }
            ...
        ...
        }
    }
}
事件写入 ch 后,由 sendLoop() 通过 gRPC 发送;入队成功不代表客户端已经收到或处理。
历史回放¶
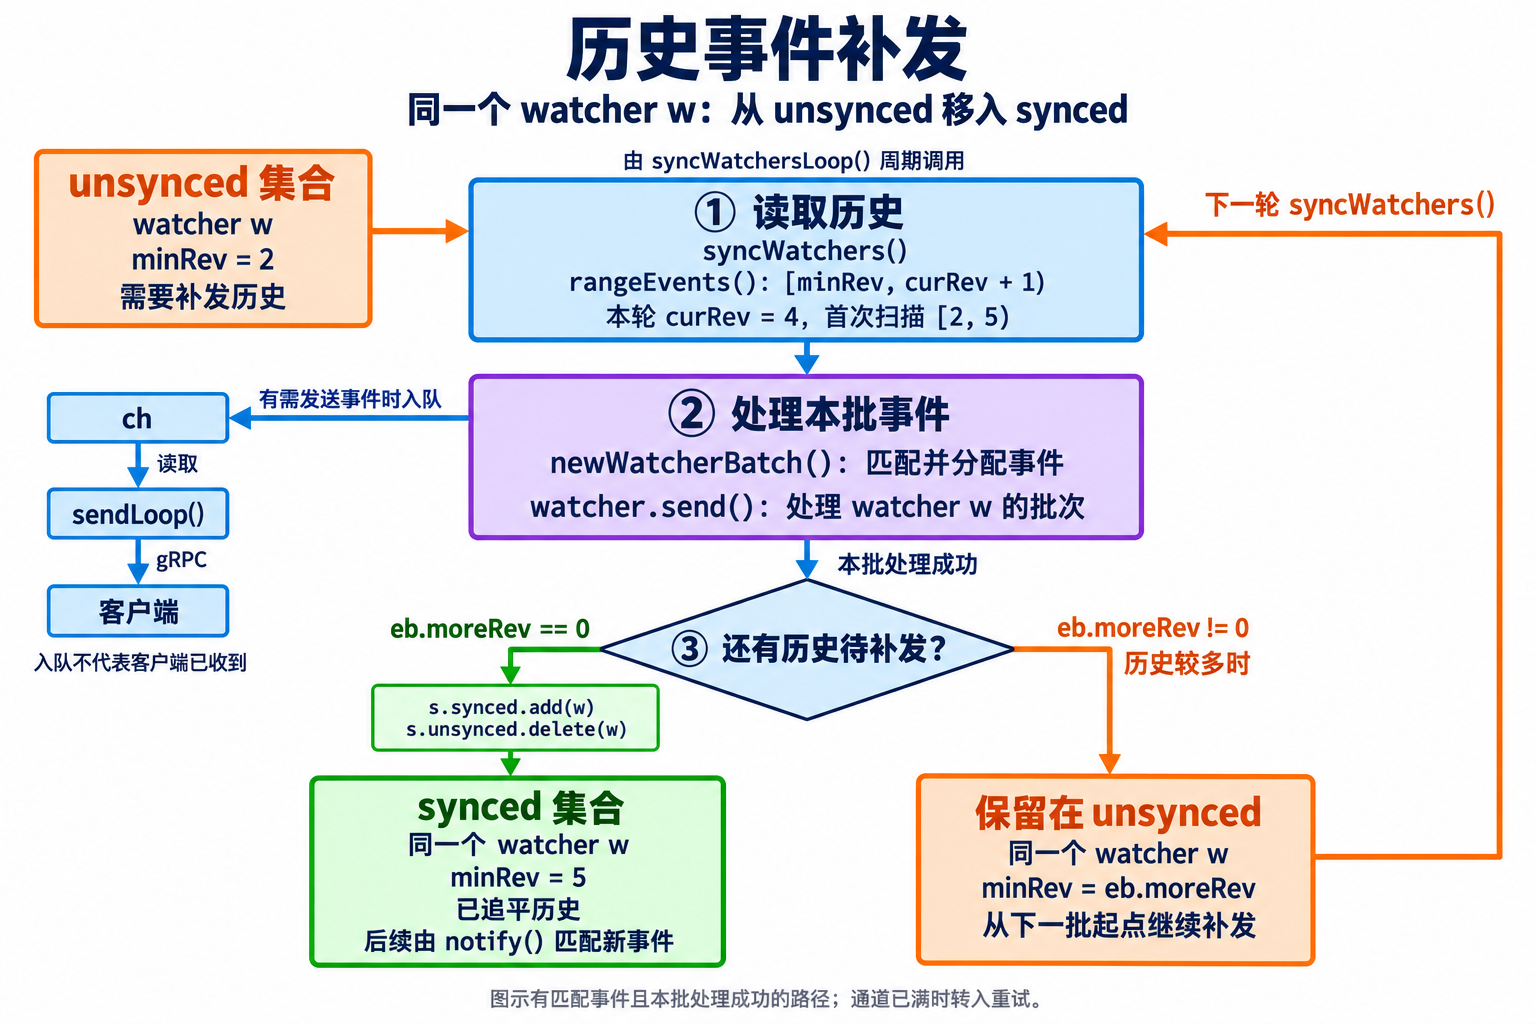
图:Watch 历史补发与订阅状态转换。
创建 watchableStore 时,mvcc.New() 通过 go s.syncWatchersLoop() 启动后台任务,统一处理各份订阅的历史补发。syncWatchersLoop() 定期检查 unsynced,有待补发的 watcher 时调用 syncWatchers(),随后等待定时器进入下一轮。
syncWatchers() 每次选取一批待补发的 watcher,完成以下处理:
- 读取历史:
syncWatchers()从unsynced中选出待补发的watcher,按最低minRev确定扫描起点。图中起点为2、本轮curRev=4,所以rangeEvents()读取[2, 5)内的历史记录。 - 处理本批事件:
newWatcherBatch()将匹配事件分配给watcher w。watcher.send()应用过滤条件后,将需要发送的事件写入所属流的ch,由sendLoop()通过 gRPC 发给客户端。 -
判断是否追平:本批处理成功后,根据
eb.moreRev决定同一个watcher w的去向:eb.moreRev == 0:历史已补完。通过s.synced.add(w)和s.unsynced.delete(w)将它移入synced。图中minRev=5,后续由notify()匹配新事件。eb.moreRev != 0:还有历史待补发。它保留在unsynced,minRev更新为eb.moreRev,下一轮syncWatchers()从这个位置继续补发。
func (s *watchableStore) syncWatchers() int {
    ...
    curRev := s.store.currentRev
    compactionRev := s.store.compactMainRev

    // 选出待补发的 watcher,并取得这一组的最低起点。
    wg, minRev := s.unsynced.choose(maxWatchersPerSync, curRev, compactionRev)
    // 扫描 [minRev, curRev+1) 内的历史事件。
    evs := rangeEvents(s.store.lg, s.store.b, minRev, curRev+1, wg)
    ...
    // 按键范围和 minRev,将匹配事件分配到各 watcher 的批次。
    wb := newWatcherBatch(wg, evs)
    for w := range wg.watchers {
        ...
        // 尝试将本批事件写入所属流的 ch。
        if w.send(WatchResponse{WatchID: w.id, Events: eb.evs, Revision: curRev}) {
            ...
        } else {
            // 通道已满,标记为待重试。
            w.victim = true
        }

        if w.victim {
            ...
        } else {
            if eb.moreRev != 0 {
                // 还有历史待补发,继续留在 unsynced。
                continue
            }
            // 本批已处理且历史已读完,加入 synced。
            s.synced.add(w)
        }
        // 已转入 synced 或重试流程,从 unsynced 移除。
        s.unsynced.delete(w)
    }
    ...
    return s.unsynced.size()
}
发送重试¶
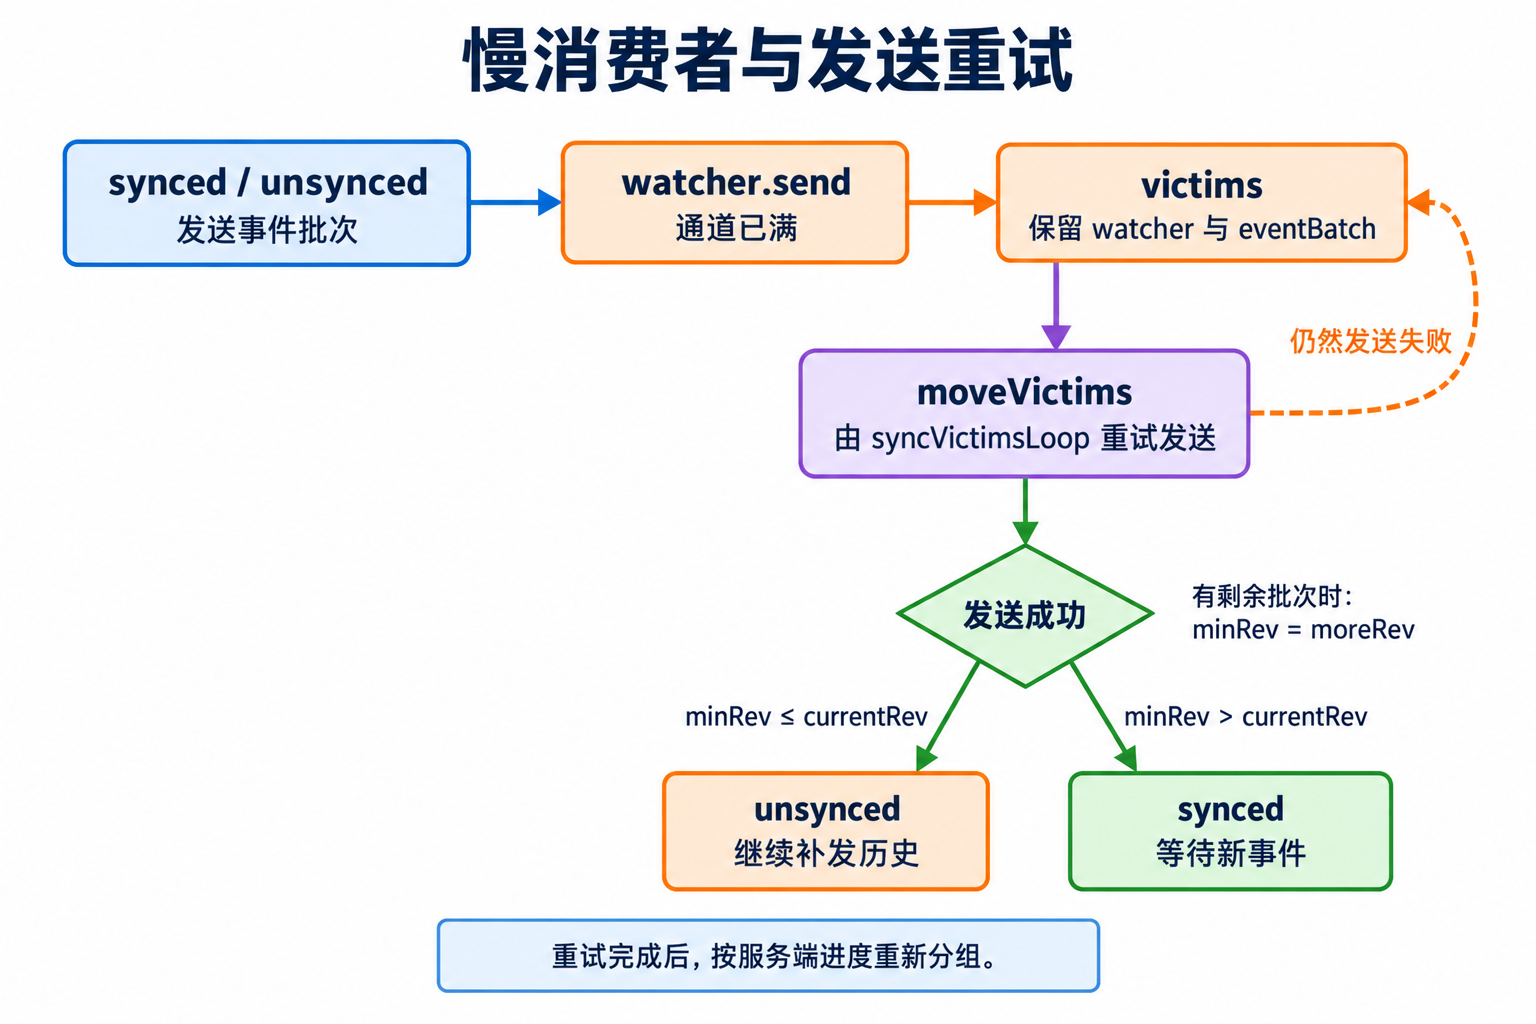
图:Watch 事件的发送积压与重试。
网络发送跟不上事件生成速度时,sendLoop() 来不及从 ch 取出响应,通道可能被填满。为了避免阻塞 MVCC 写事务,服务端会保存未能入队的批次,交给后台任务重试。
watcher.send() 返回 false,表示这批事件已经准备好,但通道 ch 暂时无法接收。调用方将该 watcher 标记为 victim,把未能入队的批次保存在 victims 中,并将它从原来的 synced 或 unsynced 集合移出。
unsynced 用于补查历史,victims 用于重试已准备好的事件批次。 保存批次可以避免重复读取和匹配历史,也能保留已经处理、但尚未入队的事件。
后台任务 syncVictimsLoop() 调用 moveVictims(),再次尝试将批次写入 ch。通道仍满就继续保留;入队成功后,再比较 minRev(后续需要接收事件的最低 revision)与当前版本 curRev,恢复该订阅的后续处理:
minRev <= curRev:还有历史需要补查,放回unsynced,从minRev开始补发匹配的事件。minRev > curRev:已经追平,放回synced,等待符合版本条件的新事件。
对同一个 watcher,先将积压批次入队,再补发后续历史;其他 watcher 无需等待整个 victims 集合清空。 这里的成功仅指写入 ch,网络发送仍由 sendLoop() 完成。
func (s *watchableStore) moveVictims() (moved int) {
    s.mu.Lock()
    victims := s.victims
    s.victims = nil
    s.mu.Unlock()

    var newVictim watcherBatch
    for _, wb := range victims {
        // 重试尚未入队的事件批次。
        for w, eb := range wb {
            // 用下一待处理 revision 减一,设置重试响应的 revision。
            rev := w.minRev - 1
            if !w.send(WatchResponse{WatchID: w.id, Events: eb.evs, Revision: rev}) {
                if newVictim == nil {
                    newVictim = make(watcherBatch)
                }
                newVictim[w] = eb
                continue
            }
            pendingEventsGauge.Add(float64(len(eb.evs)))
            moved++
        }

        // 将重试成功的订阅恢复到 unsynced 或 synced。
        s.mu.Lock()
        s.store.revMu.RLock()
        curRev := s.store.currentRev
        for w, eb := range wb {
            if newVictim != nil && newVictim[w] != nil {
                // 仍未入队的订阅继续保留在 victims 中。
                continue
            }
            w.victim = false
            if eb.moreRev != 0 {
                w.minRev = eb.moreRev
            }
            // 仍落后于当前版本时补发历史,否则恢复新事件的匹配。
            if w.minRev <= curRev {
                s.unsynced.add(w)
            } else {
                slowWatcherGauge.Dec()
                s.synced.add(w)
            }
        }
        s.store.revMu.RUnlock()
        s.mu.Unlock()
    }

    if len(newVictim) > 0 {
        s.mu.Lock()
        s.victims = append(s.victims, newVictim)
        s.mu.Unlock()
    }

    return moved
}
etcd 在 Kubernetes 中的应用¶
API Server 将 Kubernetes 资源对象编码后存入 etcd,读取时再解码为资源对象。Controller Manager、Scheduler 和 Kubelet 通过 Kubernetes API 获取所需对象,并通过 Watch 持续跟踪变化。对于 Watch 请求,API Server 将变化转换为 ADDED、MODIFIED、DELETED 等通知,返回对象内容及其 metadata.resourceVersion。
对象存储¶
API Server 的存储层将资源对象保存为键值记录。Key 定位对象,Deployment 等内置资源的 Value 默认保存 Kubernetes Protobuf 编码后的对象内容。etcd 元数据记录该 key 的创建版本、修改版本和修改次数。
Key 路径¶
在 default namespace 中创建一个名为 vllm-demo 的 Deployment 后,API Server 将它保存到以下 key:
这里的 /registry 是默认存储前缀,deployments、default 和 vllm-demo 分别对应资源类型、namespace 和对象名称。
Value 编码¶
Kubernetes API Server 默认使用 Kubernetes Protobuf 编码 Deployment 等内置资源。以 Deployment 为例,etcd Value 的结构如下:
etcd Value
├── 格式头:k8s\x00
│   └── 固定 4 字节:6b 38 73 00
│
└── runtime.Unknown(外层 Protobuf 消息)
    ├── typeMeta
    │   ├── apiVersion = "apps/v1"
    │   └── kind = "Deployment"
    │
    ├── raw(Deployment 编码后的二进制字节)
    │   └── 按 Deployment 的定义解码后得到:
    │       ├── metadata:名称、namespace、标签等
    │       ├── spec:副本数、Pod 模板等
    │       └── status:已观察到的运行状态
    │
    ├── contentEncoding = ""
    └── contentType = ""
k8s\x00:固定的四字节格式头,用于识别 Kubernetes Protobuf 数据。runtime.Unknown:Kubernetes Protobuf 使用的通用外层封装。typeMeta标识对象的 API 版本和类型,raw保存对象编码后的字节。解码时,程序先读取类型标识,再选择对应的解码器解析raw,得到 Deployment、Pod 等具体对象。定义见runtime.Unknown源码。typeMeta:记录对象的 API 版本和类型。这里的apps/v1和Deployment指明了raw应按哪种对象结构解码。raw:保存 Deployment 的 Protobuf 字节,解码后得到metadata、spec和status。contentEncoding:描述raw是否经过额外的内容编码;空字符串表示没有额外编码。contentType:描述raw的序列化格式。在 Kubernetes Protobuf 封装中,空字符串默认表示application/vnd.kubernetes.protobuf。
同一种 runtime.Unknown 可以封装不同类型的对象。下面只展示 typeMeta.kind 和 raw:
Unknown { typeMeta: { kind: "Deployment" }, raw: Deployment 的字节 }
Unknown { typeMeta: { kind: "Pod"        }, raw: Pod 的字节 }
Unknown { typeMeta: { kind: "Service"    }, raw: Service 的字节 }
CRD 定义的自定义资源(Custom Resource)默认使用 JSON 编码,详见 Kubernetes Protobuf 的兼容范围。
启用默认关闭的 CBORServingAndStorage 特性门控后,新建或更新的自定义资源会使用 CBOR 编码写入 etcd。CBOR(Concise Binary Object Representation) 是一种二进制数据格式,和 JSON 一样能表示对象、数组、字符串、数字等数据,区别在于编码方式:
- JSON:用文本表示数据,可以直接阅读。例如,数字
1000保存为四个数字字符。 - CBOR:用二进制编码数据类型和值,数字也直接按二进制表示。同一个对象通常比 JSON 编码更紧凑,但需要解码工具才能查看内容。
在 kubeadm 控制面节点上,使用默认的 etcd 地址和客户端证书路径,直接读取这个 Deployment:
export ETCDCTL_ENDPOINTS="https://127.0.0.1:2379"
export ETCDCTL_CACERT="/etc/kubernetes/pki/etcd/ca.crt"
export ETCDCTL_CERT="/etc/kubernetes/pki/etcd/healthcheck-client.crt"
export ETCDCTL_KEY="/etc/kubernetes/pki/etcd/healthcheck-client.key"

etcdctl get /registry/deployments/default/vllm-demo --write-out=json | jq .
一个最小 Deployment 对象对应的完整响应示例:
{
  "header": {
    "cluster_id": 16437170360356138769,
    "member_id": 13066528733661906017,
    "revision": 2,
    "raft_term": 2
  },
  "kvs": [
    {
      "key": "L3JlZ2lzdHJ5L2RlcGxveW1lbnRzL2RlZmF1bHQvdmxsbS1kZW1v",
      "create_revision": 2,
      "mod_revision": 2,
      "version": 1,
      "value": "azhzAAoVCgdhcHBzL3YxEgpEZXBsb3ltZW50EssBCiAKCXZsbG0tZGVtbxIAGgdkZWZhdWx0IgAqADIAOABCABKYAQgBEhIKEAoDYXBwEgl2bGxtLWRlbW8aeAoiCgASABoAIgAqADIAOABCAFoQCgNhcHASCXZsbG0tZGVtbxJSEjQKBHZsbG0SGHZsbG0vdmxsbS1vcGVuYWk6djAuMjcuMSoAQgBqAHIAgAEAiAEAkAEAogEAGgAyAEIASgBSAFgAYABoAIIBAIoBAJoBAMIBACICCgAoADgAGgwIABAAGAAgACgAOAAaACIA"
    }
  ],
  "count": 1
}
JSON 响应中的 key 和 value 使用 Base64 编码。key 解码后就是 /registry/deployments/default/vllm-demo;value 解码后仍是 Kubernetes Protobuf 二进制数据。可以使用 etcdedit 的 get 命令直接从 etcd 读取并解码为 YAML,查看对象字段。
对象版本¶
Kubernetes 使用 metadata.resourceVersion 标识对象版本。客户端更新对象时,可以携带这个版本检查对象是否已被修改;监听资源变化时,也通过 resourceVersion 指定续接位置。
Revision 映射¶
API Server 将对象对应 key 的 mod_revision 转换为十进制字符串,填入 metadata.resourceVersion。
以一个最小的 vllm-demo Deployment 为例,假设它在 revision 120 创建,此后尚未修改。从 etcd 查询:
响应示例中,注释标出了关键版本字段:
{
  "header": {
    "cluster_id": 16437170360356138769,
    "member_id": 13066528733661906017,
    "revision": 120, // 本次读取的全局 revision
    "raft_term": 2 // 处理本次请求时的 Raft 任期
  },
  "kvs": [
    {
      "key": "L3JlZ2lzdHJ5L2RlcGxveW1lbnRzL2RlZmF1bHQvdmxsbS1kZW1v",
      "create_revision": 120, // 该 key 创建时的 revision
      "mod_revision": 120, // 该 key 最近一次修改的 revision,用于回填 resourceVersion
      "version": 1, // 该 key 已写入一次
      "value": "azhzAAoVCgdhcHBzL3YxEgpEZXBsb3ltZW50EssBCiAKCXZsbG0tZGVtbxIAGgdkZWZhdWx0IgAqADIAOABCABKYAQgBEhIKEAoDYXBwEgl2bGxtLWRlbW8aeAoiCgASABoAIgAqADIAOABCAFoQCgNhcHASCXZsbG0tZGVtbxJSEjQKBHZsbG0SGHZsbG0vdmxsbS1vcGVuYWk6djAuMjcuMSoAQgBqAHIAgAEAiAEAkAEAogEAGgAyAEIASgBSAFgAYABoAIIBAIoBAJoBAMIBACICCgAoADgAGgwIABAAGAAgACgAOAAaACIA"
    }
  ],
  "count": 1
}
通过 Kubernetes API 查询:
下面是同一对象回填 resourceVersion 后的 YAML 示例:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vllm-demo
  namespace: default
  resourceVersion: "120" # 来自 etcd 的 mod_revision,以字符串返回
spec:
  replicas: 1
  selector:
    matchLabels:
      app: vllm-demo
  template:
    metadata:
      labels:
        app: vllm-demo
    spec:
      containers:
        - name: vllm
          image: vllm/vllm-openai:v0.27.1
          resources: {}
  strategy: {}
status: {}
更新冲突¶
客户端读取对象后,可以携带原来的 resourceVersion 提交 PUT 更新。API Server 检查这个版本是否仍与当前对象一致,防止旧对象覆盖其他客户端已经提交的修改。
实际写入时,API Server 的存储层通过 etcd 的 Txn 比较 key 的 mod_revision,版本仍与读取时一致才写入新值。比较和写入在同一事务内原子执行,具体实现见 OptimisticPut()。
expectedRevision 是调用方期望的 key 修改版本。If 比较版本,匹配时执行 Then 写入,不匹配时不写入:
func (k Client) OptimisticPut(ctx context.Context, key string, value []byte, expectedRevision int64, opts PutOptions) (resp PutResponse, err error) {
    txn := k.KV.Txn(ctx).If(
        // 当前 key 的修改版本必须与期望版本一致。
        clientv3.Compare(clientv3.ModRevision(key), "=", expectedRevision),
    ).Then(
        // 比较通过才写入新值,并使用指定的 Lease。
        clientv3.OpPut(key, string(value), clientv3.WithLease(opts.LeaseID)),
    )

    ...
    // 提交事务,比较和条件写入在 etcd 中原子执行。
    txnResp, err := txn.Commit()
    ...
}
假设客户端 A 和 B 都读取到 resourceVersion: "120" 的 vllm-demo,分别修改它的顶层 annotation:
# 客户端 A 的待提交对象。
# ...
metadata:
  name: vllm-demo
  namespace: default
  resourceVersion: "120"
  annotations:
    course.example.com/editor: client-a@120
  # ...
# ...
---
# 客户端 B 的待提交对象。
# ...
metadata:
  name: vllm-demo
  namespace: default
  resourceVersion: "120"
  annotations:
    course.example.com/editor: client-b@120
  # ...
# ...
A 先完成更新,假设对象版本变为 "136"。B 再携带旧版本 "120" 提交时,API Server 返回 409 Conflict,B 的修改没有写入。通用资源存储层的版本检查负责识别这种冲突。
状态同步¶
API Server 使用 etcd 的 Range 读取资源对象,使用 Watch 持续接收变化。API Server 默认启用 Watch Cache,按资源类型在内存中维护当前对象和有限的事件历史,供客户端读取和订阅。每个 API Server 维护自己的缓存,同一类资源的多个客户端共享这份缓存。
缓存同步与事件分发¶
API Server 的 etcd3 Storage 负责读取 etcd 数据并解码为 Kubernetes 对象,Reflector 将对象同步到 Watch Cache,Cacher 再向客户端分发变化事件。
下图以 default/vllm-demo Deployment 为例,展示对象读取、缓存更新和事件分发的过程。
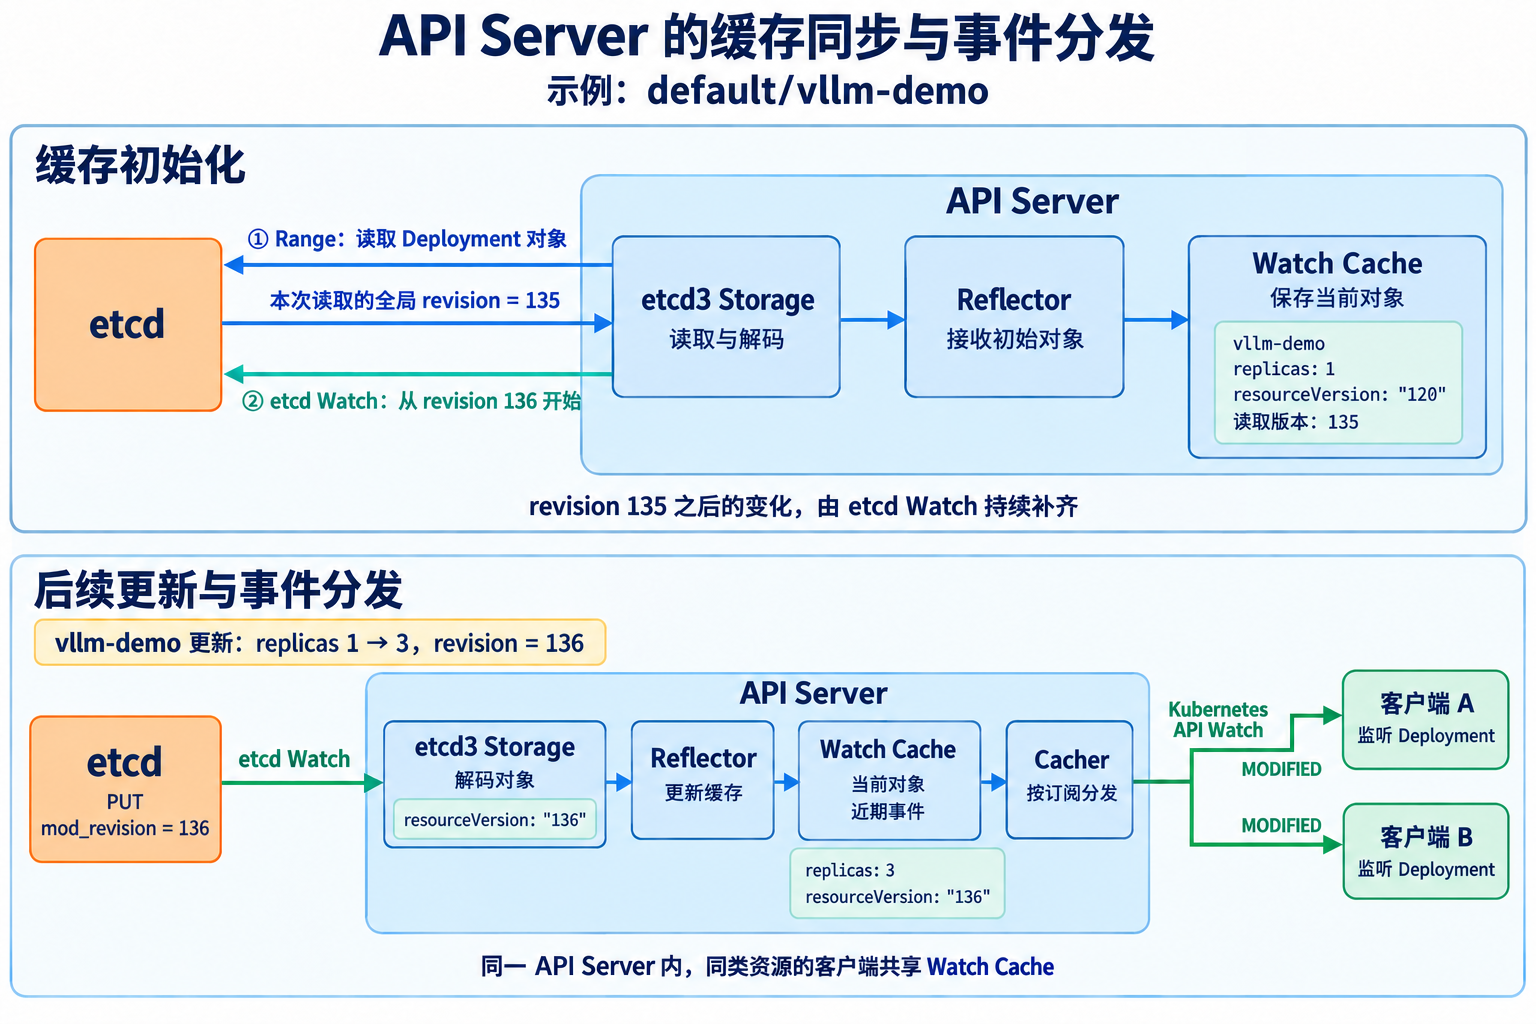
图:API Server 的缓存同步与事件分发。
- 读取对象:存储层通过 Range 读取
/registry/deployments/下的对象。假设本次读取对应的全局 revision 为135,返回的就是该版本的对象集合。vllm-demo最后修改于 revision120,因此对象的metadata.resourceVersion仍为"120"。 - 建立 Watch:存储层从 etcd revision
136开始监听同一前缀,持续接收读取之后的变化。 - 更新缓存:假设
vllm-demo的副本数从1改为3,etcd 产生 revision136的PUT事件。存储层解码对象,将其metadata.resourceVersion设为"136",Reflector 随后更新 Watch Cache。 - 分发事件:Cacher 按客户端的资源范围和筛选条件分发事件。持续匹配该 Deployment 的订阅会收到
MODIFIED,其中携带更新后的对象和resourceVersion: "136"。同一 API Server 中监听同类资源的多个客户端可以共享底层的 etcd Watch。
缓存一致性读取¶
Kubernetes 组件需要根据资源对象的状态执行协调、调度和节点管理。一致性读取保证:更新成功后再发起读取,不会因缓存尚未同步而返回更新前的旧状态。 例如,Deployment 的 spec.replicas 已成功从 1 改为 3,在没有后续修改的情况下,随后发起的一致性读取应返回 3。
客户端发起 GET 或 LIST 请求时,不传 resourceVersion,默认采用 Most Recent 一致性读取语义。分页 LIST 的后续请求通过 continue 延续第一页的集合版本。
直接读取的开销
在从缓存提供一致性读取之前,这类 LIST 请求需要向 etcd 发起一致性读取(Quorum Read),读取对象集合,再由 API Server 解码和筛选。请求越多、对象集合越大,etcd 和 API Server 需要处理的数据就越多。
API Server 可以利用 namespace 对应的存储键范围缩小读取范围。对于无法通过键范围完成的标签或字段筛选,则需要取回候选对象后在内存中处理。以 Kubelet 按节点筛选 Pod 为例:它只需要本节点上的 Pod,但原有读取路径需要从 etcd 读取集群中的 Pod 集合,再筛出属于该节点的对象。最终只返回少量 Pod,却可能需要读取、传输和解码整个 Pod 集合。
从缓存提供一致性读取
Watch Cache 已经保存了对象,可以在内存中完成查询和筛选。难点在于缓存通过 Watch 异步更新,可能暂时落后于 etcd;在返回数据前,API Server 必须确认缓存已经同步到本次读取要求的位置。
缓存一致性读取(Consistent Reads from Cache) 利用 etcd 的 进度通知(Progress Notification) 确认 Watch 的同步进度。API Server 先取得本次读取所需的 revision;如果缓存尚未追平,就请求进度通知并等待缓存处理到该位置,随后直接从缓存返回对象列表。这个过程保留了轻量的一致性读取,同时省去了从 etcd 重新拉取对象集合的开销。
下图展示一个独立的读取场景:Deployment 的对象版本为 "120",API Server 需要确认缓存已经同步到 revision 135。
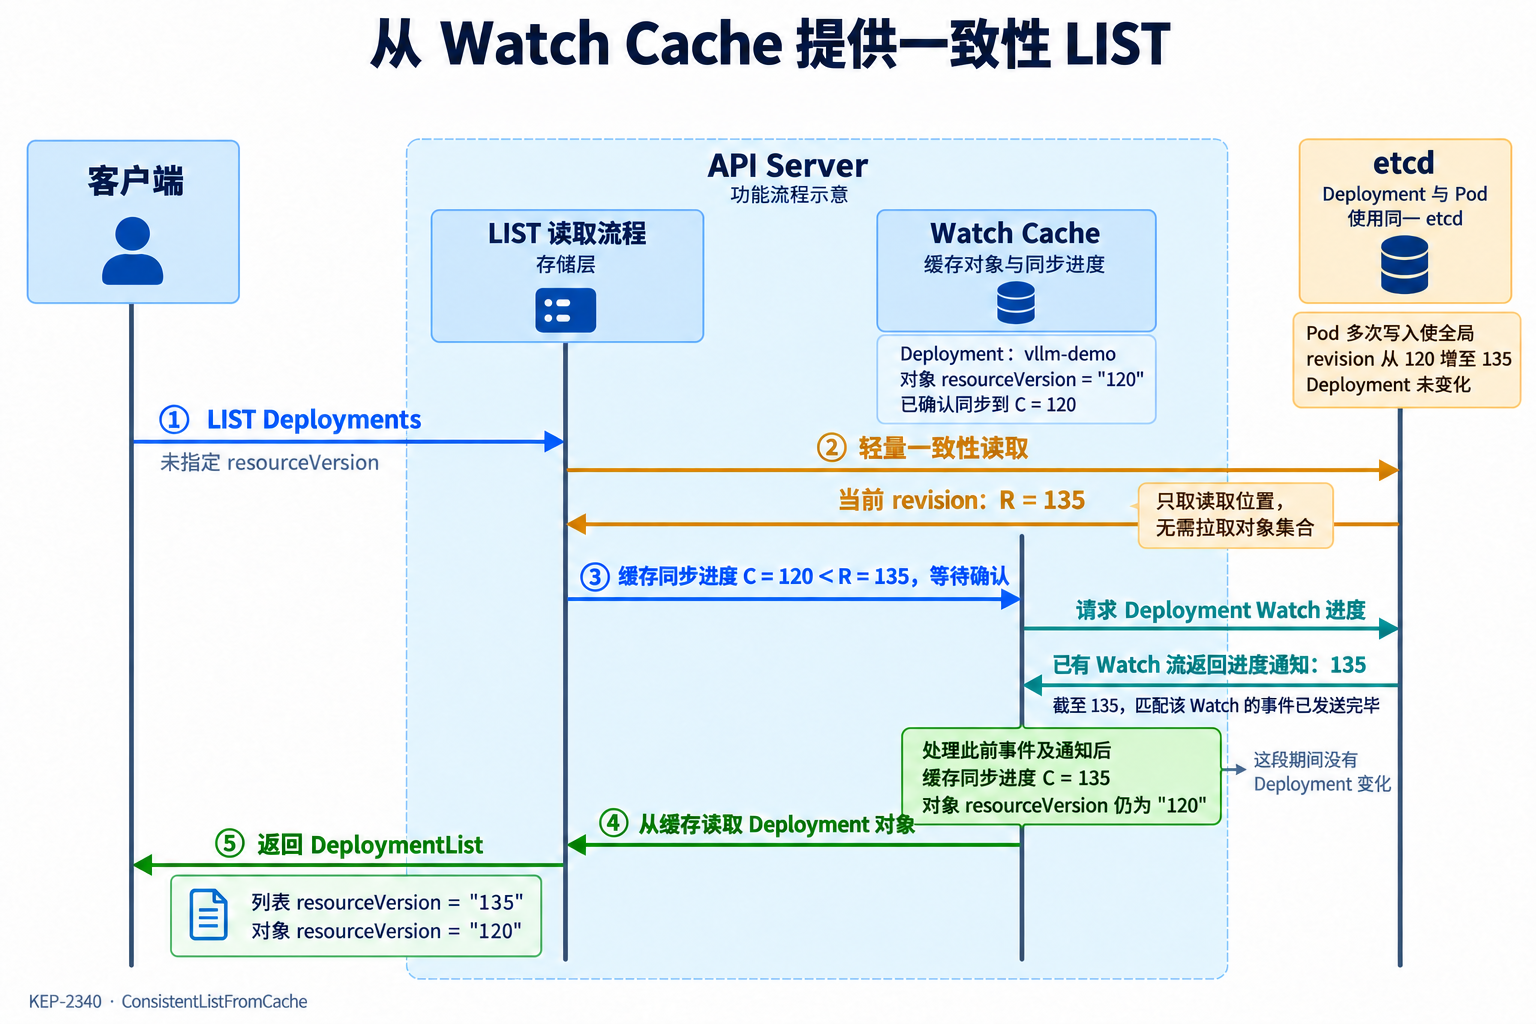
图:缓存同步进度与对象版本。
- 请求列表:客户端发起 Deployment LIST 请求,不指定
resourceVersion,采用一致性读取语义。 - 确定读取版本:API Server 向 etcd 发起轻量的一致性读取,取得全局 revision
135,无需取回整个 Deployment 集合。 - 确认缓存进度:缓存目前只确认同步到
120。API Server 请求 etcd 返回 Watch 进度通知,等待缓存处理完截至135的相关事件及通知,确认该范围内的 Deployment 变化均已处理。 - 从缓存返回列表:确认缓存同步到
135后,API Server 从内存中查询对象、应用筛选条件并返回列表。具体流程见 KEP-2340 的读取算法。
图中从 revision 120 到 135 只有 Pod 被修改,Deployment 未发生变化,因此返回结果中的两个版本不同:
- 列表
resourceVersion: "135":表示这份对象集合对应版本135时的状态。 - 对象
resourceVersion: "120":表示该 Deployment 最后一次修改发生在版本120。
性能收益
- 降低 etcd 负载:从缓存提供对象集合,减少 etcd 重复读取和传输大量对象的工作。
- 降低读取延迟:复用内存中已经解码的对象与索引,减少数据传输、对象解码和筛选的开销。
- 提升可扩展性:降低单次 LIST 请求的处理成本,使控制平面能够在大型集群中承载更多读取请求。
官方博客的性能结果显示,在其 5000 节点集群的可扩展性测试中,启用从缓存进行一致性读取后,得到以下改善:
| 指标 | 测试结果 |
|---|---|
| kube-apiserver CPU 使用率 | 降低 30% |
| etcd CPU 使用率 | 降低 25% |
| Pod LIST 请求的 P99 延迟 | 从 5 秒降至 1.5 秒 |
静态加密¶
EncryptionConfiguration 指定需要加密的资源。API Server 在写入 etcd 前加密对象内容,读取时再解密。对于已加密的对象,直接读取 etcd Value 或查看数据库文件、快照,只能取得密文,没有相应密钥就无法还原对象内容。配置方式见 Kubernetes 静态数据加密。
加解密流程¶
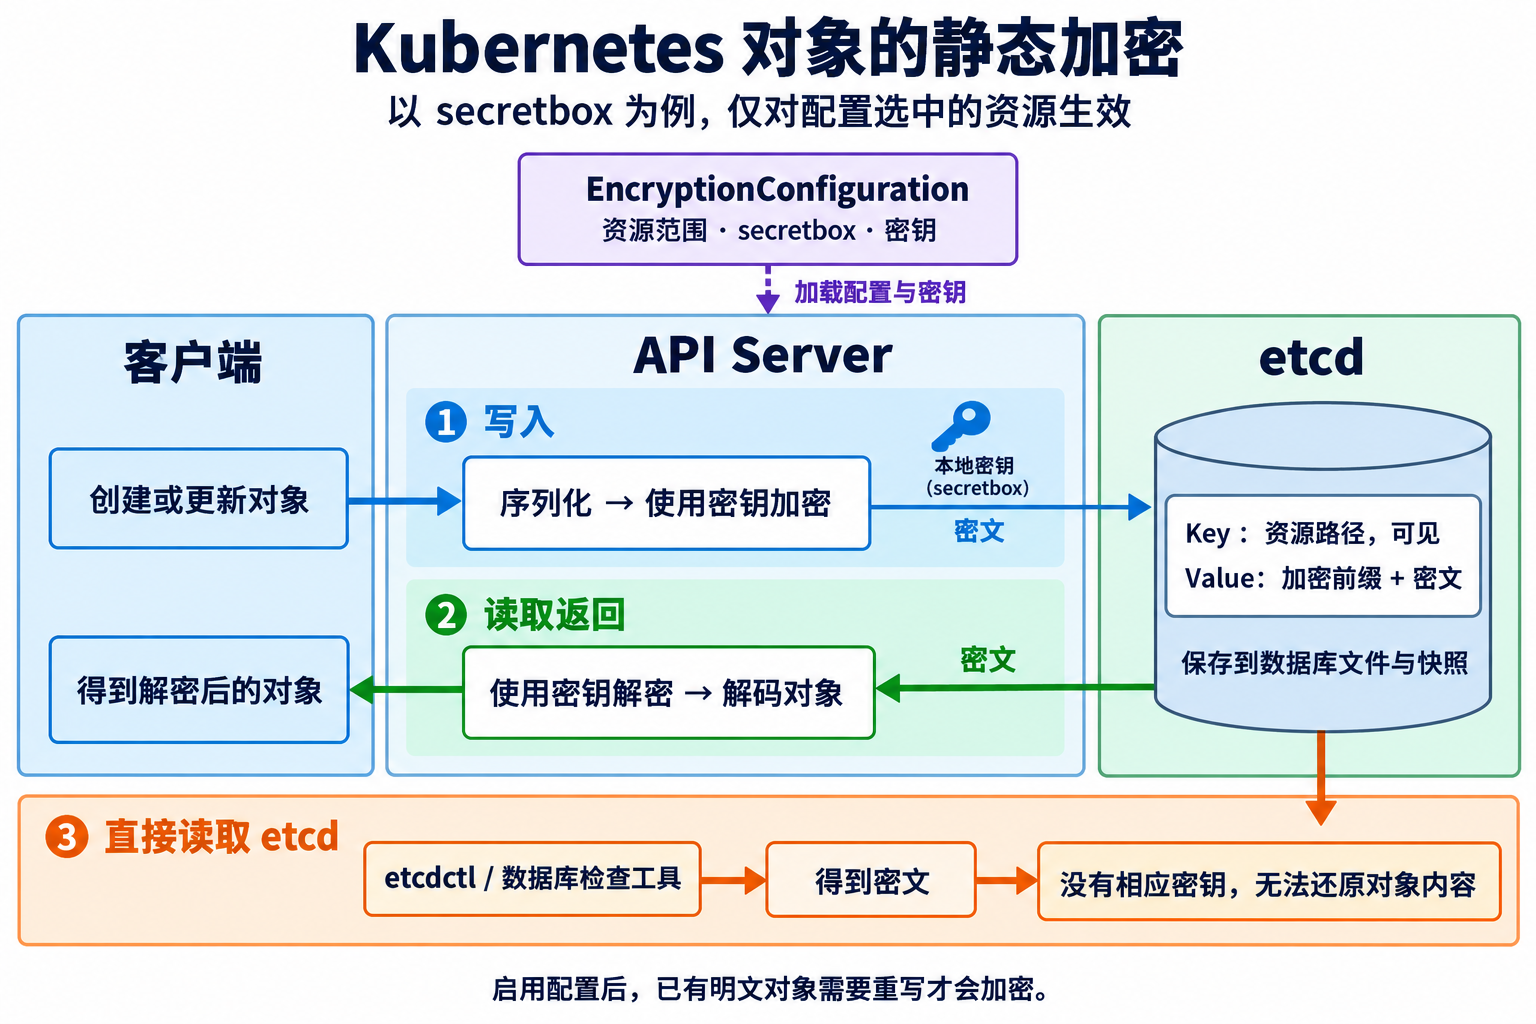
图:Kubernetes 对象的加密存储与读取。
图中使用 secretbox,API Server 从控制平面上的 EncryptionConfiguration 文件加载密钥:
- 写入对象:API Server 将对象序列化,再用密钥加密,将密文保存为 etcd Value。
- 读取对象:API Server 从 etcd 取得密文,用密钥解密并解码,再将对象返回客户端。
- 直接读取 etcd:
etcdctl或数据库检查工具取得的是密文。etcd 中没有保存这把密钥,无法仅凭这些数据还原对象内容;Key 中的资源路径仍然可见。
provider 指具体的加解密实现。Kubernetes 支持的常见选项包括:
secretbox:使用 32 字节本地密钥加解密,无需外部服务。kms(v2):接入外部密钥管理服务,将密钥加密密钥(KEK)保存在控制平面之外。aesgcm:使用 AES-GCM,需要自动轮换密钥,并在每把密钥达到 200,000 次写入前完成轮换。aescbc:使用 AES-CBC,官方目前不推荐使用。identity:原样读写数据,不进行加密,可用于读取迁移前的明文对象。
各 provider 的算法、密钥长度和限制见 EncryptionConfiguration 支持的加密 provider。
API Server 配置¶
将下面的配置保存为 /etc/kubernetes/enc/encryption-config.yaml,用于加密 Secret 和 Deployment。${ENCRYPTION_KEY} 需替换为随机生成的 32 字节密钥的 Base64 编码。
apiVersion: apiserver.config.k8s.io/v1
kind: EncryptionConfiguration
resources:
  - resources:
      - secrets
      - deployments.apps
    providers:
      - secretbox:
          keys:
            - name: key-2026-08
              secret: ${ENCRYPTION_KEY}
      # 原样读取启用加密前保存的未加密对象,读取时不会将其加密。
      # 这些对象后续更新时,由前面的 secretbox 加密写回 etcd。
      - identity: {}
在 kubeadm 的 /etc/kubernetes/manifests/kube-apiserver.yaml 中添加以下配置,通过 --encryption-provider-config 指定配置文件,并将文件只读挂载到 API Server 容器:
# ...
spec:
  containers:
    - name: kube-apiserver
      # ...
      command:
        - kube-apiserver
        # ...
        - --encryption-provider-config=/etc/kubernetes/enc/encryption-config.yaml
      volumeMounts:
        # ...
        - name: encryption-config
          mountPath: /etc/kubernetes/enc/encryption-config.yaml
          readOnly: true
  volumes:
    # ...
    - name: encryption-config
      hostPath:
        path: /etc/kubernetes/enc/encryption-config.yaml
        type: File
  # ...
etcd 命令行工具¶
常见的 etcd 命令行工具包括:
- etcd:启动 etcd 服务,配置监听地址、数据目录和集群参数。
- etcdctl:连接运行中的 etcd,读写键值、监听变化、检查集群状态、管理成员和备份快照。
- etcdutl:操作本地快照和数据目录,检查或恢复快照、离线整理数据库碎片。
- etcd-dump-db:检查 etcd 数据库文件,支持列出 bucket、查看和解码键值记录、计算数据库哈希。
- etcdedit:直接连接 etcd,解码、查看和编辑其中保存的 Kubernetes 资源对象。
启动本地环境¶
可以使用 Docker 命令在本地快速启动一个单节点 etcd 集群,并将客户端端口映射到本地的 127.0.0.1:2379:
docker run -d --rm --name etcd-demo \
  -p 127.0.0.1:2379:2379 \
  quay.io/coreos/etcd:v3.7.1 \
  /usr/local/bin/etcd \
  --data-dir=/etcd-data \
  --listen-client-urls=http://0.0.0.0:2379 \
  --advertise-client-urls=http://127.0.0.1:2379
在宿主机终端设置 etcdctl 的连接地址,后续命令会使用该地址:
etcdctl¶
etcdctl 通过网络连接正在运行的 etcd endpoint,用于 KV 读写、Watch、Lease、成员管理、在线维护和快照备份。完整的 etcdctl 命令说明见 etcdctl 命令参考。
| 类型 | 常用命令 | 用途 |
|---|---|---|
| KV | put、get、del |
写入、读取和删除单个 key 或 key range |
| 原子操作 | txn |
根据 value、version 或 revision 条件执行一组原子请求 |
| 变化通知 | watch |
监听 key、range 或 prefix 的后续事件 |
| 临时数据 | lease grant、lease keep-alive、lease revoke |
为 key 设置 TTL 并管理 Lease |
| 并发控制 | lock、elect |
使用 etcd concurrency API 实现互斥锁和 leader election |
| 集群检查 | endpoint health、endpoint status、endpoint hashkv、member list |
检查 endpoint、Raft 状态、KV hash 和成员列表 |
| 在线维护 | compact、defrag、alarm、snapshot save |
压缩历史、整理 backend、处理告警和创建快照 |
连接配置¶
设置本地 etcd 的连接地址,并检查服务状态:
$ export ETCDCTL_ENDPOINTS="http://127.0.0.1:2379"
$ etcdctl endpoint health
http://127.0.0.1:2379 is healthy: successfully committed proposal: took = 1.060091ms
集群状态¶
以下示例展示在三节点 etcd 集群上的操作。
通过线性一致读取检查各成员的健康状态:
$ etcdctl endpoint --cluster health
http://127.0.0.1:12379 is healthy: successfully committed proposal: took = 2.200167ms
http://127.0.0.1:22379 is healthy: successfully committed proposal: took = 2.499584ms
http://127.0.0.1:32389 is healthy: successfully committed proposal: took = 2.263542ms
查看各成员的版本、数据库大小和 Raft 状态:
$ etcdctl --write-out=table endpoint --cluster status
┌────────────────────────┬──────────────────┬─────────┬─────────────────┬─────────┬────────┬───────────────────────┬────────┬───────────┬────────────┬───────────┬────────────┬────────────────────┬────────┬──────────────────────────┬───────────────────┐
│        ENDPOINT        │        ID        │ VERSION │ STORAGE VERSION │ DB SIZE │ IN USE │ PERCENTAGE NOT IN USE │ QUOTA  │ IS LEADER │ IS LEARNER │ RAFT TERM │ RAFT INDEX │ RAFT APPLIED INDEX │ ERRORS │ DOWNGRADE TARGET VERSION │ DOWNGRADE ENABLED │
├────────────────────────┼──────────────────┼─────────┼─────────────────┼─────────┼────────┼───────────────────────┼────────┼───────────┼────────────┼───────────┼────────────┼────────────────────┼────────┼──────────────────────────┼───────────────────┤
│ http://127.0.0.1:32389 │  fcc4adbd5421f11 │   3.7.1 │           3.7.0 │   98 kB │  98 kB │                    0% │ 2.1 GB │      true │      false │         2 │         14 │                 14 │        │                          │             false │
│ http://127.0.0.1:12379 │ 8211f1d0f64f3269 │   3.7.1 │           3.7.0 │   98 kB │  98 kB │                    0% │ 2.1 GB │     false │      false │         2 │         14 │                 14 │        │                          │             false │
│ http://127.0.0.1:22379 │ 91bc3c398fb3c146 │   3.7.1 │           3.7.0 │   98 kB │  98 kB │                    0% │ 2.1 GB │     false │      false │         2 │         14 │                 14 │        │                          │             false │
└────────────────────────┴──────────────────┴─────────┴─────────────────┴─────────┴────────┴───────────────────────┴────────┴───────────┴────────────┴───────────┴────────────┴────────────────────┴────────┴──────────────────────────┴───────────────────┘
比较各成员在同一 revision 下的 KV 哈希,检查副本数据是否一致:
$ etcdctl --write-out=table endpoint --cluster hashkv
┌────────────────────────┬────────────┬───────────────┐
│        ENDPOINT        │    HASH    │ HASH REVISION │
├────────────────────────┼────────────┼───────────────┤
│ http://127.0.0.1:12379 │ 1084519789 │             1 │
│ http://127.0.0.1:22379 │ 1084519789 │             1 │
│ http://127.0.0.1:32389 │ 1084519789 │             1 │
└────────────────────────┴────────────┴───────────────┘
列出集群成员,表中两类地址的用途如下:
PEER ADDRS:成员之间通信的地址,用于 Raft 心跳、选举和日志复制。CLIENT ADDRS:客户端访问地址,etcdctl和应用通过它执行键值读写、Watch 等操作。
$ etcdctl --write-out=table member list
┌──────────────────┬─────────┬────────┬────────────────────────┬────────────────────────┬────────────┐
│        ID        │ STATUS  │  NAME  │       PEER ADDRS       │      CLIENT ADDRS      │ IS LEARNER │
├──────────────────┼─────────┼────────┼────────────────────────┼────────────────────────┼────────────┤
│  fcc4adbd5421f11 │ started │ infra2 │ http://127.0.0.1:32390 │ http://127.0.0.1:32389 │      false │
│ 8211f1d0f64f3269 │ started │ infra0 │ http://127.0.0.1:12380 │ http://127.0.0.1:12379 │      false │
│ 91bc3c398fb3c146 │ started │ infra1 │ http://127.0.0.1:22380 │ http://127.0.0.1:22379 │      false │
└──────────────────┴─────────┴────────┴────────────────────────┴────────────────────────┴────────────┘
KV 读写¶
使用 put 写入键 hello,值为 world:
使用 get 读取 hello,输出 key 和 value:
写入两个以 app/ 开头的键值对:
使用 --prefix 读取以 app/ 开头的所有键值:
使用 --keys-only 只显示 key。默认输出格式会在每个 key 后保留一个空行:
使用 del 删除 hello,返回删除的 key 数量:
Watch¶
Watch 持续接收指定 key 或前缀的变化,可用于配置更新通知、服务发现和本地缓存同步。命令用法见 How to watch keys。
在终端一监听 hello,完成终端二的操作后会收到以下事件:
在终端二写入并删除 hello:
事务¶
事务根据比较结果选择一组读写操作,并将条件检查与所选操作原子地执行,常用于防止并发更新互相覆盖。输入语法见 etcdctl TXN 命令说明。
写入初始值:
使用 txn 比较 hello 的值:等于 world 时更新为 world2,否则读取当前值。比较条件、成功分支和失败分支之间用空行分隔:
Lease¶
Lease(租约)可以绑定一个或多个键值对。客户端持续续约,键值对就保留;租约到期或被主动撤销后,etcd 会自动删除所有绑定的键值对。
申请一个有效期为 60 秒的租约。后续命令中的 ID 替换为实际返回的 Lease ID:
写入键值对 key1=value1,通过 --lease 绑定租约,再读取这个 key:
查看租约的剩余时间,attached keys 显示绑定的 key:
$ etcdctl lease timetolive 6e8fa16ce5e91d05 --keys
lease 6e8fa16ce5e91d05 granted with TTL(60s), remaining(59s), attached keys([key1])
使用 --once 续约一次,将剩余有效期恢复到约 60 秒;去掉 --once 后,命令会持续续约:
主动撤销租约,同时删除绑定的键值对 key1=value1:
此时再读取 key1,没有输出,表示键值对已删除:
如果停止续约并等待租约到期,etcd 也会自动删除 key1=value1。监听 key1 的客户端会收到 DELETE 事件。
分布式锁与选主¶
分布式锁
多个进程需要互斥执行任务时,可以争用同一把锁。终端 A 获取 job 锁后输出提示,并等待 15 秒;命令结束后释放锁。命令及输出示例如下:
在 A 结束前,在终端 B 执行下面的命令。B 会等待,直到 A 释放锁后才输出 B acquired:
同一时间,只有持有 job 锁的进程能执行后面的命令。
选主
多个实例需要选出一个持续负责工作的实例时,可以参与同一场选举。终端 A 执行以下命令,当选后输出候选 key 和值,并保持运行:
保持 A 运行,在终端 B 执行以下命令,B 暂时没有输出。在终端 A 按 Ctrl+C 退出,待 A 的候选记录移除后,B 当选并输出自己的候选 key 和值:
leader 是应用层选举的名称,worker1、worker2 是各候选 key 保存的值;key 的后缀由 etcd 自动生成,以上为示例。这里是在多个应用实例之间选出 Leader,与 etcd 成员之间的 Raft Leader 选举是两回事。
成员管理¶
先通过 ETCDCTL_ENDPOINTS 指定已有集群的客户端地址,再使用 etcdctl member add 将 infra3 作为 Learner 加入集群。--peer-urls 指定其他成员连接 infra3 的通信地址。成员变更通过 Raft 同步,原有成员无需修改启动配置或重启。
下表列出了本例各成员的地址。ETCDCTL_ENDPOINTS 使用已有成员的 Client 地址;添加成员后输出的 ETCD_INITIAL_CLUSTER 使用包含 infra3 在内的全部成员的 Peer 地址。
| 成员 | Client 地址(客户端请求) | Peer 地址(成员间通信) |
|---|---|---|
| infra0 | http://127.0.0.1:12379 |
http://127.0.0.1:12380 |
| infra1 | http://127.0.0.1:22379 |
http://127.0.0.1:22380 |
| infra2 | http://127.0.0.1:32389 |
http://127.0.0.1:32390 |
| infra3(新成员) | http://127.0.0.1:42379 |
http://127.0.0.1:42390 |
命令成功后输出 Member ID 和四项启动配置;输出中的 ETCD_ 配置不会自动设置为环境变量:
$ export ETCDCTL_ENDPOINTS="http://127.0.0.1:12379,http://127.0.0.1:22379,http://127.0.0.1:32389"
$ etcdctl member add infra3 --peer-urls=http://127.0.0.1:42390 --learner
Member 5094c622c005a852 added as learner to cluster ec2d0938e54d3cce

ETCD_NAME="infra3"
ETCD_INITIAL_CLUSTER="infra2=http://127.0.0.1:32390,infra3=http://127.0.0.1:42390,infra0=http://127.0.0.1:12380,infra1=http://127.0.0.1:22380"
ETCD_INITIAL_ADVERTISE_PEER_URLS="http://127.0.0.1:42390"
ETCD_INITIAL_CLUSTER_STATE="existing"
这四项配置供新成员的 etcd 进程读取,含义见 etcd 配置选项:
ETCD_NAME:本成员的名称,这里是infra3。ETCD_INITIAL_CLUSTER:加入时使用的成员列表,格式为成员名称=Peer 地址,包含已有成员和新成员infra3。ETCD_INITIAL_ADVERTISE_PEER_URLS:本成员向集群公布的 Peer 地址,应与member add --peer-urls登记的地址一致。ETCD_INITIAL_CLUSTER_STATE:existing表示加入已有集群;new用于初始化新集群。
在新终端中,将实际输出的四项配置分别加上 export 执行,再启动 infra3。启动命令中的地址参数分别用于:
--listen-peer-urls:实际监听成员间通信。前面的ETCD_INITIAL_ADVERTISE_PEER_URLS告诉其他成员连接哪里,这个参数让进程在对应地址接收请求。--listen-client-urls:实际监听客户端请求,这里使用42379端口。--advertise-client-urls:向客户端公布可连接的地址。
本地示例中,监听地址与公布地址相同。经过地址映射时,两者可以不同,但公布地址必须能被对应的成员或客户端访问。下面使用独立的数据目录和监听端口启动 infra3:
export ETCD_NAME="infra3"
export ETCD_INITIAL_CLUSTER="infra2=http://127.0.0.1:32390,infra3=http://127.0.0.1:42390,infra0=http://127.0.0.1:12380,infra1=http://127.0.0.1:22380"
export ETCD_INITIAL_ADVERTISE_PEER_URLS="http://127.0.0.1:42390"
export ETCD_INITIAL_CLUSTER_STATE="existing"

etcd --data-dir=infra3.etcd \
  --listen-peer-urls=http://127.0.0.1:42390 \
  --listen-client-urls=http://127.0.0.1:42379 \
  --advertise-client-urls=http://127.0.0.1:42379
如果统一使用环境变量,保留前面的四项 export,将启动命令替换为:
export ETCD_LISTEN_PEER_URLS="http://127.0.0.1:42390"
export ETCD_LISTEN_CLIENT_URLS="http://127.0.0.1:42379"
export ETCD_ADVERTISE_CLIENT_URLS="http://127.0.0.1:42379"

etcd --data-dir=infra3.etcd
保持该进程运行,回到连接已有集群的终端执行晋升命令,将 Member ID 替换为实际返回值。etcd 会检查 Learner 的日志进度;尚未追平时,等待同步后再执行。成员加入与晋升流程见 etcd 成员变更说明:
$ etcdctl member promote 5094c622c005a852
Member 5094c622c005a852 promoted in cluster ec2d0938e54d3cce
如果需要删除成员,可以使用 etcdctl member remove,指定要删除的 Member ID:
$ etcdctl member remove 5094c622c005a852
Member 5094c622c005a852 removed from cluster ec2d0938e54d3cce
在线维护¶
compact 清理旧版本,保留键的当前值。向 compact-demo 连续写入两个值,用 jq 查看每次写入的 revision。下面假设返回 2、3;执行时使用实际返回的 revision:
$ etcdctl put compact-demo v1 --write-out=json | jq '.header.revision'
2
$ etcdctl put compact-demo v2 --write-out=json | jq '.header.revision'
3
$ etcdctl get compact-demo --rev=2
compact-demo
v1
etcdctl compact 3 将 revision 3 设为历史压缩点,清理此前不再需要的旧版本。在这个例子中:
- revision
2:compact-demo=v1。 - revision
3:compact-demo=v2。
执行压缩后,查询 revision 2 会报“历史已压缩”;直接查询当前值,仍然得到 v2。--physical 让命令等待处理请求的成员完成后端旧版本记录的清理后再返回;不加时,命令返回后清理可能仍在后台进行。以下错误输出仅保留最后一行:
$ etcdctl compact 3 --physical
compacted revision 3
$ etcdctl get compact-demo --rev=2
Error: etcdserver: mvcc: required revision has been compacted
$ etcdctl get compact-demo
compact-demo
v2
压缩作用于整个 etcd 的 MVCC 历史。某个键即使最后修改的 revision 小于 3,只要仍是该键的有效当前值,就会保留。
compact 清理历史数据,defrag 缩小数据库文件。 etcd 底层的 bbolt 按页管理数据库文件。清理旧版本后,相关页被标记为可复用,文件本身不会自动缩小;这些页仍占用文件内的空间,供 etcd 后续写入使用。
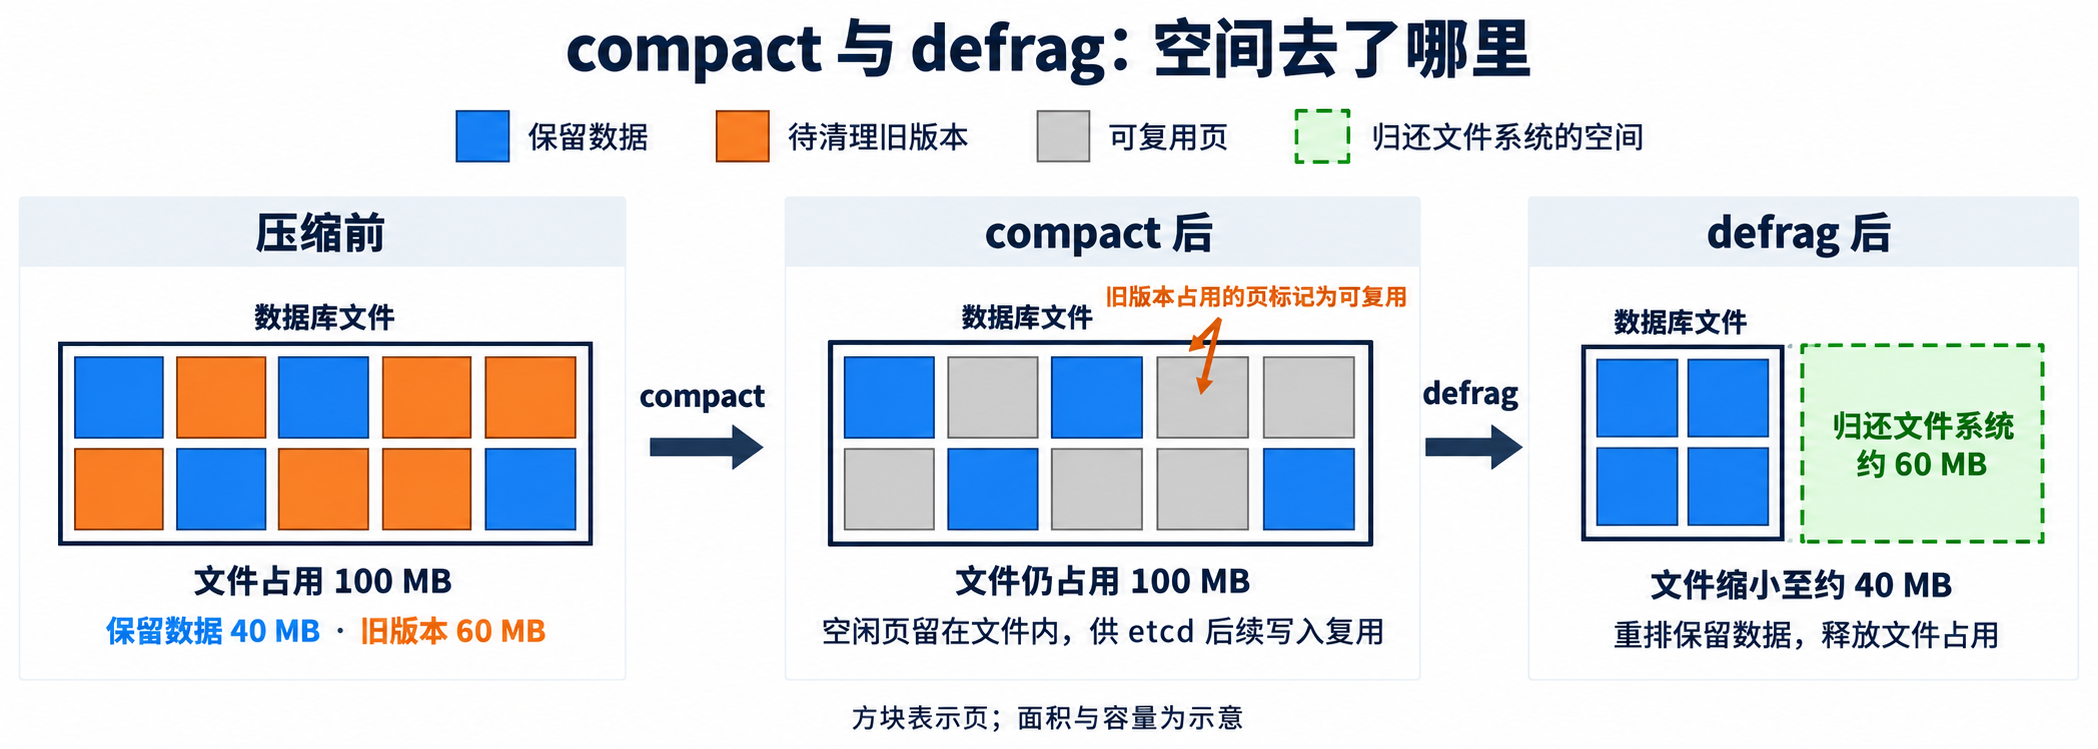
图:历史压缩与磁盘空间回收。
假设数据库文件占 100 MB,其中待清理的旧版本占 60 MB,需要保留的数据占 40 MB:
- 执行
compact后:约 60 MB 的页被标记为可复用,但文件仍占磁盘 100 MB,这部分空间尚未归还文件系统。 - 执行
defrag后:将需要保留的数据重新整理,文件缩小到约 40 MB,释放的磁盘空间可供其他文件使用。
下面的 defrag 整理当前连接成员的数据库,执行期间会阻塞该成员的读写。更多说明见 etcd 存储维护:
快照备份¶
从一个 endpoint 导出快照,保存为当前目录下的 snapshot.db:
$ etcdctl --endpoints=http://127.0.0.1:12379 snapshot save snapshot.db
...
Snapshot saved at snapshot.db
Server version 3.7.0
快照文件的检查和恢复由 etcdutl 完成。
etcdutl¶
etcdutl 直接操作本地快照文件和数据目录。完整命令见 etcdutl 命令参考。
快照检查¶
查看快照的哈希、revision、key 数量、文件大小和存储版本:
$ etcdutl --write-out=table snapshot status snapshot.db
┌──────────┬──────────┬────────────┬────────────┬─────────┐
│   HASH   │ REVISION │ TOTAL KEYS │ TOTAL SIZE │ VERSION │
├──────────┼──────────┼────────────┼────────────┼─────────┤
│ c4dcbf3f │       14 │          2 │      98 kB │   3.7.0 │
└──────────┴──────────┴────────────┴────────────┴─────────┘
VERSION 表示快照的存储格式版本。
KV 哈希¶
计算快照的 KV 哈希,默认使用快照中的最新 revision:
$ etcdutl --write-out=table hashkv snapshot.db
┌────────────┬───────────────┬──────────────────┐
│    HASH    │ HASH REVISION │ COMPACT REVISION │
├────────────┼───────────────┼──────────────────┤
│ 1918550935 │            14 │               14 │
└────────────┴───────────────┴──────────────────┘
复制文件不是必需步骤。hashkv 以可写方式打开文件,表示允许写入,不等于一定会修改业务数据。如果需要保证原始快照不受影响,可以先复制,再对副本执行命令。
比较不同文件的哈希时,需要使用相同的 HASH REVISION 和 COMPACT REVISION。
快照恢复¶
将快照恢复到新的 etcd-restored 数据目录。目标目录应不存在或为空,恢复时会生成新的成员和集群 ID:
$ etcdutl snapshot restore snapshot.db --data-dir=etcd-restored
...
... restored snapshot {"path": "snapshot.db", "data-dir": "etcd-restored", ...}
多成员集群和 Kubernetes 的恢复流程见 etcd Disaster recovery。
离线碎片整理¶
defrag 重写数据库,将空闲空间归还给文件系统。目标目录必须没有 etcd 进程使用;这里操作刚恢复、尚未启动的目录:
$ etcdutl defrag --data-dir=etcd-restored
...
... finished defragmenting directory {"path": "etcd-restored/member/snap/db", ...}
数据目录迁移¶
etcdutl migrate 用于故障恢复等场景下的离线存储格式转换。正常集群降级会自动迁移存储格式,无需单独执行此命令。
参数见 etcdutl migrate 命令定义。下面使用 3.7 系列的 etcdutl,将 3.7 格式的目录转换为 3.6;成功时输出如下:
$ etcdutl migrate --data-dir=etcd-restored --target-version=3.6
... updated storage version {"new-storage-version": "3.6.0"}
使用时有以下限制:
- 数据目录:成员必须已停止,操作前保留备份。
--data-dir指向包含数据库和 WAL 的成员目录,不能直接传入snapshot.db。 - 目标版本:使用
主版本.次版本格式,例如3.6,不能写成3.6.0。上述工具要求目标至少为3.5,且转换路径必须由该版本工具支持;不支持跨主版本转换。 - WAL 兼容性:降级时,如果 WAL 中包含目标版本不支持的记录,命令会拒绝转换,检查逻辑见 存储格式迁移源码。
--force会在迁移失败后强制改写存储版本标记,不能据此保证数据兼容。 - 集群降级:该命令只处理本地目录。运行中的集群应遵循 etcd 从 v3.7 降级到 v3.6 的流程,一次只降一个次版本;启用降级后,集群会自动迁移存储格式,再逐个替换成员的二进制文件。
etcd-dump-db¶
etcd-dump-db 直接检查本地数据库或快照文件,查看 bucket、键值记录和保留的历史版本,完整命令见官方工具说明。
按照官方安装说明,在 etcd 源码目录中执行 go install:
git clone --depth 1 --branch v3.7.1 \
  https://github.com/etcd-io/etcd.git etcd-source
cd etcd-source
go install -v ./tools/etcd-dump-db
将工具的安装目录加入 PATH 后,即可直接执行 etcd-dump-db。默认安装位置为 $HOME/go/bin;自定义 Go 安装路径时,可在源码目录中通过以下命令查看实际位置:
下面四个命令使用快照备份中导出的 snapshot.db,也可以传入 etcd 数据目录。
list-bucket¶
列出数据库中的 bucket。bucket 是 bbolt 组织键值记录的存储分区,其中名为 key 的 bucket 保存 MVCC 版本记录:
$ etcd-dump-db list-bucket snapshot.db
alarm
auth
authRoles
authUsers
cluster
key
lease
members
members_removed
meta
hash¶
计算数据库内容的哈希。输出包含文件路径和哈希值,下面省略具体数值:
iterate-bucket¶
按逆序遍历指定 bucket 中的记录。这里查看 key bucket,--limit 3 最多输出三条记录,--decode 将内部编码转换为可读字段。
假设快照保留了三次写入:revision 2 创建 /key1,revision 3 创建 /key2,revision 4 更新 /key1:
$ etcd-dump-db iterate-bucket snapshot.db key --limit 3 --decode
rev={Revision:{Main:4 Sub:0} tombstone:false}, value=[key "/key1" | val "value-1a" | created 2 | mod 4 | ver 2]
rev={Revision:{Main:3 Sub:0} tombstone:false}, value=[key "/key2" | val "value-2" | created 3 | mod 3 | ver 1]
rev={Revision:{Main:2 Sub:0} tombstone:false}, value=[key "/key1" | val "value-1" | created 2 | mod 2 | ver 1]
输出中的两条 /key1 记录保存了不同版本:(2, 0) 对应创建时的旧值 value-1,(4, 0) 对应更新后的新值 value-1a。更新会新增一条版本记录,旧记录在历史压缩前仍可保留。
以新记录 Main:4 Sub:0、created 2、mod 4、ver 2 为例:
Main:4:这次修改使用的全局 revision 为4。Sub:0:这是该事务中的第一项键值修改,序号从0开始。(Main, Sub)一起定位底层的版本记录。created 2:/key1在 revision2创建,更新时保留这个值。mod 4:这一版本由 revision4的修改产生。ver 2:这是/key1自创建以来的第2个版本;创建时为1,本次更新后变为2。它是单个 key 的版本计数,与全局 revision 不同。
scan-keys¶
扫描数据库页,查找 revision 不小于指定起点的键值记录。数据库部分损坏、无法正常遍历 bucket 时,也可用它尝试查找仍可解析的记录。下面从 revision 2 开始扫描,并只显示包含 /key1 的行:
$ etcd-dump-db scan-keys snapshot.db 2 | grep '/key1'
pageID=5, index=0/2, rev={Revision:{Main:2 Sub:0} tombstone:false}, value=[key "/key1" | val "value-1" | created 2 | mod 2 | ver 1]
pageID=5, index=2/2, rev={Revision:{Main:4 Sub:0} tombstone:false}, value=[key "/key1" | val "value-1a" | created 2 | mod 4 | ver 2]
以上是沿用前面三条记录的示例输出,页编号和位置以实际文件为准:
pageID=5:记录位于数据库文件的第5号页。index=0/2:记录在该页中的索引为0,该页最后一条记录的索引为2;索引从0开始。Main:2、Main:4:分别对应/key1的旧值value-1和新值value-1a。
scan-keys 按物理页扫描,输出不保证按 revision 排序。
etcdedit¶
etcdedit 直接连接 etcd,将其中以 Kubernetes Protobuf 或 JSON 保存的资源对象解码为 YAML,并支持编辑后写回。
macOS 可以通过 Homebrew 安装,详见 etcdedit 安装说明:
使用 etcdedit 前,也需要设置 ETCDCTL_ENDPOINTS 指定 Kubernetes 的 etcd 地址;使用 TLS 时,还需设置 ETCDCTL_CACERT、ETCDCTL_CERT 和 ETCDCTL_KEY 指定证书与私钥。设置方法见 Value 编码中的连接命令;同一终端中已设置的变量可以直接复用。
get¶
假设要查询 default namespace 中的 nginx Pod,先列出该 namespace 下的 Pod key,找到对应路径:
将查到的 key 交给 etcdedit get,读取对象并解码为 YAML,以下保留主要字段:
$ etcdedit get /registry/pods/default/nginx
apiVersion: v1
kind: Pod
metadata:
  labels:
    app: nginx
  name: nginx
  namespace: default
  # ...
spec:
  containers:
    - image: nginx:1.27
      name: nginx
      # ...
status:
  phase: Pending
  # ...
edit¶
用编辑器修改对象,保存退出后写回 etcd。edit 会检查 mod_revision,对象已被其他客户端修改时,拒绝覆盖:
$ etcdedit edit /registry/pods/default/nginx
Updated /registry/pods/default/nginx
Backup of original saved to: /tmp/etcdedit-backup-<timestamp>.bin
apply¶
apply 将 YAML 对象写入指定 key,已存在时覆盖原值。-f - 从标准输入读取;下面创建 ConfigMap,名称和 namespace 从 key 路径补入:
$ etcdedit apply -f - /registry/configmaps/default/my-config <<'EOF'
apiVersion: v1
kind: ConfigMap
metadata:
  labels:
    foo: bar
data:
  key1: value1
EOF
Setting metadata.name to "my-config" (derived from etcd key).
Setting metadata.namespace to "default" (derived from etcd key).
Created /registry/configmaps/default/my-config
etcd 集群搭建¶
etcd Clustering Guide 介绍了三种建立新集群时发现成员的方式:
- Static:启动前确定各成员的名称和 Peer URL,通过
--initial-cluster配置完整成员列表。 - etcd Discovery:各成员向独立的发现服务注册自己的信息,再从该服务取得集群的初始成员列表。
- DNS Discovery:各成员查询 DNS SRV 记录,获取其他成员的 Peer 地址。
| 方式 | 初始成员列表的来源 | 适用条件 |
|---|---|---|
Static |
每个成员配置相同的 --initial-cluster |
成员名称和 Peer URL 在启动前已经确定 |
etcd Discovery |
独立的 etcd discovery service 收集成员注册信息 | 各成员在启动前无法取得完整成员列表,且已有可用的 discovery service |
DNS Discovery |
DNS SRV 记录 | 成员拥有稳定域名,DNS 记录可以在启动前配置 |
Static¶
Static 通过 --initial-cluster 指定完整的成员名称和 Peer URL。下面这些参数都有默认值,但跨主机搭建三成员集群时,需要显式配置成员名称、成员列表和可达地址。表中的“配置要求”针对下面的三主机示例,默认值见 etcd 配置选项。
| 参数 | 作用 | 默认值 | 配置要求 |
|---|---|---|---|
--name |
本成员名称,与成员列表中的名称一致 | default |
需要,分别设为 infra0、infra1、infra2 |
--data-dir |
保存 WAL、Snapshot 和 backend 数据库 | <name>.etcd |
可省略;指定后便于管理数据位置,每个进程独占目录 |
--listen-peer-urls |
实际监听成员间通信的地址 | http://localhost:2380 |
需要,监听其他主机能够连接的网络接口 |
--initial-advertise-peer-urls |
向其他成员公布本成员的 Peer 地址 | http://localhost:2380 |
需要,与成员列表中本成员的 URL 一致 |
--listen-client-urls |
实际监听客户端请求的地址 | http://localhost:2379 |
需要远程访问时设置;默认只监听本机 |
--advertise-client-urls |
向客户端公布访问地址 | http://localhost:2379 |
需要远程访问时设置为客户端可达的地址 |
--initial-cluster |
初始成员列表,格式为 name=peerURL |
default=http://localhost:2380 |
需要,各成员配置相同的完整列表 |
--initial-cluster-token |
区分不同的初始集群 | etcd-cluster |
可省略;建议每套新集群使用不同 token,同一集群保持一致 |
--initial-cluster-state |
创建新集群或加入已有集群 | new |
新建时可省略;登记后加入已有集群时设为 existing |
配置示例:三成员 Static 集群
下面三组命令分别在对应主机执行。三台主机的 --initial-cluster、--initial-cluster-token 和 --initial-cluster-state 完全相同,本机的名称、监听地址和广播地址各不相同。
# 在 infra0.example.com(10.0.1.10)上执行
# 本机名称为 infra0,Peer 和客户端地址使用 10.0.1.10。
etcd \
  --name infra0 \
  --data-dir /var/lib/etcd \
  --initial-advertise-peer-urls http://10.0.1.10:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --advertise-client-urls http://10.0.1.10:2379 \
  --listen-client-urls http://10.0.1.10:2379 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster-state new

# 在 infra1.example.com(10.0.1.11)上执行
# 本机名称为 infra1,Peer 和客户端地址使用 10.0.1.11。
etcd \
  --name infra1 \
  --data-dir /var/lib/etcd \
  --initial-advertise-peer-urls http://10.0.1.11:2380 \
  --listen-peer-urls http://10.0.1.11:2380 \
  --advertise-client-urls http://10.0.1.11:2379 \
  --listen-client-urls http://10.0.1.11:2379 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster-state new

# 在 infra2.example.com(10.0.1.12)上执行
# 本机名称为 infra2,Peer 和客户端地址使用 10.0.1.12。
etcd \
  --name infra2 \
  --data-dir /var/lib/etcd \
  --initial-advertise-peer-urls http://10.0.1.12:2380 \
  --listen-peer-urls http://10.0.1.12:2380 \
  --advertise-client-urls http://10.0.1.12:2379 \
  --listen-client-urls http://10.0.1.12:2379 \
  --initial-cluster infra0=http://10.0.1.10:2380,infra1=http://10.0.1.11:2380,infra2=http://10.0.1.12:2380 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster-state new
etcd Discovery¶
etcd Discovery 借助另一套运行中的 etcd 集群收集新成员的名称和 Peer URL。注册数量达到预设成员数后,各成员取得完整列表并建立新集群。
每套新集群使用独立的 discovery token,初始化失败后重建也需更换 token,详见 v3 Discovery Protocol。
下图展示了 discovery service 如何把三个彼此未知的成员汇总成同一份初始成员列表。
sequenceDiagram
    participant O as Operator
    participant D as Discovery service
    participant M0 as infra0
    participant M1 as infra1
    participant M2 as infra2

    O->>D: Set token and expected size = 3
    M0->>D: Register name and peer URL
    M1->>D: Register name and peer URL
    M2->>D: Register name and peer URL
    D-->>M0: Return complete member list
    D-->>M1: Return complete member list
    D-->>M2: Return complete member list
    Note over M0,M2: Members bootstrap Raft with the same member list
配置示例:使用 v3 Discovery Protocol
假设有一台 IP 为 10.0.2.10 的主机,在该主机上启动单成员 etcd,作为独立的 discovery service:
etcd --data-dir=discovery.etcd \
  --listen-client-urls=http://10.0.2.10:2379 \
  --advertise-client-urls=http://10.0.2.10:2379
保持该进程运行,在另一个终端生成 token,并向发现服务登记期望成员数 3。DISCOVERY_ENDPOINTS 使用上面服务的客户端地址 http://10.0.2.10:2379,三台新成员都需要能够访问它;DISCOVERY_TOKEN 在本地生成,随后供三台新成员共同使用。
export DISCOVERY_ENDPOINTS="http://10.0.2.10:2379"
export DISCOVERY_TOKEN="$(uuidgen)"

etcdctl --endpoints="${DISCOVERY_ENDPOINTS}" \
  put "/_etcd/registry/${DISCOVERY_TOKEN}/_config/size" \
  "3"

printf '%s\n' "${DISCOVERY_TOKEN}"
put 返回 OK,随后打印新生成的 token。每次创建集群都应使用新的 UUID:
将上一步输出的 token 替换到三条命令的 <shared-discovery-token>。--discovery-endpoints 指向前面启动的 Discovery etcd 服务,地址为 http://10.0.2.10:2379。下面三组命令分别在对应主机执行,使用相同的 token 和发现服务地址。
# 在 infra0.example.com(10.0.1.10)上执行
etcd \
  --name infra0 \
  --data-dir /var/lib/etcd \
  --initial-advertise-peer-urls http://10.0.1.10:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --advertise-client-urls http://10.0.1.10:2379 \
  --listen-client-urls http://10.0.1.10:2379 \
  --discovery-token "<shared-discovery-token>" \
  --discovery-endpoints http://10.0.2.10:2379 \
  --initial-cluster-state new

# 在 infra1.example.com(10.0.1.11)上执行
etcd \
  --name infra1 \
  --data-dir /var/lib/etcd \
  --initial-advertise-peer-urls http://10.0.1.11:2380 \
  --listen-peer-urls http://10.0.1.11:2380 \
  --advertise-client-urls http://10.0.1.11:2379 \
  --listen-client-urls http://10.0.1.11:2379 \
  --discovery-token "<shared-discovery-token>" \
  --discovery-endpoints http://10.0.2.10:2379 \
  --initial-cluster-state new

# 在 infra2.example.com(10.0.1.12)上执行
etcd \
  --name infra2 \
  --data-dir /var/lib/etcd \
  --initial-advertise-peer-urls http://10.0.1.12:2380 \
  --listen-peer-urls http://10.0.1.12:2380 \
  --advertise-client-urls http://10.0.1.12:2379 \
  --listen-client-urls http://10.0.1.12:2379 \
  --discovery-token "<shared-discovery-token>" \
  --discovery-endpoints http://10.0.2.10:2379 \
  --initial-cluster-state new
discovery service 启用 TLS 或身份认证时,还需要配置 --discovery-cacert、--discovery-cert、--discovery-key 或 --discovery-user 等连接参数。
DNS Discovery¶
DNS Discovery 通过 DNS SRV 记录发现新集群的初始成员。SRV 记录用于指定服务所在的主机名和端口,主机名再通过 A 或 AAAA 记录解析为 IP。
--discovery-srv example.com:指定查询 SRV 记录的域名,各成员使用相同配置。- Peer 服务记录:先查询
_etcd-server-ssl._tcp.example.com,用于 TLS 通信;未找到时再查询_etcd-server._tcp.example.com,用于明文通信。 - 成员地址:
--initial-advertise-peer-urls中的地址解析后,必须与 SRV 记录中的某个成员地址匹配,etcd 据此识别本成员。
配置示例:使用 DNS SRV 记录
下面的 DNS 记录定义三个成员的地址和 Peer 端口。三条 _etcd-server 记录共同组成初始成员列表。
infra0.example.com. 300 IN A 10.0.1.10
infra1.example.com. 300 IN A 10.0.1.11
infra2.example.com. 300 IN A 10.0.1.12

_etcd-server._tcp.example.com. 300 IN SRV 0 0 2380 infra0.example.com.
_etcd-server._tcp.example.com. 300 IN SRV 0 0 2380 infra1.example.com.
_etcd-server._tcp.example.com. 300 IN SRV 0 0 2380 infra2.example.com.
以第一条 SRV 记录为例,各字段表示:
300:DNS TTL,单位为秒。IN:Internet DNS class。SRV:记录类型。- 第一个
0:priority,数值较小的记录优先。 - 第二个
0:weight,同一 priority 下的相对权重。 2380:etcd Peer 端口。infra0.example.com.:target,Peer endpoint 对应的主机名。
SRV 记录告诉 etcd:哪些主机提供成员间通信服务,以及使用哪个端口;A 记录再将这些主机名解析为 IPv4 地址。 例如,SRV 返回 infra0.example.com:2380,A 记录返回 10.0.1.10,组合后得到 Peer 地址 10.0.1.10:2380。
配置好上述 DNS 记录后,启动前使用 dig 检查。预期返回三个成员的主机名、Peer 端口和对应 IP:
$ dig +noall +answer SRV _etcd-server._tcp.example.com
_etcd-server._tcp.example.com. 300 IN SRV 0 0 2380 infra0.example.com.
_etcd-server._tcp.example.com. 300 IN SRV 0 0 2380 infra1.example.com.
_etcd-server._tcp.example.com. 300 IN SRV 0 0 2380 infra2.example.com.

$ dig +noall +answer infra0.example.com infra1.example.com infra2.example.com
infra0.example.com. 300 IN A 10.0.1.10
infra1.example.com. 300 IN A 10.0.1.11
infra2.example.com. 300 IN A 10.0.1.12
--discovery-srv example.com 指定用于发现成员的 DNS 域名。 etcd 会查询该域名下的 SRV 记录;本例通过前面配置的 _etcd-server._tcp.example.com,取得三个成员的主机名和 Peer 端口,生成初始成员列表,因此无需手动填写 --initial-cluster。
下面三组命令分别在对应主机执行,均使用 --discovery-srv example.com,从同一组 DNS 记录发现成员。
# 在 infra0.example.com(10.0.1.10)上执行
etcd \
  --name infra0 \
  --data-dir /var/lib/etcd \
  --discovery-srv example.com \
  --initial-advertise-peer-urls http://infra0.example.com:2380 \
  --listen-peer-urls http://10.0.1.10:2380 \
  --advertise-client-urls http://infra0.example.com:2379 \
  --listen-client-urls http://10.0.1.10:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster-state new

# 在 infra1.example.com(10.0.1.11)上执行
etcd \
  --name infra1 \
  --data-dir /var/lib/etcd \
  --discovery-srv example.com \
  --initial-advertise-peer-urls http://infra1.example.com:2380 \
  --listen-peer-urls http://10.0.1.11:2380 \
  --advertise-client-urls http://infra1.example.com:2379 \
  --listen-client-urls http://10.0.1.11:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster-state new

# 在 infra2.example.com(10.0.1.12)上执行
etcd \
  --name infra2 \
  --data-dir /var/lib/etcd \
  --discovery-srv example.com \
  --initial-advertise-peer-urls http://infra2.example.com:2380 \
  --listen-peer-urls http://10.0.1.12:2380 \
  --advertise-client-urls http://infra2.example.com:2379 \
  --listen-client-urls http://10.0.1.12:2379 \
  --initial-cluster-token etcd-cluster-1 \
  --initial-cluster-state new
etcd 运维¶
运行 etcd 时,重点关注磁盘读写延迟、成员间的网络延迟,以及剩余存储空间。硬件配置可以参考 etcd Hardware recommendations,再按实际数据量和请求量做压测。
硬件配置¶
- CPU:普通负载通常需要 2–4 核;服务数千客户端或每秒数万次请求时,可考虑 8–16 个独占核心。
- 内存:主要用于缓存键值数据和维护 Watcher。普通负载通常 8 GB 足够;数百万个 Key、数千个 Watcher 的场景可考虑 16–64 GB。
- 磁盘:优先使用低延迟 SSD,容量可参考官方小规模部署示例的 50 GB,再按数据库、WAL 和快照的占用预留空间。写盘过慢会增加请求延迟,严重时可能触发心跳超时和重新选举。
- 网络:成员间需要低延迟、可靠的网络。普通负载通常使用理论带宽为 125 MB/s 的网络即可;数据量较大时,理论带宽为 1,250 MB/s 的网络有助于缩短故障成员的数据恢复时间。
下表列出了不同负载下的 etcd 官方硬件配置示例。
| 负载档位 | Kubernetes 示例节点数 | GCE 实例 | vCPU | 内存(GB) | 磁盘 | 最大并发 IOPS | 磁盘带宽(MB/s) |
|---|---|---|---|---|---|---|---|
| Small | 50 | n1-standard-2 | 2 | 7.5 | 50 GB PD SSD | 1,500 | 25 |
| Medium | 250 | n1-standard-4 | 4 | 15 | 150 GB PD SSD | 4,500 | 75 |
| Large | 1,000 | n1-standard-8 | 8 | 30 | 250 GB PD SSD | 7,500 | 125 |
| xLarge | 3,000 | n1-standard-16 | 16 | 60 | 500 GB PD SSD | 15,000 | 250 |
监控指标¶
etcd 默认在客户端监听地址的 /metrics 提供 Prometheus 指标,例如 http://127.0.0.1:2379/metrics。Prometheus 需要分别采集每个成员,配置见 etcd Monitoring。
--listen-metrics-urls:指定额外的指标监听地址,默认为空。例如设置为http://127.0.0.1:2381后,可通过http://127.0.0.1:2381/metrics读取指标。--metrics:默认basic;设为extensive后增加服务端 gRPC 请求延迟直方图,详见 etcd 监控参数。
下表列出常用指标及读法,完整列表见 etcd Metrics。
| 关注点 | 指标 | 读法 |
|---|---|---|
| 采集状态 | up |
Prometheus 生成的指标,1 表示采集成功,0 表示失败 |
| Leader | etcd_server_has_leader、etcd_server_is_leader |
分别表示该成员是否有 Leader、是否自身为 Leader;1 为是 |
| Leader 变化 | etcd_server_leader_changes_seen_total |
用 increase() 查看一段时间内的选举变化次数 |
| Raft Proposal | etcd_server_proposals_pending、etcd_server_proposals_failed_total |
分别表示待提交数量和累计失败次数;持续积压或失败增加时需要排查 |
| 磁盘延迟 | etcd_disk_wal_fsync_duration_seconds、etcd_disk_backend_commit_duration_seconds |
分别反映 WAL 同步和 backend 提交耗时,可用 histogram_quantile() 查看 P99 |
| 成员网络 | etcd_network_peer_round_trip_time_seconds |
成员间通信的往返延迟,可用 histogram_quantile() 查看 P99 |
| 数据库空间 | etcd_mvcc_db_total_size_in_bytes、etcd_mvcc_db_total_size_in_use_in_bytes、etcd_server_quota_backend_bytes |
分别表示数据库已分配空间、实际使用空间和配额;关注配额使用率及空闲空间大小 |
| gRPC 请求 | grpc_server_started_total、grpc_server_handled_total |
用 rate() 查看请求速率,按 grpc_code 区分处理结果 |
告警¶
告警重点关注成员不可用、Leader 频繁变化、磁盘与网络延迟、数据库空间不足。查询与规则可参考:
- etcd 官方告警规则:查看 etcd 告警使用的 PromQL 表达式和阈值。
- Prometheus 查询基础:了解指标筛选与聚合方法。
- Prometheus 告警规则配置:配置告警条件、持续时间和说明。
Grafana Dashboard¶
将 etcd 官方 Dashboard JSON 导入 Grafana,并选择采集 etcd 指标的 Prometheus 数据源。面板展示成员状态、请求量、数据库大小、磁盘延迟和网络流量。
图:etcd Grafana Dashboard。来源:etcd Monitoring。
相关资料¶
- Raft 论文:In Search of an Understandable Consensus Algorithm
- The Secret Lives of Data:Raft 交互动画
- etcd API
- etcd 数据模型
- etcd API 一致性保证
- Etcd 教程(五):Watch 机制原理分析
- Leipzig Gophers #19: A Journey into the Kubernetes ListerWatcher Rabbit Hole(视频)
- etcd Deep Dive at Golang Leipzig Meetup:KV、Revision、Compaction 与 Watch 命令示例
- The Anatomy of Kubernetes ListWatch(): Prologue
- Onwards to the Core: etcd — Watch Flow
- etcd 故障模式
- etcd Hardware recommendations
- etcd Tuning
- etcd Maintenance
- etcd 持久存储文件
- etcd 集群搭建
- etcd v3 Discovery Protocol
- etcd 三成员演示集群
- etcd Developer Tasks
- etcd Monitoring
- etcd Metrics
- etcd Monitoring Mixin
- etcdctl 命令参考
- etcdutl 命令参考
- etcdedit
- etcd Disaster Recovery
- Kubernetes API Concepts
- KEP-2340:缓存一致性读取(Consistent Reads from Cache)
- KEP-4988:Snapshottable API Server Cache
- Kubernetes 官方 etcd 运维指南