Scheduler:Pod 调度机制
Kubernetes Scheduler 是 Kubernetes 的控制面组件,负责为尚未分配节点的 Pod 选择合适的运行节点。它根据 Pod 的资源请求、调度约束和节点的可用资源筛选候选节点,再通过评分选出目标节点。选定节点后,调度器通过 API Server 提交 Pod 与节点的绑定关系。kube-scheduler 是 Kubernetes 的默认调度器,也可以按需部署自定义调度器,满足不同的调度需求。
Scheduling Framework
Scheduling Framework 是 Kubernetes 调度器的可插拔架构。它由一组直接编译进调度器的插件 API 组成,使大多数调度功能可以通过插件实现,同时让调度核心保持轻量、易于维护。更多设计细节见 Scheduling Framework 设计提案。
整体架构
下图展示了 Pod 的调度流程,以及 Scheduling Framework 在各阶段提供的扩展点。插件通过实现扩展点接口参与调度。同一个插件可以实现多个接口,在不同阶段执行相应的逻辑。各扩展点启用哪些插件,可以通过调度器配置指定。
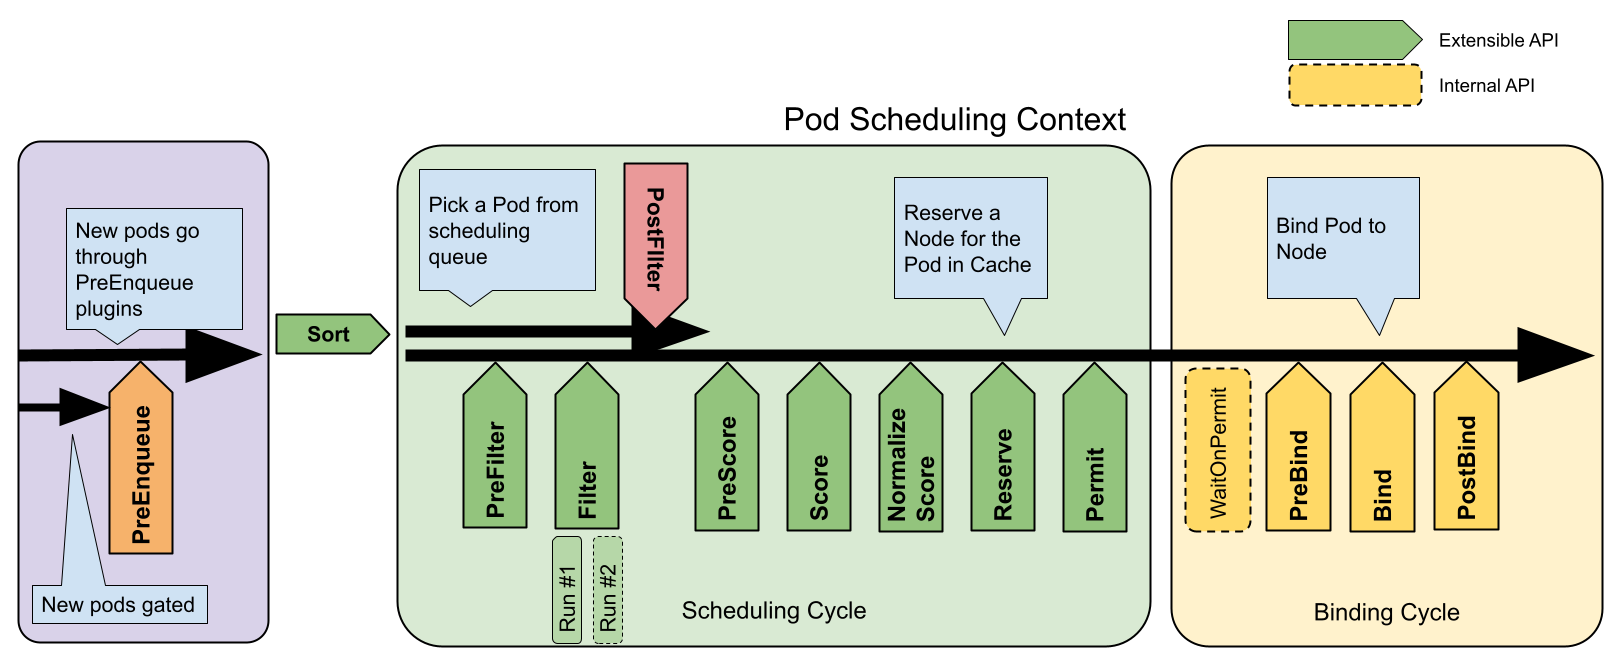
图:Scheduling Framework 扩展点。来源:Kubernetes Scheduling Framework,CC BY 4.0。
Pod 的调度流程涉及调度队列、调度阶段和绑定阶段:
- 调度队列(Scheduling queue):
PreEnqueuePlugin决定 Pod 能否进入活动队列,QueueSortPlugin决定活动队列中的先后顺序。 - 调度阶段(Scheduling cycle):Scheduler 串行处理 Pod,从队列中取出一个 Pod,过滤不符合条件的 Node,再对剩余 Node 评分,选出目标 Node。
- 绑定阶段(Binding cycle):Scheduler 可以并发执行不同 Pod 的绑定阶段,完成卷绑定等准备工作,再将 Pod 绑定到选定的 Node,并通过 API Server 保存结果。
扩展点接口
默认 Profile 通过 MultiPoint 启用插件,同一个插件会进入它所实现的所有扩展点。下表列出普通 Pod 调度路径中的扩展点接口及默认插件。
| 接口 | 所属阶段 | 作用 | 默认插件 |
|---|---|---|---|
PreEnqueuePlugin |
调度队列 | 检查 Pod 是否具备入队条件 | SchedulingGates、DynamicResources、DefaultPreemption |
QueueSortPlugin |
调度队列 | 决定 activeQ 中 Pod 的取出顺序 |
PrioritySort |
PreFilterPlugin |
调度阶段 | 为后续过滤准备共享数据,并可限定需要检查的候选节点。 | NodeAffinity、NodePorts、NodeResourcesFit、VolumeRestrictions、NodeVolumeLimits、VolumeBinding、VolumeZone、PodTopologySpread、InterPodAffinity、DynamicResources、NodeDeclaredFeatures |
FilterPlugin |
调度阶段 | 逐个检查 Node 是否满足硬约束 | NodeUnschedulable、NodeName、TaintToleration、NodeAffinity、NodePorts、NodeResourcesFit、VolumeRestrictions、NodeVolumeLimits、VolumeBinding、VolumeZone、PodTopologySpread、InterPodAffinity、DynamicResources、NodeDeclaredFeatures |
PostFilterPlugin |
调度阶段 | 没有满足调度条件的节点时,尝试释放资源或执行抢占 | DynamicResources、DefaultPreemption |
PreScorePlugin |
调度阶段 | 准备全部候选 Node 共用的评分数据 | TaintToleration、NodeAffinity、NodeResourcesFit、VolumeBinding、PodTopologySpread、InterPodAffinity、NodeResourcesBalancedAllocation |
ScorePlugin |
调度阶段 | 为通过过滤的节点计算分数 | TaintToleration、NodeAffinity、NodeResourcesFit、VolumeBinding、PodTopologySpread、InterPodAffinity、DynamicResources、NodeResourcesBalancedAllocation、ImageLocality |
ReservePlugin |
调度阶段及失败处理 | 通过 Reserve 记录临时状态,在调度或绑定失败时通过 Unreserve 撤销 |
VolumeBinding、DynamicResources |
PermitPlugin |
调度阶段 | 允许、等待或拒绝进入绑定阶段 | 无 |
PreBindPlugin |
绑定阶段 | 在提交绑定前完成卷或设备相关操作 | VolumeBinding、DynamicResources |
BindPlugin |
绑定阶段 | 向 API Server 提交 Pod 与 Node 的绑定关系 | DefaultBinder |
PostBindPlugin |
绑定阶段 | 在 Pod 绑定成功后执行收尾操作,例如清理插件状态 | 无 |
辅助接口
辅助接口用于补充入队、预处理和评分逻辑,没有独立的扩展点配置项。下表列出这些接口及实现它们的默认插件。
| 接口 | 所属阶段 | 作用 | 默认插件 |
|---|---|---|---|
EnqueueExtensions |
入队与重试 | 注册可能改变插件失败结果的集群事件,并通过 QueueingHint 判断 Pod 是否需要重新入队 |
SchedulingGates、NodeUnschedulable、NodeName、TaintToleration、NodeAffinity、NodePorts、NodeResourcesFit、VolumeRestrictions、NodeVolumeLimits、VolumeBinding、VolumeZone、PodTopologySpread、InterPodAffinity、DynamicResources、DefaultPreemption、NodeDeclaredFeatures |
PreFilterExtensions |
调度阶段 | 同步更新 PreFilter 的预计算状态 | InterPodAffinity、PodTopologySpread、VolumeRestrictions |
ScoreExtensions |
调度阶段 | 所有候选节点完成 Score 后,可通过 NormalizeScore 将同一插件的分数归一化到 0–100 |
TaintToleration、NodeAffinity、PodTopologySpread、InterPodAffinity、DynamicResources |
Pod 调度流程
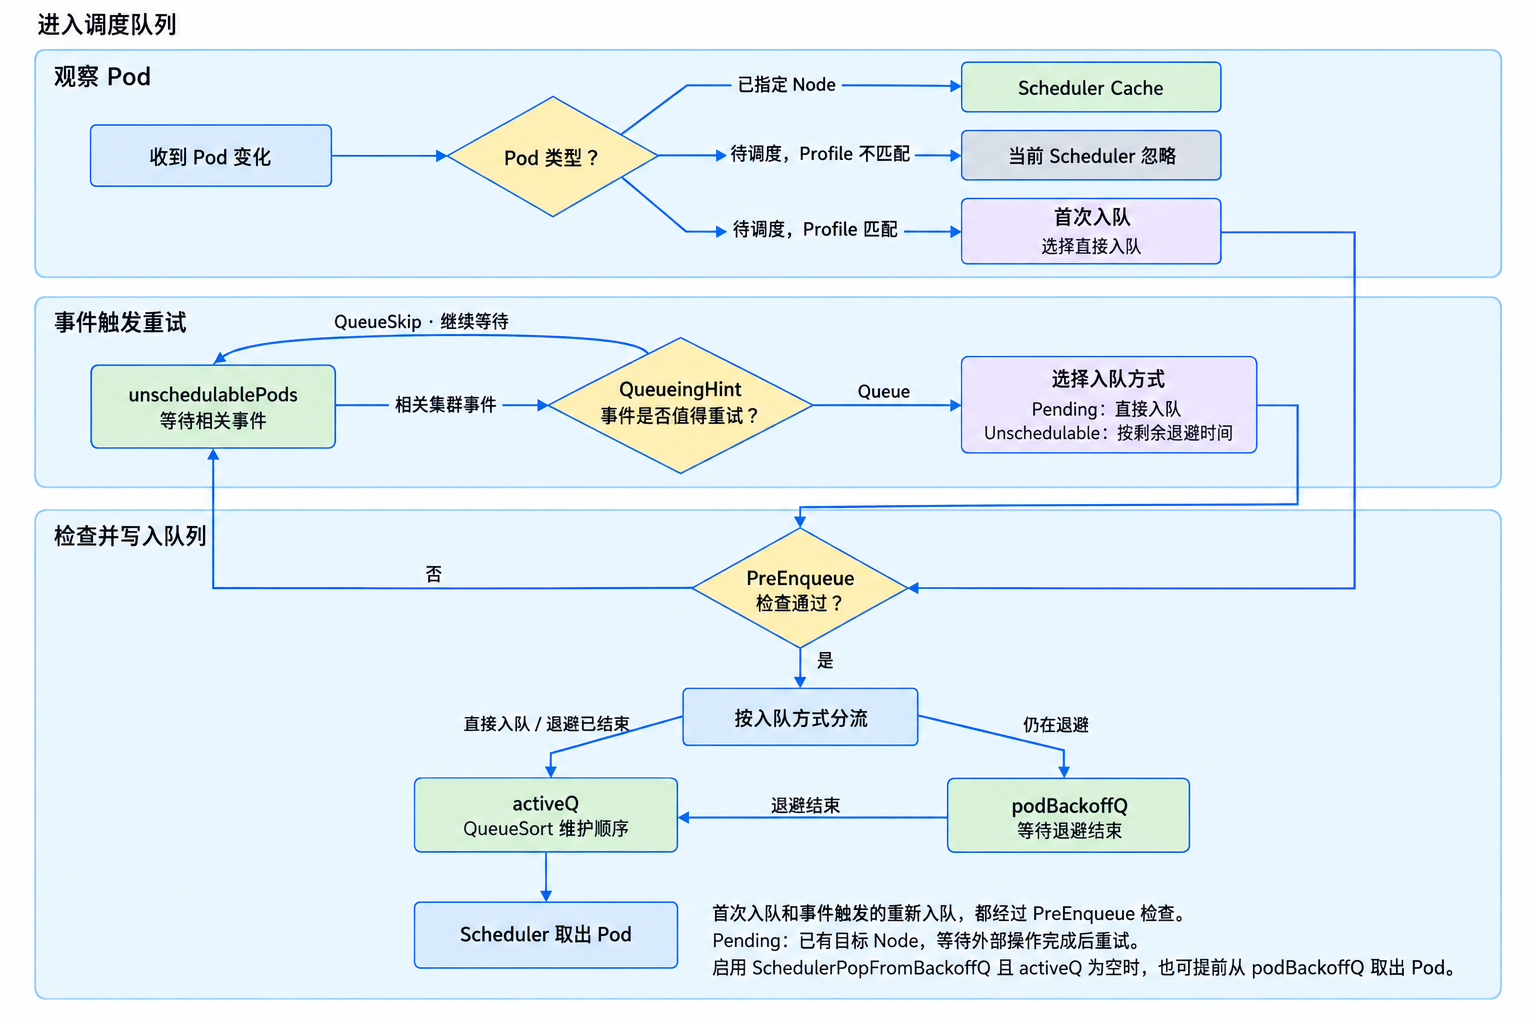
调度队列(Scheduling queue)
-
观察 Pod:Scheduler 观察 API Server 中的 Pod 变化,根据 Pod 是否已分配节点,分别处理:
- 已分配节点:Pod 的
spec.nodeName已设置。Scheduler 将它记录到本地 Scheduler Cache,用于统计目标节点的资源占用。 - 尚未分配节点:Pod 的
spec.nodeName为空。如果该 Pod 由当前 Scheduler 负责,则将它加入 SchedulingQueue,等待调度。
- 已分配节点:Pod 的
-
检查入队:PreEnqueue 检查 Pod 能否进入可调度队列。首次通过检查的 Pod 进入
activeQ;检查未通过时进入unschedulablePods。 - 等待重试:调度未能继续的 Pod 进入
unschedulablePods,等待可能改变结果的集群事件。Unschedulable表示当前条件下无法完成调度;Pending表示已经选出目标 Node,但插件需要等待外部组件根据调度结果完成操作,Pod 暂时不能进入绑定阶段。相关事件触发重新入队后,PendingPod 直接进入activeQ;UnschedulablePod 在退避尚未结束时进入podBackoffQ,退避结束后进入activeQ。
调度阶段(Scheduling cycle)
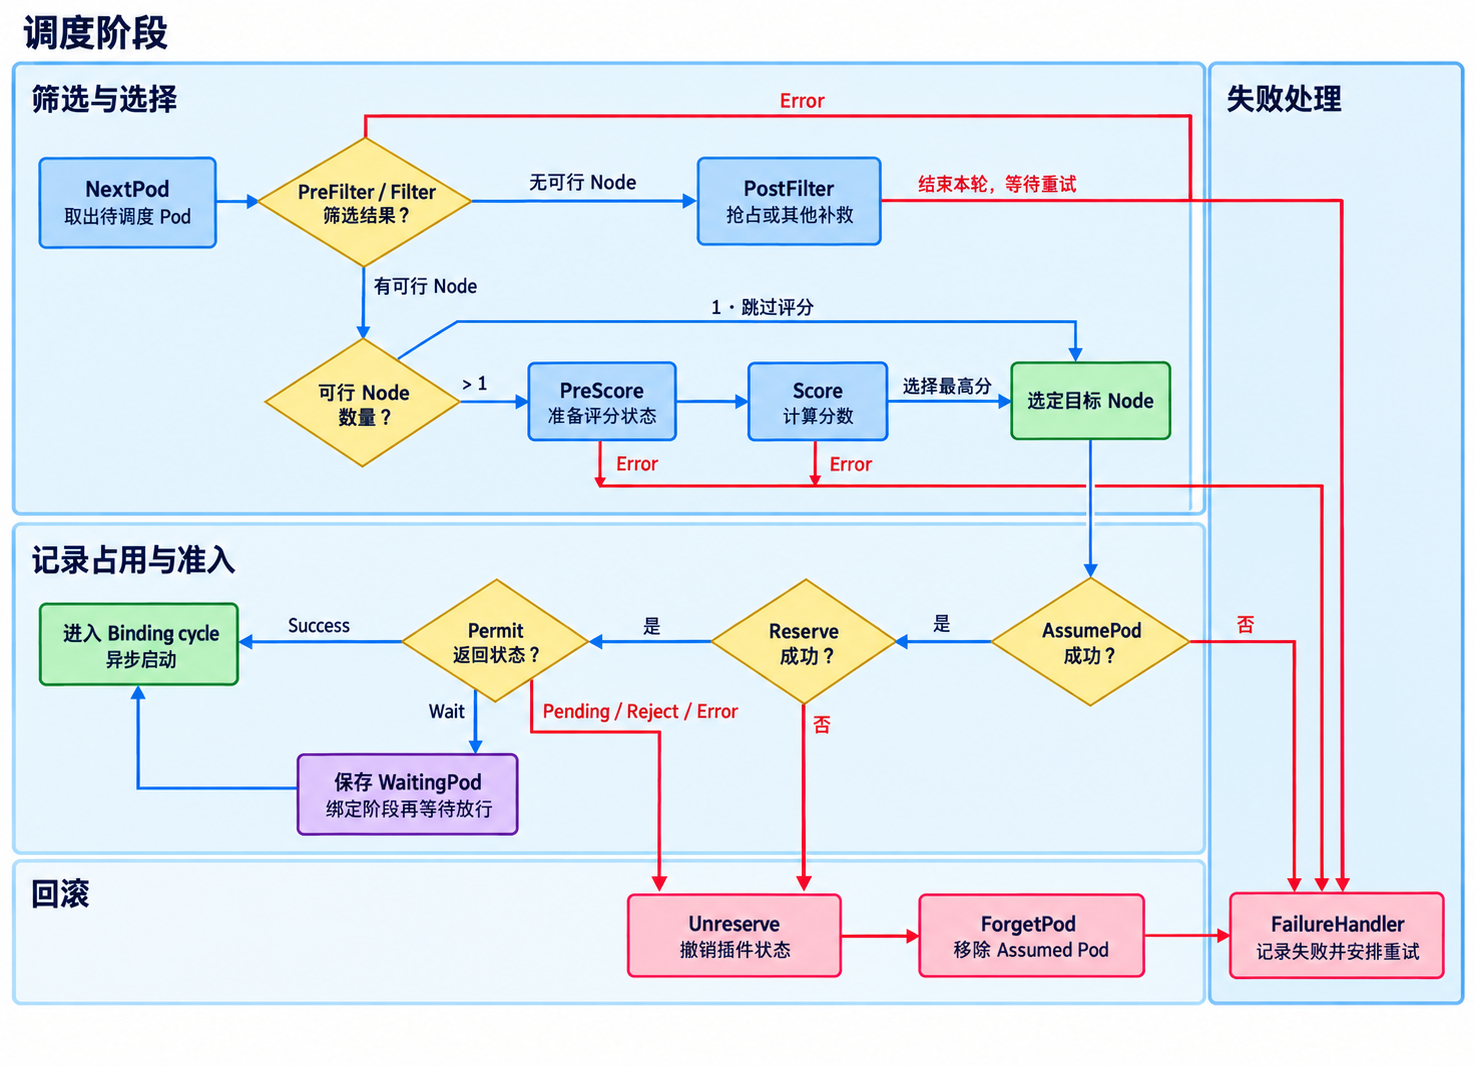
- 取出 Pod:Scheduler 从 SchedulingQueue 取出 Pod,读取当前的 Node 和资源状态。
- 筛选 Node:PreFilter 准备筛选所需的状态,Filter 排除不满足硬约束的 Node。没有可行 Node 时,PostFilter 尝试抢占或其他补救措施;仍无法选出 Node 时,由 FailureHandler 记录失败原因,并将 Pod 交回 SchedulingQueue 等待重试。
- 选择 Node:存在多个可行 Node 时,PreScore 准备评分所需的状态,Score 选择得分最高的 Node;只有一个可行 Node 时直接使用该 Node。
- 记录选择:Scheduler 在本地 Cache 中记录目标 Node 和资源占用。Reserve 保存可回滚的临时状态,例如卷的预绑定信息;Permit 决定继续绑定、等待其他条件满足,或者拒绝本次选择。Reserve 或 Permit 失败时,Scheduler 先运行
Unreserve撤销插件状态,再调用ForgetPod删除 Cache 中的 Assumed Pod。
绑定阶段(Binding cycle)
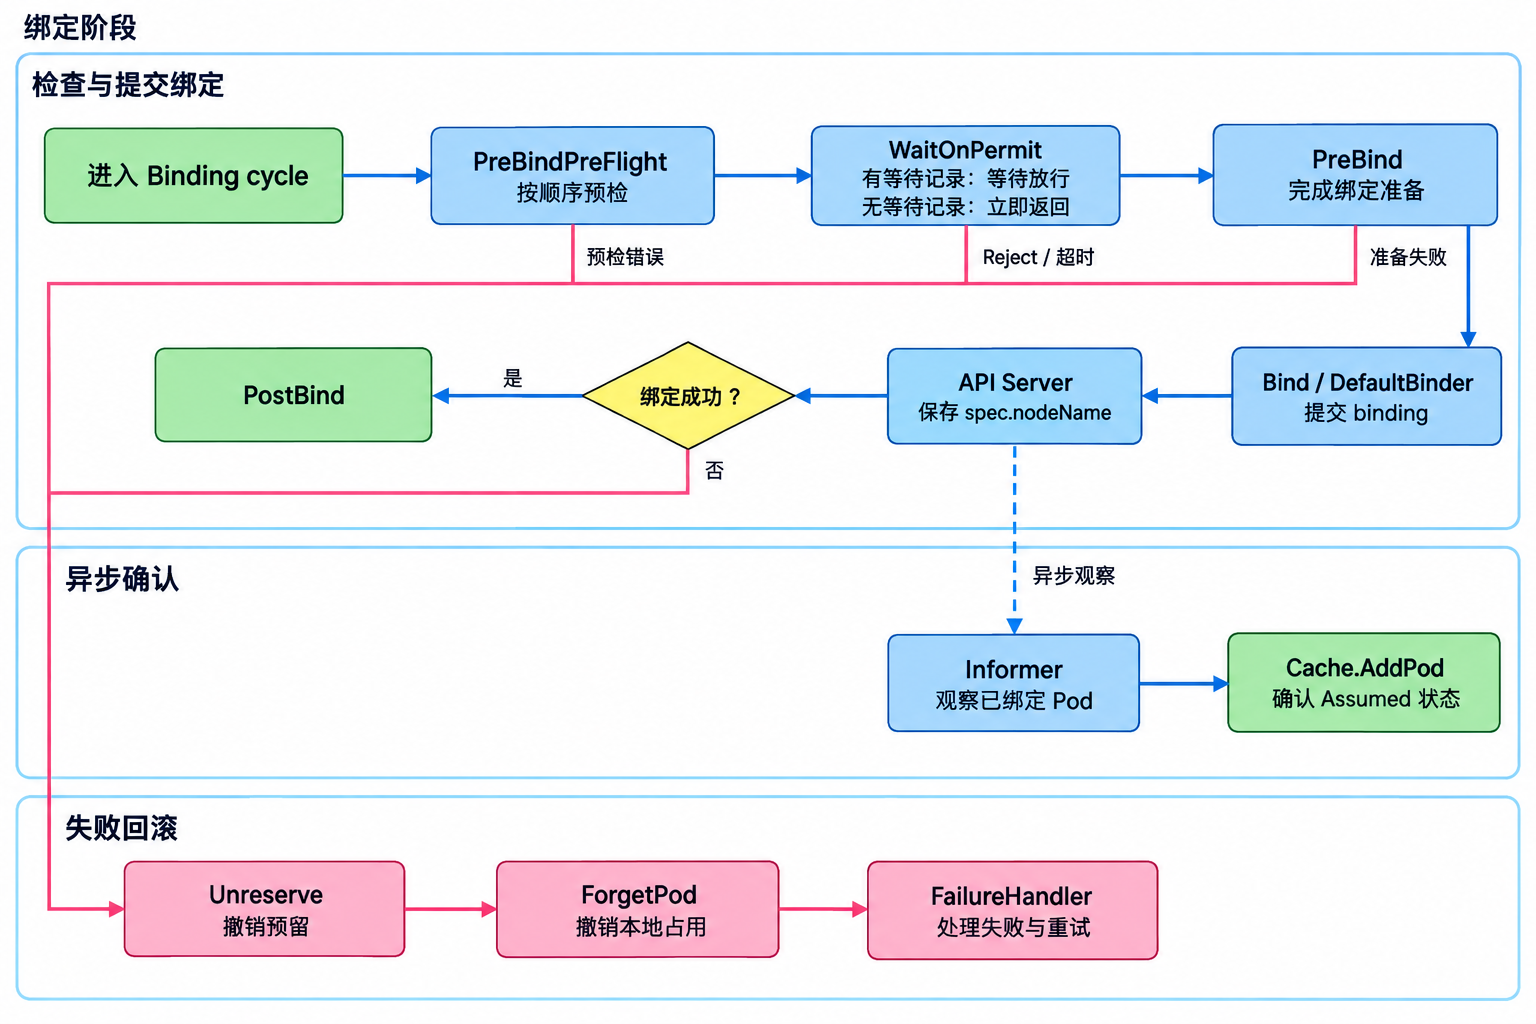
- 预检 PreBind 插件:Scheduler 按顺序调用各插件的
PreBindPreFlight,确定本次需要运行的插件及其并行执行能力。预检只做轻量检查,卷绑定等实际操作由后续PreBind完成。 - 等待 Permit 放行:Scheduler 调用 WaitOnPermit。只有 Permit 插件在调度阶段返回
Wait时,这一步才会阻塞;否则立即进入PreBind。等待期间保留目标 Node 的本地资源占用,插件拒绝或等待超时会撤销本次选择。 - 准备绑定:PreBind 完成 Pod 绑定到节点前所需的资源准备。例如,Pod 的 PVC 尚未绑定,而调度阶段已选好匹配的 PV,
VolumeBinding会提交卷绑定信息,并等待 PersistentVolumeBinder Controller 完成 PVC 与 PV 的绑定。这些准备成功后,后续Bind才会提交 Pod 与 Node 的绑定关系。 - 提交绑定:Bind 负责提交绑定结果。默认
DefaultBinder请求 Pod 的binding子资源,API Server 将目标 Node 写入spec.nodeName。 - 确认结果:PostBind 在绑定成功后运行。Scheduler 随后观察到已绑定的 Pod,并用新的 API 对象确认本地 Cache 中的 Assumed 状态。
调度队列(Scheduling queue)
Pod 进入调度队列前,PreEnqueue 检查它是否已具备开始调度的条件。Pod 入队后,QueueSort 决定 activeQ 中的取出顺序;调度失败的 Pod 重新入队时,EnqueueExtensions 和 QueueingHint 决定哪些集群事件可以触发重试。
PreEnqueue
PreEnqueue 检查 Pod 是否已经具备开始调度的前置条件。例如,Pod 的 spec.schedulingGates 仍有条目时,内置 SchedulingGates 插件会阻止它进入可调度队列;控制器移除全部 gate 后,Pod 才会重新参加调度。
| 默认插件 | 具体作用 |
|---|---|
SchedulingGates |
Pod 仍包含 spec.schedulingGates 时阻止入队,全部 gate 被移除后允许重新检查 |
DynamicResources |
检查 Pod 引用的 DRA ResourceClaim 是否存在并具备开始调度的条件 |
DefaultPreemption |
启用异步抢占时,阻止正在执行抢占操作的 Pod 或 PodGroup 重复进入调度队列 |
Kueue 通过 schedulingGates 控制 Pod 的调度时机
schedulingGates 适合由外部控制器决定 Pod 何时具备调度条件的场景。该字段只能在 Pod 创建时由客户端设置,或由 Admission Webhook 写入;Pod 创建后只能移除已有 gate,不能再添加。具体约束见 Kubernetes 的 Pod Scheduling Readiness。
下面的 Pod 设置了两个 scheduling gate。创建后,它保持 SchedulingGated 状态;两个 gate 全部移除后,Scheduler 才会把它放入可调度队列。
apiVersion: v1
kind: Pod
metadata:
  name: test-pod
spec:
  schedulingGates:
    - name: example.com/foo
    - name: example.com/bar
  containers:
    - name: pause
      image: registry.k8s.io/pause:3.6
Kueue 的 Pod 集成通过 Mutating Webhook 注入 kueue.x-k8s.io/admission gate。对应的 Workload 等待配额、ResourceFlavor 或 AdmissionCheck 时,Pod 保持 SchedulingGated,不会进入 activeQ。Workload 完成准入后,Kueue 移除自己管理的 gate;Pod 没有其他 gate 时,SchedulingGates 插件允许它进入调度队列。
Kueue 直接管理 Pod 时使用 schedulingGates 控制调度时机。Kueue 管理 Kubernetes Job时,通常通过 Job 的 spec.suspend 控制启动时机。
SchedulingQueue 准备将 Pod 放入 activeQ 或 backoffQ 时,依次调用当前 Profile 中的 PreEnqueuePlugin.PreEnqueue。全部插件返回 Success 后,Pod 才会进入目标队列;任一插件返回失败状态时,调用立即停止,队列记录拒绝它的插件,并将 Pod 转入 unschedulablePods。这条分流可以在 moveToActiveQ 和 moveToBackoffQ 中看到。此后只有该插件关注的事件或通配事件才会触发重新检查。
QueueSort
activeQ 中可能同时存在多个 Pod,QueueSort 决定 Scheduler 下一次取出哪一个。
| 默认插件 | 具体作用 |
|---|---|
PrioritySort |
优先级较高的 Pod 先取出;优先级相同时,入队更早的 Pod 先取出 |
| Pod | Priority | 入队时间 | 取出次序 |
|---|---|---|---|
| A | 100 | 10:02 | 2 |
| B | 50 | 10:00 | 3 |
| C | 100 | 10:01 | 1 |
Pod C 和 Pod A 的 Priority 相同,入队更早的 Pod C 先被取出;Pod B 的 Priority 较低,最后取出。因此,取出顺序为 C、A、B。
QueueSortPlugin.Less 每次比较两个 QueuedPodInfo,activeQ 的堆结构使用比较结果维护上述顺序。newQueuedPodInfo 创建队列对象时将 Timestamp 设置为当前时间;一次调度失败后,AddUnschedulableIfNotPresent 在 Pod 重新入队前刷新该字段。InitialAttemptTimestamp 在 Pod 第一次进入 activeQ 时设置,之后保持不变,用于计算端到端调度延迟。
一个 Scheduler 进程中的所有 Profile 共享同一条调度队列,因此必须使用相同的 QueueSort 插件和配置。profile.Map 的校验逻辑会拒绝不一致的配置。
EnqueueExtensions
插件拒绝 Pod 后,SchedulingQueue 需要知道哪些集群变化可能改变上次的调度结果。EnqueueExtensions 让插件注册自己关注的事件,避免无关的 Node、Pod 或 PVC 变化反复触发调度。
| 默认插件 | 具体作用 |
|---|---|
SchedulingGates |
关注 Pod 的 scheduling gate 是否已全部移除 |
NodeUnschedulable |
关注新 Node、Node 的 unschedulable taint 和目标 Pod 的 Toleration 变化 |
NodeName |
关注与 spec.nodeName 匹配的新 Node |
TaintToleration |
关注 Node Taint 和目标 Pod Toleration 的变化 |
NodeAffinity |
关注新 Node,以及 Node label 是否从不匹配变为匹配 |
NodePorts |
关注新 Node,以及占用冲突 hostPort 的 Pod 是否被删除 |
NodeResourcesFit |
关注 Node 可分配资源增加、已调度 Pod 删除或原地缩容 |
VolumeRestrictions |
关注 Pod 删除或 PVC 创建后,原有卷冲突是否消失 |
NodeVolumeLimits |
关注 CSINode、PVC、Pod 和 VolumeAttachment 的变化是否释放卷连接额度 |
VolumeBinding |
关注 Node、PV、PVC、StorageClass 和 CSI 容量信息是否出现可用的卷绑定方案 |
VolumeZone |
关注 Node、PV、PVC 和 StorageClass 的变化是否满足卷拓扑要求 |
PodTopologySpread |
关注 Pod 或 Node 的变化是否改善拓扑分布 |
InterPodAffinity |
关注 Pod 或 Node 的变化是否满足 Pod Affinity 或 Anti-Affinity |
DynamicResources |
关注 ResourceClaim、ResourceSlice、DeviceClass 等 DRA 对象是否提供可用设备 |
DefaultPreemption |
启用异步抢占时,关注被抢占 Pod 删除后抢占操作是否完成 |
NodeDeclaredFeatures |
关注 Node 声明的 Feature 或 Pod 所需 Feature 是否发生变化 |
Scheduler 启动时调用一次 EnqueueExtensions.EventsToRegister,并在运行期间沿用这份注册结果。该方法返回一组 ClusterEventWithHint:
例如,Pod 要求 Node 带有 storage=ssd label,但当前没有 Node 满足条件。Node label 更新后,NodeAffinity 的 QueueingHint 回调会重新检查该 Node:
- Node 从不匹配变为匹配时返回
Queue,Pod 可以重新入队。 - 更新后的 Node 仍不匹配时返回
QueueSkip,Pod 继续留在unschedulablePods。
Queue 只说明这次事件可能改变调度结果,不保证 Pod 已经具备调度条件,也不直接决定它进入哪个队列。
收到 Queue 后,SchedulingQueue 再根据上次的插件状态选择入队方式:
- 返回
Queue的插件此前将 Pod 标记为Pending时,Pod 跳过退避并进入activeQ。 - 返回
Queue的插件此前将 Pod 标记为Unschedulable时,Pod 根据剩余退避时间进入podBackoffQ或activeQ。
默认启用 SchedulerPopFromBackoffQ。Pod 从 unschedulablePods 写入 activeQ 或 podBackoffQ 前会重新运行 PreEnqueue;检查未通过时,Pod 继续留在 unschedulablePods。
PreEnqueue、PreFilter、Filter、Reserve 或 Permit 插件没有实现 EnqueueExtensions 时,Scheduler 会为它注册默认的全部已知集群事件。这样可以避免 Pod 因缺少事件注册而一直留在 unschedulablePods,代价是部分无关事件也会触发重新入队。EventsToRegister 返回错误时,Scheduler 无法启动。
调度阶段(Scheduling cycle)
调度阶段通过 Filter 筛选满足 Pod 资源请求和调度约束的节点,再通过 Score 评分选择目标节点。选定节点后,Scheduler 记录本地资源占用,并检查是否可以进入绑定阶段。
PreFilter
多个 PreFilter 插件按配置顺序串行执行,在当前 Pod 的一轮调度中各运行一次。插件按需读取当前 Pod 和候选节点的信息,并可将后续 Filter 需要复用的计算结果写入 CycleState。PreFilterPlugin.PreFilter 还可以返回 PreFilterResult,通过 NodeNames 限定后续检查的候选 Node。
例如,Pod 的必需节点亲和性通过 matchFields 限定 metadata.name 只能是 node-a 或 node-b。NodeAffinity.PreFilter 会将这两个名称写入 PreFilterResult.NodeNames,后续 Filter 只检查这两个 Node 是否满足资源、污点等其他约束。
| 默认插件 | 具体作用 |
|---|---|
NodeAffinity |
解析 nodeSelector、必需 Node Affinity 和 Scheduler 额外配置的 Node Affinity |
NodePorts |
收集 Pod 请求的 hostPort,供 Filter 检查端口冲突 |
NodeResourcesFit |
计算 Pod 的 CPU、内存、临时存储、Pod 数量和扩展资源请求 |
VolumeRestrictions |
收集 ReadWriteOncePod PVC 等卷信息,准备卷冲突检查 |
NodeVolumeLimits |
识别 Pod 使用的 CSI 卷,准备计算每个 Driver 的卷连接数量 |
VolumeBinding |
解析 Pod 的 PVC,并区分已绑定卷和需要延迟绑定的卷 |
VolumeZone |
读取已绑定 PV 的 zone 和 region 信息 |
PodTopologySpread |
计算硬性拓扑分布约束及各拓扑域中的匹配 Pod 数量 |
InterPodAffinity |
计算必需 Pod Affinity 和 Anti-Affinity 使用的拓扑计数 |
DynamicResources |
解析 DRA ResourceClaim,准备每个 Node 的设备分配状态 |
NodeDeclaredFeatures |
推导 Pod 所需的 Node Feature 集合 |
PreFilter 返回 Unschedulable 时,本轮不再检查 Node;返回 Skip 时,与它配套的 Filter 和 PreFilterExtensions 在本轮一起跳过。
Filter
Filter 检查候选 Node 是否满足 Pod 的硬约束。FilterPlugin.Filter 每次接收 Pod 和一台候选 Node 的 NodeInfo;同一 Node 通过全部 Filter 插件后,才会进入可行节点集合。
| 默认插件 | 具体作用 |
|---|---|
NodeUnschedulable |
检查 node.spec.unschedulable;只有 Pod 容忍对应状态时才允许使用该 Node |
NodeName |
Pod 指定了 spec.nodeName 时,只允许名称相同的 Node |
TaintToleration |
排除带有 Pod 无法容忍的 NoSchedule 或 NoExecute Taint 的 Node |
NodeAffinity |
检查 Node label 和名称是否满足 nodeSelector、必需 Node Affinity 以及 Scheduler 额外配置的 Node Affinity |
NodePorts |
检查 Pod 请求的 hostPort 是否与 Node 上已有 Pod 冲突 |
NodeResourcesFit |
检查 Node 的可分配 CPU、内存、临时存储、Pod 数量和扩展资源是否满足请求 |
VolumeRestrictions |
检查 ReadWriteOncePod PVC 和部分块存储类型是否与 Node 上已有 Pod 的卷冲突 |
NodeVolumeLimits |
按 CSI Driver 统计 Node 已连接和本次需要连接的卷,检查是否超过 CSINode 声明的上限 |
VolumeBinding |
检查已绑定 PV 的 Node Affinity;对于延迟绑定 PVC,寻找能够在当前 Node 上绑定或动态供应的卷 |
VolumeZone |
检查已绑定 PV 的 zone 和 region 是否与 Node 标签一致 |
PodTopologySpread |
检查 DoNotSchedule 约束的 maxSkew 和 minDomains,排除会破坏硬性拓扑分布的 Node |
InterPodAffinity |
检查必需的 Pod Affinity 和 Anti-Affinity,确认当前 Node 的拓扑域满足约束 |
DynamicResources |
检查已分配设备能否在当前 Node 使用,并尝试为尚未分配的 ResourceClaim 找到可用设备 |
NodeDeclaredFeatures |
检查 Node 声明的 Feature 是否包含 Pod 所需的全部 Feature |
Filter 插件的返回状态先决定当前节点的检查如何继续:
- Success:继续运行该节点的下一个 Filter 插件;全部通过后,该节点才进入可用于调度的节点集合。
- Unschedulable:停止该节点的后续 Filter 检查,将其排除,继续检查其他候选节点。该节点的问题可能通过资源释放或抢占解决。
- UnschedulableAndUnresolvable:同样排除该节点,继续检查其他候选节点。由于问题无法通过抢占解决,例如必需 label 不匹配,默认抢占插件也会跳过该节点。
- Error:终止本次调度,不再进入评分或 PostFilter,Pod 进入错误退避路径等待重试。
过滤结束且没有执行错误时,Scheduler 根据通过检查的节点数量继续处理:多个节点通过则进入 PreScore 和 Score;只有一个节点则直接选用。没有节点通过时,进入 PostFilter 尝试抢占等补救措施;本轮随后结束,Pod 交回队列等待重试。
Filter 接口接收 NodeInfo。NodeInfo 聚合 Node 对象、已经分配和 Assumed 的 Pod、资源请求、端口、PVC 与镜像状态,插件使用传入的 NodeInfo 完成当前节点判断。
PostFilter
当 PreFilter 或 Filter 没有留下可行 Node 时,Scheduler 调用 PostFilter,尝试通过抢占等方式为当前 Pod 腾出资源。
| 默认插件 | 具体作用 |
|---|---|
DynamicResources |
尝试清理尚未被其他 Pod 使用的 DRA ResourceClaim 分配,让后续调度重新选择设备 |
DefaultPreemption |
选择候选 Node 和需要移除的低优先级 Pod,并为当前 Pod 设置 nominated Node |
默认的抢占插件会跳过 UnschedulableAndUnresolvable 的 Node,并检查移除哪些低优先级 Pod 后能够容纳当前 Pod。找到候选方案后,插件发起抢占,并将当前 Pod 提名到选定的节点。本轮调度结束,Pod 返回队列等待重试。
等待期间,Scheduler 检查同级或低优先级的其他 Pod 时,会将已提名 Pod 的需求纳入 Filter 检查,保护它所需的资源。但提名不保证最终绑定到该节点:更高优先级的 Pod 可能先使用该节点;如果其他节点先满足条件,当前 Pod 也可能调度到其他节点。
PostFilterPlugin.PostFilter 只在 PreFilter 或 Filter 返回不可调度结果时运行。没有插件能够改善结果时,Scheduler 记录 FailedScheduling Event,并将 Pod 放回不可调度队列或退避队列。
PreFilterExtensions
PreFilterExtensions 在 Filter 的 Nominated Pod 检查和 PostFilter 的抢占模拟中按需调用。Scheduler 在 NodeInfo 副本中模拟加入或移除 Pod 时,分别通过 AddPod 或 RemovePod 同步更新 CycleState 中的预计算结果,供后续 Filter 使用。
| 默认插件 | 具体作用 |
|---|---|
InterPodAffinity |
Pod 集合变化时更新 Affinity 和 Anti-Affinity 的拓扑计数 |
PodTopologySpread |
Pod 集合变化时更新各拓扑域中的匹配 Pod 数量 |
VolumeRestrictions |
Pod 集合变化时更新 ReadWriteOncePod PVC 的使用计数 |
这两个方法主要用于以下两类调度计算:
-
Nominated Pod 检查:提名表示 Scheduler 为尚未绑定的 Pod 记录预期运行节点。提名本身不代表已经占用节点资源;如果 Filter 只按节点当前的资源占用检查,后续 Pod 可能先用掉提名 Pod 正在等待的资源。
因此,运行 Filter 前,Scheduler 会将提名到该节点、优先级不低于当前 Pod 的其他 Pod 加入
NodeInfo副本,并调用AddPod同步预计算结果,再检查计入这些提名 Pod 后,当前 Pod 能否调度。例如:- 先调度 Pod A:高优先级的 A 因资源不足触发抢占,Scheduler 将 Pod A 提名到
node-a,并开始删除选定的低优先级 Pod。 - Pod A 等待资源释放:被抢占的 Pod 尚未完全退出,A 暂时无法绑定,Scheduler 继续调度其他 Pod。
- 再调度 Pod B:检查
node-a时,Scheduler 将已提名到该节点的 Pod A 临时加入NodeInfo副本,并调用AddPod更新预计算结果,再判断计入 Pod A 的需求后,Pod B 是否仍能调度。
提名时,A 尚未绑定到节点;真正绑定后,目标节点才会写入 A 的
spec.nodeName。 - 先调度 Pod A:高优先级的 A 因资源不足触发抢占,Scheduler 将 Pod A 提名到
-
抢占模拟:Filter 没有找到合适节点时,DefaultPreemption 在 PostFilter 中分两步检查:
- 判断抢占是否可行:在当前候选节点的
NodeInfo副本中,先移除该节点上所有优先级低于当前 Pod 的 Pod,并调用RemovePod更新预计算结果,再运行 Filter,检查腾出这些资源后,当前 Pod 能否调度。 - 尽量减少抢占对象:若检查通过,逐个加回刚才移除的 Pod,每次调用
AddPod并重新运行 Filter。检查仍通过则保留该 Pod;若检查失败,则再次移除它并列入抢占对象。这样可以保留不必删除的 Pod,尽量减少实际抢占造成的中断。
- 判断抢占是否可行:在当前候选节点的
这些操作只修改本地的 NodeInfo 副本和 CycleState,不会直接增删集群中的 Pod。
PreScore
通过 Filter 的 Node 多于一台时,PreScore 会先处理整组可行 Node,为后续评分准备共享状态。例如,拓扑相关插件可以先统计各拓扑域中的 Pod 数量,再由 Score 使用这些结果逐台打分。PreScorePlugin.PreScore 的计算结果保存在本轮 CycleState 中。
| 默认插件 | 具体作用 |
|---|---|
TaintToleration |
收集 Pod 对 PreferNoSchedule Taint 的 Toleration,供 Score 统计无法容忍的 Taint |
NodeAffinity |
解析首选 Node Affinity 条件 |
NodeResourcesFit |
计算参与资源利用率评分的 Pod 资源请求 |
VolumeBinding |
判断本轮是否需要根据可动态供应卷的容量进行评分 |
PodTopologySpread |
统计软性拓扑约束下各拓扑域中的匹配 Pod 数量 |
InterPodAffinity |
计算首选 Pod Affinity 和 Anti-Affinity 的拓扑权重 |
NodeResourcesBalancedAllocation |
计算参与资源均衡评分的 Pod 资源请求 |
PreScore 返回 Skip 时,与它配套的 Score 插件在本轮一起跳过。Filter 只剩一台可行 Node 时,schedulePod 直接选择该 Node,不运行 PreScore 和 Score。
Score
Filter 留下多台可行 Node 时,Scheduler 运行 Score 插件为这些 Node 打分,再根据加权总分选择目标 Node。ScorePlugin.Score 每次接收 Pod 和一台 Node 的 NodeInfo,并返回该插件为这台 Node 计算的分数;分数越高,Node 越符合该插件的偏好。
| 默认插件 | 默认权重 | 具体作用 |
|---|---|---|
TaintToleration |
3 | 无法容忍的 PreferNoSchedule Taint 越少,Node 得分越高 |
NodeAffinity |
2 | 累加 Node 命中的首选 Node Affinity 条件权重 |
NodeResourcesFit |
1 | 按配置的 LeastAllocated、MostAllocated 或 RequestedToCapacityRatio 策略计算资源利用率得分 |
VolumeBinding |
1 | 根据可绑定卷的容量与 PVC 请求量计算容量匹配度;不需要容量评分时跳过 |
PodTopologySpread |
2 | 根据各拓扑域已有的匹配 Pod 数量评分,倾向于降低分布偏差 |
InterPodAffinity |
2 | 根据首选 Pod Affinity 和 Anti-Affinity 的权重为 Node 评分 |
DynamicResources |
2 | 启用 DRA prioritized list 时,根据候选设备分配结果为 Node 评分 |
NodeResourcesBalancedAllocation |
1 | 比较调度后 CPU、内存等资源的利用率差异,倾向于资源使用更均衡的 Node |
ImageLocality |
1 | 根据 Node 已缓存镜像的大小和镜像在集群中的分布评分,减少镜像拉取和启动等待 |
NormalizeScore
Score 每次只为一台 Node 打分。某些插件得到的是原始值,需要看到全部候选 Node 后才能换算成可比较的分数。NormalizeScore 接收该插件产生的完整分数列表,并将每台 Node 的分数调整到 Framework 规定的 0–100 范围;分数越高,Node 越符合该插件的偏好。
| 默认插件 | 具体作用 |
|---|---|
TaintToleration |
反向归一化无法容忍的 PreferNoSchedule Taint 数量,使数量更少的 Node 得分更高 |
NodeAffinity |
将首选 Node Affinity 的原始权重映射到 0–100 |
PodTopologySpread |
将拓扑域计数产生的原始分数映射到 0–100 |
InterPodAffinity |
根据候选 Node 的最小值和最大值线性归一化 Affinity 分数 |
DynamicResources |
将 DRA prioritized list 产生的设备分配分数映射到 0–100 |
假设一个插件按照 Node 上已经缓存的数据块数量打分,三台 Node 的原始值分别是 2、6 和 10,NormalizeScore 可以将它们映射为 0、50 和 100。
插件通过 ScoreExtensions() 提供可选的 NormalizeScore。返回 nil 表示 Score() 已经生成可以直接使用的分数,不需要再次归一化。Framework 校验最终分数是否位于 0–100,分数越界时本次调度失败。校验通过后,Framework 将每个插件的分数乘以 Profile 中配置的 weight,再把加权结果相加,选择总分最高的 Node。
Reserve
选定目标节点后,Scheduler 先通过 AssumePod 在 Cache 中计入 Pod 对该节点的资源请求,再调用 Reserve,让插件记录本次调度所需的临时预留信息。例如,VolumeBinding.Reserve 会在本地卷缓存中暂存选定的 PV/PVC 绑定关系,避免后续 Pod 重复选用同一个 PV。卷绑定信息会在后续 PreBind 中提交。
| 默认插件 | 具体作用 |
|---|---|
VolumeBinding |
在 Scheduler 本地缓存中假定选定的 PV/PVC 绑定成立,避免其他 Pod 同时使用相同绑定结果 |
DynamicResources |
在本轮 CycleState 中保存目标 Node 对应的 DRA Claim 和设备分配结果 |
如果某个 Reserve 插件失败,或者后续 Permit、PreBind、Bind 失败,Framework 会按 Reserve 的相反顺序调用 Unreserve。VolumeBinding 会在这里撤销之前 Assume 的 PV 与 PVC 状态;Scheduler 随后还会 Forget Pod,释放 Scheduler Cache 中为目标 Node 记录的假定资源。
ReservePlugin 要求 Unreserve 保持幂等。Framework 可能在对应 Reserve 尚未运行时调用它,因此实现必须能够安全处理不存在的临时状态。
Permit
Permit 是进入绑定阶段前的最后一个决策点。它接收 Pod 和已经选定的 Node,在 Scheduler 完成 Assume 与 Reserve 后决定立即放行、保留当前结果继续等待,还是结束本次尝试。
| 默认插件 | 具体作用 |
|---|---|
| 无 | 默认 Profile 不在 Permit 阶段等待或拒绝 Pod |
例如,一组分布式训练 Pod 需要凑齐全部成员才能启动。Permit 插件可以让已经选到 Node 的成员返回 Wait;等全部成员都有位置后,插件再逐个调用 WaitingPod.Allow。等待期间,这些 Pod 仍占用 Scheduler Cache 中的 Assumed 资源,避免同一批资源被后续 Pod 选走。
RunPermitPlugins 根据状态码决定如何继续。Permit 中各状态的处理方式如下:
- Success:当前插件接受这次选择,Framework 继续运行后面的 Permit 插件。全部插件执行完且没有等待、拒绝或错误时,Pod 进入绑定阶段。
- Wait:当前插件给出等待时长,Framework 继续运行后面的 Permit 插件。全部插件执行完且没有拒绝或错误时,只要存在一个 Wait,Scheduler 就会登记 WaitingPod;全部等待插件调用
Allow后继续绑定,任一插件 Reject 或超时都会撤销本次选择。 - Pending:适用于外部组件需要根据本次节点选择完成后续操作、Pod 暂时还不能绑定的情况。例如,自定义 Permit 插件将目标 Node 交给外部设备分配控制器,等待它更新资源状态。插件返回
Pending后,当前调度尝试结束。Scheduler 随后运行Unreserve和ForgetPod,撤销本地预留;关联事件到达且 QueueingHint 返回Queue后,Pod 直接进入activeQ,无需等待退避。 - Unschedulable:插件认为当前条件下无法继续调度,但抢占或集群状态变化可能解决问题。例如,移除低优先级 Pod 后,目标 Node 可能释放出足够的资源。Scheduler 撤销本地状态,并根据插件注册的事件等待重新调度。
- UnschedulableAndUnresolvable:当前问题无法通过抢占解决,例如目标节点的标签不满足 Pod 的要求,移除其他 Pod 也无法改变标签。Scheduler 撤销本地状态并等待相关事件;标签或其他对象变化后,Pod 仍可重新调度。
- Error:插件执行失败或收到意外输入。Scheduler 撤销本地状态,并按错误退避路径重试。
两者都会结束当前调度尝试并进入失败退避。区别在于 Unschedulable 表示 PostFilter 仍可能改善结果,而 UnschedulableAndUnresolvable 表示当前条件下无需尝试抢占。Permit 阶段已经选出目标 Node,两种状态使用相同的 Unreserve、ForgetPod 和重新入队流程。
每个 Permit 插件给出的 Wait 时长最多为 15 分钟;上限由 maxTimeout 定义。RunPermitPlugins 收集等待时长,Scheduler 登记 WaitingPod 时再由 newWaitingPod 为各插件启动计时器。任一计时器先到期,整个 Pod 的 Permit 等待都会失败。
绑定阶段(Binding cycle)
绑定阶段把调度阶段选出的目标 Node 写入 Kubernetes API。在此之前,Scheduler 会等待 Permit 放行,并完成卷绑定等必须成功的准备工作;绑定成功后,再运行通知和清理类操作。
不同 Pod 可以并发执行绑定阶段。同一个 Pod 依次经过 PreBindPreFlight、WaitOnPermit、PreBind、Bind 和 PostBind。scheduleOnePod 为每个完成调度阶段的 Pod 启动一个 goroutine,并在其中调用 runBindingCycle。
WaitOnPermit
Permit 阶段有插件返回 Wait,且其余 Permit 插件没有拒绝或报错时,Scheduler 为当前 Pod 创建一条 WaitingPod 记录。记录保存当前 Pod、返回 Wait 且尚未放行的 Permit 插件名称、各插件的超时定时器,以及接收等待结果的通道。返回 Success 的 Permit 插件无需等待,不加入这份等待名单。
Framework.WaitOnPermit 按 Pod 的 UID 查询这条记录,并按以下情况处理:
- 没有等待记录:无需等待 Permit 插件,直接返回
nil,继续执行 PreBind。 - 仍有 Permit 插件尚未放行,且未收到失败结果:阻塞当前 Pod 的绑定 goroutine,等待结果通道收到通知。
- 所有返回
Wait的 Permit 插件均调用 Allow:向结果通道发送Success;WaitOnPermit 收到后返回nil,继续执行 PreBind。 - 任一等待中的 Permit 插件调用 Reject,或其等待超时:向结果通道发送
Unschedulable;WaitOnPermit 收到后返回失败,结束本次绑定。
等待期间,Pod 仍以 Assumed 状态占用 Scheduler Cache 中的目标 Node 资源。等待失败后,Scheduler 运行 Unreserve 并从 Cache 中 ForgetPod,再由 FailureHandler 处理重新入队。WaitOnPermit 是 Framework 的内部步骤,不是插件扩展点。
PreBind
PreBind 在写入 Pod 与 Node 的绑定关系前,完成绑定所依赖的准备工作。例如,VolumeBinding 插件会把调度阶段确定的卷绑定结果提交给 API Server,并等待卷控制器完成绑定。
| 默认插件 | 具体作用 |
|---|---|
VolumeBinding |
提交调度阶段假定的 PV/PVC 绑定,并等待卷控制器完成绑定 |
DynamicResources |
写入 ResourceClaim 的设备分配和 reservedFor,必要时等待设备满足绑定条件 |
PreBind 插件接收 Pod、目标 Node 名称和本轮 CycleState。WaitOnPermit 成功后,所有需要运行的 PreBind 插件都必须返回 Success;任一插件失败都会终止本次绑定。
PreBindPlugin 包含 PreBindPreFlight 和 PreBind 两个方法。前者做轻量预检,让框架提前决定插件的执行安排;后者执行卷绑定等实际准备工作。预检返回两类信息:
- 状态:
Success表示需要运行该插件的PreBind,Skip表示跳过,Error表示终止本次绑定。 AllowParallel:标记该插件的PreBind能否与执行列表中相邻的其他 PreBind 插件并行执行。
例如,VolumeBinding.PreBindPreFlight 发现卷已全部绑定时返回 Skip。PreBind 内部也会检查是否需要处理,但提前预检可以让框架直接跳过该插件,并在执行实际操作前完成并行分组。
RunPreBindPreFlights 使用普通 for 循环逐个执行预检,并将 Skip 和 AllowParallel 结果写入 CycleState,预检本身不并行。RunPreBindPlugins 随后把连续允许并行的插件组成一组,并通过 Parallelizer().Until 并行执行组内插件;不允许并行的插件会截断分组并单独执行。
Bind
Bind 把已经选定的目标 Node 写入 Kubernetes API。绑定请求成功后,Pod 的 spec.nodeName 已经保存;Scheduler 的 Informer 随后收到 Pod 更新,并用它确认本地的 Assumed 状态。
| 默认插件 | 具体作用 |
|---|---|
DefaultBinder |
请求 Pod 的 binding 子资源,将目标 Node 写入 spec.nodeName |
BindPlugin.Bind 接收 Pod、目标 Node 名称和 CycleState,并按 Profile 中的配置顺序执行。Skip 表示当前插件不处理该 Pod,Framework 继续调用下一个插件;Success 表示绑定已经完成,其余 Bind 插件不再运行。所有插件都返回 Skip,或者任一插件失败时,本次绑定失败。
默认 DefaultBinder 构造一个 v1.Binding 请求体,并调用 Pod 的 binding 子资源。API Server 根据该请求更新现有 Pod 的 spec.nodeName;v1.Binding 在这里是请求对象,不是另行持久化的资源。具体调用见 DefaultBinder.Bind 和 API Server 的 BindingREST。
PostBind
PostBind 在 Pod 成功绑定到 Node 后执行,位于绑定周期末尾,可用于清理插件内部状态等收尾工作。
| 默认插件 | 具体作用 |
|---|---|
| 无 | 默认 Profile 不执行 PostBind 回调 |
PostBind 插件接收 Pod、目标 Node 名称和 CycleState,并按配置顺序执行。PostBindPlugin.PostBind 没有返回状态,因此不能撤销已经完成的绑定;插件需要自行处理内部错误。
核心源码
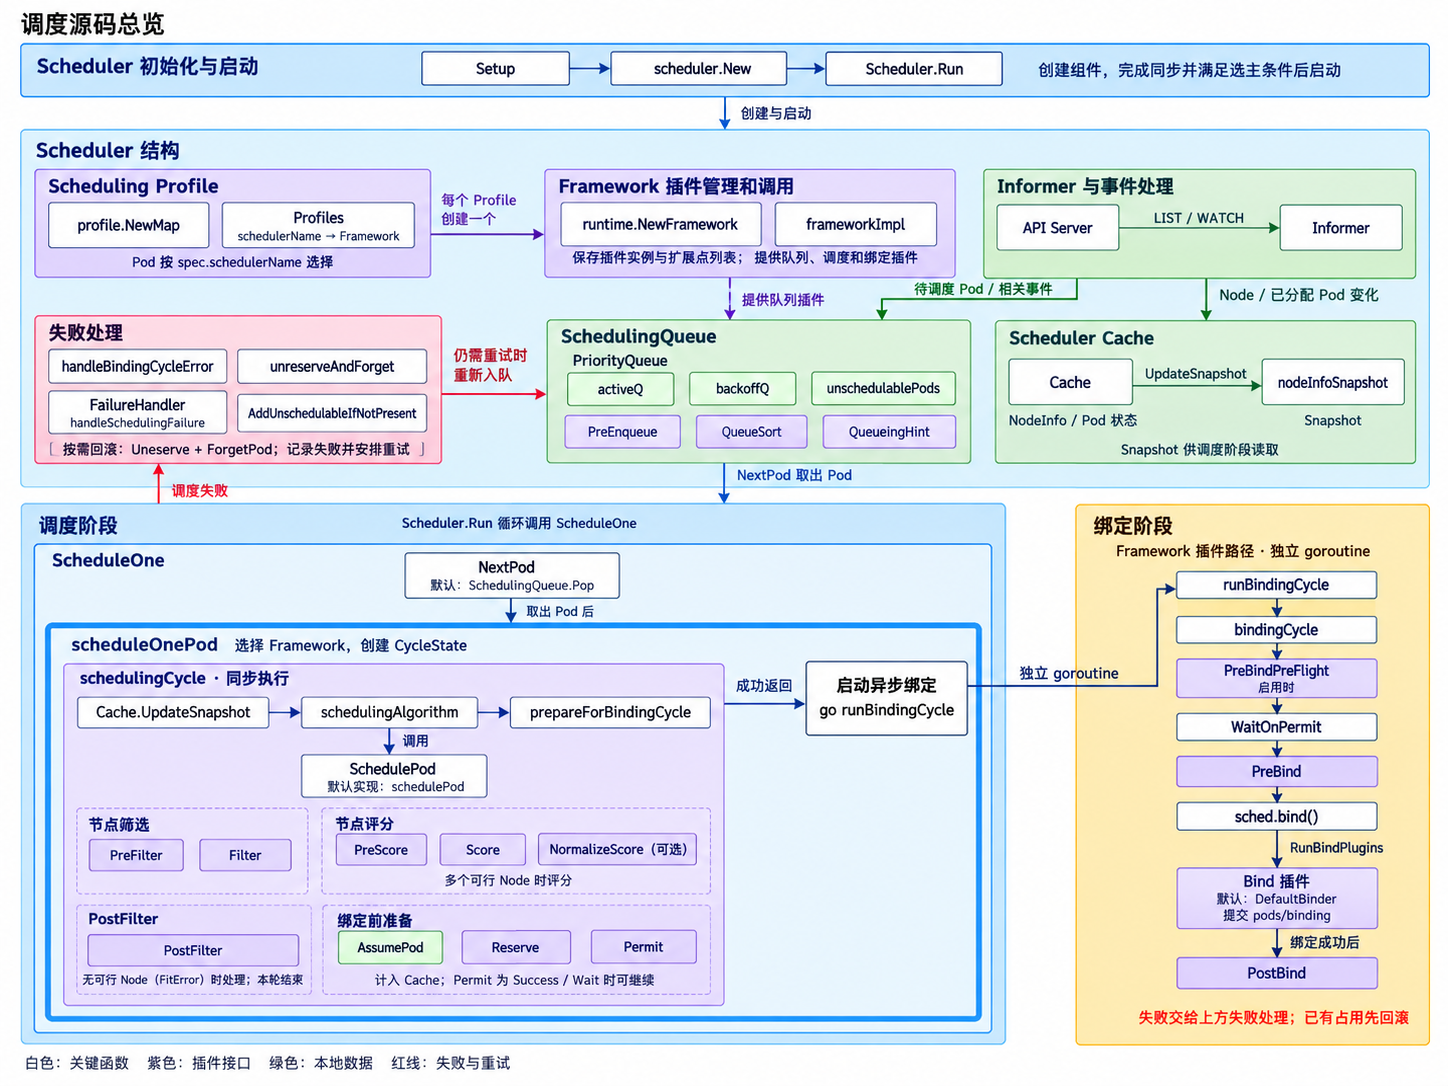
下图展示 kube-scheduler 的核心组件与主要调用关系,涵盖初始化、插件管理、调度数据维护,以及 Pod 的调度、绑定和失败处理。
Scheduler 初始化与启动
scheduler.New 创建 Framework、队列和 Cache,并注册事件处理函数。完成 Informer 数据同步且满足选主条件后,Scheduler.Run 启动队列后台任务和调度主循环。
Scheduler 结构
保存 SchedulingQueue、Cache、Profiles 和 nodeInfoSnapshot,并通过 NextPod、SchedulePod、FailureHandler 分别连接取出 Pod、选择 Node 和失败处理。
- Scheduling Profile:将调度器名称、插件及其参数组合成一套调度策略。Pod 通过
spec.schedulerName选择 Profile,Profiles按该名称保存对应的 Framework。 - Framework 插件管理和调用:每个 Profile 对应一个 Framework,负责创建插件实例、维护各扩展点的插件列表,并通过
RunFilterPlugins、RunScorePlugins等方法执行插件。 - SchedulingQueue:管理待调度和等待重试的 Pod,使用
activeQ、backoffQ和unschedulablePods等队列保存不同状态的 Pod。NextPod默认调用队列的Pop,取出下一次调度要处理的 Pod。 - Scheduler Cache 与 Snapshot:Cache 汇总 Node、已绑定 Pod 和 Assumed Pod 的状态;每轮调度开始时,通过
UpdateSnapshot刷新节点视图,供调度算法和插件读取。
调度阶段
ScheduleOne 取出 Pod 后,调用 scheduleOnePod 处理该 Pod 的调度与绑定流程。该方法选择对应的 Framework、创建本轮的 CycleState,再调用 schedulingCycle 同步完成节点选择和绑定前准备。选出 Node 后,先记录 Assumed 状态,再运行 Reserve 和 Permit。
绑定阶段
调度阶段成功后,scheduleOnePod 启动独立 goroutine 执行 runBindingCycle,完成等待 Permit、PreBind、Bind 和 PostBind。默认 Bind 插件向 API Server 提交 Pod 与 Node 的绑定请求。
失败处理
调度或绑定失败时,按需通过 Unreserve 和 ForgetPod 撤销插件状态与本地资源占用,再由 FailureHandler 记录诊断,并将仍需重试的 Pod 交回 SchedulingQueue。
Scheduler 结构
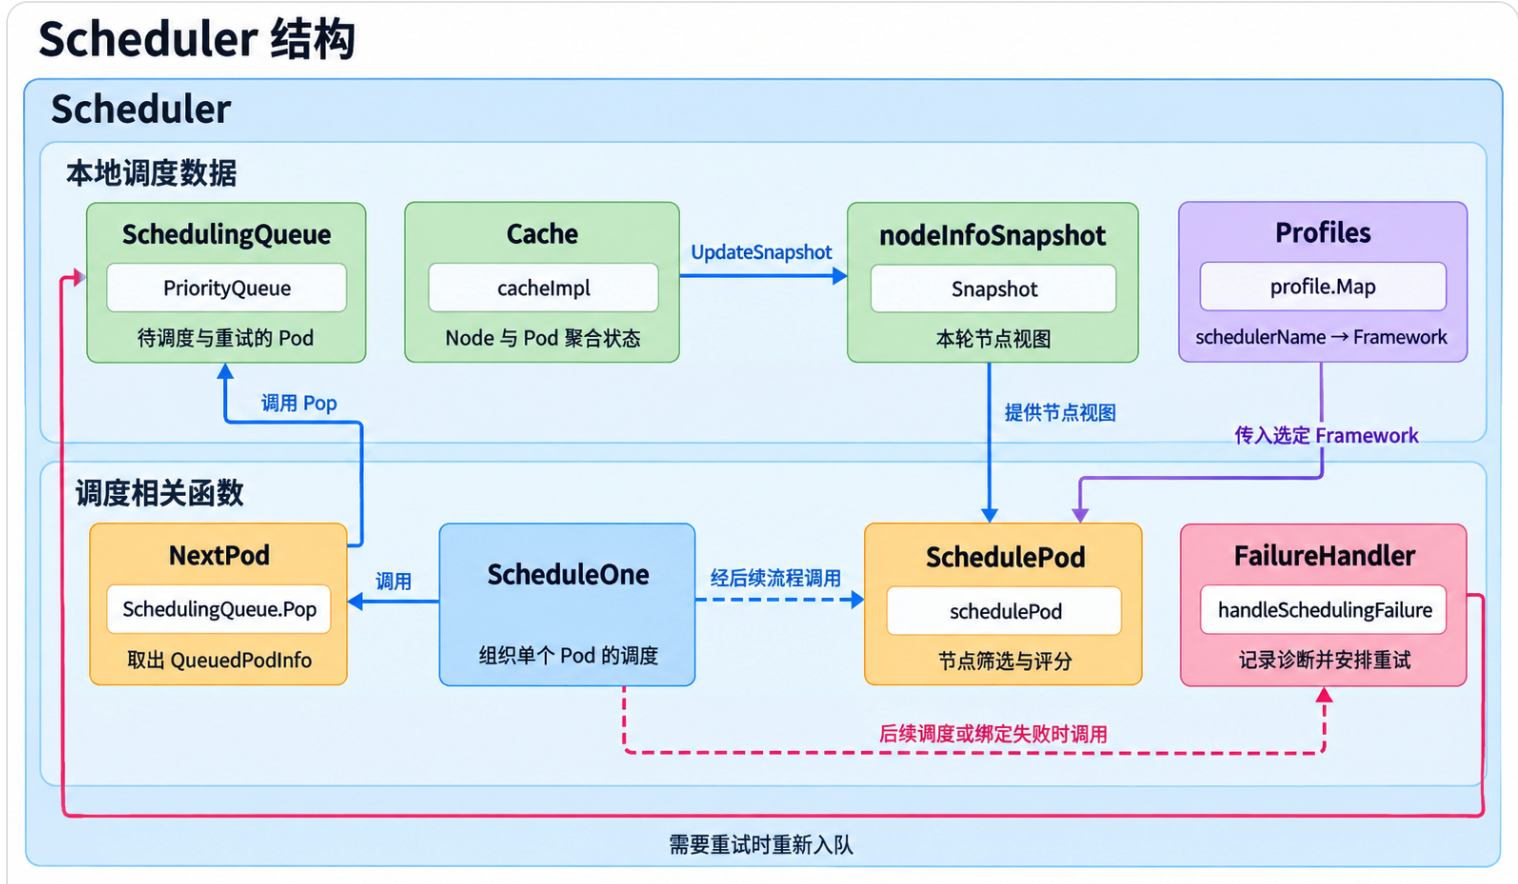
Scheduler 结构体集中保存调度器运行所需的本地数据和流程入口。SchedulingQueue、Cache、Profiles 和 nodeInfoSnapshot 提供调度数据;NextPod、SchedulePod 和 FailureHandler 分别连接取出 Pod、选择 Node 和失败处理流程。
- 保存本地数据:
SchedulingQueue保存待处理 Pod,Cache汇总 Node 与 Pod 状态,Profiles保存各调度策略对应的 Framework,nodeInfoSnapshot提供本轮调度使用的节点视图。 - 取出 Pod:
NextPod默认指向SchedulingQueue.Pop,队列为空时阻塞等待。 - 选择 Node:
SchedulePod默认指向schedulePod,使用选定的 Framework 和 NodeInfo Snapshot 完成筛选与评分。 - 处理失败:
FailureHandler默认指向handleSchedulingFailure,负责记录诊断信息并把 Pod 交回 SchedulingQueue。
下面的源码保留普通 Pod 调度主路径使用的字段。
type Scheduler struct {
    // 保存 Node、已绑定 Pod 和 Assumed Pod 的本地状态。
    Cache internalcache.Cache

    ...

    // 从调度队列中取出下一项;队列为空时阻塞等待。
    NextPod func(logger klog.Logger) (*framework.QueuedPodInfo, error)

    // 处理调度失败,记录诊断信息并把 Pod 交回队列。
    FailureHandler FailureHandlerFn

    // 执行节点筛选、评分和目标 Node 选择。
    SchedulePod func(
        ctx context.Context,
        fwk framework.Framework,
        state fwk.CycleState,
        podInfo *framework.QueuedPodInfo,
    ) (ScheduleResult, error)

    ...

    // 保存等待调度、退避和暂时不可调度的 Pod。
    SchedulingQueue internalqueue.SchedulingQueue

    // 按 schedulerName 保存各 Profile 对应的 Framework。
    Profiles profile.Map

    // 为当前调度周期提供稳定的 NodeInfo 视图。
    nodeInfoSnapshot *internalcache.Snapshot

    ...
}
Scheduler 初始化与启动
kube-scheduler 命令读取配置并创建 Scheduler,再启动 Informer、等待初始数据处理完成,最后进入 ScheduleOne 主循环。Leader Election 开启时,只有持有 Lease 的实例会运行主循环。
相关代码位置如下:
cmd/kube-scheduler/app/
├── server.go                       # 命令入口、Setup 与进程级 Run
└── config/config.go                # Config、CompletedConfig:保存进程运行配置

pkg/scheduler/
├── scheduler.go                    # New 创建组件,Run 启动队列与调度循环
├── eventhandlers.go                # 注册事件回调,等待初始对象处理完成
├── backend/queue/scheduling_queue.go # 队列 Run、退避刷新与停留超时检查
└── schedule_one.go                 # ScheduleOne:主循环调用的调度入口
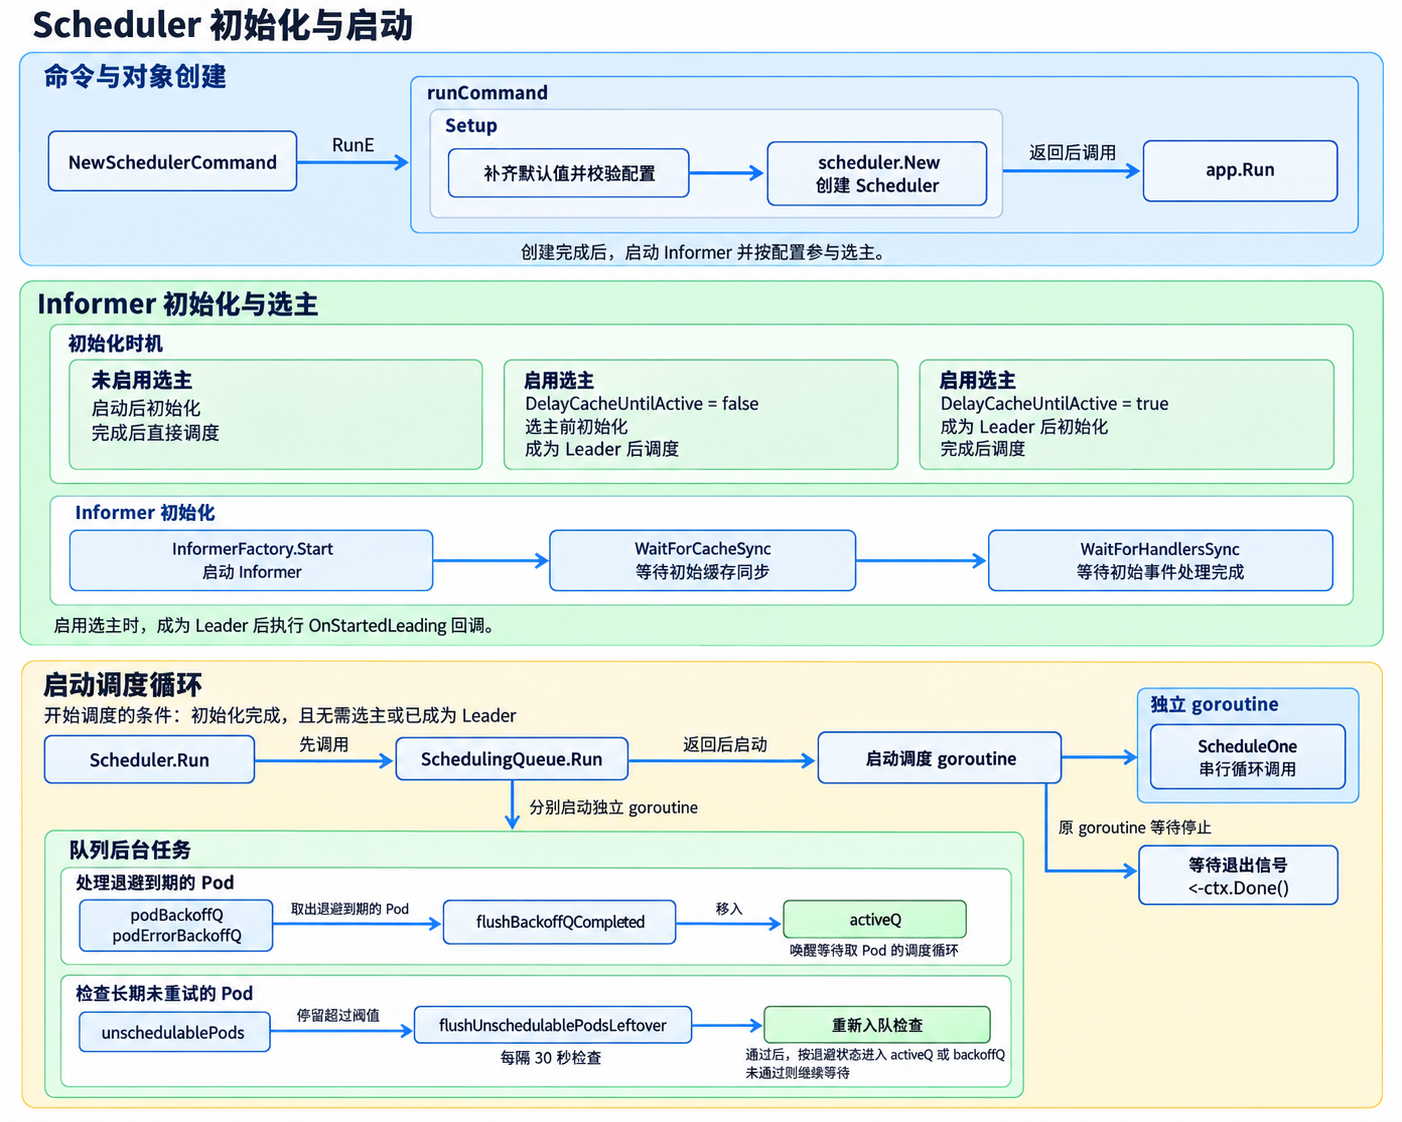
下图展示了从命令入口到调度主循环的启动顺序。
命令与对象创建
- 创建命令:
NewSchedulerCommand创建 Cobra 命令,在RunE中调用runCommand。runCommand建立进程 Context,再调用Setup。 - 创建 Scheduler:
Setup补齐配置默认值、校验配置,并收集 out-of-tree 插件,再调用scheduler.New创建 Scheduler。 - 启动进程服务:
Setup返回后,runCommand调用app.Run,启动事件广播、安全端口和健康检查,并按配置初始化 Informer、参与选主。
Informer 初始化与选主
-
初始化时机:
- 未启用选主:直接初始化 Informer,完成后开始调度,
DelayCacheUntilActive的取值不影响这条路径。 - 启用选主且
DelayCacheUntilActive = false(默认):先初始化 Informer,再参与选主;成为 Leader 后开始调度。 - 启用选主且
DelayCacheUntilActive = true:成为 Leader 后才初始化 Informer,完成后开始调度。
- 未启用选主:直接初始化 Informer,完成后开始调度,
-
Informer 初始化:
app.Run调用InformerFactory.Start启动 Informer,通过WaitForCacheSync等待初始缓存同步,再通过WaitForHandlersSync等待 Scheduler 处理完首次同步的对象,使相关节点和 Pod 信息进入 Cache 或 SchedulingQueue。 - 选主回调:启用选主时,实例成为 Leader 后执行
OnStartedLeading回调。回调完成必要的 Informer 初始化后,调用Scheduler.Run。
启动调度循环
-
启动队列后台任务:
Scheduler.Run先调用SchedulingQueue.Run,分别在独立 goroutine 中运行两个任务:- 处理退避到期的 Pod:
flushBackoffQCompleted处理podBackoffQ和podErrorBackoffQ中退避已经结束的 Pod,将可以重新调度的 Pod 移入activeQ,并唤醒等待取 Pod 的调度循环。 - 检查长期未重试的 Pod:
flushUnschedulablePodsLeftover每隔 30 秒检查unschedulablePods,对停留超过阈值的 Pod 触发重新入队检查。检查通过后,按剩余退避时间进入activeQ或backoffQ;未通过则继续留在unschedulablePods。
- 处理退避到期的 Pod:
-
启动调度 goroutine:
SchedulingQueue.Run启动后台任务并返回后,Scheduler.Run再创建独立 goroutine,串行循环调用ScheduleOne,从队列取出 Pod 并执行调度。 - 等待停止信号:原 goroutine 阻塞在
<-ctx.Done()。Context 取消后,它关闭队列并清理插件;等待期间,队列后台任务和调度 goroutine 继续运行。
命令入口
NewSchedulerCommand 创建 Cobra 命令和配置选项,并在 RunE 中调用 runCommand。
runCommand 创建可取消的 Context,用于在收到停止信号时通知各组件退出。随后调用 Setup,准备配置,并通过 scheduler.New 创建调度器。
Setup 返回两个对象:
cc(CompletedConfig):保存准备好的运行配置和依赖,包括组件配置、访问 API Server 的 Client、Informer Factory、服务端和 Leader Election 配置。sched(Scheduler):创建好的调度器实例,保存 Cache、SchedulingQueue、Profiles 等组件,以及节点选择和失败处理的执行入口。
runCommand 再把 Context、cc 和 sched 传给 app.Run。app.Run 使用这些配置和对象启动服务、同步数据并按配置参与选主,在满足条件后调用 Scheduler.Run,开始执行调度。
func NewSchedulerCommand(registryOptions ...Option) *cobra.Command {
    opts := options.NewOptions()

    cmd := &cobra.Command{
        Use: "kube-scheduler",
        RunE: func(cmd *cobra.Command, args []string) error {
            // 命令参数解析完成后进入 Scheduler 的创建与运行流程。
            return runCommand(cmd, opts, registryOptions...)
        },
        ...
    }
    ...
    return cmd
}

func runCommand(
    cmd *cobra.Command,
    opts *options.Options,
    registryOptions ...Option,
) error {
    ...
    cc, sched, err := Setup(ctx, opts, registryOptions...)
    if err != nil {
        return err
    }
    // cc 保存进程运行配置和依赖,sched 是 scheduler.New 创建的调度器。
    // Run 使用二者启动 Informer、Leader Election 和调度主循环。
    return Run(ctx, cc, sched)
}
Setup 补齐配置默认值、校验配置并收集 out-of-tree 插件,再调用 scheduler.New 创建 Scheduler。
in-tree 指 Kubernetes 源码中内置的插件,例如 NodeAffinity;out-of-tree 指在 Kubernetes 源码仓库之外开发的插件。后文的实现 GPUModelFilter介绍了一个 out-of-tree 插件示例。两类插件可以在同一个调度器进程中运行。
func Setup(
    ctx context.Context,
    opts *options.Options,
    outOfTreeRegistryOptions ...Option,
) (*config.CompletedConfig, *scheduler.Scheduler, error) {
    ...

    // 收集通过 app.WithPlugin 注册的 out-of-tree 插件。
    // 内置插件的 Registry 由 scheduler.New 创建,再与此处的 Registry 合并。
    outOfTreeRegistry := make(runtime.Registry)
    for _, option := range outOfTreeRegistryOptions {
        if err := option(outOfTreeRegistry); err != nil {
            return nil, nil, err
        }
    }

    // 传入配置、InformerFactory 和插件 Registry,创建 Scheduler。
    sched, err := scheduler.New(
        ctx,
        cc.Client,
        cc.InformerFactory,
        cc.DynInformerFactory,
        recorderFactory,
        scheduler.WithProfiles(cc.ComponentConfig.Profiles...),
        scheduler.WithFrameworkOutOfTreeRegistry(outOfTreeRegistry),
        ...,
    )
    ...
    return &cc, sched, nil
}
Scheduler 创建
scheduler.New 负责初始化 Scheduler。它合并 in-tree 插件 Registry 与 out-of-tree 插件 Registry,并完成以下初始化工作:
- Snapshot:保存本轮调度读取的节点视图,每轮调度开始时由 Scheduler Cache 增量刷新。
- Scheduler Cache:保存 Node、已绑定 Pod 和 Assumed Pod 的最新聚合状态。
- Scheduling Profile:
profile.NewMap为每个 Profile 创建 Framework,并按schedulerName写入profile.Map。调度 Pod 时,Scheduler 根据spec.schedulerName取得对应的 Framework,运行该 Profile 配置的插件。 - SchedulingQueue:保存等待调度或等待重试的 Pod,所有 Profile 共用一个队列。
- 注册事件处理器:为 Pod、Node 和存储资源注册 Event Handler,用对象变化更新 SchedulingQueue 与 Scheduler Cache。
以下源码展示这些数据结构的创建、字段赋值和 Event Handler 注册位置:
func New(
    ctx context.Context,
    client clientset.Interface,
    informerFactory informers.SharedInformerFactory,
    dynInformerFactory dynamicinformer.DynamicSharedInformerFactory,
    recorderFactory profile.RecorderFactory,
    opts ...Option,
) (*Scheduler, error) {
    ...

    // 创建 Kubernetes 源码内置的 in-tree 插件 Registry。
    registry := frameworkplugins.NewInTreeRegistry()

    // 合并通过 app.WithPlugin 注册的 out-of-tree 插件。
    // 后续 Profile 根据插件名称从同一个 Registry 创建插件实例。
    if err := registry.Merge(options.frameworkOutOfTreeRegistry); err != nil {
        return nil, err
    }

    // Cache 持续接收 Informer 事件和 Assume、Forget 更新,保存最新的集群状态。
    // Snapshot 在每轮调度开始时由 Cache.UpdateSnapshot 增量刷新,供本轮调度读取。
    snapshot := internalcache.NewEmptySnapshot()
    schedulerCache := internalcache.New(
        ctx,
        apiDispatcher,
        feature.DefaultFeatureGate.Enabled(features.GenericWorkload),
    )

    // 为每个 Profile 创建一个 Framework,保存到 profile.Map。
    // profile.Map 的类型定义为:type Map map[string]framework.Framework。
    // 键为 schedulerName,值为对应的 Framework 实例。
    profiles, err := profile.NewMap(
        ctx, options.profiles, registry, recorderFactory,
        frameworkruntime.WithSnapshotSharedLister(snapshot),
        ...,
    )
    if err != nil {
        return nil, fmt.Errorf("initializing profiles: %v", err)
    }

    // 所有 Profile 共用一个 SchedulingQueue。
    podQueue := internalqueue.NewSchedulingQueue(
        profiles[options.profiles[0].SchedulerName].QueueSortFunc(),
        informerFactory,
        ...,
    )

    sched := &Scheduler{
        // 保存持续变化的 Node 和 Pod 聚合状态。
        Cache:            schedulerCache,
        // 保存等待调度或等待重试的 Pod。
        SchedulingQueue:  podQueue,
        // 按 schedulerName 保存各 Profile 对应的 Framework,供调度 Pod 时查询。
        Profiles:         profiles,
        // 每轮调度开始时由 Cache.UpdateSnapshot 增量刷新。
        nodeInfoSnapshot: snapshot,
        ...,
    }
    // 主循环通过 NextPod 从 SchedulingQueue 取出下一个 Pod。
    sched.NextPod = podQueue.Pop
    // 设置默认的 SchedulePod 和 FailureHandler。
    sched.applyDefaultHandlers()

    // 从 SharedInformerFactory 取得 Pod、Node、PVC 等资源各自的 Shared Informer,
    // 并为它们注册 Add、Update 和 Delete 回调。
    // Informer 启动后,回调更新 SchedulingQueue 与 Scheduler Cache,并触发 Pod 重新入队。
    if err := addAllEventHandlers(sched, informerFactory, ...); err != nil {
        return nil, fmt.Errorf("adding event handlers: %w", err)
    }
    return sched, nil
}
数据同步与主循环
app.Run 是进程级运行入口,负责以下工作:
- 启动进程服务:启动事件广播和健康检查等服务。
- 缓存初始对象:启动 Informer,从 API Server 获取已有的 Node、Pod、PVC 等对象,保存到各自的本地缓存。
WaitForCacheSync等待这次缓存填充完成。 - 建立 Scheduler 初始状态:事件处理函数将节点和已绑定 Pod 的信息写入 Scheduler Cache,将当前调度器负责的未绑定 Pod 加入 SchedulingQueue。
WaitForHandlersSync等待这批初始事件处理完成。 - 参与选主:启用 Leader Election 时,只有 Leader 执行调度;Informer 同步与选主的先后顺序由
DelayCacheUntilActive决定。 - 启动调度循环:数据同步完成,且未启用选主或当前实例已成为 Leader 后,调用
Scheduler.Run,启动 SchedulingQueue 后台任务和ScheduleOne主循环。
WaitForCacheSync 和 WaitForHandlersSync 针对同一批初始数据,分别确认缓存填充和事件处理完成;事件处理可以在缓存同步过程中进行。
func Run(
    ctx context.Context,
    cc *schedulerserverconfig.CompletedConfig,
    sched *scheduler.Scheduler,
) error {
    logger := klog.FromContext(ctx)

    ...

    // 这里只定义启动 Informer 并等待同步的函数,尚未执行。
    // 后面根据 DelayCacheUntilActive 和 Leader Election 的状态调用它。
    startInformersAndWaitForSync := func(ctx context.Context) {
        // 启动 SharedInformerFactory 中已经创建的 Informer。
        cc.InformerFactory.Start(ctx.Done())
        if cc.DynInformerFactory != nil {
            cc.DynInformerFactory.Start(ctx.Done())
        }

        // 等待初始 LIST 完成,确保各 Informer 的 Store 已经填充。
        cc.InformerFactory.WaitForCacheSync(ctx.Done())
        if cc.DynInformerFactory != nil {
            cc.DynInformerFactory.WaitForCacheSync(ctx.Done())
        }

        // 等待 Scheduler 的事件处理函数处理完首次同步的对象。
        // 这些函数负责将相关节点和 Pod 信息写入 Scheduler Cache 或 SchedulingQueue。
        if err := sched.WaitForHandlersSync(ctx); err != nil {
            logger.Error(err, "handlers are not fully synchronized")
        }

        ...
    }

    // 未延迟缓存,或未启用 Leader Election 时,在这里调用并完成同步。
    if !cc.ComponentConfig.DelayCacheUntilActive || cc.LeaderElection == nil {
        startInformersAndWaitForSync(ctx)
    }

    if cc.LeaderElection != nil {
        ...

        cc.LeaderElection.Callbacks = leaderelection.LeaderCallbacks{
            OnStartedLeading: func(ctx context.Context) {
                ...

                // 延迟缓存时,当前实例成为 Leader 后才在这里调用该函数。
                if cc.ComponentConfig.DelayCacheUntilActive {
                    startInformersAndWaitForSync(ctx)
                }

                // 只有 Leader 进入 Scheduler 主循环。
                sched.Run(ctx)
            },
            OnStoppedLeading: func() {
                ...
            },
        }

        leaderElector, err := leaderelection.NewLeaderElector(*cc.LeaderElection)
        if err != nil {
            return fmt.Errorf("couldn't create leader elector: %v", err)
        }
        leaderElector.Run(ctx)
        return fmt.Errorf("lost lease")
    }

    // 未启用 Leader Election,当前实例直接运行 Scheduler。
    sched.Run(ctx)
    ...
}
delayCacheUntilActive 默认为 false,所有实例都会提前启动 Informer 并同步本地调度数据,以缩短 Leader 切换时间。设置为 true 后,备用实例成为 Leader 时才同步数据,可以减少内存和 API Server 开销,但会增加切换后的等待时间。当未启用 Leader Election 时,Informer 会立即启动。
Scheduler.Run 启动队列后台任务,并在独立 goroutine 中循环调用 ScheduleOne:
func (sched *Scheduler) Run(ctx context.Context) {
    // 启动退避刷新、不可调度 Pod 超时检查等队列任务。
    sched.SchedulingQueue.Run(klog.FromContext(ctx))

    ...

    // ScheduleOne 从 SchedulingQueue 取出下一个 Pod;队列为空时会阻塞等待。
    // 如果在当前 goroutine 中运行,Context 取消后将无法继续执行
    // SchedulingQueue.Close 来解除阻塞,导致关闭过程死锁,因此使用独立 goroutine。
    go wait.UntilWithContext(ctx, sched.ScheduleOne, 0)

    <-ctx.Done()
    sched.SchedulingQueue.Close()
    _ = sched.Profiles.Close()
}
Scheduling Profile
Scheduling Profile 将调度器名称、插件及其参数组合成一套调度策略。一个 kube-scheduler 进程可以配置多个 Profile,Pod 通过 spec.schedulerName 选择其中一套策略。kube-scheduler 随后按照该 Profile 的配置,在各个扩展点运行对应插件。
相关代码位置如下:
staging/src/k8s.io/kube-scheduler/config/v1/
└── types.go                        # KubeSchedulerProfile、插件列表与参数配置字段

pkg/scheduler/
├── apis/config/v1/
│   ├── defaults.go                 # 补齐 Profile 默认值与内置插件参数
│   └── default_plugins.go          # 默认插件集合,以及与用户插件配置的合并
├── profile/profile.go              # NewMap 创建并校验 Profile,保存 Framework
├── framework/runtime/framework.go  # NewFramework 按单份 Profile 创建插件运行环境
└── schedule_one.go                 # frameworkForPod 选择 Framework;计算可行节点数量
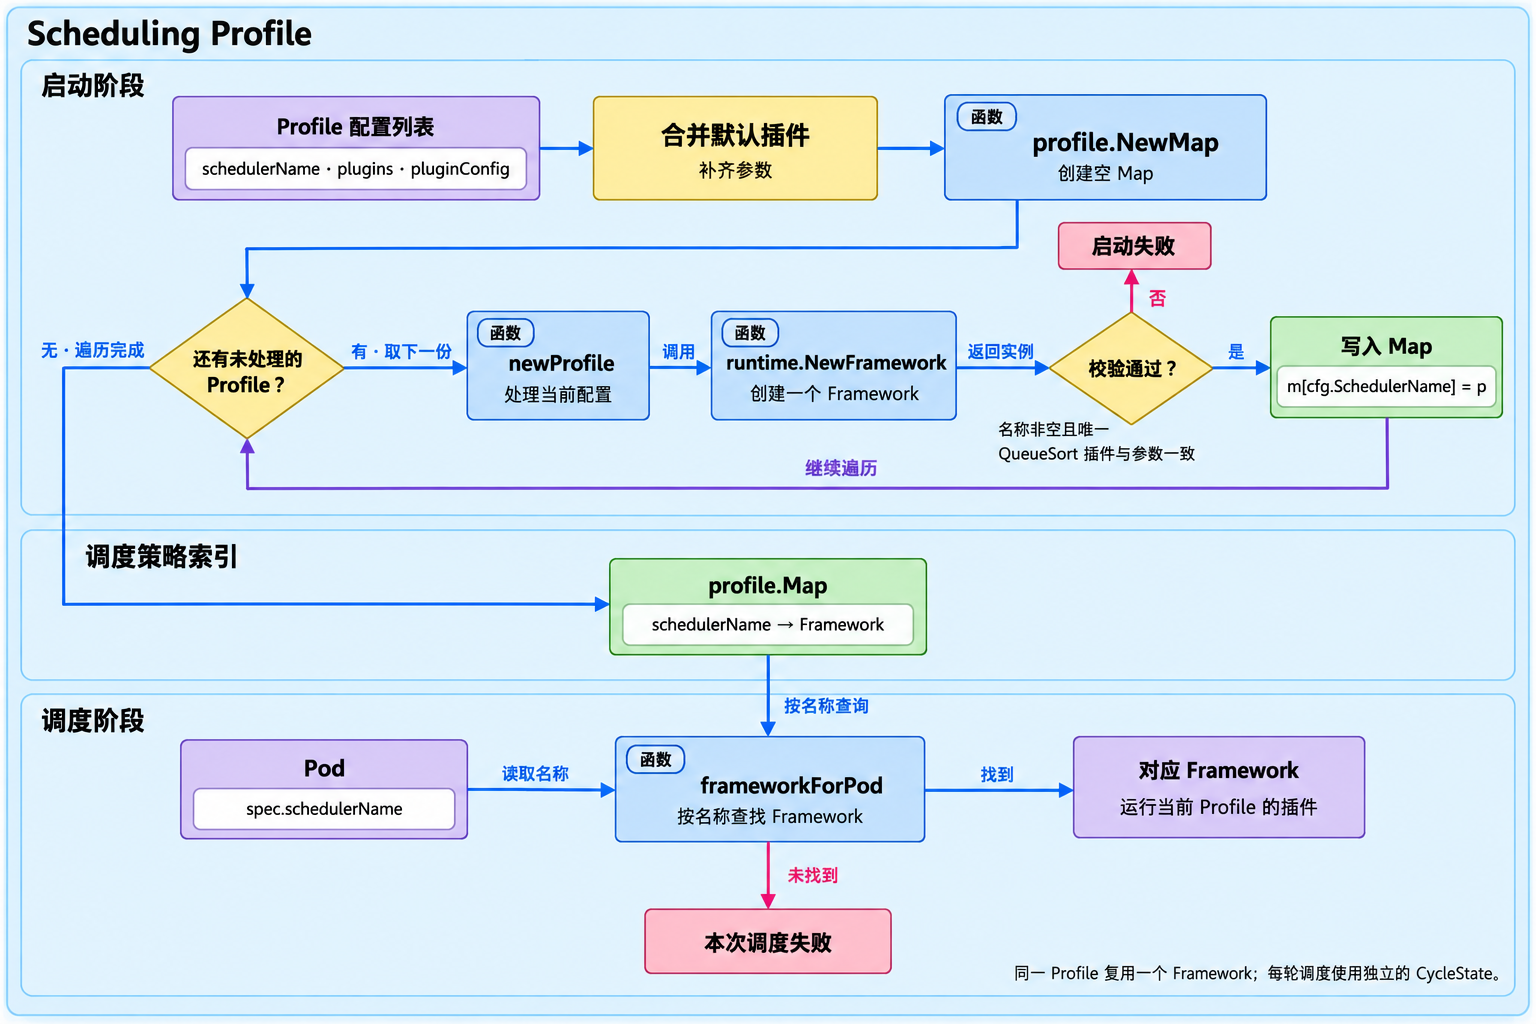
下图展示 Profile 的创建与选择:启动阶段将每份配置转换为 Framework,并以 schedulerName 为 key 写入 profile.Map;调度 Pod 时,Scheduler 根据 spec.schedulerName 取得对应的 Framework。
- 读取 Profile 配置:
KubeSchedulerProfile保存调度器名称、启用的插件及插件参数。 - 合并默认插件并补齐参数:Scheduler 将用户配置与内置插件集合合并,并补齐缺少的内置插件参数。
- 遍历 Profile:
profile.NewMap依次处理每份 Profile 配置。 - 创建 Framework:
newProfile为当前 Profile 调用runtime.NewFramework。 - 校验 Profile:
schedulerName必须非空且唯一;多个 Profile 的 QueueSort 插件名称和参数必须一致。校验失败时,Scheduler 无法启动。 - 建立索引:校验通过后,Framework 以
schedulerName为 key 写入profile.Map。 - 读取调度器名称:调度 Pod 时,Scheduler 读取
spec.schedulerName。 - 查找 Framework:
frameworkForPod使用该名称查询profile.Map;没有对应 Profile 时,本次调度返回错误。 - 运行插件:查询成功后,Scheduler 使用对应的 Framework 运行该 Profile 配置的插件。
Profile 配置
KubeSchedulerProfile 包含以下字段:
schedulerName:Profile 的名称,与 Pod 的spec.schedulerName匹配。只有一个 Profile 且未填写名称时,默认值为default-scheduler;配置多个 Profile 时,每个名称都必须非空且唯一。percentageOfNodesToScore:控制找到多少个可行 Node 后停止筛选。默认值0表示自动计算,公式为max(5, 50 - Node 总数 / 125)%,同时至少查找 100 个可行 Node。例如,集群有 1,000 个 Node 时比例为 42%,找到 420 个可行 Node 后停止。numFeasibleNodesToFind实现了这项计算。plugins:按扩展点启用、禁用或重新配置插件。enabled可以添加插件,也可以覆盖默认插件在该扩展点上的顺序和 Score 权重;disabled删除指定的默认插件,*表示删除该扩展点的全部默认插件。pluginConfig:按插件名称提供初始化参数。一个插件实现多个扩展点时只创建一个实例,这组参数由该实例共同使用。
setDefaults_KubeSchedulerProfile 先把用户配置与默认插件集合合并。对于已经启用但没有配置参数的内置插件,Scheduler 会生成默认参数,供创建插件实例时使用。
func setDefaults_KubeSchedulerProfile(
    logger klog.Logger,
    prof *configv1.KubeSchedulerProfile,
) {
    // enabled、disabled 和 MultiPoint 配置在这里与默认插件合并。
    prof.Plugins = mergePlugins(logger, getDefaultPlugins(), prof.Plugins)

    scheme := GetPluginArgConversionScheme()
    existingConfigs := sets.New[string]()
    // 遍历用户显式提供的 pluginConfig,并为 Args 中未设置的字段补上默认值。
    for j := range prof.PluginConfig {
        // 记录已经配置过参数的插件,后续不再为它生成整份默认 pluginConfig。
        existingConfigs.Insert(prof.PluginConfig[j].Name)
        args := prof.PluginConfig[j].Args.Object
        // out-of-tree 插件参数由插件构造函数自行解析并补齐默认值。
        if _, isUnknown := args.(*runtime.Unknown); isUnknown {
            continue
        }
        scheme.Default(args)
    }

    // 为其余内置插件补上对应的默认 Args。
    for _, name := range pluginsNames(prof.Plugins) {
        if existingConfigs.Has(name) {
            continue
        }
        ...
        prof.PluginConfig = append(prof.PluginConfig, configv1.PluginConfig{
            Name: name,
            Args: runtime.RawExtension{Object: args},
        })
    }
}
插件配置
这份配置包含两个 Profile。default-scheduler 使用默认插件;gpu-binpack-scheduler 调整插件权重、默认抢占和插件初始化参数。
gpu-binpack-scheduler 是本例定义的 Profile 名称。它继续使用 kube-scheduler 的内置插件,只通过 KubeSchedulerProfile 修改插件配置,不需要编写或编译新的调度插件。当内置插件无法满足调度规则时,可以使用 Scheduling Framework 编写自定义插件;后面的自定义调度插件通过完整示例介绍插件接口、注册、配置和验证过程。
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
  # 未配置插件时,Profile 使用 kube-scheduler 的默认插件和参数。
  - schedulerName: default-scheduler

  # 这个 Profile 倾向于集中放置 CPU、内存和 GPU 工作负载。
  - schedulerName: gpu-binpack-scheduler
    plugins:
      score:
        # 不再根据镜像是否已经缓存在 Node 上增加分数。
        disabled:
          - name: ImageLocality
        # 覆盖默认 Score 插件的权重;其他扩展点保持默认配置。
        enabled:
          - name: NodeResourcesFit
            weight: 5
          - name: PodTopologySpread
            weight: 3
      postFilter:
        # 没有可行 Node 时不运行默认抢占。
        disabled:
          - name: DefaultPreemption
    pluginConfig:
      - name: NodeResourcesFit
        args:
          # 优先选择资源利用率较高的 Node,集中放置工作负载。
          scoringStrategy:
            type: MostAllocated
            resources:
              - name: cpu
                weight: 1
              - name: memory
                weight: 1
              - name: nvidia.com/gpu
                weight: 5
- 多个 Score 插件:
NodeResourcesFit和PodTopologySpread仍在默认扩展点运行,这里只把它们的 Score 权重改为5和3。 - 禁用单个插件:
ImageLocality只从 Score 扩展点移除;其他默认 Score 插件继续参与评分。 - 禁用默认抢占:
DefaultPreemption从 PostFilter 移除。该 Profile 找不到可行 Node 时,不会通过默认抢占移除低优先级 Pod。 - 配置插件参数:
NodeResourcesFit的scoringStrategy.type设置为MostAllocated,资源已请求比例越高的 Node 得分越高。resources[].name指定 CPU、内存和 GPU 参与评分,resources[].weight将nvidia.com/gpu的比重设为 CPU 和内存的 5 倍。
Pod 设置 spec.schedulerName: gpu-binpack-scheduler 时,Scheduler 使用第二个 Profile;没有显式设置该字段的 Pod 由 API Server 默认填写 default-scheduler。
Profile 创建
profile.NewMap 为每份 Profile 创建 Framework,并以 schedulerName 建立索引;Framework 保存该 Profile 的插件实例和扩展点执行顺序,具体结构见 Framework 插件管理和调用。
profile.NewMap 遍历所有 Profile 配置。newProfile 将一份配置交给 frameworkruntime.NewFramework,创建对应的 Framework;校验通过后,再以 schedulerName 为 key 保存到 profile.Map:
func newProfile(
    ctx context.Context,
    cfg config.KubeSchedulerProfile,
    r frameworkruntime.Registry,
    recorderFact RecorderFactory,
    opts ...frameworkruntime.Option,
) (framework.Framework, error) {
    recorder := recorderFact(cfg.SchedulerName)
    opts = append(opts, frameworkruntime.WithEventRecorder(recorder))

    // 根据 Profile 的 plugins 和 pluginConfig 创建插件实例与执行链。
    return frameworkruntime.NewFramework(ctx, r, &cfg, opts...)
}

// Map 使用 schedulerName 索引各个 Profile 对应的 Framework。
type Map map[string]framework.Framework

func NewMap(...) (Map, error) {
    m := make(Map)
    v := cfgValidator{m: m}

    for _, cfg := range cfgs {
        // 每份 Profile 配置创建一个 Framework。
        p, err := newProfile(ctx, cfg, r, recorderFact, opts...)
        if err != nil {
            ...
        }

        // 检查 schedulerName 和多个 Profile 的 QueueSort 配置。
        if err := v.validate(cfg, p); err != nil {
            return nil, err
        }

        m[cfg.SchedulerName] = p
    }
    return m, nil
}
cfgValidator.validate 检查 Profile 名称是否为空或重复,并比较不同 Profile 的 QueueSort 插件及参数。
Profile 选择
调度一个 Pod 时,frameworkForPod 使用 spec.schedulerName 查询这个 Map:
func (sched *Scheduler) frameworkForPod(pod *v1.Pod) (framework.Framework, error) {
    // schedulerName 决定本次调度使用哪一组插件和插件参数。
    fwk, ok := sched.Profiles[pod.Spec.SchedulerName]
    if !ok {
        return nil, fmt.Errorf(
            "profile not found for scheduler name %q",
            pod.Spec.SchedulerName,
        )
    }
    return fwk, nil
}
选择同一个 Profile 的 Pod 复用同一个 Framework;每次调度尝试创建独立的 CycleState,保存插件的临时计算结果。
Framework 插件管理和调用
Framework 是 Scheduler 根据 Profile 创建的插件管理与调用对象。Scheduler 通过 Framework 运行当前 Profile 配置的扩展点插件。
相关代码位置如下,plugins/ 中列出部分内置插件实现:
pkg/scheduler/framework/
├── interface.go                    # Scheduler 内部使用的 Framework 接口
├── runtime/
│   ├── registry.go                 # Registry 与 PluginFactory:保存插件构造函数
│   └── framework.go                # frameworkImpl、NewFramework 与扩展点插件调用
└── plugins/
    ├── registry.go                            # NewInTreeRegistry:注册内置插件构造函数
    ├── schedulinggates/scheduling_gates.go     # SchedulingGates:PreEnqueue 检查调度门控
    ├── queuesort/priority_sort.go              # PrioritySort:按优先级和入队时间排序
    ├── nodeunschedulable/node_unschedulable.go # NodeUnschedulable:Filter 检查节点禁调度标记
    ├── nodeaffinity/node_affinity.go           # NodeAffinity:节点亲和性筛选与评分
    ├── noderesources/fit.go                    # NodeResourcesFit:资源请求检查与评分
    ├── defaultpreemption/default_preemption.go # DefaultPreemption:PostFilter 抢占,复用 Filter
    ├── volumebinding/volume_binding.go         # VolumeBinding:卷匹配与预留,在 PreBind 中绑定卷
    ├── defaultbinder/default_binder.go         # DefaultBinder:Bind 提交 Pod 绑定请求
    └── ...                                    # 其他内置插件未在此展开

staging/src/k8s.io/kube-scheduler/framework/
└── interface.go                    # 公开的 Handle、PluginsRunner 与扩展点插件接口
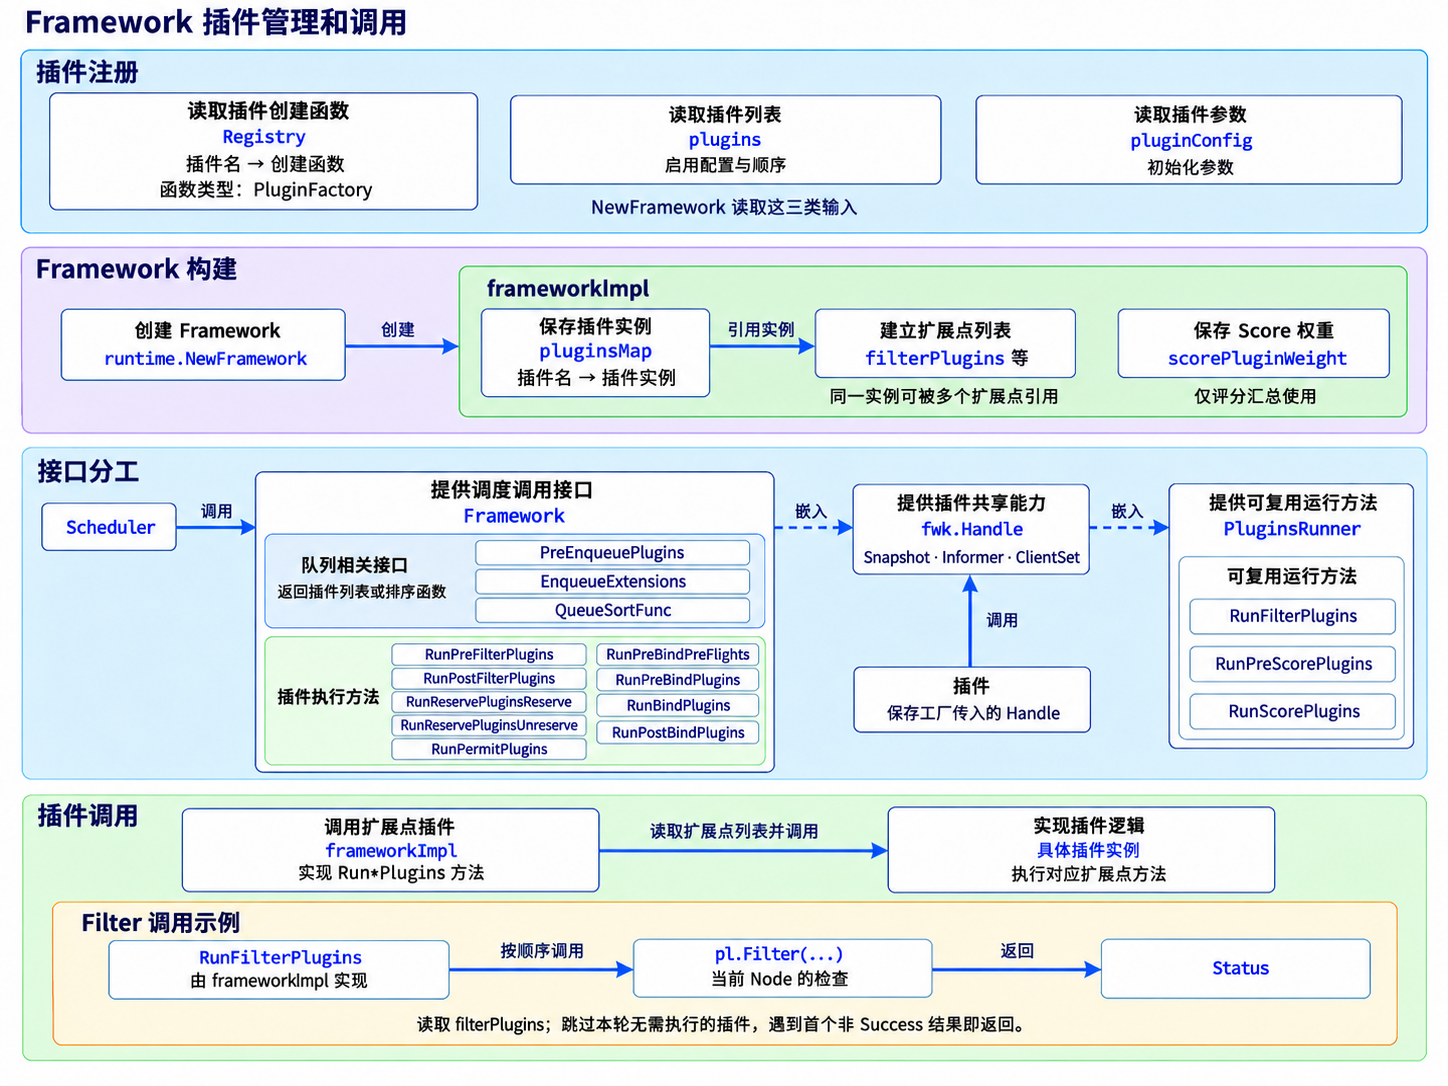
插件注册
- 读取插件构造函数:Registry 按插件注册名称保存构造函数,函数类型统一为
PluginFactory。NewFramework根据当前 Profile 启用的插件名称,找到对应函数。 - 读取插件启用配置:Profile 的
plugins指定各扩展点启用或禁用的插件及其执行顺序。MultiPoint可以一次启用插件,由 Framework 构建过程将其加入所实现的各扩展点。 - 读取插件初始化参数:Profile 的
pluginConfig按插件名称提供创建实例所需的参数。同一个插件实现多个扩展点时,仍使用同一份参数。
Framework 构建
- 创建 Framework:
runtime.NewFramework根据 Registry 和当前 Profile 创建 Framework,只初始化当前 Profile 实际启用的插件。 - 保存插件实例:
frameworkImpl是 Framework 的实现,pluginsMap以插件注册名称为键保存实例,同一插件的多个扩展点可以引用同一个对象。 - 建立扩展点列表:按 Profile 配置建立 PreFilter、Filter、Score、Bind 等列表,保存对应的插件实例和调用顺序。
- 保存 Score 权重:
scorePluginWeight按插件名称保存经过校验的 Score 权重。未设置或配置为0时使用1,只在RunScorePlugins汇总节点分数时使用。
接口分工
- 提供调度调用接口:Framework 提供队列插件访问方法,以及
Run*Plugins等调度和绑定执行入口。Scheduler 通过该接口使用当前 Profile 的插件,具体方法由frameworkImpl实现。 - 提供插件共享能力:
fwk.Handle提供 Snapshot、Informer 和 ClientSet 等能力。Framework 嵌入 Handle;创建插件时,将当前frameworkImpl作为 Handle 传入,插件可以保存并使用它。 - 提供可复用运行方法:Handle 嵌入
PluginsRunner,包含RunFilterPlugins、RunPreScorePlugins和RunScorePlugins等方法。Scheduler 通过 Framework、插件通过 Handle,复用当前 Profile 对应的执行方法。
插件调用
- 调用扩展点插件:
frameworkImpl的Run*Plugins方法读取对应的插件列表,按当前 Profile 配置的顺序调用插件。 - 实现插件逻辑:具体检查由插件自身完成。例如,
NodeResourcesFit的Filter方法检查节点资源是否满足 Pod 的 CPU、内存等请求,并返回检查结果。
Framework 接口
Framework 是 Scheduler 调用当前 Profile 插件的接口,frameworkImpl 是实现这个接口的结构体。Framework 同时嵌入 fwk.Handle,因此也提供节点快照、Informer 和 Kubernetes Client 的访问方法,以及可供插件复用的运行方法:
type Framework interface {
    // Handle 提供节点快照、Informer、Kubernetes Client 等共享能力,
    // 以及可供插件复用的 RunFilterPlugins、RunPreScorePlugins 和 RunScorePlugins。
    fwk.Handle

    // 返回入队插件、事件扩展接口和队列排序函数,供 SchedulingQueue 使用。
    PreEnqueuePlugins() []fwk.PreEnqueuePlugin
    EnqueueExtensions() []fwk.EnqueueExtensions
    QueueSortFunc() fwk.LessFunc

    // 运行筛选前的准备和无可行 Node 时的补救插件。
    RunPreFilterPlugins(
        ctx context.Context, state fwk.CycleState, pod *v1.Pod,
    ) (*fwk.PreFilterResult, *fwk.Status, sets.Set[string])
    RunPostFilterPlugins(
        ctx context.Context, state fwk.CycleState,
        pod *v1.Pod, filteredNodeStatusMap fwk.NodeToStatusReader,
    ) (*fwk.PostFilterResult, *fwk.Status)

    // 在写入 Binding 前后运行对应插件。
    RunPreBindPlugins(
        ctx context.Context, state fwk.CycleState, pod *v1.Pod, nodeName string,
    ) *fwk.Status
    RunPreBindPreFlights(
        ctx context.Context, state fwk.CycleState, pod *v1.Pod, nodeName string,
    ) *fwk.Status
    RunPostBindPlugins(
        ctx context.Context, state fwk.CycleState, pod *v1.Pod, nodeName string,
    )

    // Reserve 先占用插件内部资源;后续失败时按逆序运行 Unreserve。
    RunReservePluginsReserve(
        ctx context.Context, state fwk.CycleState, pod *v1.Pod, nodeName string,
    ) *fwk.Status
    RunReservePluginsUnreserve(
        ctx context.Context, state fwk.CycleState, pod *v1.Pod, nodeName string,
    )
    // Permit 可以放行、拒绝或让 Pod 等待外部条件。
    RunPermitPlugins(
        ctx context.Context, state fwk.CycleState, pod *v1.Pod, nodeName string,
    ) (pluginsWaitTime map[string]time.Duration, status *fwk.Status)
    AddWaitingPod(pod *v1.Pod, pluginsWaitTime map[string]time.Duration)
    WillWaitOnPermit(ctx context.Context, pod *v1.Pod) bool
    WaitOnPermit(ctx context.Context, pod *v1.Pod) *fwk.Status

    // Bind 插件提交 Pod 与 Node 的绑定关系。
    RunBindPlugins(
        ctx context.Context, state fwk.CycleState, pod *v1.Pod, nodeName string,
    ) *fwk.Status

    // ...
    Close() error
}
RunFilterPlugins、RunPreScorePlugins 和 RunScorePlugins 没有直接声明在上面的 Framework 接口中,而是定义在 PluginsRunner 中。Framework 嵌入 fwk.Handle,fwk.Handle 再嵌入 PluginsRunner,因此 Scheduler 仍然可以通过 Framework 调用这些方法:
type Handle interface {
    ...
    // 允许插件复用 Framework 的 Filter、PreScore 和 Score 执行逻辑。
    PluginsRunner
    ...
}

type PluginsRunner interface {
    RunPreScorePlugins(
        context.Context, CycleState, *v1.Pod, []NodeInfo,
    ) *Status
    RunScorePlugins(
        context.Context, CycleState, *v1.Pod, []NodeInfo,
    ) ([]NodePluginScores, *Status)
    RunFilterPlugins(
        context.Context, CycleState, *v1.Pod, NodeInfo,
    ) *Status
    ...
}
RunFilterPlugins、RunPreScorePlugins 和 RunScorePlugins 最初直接声明在 Framework 接口中,后来为了让获得 Handle 的插件复用这些运行方法,被提取到独立的 PluginsRunner 接口。
例如,DefaultPreemption 在抢占模拟中移除低优先级 Pod 后,通过 Handle 间接调用 RunFilterPlugins,复用当前 Profile 的 Filter 插件,检查当前 Pod 能否调度:
// plugins/defaultpreemption/default_preemption.go
type DefaultPreemption struct {
    fh fwk.Handle
    ...
}

// 编译期确认 DefaultPreemption 实现 PostFilterPlugin 接口。
var _ fwk.PostFilterPlugin = &DefaultPreemption{}

func (pl *DefaultPreemption) SelectVictimsOnNode(
    ctx context.Context,
    state fwk.CycleState,
    pod *v1.Pod,
    nodeInfo fwk.NodeInfo,
    pdbs []*policy.PodDisruptionBudget,
) ([]*v1.Pod, int, *fwk.Status) {
    ...
    // 使用当前 Profile 的 Filter 插件检查移除候选 Pod 后的 Node。
    if status := pl.fh.RunFilterPluginsWithNominatedPods(
        ctx, state, pod, nodeInfo,
    ); !status.IsSuccess() {
        return nil, 0, status
    }
    ...
}

// runtime/framework.go
func (f *frameworkImpl) RunFilterPluginsWithNominatedPods(
    ctx context.Context,
    state fwk.CycleState,
    pod *v1.Pod,
    info fwk.NodeInfo,
) *fwk.Status {
    ...
    // stateToUse 和 nodeInfoToUse 是本次检查使用的状态和节点视图。
    // 调用当前 Profile 的 Filter 插件。
    status = f.RunFilterPlugins(ctx, stateToUse, pod, nodeInfoToUse)
    ...
    return status
}
插件注册
Registry 是一个 Map,按插件注册名称保存插件构造函数,函数类型统一为 PluginFactory。
构造函数接收 Context、插件初始化参数和 Handle,返回插件实例及错误。对应的类型定义如下:
// PluginFactory 是插件构造函数的统一类型,调用后返回插件实例。
type PluginFactory = func(
    ctx context.Context,
    // configuration 对应当前插件的 pluginConfig.args。
    configuration runtime.Object,
    // f 向插件提供 Snapshot、Informer 和 ClientSet 等共享能力。
    f fwk.Handle,
) (fwk.Plugin, error)

// Registry 按插件名称保存对应的插件构造函数。
type Registry map[string]PluginFactory
内置插件由 NewInTreeRegistry 统一注册,每个注册项将插件名称与构造函数关联:
func NewInTreeRegistry() runtime.Registry {
    fts := plfeature.NewSchedulerFeaturesFromGates(feature.DefaultFeatureGate)
    registry := runtime.Registry{
        // 插件注册名称对应构造函数,调用该函数后才创建实例。
        nodeports.Name:         runtime.FactoryAdapter(fts, nodeports.New),
        nodeaffinity.Name:      runtime.FactoryAdapter(fts, nodeaffinity.New),
        podtopologyspread.Name: runtime.FactoryAdapter(fts, podtopologyspread.New),
        noderesources.Name:     runtime.FactoryAdapter(fts, noderesources.NewFit),
        volumebinding.Name:     runtime.FactoryAdapter(fts, volumebinding.New),
        ...
    }
    return registry
}
以 NodePorts 这一项为例:
- 注册名称:
nodeports.Name的值是"NodePorts",作为 Registry 的键。 - 构造函数:
nodeports.New初始化并返回 NodePorts 插件实例。 - Registry 中的值:
FactoryAdapter(fts, nodeports.New)预先保存特性开关配置fts(features的简写),返回PluginFactory类型的包装函数。Framework 调用它时,包装函数会将fts一并传给nodeports.New。
Registry 保存可用插件的构造函数,实际启用哪些插件、使用什么参数,由当前调度策略对应的 Profile 决定。Profile 的 plugins 按注册名称选择插件,pluginConfig 提供初始化参数,字段说明见Profile 配置。
NewFramework 读取 Profile 配置,按插件名称从 Registry 中找到构造函数,再传入对应参数创建插件实例,具体过程见Framework 构建。
Framework 构建
插件创建后,frameworkImpl 负责保存实例和执行列表。pluginsMap 按插件注册名称保存实例,filterPlugins 等列表按配置顺序引用这些实例;同一个实例可以供多个扩展点使用:
type frameworkImpl struct {
    registry Registry

    // 按插件名称保存经过校验的 Score 权重,仅 RunScorePlugins 使用。
    scorePluginWeight map[string]int

    // 各扩展点按 Profile 配置保存插件调用顺序。
    preEnqueuePlugins         []fwk.PreEnqueuePlugin
    enqueueExtensions         []fwk.EnqueueExtensions
    queueSortPlugins          []fwk.QueueSortPlugin
    preFilterPlugins          []fwk.PreFilterPlugin
    filterPlugins             []fwk.FilterPlugin
    postFilterPlugins         []fwk.PostFilterPlugin
    preScorePlugins           []fwk.PreScorePlugin
    scorePlugins              []fwk.ScorePlugin
    reservePlugins            []fwk.ReservePlugin
    preBindPlugins            []fwk.PreBindPlugin
    bindPlugins               []fwk.BindPlugin
    postBindPlugins           []fwk.PostBindPlugin
    permitPlugins             []fwk.PermitPlugin

    // 每个插件名称只对应一个实例,各扩展点列表引用这里的对象。
    pluginsMap map[string]fwk.Plugin

    ...
}
NewFramework 按以下顺序创建插件并建立扩展点列表:
-
选择插件:根据当前 Profile 的启用列表,从 Registry 中选出需要创建的插件。
-
创建插件实例:根据插件配置创建实例,按插件名称保存到
pluginsMap,供各扩展点调用。 -
处理各扩展点配置:
updatePluginList处理plugins.filter、plugins.score等逐个扩展点的配置,将插件实例按配置顺序加入对应执行列表。例如,Filter 插件保存到filterPlugins;过滤某个节点时,Scheduler 调用RunFilterPlugins,由它循环遍历该列表,依次执行插件的Filter方法。 -
展开 MultiPoint 配置:
expandMultiPointPlugins处理plugins.multiPoint,根据插件实现的扩展点接口,将配置合并到前面建立的同一组执行列表中。例如,同时实现 Filter 和 Score 的插件会被加入filterPlugins和scorePlugins。各扩展点显式配置的enabled或disabled优先于 MultiPoint。NodeAffinity 的 MultiPoint 配置
以
NodeAffinity为例,它实现了 PreFilter、Filter、PreScore 和 Score 接口。分别配置各扩展点时,需要在各自的enabled中填写插件名称:plugins: preFilter: enabled: - name: NodeAffinity filter: enabled: - name: NodeAffinity preScore: enabled: - name: NodeAffinity score: enabled: - name: NodeAffinity使用
multiPoint时,只需填写一次插件名称,Framework 就会将它加入所实现的各扩展点:
func NewFramework(
    ctx context.Context,
    r Registry,
    profile *config.KubeSchedulerProfile,
    opts ...Option,
) (framework.Framework, error) {
    ...
    f := &frameworkImpl{
        registry: r,
        ...,
    }
    f.profileName = profile.SchedulerName

    // 收集当前 Profile 启用的插件名称。
    pg := f.pluginsNeeded(profile.Plugins)
    // 将 pluginConfig 整理为“插件名称 → 初始化参数”,供后续创建实例时读取。
    pluginConfig := make(map[string]runtime.Object, len(profile.PluginConfig))
    for i := range profile.PluginConfig {
        name := profile.PluginConfig[i].Name
        if _, ok := pluginConfig[name]; ok {
            return nil, fmt.Errorf("repeated config for plugin %s", name)
        }
        pluginConfig[name] = profile.PluginConfig[i].Args
    }

    f.pluginsMap = make(map[string]fwk.Plugin)
    // 遍历 Registry:name 是插件注册名称,factory 是该名称对应的构造函数。
    // factory 的类型是 PluginFactory,调用它才会创建插件实例。
    for name, factory := range r {
        // 只创建当前 Profile 启用的插件。
        if !pg.Has(name) {
            continue
        }

        // 按插件名称取得初始化参数,来自该插件的 pluginConfig.args。
        args := pluginConfig[name]
        // 调用构造函数,将参数 args 和当前 Framework f 传入,得到插件实例 p。
        // f 作为 fwk.Handle 使用,供插件访问节点快照、Informer 和 ClientSet。
        p, err := factory(ctx, args, f)
        if err != nil {
            return nil, fmt.Errorf("initializing plugin %q: %w", name, err)
        }
        // 按插件注册名称保存实例,后续各扩展点列表引用同一个对象。
        f.pluginsMap[name] = p
        f.fillEnqueueExtensions(p)
    }

    // 按各扩展点的 enabled 配置,从 pluginsMap 取得实例并依次加入 filterPlugins 等执行列表。
    for _, point := range f.getExtensionPoints(profile.Plugins) {
        if err := updatePluginList(point.slicePtr, *point.plugins, f.pluginsMap); err != nil {
            return nil, err
        }
    }
    // 将 MultiPoint 配置合并到前面建立的各扩展点执行列表。
    // 各扩展点的显式 enabled/disabled 配置优先于 MultiPoint。
    if len(profile.Plugins.MultiPoint.Enabled) > 0 {
        if err := f.expandMultiPointPlugins(logger, profile); err != nil {
            return nil, err
        }
    }

    ...
    return f, nil
}
插件调用
filterPlugins 中的每个插件实例都实现 FilterPlugin 接口。该接口规定插件需要提供 Filter 方法,用于检查当前 Pod 是否能在给定节点上运行:
type FilterPlugin interface {
    // Plugin 提供获取插件名称的 Name 方法。
    Plugin

    // 检查当前 Pod 能否在候选节点上运行,并返回检查结果。
    Filter(
        ctx context.Context,
        state CycleState,
        pod *v1.Pod,
        nodeInfo NodeInfo,
    ) *Status
}
运行过滤时,RunFilterPlugins 遍历列表,取出插件实例 pl,通过 runFilterPlugin 最终调用 pl.Filter(...),执行该插件自己的过滤逻辑。本轮无需执行的插件会被跳过,遇到首个非 Success 结果即返回:
func (f *frameworkImpl) RunFilterPlugins(
    ctx context.Context,
    state fwk.CycleState,
    pod *v1.Pod,
    nodeInfo fwk.NodeInfo,
) *fwk.Status {
    for _, pl := range f.filterPlugins {
        // PreFilter 返回 Skip 时,同名 Filter 插件在本轮一起跳过。
        if state.GetSkipFilterPlugins().Has(pl.Name()) {
            continue
        }

        if status := f.runFilterPlugin(ctx, pl, state, pod, nodeInfo); !status.IsSuccess() {
            // Filter 只应返回 Success 或拒绝状态;其他状态按插件错误处理。
            if !status.IsRejected() {
                status = fwk.AsStatus(fmt.Errorf(
                    "running %q filter plugin: %w", pl.Name(), status.AsError(),
                ))
            }
            // 失败状态携带插件名,供诊断和 QueueingHint 使用。
            status.SetPlugin(pl.Name())
            return status
        }
    }
    return nil
}
CycleState
CycleState 是本轮调度中插件共享计算结果的键值存储。同一个 CycleState 的 storage 可以同时保存多个插件的数据,各插件使用不同的键写入和读取自己的状态。后续检查不同 Node 时,可以复用已经保存的计算结果。
下图展示 NodeResourcesFit、NodePorts 和 NodeAffinity 三个插件如何在同一份 storage 中保存三条状态记录,再由各自的 Filter 读取。
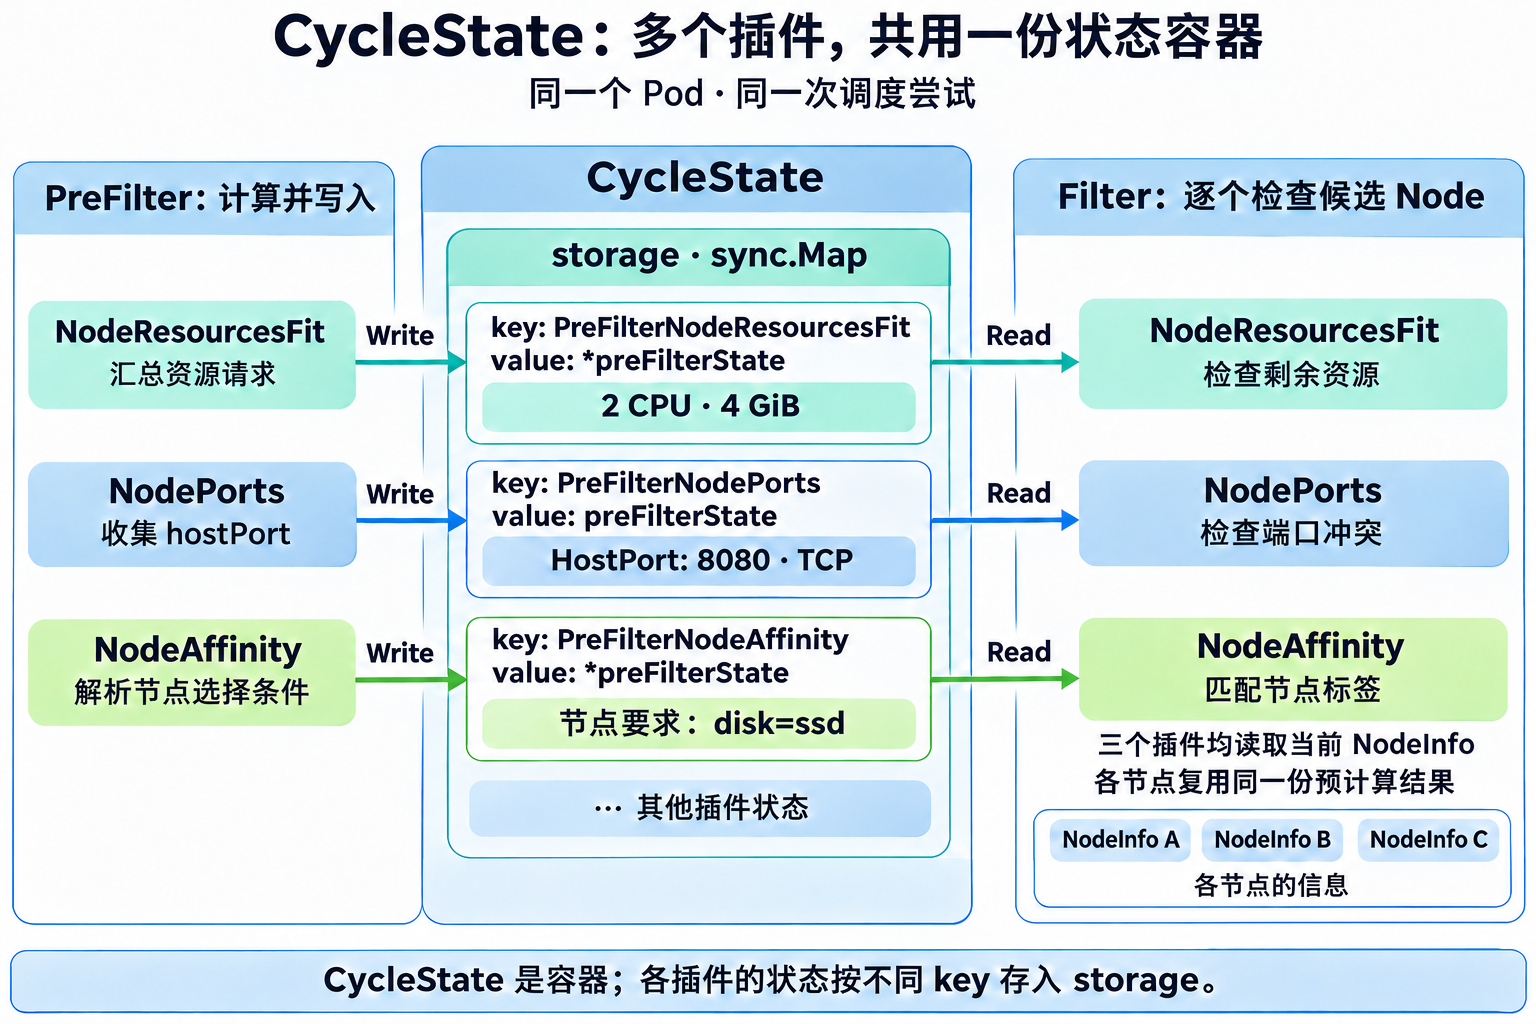
图:同一 CycleState 中的多个插件状态。
插件通过 CycleState 接口读写状态,实际数据由 pkg/scheduler/framework 包中的同名结构体保存。下面列出结构体的全部字段,其中 storage 保存插件数据,其余字段记录本轮插件执行的控制信息和关联状态:
type CycleState struct {
    // 插件计算结果:键为 StateKey,值实现 StateData 接口。
    storage sync.Map

    // 是否记录本轮插件执行耗时指标。
    recordPluginMetrics bool

    // 本轮各扩展点需要跳过的插件。
    skipFilterPlugins sets.Set[string]
    skipScorePlugins sets.Set[string]
    skipPreBindPlugins sets.Set[string]

    // 是否跳过全部 PostFilter 插件。
    skipAllPostFilterPlugins bool

    // 允许并行执行的 PreBind 插件。
    parallelPreBindPlugins sets.Set[string]

    // 当前 Pod 关联的 PodGroup 调度状态。
    podGroupCycleState fwk.PodGroupCycleState
}
storage 使用 sync.Map 保存插件状态:键类型为 StateKey,值可以是插件自行定义的不同类型,只要实现 StateData 接口即可。图中的三条记录分别来自以下插件:
NodeResourcesFit:以PreFilterNodeResourcesFit为键,保存*preFilterState。该结构体嵌入framework.Resource,保存 Pod 的 CPU、内存等资源请求,例如 2 CPU、4 GiB 内存,供 Filter 检查节点资源是否充足。NodePorts:以PreFilterNodePorts为键,保存preFilterState。该类型是以[]v1.ContainerPort定义的切片,保存 Pod 的主机端口需求,例如HostPort: 8080、Protocol: TCP,供 Filter 检查端口冲突。NodeAffinity:以PreFilterNodeAffinity为键,保存*preFilterState。其中的requiredNodeSelectorAndAffinity保存解析后的必需节点选择条件,例如nodeSelector要求disk=ssd,供 Filter 匹配节点标签。
这三个 preFilterState 分别定义在不同插件包中,是彼此独立的类型。状态类型的名称和字段均由插件自行定义,不必统一叫作 preFilterState。
SchedulingQueue
SchedulingQueue 是 Scheduler 使用的队列接口,定义等待调度 Pod 的加入、更新、取出和重新入队操作。
相关代码位置如下:
pkg/scheduler/
├── backend/queue/
│   ├── scheduling_queue.go         # SchedulingQueue、PriorityQueue 与重新入队策略
│   ├── active_queue.go             # activeQueue、取出 Pod 与调度期间的事件跟踪
│   ├── backoff_queue.go            # 普通退避与错误退避队列
│   └── unschedulable_pods.go        # 保存等待相关事件的不可调度 Pod
├── scheduler.go                    # 创建 SchedulingQueue 并启动后台任务
├── eventhandlers.go                # 将待调度 Pod 变化与相关集群事件交给队列
└── schedule_one.go                 # 取出 Pod,处理失败后的重新入队
下图展示 Pod 在 activeQ、backoffQ 和 unschedulablePods 之间的主要流转路径。
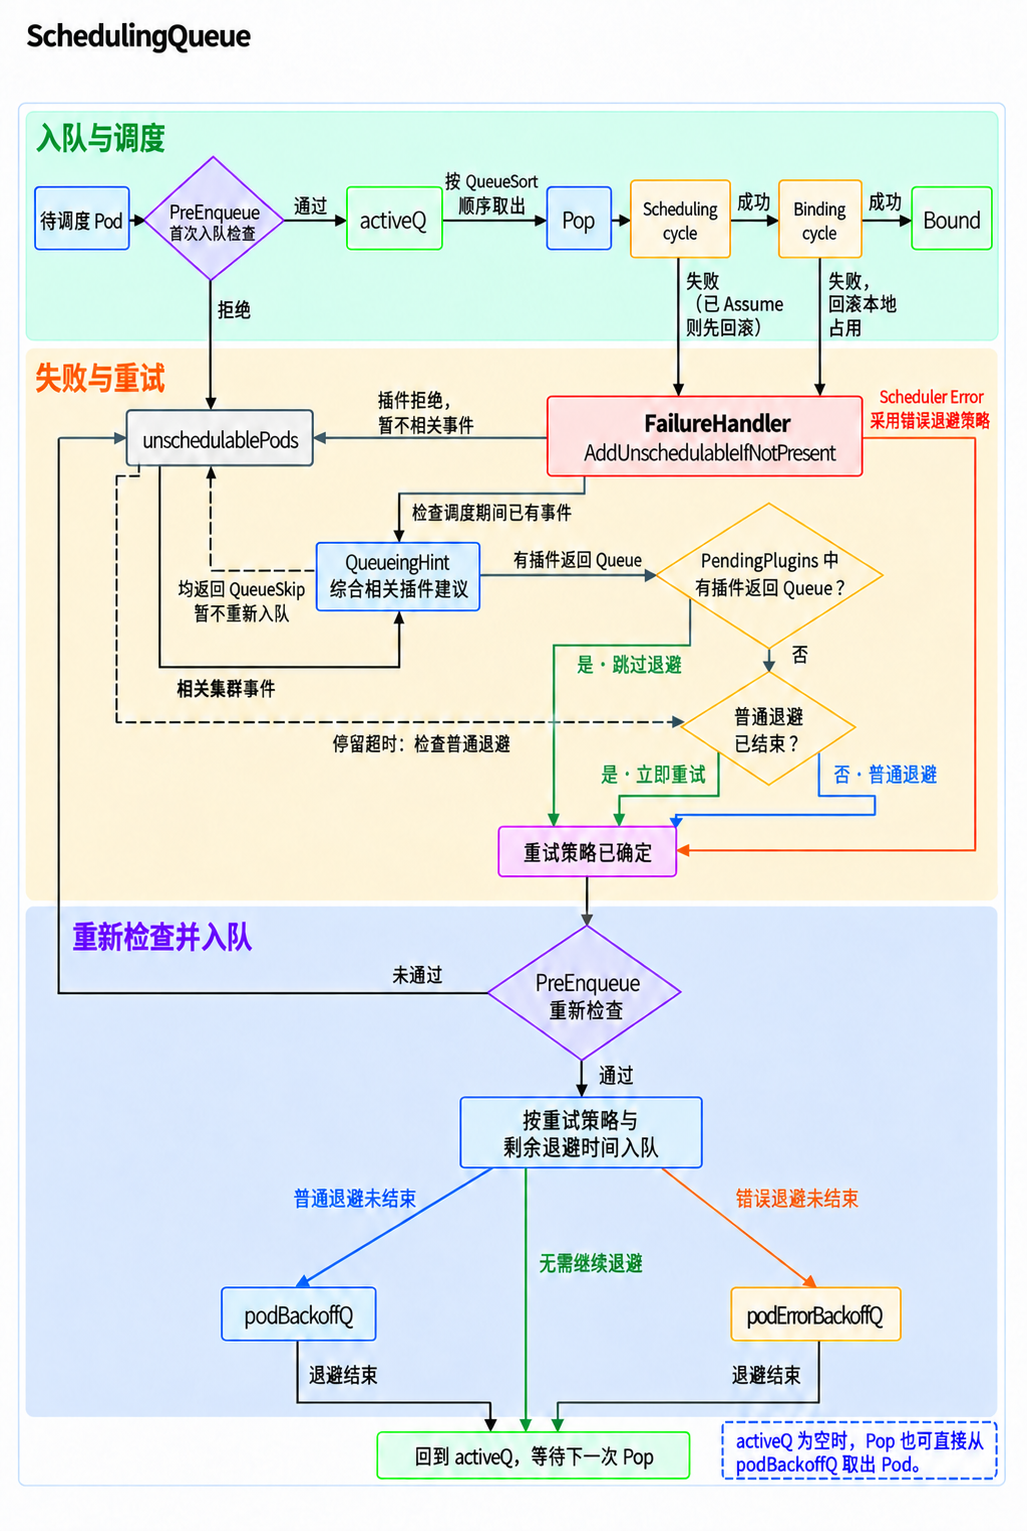
- 接收待调度 Pod:Scheduler 将自己负责、尚未分配节点的 Pod 加入 SchedulingQueue,等待调度。
- 检查首次入队:Pod 先运行对应 Profile 的 PreEnqueue 插件。全部通过后进入
activeQ;任一插件拒绝后进入unschedulablePods,并记录拒绝它的插件。 - 取出 Pod:Scheduler 按 QueueSort 的顺序从
activeQ取出 Pod,再根据spec.schedulerName选择对应 Profile 的 Framework。启用SchedulerPopFromBackoffQ后,activeQ为空时也可以直接从podBackoffQ取出一个 Pod。 -
执行调度与绑定:
- 调度阶段成功:Scheduler 启动异步的绑定阶段。
- 调度阶段失败:FailureHandler 调用
AddUnschedulableIfNotPresent处理重新入队。- 插件拒绝且调度期间没有相关事件时,Pod 进入
unschedulablePods。 - 插件拒绝且调度期间已经发生相关事件时,Scheduler 调用相应插件的 QueueingHint,判断该事件是否可能改变上次的调度结果,以及是否需要重新入队。
- Scheduler Error 进入
podErrorBackoffQ的重试路径。
- 插件拒绝且调度期间没有相关事件时,Pod 进入
- 绑定阶段成功:API Server 保存绑定结果,Pod 进入 Bound 状态。
- 绑定阶段失败:Scheduler 回滚本地状态,再由 FailureHandler 处理重新入队。
-
重新入队:SchedulingQueue 根据失败原因、相关事件和退避状态安排 Pod 重试。
- 重新检查:相关集群事件到达时,通过 QueueingHint 判断
unschedulablePods中的 Pod 是否值得重试;停留超时 也会触发检查。没有重试建议时,Pod 继续等待。 - 选择目标队列:跳过退避或退避已结束时,目标为
activeQ;尚需普通退避或错误退避时,目标分别为podBackoffQ和podErrorBackoffQ。 - 检查入队条件:默认配置下,重新入队前运行 PreEnqueue。通过后写入目标队列,未通过则进入
unschedulablePods。
- 重新检查:相关集群事件到达时,通过 QueueingHint 判断
PriorityQueue
Scheduler 创建过程中会调用 NewSchedulingQueue,得到默认实现 PriorityQueue。PriorityQueue 使用三个字段保存不同状态的 Pod:
activeQ:现在可以尝试调度的 Pod。backoffQ:保存已经满足重新入队条件、但仍处于退避期的 Pod。podBackoffQ保存插件拒绝后等待普通退避结束的 Pod;podErrorBackoffQ保存发生 Scheduler Error 后等待错误退避结束的 Pod。unschedulablePods:保存尚未满足重新入队条件的 Pod,等待可能改变上次调度结果的集群事件。
type PriorityQueue struct {
    // 保存可以取出并尝试调度的 Pod。
    activeQ activeQueuer
    // 保存需要普通退避或错误退避的 Pod。
    backoffQ backoffQueuer
    // 保存暂时不能重新入队的 Pod。
    unschedulablePods *unschedulablePods
    ...
}
activeQ 和 backoffQ 是接口字段,具体实现分别是 activeQueue 和 backoffQueue;unschedulablePods 字段直接指向同名结构体。activeQueue、backoffQueue 使用 Heap 保存调度记录,unschedulablePods 使用 Map,保存的类型都是 *framework.QueuedPodInfo。对应字段如下:
// active_queue.go:activeQ 的 Heap 保存 QueuedPodInfo 指针。
type activeQueue struct {
    queue *heap.Heap[*framework.QueuedPodInfo]
    ...
}

// backoff_queue.go:两个退避队列也保存 QueuedPodInfo 指针。
type backoffQueue struct {
    podBackoffQ      *heap.Heap[*framework.QueuedPodInfo]
    podErrorBackoffQ *heap.Heap[*framework.QueuedPodInfo]
    ...
}

// unschedulable_pods.go:Map 的值是 QueuedPodInfo 指针。
type unschedulablePods struct {
    podInfoMap map[string]*framework.QueuedPodInfo
    ...
}
QueuedPodInfo 是每个待调度 Pod 自己的队列记录。它包装 Pod 对象,并保存入队时间、失败插件和退避信息,供这个 Pod 后续排序和重新入队时使用:
type QueuedPodInfo struct {
    // 包含 Pod 对象及调度所需的 Pod 信息。
    *PodInfo

    // 本次加入队列的时间,以及退避截止时间。
    Timestamp         time.Time
    BackoffExpiration time.Time

    // 记录调度失败或入队检查失败涉及的插件名称,供事件处理筛选回调。
    UnschedulablePlugins sets.Set[string]
    // 记录返回 Pending、要求结束本轮调度尝试的插件名称。
    PendingPlugins sets.Set[string]

    // 当前阻止 Pod 入队的 PreEnqueue 插件名称;空字符串表示没有入队阻塞。
    GatingPlugin string
    ...
}
这几个字段保存与当前 Pod 的调度或入队失败有关的插件名称:
UnschedulablePlugins:记录导致本轮调度失败、返回Unschedulable或UnschedulableAndUnresolvable的插件名称。PendingPlugins:记录返回Pending的插件名称。这类插件要求结束本轮调度尝试,等待后续条件满足;队列会保留它们的名称,供相关事件到达时检查是否可以跳过退避重试。GatingPlugin:记录当前在 PreEnqueue 阻止入队的插件名称。例如,SchedulingGates 发现 Pod 的调度门控尚未移除,队列就将该字段设为"SchedulingGates"。
activeQ
activeQ 保存可以尝试调度的 Pod,使用 Heap 维护取出顺序。排序规则由 QueueSort 插件提供:Scheduler 取得 QueueSortFunc,再把比较函数传入 NewPriorityQueue,供 Heap 使用。
NewPriorityQueue 先初始化退避队列和不可调度 Pod 集合,再创建使用 QueueSort 比较函数的 Heap,并将它交给 activeQueue:
func NewPriorityQueue(
    lessFn fwk.LessFunc,
    informerFactory informers.SharedInformerFactory,
    opts ...Option,
) *PriorityQueue {
    options := defaultPriorityQueueOptions
    ...
    for _, opt := range opts {
        opt(&options)
    }

    isSchedulingQueueHintEnabled := utilfeature.DefaultFeatureGate.Enabled(
        features.SchedulerQueueingHints,
    )
    isPopFromBackoffQEnabled := utilfeature.DefaultFeatureGate.Enabled(
        features.SchedulerPopFromBackoffQ,
    )
    // 将 QueueSort 的比较函数转换为内部队列所需的类型。
    lessConverted := convertLessFn(lessFn)

    // 创建退避队列,供 PriorityQueue 和 activeQueue 使用。
    backoffQ := newBackoffQueue(
        options.clock,
        options.podInitialBackoffDuration,
        options.podMaxBackoffDuration,
        lessFn,
        isPopFromBackoffQEnabled,
    )
    pq := &PriorityQueue{
        backoffQ: backoffQ,
        unschedulablePods: newUnschedulablePods(
            metrics.NewUnschedulablePodsRecorder(),
            metrics.NewGatedPodsRecorder(),
        ),
        ...
    }

    // 启用提前取出时,让 activeQueue 能够访问普通退避队列。
    var backoffQPopper backoffQPopper
    if isPopFromBackoffQEnabled {
        backoffQPopper = backoffQ
    }

    // 创建 Heap,再交给 activeQueue 保存和取出 Pod。
    pq.activeQ = newActiveQueue(
        heap.NewWithRecorder(
            podInfoKeyFunc,
            heap.LessFunc[*framework.QueuedPodInfo](lessConverted),
            metrics.NewActivePodsRecorder(),
        ),
        isSchedulingQueueHintEnabled,
        options.metricsRecorder,
        backoffQPopper,
    )
    ...
    return pq
}
unschedulablePods
unschedulablePods 保存 PreEnqueue 未通过,或调度失败后尚未满足重试条件的 Pod。它使用 Map,以 Pod 的 namespace/name 为键,保存对应的 QueuedPodInfo 指针:
type unschedulablePods struct {
    // 键为 Pod 的 namespace/name,值为该 Pod 的调度记录。
    podInfoMap map[string]*framework.QueuedPodInfo
    keyFunc    func(*framework.QueuedPodInfo) string
    ...
}
相关集群事件到达时,队列通过 QueueingHint 判断是否重试;Pod 停留超时 时也会触发重新入队检查。
backoffQ
backoffQ 内部使用两个 Heap,分别处理插件拒绝和 Scheduler Error。两者使用相同的指数退避算法,默认初始退避为 1 秒、最大为 10 秒,但使用不同的失败计数:
podBackoffQ:保存因插件原因进入普通退避的 Pod,按该 Pod 因插件原因调度失败的次数计算退避。默认配置下,activeQ为空时可以提前取出其中的 Pod。podErrorBackoffQ:保存因 Scheduler Error 进入错误退避的 Pod,例如访问 API Server 时发生临时错误。
backoffQueue.add 为需要退避的 Pod 选择队列:有失败插件名称记录时进入 podBackoffQ;UnschedulablePlugins 和 PendingPlugins 都为空时进入 podErrorBackoffQ,使用错误退避。
func (bq *backoffQueue) add(
    logger klog.Logger,
    pInfo *framework.QueuedPodInfo,
    event string,
) {
    ...
    // UnschedulablePlugins 和 PendingPlugins 都为空,使用错误退避队列。
    if pInfo.UnschedulablePlugins.Len() == 0 && pInfo.PendingPlugins.Len() == 0 {
        bq.podErrorBackoffQ.AddOrUpdate(pInfo)
        ...
        return
    }

    // 有不可调度或 Pending 插件记录,使用普通退避队列。
    bq.podBackoffQ.AddOrUpdate(pInfo)
    ...
}
Pod 加入退避队列后,由队列的后台任务检查退避是否结束。Scheduler 启动队列时调用 PriorityQueue.Run,它启动独立 goroutine,定期运行 flushBackoffQCompleted。该方法从 podBackoffQ 和 podErrorBackoffQ 两个 Heap 中取出退避已结束的 Pod,移回 activeQ,并唤醒等待中的 Pop:
func (p *PriorityQueue) Run(logger klog.Logger) {
    // 启动后台任务,定期检查退避队列。
    go p.backoffQ.waitUntilAlignedWithOrderingWindow(func() {
        p.flushBackoffQCompleted(logger)
    }, p.stop)
    ...
}

func (p *PriorityQueue) flushBackoffQCompleted(logger klog.Logger) {
    p.lock.Lock()
    defer p.lock.Unlock()

    // 从普通退避和错误退避两个 Heap 中取出已到期的 Pod。
    podsCompletedBackoff := p.backoffQ.popAllBackoffCompleted(logger)
    activated := false
    for _, pInfo := range podsCompletedBackoff {
        // true 标记这个 Pod 直接从退避队列转入 activeQ。
        if added := p.moveToActiveQ(logger, pInfo, framework.BackoffComplete, true); added {
            activated = true
        }
    }
    // 有 Pod 成功进入 activeQ 时,唤醒等待中的 Pop。
    if activated {
        p.activeQ.broadcast()
    }
}
回到 activeQ 后,Pod 按 QueueSort 的顺序等待 Scheduler 下一次取出。
Pod 取出
Scheduler 通过 NextPod 取出下一个 Pod,默认调用 PriorityQueue.Pop。
队列优先从 activeQ 的 Heap 取出队首 Pod。默认启用 SchedulerPopFromBackoffQ:activeQ 为空且普通退避队列非空时,也可以直接取出 podBackoffQ 的队首,不必等待退避结束。podErrorBackoffQ 不参与这条提前取出路径。
没有可取出的 Pod 时,Pop 会阻塞等待:
func (aq *activeQueue) pop(logger klog.Logger) (*framework.QueuedPodInfo, error) {
    aq.lock.Lock()
    defer aq.lock.Unlock()
    return aq.unlockedPop(logger)
}

func (aq *activeQueue) unlockedPop(logger klog.Logger) (*framework.QueuedPodInfo, error) {
    var pInfo *framework.QueuedPodInfo
    for aq.queue.Len() == 0 {
        // activeQ 为空时,允许直接从普通退避队列取出 Pod。
        if aq.backoffQPopper != nil && aq.backoffQPopper.lenBackoff() != 0 {
            break
        }
        // 关闭队列时结束等待,使 Pop 能够退出。
        if aq.closed {
            return nil, nil
        }
        // 没有可取出的 Pod,在这里阻塞当前取 Pod 的 goroutine。
        // 收到入队或关闭通知后被唤醒,再次检查队列。
        aq.cond.Wait()
    }

    // 优先从 activeQ 取出队首 Pod。
    pInfo, err := aq.queue.Pop()
    if err != nil {
        if aq.backoffQPopper == nil {
            return nil, err
        }
        // activeQ 为空,改从 podBackoffQ 取出。
        pInfo, err = aq.backoffQPopper.popBackoff()
        if err != nil {
            return nil, err
        }
    }
    ...
    return pInfo, nil
}
返回的 QueuedPodInfo 交给 Scheduler 开始本轮调度。调度失败后,失败处理会更新这份记录中的失败插件和退避信息,再决定如何重新入队。
Pod 重新入队
本轮调度失败后,失败处理会将仍需重试的 Pod 交回 SchedulingQueue,由队列安排等待或再次调度。对于已经在 unschedulablePods 中等待的 Pod,队列会在相关集群事件到达后重新检查,判断是否需要重试。
调度失败
本轮调度失败后,FailureHandler 调用 AddUnschedulableIfNotPresent,处理当前刚失败的一个 Pod。它通过 determineSchedulingHintForInFlightPod 检查这个 Pod 本轮调度期间已记录的多个事件,根据返回的建议安排等待或重试。
例如,Pod A 因 CPU 不足被 NodeResourcesFit 拒绝,插件返回 Unschedulable。本轮失败处理开始前,节点上的另一个已绑定 Pod 被删除,队列记录了这条事件。Pod A 返回队列时,NodeResourcesFit 的 QueueingHint 根据这条删除事件返回 Queue,建议再次尝试调度:
func (p *PriorityQueue) AddUnschedulableIfNotPresent(
    logger klog.Logger,
    pInfo *framework.QueuedPodInfo,
    podSchedulingCycle int64,
) error {
    ...
    // 更新本次返回队列的时间,清除上次计算的退避截止时间。
    pInfo.Timestamp = p.clock.Now()
    pInfo.BackoffExpiration = time.Time{}
    ...
    // 针对当前这一个 Pod,检查它本轮调度期间已记录的事件。
    schedulingHint := p.determineSchedulingHintForInFlightPod(logger, pInfo)
    // 交给统一方法选择队列,并在写入前检查入队条件。
    queue := p.requeuePodWithQueueingStrategy(
        logger, pInfo, schedulingHint, framework.ScheduleAttemptFailure,
    )
    if queue == activeQ || (p.isPopFromBackoffQEnabled && queue == backoffQ) {
        p.activeQ.broadcast()
    }
    return nil
}
事件触发
相关集群事件到达时,movePodsToActiveOrBackoffQueue 用这一个新事件检查 unschedulablePods 中等待的一批 Pod。它通过 isPodWorthRequeuing 获取各 Pod 关联插件的 QueueingHint 建议。没有重试建议时继续等待,有建议时安排重新入队:
func (p *PriorityQueue) movePodsToActiveOrBackoffQueue(
    logger klog.Logger,
    podInfoList []*framework.QueuedPodInfo,
    event fwk.ClusterEvent,
    oldObj, newObj interface{},
) {
    if !p.isEventOfInterest(logger, event) {
        return
    }

    activated := false
    // 用同一个新事件,逐个检查等待中的 Pod。
    for _, pInfo := range podInfoList {
        ...
        // 判断当前事件是否可能改善这个 Pod 的调度结果。
        strategy := p.isPodWorthRequeuing(logger, pInfo, event, oldObj, newObj)
        if strategy == queueSkip {
            // 没有重试建议,继续留在 unschedulablePods。
            continue
        }

        // 交给重新入队方法处理退避、入队检查和目标队列选择。
        p.unschedulablePods.delete(pInfo.Pod, pInfo.Gated())
        queue := p.requeuePodWithQueueingStrategy(logger, pInfo, strategy, event.Label())
        if queue == activeQ || (p.isPopFromBackoffQEnabled && queue == backoffQ) {
            activated = true
        }
    }
    ...
    // 通知等待中的 Pop 重新检查可取出的 Pod。
    if activated {
        p.activeQ.broadcast()
    }
}
入队处理
调度失败处理和事件处理得到的重试建议,作为 strategy 参数传给 requeuePodWithQueueingStrategy。该方法结合 pInfo.BackoffExpiration 保存的退避截止时间选择目标队列:无需继续退避的 Pod 进入 activeQ,仍需普通退避或错误退避的 Pod 分别进入 podBackoffQ、podErrorBackoffQ。自定义插件返回 Pending 后,若关联的 QueueingHint 建议重试,可以跳过退避。
写入目标队列前,还要检查 Pod 是否满足入队条件。默认配置下,moveToActiveQ 和 moveToBackoffQ 会运行 PreEnqueue;检查未通过时,将 Pod 放回 unschedulablePods:
func (p *PriorityQueue) requeuePodWithQueueingStrategy(
    logger klog.Logger,
    pInfo *framework.QueuedPodInfo,
    strategy queueingStrategy,
    event string,
) string {
    if strategy == queueSkip {
        // 暂不重新入队,继续等待相关事件。
        p.unschedulablePods.addOrUpdate(pInfo, pInfo.Gated(), event)
        return unschedulableQ
    }

    // strategy 指示本次重试需要遵守退避。
    // isPodBackingoff 读取或计算 pInfo 的退避截止时间,判断退避是否结束。
    if strategy == queueAfterBackoff && p.backoffQ.isPodBackingoff(pInfo) {
        // 先检查 PreEnqueue,再按失败记录选择普通或错误退避队列。
        if added := p.moveToBackoffQ(logger, pInfo, event); added {
            return backoffQ
        }
        // 入队检查未通过,Pod 已回到 unschedulablePods。
        return unschedulableQ
    }

    // 跳过退避或退避已经结束:通过 PreEnqueue 后进入 activeQ。
    if added := p.moveToActiveQ(logger, pInfo, event, false); added {
        return activeQ
    }
    return unschedulableQ
}
Scheduler Cache
Cache 是 Kubernetes Scheduler 保存在内存中的本地集群状态。它把已经分配和暂时假定分配的 Pod 汇总到各个 Node 的 NodeInfo 中;每轮调度开始时,Scheduler 再从 Cache 增量刷新 Snapshot,节点筛选、评分和相关插件读取这份本轮视图。
相关代码位置如下:
pkg/scheduler/backend/cache/
├── interface.go                    # Cache 接口
├── cache.go                        # cacheImpl、内部索引和 UpdateSnapshot
├── node_tree.go                    # 按 Zone 组织 Node,并交错生成顺序,使优先检查的节点来自不同 Zone
└── snapshot.go                     # 本轮调度读取的 Snapshot

pkg/scheduler/framework/types.go    # NodeInfo 的具体实现
pkg/scheduler/eventhandlers.go      # 将已分配 Pod 和 Node 的变化写入 Cache
pkg/scheduler/schedule_one.go       # 刷新 Snapshot,记录和撤销 Assumed Pod
pkg/scheduler/framework/runtime/
└── framework.go                    # 保存 Snapshot 的 SharedLister,运行扩展点插件

staging/src/k8s.io/kube-scheduler/framework/
├── listers.go                      # 定义 SharedLister 与 NodeInfoLister 查询接口
└── interface.go                    # 在 Handle 中暴露 SnapshotSharedLister()
下图展示 Scheduler Cache 的三条主要数据路径:更新 Cache、增量刷新 Snapshot,以及在调度周期内读取 Snapshot。
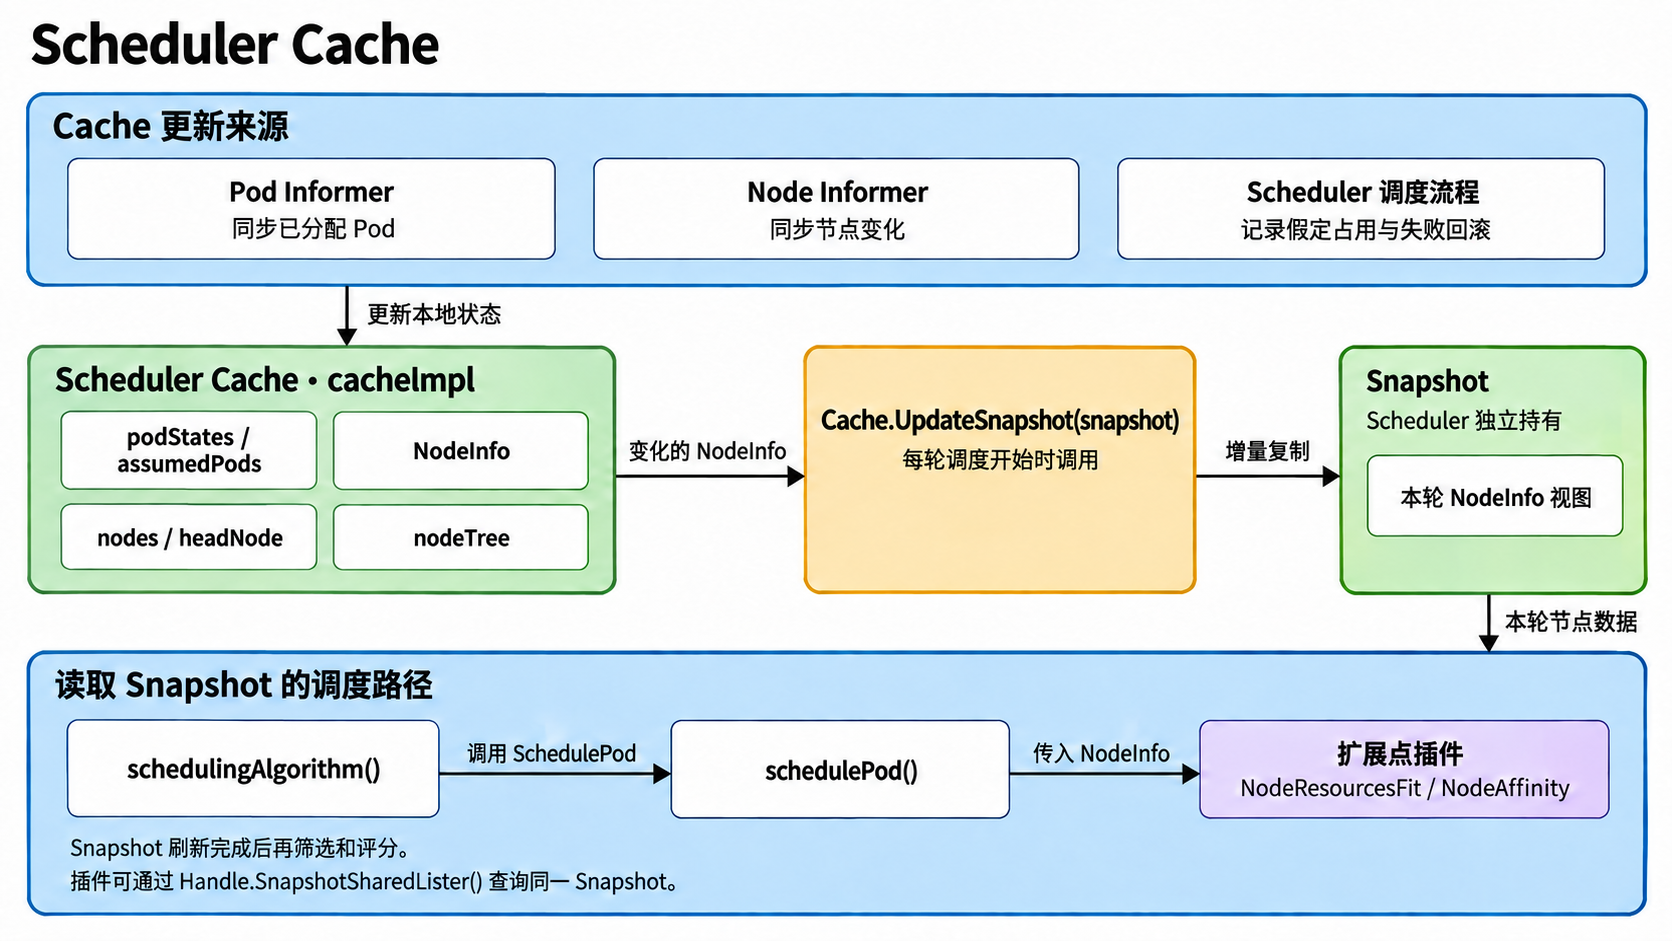
-
更新 Cache:普通 Pod 调度中,Cache 主要通过以下来源更新:
- Pod Informer:同步已分配 Pod 的新增、更新和删除,维护各节点的 Pod 及资源占用。
- Node Informer:同步节点的新增、更新和删除,维护资源容量、标签、污点等调度信息。
- Scheduler 临时记录:选定节点后,通过
Cache.AssumePod()将 Pod 记入 Cache 并标记为 Assumed,提前计入节点资源占用;后续失败时由Cache.ForgetPod()撤销,绑定结果由 Pod Informer 确认。
-
增量刷新 Snapshot:每轮调度开始时,
Cache.UpdateSnapshot()将 Cache 中变化的NodeInfo和相关索引同步到 Snapshot,为本轮过滤和评分提供稳定的节点视图。Cache 在此期间继续接收更新,新的变化在下一轮刷新时同步。 - 调度期间读取 Snapshot:
UpdateSnapshot()完成后,schedulingCycle()调用schedulingAlgorithm(),为当前 Pod 选择目标 Node。schedulingAlgorithm()通过schedulePod()从 Snapshot 读取本轮NodeInfo,完成节点筛选与评分并返回选中的 Node。调度期间的插件也可以通过Handle.SnapshotSharedLister()查询同一份 Snapshot。
Cache 数据结构
Scheduler 和事件处理函数通过 Cache 接口同步 Pod、Node 状态,记录或撤销临时占用,并刷新 Snapshot。相关的主要方法如下:
type Cache interface {
    // Scheduler 选定节点后,记录本地资源占用;后续失败时撤销。
    AssumePod(logger klog.Logger, pod *v1.Pod) error
    ForgetPod(logger klog.Logger, pod *v1.Pod) error

    // 将 Informer 观察到的已分配 Pod 的新增、更新和删除同步到 Cache。
    AddPod(logger klog.Logger, pod *v1.Pod) error
    UpdatePod(logger klog.Logger, oldPod, newPod *v1.Pod) error
    RemovePod(logger klog.Logger, pod *v1.Pod) error

    // 查询 Pod 缓存和 Assumed 状态。
    GetPod(pod *v1.Pod) (*v1.Pod, error)
    IsAssumedPod(pod *v1.Pod) (bool, error)

    // 同步节点的新增、更新和删除。
    AddNode(logger klog.Logger, node *v1.Node) *framework.NodeInfo
    UpdateNode(logger klog.Logger, oldNode, newNode *v1.Node) *framework.NodeInfo
    RemoveNode(logger klog.Logger, node *v1.Node) error

    // 从 Cache 增量刷新本轮调度使用的节点快照。
    UpdateSnapshot(logger klog.Logger, nodeSnapshot *Snapshot) error
    ...
}
cacheImpl 是 Cache 接口的具体实现,主要通过以下结构维护 Pod 和节点状态:
- Pod 索引:
podStates是一个 Map,以 Pod UID 为键,保存对应的podState记录。 - Node 索引:
nodes是一个 Map,按节点名称查找对应的链表项及其中的NodeInfo。 - 节点更新链表:
headNode指向链表头,最近更新的NodeInfo排在前面,便于UpdateSnapshot()查找需要同步的节点。
对应的主要字段如下:
// Cache 中单个 Pod 的记录,保存 Pod 对象的指针。
type podState struct {
    pod *v1.Pod
}

// 每个链表项保存一个 NodeInfo,最近更新的节点移到链表头。
type nodeInfoListItem struct {
    info *framework.NodeInfo
    next *nodeInfoListItem // 指向更早更新的节点。
    prev *nodeInfoListItem // 指向更近更新的节点。
}

type cacheImpl struct {
    mu sync.RWMutex

    // Pod UID → Pod 状态;assumedPods 是其中 Assumed Pod 的 UID 集合。
    podStates   map[string]*podState
    assumedPods sets.Set[string]

    // Node 名称索引,以及按更新顺序排列的链表入口。
    nodes    map[string]*nodeInfoListItem
    headNode *nodeInfoListItem

    // 按 Zone 保存 Node 名称;需要重建 Snapshot 节点列表时,交错生成跨 Zone 的遍历顺序。
    nodeTree *nodeTree

    // 汇总镜像所在的 Node,供各 NodeInfo 建立 ImageStates。
    imageStates map[string]*fwk.ImageStateSummary
    // ...
}
Pod 缓存状态
Cache 中的 Pod 分为**本地假定分配(Assumed)和已确认分配(Added)**两种状态,下图展示它们的流转方式。
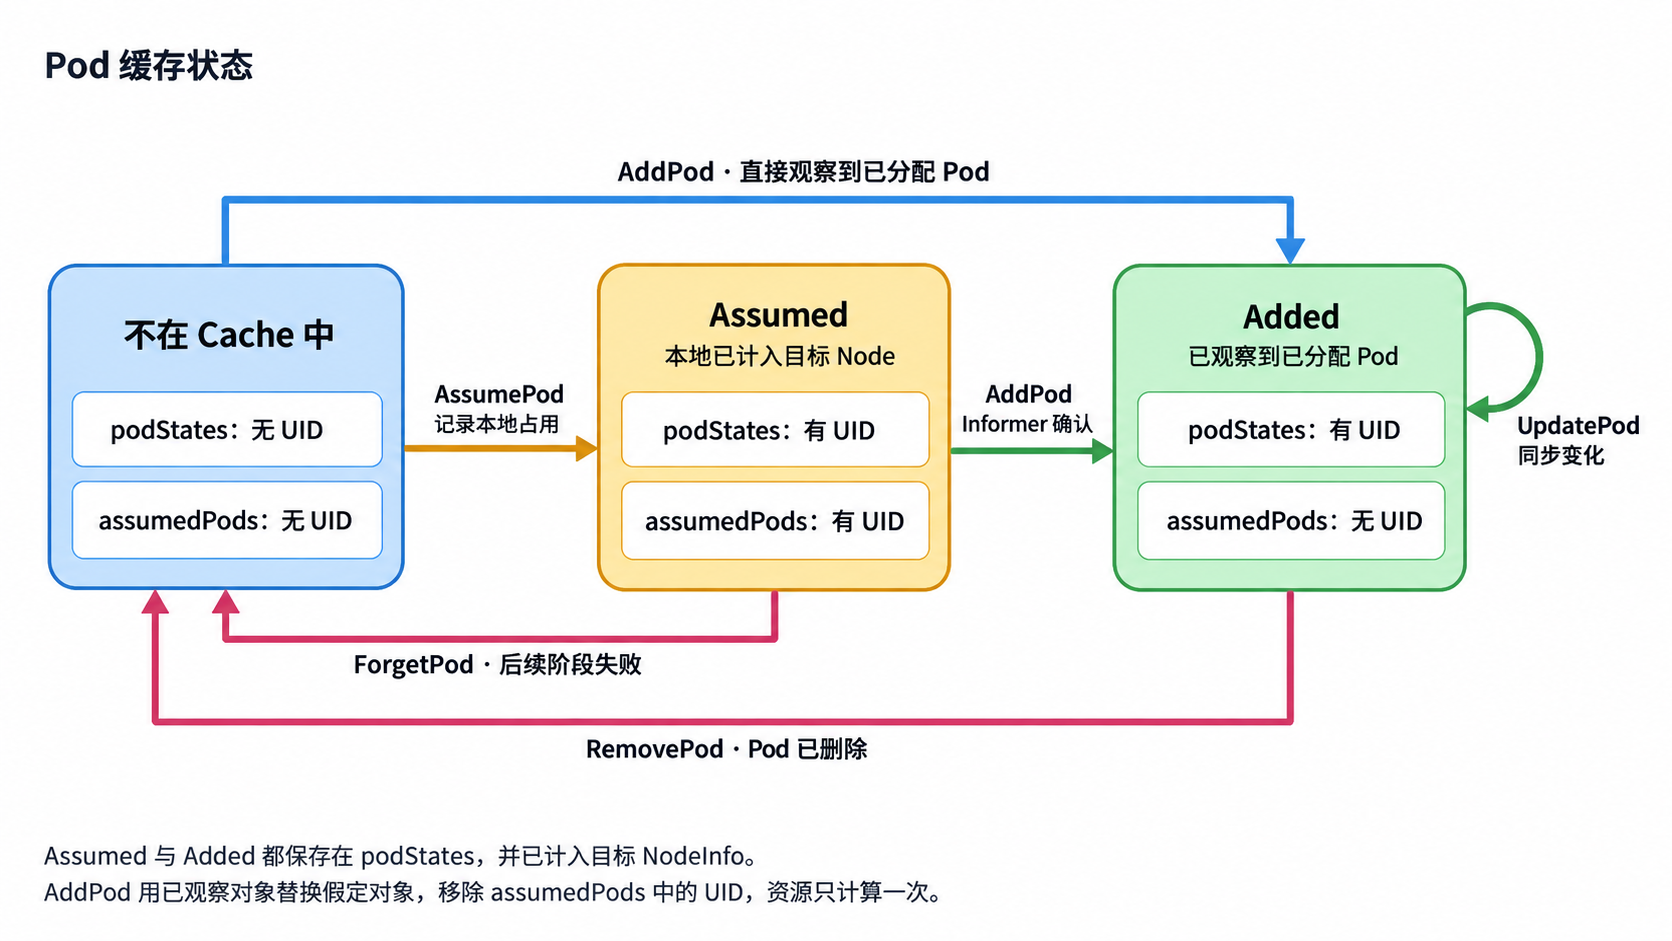
本地假定分配(Assumed)
Scheduler 已为 Pod 选定目标节点,并在本地记录资源占用,但尚未通过 Pod Informer 确认分配结果。
- 进入本地假定分配状态(Assumed):
AssumePod()将 Pod 写入podStates,把 UID 加入assumedPods,并将其占用计入目标NodeInfo。 - 确认分配:Informer 观察到节点分配结果后,
AddPod()用观察到的对象更新缓存,移除assumedPods中的 UID,转为 Added。 - 撤销分配假定:后续阶段失败时,
ForgetPod()删除临时记录,并撤销目标节点上的假定占用。
已确认分配(Added)
Pod Informer 已观察到 API Server 中的 Pod 指定了节点,Cache 使用这个已确认的对象维护节点占用。
- 直接进入已确认分配状态(Added):对于已经分配节点、尚未进入 Cache 的 Pod,
AddPod()直接加入缓存。 - 更新缓存:Pod 变化时,
UpdatePod()用新对象替换旧对象,并更新NodeInfo中的汇总信息。 - 移出缓存:Pod 删除时,
RemovePod()扣除节点上的占用,并删除缓存记录。
podStates 统一保存 Pod 的缓存记录,assumedPods 只用 UID 标记其中尚未确认分配结果的 Pod,供后续确认或撤销。确认分配后,更新 Pod 记录并移除标记;后续阶段失败时,撤销对应的临时记录。
例如,Scheduler 为 Pod train-worker-0(UID 为 pod-123)选中 node-a。确认分配前后,Pod 缓存记录和临时标记的变化如下:
AssumePod() 后(Scheduler 本地副本):
podStates
└─ pod-123 → podState{pod: Pod{name: train-worker-0, spec.nodeName: node-a}}
assumedPods
└─ pod-123

Pod Informer 调用 Cache.AddPod() 后(观察到的 API Server 对象):
podStates
└─ pod-123 → podState{pod: Pod{name: train-worker-0, spec.nodeName: node-a}}
assumedPods
└─ (空)
Node 状态与索引
NodeInfo 汇总单个节点的调度状态,包括 Node 对象、已分配和 Assumed 的 Pod,以及资源、端口、PVC 使用情况等信息。Snapshot 复制这些状态,供本轮过滤和评分读取。
节点状态汇总
NodeInfo 同时接收节点自身和节点上 Pod 的变化:
- Node 变化:Node Informer 的事件处理函数调用 Cache 的节点方法,更新 Node 对象及其可分配资源。
- Pod 变化:Pod Informer 同步已分配 Pod,Scheduler 通过 Assume 和 Forget 记录或撤销临时占用。这些操作更新节点上的 Pod 列表,以及资源请求、端口和 PVC 使用计数等汇总值。
例如,一个请求 2 CPU 的 Pod 被加入节点后,Pods 中增加该 Pod,Requested 中的 CPU 请求也相应增加。主要字段如下:
type NodeInfo struct {
    // Node 对象包含节点标签、污点等信息。
    node *v1.Node

    // 节点上的已分配和 Assumed Pod,以及亲和性检查使用的 Pod 子集。
    Pods                         []fwk.PodInfo
    PodsWithAffinity             []fwk.PodInfo
    PodsWithRequiredAntiAffinity []fwk.PodInfo

    // Pod 请求的资源总量,以及 Node.Status.Allocatable 中的资源量。
    Requested   *Resource
    Allocatable *Resource

    // 节点上已占用的主机端口,以及各 PVC 的 Pod 引用计数。
    UsedPorts    fwk.HostPortInfo
    PVCRefCounts map[string]int

    // 节点上的镜像信息;Generation 标记 NodeInfo 最近一次变化。
    ImageStates map[string]*fwk.ImageStateSummary
    Generation  int64
    // ...
}
下图展示 nodes、节点更新链表和 nodeTree 如何组织节点信息,以及它们与 Snapshot 的关系。
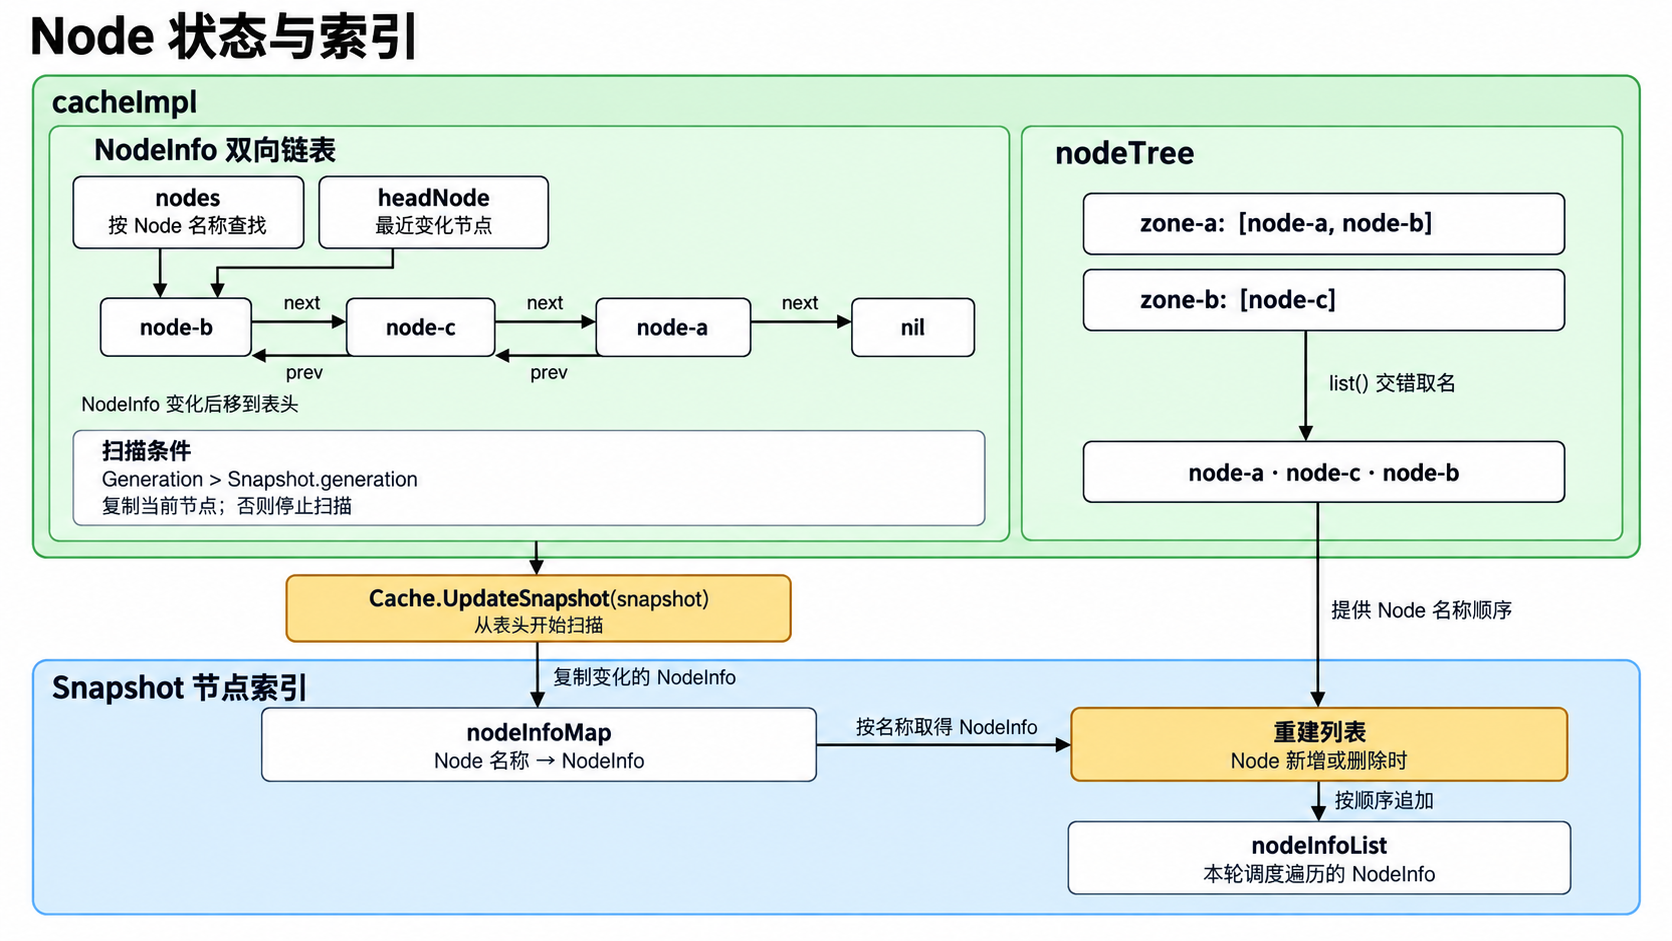
名称索引与更新链表
nodeInfoListItem 把 NodeInfo 组织成双向链表,nodes 和 headNode 分别用于查找节点和追踪更新:
- 按名称查找:
nodes["node-b"]找到node-b的链表项,再通过info访问它的NodeInfo。 - 按更新顺序扫描:节点状态变化后,
moveNodeInfoToHead()将对应链表项移到headNode。沿next访问更早更新的节点,沿prev返回更近更新的节点。UpdateSnapshot()利用这个顺序和Generation,只扫描上次同步后变化的节点。
节点遍历顺序
nodeTree 按 Zone 保存节点名称,为 Snapshot 生成节点的基础遍历顺序。节点新增、删除或 Zone 归属变化时,Cache 同步更新它:
type nodeTree struct {
    // 由 Region 和 Zone 组成的键 → 该 Zone 中的节点名称列表。
    tree map[string][]string
    // Zone 的遍历顺序。
    zones []string
    // 节点总数。
    numNodes int
}
nodeTree.list() 依次取各 Zone 的第一个节点,再取各 Zone 的第二个节点。例如,Zone A 包含 node-a1、node-a2,Zone B 包含 node-b1、node-b2,得到的顺序就是 node-a1 → node-b1 → node-a2 → node-b2。
Snapshot.nodeInfoMap 按节点名称保存所有有效节点的 NodeInfo,nodeTree.list() 提供跨 Zone 交错排列的节点名称。Cache 按这个名称顺序,从 Snapshot.nodeInfoMap 中取出对应的 NodeInfo 引用,组成 nodeInfoList,供后续调度遍历。
节点筛选找到足够数量的可行节点后便可能提前停止。跨 Zone 交错排列使优先检查的节点更分散,减少候选节点集中在同一 Zone 的情况。
Snapshot 增量更新与读取
Snapshot 保存调度周期读取的 NodeInfo 及其索引。Scheduler 通过自身的 nodeInfoSnapshot *internalcache.Snapshot 字段保存这个快照对象的指针。
每轮调度将 sched.nodeInfoSnapshot 传给 Cache.UpdateSnapshot(),将变化节点更新到已有快照,未变化的节点继续保留。因此,Snapshot 保存的是本轮所有有效节点的视图。主要字段如下:
type Snapshot struct {
    // 保存所有有效节点的 NodeInfo,供按名称查找。
    nodeInfoMap map[string]*framework.NodeInfo
    // 引用 Map 中同一批 NodeInfo,按 nodeTree 给出的顺序遍历。
    nodeInfoList []fwk.NodeInfo

    // 亲和性和 PVC 查询使用的辅助索引。
    havePodsWithAffinityNodeInfoList             []fwk.NodeInfo
    havePodsWithRequiredAntiAffinityNodeInfoList []fwk.NodeInfo
    usedPVCSet                                   sets.Set[string]

    // 上次已同步到的最新 NodeInfo.Generation。
    generation int64
    // ...
}
下图展示 UpdateSnapshot() 如何根据 generation 扫描变化节点、更新 Snapshot 内部索引,以及调度算法如何读取刷新后的 NodeInfo:
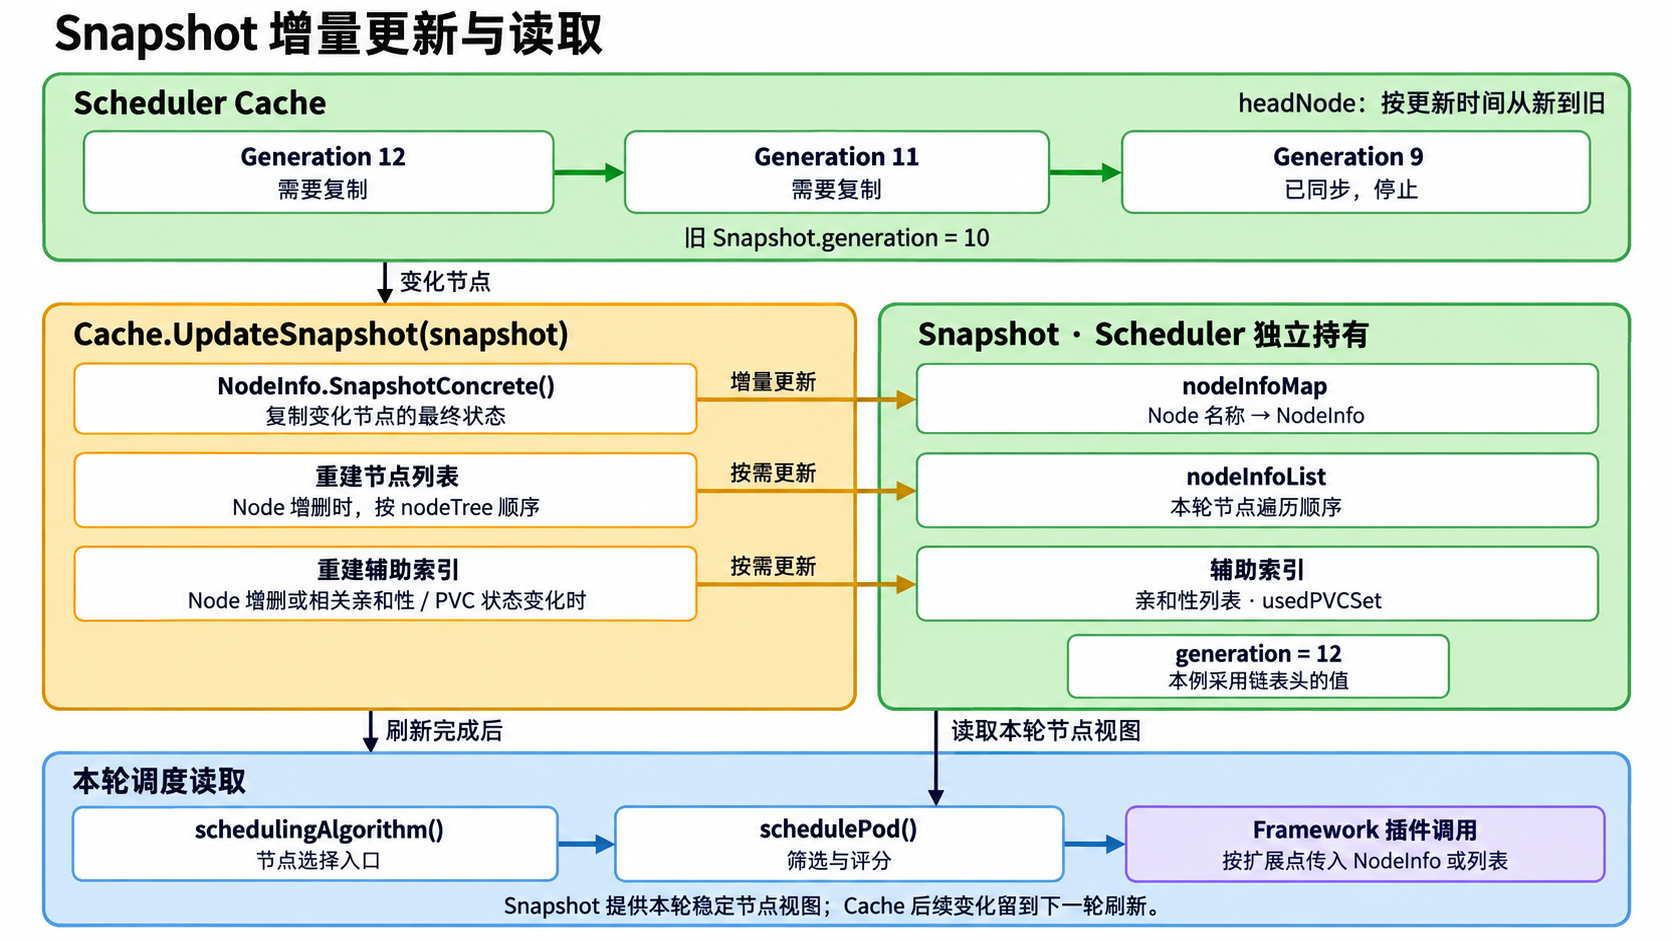
每轮调度开始时,schedulingCycle() 先调用 Cache.UpdateSnapshot() 更新本轮节点视图,再根据这份视图为当前 Pod 选择目标节点。
Scheduler Cache:识别变化节点
图中的 12、11、10 是各节点的 NodeInfo.Generation,表示最近一次状态变化对应的更新序号。旧快照的 Snapshot.generation = 10,表示上次已同步到序号 10:
Generation = 12和11:都大于10,这些节点在上次同步后发生过变化,需要复制到 Snapshot。Generation = 10:等于旧快照的同步基准,该节点在上次同步后没有变化,继续使用 Snapshot 中已有的数据。扫描到这里就停止,后面更旧的节点也无需复制。
更新 Snapshot
UpdateSnapshot() 按扫描结果更新 Snapshot:
- 更新
nodeInfoMap:Map 保留所有有效节点的 NodeInfo。本轮通过SnapshotConcrete()复制变化节点的最终状态,更新对应条目;未变化的条目继续保留。图中更新12、11对应的节点,保留10对应的节点。 - 维护
nodeInfoList:节点增删、需要重建列表时,通过updateNodeInfoSnapshotList()按nodeTree.list()的跨 Zone 名称顺序,从 Map 中取得同一批 NodeInfo 引用。列表沿用时,直接读取这些对象更新后的内容。 - 维护辅助索引:节点增删,或相关亲和性、PVC 使用情况变化时,按需重建亲和性相关的节点列表和
usedPVCSet。
func (cache *cacheImpl) UpdateSnapshot(
    logger klog.Logger,
    nodeSnapshot *Snapshot,
) error {
    cache.mu.Lock()
    defer cache.mu.Unlock()
    ...

    // 读取旧快照的同步基准,图中为 10,用它比较各节点当前的 Generation。
    snapshotGeneration := nodeSnapshot.generation
    updateAllLists := false
    updateNodesHavePodsWithAffinity := false
    updateNodesHavePodsWithRequiredAntiAffinity := false
    updateUsedPVCSet := false
    ...

    // nodeInfoMap 沿用已有的完整节点索引,未变化的条目继续保留。
    // 从链表头开始扫描,图中各节点当前的 Generation 依次为 12 → 11 → 10。
    for node := cache.headNode; node != nil; node = node.next {
        if node.info.Generation <= snapshotGeneration {
            // 图中 10 等于旧基准 10,保留 Map 中已有的 NodeInfo,停止向后扫描。
            break
        }
        if np := node.info.Node(); np != nil {
            existing, ok := nodeSnapshot.nodeInfoMap[np.Name]
            if !ok {
                // Snapshot 中尚无该节点,后续需要重建节点列表。
                updateAllLists = true
                existing = &framework.NodeInfo{}
                nodeSnapshot.nodeInfoMap[np.Name] = existing
            }

            // 图中 12、11 都大于旧基准 10,需要复制这些节点的当前状态。
            clone := node.info.SnapshotConcrete()
            // 检查亲和性相关节点集合和 PVC 使用集合是否变化,更新相应标记。
            ...
            // 更新已有对象的内容,Map 和 List 继续引用同一个 NodeInfo。
            *existing = *clone
        }
    }

    // 以链表头的 Generation 作为下轮同步基准。
    // 图中变化的是 Snapshot.generation:10 → 12。
    if cache.headNode != nil {
        nodeSnapshot.generation = cache.headNode.info.Generation
    }

    // 已删除的节点不再出现在 nodeTree 中,从 Snapshot 移除后重建列表。
    if len(nodeSnapshot.nodeInfoMap) > cache.nodeTree.numNodes {
        cache.removeDeletedNodesFromSnapshot(nodeSnapshot)
        updateAllLists = true
    }

    // 节点增删时传入 true,重建 nodeInfoList 和辅助索引。
    // 仅辅助索引对应的集合变化时传入 false,沿用 nodeInfoList。
    // 这些标记都为 false 时,不调用此方法,沿用已有列表和辅助索引。
    if updateAllLists || updateNodesHavePodsWithAffinity ||
        updateNodesHavePodsWithRequiredAntiAffinity || updateUsedPVCSet {
        cache.updateNodeInfoSnapshotList(logger, nodeSnapshot, updateAllLists)
    }
    ...
    return nil
}
UpdateSnapshot() 先更新 Snapshot.nodeInfoMap:加入新增节点,更新变化节点的内容,移除已删除节点,未变化的节点继续保留。随后,根据本轮变化决定是否调用 updateNodeInfoSnapshotList():
- 节点新增或删除(
updateAll = true):调用该方法,按nodeTree.list()返回的跨 Zone 名称顺序,从Snapshot.nodeInfoMap取出 NodeInfo 引用,重建nodeInfoList,同时重建亲和性相关的节点列表和 PVC 使用集合。 - 辅助索引对应的集合变化(
updateAll = false):节点没有增删,但 Pod 亲和性相关的节点集合或各节点使用的 PVC 集合发生变化。此时调用该方法,沿用已有的nodeInfoList,重建辅助索引。 - 仅 NodeInfo 内容变化(不调用):资源请求等数据发生变化,但节点集合和辅助索引依赖的集合均未变化。此时只更新
Snapshot.nodeInfoMap中的 NodeInfo 内容,原有节点列表和辅助索引继续使用。
func (cache *cacheImpl) updateNodeInfoSnapshotList(
    logger klog.Logger,
    snapshot *Snapshot,
    updateAll bool,
) {
    // 初始化需要重建的亲和性节点列表和 PVC 使用集合。
    ...
    if updateAll {
        snapshot.nodeInfoList = make([]fwk.NodeInfo, 0, cache.nodeTree.numNodes)
        // 取得跨 Zone 交错排列的节点名称。
        nodesList, err := cache.nodeTree.list()
        if err != nil {
            utilruntime.HandleErrorWithLogger(
                logger, err,
                "Error occurred while retrieving the list of names of the nodes from node tree",
            )
        }
        for _, nodeName := range nodesList {
            if nodeInfo := snapshot.nodeInfoMap[nodeName]; nodeInfo != nil {
                // 按名称顺序引用 Map 中已有的 NodeInfo,不再复制节点数据。
                snapshot.nodeInfoList = append(snapshot.nodeInfoList, nodeInfo)
                // 同时收集亲和性节点和 PVC 使用情况,重建辅助索引。
                ...
            } else {
                ...
            }
        }
    } else {
        // 保留原有节点列表,遍历同一批 NodeInfo 重建辅助索引。
        for _, nodeInfo := range snapshot.nodeInfoList {
            ...
        }
    }
}
本轮调度读取
刷新完成后,schedulingAlgorithm() 通过 schedulePod() 为当前 Pod 选择目标节点。实际读取 Snapshot 的代码位于 schedulePod() 调用的 findNodesThatFitPod() 中:它先取得节点列表,再交给后续筛选流程。
func (sched *Scheduler) findNodesThatFitPod(
    ctx context.Context,
    schedFramework framework.Framework,
    state fwk.CycleState,
    podInfo *framework.QueuedPodInfo,
) ([]fwk.NodeInfo, framework.Diagnosis, string, error) {
    ...
    diagnosis := framework.Diagnosis{
        NodeToStatus: framework.NewDefaultNodeToStatus(),
    }
    // 从本轮已刷新的 Snapshot 中取得节点列表。
    allNodes, err := sched.nodeInfoSnapshot.ListNodesInPlacement()
    if err != nil {
        return nil, diagnosis, "", err
    }

    pod := podInfo.Pod
    preRes, s, unscheduledPlugins := schedFramework.RunPreFilterPlugins(ctx, state, pod)
    ...

    // 默认使用 Snapshot 的全部节点;PreFilter 也可以限定候选节点。
    nodes := allNodes
    if !preRes.AllNodes() {
        ...
    }
    // 将候选节点的 NodeInfo 交给 Filter 检查。
    feasibleNodes, err := sched.findNodesThatPassFilters(
        ctx, schedFramework, state, pod, &diagnosis, nodes,
    )
    ...
}
普通 Pod 调度未设置额外的节点范围时,ListNodesInPlacement() 通过 List() 返回 Snapshot 中已经构建好的 nodeInfoList:
func (s *Snapshot) ListNodesInPlacement() ([]fwk.NodeInfo, error) {
    if s.placementNodes == nil {
        // 未限定节点范围,返回完整节点列表。
        return s.List()
    }
    // 已限定节点范围时,返回该范围内的节点列表。
    return s.placementNodes.nodeInfoList, nil
}

func (s *Snapshot) List() ([]fwk.NodeInfo, error) {
    return s.nodeInfoList, nil
}
调度阶段(Scheduling cycle)
ScheduleOne 每次从队列取出一个 Pod。普通 Pod 进入 scheduleOnePod(),同步执行 schedulingCycle();该阶段刷新 Snapshot、选择目标 Node,并完成 Assume、Reserve 和 Permit。调度阶段成功后,scheduleOnePod() 再启动异步绑定。
相关代码位置如下:
pkg/scheduler/
├── schedule_one.go                 # ScheduleOne、节点选择算法与绑定前准备
├── backend/
│   ├── queue/scheduling_queue.go    # Pop:取得下一次调度要处理的 Pod
│   └── cache/cache.go               # UpdateSnapshot 刷新视图,AssumePod 记录占用
└── framework/runtime/framework.go  # 执行筛选、评分、Reserve 和 Permit 插件
下图展示普通 Pod 从出队到启动绑定的路径,包含节点快照刷新、节点筛选与评分、绑定前准备和失败处理。
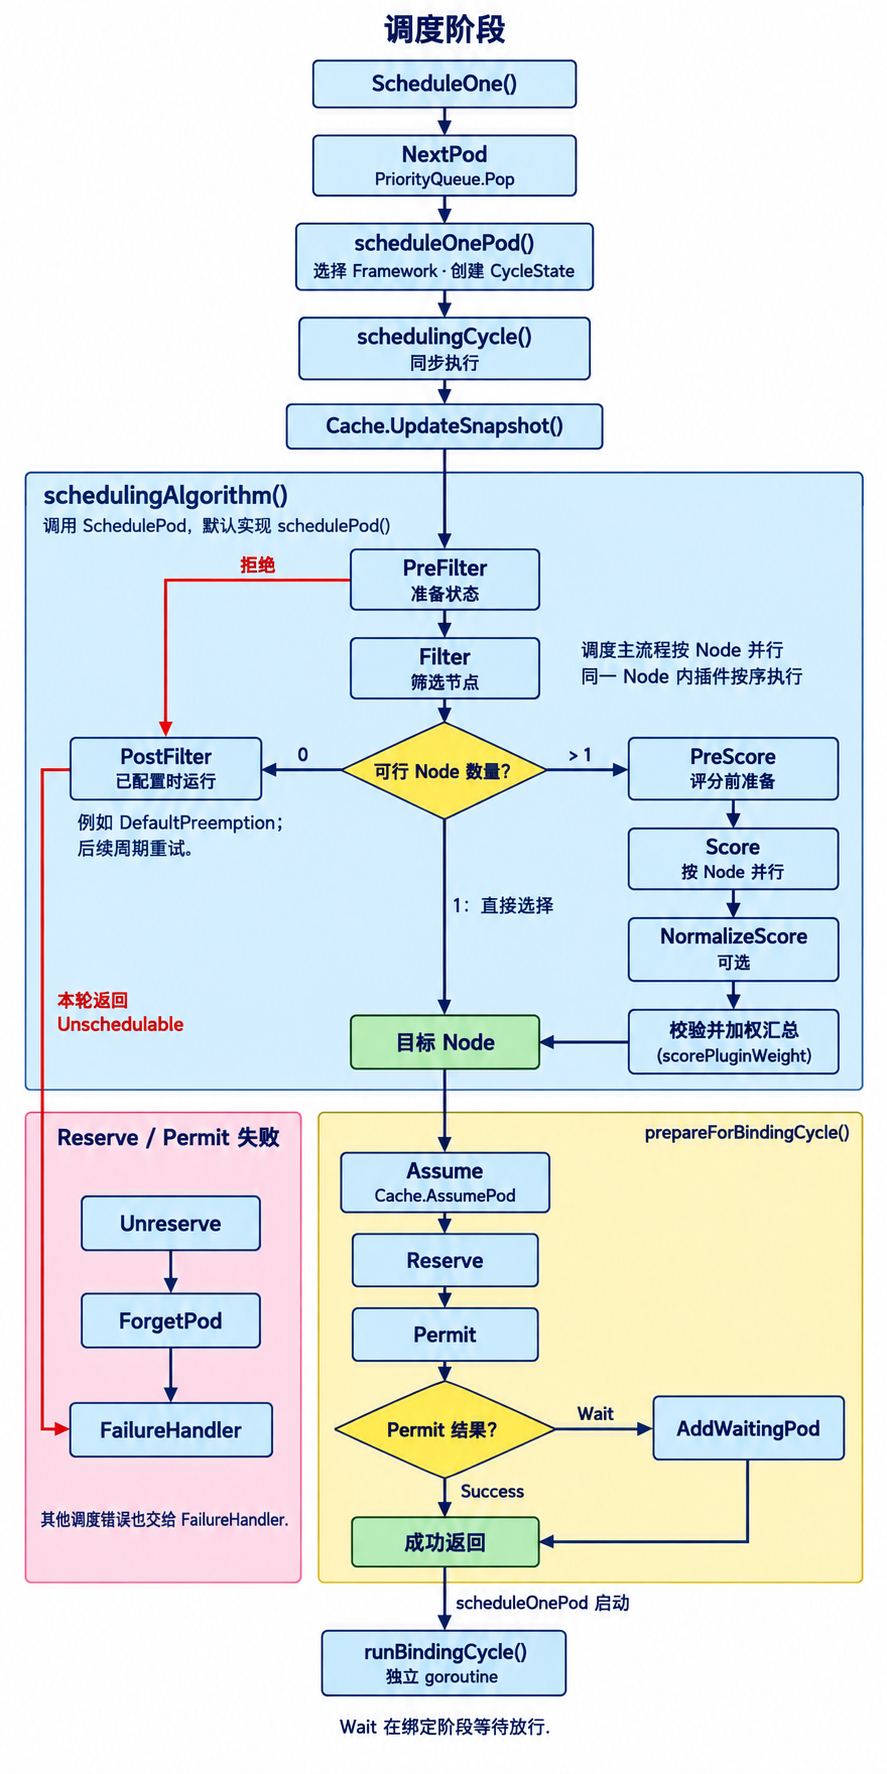
- 取出待调度 Pod:
ScheduleOne()调用NextPod,后者默认通过PriorityQueue.Pop取得下一个QueuedPodInfo,开始一次 Pod 调度尝试。 - 建立本轮调度上下文:
scheduleOnePod()根据schedulerName选择 Framework,并创建当前 Pod 独享的CycleState,随后同步调用schedulingCycle()。 - 执行调度周期:
schedulingCycle()先调用Cache.UpdateSnapshot()刷新本轮节点视图,再依次运行节点选择算法和绑定前准备。任一步骤失败都会把状态返回给scheduleOnePod(),由它调用FailureHandler。 - 选择目标 Node:
schedulingAlgorithm()调用SchedulePod,其默认实现schedulePod()运行 PreFilter 和 Filter;存在多个可行 Node 时,再运行 PreScore 和 Score 选出目标 Node。无法选出 Node 或发生错误时,本轮调度结束。 - 准备绑定状态:
prepareForBindingCycle()先通过 Assume 将 Pod 的资源占用写入 Scheduler Cache,再运行 Reserve 和 Permit。Reserve 或 Permit 失败时调用 Unreserve,并通过ForgetPod()撤销本地假定;Permit 返回Wait时,Scheduler 先记录 WaitingPod。 - 启动异步绑定:Permit 返回
Success或Wait后,schedulingCycle()都会成功返回,scheduleOnePod()随即启动runBindingCycle()goroutine。Wait状态会在该 goroutine 内继续等待 Permit 插件放行。
ScheduleOne
ScheduleOne 是一次调度的入口。它通过 NextPod 从 SchedulingQueue 取出队首 Pod;NextPod 默认调用 PriorityQueue.Pop,队列为空时会等待。
func (sched *Scheduler) ScheduleOne(ctx context.Context) {
    // NextPod 默认从 SchedulingQueue 取出队首 Pod。
    // 队列为空时等待;队列关闭时可能返回 nil。
    podInfo, err := sched.NextPod(klog.FromContext(ctx))
    if err != nil || podInfo == nil || podInfo.Pod == nil {
        return
    }

    // 启用 GenericWorkload 且 Pod 指定 SchedulingGroup 时,
    // 先取得组信息,再进入 PodGroup 调度流程。
    if sched.genericWorkloadEnabled && podInfo.Pod.Spec.SchedulingGroup != nil {
        podGroupInfo, err := sched.podGroupInfoForPod(ctx, podInfo)
        if err != nil {
            ...
            return
        }
        sched.scheduleOnePodGroup(ctx, podGroupInfo)
    } else {
        // 其余 Pod 使用单 Pod 调度流程。
        sched.scheduleOnePod(ctx, podInfo)
    }
}
scheduleOnePod
scheduleOnePod 负责组织一个普通 Pod 的完整调度尝试。它根据 spec.schedulerName 取得对应的 Framework,创建本次调度使用的 CycleState,然后同步执行调度阶段。调度失败时交给 FailureHandler;成功时,Pod 已在 Cache 中完成 Assume,因此绑定阶段可以在独立 goroutine 中运行。
schedulingCycle() 返回的 scheduleResult 类型为 ScheduleResult,其中 SuggestedHost 保存选中的节点名称。
func (sched *Scheduler) scheduleOnePod(
    ctx context.Context,
    podInfo *framework.QueuedPodInfo,
) {
    pod := podInfo.Pod
    ...
    fwk, err := sched.frameworkForPod(pod)
    if err != nil {
        sched.SchedulingQueue.Done(pod.UID)
        return
    }
    if sched.skipPodSchedule(ctx, fwk, pod) {
        sched.SchedulingQueue.Done(pod.UID)
        return
    }

    // 保存本次调度中各扩展点插件共享的临时状态;
    // 调度阶段和后续绑定阶段使用同一个 CycleState。
    state := framework.NewCycleState()
    ...

    // 调度阶段同步执行,完成 Snapshot 刷新、节点选择、
    // Assume、Reserve 和 Permit。
    schedulingCycleCtx, cancel := context.WithCancel(ctx)
    defer cancel()

    // 分别返回节点选择结果、Pod 信息和执行状态。
    // 成功时,Pod 副本已设置目标节点并完成 Assume。
    scheduleResult, assumedPodInfo, status := sched.schedulingCycle(
        schedulingCycleCtx, state, fwk, podInfo, start, podsToActivate,
    )
    if !status.IsSuccess() {
        // 记录失败原因,并决定 Pod 后续进入哪个重试队列。
        sched.FailureHandler(
            schedulingCycleCtx, fwk, assumedPodInfo,
            status, scheduleResult.nominatingInfo, start,
        )
        return
    }

    // Pod 已通过 Assume 计入 Scheduler Cache。
    // 绑定可以异步执行,主调度循环继续处理下一个 Pod。
    go sched.runBindingCycle(
        ctx, state, fwk, scheduleResult, assumedPodInfo, start, podsToActivate,
    )
}
schedulingCycle
schedulingCycle 是同步调度阶段。它先刷新 Snapshot,再从这份固定视图中选择目标 Node;选中后调用 prepareForBindingCycle,把 Pod 临时计入目标 Node,并运行 Reserve 和 Permit 插件。
func (sched *Scheduler) schedulingCycle(...) (
    ScheduleResult, *framework.QueuedPodInfo, *fwk.Status,
) {
    // 把 Cache 中发生变化的 NodeInfo 增量更新到 Snapshot。
    // 本轮 Filter 和 Score 都读取刷新后的同一份节点视图。
    if err := sched.Cache.UpdateSnapshot(
        klog.FromContext(ctx), sched.nodeInfoSnapshot,
    ); err != nil {
        return ScheduleResult{nominatingInfo: clearNominatedNode},
            podInfo, fwk.AsStatus(err)
    }

    // 运行节点筛选和评分,返回选中的目标 Node。
    result, status := sched.schedulingAlgorithm(
        ctx, state, schedFramework, podInfo, start,
    )
    if !status.IsSuccess() {
        return result, podInfo, status
    }

    // 在真正绑定前应用调度结果:设置目标 Node、执行
    // Cache.AssumePod(),再运行 Reserve 和 Permit。
    assumedPodInfo, status := sched.prepareForBindingCycle(
        ctx, state, schedFramework, podInfo, podsToActivate, result,
    )
    if !status.IsSuccess() {
        return ScheduleResult{nominatingInfo: clearNominatedNode},
            assumedPodInfo, status
    }

    // 返回已完成 Assume 的 Pod,交给异步绑定阶段继续处理。
    return result, assumedPodInfo, nil
}
schedulingAlgorithm
schedulingAlgorithm 调用 SchedulePod 执行节点选择。SchedulePod 是 Scheduler 的函数类型字段,默认指向 schedulePod(),由它完成节点筛选与评分。没有可行节点时,schedulingAlgorithm() 再运行 PostFilter,尝试改善后续调度条件;即使找到候选方案,本轮也不会进入绑定阶段。
func (sched *Scheduler) schedulingAlgorithm(
    ctx context.Context,
    state fwk.CycleState,
    schedFramework framework.Framework,
    podInfo *framework.QueuedPodInfo,
    start time.Time,
) (ScheduleResult, *fwk.Status) {
    ...
    // 从本轮 Snapshot 中筛选可行 Node,并通过评分选出目标 Node。
    result, err := sched.SchedulePod(
        ctx, schedFramework, state, podInfo,
    )
    if err == nil {
        return result, nil
    }
    ...

    // FitError 包含各 Node 未通过 Filter 的原因。
    fitError, ok := err.(*framework.FitError)
    if !ok {
        ...
    }
    if !schedFramework.HasPostFilterPlugins() {
        ...
    }

    // PostFilter 根据 Filter 的失败结果尝试改善后续调度条件,
    // 例如 DefaultPreemption 可以选择一个抢占候选 Node。
    postFilterResult, status := schedFramework.RunPostFilterPlugins(
        ctx, state, podInfo.Pod, fitError.Diagnosis.NodeToStatus,
    )
    ...
    // 保存 PostFilter 的提名结果,供后续调度使用;本轮返回 Unschedulable。
    return ScheduleResult{...},
        fwk.NewStatus(fwk.Unschedulable).WithError(err)
}
schedulePod
schedulePod() 接收当前 Framework、CycleState 和 Pod 信息,返回节点选择结果。节点选择分为两个步骤:
- 筛选节点:
findNodesThatFitPod()读取 Snapshot,运行 PreFilter 和 Filter,得到可行节点。 - 评分选点:存在多个可行节点时,
prioritizeNodes()运行 PreScore 和 Score,再根据评分结果选择目标节点;只有一个可行节点时直接选中。
func (sched *Scheduler) schedulePod(
    ctx context.Context,
    fwk framework.Framework,
    state fwk.CycleState,
    podInfo *framework.QueuedPodInfo,
) (result ScheduleResult, err error) {
    pod := podInfo.Pod
    ...
    if sched.nodeInfoSnapshot.NumNodesInPlacement() == 0 {
        return result, ErrNoNodesAvailable
    }

    // 先运行 PreFilter 和 Filter,得到满足条件的节点。
    feasibleNodes, diagnosis, nodeHint, err := sched.findNodesThatFitPod(
        ctx, fwk, state, podInfo,
    )
    if err != nil {
        return result, err
    }
    ...
    if len(feasibleNodes) == 0 {
        // 返回过滤诊断,由 schedulingAlgorithm 决定是否运行 PostFilter。
        return result, &framework.FitError{
            Pod:         pod,
            NumAllNodes: sched.nodeInfoSnapshot.NumNodesInPlacement(),
            Diagnosis:   diagnosis,
        }
    }

    if len(feasibleNodes) == 1 {
        // 只有一个可行节点,直接选中,跳过评分。
        node := feasibleNodes[0].Node().Name
        ...
        return ScheduleResult{
            SuggestedHost:  node,
            EvaluatedNodes: 1 + diagnosis.NodeToStatus.Len(),
            FeasibleNodes:  1,
        }, nil
    }

    // 多个可行节点时,再运行 PreScore 和 Score。
    priorityList, err := prioritizeNodes(
        ctx, sched.Extenders, fwk, state, pod, feasibleNodes,
    )
    if err != nil {
        return result, err
    }

    // 根据节点总分选出目标节点。
    sortedPrioritizedNodes := newSortedNodeScores(priorityList)
    node := sortedPrioritizedNodes.Pop()
    ...
    return ScheduleResult{
        SuggestedHost:  node,
        EvaluatedNodes: len(feasibleNodes) + diagnosis.NodeToStatus.Len(),
        FeasibleNodes:  len(feasibleNodes),
    }, err
}
Filter 与 Score 的节点并行
Filter 与 Score 的节点并行入口不同:Filter 由 findNodesThatPassFilters() 发起,Score 由 RunScorePlugins() 发起。
Filter:Node 并行由 findNodesThatPassFilters 发起
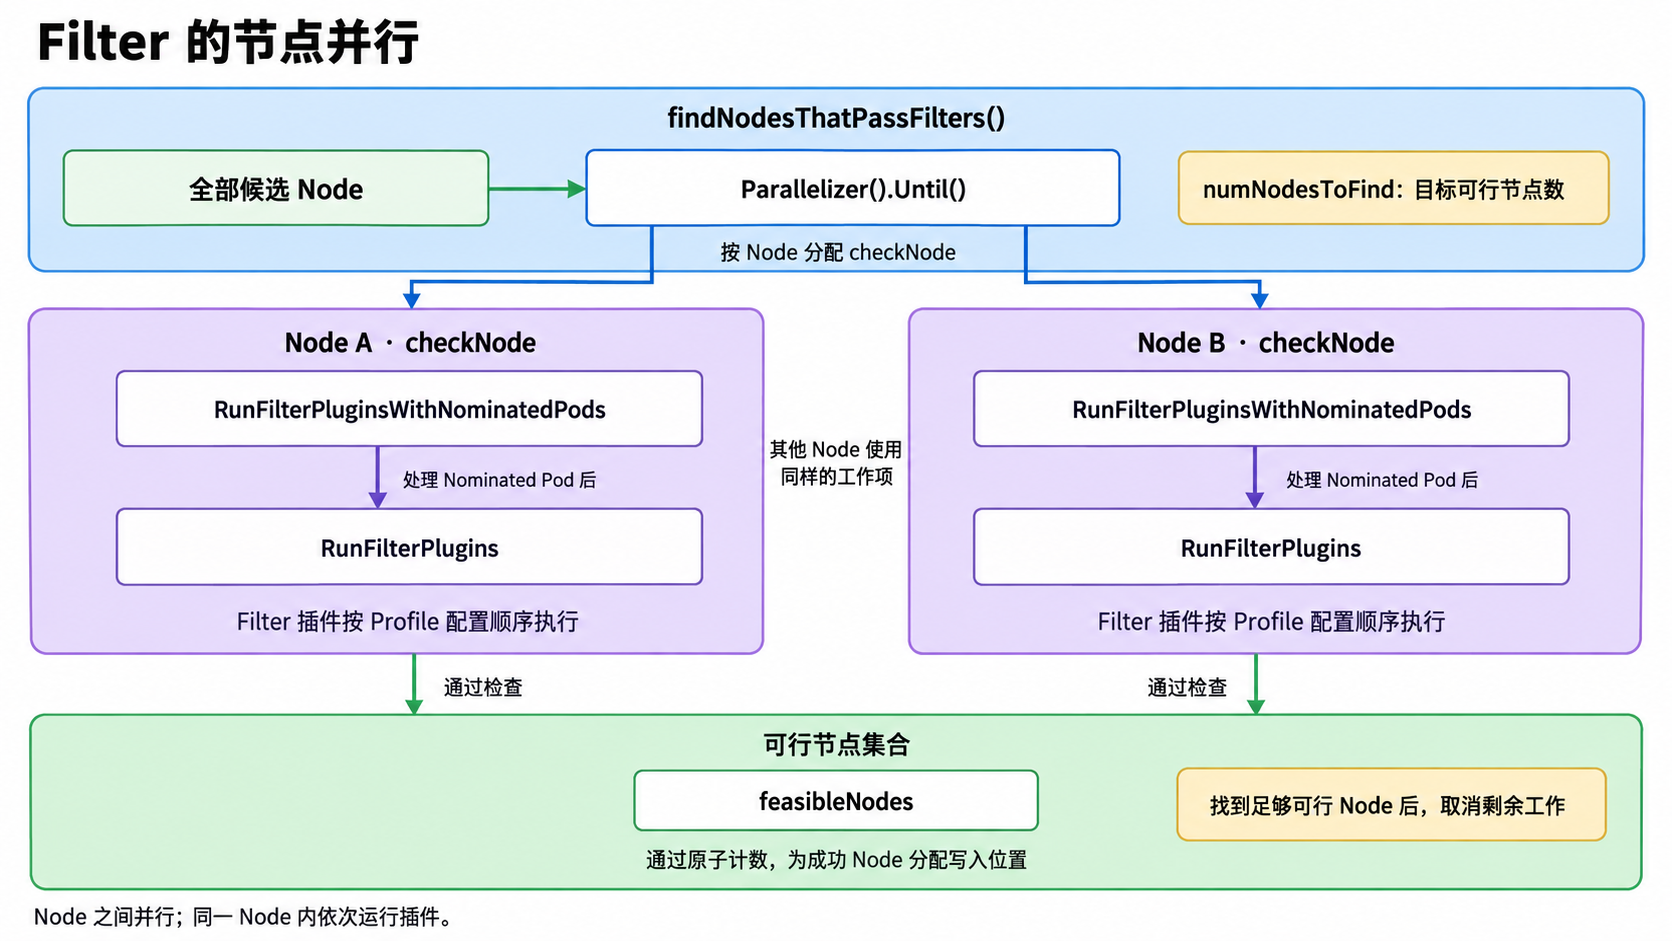
Score:Node 并行由 RunScorePlugins 发起
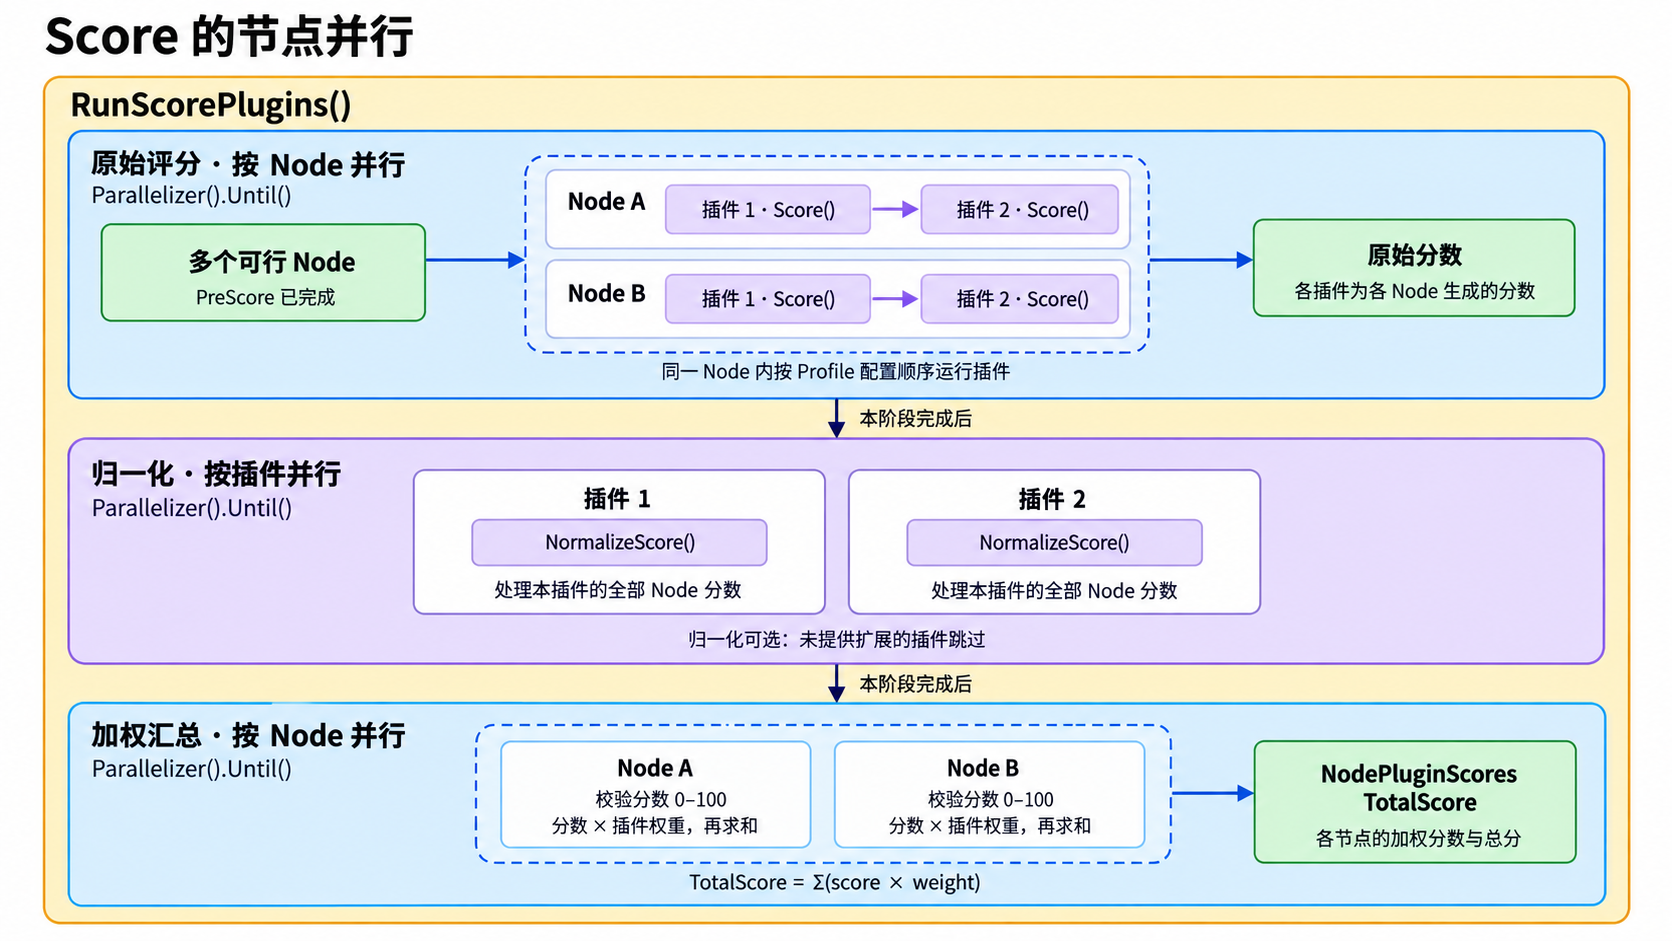
Filter 并行源码
findNodesThatPassFilters 先计算本轮需要找到多少台可行 Node,再把“检查一台 Node”封装成 checkNode。Parallelizer 并行执行这些工作项;每台检查通过的 Node 通过原子计数取得结果数组中的位置,找到足够数量后取消剩余工作:
func (sched *Scheduler) findNodesThatPassFilters(
    ctx context.Context,
    schedFramework framework.Framework,
    state fwk.CycleState,
    pod *v1.Pod,
    diagnosis *framework.Diagnosis,
    nodes []fwk.NodeInfo,
) ([]fwk.NodeInfo, error) {
    numAllNodes := len(nodes)
    numNodesToFind := sched.numFeasibleNodesToFind(
        schedFramework.PercentageOfNodesToScore(),
        int32(numAllNodes),
    )
    feasibleNodes := make([]fwk.NodeInfo, numNodesToFind)
    ...

    errCh := parallelize.NewResultChannel[error]()
    var feasibleNodesLen int32
    ctx, cancel := context.WithCancelCause(ctx)
    defer cancel(errors.New("findNodesThatPassFilters has completed"))
    type nodeStatus struct {
        node   string
        status *fwk.Status
    }
    result := make([]*nodeStatus, numAllNodes)

    // checkNode 只负责检查一台 Node。
    checkNode := func(i int) {
        // 从上一轮停止的位置继续,避免每轮总从相同 Node 开始。
        nodeInfo := nodes[(sched.nextStartNodeIndex+i)%numAllNodes]

        // 该方法处理 Nominated Pod 后,调用 RunFilterPlugins 检查当前 Node。
        status := schedFramework.RunFilterPluginsWithNominatedPods(
            ctx, state, pod, nodeInfo,
        )
        if status.Code() == fwk.Error {
            errCh.SendWithCancel(status.AsError(), func() {
                cancel(errors.New("some other Filter operation failed"))
            })
            return
        }

        if status.IsSuccess() {
            // 多个工作项并行写入结果,使用原子计数分配唯一位置。
            length := atomic.AddInt32(&feasibleNodesLen, 1)
            if length > numNodesToFind {
                // 已找到足够的可行 Node,停止尚未完成的检查。
                cancel(errors.New("findNodesThatPassFilters has found enough nodes"))
                atomic.AddInt32(&feasibleNodesLen, -1)
            } else {
                feasibleNodes[length-1] = nodeInfo
            }
        } else {
            // 每个工作项只写入自己的下标,不需要额外加锁。
            result[i] = &nodeStatus{
                node:   nodeInfo.Node().Name,
                status: status,
            }
        }
    }

    // 将全部候选 Node 索引作为工作项交给 Parallelizer。
    schedFramework.Parallelizer().Until(
        ctx, numAllNodes, checkNode, metrics.Filter,
    )
    feasibleNodes = feasibleNodes[:feasibleNodesLen]
    ...

    return feasibleNodes, nil
}
Score 并行源码
RunScorePlugins() 接收多台可行 Node,并执行三轮并行处理:先按 Node 计算各插件的原始分数,再按插件运行可选的 NormalizeScore,最后按 Node 应用插件权重并汇总总分。第一轮中,不同 Node 可以并行处理,但同一台 Node 上的 Score 插件仍按 Profile 中的配置顺序运行。
func (f *frameworkImpl) RunScorePlugins(
    ctx context.Context,
    state fwk.CycleState,
    pod *v1.Pod,
    nodes []fwk.NodeInfo,
) (ns []fwk.NodePluginScores, status *fwk.Status) {
    ...

    // len(nodes) 个索引是可以并行执行的工作项。
    f.Parallelizer().Until(ctx, len(nodes), func(index int) {
        nodeInfo := nodes[index]
        nodeName := nodeInfo.Node().Name

        // 同一台 Node 内,各 Score 插件仍按 Profile 配置顺序运行。
        for _, pl := range plugins {
            score, status := f.runScorePlugin(
                ctx, pl, state, pod, nodeInfo,
            )
            if !status.IsSuccess() {
                errCh.SendWithCancel(
                    fmt.Errorf("plugin %q failed with: %w", pl.Name(), status.AsError()),
                    cancel,
                )
                return
            }

            // 保存当前插件为当前 Node 生成的原始分数。
            pluginToNodeScores[pl.Name()][index] = fwk.NodeScore{
                Name:  nodeName,
                Score: score,
            }
        }
    }, metrics.Score)
    ...

    // 每个 Score 插件独立归一化自己为所有 Node 生成的分数。
    f.Parallelizer().Until(ctx, len(plugins), func(index int) {
        pl := plugins[index]
        if pl.ScoreExtensions() == nil {
            return
        }

        nodeScoreList := pluginToNodeScores[pl.Name()]
        // runScoreExtension 调用 pl.ScoreExtensions().NormalizeScore(...),
        // 对当前插件为所有候选 Node 生成的分数进行归一化。
        status := f.runScoreExtension(ctx, pl, state, pod, nodeScoreList)
        if !status.IsSuccess() {
            errCh.SendWithCancel(
                fmt.Errorf("plugin %q failed with: %w", pl.Name(), status.AsError()),
                cancel,
            )
        }
    }, metrics.Score)
    ...

    // 再次并行处理各台 Node,校验分数、应用权重并计算总分。
    f.Parallelizer().Until(ctx, len(nodes), func(index int) {
        nodePluginScores := fwk.NodePluginScores{
            Name:   nodes[index].Node().Name,
            Scores: make([]fwk.PluginScore, len(plugins)),
        }

        for i, pl := range plugins {
            // scorePluginWeight 只用于 Score 扩展点;
            // 同一插件实现的 Filter、Reserve 等扩展点不参与加权。
            weight := f.scorePluginWeight[pl.Name()]
            score := pluginToNodeScores[pl.Name()][index].Score

            // 插件最终提供的分数必须位于 0–100。
            if score > fwk.MaxNodeScore || score < fwk.MinNodeScore {
                errCh.SendWithCancel(
                    fmt.Errorf("plugin %q returns an invalid score %v", pl.Name(), score),
                    cancel,
                )
                return
            }

            weightedScore := score * int64(weight)
            nodePluginScores.Scores[i] = fwk.PluginScore{
                Name:  pl.Name(),
                Score: weightedScore,
            }
            nodePluginScores.TotalScore += weightedScore
        }
        allNodePluginScores[index] = nodePluginScores
    }, metrics.Score)
    ...

    return allNodePluginScores, nil
}
prepareForBindingCycle
prepareForBindingCycle 在选定节点后,为异步绑定依次完成以下准备:
- 记录占用(Assume):通过
Cache.AssumePod()提前记录目标节点上的资源占用,后续调度无需等待实际绑定完成。 - 预留插件状态(Reserve):运行 Reserve 插件,保存后续绑定需要的临时状态。
- 检查许可(Permit):返回
Success或Wait时,均可进入异步绑定阶段。Wait会登记WaitingPod,由绑定阶段的WaitOnPermit()等待放行。
前两步由 assumeAndReserve() 完成。Reserve 或 Permit 失败时,执行 Unreserve 和 ForgetPod(),撤销插件状态与 Cache 中的临时占用。
func (sched *Scheduler) prepareForBindingCycle(...) (
    *framework.QueuedPodInfo, *fwk.Status,
) {
    // 先创建 Assumed Pod:在副本中写入目标 Node 并计入 Cache,
    // 再让 Reserve 插件保存绑定阶段需要的可回滚状态。
    assumedPodInfo, status := sched.assumeAndReserve(
        ctx, state, schedFramework, podInfo, scheduleResult,
    )
    if !status.IsSuccess() {
        // Assume 或 Reserve 未完成,停止当前调度周期。
        // Reserve 失败时,assumeAndReserve 已执行 Unreserve 和 ForgetPod。
        return assumedPodInfo, status
    }

    // Permit 插件在进入异步绑定阶段前决定立即放行、等待或拒绝。
    pluginsWaitTime, runPermitStatus := schedFramework.RunPermitPlugins(
        ctx, state, assumedPodInfo.Pod, scheduleResult.SuggestedHost,
    )
    if runPermitStatus.IsWait() {
        // Wait 表示至少一个 Permit 插件需要异步决定。
        // WaitingPod 保存等待该 Pod 的插件及超时时间;绑定阶段随后
        // 通过 WaitOnPermit 等待全部插件放行,或在拒绝、超时后失败。
        schedFramework.AddWaitingPod(assumedPodInfo.Pod, pluginsWaitTime)
    } else if !runPermitStatus.IsSuccess() {
        // Permit 直接拒绝或返回错误,绑定阶段不会启动。
        // 先清理 Reserve 插件状态,再从 Cache 撤销 Assumed Pod。
        _ = sched.unreserveAndForget(
            ctx, state, schedFramework,
            assumedPodInfo, scheduleResult.SuggestedHost,
        )
        if runPermitStatus.IsRejected() {
            // 将所选 Node 上的拒绝结果包装为 FitError,
            // 供 FailureHandler 记录失败原因并处理重新入队。
            fitErr := &framework.FitError{...}
            ...
            return assumedPodInfo,
                fwk.NewStatus(runPermitStatus.Code()).WithError(fitErr)
        }
        return assumedPodInfo, runPermitStatus
    }

    ...
    // Success 可以直接进入绑定;Wait 已登记 WaitingPod,绑定阶段会等待。
    // 两种情况都将 Assumed Pod 副本交给异步绑定阶段。
    return assumedPodInfo, nil
}
绑定阶段(Binding cycle)
绑定阶段由独立 goroutine 执行。多个已经完成调度阶段的 Pod 可以并发运行 PreBind、Bind 和 PostBind;Scheduler 的主循环同时继续为后续 Pod 选择 Node。
相关代码位置如下:
pkg/scheduler/
├── schedule_one.go                 # runBindingCycle、bindingCycle 与 bind
├── backend/queue/active_queue.go    # 结束本轮 Pod 跟踪,清理不再需要的事件
└── framework/
    ├── runtime/framework.go        # 等待 Permit,运行绑定阶段的扩展点插件
    └── plugins/defaultbinder/default_binder.go # DefaultBinder 提交 pods/binding 请求
下图展示一个 Pod 的绑定流程。
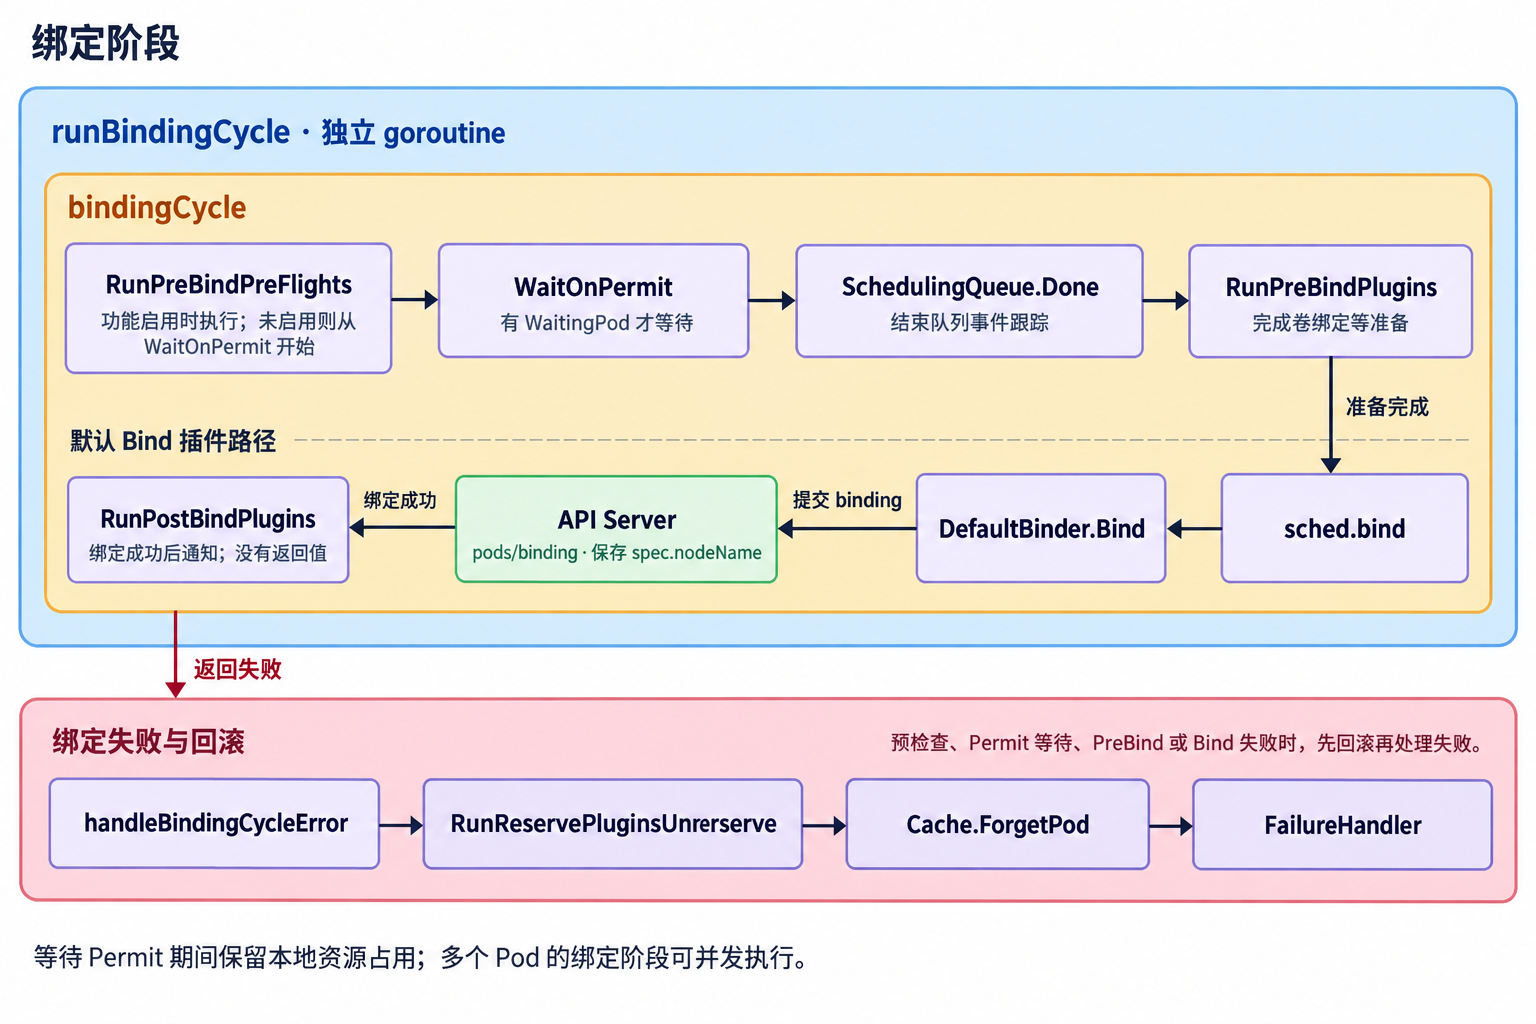
- 异步执行:
scheduleOnePod()启动独立 goroutine,由runBindingCycle()调用bindingCycle()执行绑定。 - 绑定前预检:
PreBindPreFlight()确定哪些 PreBind 插件可以跳过、哪些相邻插件可以并行执行。 - 等待 Permit 放行:Permit 返回
Wait后,WaitOnPermit()等待相关插件全部放行;拒绝或超时则回滚。没有 WaitingPod 记录时直接继续。 - 绑定前准备:PreBind 完成卷绑定等准备工作。
- 提交绑定:
sched.bind()调用 Bind 插件,默认由DefaultBinder请求 API Server 的pods/binding,将目标节点写入spec.nodeName。 - 绑定后处理:PostBind 清理临时状态或记录绑定结果,没有返回值。
- 失败回滚:预检、Permit 等待、PreBind 或 Bind 失败时,
handleBindingCycleError()执行 Unreserve 和Cache.ForgetPod(),再由 FailureHandler 处理重试。
runBindingCycle
runBindingCycle() 调用 bindingCycle() 执行绑定流程。PreBindPreFlight、WaitOnPermit、PreBind 或 Bind 返回失败时,它会调用 handleBindingCycleError(),撤销 Reserve 状态和 Cache 中的 Assumed Pod,再把 Pod 交给 FailureHandler:
func (sched *Scheduler) runBindingCycle(...) {
    bindingCycleCtx, cancel := context.WithCancel(ctx)
    defer cancel()

    ...
    status := sched.bindingCycle(
        bindingCycleCtx, state, schedFramework,
        scheduleResult, assumedPodInfo, start, podsToActivate,
    )
    if !status.IsSuccess() {
        sched.handleBindingCycleError(
            bindingCycleCtx, state, schedFramework,
            assumedPodInfo, start, scheduleResult, status,
        )
        return
    }
}
bindingCycle
默认情况下,NominatedNodeNameForExpectation 特性开关已启用,bindingCycle() 会先运行 PreBindPreFlight,确定哪些 PreBind 插件需要执行、哪些相邻插件可以并行执行;再处理可能存在的 Permit 等待,最后执行 PreBind、Bind 和 PostBind。
func (sched *Scheduler) bindingCycle(
    ctx context.Context,
    state fwk.CycleState,
    schedFramework framework.Framework,
    scheduleResult ScheduleResult,
    assumedPodInfo *framework.QueuedPodInfo,
    start time.Time,
    podsToActivate *framework.PodsToActivate,
) *fwk.Status {
    assumedPod := assumedPodInfo.Pod

    var preFlightStatus *fwk.Status
    // NominatedNodeNameForExpectation 特性开关启用时,先收集预检结果。
    if sched.nominatedNodeNameForExpectationEnabled {
        // 收集当前 Pod 的 PreBind 执行计划。
        preFlightStatus = schedFramework.RunPreBindPreFlights(
            ctx, state, assumedPod, scheduleResult.SuggestedHost,
        )
        if preFlightStatus.Code() == fwk.Error || preFlightStatus.IsRejected() {
            return preFlightStatus
        }
        ...
    }

    // 等待 Permit 放行;没有等待记录时直接通过。
    if status := schedFramework.WaitOnPermit(ctx, assumedPod); !status.IsSuccess() {
        ...
        return status
    }
    ...

    // VolumeBinding 等插件在这里完成 API Binding 前的准备。
    if status := schedFramework.RunPreBindPlugins(
        ctx, state, assumedPod, scheduleResult.SuggestedHost,
    ); !status.IsSuccess() {
        return status
    }

    ...

    // 执行 Bind,将 Pod 绑定到选定节点。
    if status := sched.bind(
        ctx, schedFramework, assumedPod,
        scheduleResult.SuggestedHost, state,
    ); !status.IsSuccess() {
        return status
    }

    // 绑定成功后运行 PostBind。
    schedFramework.RunPostBindPlugins(
        ctx, state, assumedPod, scheduleResult.SuggestedHost,
    )
    return nil
}
RunPreBindPlugins 根据 PreBindPreFlight 保存的结果组织执行:允许并行的插件可以并发运行,需要串行的插件仍按配置顺序执行。
API Binding
bind 先检查是否有 Extender Binder 接管当前 Pod;否则调用 Framework 中的 Bind 插件。默认的 DefaultBinder 向 API Server 提交 pods/binding 子资源,API Server 将目标 Node 保存到 Pod 的 spec.nodeName。
func (b DefaultBinder) Bind(
    ctx context.Context,
    state fwk.CycleState,
    pod *v1.Pod,
    nodeName string,
) *fwk.Status {
    binding := &v1.Binding{
        ObjectMeta: metav1.ObjectMeta{
            Namespace: pod.Namespace,
            Name:      pod.Name,
            UID:       pod.UID,
        },
        Target: v1.ObjectReference{Kind: "Node", Name: nodeName},
    }

    // 启用异步 API Cacher 时,通过它提交并等待写入完成。
    if b.handle.APICacher() != nil {
        onFinish, err := b.handle.APICacher().BindPod(binding)
        if err != nil {
            return fwk.AsStatus(err)
        }
        err = b.handle.APICacher().WaitOnFinish(ctx, onFinish)
        if err != nil {
            return fwk.AsStatus(err)
        }
        return nil
    }

    // 直接请求 API Server 的 pods/binding 子资源。
    err := b.handle.ClientSet().CoreV1().Pods(binding.Namespace).
        Bind(ctx, binding, metav1.CreateOptions{})
    if err != nil {
        return fwk.AsStatus(err)
    }
    return nil
}
失败处理
调度或绑定失败后,Scheduler 会按需撤销本轮预留,避免残留占用影响后续调度。随后将仍需调度的 Pod 交回 SchedulingQueue,等待后续重试,并记录本次失败原因。
相关代码位置如下:
pkg/scheduler/
├── schedule_one.go                 # 调度与绑定失败入口、回滚及诊断更新
├── framework/runtime/framework.go  # 逆序运行 Reserve 插件的 Unreserve 回调
└── backend/
    ├── cache/cache.go              # ForgetPod:撤销 Assumed Pod 的本地占用
    └── queue/scheduling_queue.go    # AddUnschedulableIfNotPresent:安排重新入队
下图展示三类失败如何汇入统一处理,以及 FailureHandler 的入队检查、SchedulingQueue 的重试安排和失败状态记录之间的关系。
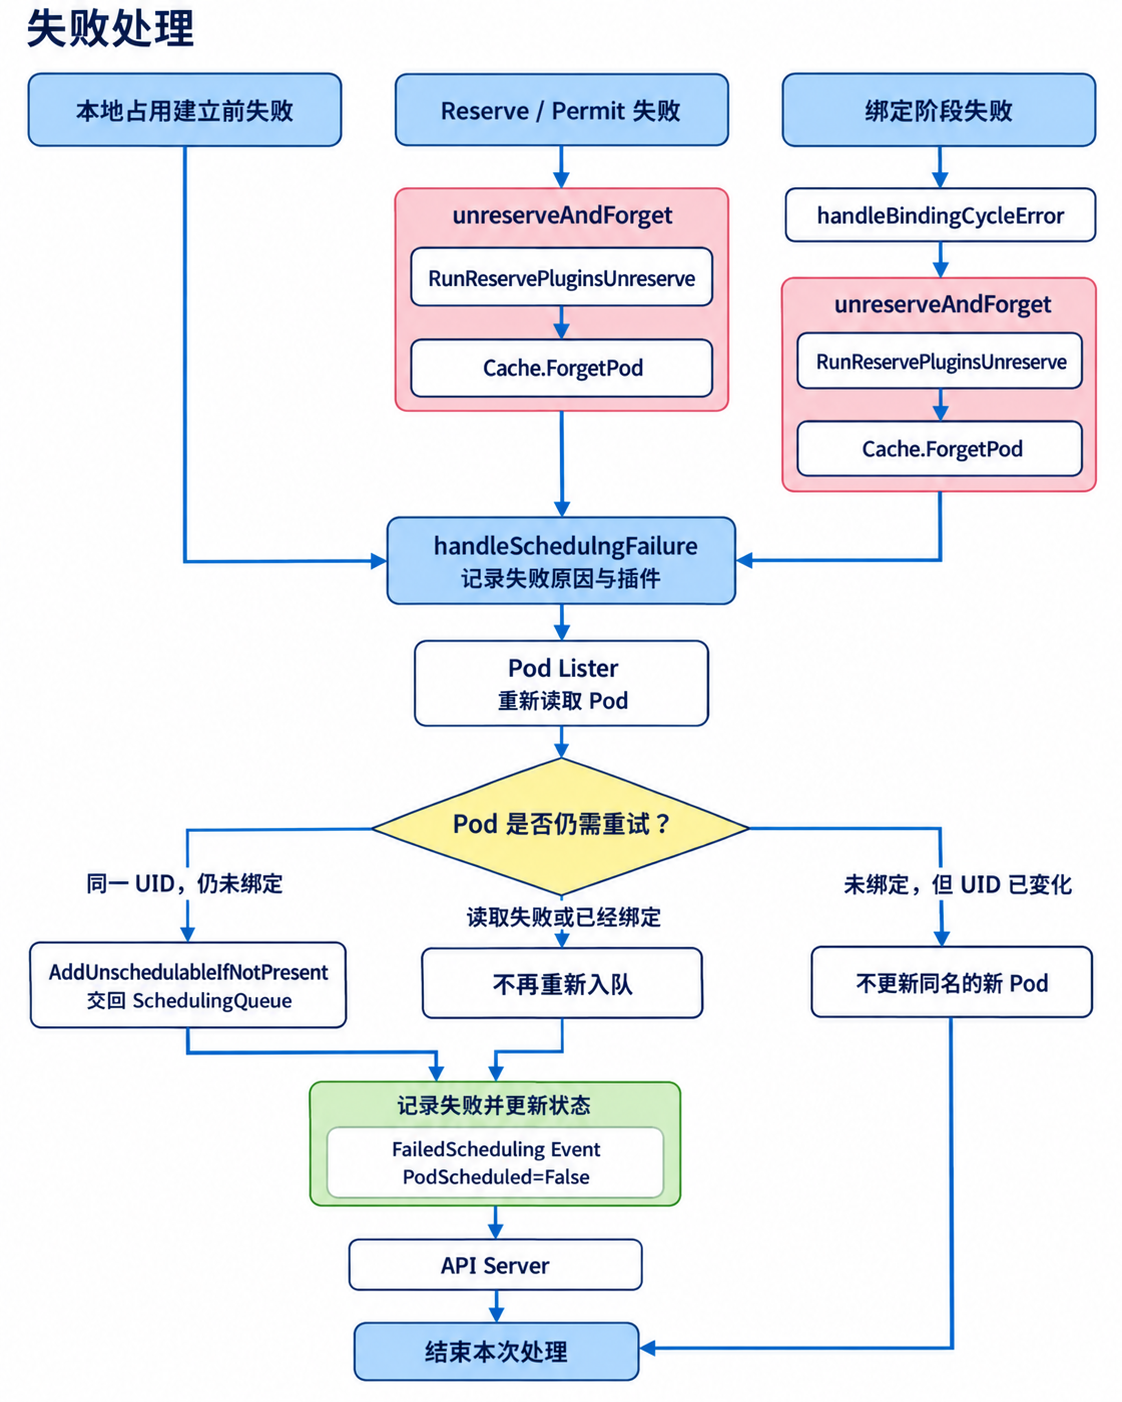
失败分类
失败发生在不同阶段,对应不同的处理方式:
- 本地占用建立前失败:节点选择或 Assume 失败,本轮没有需要撤销的占用,直接进入 FailureHandler。
- Reserve / Permit 同步失败:仍在主调度流程中,尚未启动异步绑定。清理本轮预留后,失败状态返回
scheduleOnePod(),由它调用 FailureHandler;完成失败处理后,主循环才继续为下一个 Pod 选择节点。 - 绑定阶段失败:绑定已在独立 goroutine 中运行,主循环可能已经继续处理后续 Pod。绑定 goroutine 通过
handleBindingCycleError()组织回滚,再调用 FailureHandler;回滚成功后,还会安排通知 SchedulingQueue 重新评估其他受这份临时占用影响的 Pod。
回滚统一由 unreserveAndForget() 完成:先运行 Unreserve,清理插件预留;再调用 Cache.ForgetPod(),从 Cache 撤销 Assumed Pod 及其资源占用。完成必要的清理后,三条路径汇入统一失败处理。
FailureHandler:统一失败处理
FailureHandler 的默认实现 handleSchedulingFailure() 先保存本轮错误消息和失败插件名,再通过 Pod Lister 重新读取 Informer 缓存中的 Pod,确认它是否仍需调度。
本轮处理期间,Pod 可能已被删除、重建或完成绑定。例如,API Server 已保存绑定结果,但响应超时,Scheduler 收到的仍可能是错误。因此,需要根据重新读取的对象判断:
- 仍是同一个未绑定 Pod:交回 SchedulingQueue,由队列安排等待或重试。
- 读取失败或已经绑定:本次不再重新入队。
- 同名 Pod 已重建:直接结束旧对象的处理,避免向新 Pod 写入这次失败状态。
除同名 Pod 已重建的情况外,FailureHandler 随后都会继续记录本次失败:发出 FailedScheduling Event,并尝试向 API Server 提交 PodScheduled=False 的状态更新,保存失败原因,供用户排查。
SchedulingQueue:安排等待或重试
确认 Pod 仍需调度后,还要决定何时再试。资源不足等条件可能尚未改善,立即重复尝试仍可能失败,因此需要由 SchedulingQueue 管理下一次调度的时机。
FailureHandler 通过 AddUnschedulableIfNotPresent(),将 Pod 和本轮失败插件信息交回队列。SchedulingQueue 再结合相关事件、退避状态和 PreEnqueue 检查,决定让 Pod 等待条件变化、进入退避队列,或进入 activeQ。
这个方法完成入队安排后就返回,无需等待 Pod 完成下一次调度。
unreserveAndForget
unreserveAndForget() 先运行 Unreserve,再调用 Cache.ForgetPod() 移除 Assumed Pod。Unreserve 按 Reserve 插件执行顺序的逆序运行。例如,Reserve 按 A → B 执行,回滚时就按 B → A 调用 Unreserve。
func (sched *Scheduler) unreserveAndForget(...) error {
    // 撤销 Reserve 插件保存的卷预绑定等临时状态。
    schedFramework.RunReservePluginsUnreserve(
        ctx, state, assumedPodInfo.Pod, nodeName,
    )

    ...
    // 释放 Scheduler Cache 中的本地资源占用。
    return sched.Cache.ForgetPod(
        klog.FromContext(ctx), assumedPodInfo.Pod,
    )
}
handleBindingCycleError
handleBindingCycleError() 由绑定 goroutine 在收到失败后调用。此时主调度循环可能已经处理了后续 Pod,其中一些 Pod 可能因这份 Assumed 占用而被判断为资源不足。
方法先调用 unreserveAndForget() 清理本轮预留,并在回滚成功后安排 EventAssignedPodDelete 通知,表示这份本地占用已移除。SchedulingQueue 据此重新评估受影响的 Pod,让它们有机会重试;当前失败的 Pod 则单独交给 FailureHandler 继续处理。
func (sched *Scheduler) handleBindingCycleError(...) {
    logger := klog.FromContext(ctx)
    assumedPod := podInfo.Pod

    if err := sched.unreserveAndForget(
        ctx, state, fwk, podInfo, scheduleResult.SuggestedHost,
    ); err == nil {
        if status.IsRejected() {
            // 拒绝类失败先由 FailureHandler 处理当前 Pod,再通知其他 Pod。
            // 通知时排除当前 Pod,避免把本次清理当作它的重试信号。
            defer sched.SchedulingQueue.MoveAllToActiveOrBackoffQueue(
                logger, framework.EventAssignedPodDelete,
                assumedPod, nil,
                func(pod *v1.Pod) bool { return assumedPod.UID != pod.UID },
            )
        } else {
            sched.SchedulingQueue.MoveAllToActiveOrBackoffQueue(
                logger, framework.EventAssignedPodDelete,
                assumedPod, nil, nil,
            )
        }
    }

    sched.FailureHandler(
        ctx, fwk, podInfo, status, clearNominatedNode, start,
    )
}
handleSchedulingFailure
FailureHandler 是 Scheduler 中保存失败处理函数的字段。初始化时,applyDefaultHandlers() 将 handleSchedulingFailure 赋给该字段,因此调用 sched.FailureHandler(...) 时,默认执行的就是 handleSchedulingFailure():
func (sched *Scheduler) applyDefaultHandlers() {
    sched.SchedulePod = sched.schedulePod
    // 设置统一失败处理函数,供同步调度和异步绑定失败时调用。
    sched.FailureHandler = sched.handleSchedulingFailure
}
两种失败分别通过以下调用进入统一处理:
- 同步调度失败:失败状态返回
scheduleOnePod()后,由它调用sched.FailureHandler(...)。Reserve 或 Permit 失败时,返回前已执行unreserveAndForget()回滚。 - 异步绑定失败:
runBindingCycle()调用handleBindingCycleError(),由它执行unreserveAndForget(),安排必要的队列通知,再调用sched.FailureHandler(...)。
handleSchedulingFailure() 收到失败后,负责处理当前 Pod 的失败记录和重新入队检查。具体重试时机由 SchedulingQueue 决定,方法中的主线是:
- 保存失败诊断:取得本轮错误消息,将
FitError中的失败插件名保存到podInfo,供队列评估后续事件是否值得重试。 - 重新读取 Pod:通过 Pod Lister 取得 Informer 缓存中的对象,后续检查和重新入队使用这个对象。
- 确认能否交回队列:只有读取成功、UID 未变且尚未绑定的 Pod 才继续入队。检测到同名 Pod 已重建时,直接结束旧对象的处理。
- 交回 SchedulingQueue:调用
AddUnschedulableIfNotPresent(),由队列安排等待、退避或进入activeQ。 - 记录失败状态:发出
FailedSchedulingEvent,并向 API Server 提交PodScheduled=False的状态更新;读取失败或已绑定而不再入队的分支,也会继续记录本次失败。
func (sched *Scheduler) handleSchedulingFailure(
    ctx context.Context,
    podFwk framework.Framework,
    podInfo *framework.QueuedPodInfo,
    status *fwk.Status,
    nominatingInfo *fwk.NominatingInfo,
    start time.Time,
) {
    ...
    logger := klog.FromContext(ctx)
    pod := podInfo.Pod
    err := status.AsError()
    errMsg := status.Message()

    // 保存本轮失败涉及的插件名,替换上次尝试留下的记录。
    podInfo.ClearRejectorPlugins()
    if fitError, ok := err.(*framework.FitError); ok {
        podInfo.UnschedulablePlugins = fitError.Diagnosis.UnschedulablePlugins
        podInfo.PendingPlugins = fitError.Diagnosis.PendingPlugins
    }

    // 重新读取 Informer 缓存中的 Pod。
    podLister := podFwk.SharedInformerFactory().Core().V1().Pods().Lister()
    cachedPod, e := podLister.Pods(pod.Namespace).Get(pod.Name)
    // 检查对象身份与绑定状态,决定能否交回队列。
    if e != nil {
        // 读取失败:跳过入队,继续记录失败状态。
        ...
    } else if len(cachedPod.Spec.NodeName) != 0 {
        // 已经绑定:跳过入队,继续记录失败状态。
        ...
    } else {
        // 同名 Pod 已重建:结束旧对象处理,不更新新 Pod。
        if cachedPod.UID != podInfo.Pod.UID {
            return
        }

        podInfo.PodInfo, _ = framework.NewPodInfo(cachedPod.DeepCopy())
        pod = podInfo.Pod

        // 交给 SchedulingQueue,由队列安排等待或重试。
        if err := sched.SchedulingQueue.AddUnschedulableIfNotPresent(
            logger,
            podInfo,
            sched.SchedulingQueue.SchedulingCycle(),
        ); err != nil {
            ...
        }
        ...
    }
    ...

    // 记录失败事件,并提交 PodScheduled=False 的状态更新。
    msg := truncateMessage(errMsg)
    podFwk.EventRecorder().WithLogger(logger).Eventf(
        pod, nil, v1.EventTypeWarning,
        "FailedScheduling", "Scheduling", msg,
    )
    if err := updatePod(ctx, sched.client, podFwk.APICacher(), pod, &v1.PodCondition{
        Type:   v1.PodScheduled,
        Status: v1.ConditionFalse,
        ...
    }, nominatingInfo); err != nil {
        ...
    }
}
自定义调度插件
前面介绍了 Scheduling Framework 的扩展点和插件调用流程。接下来编写一个自定义调度插件 GPUModelFilter,根据 Pod 指定的 GPU 型号,筛选出符合要求的 Node。
实现 GPUModelFilter
配置字段
插件通过 pluginConfig.args 接收两个必填字段,由 Args 保存:
nodeLabelKey:Node 声明 GPU 型号时使用的 Label Key。示例配置为nvidia.com/gpu.product,与 GPU Feature Discovery 生成的标签一致。podAnnotationKey:Pod 声明所需 GPU 型号时使用的 Annotation Key。示例配置为scheduler.example.com/gpu-product。
type Args struct {
    // NodeLabelKey 指定 Node 声明 GPU 型号的 label key。
    NodeLabelKey string `json:"nodeLabelKey,omitempty"`
    // PodAnnotationKey 指定 Pod 声明所需 GPU 型号的 annotation key。
    PodAnnotationKey string `json:"podAnnotationKey,omitempty"`
}
创建插件实例
Framework 调用 New() 读取并校验配置,确认两个 Key 均已填写且格式合法后,将它们保存到 GPUModelFilter 实例中。后续 Filter() 按这两个 Key 读取 Pod 注解和 Node 标签。
type GPUModelFilter struct {
    nodeLabelKey     string
    podAnnotationKey string
}

func New(_ context.Context, configuration runtime.Object, _ fwk.Handle) (fwk.Plugin, error) {
    args := Args{}
    if err := frameworkruntime.DecodeInto(configuration, &args); err != nil {
        return nil, fmt.Errorf("decode %s configuration: %w", Name, err)
    }
    if args.NodeLabelKey == "" {
        return nil, fmt.Errorf("nodeLabelKey is required")
    }
    if messages := validation.IsQualifiedName(args.NodeLabelKey); len(messages) != 0 {
        return nil, fmt.Errorf("nodeLabelKey %q is invalid: %s", args.NodeLabelKey, strings.Join(messages, "; "))
    }
    if args.PodAnnotationKey == "" {
        return nil, fmt.Errorf("podAnnotationKey is required")
    }
    if messages := validation.IsQualifiedName(args.PodAnnotationKey); len(messages) != 0 {
        return nil, fmt.Errorf("podAnnotationKey %q is invalid: %s", args.PodAnnotationKey, strings.Join(messages, "; "))
    }

    return &GPUModelFilter{
        nodeLabelKey:     args.NodeLabelKey,
        podAnnotationKey: args.PodAnnotationKey,
    }, nil
}
插件名称
Name() 返回固定名称 GPUModelFilter,与注册插件及 Profile 配置中使用的名称保持一致。
const Name = "GPUModelFilter"

func (p *GPUModelFilter) Name() string {
    return Name
}
筛选节点
Filter() 按 podAnnotationKey 读取 Pod 注解中要求的 GPU 型号,再与候选节点 nodeLabelKey 对应的标签值比较。型号匹配时返回 nil,表示检查通过;不匹配时返回 UnschedulableAndUnresolvable,拒绝该节点。
func (p *GPUModelFilter) Filter(_ context.Context, _ fwk.CycleState, pod *v1.Pod, nodeInfo fwk.NodeInfo) *fwk.Status {
    requiredProduct := strings.TrimSpace(pod.Annotations[p.podAnnotationKey])
    if requiredProduct == "" {
        return fwk.NewStatus(
            fwk.UnschedulableAndUnresolvable,
            fmt.Sprintf("pod annotation %q is required", p.podAnnotationKey),
        )
    }

    node := nodeInfo.Node()
    if node == nil {
        return fwk.NewStatus(fwk.Error, "node information is unavailable")
    }

    actualProduct, exists := node.Labels[p.nodeLabelKey]
    if !exists || strings.TrimSpace(actualProduct) == "" {
        return fwk.NewStatus(
            fwk.UnschedulableAndUnresolvable,
            fmt.Sprintf("node %q does not define label %q", node.Name, p.nodeLabelKey),
        )
    }

    if actualProduct != requiredProduct {
        return fwk.NewStatus(
            fwk.UnschedulableAndUnresolvable,
            fmt.Sprintf(
                "node %q GPU product %q does not match required product %q",
                node.Name,
                actualProduct,
                requiredProduct,
            ),
        )
    }

    return nil
}
GPUModelFilter 完整源码
package gpumodelfilter

import (
    "context"
    "fmt"
    "strings"

    v1 "k8s.io/api/core/v1"
    "k8s.io/apimachinery/pkg/runtime"
    "k8s.io/apimachinery/pkg/util/validation"
    fwk "k8s.io/kube-scheduler/framework"
    frameworkruntime "k8s.io/kubernetes/pkg/scheduler/framework/runtime"
)

const Name = "GPUModelFilter"

type Args struct {
    // NodeLabelKey 指定 Node 声明 GPU 型号的 label key。
    NodeLabelKey string `json:"nodeLabelKey,omitempty"`
    // PodAnnotationKey 指定 Pod 声明所需 GPU 型号的 annotation key。
    PodAnnotationKey string `json:"podAnnotationKey,omitempty"`
}

// GPUModelFilter 根据 Pod 注解选择具有相同 GPU 产品标签的节点。
type GPUModelFilter struct {
    nodeLabelKey     string
    podAnnotationKey string
}

var _ fwk.FilterPlugin = &GPUModelFilter{}

// New 解码并校验 pluginConfig.args,再创建插件实例。
func New(_ context.Context, configuration runtime.Object, _ fwk.Handle) (fwk.Plugin, error) {
    args := Args{}
    if err := frameworkruntime.DecodeInto(configuration, &args); err != nil {
        return nil, fmt.Errorf("decode %s configuration: %w", Name, err)
    }
    if args.NodeLabelKey == "" {
        return nil, fmt.Errorf("nodeLabelKey is required")
    }
    if messages := validation.IsQualifiedName(args.NodeLabelKey); len(messages) != 0 {
        return nil, fmt.Errorf("nodeLabelKey %q is invalid: %s", args.NodeLabelKey, strings.Join(messages, "; "))
    }
    if args.PodAnnotationKey == "" {
        return nil, fmt.Errorf("podAnnotationKey is required")
    }
    if messages := validation.IsQualifiedName(args.PodAnnotationKey); len(messages) != 0 {
        return nil, fmt.Errorf("podAnnotationKey %q is invalid: %s", args.PodAnnotationKey, strings.Join(messages, "; "))
    }

    return &GPUModelFilter{
        nodeLabelKey:     args.NodeLabelKey,
        podAnnotationKey: args.PodAnnotationKey,
    }, nil
}

func (p *GPUModelFilter) Name() string {
    return Name
}

// Filter 在每个候选节点上运行。该示例只匹配产品型号,不核算 GPU 数量。
func (p *GPUModelFilter) Filter(_ context.Context, _ fwk.CycleState, pod *v1.Pod, nodeInfo fwk.NodeInfo) *fwk.Status {
    requiredProduct := strings.TrimSpace(pod.Annotations[p.podAnnotationKey])
    if requiredProduct == "" {
        return fwk.NewStatus(
            fwk.UnschedulableAndUnresolvable,
            fmt.Sprintf("pod annotation %q is required", p.podAnnotationKey),
        )
    }

    node := nodeInfo.Node()
    if node == nil {
        return fwk.NewStatus(fwk.Error, "node information is unavailable")
    }

    actualProduct, exists := node.Labels[p.nodeLabelKey]
    if !exists || strings.TrimSpace(actualProduct) == "" {
        return fwk.NewStatus(
            fwk.UnschedulableAndUnresolvable,
            fmt.Sprintf("node %q does not define label %q", node.Name, p.nodeLabelKey),
        )
    }

    if actualProduct != requiredProduct {
        return fwk.NewStatus(
            fwk.UnschedulableAndUnresolvable,
            fmt.Sprintf(
                "node %q GPU product %q does not match required product %q",
                node.Name,
                actualProduct,
                requiredProduct,
            ),
        )
    }

    return nil
}
注册插件
主程序调用 app.NewSchedulerCommand() 创建调度器启动命令,并通过 app.WithPlugin() 注册插件名称 GPUModelFilter 和工厂函数 New()。
package main

import (
    "os"

    "k8s.io/component-base/cli"
    _ "k8s.io/component-base/logs/json/register"
    _ "k8s.io/component-base/metrics/prometheus/clientgo"
    _ "k8s.io/component-base/metrics/prometheus/version"
    "k8s.io/kubernetes/cmd/kube-scheduler/app"

    "example.com/kubernetes-ai-infra/gpu-model-scheduler/pkg/gpumodelfilter"
)

func main() {
    // WithPlugin 将工厂注册到调度器 Registry;配置文件再按名称启用插件。
    command := app.NewSchedulerCommand(
        app.WithPlugin(gpumodelfilter.Name, gpumodelfilter.New),
    )
    os.Exit(cli.Run(command))
}
配置调度器
下面是自定义调度器的配置示例,用于启用 GPUModelFilter 并设置插件参数。
profiles:定义调度器使用的 Profile,每个 Profile 包含调度器名称、启用的插件和插件参数。这里配置一个 Profile。schedulerName:设为gpu-model-scheduler。需要使用这组调度配置的 Pod,其spec.schedulerName必须与这个值一致。plugins.filter.enabled:在 Filter 扩展点启用GPUModelFilter。这里的name必须与前面通过app.WithPlugin()注册的插件名称一致。pluginConfig:配置插件及其参数。它是一个列表,每个配置项包含两个同级字段:name:插件名称,这里为GPUModelFilter,与注册时使用的名称一致。args:传给插件构造函数New()的参数,对应前面的Args结构。其中,nodeLabelKey和podAnnotationKey分别指定读取 GPU 型号的 Node 标签和 Pod 注解。
apiVersion: v1
kind: ConfigMap
metadata:
  name: gpu-model-scheduler-config
  namespace: kube-system
data:
  scheduler-config.yaml: |
    apiVersion: kubescheduler.config.k8s.io/v1
    kind: KubeSchedulerConfiguration
    leaderElection:
      leaderElect: false
    profiles:
      - schedulerName: gpu-model-scheduler
        plugins:
          filter:
            enabled:
              - name: GPUModelFilter
        pluginConfig:
          - name: GPUModelFilter
            args:
              nodeLabelKey: nvidia.com/gpu.product
              podAnnotationKey: scheduler.example.com/gpu-product
上面的配置只在 enabled 中添加了 GPUModelFilter,没有显式禁用默认 Filter 插件,因此 NodeResourcesFit、NodeAffinity、TaintToleration 等检查仍然生效。
如果希望 Filter 阶段只运行 GPUModelFilter,可以在当前 Profile 的 plugins.filter.disabled 中使用 name: "*",禁用该扩展点的全部默认插件:
如果只需禁用某个默认 Filter 插件,将 "*" 替换为具体名称,例如 TaintToleration。这里的禁用范围仅限 Filter 扩展点;使用 "*" 会一并移除该阶段的资源、亲和性和污点等默认检查。
部署调度器
下面通过 Deployment 运行自定义调度器,并挂载前面定义的调度配置。
-
serviceAccountName:指定调度器访问 API Server 时使用的身份。本例使用gpu-model-scheduler,由rbac.yaml创建 ServiceAccount,并通过 ClusterRoleBinding 绑定cluster-admin。生产环境应根据调度器实际使用的资源和操作配置 RBAC 权限,仅授予必要权限。 -
image:运行包含GPUModelFilter的自定义调度器镜像,名称和标签应与部署脚本构建、加载的镜像一致。 volumes:定义名为scheduler-config的配置卷。configMap.name指向前面的 ConfigMapgpu-model-scheduler-config。volumeMounts:通过name: scheduler-config引用该配置卷,并挂载到容器的/etc/kubernetes目录。ConfigMap 中的scheduler-config.yaml会成为该目录下的同名文件。args:传给调度器的启动参数。--config=/etc/kubernetes/scheduler-config.yaml指向挂载后的配置文件,调度器据此启用插件并读取参数。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: gpu-model-scheduler
  namespace: kube-system
  labels:
    app: gpu-model-scheduler
spec:
  replicas: 1
  selector:
    matchLabels:
      app: gpu-model-scheduler
  template:
    metadata:
      labels:
        app: gpu-model-scheduler
    spec:
      serviceAccountName: gpu-model-scheduler
      containers:
        - name: scheduler
          image: k8s-ai-infra/gpu-model-scheduler:v1.36.4
          imagePullPolicy: Never
          args:
            - --config=/etc/kubernetes/scheduler-config.yaml
            - --secure-port=0
            - --v=4
          resources:
            requests:
              cpu: 100m
              memory: 128Mi
            limits:
              memory: 512Mi
          securityContext:
            allowPrivilegeEscalation: false
            readOnlyRootFilesystem: true
            runAsNonRoot: true
            capabilities:
              drop:
                - ALL
          volumeMounts:
            - name: scheduler-config
              mountPath: /etc/kubernetes
              readOnly: true
      volumes:
        - name: scheduler-config
          configMap:
            name: gpu-model-scheduler-config
本地需要安装 Docker、Kind 和 kubectl,并确保 Docker 已启动。运行 setup-kind.sh 准备 Kind 集群、构建并加载镜像,然后应用调度配置、RBAC 和 Deployment:
脚本默认使用 scheduler-demo 作为集群名称,集群包含一个 control-plane 和两个 worker。两个 worker 分别添加以下 GPU 型号标签,供 GPUModelFilter 筛选:
scheduler-demo-worker:  nvidia.com/gpu.product=NVIDIA-A100-SXM4-80GB
scheduler-demo-worker2: nvidia.com/gpu.product=NVIDIA-H100-80GB-HBM3
脚本会等待 kube-system/gpu-model-scheduler Deployment 就绪后返回。随后,spec.schedulerName 为 gpu-model-scheduler 的 Pod 就会使用这套调度配置。
验证调度结果
接下来,通过 test-pods.yaml 创建三个测试 Pod,交给 gpu-model-scheduler 调度,分别验证请求 A100、请求 H100 和缺少 GPU 型号注解时的调度结果:
apiVersion: v1
kind: Pod
metadata:
  name: gpu-model-a100
  namespace: default
  labels:
    app: gpu-model-filter-test
  annotations:
    scheduler.example.com/gpu-product: NVIDIA-A100-SXM4-80GB
spec:
  schedulerName: gpu-model-scheduler
  restartPolicy: Never
  containers:
    - name: pause
      image: registry.k8s.io/pause:3.10
---
apiVersion: v1
kind: Pod
metadata:
  name: gpu-model-h100
  namespace: default
  labels:
    app: gpu-model-filter-test
  annotations:
    scheduler.example.com/gpu-product: NVIDIA-H100-80GB-HBM3
spec:
  schedulerName: gpu-model-scheduler
  restartPolicy: Never
  containers:
    - name: pause
      image: registry.k8s.io/pause:3.10
---
apiVersion: v1
kind: Pod
metadata:
  name: gpu-model-missing-annotation
  namespace: default
  labels:
    app: gpu-model-filter-test
spec:
  schedulerName: gpu-model-scheduler
  restartPolicy: Never
  containers:
    - name: pause
      image: registry.k8s.io/pause:3.10
运行验证脚本:
脚本重新创建三个 Pod,并检查以下结果:
gpu-model-a100绑定到带 A100 标签的 worker。gpu-model-h100绑定到带 H100 标签的 worker。gpu-model-missing-annotation保持 Pending,FailedSchedulingEvent 包含插件返回的缺少注解的原因。
脚本执行成功后,输出类似如下:
GPUModelFilter verification
Pod gpu-model-a100: node=scheduler-demo-worker
Pod gpu-model-h100: node=scheduler-demo-worker2
Pod gpu-model-missing-annotation: Pending
FailedScheduling event: FailedScheduling  0/3 nodes are available: 1 node(s) had untolerated taint(s), 2 pod annotation "scheduler.example.com/gpu-product" is required. no new claims to deallocate, preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling.
GPU resource request: absent
Result: PASS
Event 中的 pod annotation "scheduler.example.com/gpu-product" is required 是插件返回的拒绝原因。缺少注解的 Pod 保持 Pending 是预期结果,PASS 表示三个测试 Pod 的检查均已通过。
验证完成后,执行清理脚本,删除本例的 scheduler-demo Kind 集群及其中的所有资源:
FAQ
PreFilter 和 Filter 有什么区别?
PreFilter 在当前 Pod 的每轮调度中运行一次,用于计算所有候选 Node 都会使用的数据。Filter 对每台候选 Node 运行一次,判断该 Node 是否满足 Pod 的硬约束。
| 阶段 | 执行次数 | 作用 |
|---|---|---|
PreFilter |
每个插件一次 | 计算所有 Node 都会用到的数据 |
Filter |
每台候选 Node 一次 | 判断当前 Node 是否满足硬约束 |
例如集群中有 1,000 台候选 Node,NodeResourcesFit 在 PreFilter 中只计算一次 Pod 的 CPU、内存和 GPU 请求,并将结果写入 CycleState。Filter 随后使用这份结果逐台检查 Node,无需重复解析 1,000 次 Pod 的资源配置。
插件没有可复用的筛选计算时,可以只实现 Filter。
PreScore 和 Score 有什么区别?
PreScore 在当前 Pod 的每轮调度中运行一次,用于汇总所有可行 Node 的评分背景数据。Score 对每台可行 Node 运行一次,计算该 Node 的分数。
| 阶段 | 执行次数 | 作用 |
|---|---|---|
PreScore |
每个插件一次 | 汇总可行 Node 的评分背景数据 |
Score |
每台可行 Node 一次 | 计算当前 Node 的分数 |
例如 PodTopologySpread 在 PreScore 中统计各个拓扑域中已有的 Pod 数量。Score 为某台 Node 打分时,直接查询该 Node 所在拓扑域的计数,无需重新扫描整个集群。
插件没有可复用的评分计算时,可以只实现 Score。
集群有几千个节点,Scheduler 会全部检查一遍吗?如果提前停止,会不会漏掉更合适的节点?
不一定会全部检查;提前停止时,也可能漏掉得分更高的节点。
进入常规 Filter 和 Score 路径时,Scheduler 会先确定本轮需要找到多少个可行节点;找到足够数量后,便取消后续扫描,再对返回的可行节点评分。
本轮需要找到的可行节点数量,按以下步骤确定:
- 读取配置:优先使用当前 Profile 的
percentageOfNodesToScore,未配置时使用全局值。 -
确定比例:配置值非零时,直接使用该比例;为
0时,根据候选节点数量自动计算,自动计算的比例最低为5%。下式中numAllNodes是候选节点数量,除法取整数商: -
换算节点数:候选节点总数不少于 100 时,按比例计算目标可行节点数,计算结果不足 100 则将目标提高到 100;候选节点总数不足 100 时,检查全部候选节点,只把通过 Filter 的节点加入可行节点列表。
例如,参与筛选的节点有 5,000 个时,两种 percentageOfNodesToScore 配置会得到不同的目标数量:
- 配置为
20:直接使用20%,目标是找到5000 × 20% = 1000个可行节点。 - 配置为
0:自动计算得到50 - 5000 / 125 = 10,即10%,目标是找到5000 × 10% = 500个可行节点。
目标数量指通过 Filter 的节点数量,不是固定扫描多少个节点。如果很多节点不满足条件,就需要检查更多节点;始终找不够时,会遍历全部候选节点。
未进入可行节点列表的节点不会参与本轮评分。提高这个比例可以扩大比较范围,但也会增加筛选和评分开销。为避免每轮总是优先检查同一批节点,Scheduler 会从上一轮停止的位置继续扫描,节点列表也会按 Zone 交错排列。这些措施让不同节点都有机会被检查,但不保证每个 Pod 都选到整个集群中得分最高的节点。
Pod 还在调度时收到资源释放事件,失败后还能据此重试吗?
可以,不会因为事件先于调度失败到达而错过。
SchedulingQueue 通过 activeQ 内的 inFlightEvents 记录 Pod 调度期间收到的相关事件。Pod 失败返回后,队列再通过 QueueingHint 判断这些变化是否有助于重试:值得重试的 Pod 进入 activeQ 或 backoffQ,否则留在 unschedulablePods 等待后续事件。重试仍受退避限制,不一定立即开始。
前一个 Pod 还没绑定完成,后一个 Pod 就开始调度,会不会把同一份资源分配两次?
在同一个 Scheduler 的普通 Pod 调度路径中,不会因前一个 Pod 尚未绑定完成而重复分配同一份资源。
Scheduler 会先为前一个 Pod 选好节点并记录本地占用,再异步执行绑定。下一个 Pod 开始调度时,已经能看到这部分占用,无需等待 API Server 确认绑定。
假设某个 Node 还可以容纳 4 CPU 的请求,Pod A 和 Pod B 各请求 3 CPU。A 选中该 Node 后,Cache.AssumePod() 会先把 A 计入目标 NodeInfo。B 的调度周期刷新 Snapshot 后,看到的剩余可分配量只有 1 CPU,因此不会因为 A 尚未绑定完成,就把同一份资源再分配给 B。
绑定成功后,Pod Informer 通过 Cache.AddPod() 用观察到的 Pod 更新临时记录,不会把 A 的资源请求再叠加一次;后续阶段失败需要回滚时,则通过 Cache.ForgetPod() 撤销这部分本地占用。这套协调依赖同一个 Scheduler 的 Cache,不能当作多个独立调度器之间的资源锁。
正在筛选节点时,集群中的资源占用发生了变化,这一轮调度应该使用旧数据还是新数据?
使用本轮开始时刷新的 Snapshot,不会在筛选过程中切换到实时更新的 Cache 数据。
Scheduler 在运行调度算法前更新 Snapshot,将 Cache 中已经观察到的变化复制过来;之后 Informer 对 Cache 的更新,不会直接改写本轮 Snapshot。
这样,Filter 和 Score 可以使用同一份节点视图,而不用一边筛选、一边跟随集群事件修改判断依据。对于本轮节点读取,Scheduler 只在刷新 Snapshot 时持有 Cache 锁,不用覆盖整个节点筛选和评分过程。接口注释明确说明,这份 Snapshot 在本轮 Permit 阶段结束前保持稳定。
例如,当前 Pod 已经根据 Snapshot 判断某个 Node 资源不足,随后另一个 Pod 被删除并释放资源,本轮不会立即重新检查这个 Node。若本次调度失败,队列可以根据删除事件安排重试,下一轮刷新 Snapshot 后再使用更新后的资源状态。这里的“最新”是 Scheduler 已经观察到的状态,不保证与 API Server 在同一时刻完全一致。
相关资料
- Kubernetes Scheduler
- Kubernetes Scheduling Framework
- KubeSchedulerConfiguration v1
- Scheduling Policies
- Kubernetes v1.36.4 Scheduler source
- 深入理解 Kubernetes Scheduler Framework 调度框架(Part 1)
- 深入理解 Kubernetes Scheduler Framework 调度框架(Part 2)
- 深入理解 Kubernetes Scheduler Framework 调度框架(Part 3)
- 深入理解 Kubernetes Scheduler Framework 调度框架(Part 4)