容器运行时:从 CRI 到容器进程
容器运行时负责根据 Pod 的运行配置在节点上创建和管理容器,并维护镜像与容器状态。Kubelet 通过 CRI 向容器运行时发送创建、启动、停止和删除请求。创建容器时,运行时准备镜像与运行环境,协调 Pod 网络接入,并将 Kubelet 已经准备好的 Volume 挂载到容器中。
容器运行时
按照调用层级,容器运行时可以分为高级容器运行时和低级容器运行时。这里的“高级”和“低级”表示它们在调用链中的位置,不表示功能强弱。
- 高级容器运行时:负责镜像管理、容器网络以及与 Kubernetes 等编排系统的集成。常见实现包括 containerd、CRI-O 和 Docker Engine。
- 低级容器运行时:负责实际执行容器,根据 OCI Bundle 创建隔离环境并启动容器进程。常见实现包括 runc、crun、gVisor 和 Kata Containers。
CRI 是 Kubelet 与高级容器运行时之间的标准接口,定义了拉取镜像、创建 Pod Sandbox 和管理容器等请求。containerd 和 CRI-O 实现 CRI,接收 Kubelet 的请求并管理镜像与容器状态;创建普通 Linux 容器时,它们再调用 runc、crun 等执行后端启动容器进程。下图展示了这条调用关系。
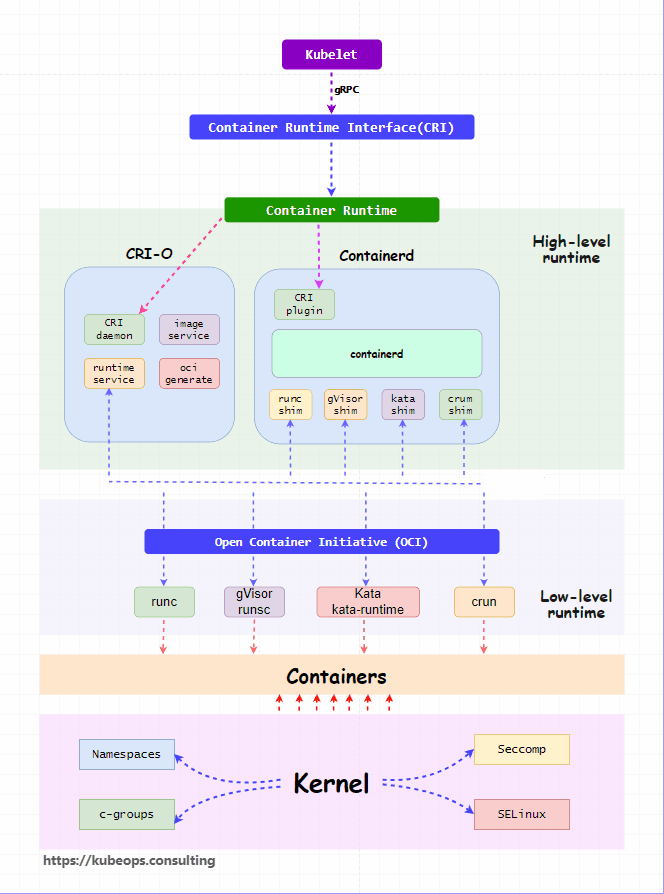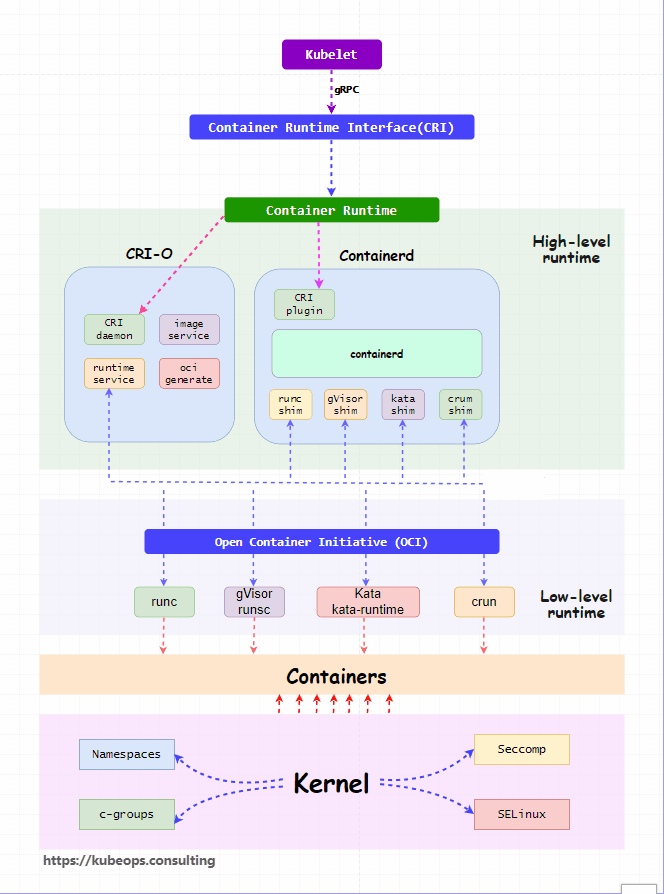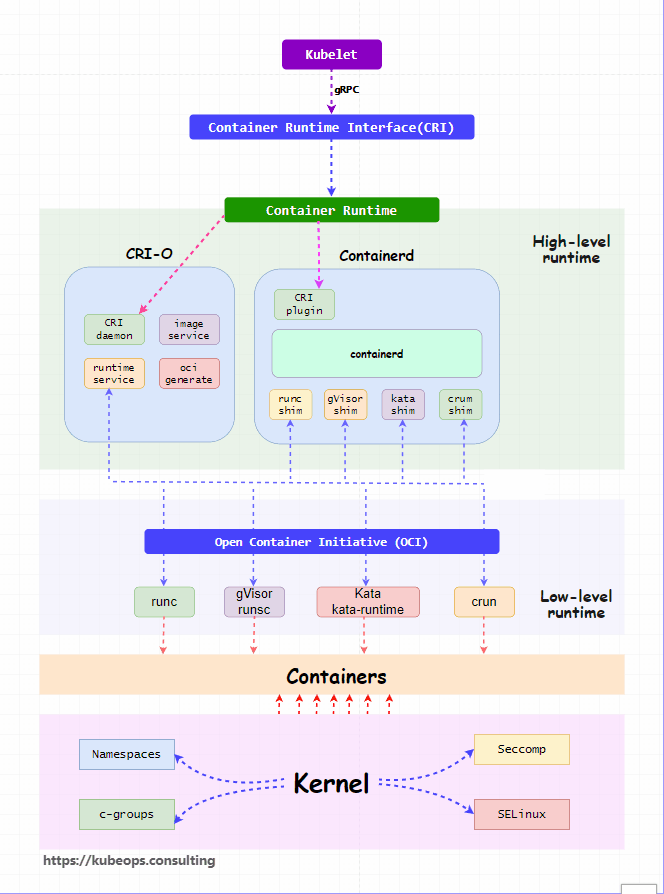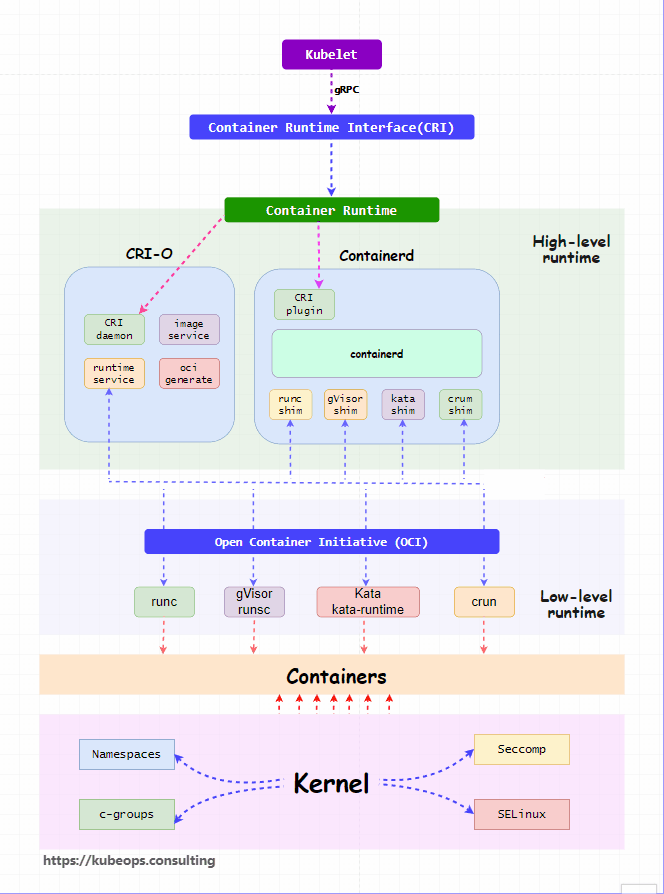
图:Kubelet、CRI、高级容器运行时与 OCI 执行后端的分层关系。来源:Vikas Yadav,Why CRI Matters: Enhancing Kubernetes with Standardized Runtimes!
CRI
容器运行时接口(Container Runtime Interface,CRI)是 Kubernetes 中基于 gRPC 的标准化 API 层。gRPC 是一种高性能远程过程调用协议,Kubelet 通过它与 containerd、CRI-O 等容器运行时通信。
CRI 抽象了拉取镜像、启动和停止容器等生命周期操作,使 Kubernetes 无需修改便可使用不同的容器运行时。它包含两个核心组件,用于定义 Kubernetes 与容器运行时的协作方式:
RuntimeService:处理容器的生命周期。它管理 Pod Sandbox,使容器能够在需要时共享网络和存储等资源。ImageService:管理运行时使用的容器镜像。它通过镜像拉取和缓存提高部署效率。
在 CRI 出现之前,Kubernetes 需要分别与每种运行时直接集成,导致系统过度依赖通用型运行时,也限制了开发者体验和性能选择。
使用 CRI 后,Kubernetes 保持了灵活、模块化的运行时架构。组织可以避免厂商锁定,并根据实际需求选择合适的运行时。
CRI 的演进
下图展示了 Kubernetes CRI 的演进过程。
%%{init: {"flowchart": {"nodeSpacing": 22, "rankSpacing": 42}, "themeVariables": {"fontSize": "14px"}}}%%
flowchart TB
    subgraph BEFORE["Kubernetes 1.5 以前"]
        direction LR
        BEFORE_KUBELET["Kubelet<br/>运行时专用适配代码"]
        BEFORE_DOCKER["Docker Engine"]
        BEFORE_RKT["rkt"]
        BEFORE_KUBELET -->|"Docker 专用适配"| BEFORE_DOCKER
        BEFORE_KUBELET -->|"rkt 专用适配"| BEFORE_RKT
        BEFORE_DOCKER --> BEFORE_CONTAINER_1["Container"]
        BEFORE_DOCKER --> BEFORE_CONTAINER_2["Container"]
        BEFORE_RKT --> BEFORE_CONTAINER_3["Container"]
    end

    subgraph CRI_PHASE["CRI 引入后、dockershim 移除前(1.5–1.23)"]
        direction LR
        CRI_KUBELET["Kubelet"]
        DOCKERSHIM["dockershim<br/>Kubelet 内置"]
        DOCKER_ENGINE["Docker Engine"]
        CONTAINERD["containerd 1.1<br/>内置 CRI Plugin<br/>Kubernetes 1.10+"]
        CRIO["CRI-O<br/>直接实现 CRI"]

        CRI_KUBELET -->|"CRI gRPC"| DOCKERSHIM
        DOCKERSHIM -->|"Docker API"| DOCKER_ENGINE
        CRI_KUBELET -->|"CRI gRPC"| CONTAINERD
        CRI_KUBELET -->|"CRI gRPC"| CRIO
        DOCKER_ENGINE --> CRI_CONTAINER_1["Container"]
        CONTAINERD --> CRI_CONTAINER_2["Container"]
        CRIO --> CRI_CONTAINER_3["Container"]
    end

    subgraph CURRENT["Kubernetes 1.24 及以后"]
        direction LR
        CURRENT_KUBELET["Kubelet"]
        CURRENT_RUNTIME["containerd / CRI-O<br/>直接提供 CRI Endpoint"]
        CURRENT_KUBELET -->|"CRI gRPC"| CURRENT_RUNTIME
        CURRENT_RUNTIME --> CURRENT_CONTAINER_1["Container"]
        CURRENT_RUNTIME --> CURRENT_CONTAINER_2["Container"]
        CURRENT_RUNTIME --> CURRENT_CONTAINER_3["Container"]
    end

    BEFORE ~~~ CRI_PHASE
    CRI_PHASE ~~~ CURRENT

    classDef kubelet fill:#eef3ff,stroke:#4c64e8,stroke-width:1.5px;
    classDef adapter fill:#f3efff,stroke:#7650d8,stroke-width:1.5px;
    classDef runtime fill:#effbf3,stroke:#22875a,stroke-width:1.5px;
    classDef container fill:#ffffff,stroke:#5f6470,stroke-width:1.25px;

    class BEFORE_KUBELET,CRI_KUBELET,CURRENT_KUBELET kubelet;
    class DOCKERSHIM adapter;
    class BEFORE_DOCKER,BEFORE_RKT,DOCKER_ENGINE,CONTAINERD,CRIO,CURRENT_RUNTIME runtime;
class BEFORE_CONTAINER_1,BEFORE_CONTAINER_2,BEFORE_CONTAINER_3,CRI_CONTAINER_1,CRI_CONTAINER_2,CRI_CONTAINER_3,CURRENT_CONTAINER_1,CURRENT_CONTAINER_2,CURRENT_CONTAINER_3 container;- Kubernetes 1.5 以前:Kubelet 源码中维护 Docker、rkt 等运行时各自的适配代码。Kubernetes 1.5 开始以 Alpha 功能提供 CRI。
-
Kubernetes 1.5–1.23:Kubelet 内置适配和运行时直接实现 CRI 的方式曾经并存:
- Docker Engine:Kubelet 内置
dockershim,将 CRI 请求转换为 Docker API。 - containerd:
containerd 1.1将 CRI Plugin 集成到 containerd 进程中,支持 Kubernetes 1.10 及以上版本。 - CRI-O:CRI-O 直接提供 CRI 服务。
- Docker Engine:Kubelet 内置
-
Kubernetes 1.24 及以后:Kubelet 移除内置 dockershim,通过 CRI Endpoint 连接 containerd、CRI-O 等运行时。
RuntimeService
RuntimeService 管理 Pod Sandbox、容器进程以及节点运行时状态。Kubelet 先通过 RunPodSandbox 请求运行时创建 Pod Sandbox,准备 Pod 内容器共享的网络等运行环境。随后使用 CreateContainer 和 StartContainer 创建并启动 Init Container、Sidecar Container 与 App Container。
| RPC 分组 | 代表方法 | 用途 |
|---|---|---|
| 版本与状态 | Version、Status、RuntimeConfig |
协商 API、检查运行时和网络状态、读取运行时配置 |
| Pod Sandbox | RunPodSandbox、StopPodSandbox、RemovePodSandbox、PodSandboxStatus |
建立和回收 Pod 级运行环境 |
| 容器生命周期 | CreateContainer、StartContainer、StopContainer、RemoveContainer、ContainerStatus |
管理单个容器和入口进程 |
| 进程交互 | ExecSync、Exec、Attach、PortForward |
执行命令或建立流式连接 |
| 资源与指标 | ContainerStats、PodSandboxStats、ListMetricDescriptors、ListPodSandboxMetrics |
返回 CPU、内存、文件系统和 Pod 指标 |
| 运行时配置 | UpdateRuntimeConfig、ReopenContainerLog、CheckpointContainer |
更新 Pod CIDR、重新打开日志或创建容器检查点 |
ImageService
ImageService 管理节点本地镜像。Kubelet 根据 PodSpec 和本地缓存状态决定是否拉取镜像,再把镜像引用、Registry 认证信息和 Pod Sandbox 配置传给 PullImage。容器运行时从镜像仓库下载镜像,校验镜像数据,并保存到节点本地,供后续创建容器使用。
| 方法 | 用途 |
|---|---|
ListImages |
列出本地镜像 |
ImageStatus |
查询指定镜像的 ID、RepoTag、RepoDigest、大小和用户信息 |
PullImage |
从 Registry 拉取镜像 |
RemoveImage |
删除镜像引用和可回收内容 |
ImageFsInfo |
返回镜像文件系统与容器可写层的空间使用情况 |
CRI 调用链
Pod 分配到节点后,Kubelet 通过 CRI 请求容器运行时创建 Pod Sandbox、准备镜像并启动容器。下图以 containerd 为例,展示镜像拉取策略为 IfNotPresent、节点尚未缓存应用镜像时的调用过程。
- 创建 Pod Sandbox(图中 1–3):Kubelet 调用 RuntimeService 的
RunPodSandbox。containerd 创建 Pod Sandbox 并配置网络,完成后向 Kubelet 返回 Sandbox ID。 - 检查本地镜像(图中 4–5):Kubelet 调用 ImageService 的
ImageStatus,查询应用镜像是否已在节点上。图中镜像尚未缓存,因此需要继续拉取。 - 拉取镜像(图中 6–8):Kubelet 调用 ImageService 的
PullImage。containerd 从镜像仓库下载并解包镜像,完成后返回镜像引用,供后续创建容器使用。 - 创建容器(图中 9–11):Kubelet 调用 RuntimeService 的
CreateContainer,传入 Sandbox ID 和容器配置。containerd 保存容器元数据并生成 OCI 运行配置,返回 Container ID。 - 启动容器(图中 12–14):Kubelet 使用 Container ID 调用 RuntimeService 的
StartContainer。containerd 创建并启动容器进程,成功后向 Kubelet 返回响应。
sequenceDiagram
    autonumber
    participant K as Kubelet Runtime Manager
    box transparent containerd CRI Plugin
        participant R as CRI RuntimeService
        participant I as CRI ImageService
    end

    K->>R: RunPodSandbox(config, runtimeHandler)
    R->>R: Create sandbox and configure network
    R-->>K: Sandbox ID
    K->>I: ImageStatus(image)
    I-->>K: Image not present
    K->>I: PullImage(image, auth, sandboxConfig)
    I->>I: Fetch and unpack image
    I-->>K: Image reference
    K->>R: CreateContainer(sandboxID, config)
    R->>R: Create container metadata and OCI spec
    R-->>K: Container ID
    K->>R: StartContainer(containerID)
    R->>R: Create and start task
R-->>K: Successcrictl
crictl 是 Kubernetes SIG Node 维护的 CRI 调试客户端。它调用 RuntimeService 和 ImageService,适合检查 Kubelet 所看到的 Pod Sandbox、Container、Image 和运行时状态。
可以在 /etc/crictl.yaml 中配置 crictl 连接的 RuntimeService 和 ImageService 地址:
runtime-endpoint: unix:///run/containerd/containerd.sock
image-endpoint: unix:///run/containerd/containerd.sock
timeout: 10
debug: false
常用命令分别查看运行时状态、Sandbox、容器和镜像:
# 查看当前节点的容器运行时信息
crictl info

# 列出当前节点的 Pod Sandbox
crictl pods

# 列出当前节点的所有容器,包括已退出的容器
crictl ps --all

# 列出当前节点的本地镜像
crictl images

# 查看指定 Pod Sandbox 的详细信息
crictl inspectp "$POD_ID"

# 查看指定容器的详细信息
crictl inspect "$CONTAINER_ID"
高级容器运行时
高级容器运行时是常驻在节点上的管理服务。它接收 Docker API、containerd API 或 CRI 请求,管理镜像、rootfs、容器配置和运行状态,再调用低级容器运行时创建并启动容器。
常见的高级容器运行时有 Docker Engine、containerd 和 CRI-O:
| 运行时 | 主要接口 | 典型调用方 |
|---|---|---|
| Docker Engine | Docker API | docker CLI、Compose、Docker SDK |
| containerd | containerd API、CRI | Docker Engine、Kubelet、ctr、nerdctl |
| CRI-O | CRI | Kubelet、crictl |
Docker Engine
Docker Engine 提供面向用户和开发工具的容器 API。它管理 Image、Container、Network、Volume 等 Docker 对象,并把容器生命周期交给 containerd。
Kubernetes 1.24 移除了 Kubelet 内置的 dockershim。Docker Engine 本身不实现 CRI,需要继续使用 Docker Engine 作为节点容器运行时时,可以通过外置的 cri-dockerd 接入 Kubelet。
组件架构
Docker Engine 使用 Client-Server 架构。下图展示了 Docker Client、dockerd、Registry,以及镜像、容器等资源之间的关系。
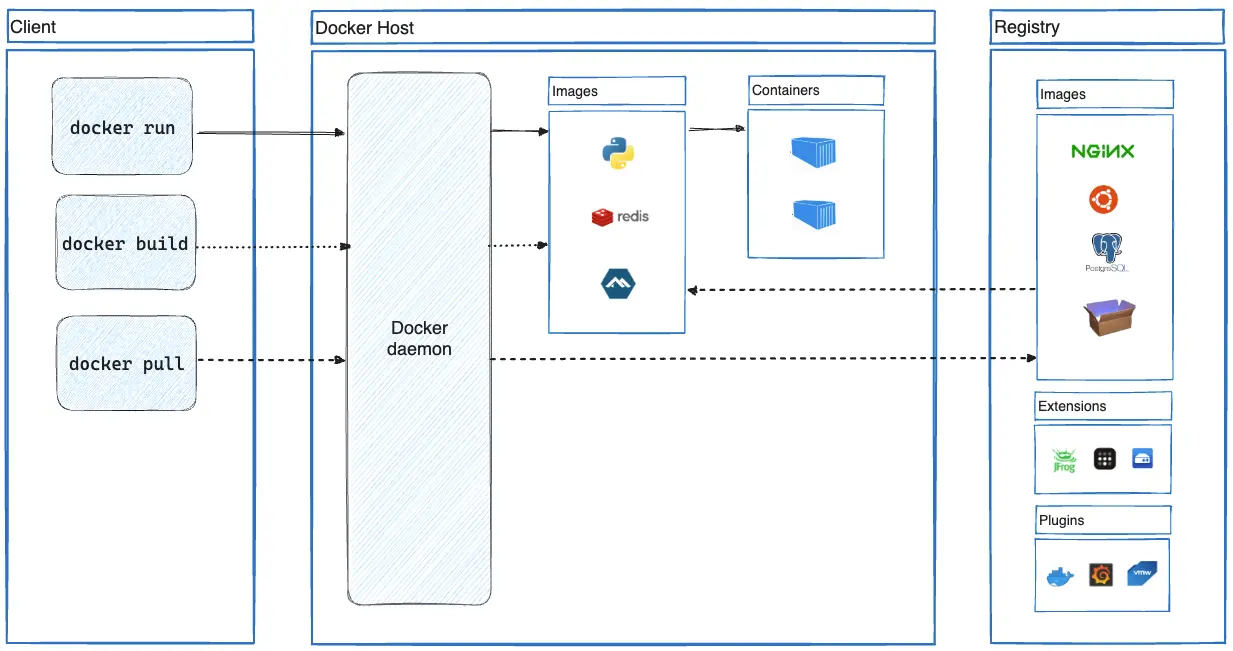
图:Docker Engine Client-Server 架构。来源:Docker Architecture。
- Docker Client:
dockerCLI 将run、pull、build等命令转换成 Docker API 请求。Client 可以连接本机 Unix Socket,也可以通过配置连接远端 daemon。 - Docker API:Docker SDK 和 CLI 通过同一组 HTTP API 管理镜像、容器、网络和数据卷。
- dockerd:
dockerd处理 API 请求,保存这些资源的元数据,并管理它们的生命周期。 - containerd:Docker Engine 使用 containerd 管理容器生命周期。containerd 准备 Task 并连接 Runtime v2 Shim,默认路径继续调用 runc。
- Registry:
docker pull从 Registry 取得 Image Manifest、Config 和 Layer;docker push将本地构建结果上传到 Registry。
使用方式
docker version 同时查询 Client 和 Server。docker info 展示 daemon 当前使用的 Runtime、Storage Driver 和 cgroup 配置:
docker version --format \
  'Client={{.Client.Version}} Server={{.Server.Version}} API={{.Server.APIVersion}}'
# 输出示例
Client=29.4.0 Server=29.4.0 API=1.54

docker info --format \
  'DefaultRuntime={{.DefaultRuntime}} StorageDriver={{.Driver}} CgroupDriver={{.CgroupDriver}} CgroupVersion={{.CgroupVersion}}'
# 输出示例
DefaultRuntime=runc StorageDriver=overlay2 CgroupDriver=cgroupfs CgroupVersion=2
下面的命令拉取 Alpine Image、创建 Container,并在 Container 中启动一个进程。--rm 在进程退出后删除 Container 元数据和可写层:
containerd
containerd 是面向系统组件的容器运行时,负责管理镜像、容器文件系统和容器生命周期。Docker Engine 和 Kubernetes 都可以把它作为节点上的运行时管理层。
核心概念
containerd 在拉取镜像、准备容器文件系统和运行容器时,涉及以下核心概念和服务:
- Image:镜像的元数据记录,保存镜像名称、标签,以及指向镜像清单(Manifest)或索引(Index)的描述信息。例如,
docker.io/library/alpine:3.22这个名称通过 Image 记录关联到具体的镜像内容。 - Content:镜像的原始内容,包括 Index、Manifest、配置和镜像层。Content Store 是 containerd 在节点上保存和读取这些内容的存储组件。它将每份内容作为独立的数据块(Blob)保存,并以内容摘要(Digest)作为标识。相同内容只需保存一份,可以被多个镜像复用。
- Snapshot:容器文件系统的快照,记录文件系统状态,不包含进程内存。Snapshotter 是创建和管理这些快照的存储插件。它为镜像解包准备文件系统,为容器准备可写层,并提供挂载根文件系统(rootfs)所需的信息。常见实现包括 overlayfs(默认)、native、blockfile、devmapper、btrfs、zfs 和 erofs。
- Diff:计算和应用文件系统差异。镜像解包时,它读取 Content Store 中的镜像层,将文件的新增、修改和删除应用到 Snapshotter 准备的文件系统中;生成镜像层时,它计算两个文件系统状态之间的差异,并将结果保存到 Content Store。
- Container:容器的持久化配置,记录使用哪个镜像、文件系统和运行时,以及要执行的命令等信息。创建 Container 是保存这份配置,实际进程由 Task 管理。
- Task:容器的进程执行实例,用于管理进程的启动、暂停、终止、输入输出和退出状态。Task 被删除后,Container 配置仍可保留,用于再次创建 Task。
- Events:事件发布与订阅服务,用于传递镜像、容器和任务的状态变化。例如,容器进程退出后,TaskExit 事件携带容器 ID、PID、退出码和退出时间,订阅者可以据此更新状态。
下图展示了 containerd 的主要服务及其职责划分。
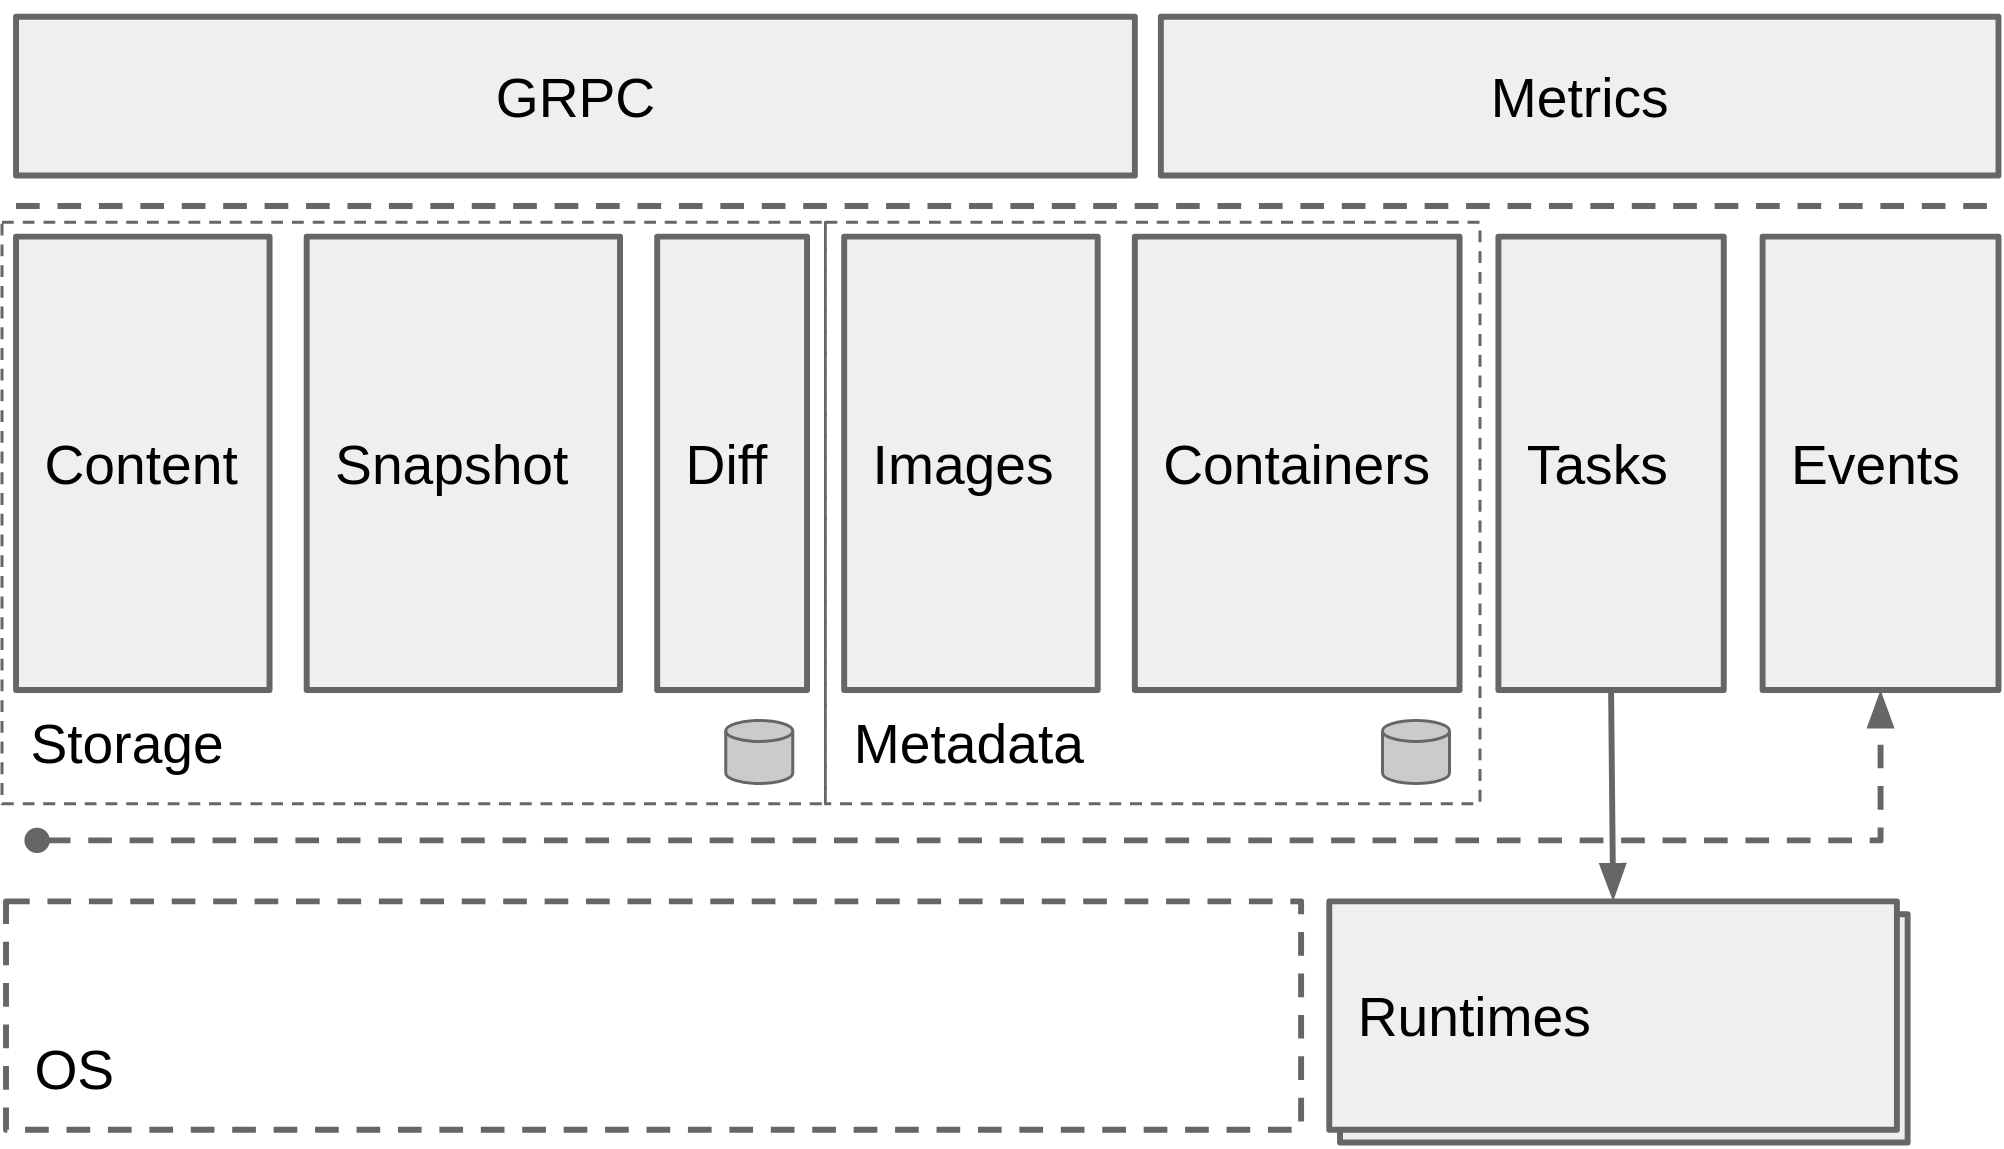
图:containerd 核心服务架构。来源:containerd v2.3.4 README。
容器运行过程
containerd 创建并启动容器的过程分为以下三个步骤:
- 创建 Container:客户端请求 Container Service 保存镜像引用、运行时选择、Snapshot 引用和 OCI 运行配置等元数据。这一步建立 Container 记录,供后续创建 Task 使用,应用进程尚未创建。
- 创建 Task:客户端请求 Task Service 创建 Task。Task Service 读取 Container 配置,再通过
TaskManager.Create准备 Bundle、建立或复用 Shim 连接,并向 Shim 发送创建请求。Shim 调用低级容器运行时准备容器的初始进程;在 runc 路径中,此时尚未执行应用入口命令。 - 启动 Task:客户端向 Task Service 发送
Start请求。containerd 将请求交给 Shim,由运行时启动应用命令,成功后向客户端返回进程 PID。
下图展示了客户端通过 Container Service 和 Task Service 创建并启动容器的调用过程。
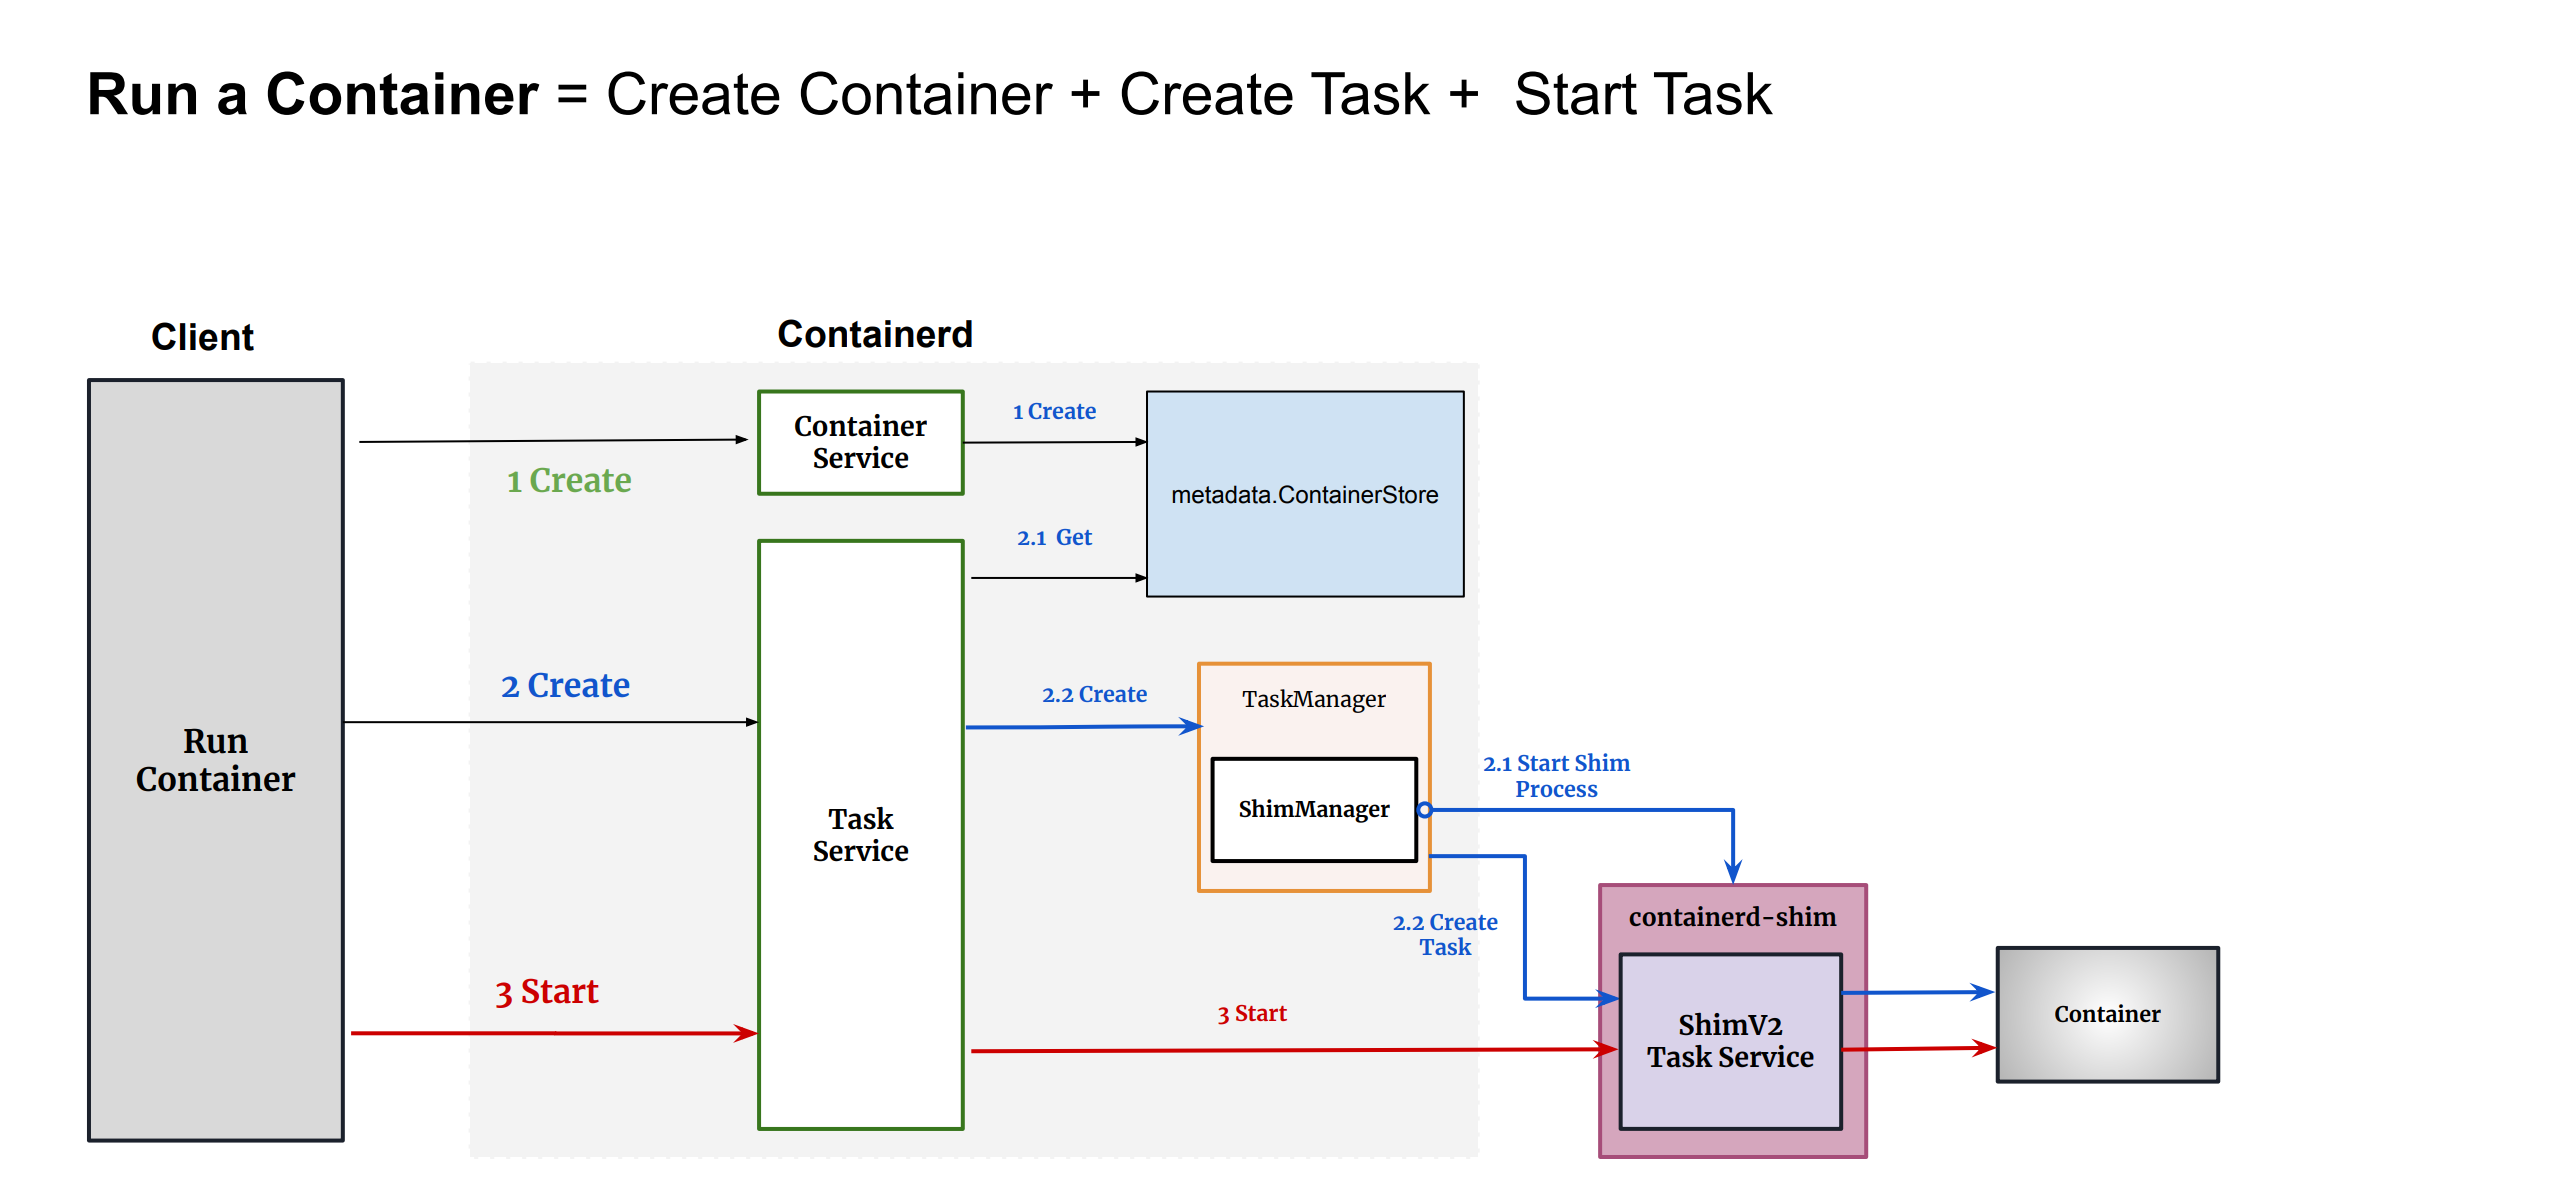
图:Container 与 Task 的创建和启动。来源:Cai Wei、Shaobao Feng,Build Container Runtime Based on Sandbox API of Containerd,KubeCon + CloudNativeCon China 2024,第 7 页。
CRI Plugin
CRI Plugin 实现了 Kubernetes 的容器运行时接口(CRI)。containerd 与 Kubelet 运行在同一个节点上,内置的 CRI Plugin 处理来自 Kubelet 的所有 CRI 服务请求,并调用 containerd 的内部功能管理容器和镜像。
CRI Plugin 使用 containerd 管理容器的完整生命周期和镜像,并通过 CNI 管理 Pod 网络。下图展示了这些组件之间的关系。
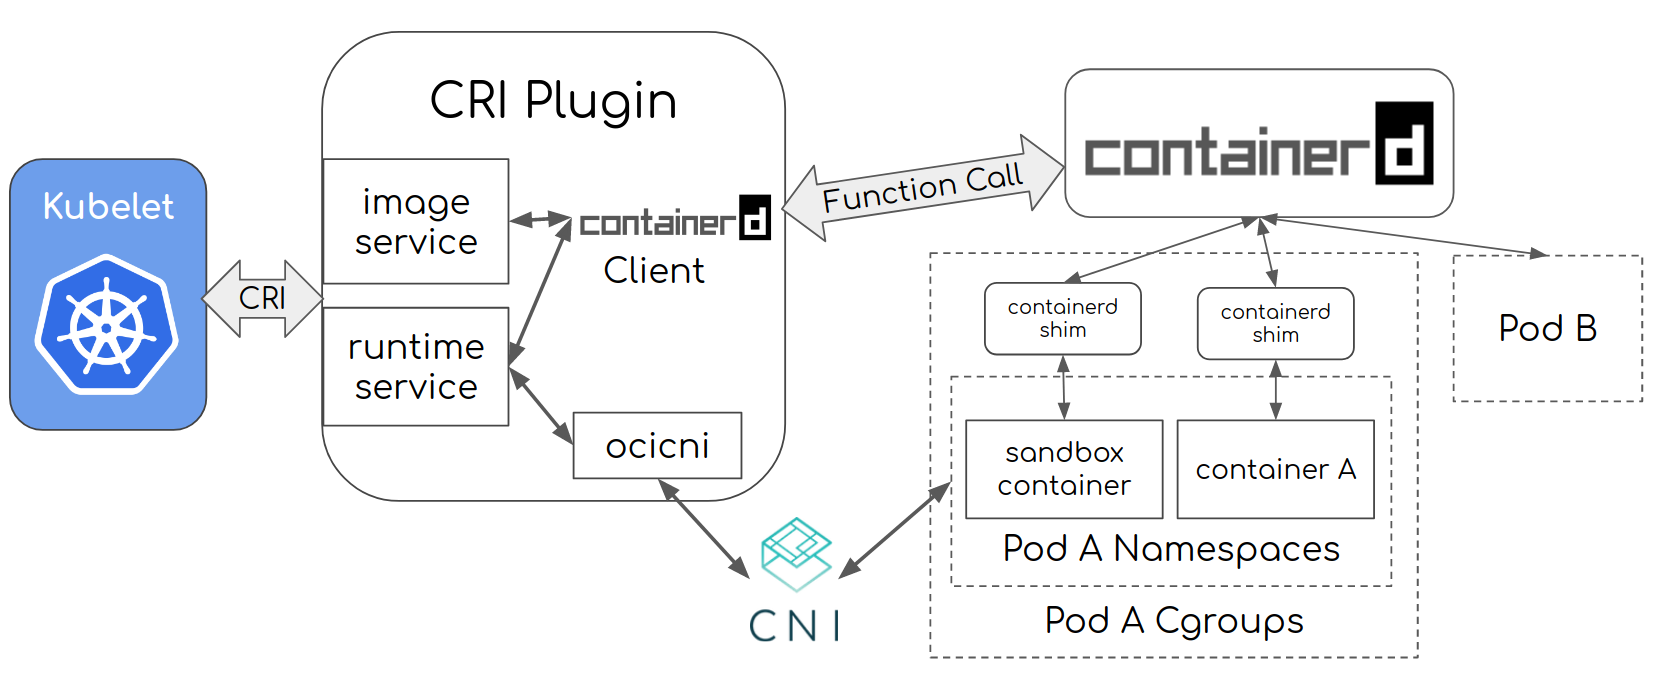
以 Kubelet 创建一个只包含单个应用容器的 Pod 为例,CRI Plugin 的处理过程如下:
- Kubelet 通过 CRI RuntimeService API 调用 CRI Plugin,请求创建 Pod 的运行环境。
- CRI Plugin 创建 Pod 的网络命名空间,并使用 CNI 配置网络。
- CRI Plugin 调用 containerd 的内部功能,创建并启动一个特殊的 pause 容器(Sandbox Container),将它放入 Pod 的 cgroup 和命名空间中。
- Kubelet 通过 CRI ImageService API 调用 CRI Plugin,请求拉取应用容器的镜像。
- 如果节点上没有该镜像,CRI Plugin 使用 containerd 拉取镜像。
- Kubelet 通过 CRI RuntimeService API 调用 CRI Plugin,请求使用已拉取的镜像在 Pod 内创建并启动应用容器。
- CRI Plugin 调用 containerd 的内部功能创建应用容器,将它放入 Pod 的 cgroup 和命名空间中,然后启动容器。
完成这些操作后,Pod 的运行环境已经建立,应用容器开始运行。
Runtime v2 与 Shim
Runtime v2 为低级容器运行时提供接入 containerd 的 Shim API,接口主要处理容器的执行生命周期。containerd 管理镜像内容、文件系统和容器配置,再通过这组接口请求运行时创建、启动和停止容器。
containerd 通过 Shim 接入具体的运行时。以 runc 为例,containerd-shim-runc-v2 负责接收 containerd 的请求,再调用运行时引擎 runc 完成容器的创建、启动和停止。
下图展示了 containerd、Shim 与容器之间的关系:
- 请求与事件:containerd 通过 Socket 向 Shim 的 Task Service 发送创建、启动和停止等请求。Shim 将容器状态变化等事件转发给 containerd 的 Event Service,对应图中反向的事件箭头。右侧列出了 Task Service 的接口。
- Shim 与容器:一个 Shim 可以管理多个容器。在 runc 路径中,
containerd-shim-runc-v2接收 Task 请求,再调用 runc 完成容器的创建、启动等操作。runc 完成创建后退出,但它创建的容器初始进程仍然存在。Linux 内核将这个失去父进程的容器初始进程交给作为 Subreaper 的 Shim,使 Shim 成为它的新父进程。Shim 继续维护容器进程的输入输出和退出状态,并在容器进程退出后回收。 - 不同运行时接入:
containerd-shim-runc-v2、containerd-shim-wasmtime-v1和containerd-shim-kata-v2分别用于将 runc、Wasmtime 和 Kata 接入 containerd。containerd 通过 Task API 发送容器操作请求,由对应的 Shim 和运行时完成执行。
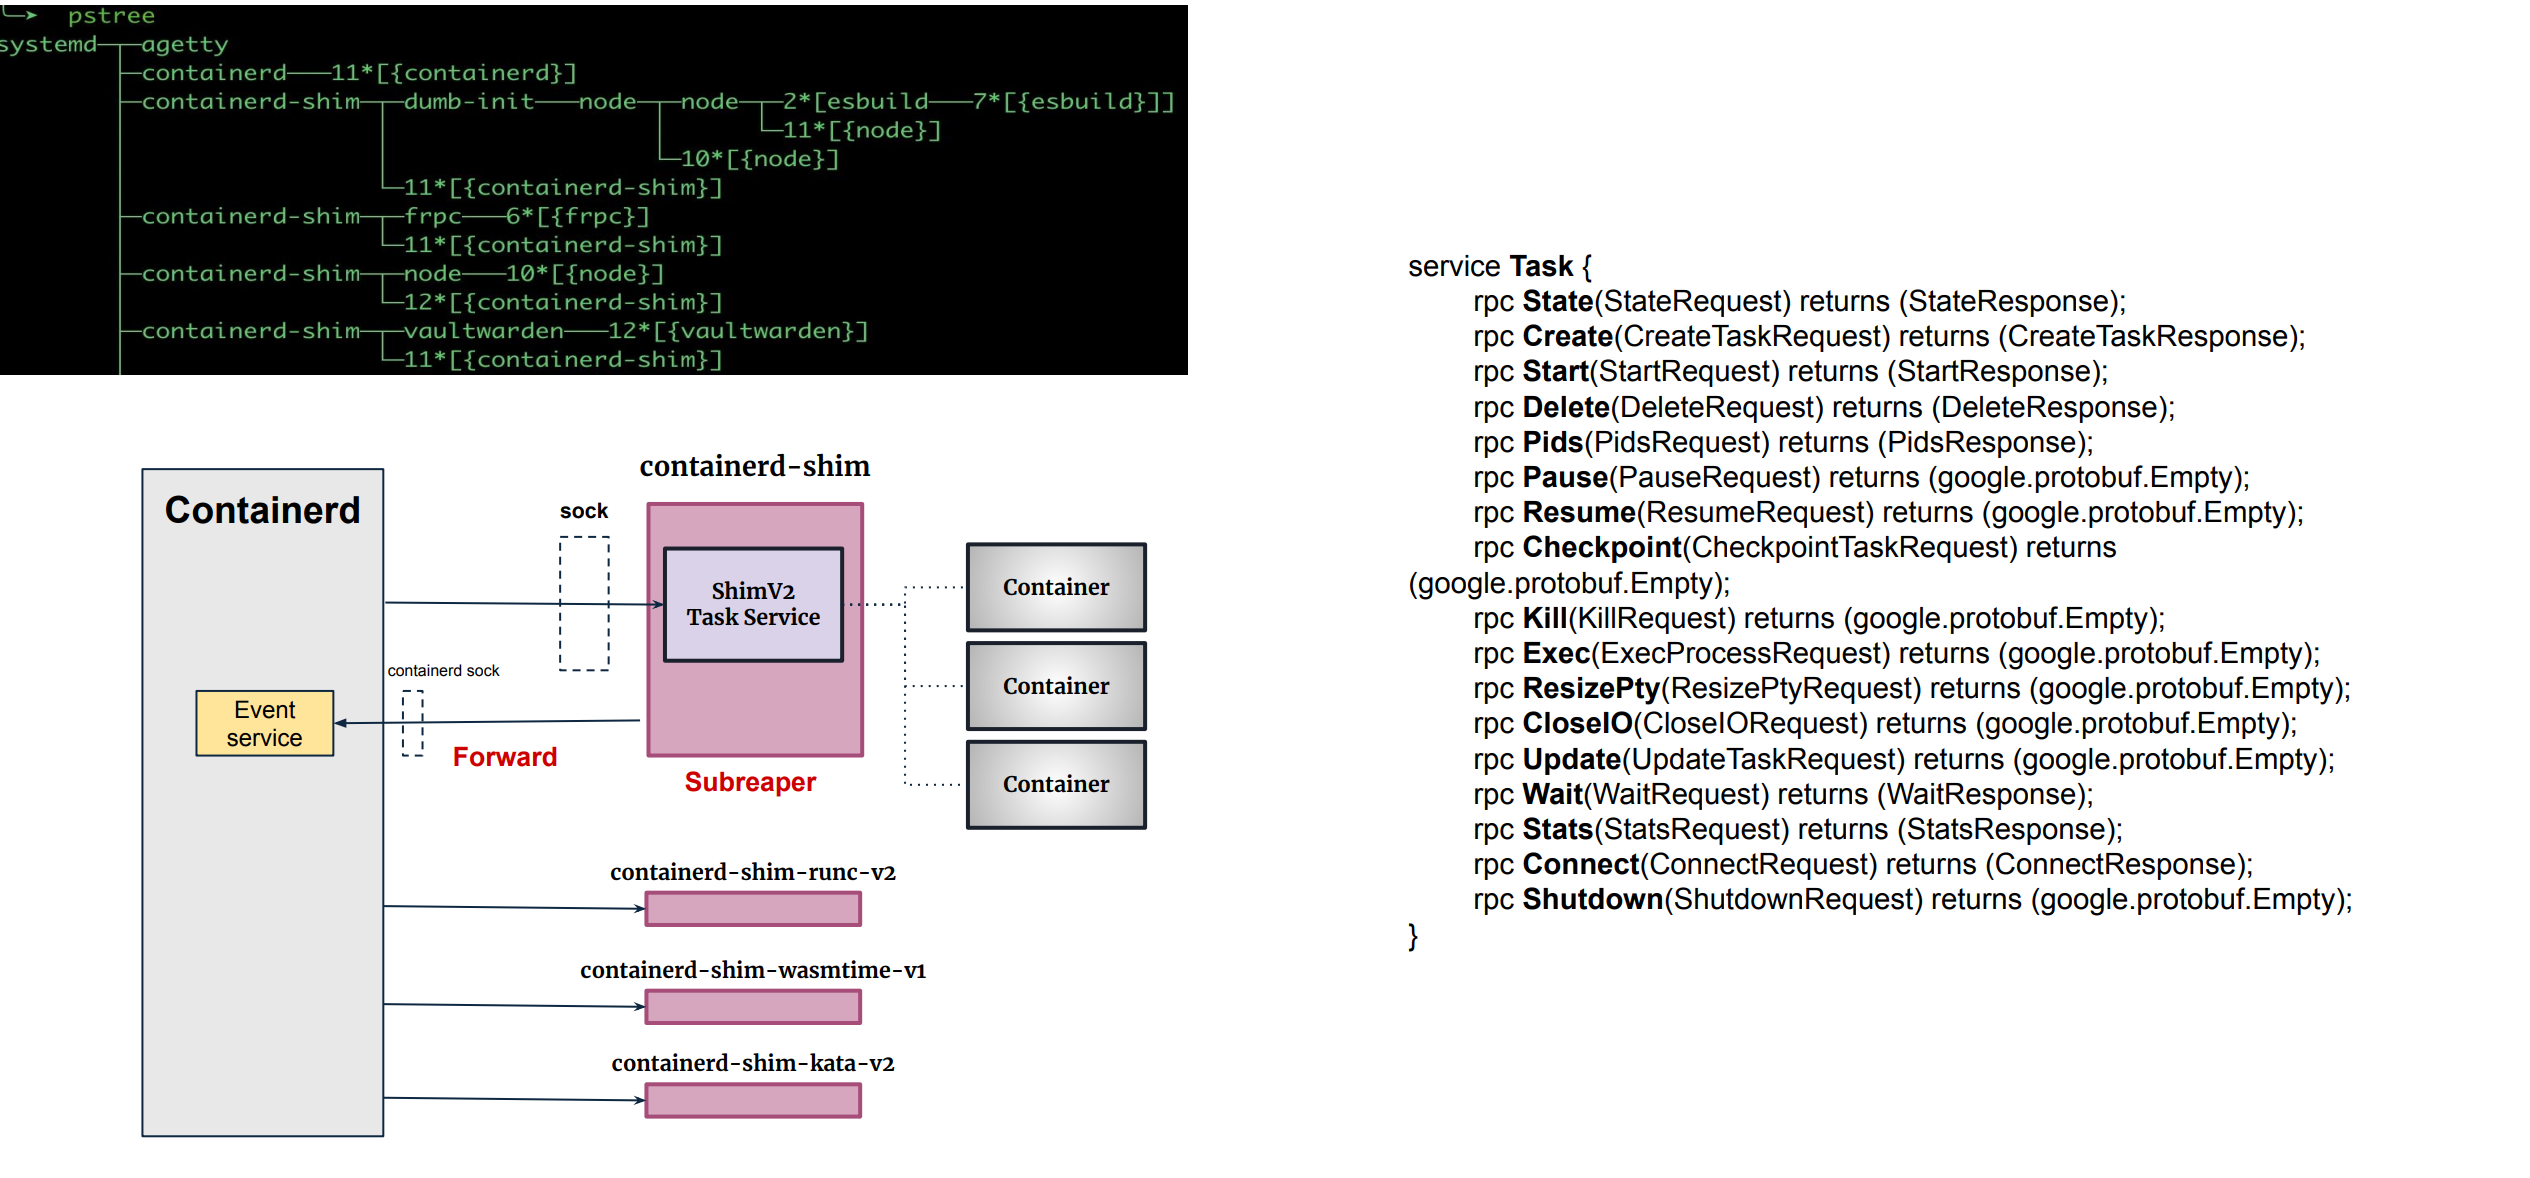
图:Task & Shim。来源:Cai Wei、Shaobao Feng,Build Container Runtime Based on Sandbox API of Containerd,KubeCon + CloudNativeCon China 2024,第 8 页。
Sandbox API
在引入 Sandbox API 之前,containerd 尚未为容器组的共享运行环境提供独立的管理接口。pause 容器的生命周期和 Sandbox 元数据都由 CRI Plugin 管理,这种实现存在以下限制:
- 实现依赖 pause 容器:Pod Sandbox 的管理流程以 pause 容器为基础。对于需要自行管理虚拟机监控器(VMM)的运行时,缺少统一的 Sandbox 接入接口。
- 缺少生命周期扩展点:Sandbox 的创建、启动、停止和清理逻辑位于 CRI Plugin 内部,运行时开发者难以通过独立接口定制这些行为。
- 生命周期以 Task 为中心:原有接口围绕 Task 的创建和销毁组织运行时操作,而 Sandbox 需要在内部容器不断创建、退出时保持运行。管理共享环境的 Shim 因此需要独立的生命周期控制。
Sandbox API 将一组容器共享的运行环境定义为 Sandbox,并在 Runtime v2 Shim 架构上提供专门的生命周期管理接口。其设计目标是:
- 统一容器组管理:通过统一的 Controller 接口 管理共享运行环境,使 microVM 等不同实现能够通过同一接口接入。Shim 侧的 RPC 定义见 SandboxService。
- 将具体实现与 CRI Plugin 解耦:让运行时开发者通过实现接口提供自己的 Sandbox,而无需为每种实现修改 containerd 或 CRI Plugin。pause 容器成为一种 Sandbox 实现,而不是固定的实现前提。
组件与接口
以下三个接口用于管理 Sandbox 的生命周期:
- Sandbox Controller Service:containerd 提供给进程外客户端的 gRPC 接口。SDK 客户端或
ctr sandboxes run等命令通过它发送 Sandbox 管理请求,containerd 再将请求交给选定的 Sandbox Controller。独立于 containerd 进程运行的 Sandbox 管理程序(外部 sandboxer)也可以提供这一服务,由 containerd 内部的 proxy plugin 通过 gRPC 调用。 - Sandbox Controller:定义 Sandbox 的创建、启动、停止和清理等操作,由
podsandbox、shim等 Controller 负责具体实现。CRI Plugin 直接调用选定的 Sandbox Controller 管理 Sandbox,无需经过面向进程外客户端的 Sandbox Controller Service。 - Runtime Sandbox Service:运行时通过 Shim 提供的 Sandbox 管理服务。containerd 的
shimController 调用它,完成 Sandbox 的创建、启动、停止和清理。
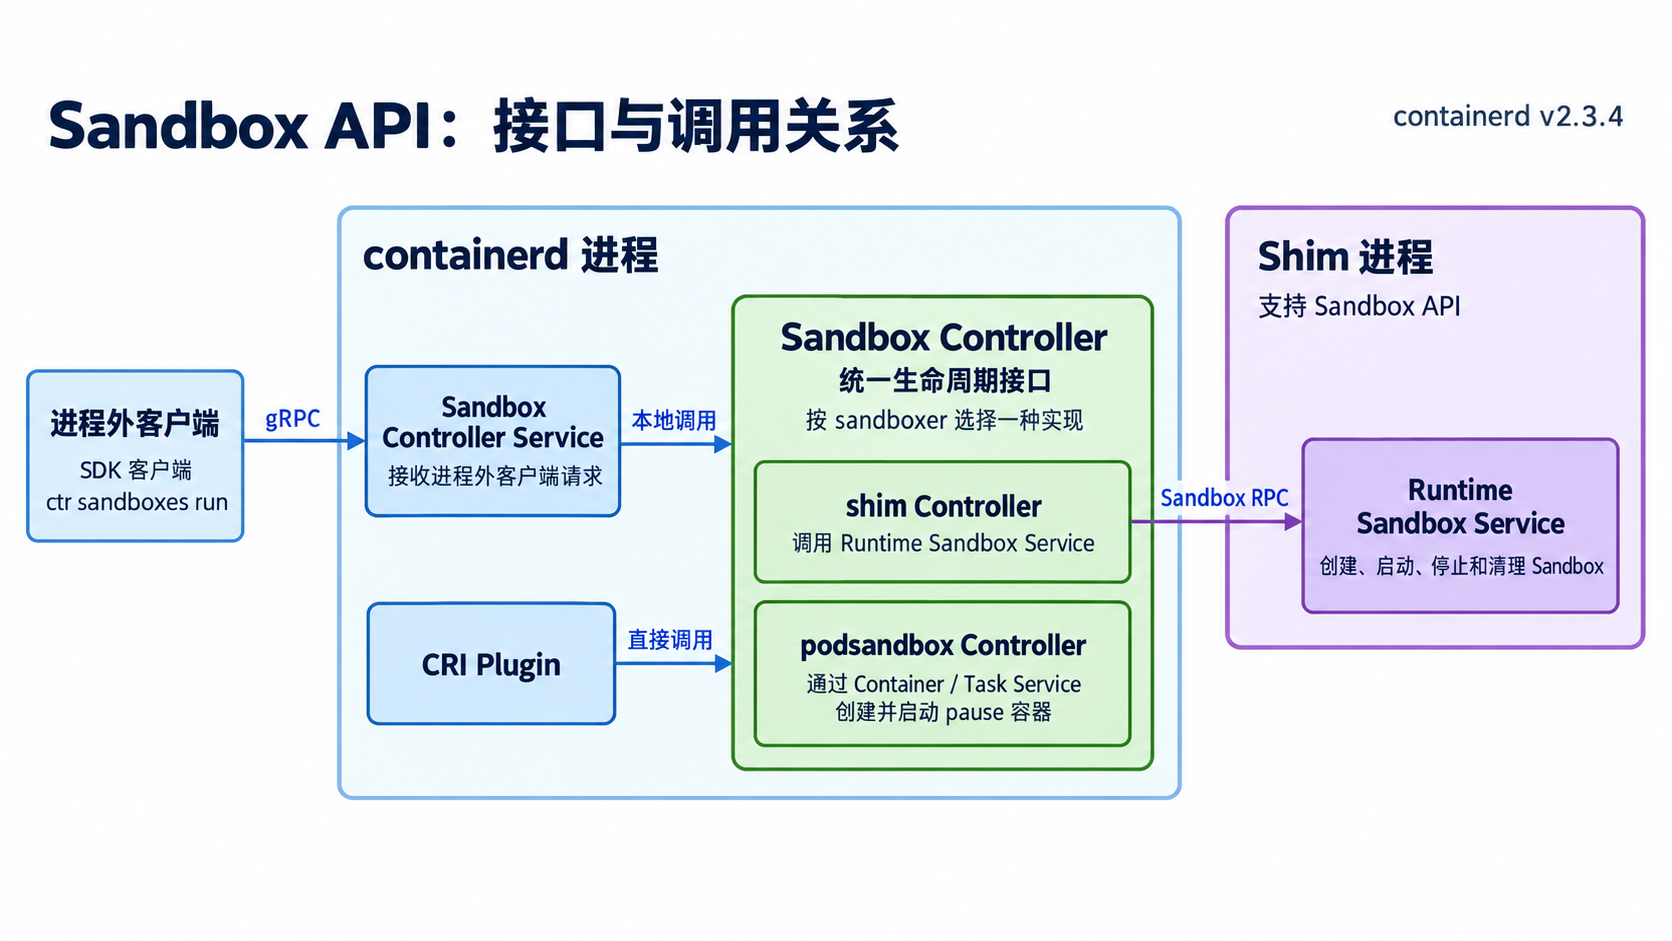
图:Sandbox API 的接口与调用关系。根据 containerd v2.3.4 Sandbox API 及上述源码绘制。
Sandbox Controller 实现
containerd v2.3.4 提供 podsandbox 和 shim 两种内置的 Sandbox Controller 实现。两种实现都会使用 Shim。下图分别展示了它们创建和启动 Sandbox 的执行路径。
-
podsandbox:沿用 Sandbox API 引入前的 pause 容器方案,通过 Task Service 创建和启动 pause 容器,维持 Pod 的共享运行环境。 当前实现位于 CRI Plugin 内部,也实现了 Sandbox Controller 接口。具体流程为:
Create:初始化并保存控制器内部的 Sandbox 状态。-
Start:准备并启动 pause 容器,依次完成以下操作:- 创建 pause 容器的 Container 记录:Controller 调用
NewContainer,通过 Container Service 保存 pause 容器的运行配置、Snapshot 引用和运行时选择。 - 创建 pause 容器的 Task:Controller 调用
NewTask。Task Service 经由TaskManager.Create建立 Shim 连接,再向 Shim 的 Task Service 发送创建请求,准备 pause 容器的初始进程。 - 启动 pause 进程:Controller 调用
task.Start,请求经 Task Service 传到 Shim,启动 pause 进程。后续业务容器根据 Pod 配置加入这些共享 Namespace。
- 创建 pause 容器的 Container 记录:Controller 调用
-
shim:采用 Sandbox API 的原生管理方式,通过专门的 Runtime Sandbox Service 直接管理 Sandbox 的生命周期。 Controller 调用支持 Sandbox RPC 的 Shim 完成具体操作,共享运行环境可以由运行时实现为轻量虚拟机等形式:
-
Create:准备 Sandbox 并建立与 Shim 的连接,依次完成以下操作:- 准备 Bundle:Controller 调用
NewBundle,按 Sandbox ID 创建 Bundle 目录。 - 启动 Shim:Controller 通过 ShimManager 启动 Sandbox 对应的 Shim,建立后续 RPC 调用所需的连接。
- 创建 Sandbox:Controller 向 Shim 的 Sandbox Service 发送
CreateSandbox请求,传入 Sandbox ID、Bundle 路径和网络 Namespace 路径等信息,由 Shim 准备共享运行环境。
- 准备 Bundle:Controller 调用
-
Start:向 Shim 的 Sandbox Service 发送StartSandbox请求,启动已经创建的 Sandbox,并取得 PID 和连接地址等信息。
同一个 Shim 通过 Sandbox Service 管理 Sandbox,通过 Task Service 管理其中的容器进程。创建业务容器的 Task 时,containerd 复用该 Sandbox 的 Shim 连接。
-
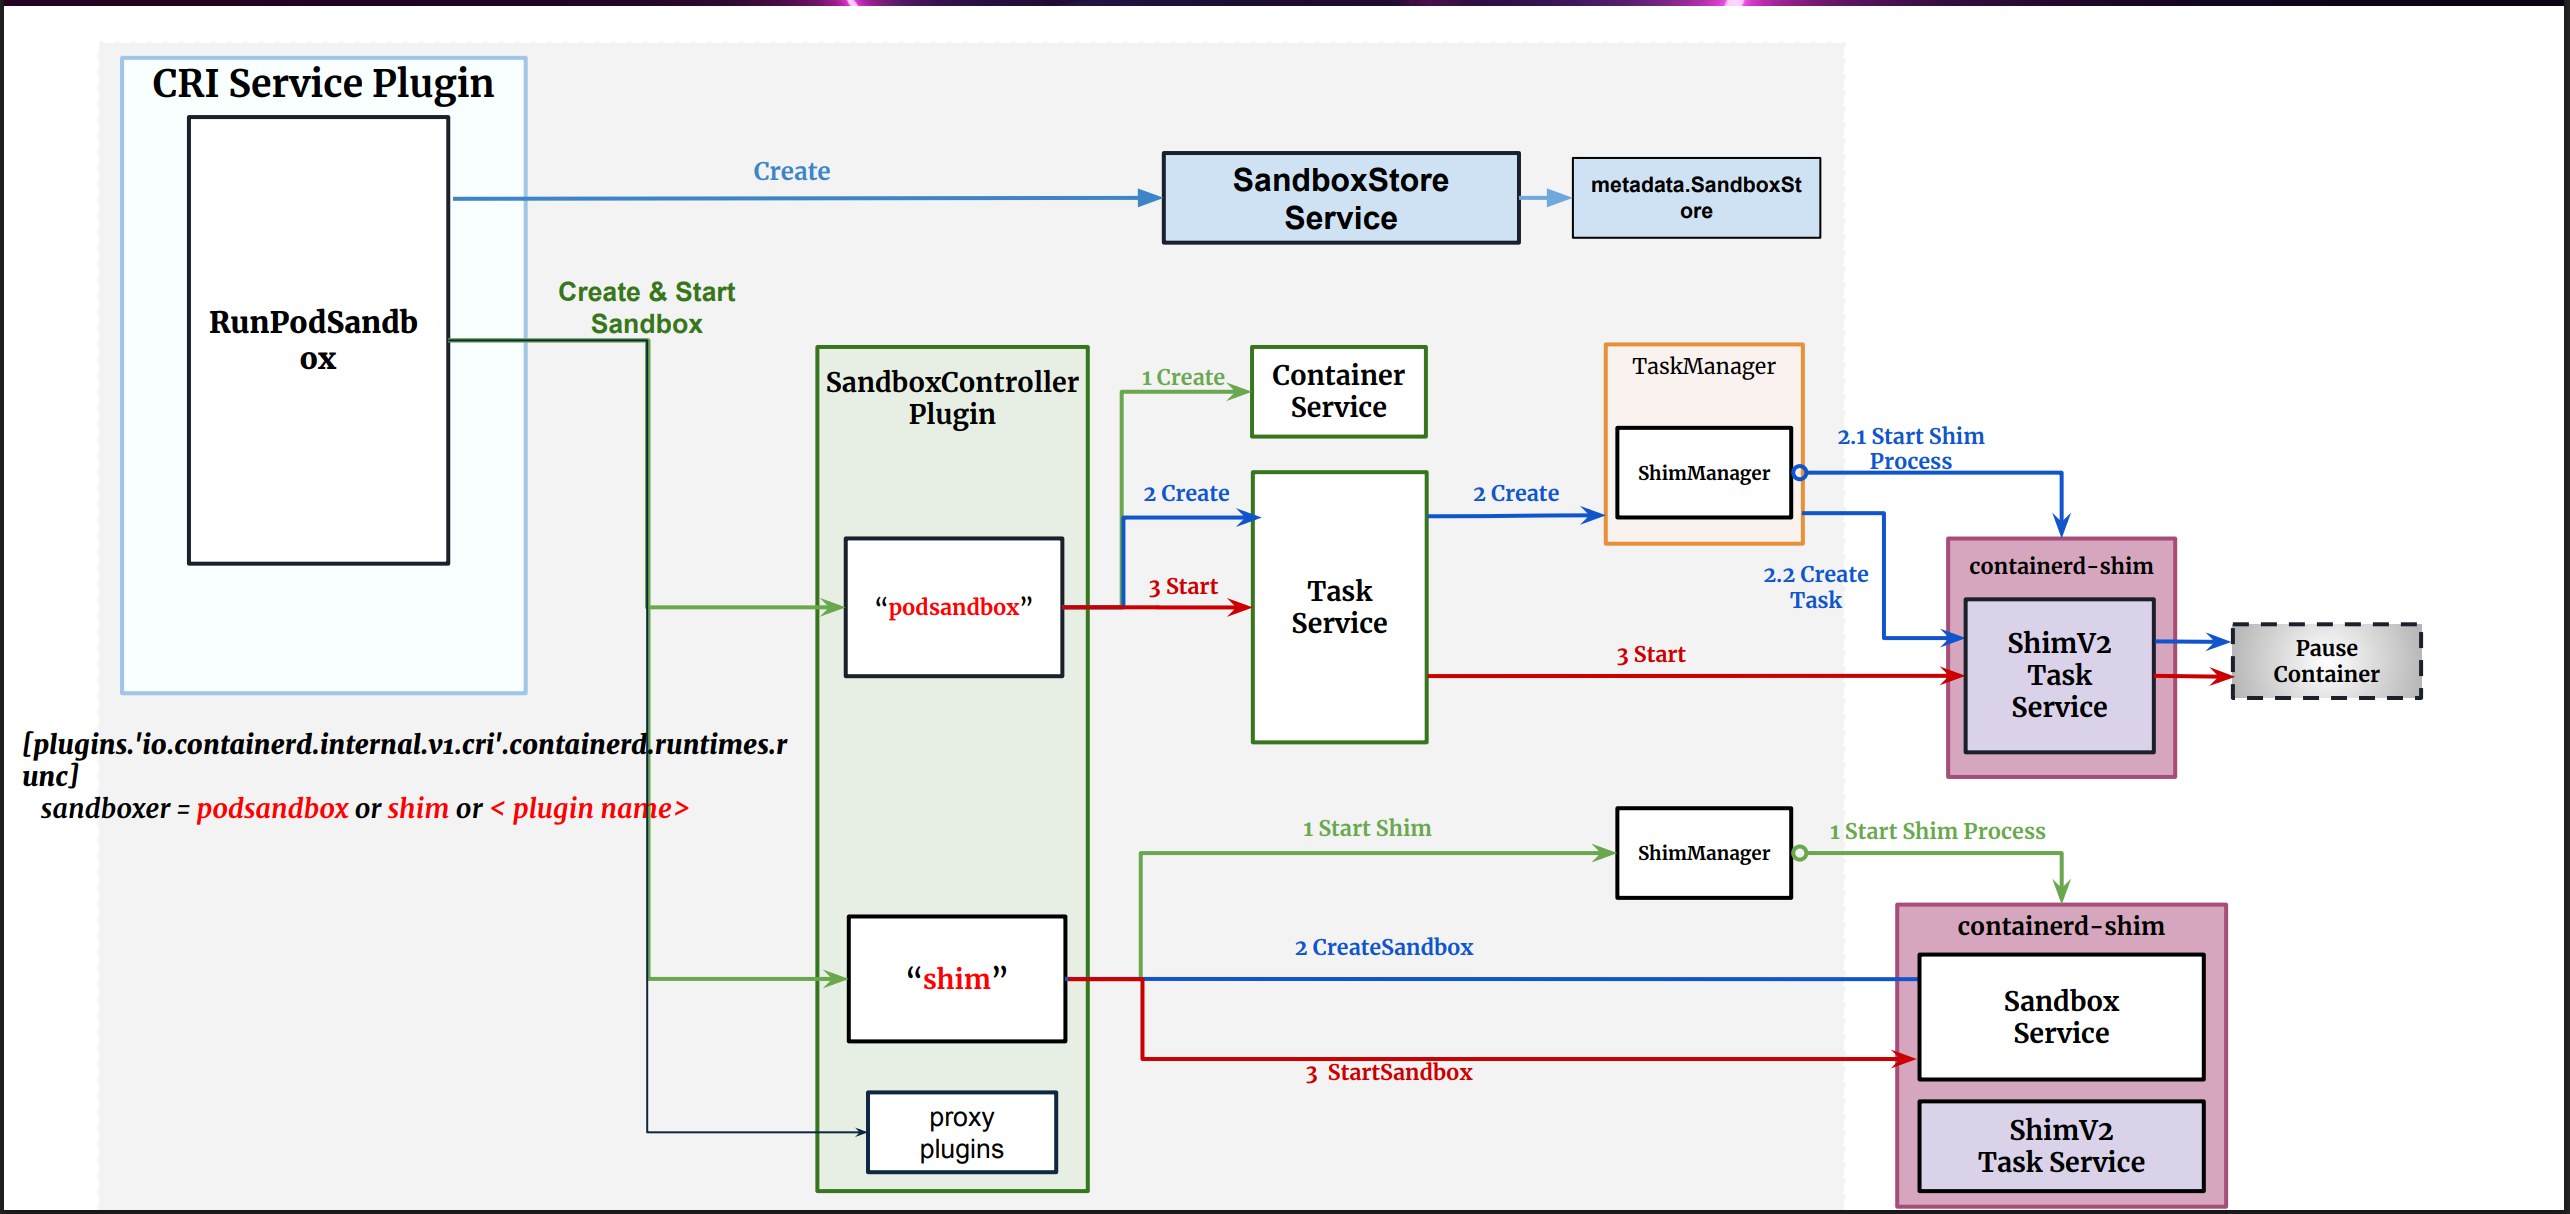
图:Sandbox API 与 Shim 的两条执行路径。来源:Cai Wei、Shaobao Feng,Build Container Runtime Based on Sandbox API of Containerd,KubeCon + CloudNativeCon China 2024,第 13 页。
命令行工具
ctr
ctr 是随 containerd 一起发布的命令行调试工具,直接调用 containerd API。它可以查询 Plugin、Namespace、Image、Content、Snapshot、Container 和 Task 等信息,并执行镜像拉取、容器运行等操作。
ctr 默认使用 default Namespace。Kubernetes 对象通常位于 k8s.io,查询时需要显式指定:
# 查看 containerd 的插件及其状态
ctr plugins list

# 查看 containerd 中的 Namespace
ctr namespaces list

# 查看 k8s.io Namespace 中的镜像
ctr --namespace k8s.io images list

# 查看 k8s.io Namespace 中的 Container 记录
ctr --namespace k8s.io containers list

# 查看 k8s.io Namespace 中的 Task 及其状态
ctr --namespace k8s.io tasks list
下面的命令在独立的 ctr-demo Namespace 中运行 Alpine,并清理示例资源。删除镜像时使用 --sync 等待关联资源回收,再删除 Namespace:
# 创建示例使用的 Namespace
ctr namespaces create ctr-demo

# 拉取并解包 Alpine 镜像
ctr --namespace ctr-demo images pull docker.io/library/alpine:3.22

# 在 Alpine 容器中执行 uname -a,退出后删除 Container 和 Task
ctr --namespace ctr-demo run --rm \
  docker.io/library/alpine:3.22 \
  alpine-demo \
  uname -a

# 删除示例镜像,并等待不再使用的关联资源回收
ctr --namespace ctr-demo images remove --sync docker.io/library/alpine:3.22

# 删除示例 Namespace
ctr namespaces remove ctr-demo
nerdctl
nerdctl 是面向 containerd、兼容 Docker CLI 的命令行工具,可用于管理容器、镜像、网络和数据卷。它支持 Docker Compose、Rootless Mode,并通过 BuildKit 构建镜像。
安装步骤及网络、数据卷的使用方式见 nerdctl 示例。
下面在 nerdctl-demo Namespace 中创建网络和数据卷,再运行 Alpine 容器,将数据卷挂载到容器的 /data 目录。示例使用 bridge 网络,需要节点已安装 CNI Plugins:
# 创建示例使用的 Namespace
nerdctl namespace create nerdctl-demo

# 创建名为 demo-net 的 bridge 网络
nerdctl --namespace nerdctl-demo network create --driver bridge demo-net

# 查看 demo-net 的网络配置
nerdctl --namespace nerdctl-demo network inspect demo-net

# 创建名为 demo-data 的数据卷
nerdctl --namespace nerdctl-demo volume create demo-data

# 查看 demo-data 的存储路径等信息
nerdctl --namespace nerdctl-demo volume inspect demo-data

# 连接 demo-net 并挂载 demo-data,执行 uname -a 后自动删除容器
nerdctl --namespace nerdctl-demo run --rm \
  --name alpine-demo \
  --network demo-net \
  --volume demo-data:/data \
  alpine:3.22 uname -a

# 查看 nerdctl-demo Namespace 中的镜像
nerdctl --namespace nerdctl-demo images

# 查看 nerdctl-demo Namespace 中的所有容器,包括已停止的容器
nerdctl --namespace nerdctl-demo ps --all

# 删除示例网络
nerdctl --namespace nerdctl-demo network rm demo-net

# 删除示例数据卷,命名数据卷不会随 --rm 自动删除
nerdctl --namespace nerdctl-demo volume rm demo-data
查看当前节点上 Kubernetes 使用的容器和镜像时,指定 k8s.io Namespace:
# 查看 Kubernetes 使用的所有容器,包括已停止的容器
nerdctl --namespace k8s.io ps --all

# 查看 Kubernetes 使用的本地镜像
nerdctl --namespace k8s.io images
SDK
containerd 提供 Go Client SDK,便于在自己的项目中调用 containerd。
示例通过 Client SDK 拉取并运行 Redis Server,需要在已运行 containerd 的 Linux 环境中执行。Go 版本要求见 containerd v2.3.4 的 go.mod。
连接 containerd
创建 main.go,导入 containerd Client 包,并连接默认的 containerd Socket:
package main

import (
    "log"

    containerd "github.com/containerd/containerd/v2/client"
)

func main() {
    if err := redisExample(); err != nil {
        log.Fatal(err)
    }
}

func redisExample() error {
    client, err := containerd.New("/run/containerd/containerd.sock")
    if err != nil {
        return err
    }
    defer client.Close()
    return nil
}
containerd.New 创建连接到 /run/containerd/containerd.sock 的 Client。Client 通过 gRPC 与 containerd daemon 通信,调用方法时需要传入 context。containerd 使用 Namespace 区分 API 调用方管理的资源,这里通过 namespaces.WithNamespace 设置 example Namespace:
使用独立的 Namespace,可以避免示例中的容器、镜像等资源与同一个 daemon 的其他使用者发生命名冲突。
拉取 Redis 镜像
使用 Client 从 Docker Hub 拉取基于 Alpine Linux 的 Redis 镜像:
    image, err := client.Pull(ctx, "docker.io/library/redis:alpine", containerd.WithPullUnpack)
    if err != nil {
        return err
    }
containerd Client 的许多方法通过 Opts 参数配置行为。containerd.WithPullUnpack 使镜像内容下载到 Content Store 后继续解包,通过 Snapshotter 准备后续容器使用的根文件系统。
下面的代码完成镜像拉取,并在终端打印镜像名称:
package main

import (
        "context"
        "log"

        containerd "github.com/containerd/containerd/v2/client"
        "github.com/containerd/containerd/v2/pkg/namespaces"
)

func main() {
        if err := redisExample(); err != nil {
                log.Fatal(err)
        }
}

func redisExample() error {
        client, err := containerd.New("/run/containerd/containerd.sock")
        if err != nil {
                return err
        }
        defer client.Close()

        ctx := namespaces.WithNamespace(context.Background(), "example")
        image, err := client.Pull(ctx, "docker.io/library/redis:alpine", containerd.WithPullUnpack)
        if err != nil {
                return err
        }
        log.Printf("Successfully pulled %s image\n", image.Name())

        return nil
}
编译和运行命令,以及官方文档中的输出示例:
> go build main.go
> sudo ./main

2017/08/13 17:43:21 Successfully pulled docker.io/library/redis:alpine image
创建 OCI Spec 与 Container
取得镜像后,需要为容器生成 OCI 运行配置,并创建 Container。containerd 提供默认的 OCI Spec,也支持通过选项将镜像中的配置应用到 Spec。
下面的代码为容器分配一个可写 Snapshot,并根据镜像配置生成 OCI Spec:
    container, err := client.NewContainer(
        ctx,
        "redis-server",
        containerd.WithNewSnapshot("redis-server-snapshot", image),
        containerd.WithNewSpec(oci.WithImageConfig(image)),
    )
    if err != nil {
        return err
    }
    defer container.Delete(ctx, containerd.WithSnapshotCleanup)
如果已经有 OCI Spec,可以使用 containerd.WithSpec 将它设置到 Container 上。
创建 Snapshot 时需要提供 Snapshot ID 和作为基础的 Image。Snapshot ID 与 Container ID 分开指定,便于在不同 Container 之间复用已有的 Snapshot。containerd.WithSnapshotCleanup 则在删除 Container 时一并清理它使用的 Snapshot。
下面的代码拉取 Redis 镜像、生成 OCI Spec、创建 Container,并在函数退出时删除 Container 和 Snapshot:
package main

import (
        "context"
        "log"

        containerd "github.com/containerd/containerd/v2/client"
        "github.com/containerd/containerd/v2/pkg/namespaces"
        "github.com/containerd/containerd/v2/pkg/oci"
)

func main() {
        if err := redisExample(); err != nil {
                log.Fatal(err)
        }
}

func redisExample() error {
        client, err := containerd.New("/run/containerd/containerd.sock")
        if err != nil {
                return err
        }
        defer client.Close()

        ctx := namespaces.WithNamespace(context.Background(), "example")
        image, err := client.Pull(ctx, "docker.io/library/redis:alpine", containerd.WithPullUnpack)
        if err != nil {
                return err
        }
        log.Printf("Successfully pulled %s image\n", image.Name())

        container, err := client.NewContainer(
                ctx,
                "redis-server",
                containerd.WithNewSnapshot("redis-server-snapshot", image),
                containerd.WithNewSpec(oci.WithImageConfig(image)),
        )
        if err != nil {
                return err
        }
        defer container.Delete(ctx, containerd.WithSnapshotCleanup)
        log.Printf("Successfully created container with ID %s and snapshot with ID redis-server-snapshot", container.ID())

        return nil
}
编译和运行命令,以及官方文档中的输出示例:
> go build main.go
> sudo ./main

2017/08/13 18:01:35 Successfully pulled docker.io/library/redis:alpine image
2017/08/13 18:01:35 Successfully created container with ID redis-server and snapshot with ID redis-server-snapshot
创建 Task
Container 是保存配置并关联资源的元数据对象,Task 对应实际的进程执行实例。每次运行结束后应删除 Task,Container 则可以继续保留、更新和查询。
通过 container.NewTask 创建 Task:
    task, err := container.NewTask(ctx, cio.NewCreator(cio.WithStdio))
    if err != nil {
        return err
    }
    defer task.Delete(ctx)
cio.WithStdio 将容器的标准输入、输出和错误连接到示例程序,使 Redis 日志能够显示在当前终端。
此时 Task 处于 OCI 生命周期的 created 状态。命名空间、根文件系统和容器级配置已经初始化,但用户指定的 redis-server 尚未启动。调用方可以在此时设置网络接口或连接监控工具,containerd 也会准备退出状态和 cgroup 指标的监控。
将 containerd 的 Metrics 监听地址配置为 127.0.0.1:1338 后,可以按原文使用以下命令查看容器指标。Metrics 服务源码注册了 /v1/metrics 路径;监听地址为空时,该服务不会启动:
等待与启动 Task
在启动 Task 之前调用 task.Wait,先建立退出通知,再调用 task.Start。这样可以避免执行 /bin/true 等立即退出的程序时,因等待建立得太晚而出现竞态:
    exitStatusC, err := task.Wait(ctx)
    if err != nil {
        return err
    }

    if err := task.Start(ctx); err != nil {
        return err
    }
Task 启动后,终端中会显示 redis-server 的日志。
终止 Task
Redis Server 会持续运行。示例等待 3 秒,让终端显示日志,然后通过 task.Kill 发送 SIGTERM,等待进程退出并获取退出状态:
    time.Sleep(3 * time.Second)

    if err := task.Kill(ctx, syscall.SIGTERM); err != nil {
        return err
    }

    status := <-exitStatusC
    code, exitedAt, err := status.Result()
    if err != nil {
        return err
    }
    fmt.Printf("redis-server exited with status: %d\n", code)
从退出通知通道读取状态,可以确认 Task 已经结束并取得退出码。如果重新加载了 Container,或之前没有等待 Task 退出,task.Delete 也会返回退出状态:
完整示例
完整代码将上述操作组合起来,保留官方示例的镜像名、Namespace、Container ID、Snapshot ID 和注释。它使用退出码并忽略退出时间,可作为完整程序编译:
package main

import (
    "context"
    "fmt"
    "log"
    "syscall"
    "time"

    "github.com/containerd/containerd/v2/pkg/cio"
    containerd "github.com/containerd/containerd/v2/client"
    "github.com/containerd/containerd/v2/pkg/oci"
    "github.com/containerd/containerd/v2/pkg/namespaces"
)

func main() {
    if err := redisExample(); err != nil {
        log.Fatal(err)
    }
}

func redisExample() error {
    // create a new client connected to the default socket path for containerd
    client, err := containerd.New("/run/containerd/containerd.sock")
    if err != nil {
        return err
    }
    defer client.Close()

    // create a new context with an "example" namespace
    ctx := namespaces.WithNamespace(context.Background(), "example")

    // pull the redis image from DockerHub
    image, err := client.Pull(ctx, "docker.io/library/redis:alpine", containerd.WithPullUnpack)
    if err != nil {
        return err
    }

    // create a container
    container, err := client.NewContainer(
        ctx,
        "redis-server",
        containerd.WithImage(image),
        containerd.WithNewSnapshot("redis-server-snapshot", image),
        containerd.WithNewSpec(oci.WithImageConfig(image)),
    )
    if err != nil {
        return err
    }
    defer container.Delete(ctx, containerd.WithSnapshotCleanup)

    // create a task from the container
    task, err := container.NewTask(ctx, cio.NewCreator(cio.WithStdio))
    if err != nil {
        return err
    }
    defer task.Delete(ctx)

    // make sure we wait before calling start
    exitStatusC, err := task.Wait(ctx)
    if err != nil {
        return err
    }

    // call start on the task to execute the redis server
    if err := task.Start(ctx); err != nil {
        return err
    }

    // sleep for a lil bit to see the logs
    time.Sleep(3 * time.Second)

    // kill the process and get the exit status
    if err := task.Kill(ctx, syscall.SIGTERM); err != nil {
        return err
    }

    // wait for the process to fully exit and print out the exit status

    status := <-exitStatusC
    code, _, err := status.Result()
    if err != nil {
        return err
    }
    fmt.Printf("redis-server exited with status: %d\n", code)

    return nil
}
在示例目录中安装依赖后,按官方命令编译和运行。下面的日志是官方文档保留的 Redis 4.0.1 输出示例,实际输出取决于拉取到的 redis:alpine 镜像版本和运行环境:
> go build main.go
> sudo ./main

1:C 04 Aug 20:41:37.682 # oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo
1:C 04 Aug 20:41:37.682 # Redis version=4.0.1, bits=64, commit=00000000, modified=0, pid=1, just started
1:C 04 Aug 20:41:37.682 # Warning: no config file specified, using the default config. In order to specify a config file use redis-server /path/to/redis.conf
1:M 04 Aug 20:41:37.682 # You requested maxclients of 10000 requiring at least 10032 max file descriptors.
1:M 04 Aug 20:41:37.682 # Server can't set maximum open files to 10032 because of OS error: Operation not permitted.
1:M 04 Aug 20:41:37.682 # Current maximum open files is 1024. maxclients has been reduced to 992 to compensate for low ulimit. If you need higher maxclients increase 'ulimit -n'.
1:M 04 Aug 20:41:37.683 * Running mode=standalone, port=6379.
1:M 04 Aug 20:41:37.683 # WARNING: The TCP backlog setting of 511 cannot be enforced because /proc/sys/net/core/somaxconn is set to the lower value of 128.
1:M 04 Aug 20:41:37.684 # Server initialized
1:M 04 Aug 20:41:37.684 # WARNING overcommit_memory is set to 0! Background save may fail under low memory condition. To fix this issue add 'vm.overcommit_memory = 1' to /etc/sysctl.conf and then reboot or run the command 'sysctl vm.overcommit_memory=1' for this to take effect.
1:M 04 Aug 20:41:37.684 # WARNING you have Transparent Huge Pages (THP) support enabled in your kernel. This will create latency and memory usage issues with Redis. To fix this issue run the command 'echo never > /sys/kernel/mm/transparent_hugepage/enabled' as root, and add it to your /etc/rc.local in order to retain the setting after a reboot. Redis must be restarted after THP is disabled.
1:M 04 Aug 20:41:37.684 * Ready to accept connections
1:signal-handler (1501879300) Received SIGTERM scheduling shutdown...
1:M 04 Aug 20:41:40.791 # User requested shutdown...
1:M 04 Aug 20:41:40.791 * Saving the final RDB snapshot before exiting.
1:M 04 Aug 20:41:40.794 * DB saved on disk
1:M 04 Aug 20:41:40.794 # Redis is now ready to exit, bye bye...
redis-server exited with status: 0
CRI-O
CRI-O 专门实现 Kubernetes CRI,接收 Kubelet 的 Runtime Service 和 Image Service 请求。它使用 containers/image library 拉取镜像,使用 containers/storage library 管理镜像层和容器 rootfs。在 runc、crun 等 OCI Runtime 的执行路径中,conmon 进程调用运行时创建容器,并持续监控容器进程。
根据 Compatibility matrix: CRI-O ⬄ Kubernetes,CRI-O 的次版本发布周期与 Kubernetes 保持一致,例如 Kubernetes 1.36 对应 CRI-O 1.36。两者的补丁版本不保持同步:Kubernetes 按月发布补丁版本,CRI-O 则仅在需要时发布。当某个 Kubernetes 版本停止维护(End of Life)时,对应的 CRI-O 版本也应视为停止维护。
组件架构
下图展示了 CRI-O 从 Kubelet 到 Image、Storage、CNI、conmon 和 OCI Runtime 的调用关系。
- CRI Server:默认监听 Unix Socket
/var/run/crio/crio.sock,提供 Runtime Service 和 Image Service,接收 Kubelet 的 Pod Sandbox、容器和镜像管理请求。 - containers/image:镜像操作 library,处理镜像仓库访问、认证和镜像验证策略,将远端镜像复制到本地存储。
- containers/storage:容器存储 library,管理镜像层、容器可写层及相关元数据,通过 OverlayFS 等存储驱动准备容器 rootfs。
- CNI:CRI-O 调用 CNI Plugins,为 Pod Sandbox 配置网络接口、IP 地址和路由。
- conmon:独立的容器监控进程,调用配置的 OCI Runtime 创建容器,维护容器的标准输入输出、写入日志,并记录退出时间和退出码。
- OCI Runtime:读取 OCI Bundle,按照运行配置创建容器进程及其隔离环境。CRI-O 1.36.4 在 Linux 上默认使用 crun,也可通过 Runtime Handler 选择 runc。Kata Containers 等 VM 后端使用独立的 VM 运行时路径接入。
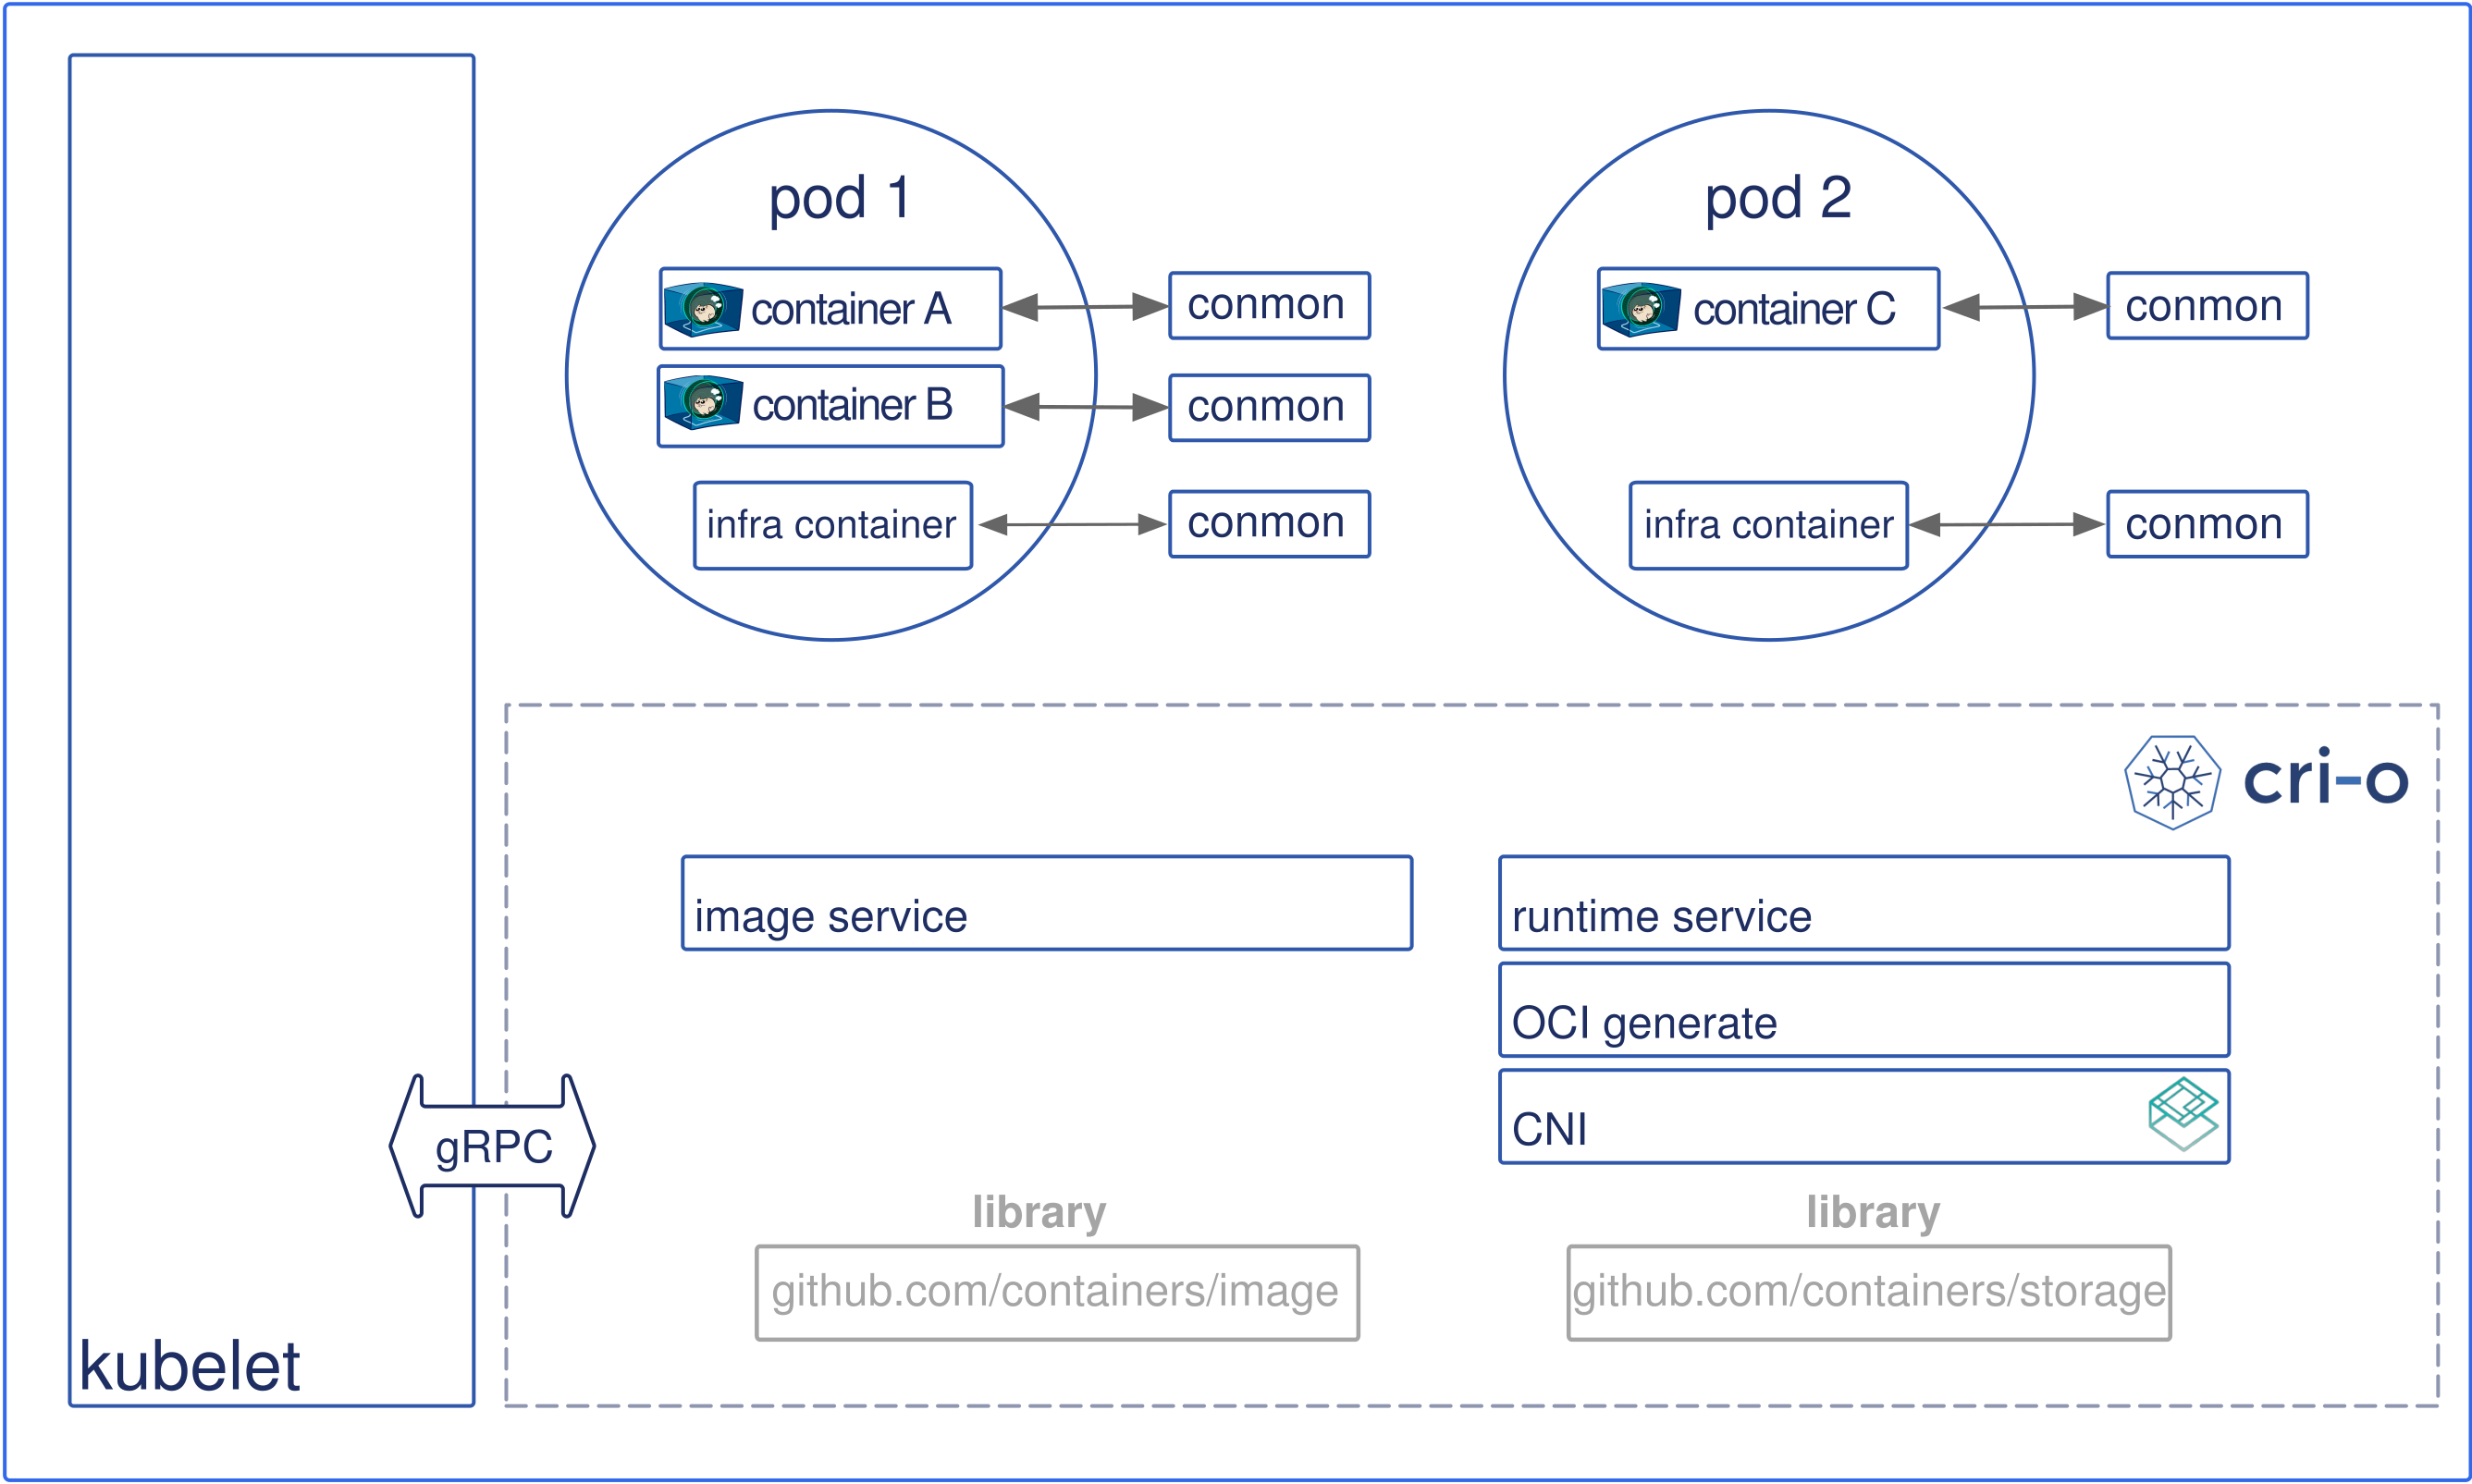
图:CRI-O 组件架构。来源:CRI-O Architecture。
镜像与存储
CRI-O 根据镜像名称和认证信息,从镜像仓库拉取镜像,并在本地保存镜像内容。创建容器时,再以镜像的文件系统层为基础准备容器可写层和 rootfs。这两个环节分别由以下 library 提供支持:
- 镜像拉取:containers/image 处理镜像仓库访问、认证、签名验证策略和镜像复制。CRI-O 收到拉取请求后,读取请求中的镜像名称和认证信息,完成拉取后返回镜像引用。对应入口是
Server.PullImage。 - 镜像层与容器可写层:containers/storage 管理镜像层、容器存储记录及相关元数据,并通过存储驱动准备 rootfs。每个容器拥有自己的可写层;例如,使用 OverlayFS 时,同一镜像创建的两个容器可以共享只读镜像层,各自在独立的可写层中保存修改。
容器创建与启动
CRI-O 根据 Kubelet 的创建请求准备容器的 rootfs 和 OCI 运行配置,再通过 conmon 调用 crun 或 runc 创建容器。收到启动请求后,CRI-O 调用运行时启动容器中的应用进程。
- 准备 rootfs 和运行配置:CRI-O 根据创建请求中的 Sandbox ID 找到所属 Pod Sandbox,沿用它的 Runtime Handler。随后创建容器存储记录和可写层、挂载 rootfs,并将启动命令、挂载和资源限制等信息保存到 OCI
config.json。 - 创建容器:CRI-O 启动 conmon 进程,将 OCI Bundle、运行时可执行文件和日志文件的路径等信息传给它。conmon 调用 OCI Runtime 创建容器进程及其隔离环境,容器进入
created状态,等待启动请求。 - 启动应用进程:Kubelet 发送启动请求后,CRI-O 检查容器处于
created状态,再通过 OCI Runtime 启动容器。
conmon 进程
conmon 为单个容器提供独立的监控进程。在 crun、runc 的执行路径中,它启动 OCI Runtime 创建容器,并保留自身进程,持续处理容器的输入输出、日志和退出状态。
容器运行期间,conmon 承担以下职责:
- 标准输入输出:保持容器的标准流连接,提供用于连接容器的 Socket,并通过它转发输入输出。
- 日志:将容器输出写入日志文件,供后续读取;容器退出后,日志仍可保留。
- 退出状态:记录容器的退出时间和退出码,供 CRI-O 获取并更新容器状态。
在 CRI-O 正常重启期间,conmon 仍可保持容器的输入输出连接,继续记录日志和监控容器。
conmon 进程创建与使用场景
在未启用 --sync 的模式下,conmon 的启动过程包含两次 fork,分别承担以下作用:
- 分离后台监控进程:conmon 通过第一次
fork创建子进程,原 conmon 进程退出,子进程继续作为监控进程运行。随后,监控进程调用setsid()创建新会话,脱离原来的控制终端。 - 启动 OCI Runtime:监控进程再次
fork,由新子进程设置标准输入输出,再通过execv()执行 runc 或 crun。运行时在子进程中执行,conmon 则继续承担监控职责。
启用 --sync 时,会跳过第一次用于后台分离的 fork,仍保留启动 OCI Runtime 的 fork。
在 CRI-O 1.36.4 中,两种模式的典型使用场景是:
- 创建容器(不启用
--sync):创建请求完成后,后台 conmon 持续处理容器的输入输出、日志和退出状态。对应的runtimeOCI.CreateContainer不传入--sync。 - 容器内同步执行命令(启用
--sync):例如 exec 类型的健康检查,在已有容器内执行cat /tmp/healthy,等待退出码以判断检查是否成功。Kubelet 通过RunInContainer调用 CRIExecSync;CRI-O 为本次命令另起 conmon,使用--exec,并在支持时添加--sync,对应ExecSyncContainer。
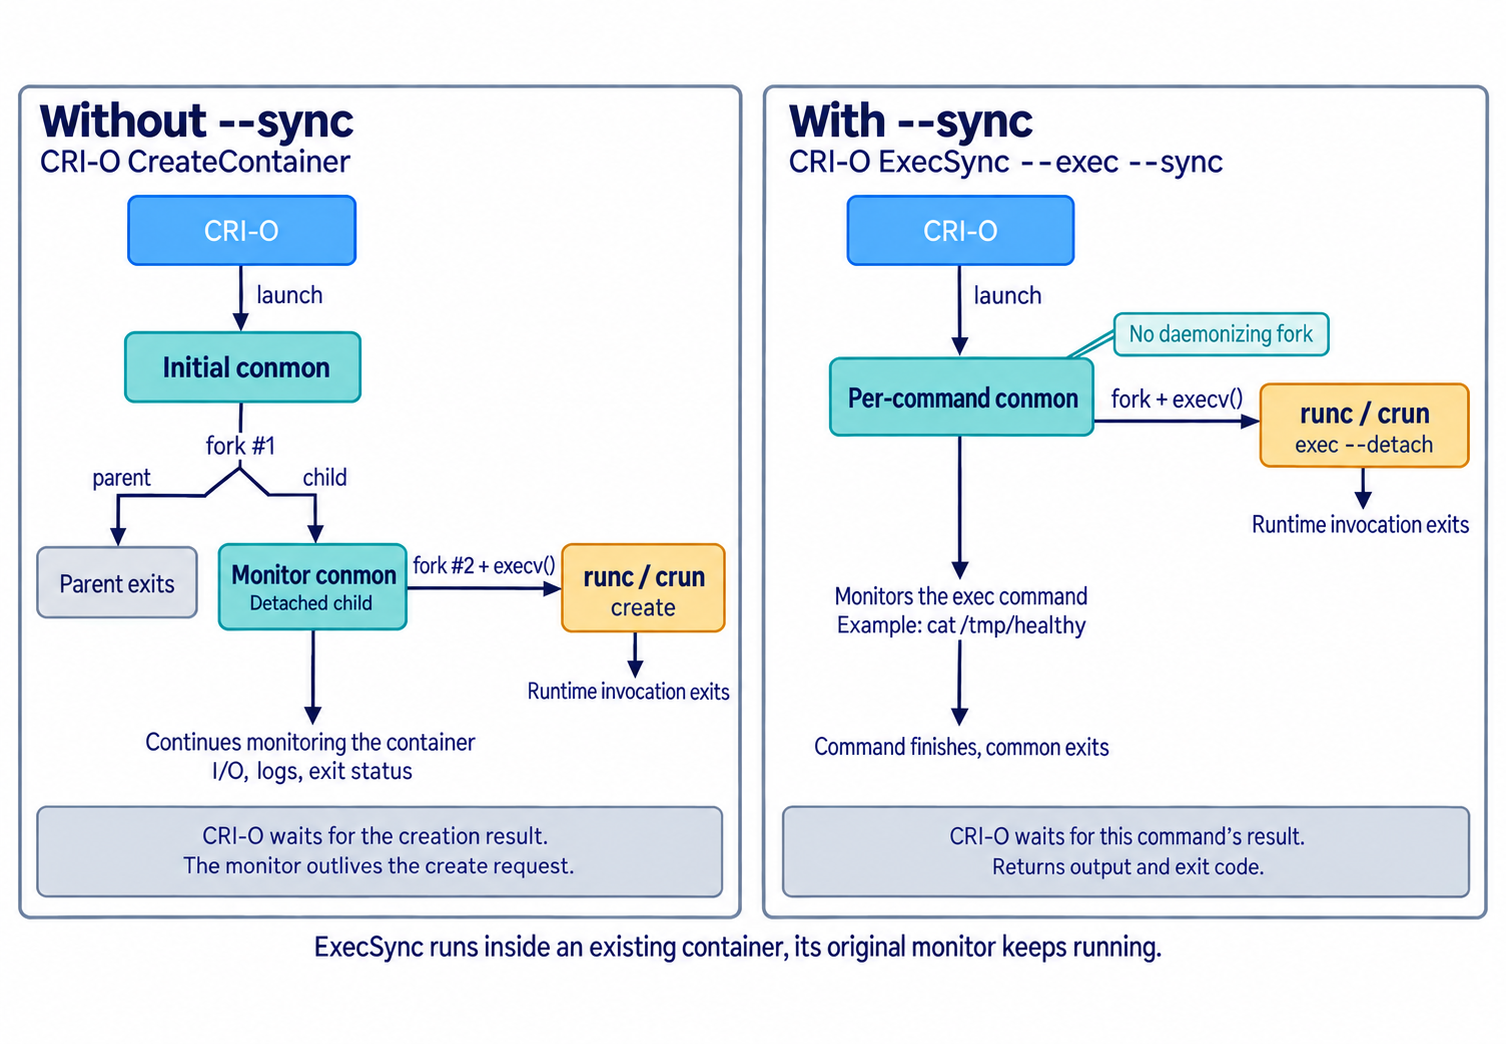
图:conmon 的后台分离与 OCI Runtime 子进程。根据 conmon 进程创建源码和 CRI-O 的创建与 ExecSync 实现绘制。
配置文件
CRI-O 默认使用以下配置文件和目录:
/etc/crio/crio.conf:主配置文件,集中设置 CRI-O 的运行参数。/etc/crio/crio.conf.d/:配置片段目录,可将存储、Sandbox 镜像和运行时等配置分别保存在独立的.conf文件中。
配置文件的合并顺序
CRI-O 按以下顺序加载并合并配置:
- 主配置文件:读取
/etc/crio/crio.conf中的设置。 - 配置片段目录:按文件名字典序加载
/etc/crio/crio.conf.d/中的文件。例如,10-storage.conf、15-sandbox-image.conf、20-runtimes.conf会依次加载。 - 命令行参数:显式传入的命令行参数覆盖配置文件中的对应设置,详见
--config-dir的说明。
如果多个配置文件设置了同一配置项,以文件名字典序排在最后的文件中的值为准。例如,00-default.conf 和 10-custom.conf 对同一配置项设置了不同值时,最终采用 10-custom.conf 中的值。配置文件的优先级见 CRI-O v1.36.4 crio.conf.d(5)。
以下示例介绍 CRI-O 的 API、存储、Sandbox 镜像、运行时、CNI 网络、cgroup,以及镜像仓库与认证配置。完整配置项见 CRI-O v1.36.4 crio.conf(5)。
API 配置
[crio.api] 配置 CRI-O 的 CRI 服务与 Streaming Server。Streaming Server 用于持续传输容器的交互输入、输出和端口转发数据,主要服务于三类操作:
kubectl exec:在容器中启动命令,并传输输入输出,例如进入容器执行交互式 Shell。kubectl attach:连接容器中已经运行的进程,查看输出或发送输入。kubectl port-forward:将本地端口的数据转发到 Pod 中的端口。
处理这三类操作时,CRI 服务接收请求并返回会话连接地址,Streaming Server 负责随后持续传输的数据。使用 kubectl 时,数据经过 API Server 和 Kubelet 代理。具体过程见 Kubernetes CRI 流式通信说明。
CRI 流式通信过程
下图展示了请求会话地址、建立连接和传输数据的过程。图中的 alt 表示客户端的两种可选路径:使用 kubectl 或 crictl。
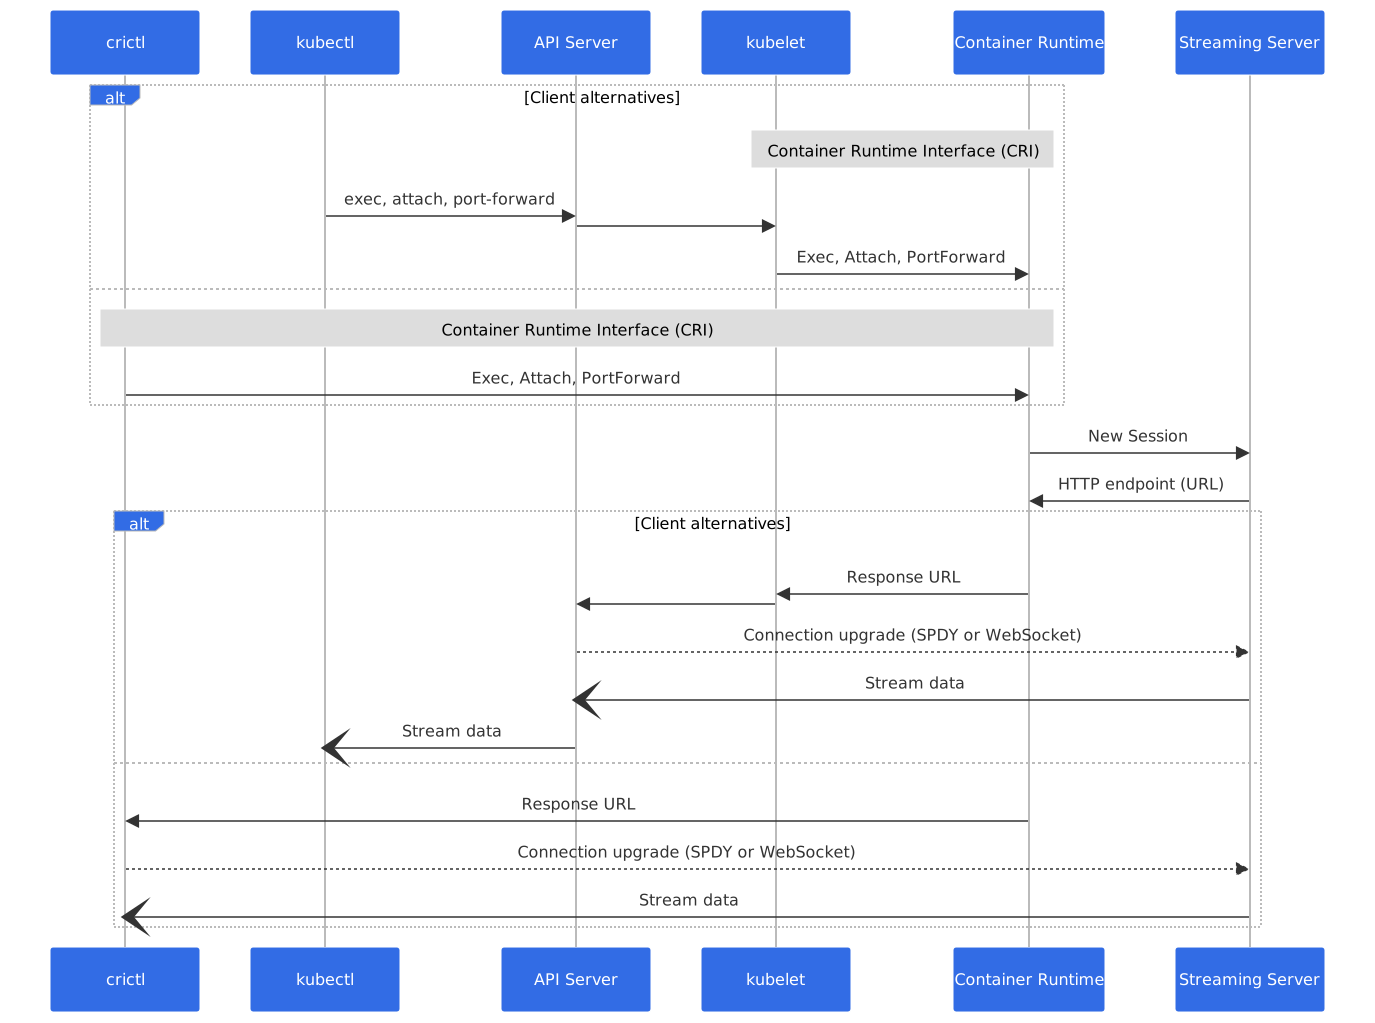
图:CRI 流式通信过程。来源:Sascha Grunert,Container Runtime Interface streaming explained。
- 请求会话:使用
kubectl exec时,请求先经过 API Server 到达目标节点的 Kubelet。Kubelet 根据容器 ID、命令和输入输出选项,调用 CRI 请求准备执行会话,对应GetExec。crictl则直接向容器运行时发送 CRI 请求。attach和port-forward使用同样的入口方式。 - 返回会话地址:运行时为本次请求准备 Streaming Server 地址,通过 CRI 响应返回给 Kubelet 或
crictl。以 CRI-O 使用的 Streaming Server 为例,它缓存请求并生成带 token 的 URL,后续连接通过这个 token 找到对应的会话。 - 建立流式连接:连接通过 HTTP Upgrade 切换为 WebSocket 或 SPDY。使用
kubectl时,API Server 连接 Kubelet,Kubelet 再根据会话 URL 代理到 Streaming Server,数据路径为kubectl ↔ API Server ↔ Kubelet ↔ Streaming Server。图中从 API Server 指向 Streaming Server 的箭头省略了这一段 Kubelet 代理。使用crictl时,客户端直接连接返回的 URL,数据路径为crictl ↔ Streaming Server。 - 持续传输数据:
exec和attach连接承载标准输入、标准输出、错误信息,以及交互终端的窗口大小变化等数据。例如,交互式 Shell 中输入的命令发往容器,命令输出再沿连接返回。port-forward连接承载本地端口与 Pod 目标端口之间的数据。
图中的 Container Runtime 和 Streaming Server 表示不同职责,并不要求独立进程。CRI-O 默认在自身进程中启动 Streaming Server。
下面使用 CRI-O v1.36.4 的默认连接地址,字段定义见 CRI-O API 配置:
listen:CRI 服务监听的 Unix Socket 路径。Kubelet 和crictl使用unix:///var/run/crio/crio.sock连接该服务。stream_address:Streaming Server 的监听 IP 地址。stream_port:Streaming Server 的监听端口,"0"表示自动选择空闲端口。stream_enable_tls:是否为 Streaming Server 启用 TLS。启用时还需配置stream_tls_cert和stream_tls_key,分别指定证书与私钥文件。
[crio.api]
listen = "/var/run/crio/crio.sock"
stream_address = "127.0.0.1"
stream_port = "0"
stream_enable_tls = false
存储配置
下面的配置指定本地存储目录,并使用 OverlayFS 准备镜像层和容器文件系统,字段定义见 CRI-O 存储配置:
root:保存镜像层、容器可写层和元数据等持久数据。runroot:保存挂载状态等运行期间的临时数据。storage_driver:选择存储驱动,overlay表示使用 OverlayFS。
[crio]
root = "/var/lib/containers/storage"
runroot = "/var/run/containers/storage"
storage_driver = "overlay"
Sandbox 镜像配置
pause_image 指定 Pod Sandbox 使用的 pause 镜像。示例使用 registry.k8s.io/pause:3.10.1,部署时可按节点要求调整镜像地址和版本,字段定义见 CRI-O 镜像配置:
[crio.image]
pause_image = "registry.k8s.io/pause:3.10.1"
运行时配置
下面的配置注册 crun 和 runc 两个 Runtime Handler,节点需已安装对应的运行时:
default_runtime:选择未指定 Runtime Handler 时使用的默认后端。runtime_path:指定运行时可执行文件的路径。runtime_type:指定运行时类型,这两个 Handler 均使用oci。
Kubernetes RuntimeClass 的 handler 字段与 [crio.runtime.runtimes.<handler>] 中的名称对应。默认运行时和 Handler 字段分别见 CRI-O 运行时配置和 Runtime Handler 配置。
[crio.runtime]
default_runtime = "crun"

[crio.runtime.runtimes.crun]
runtime_path = "/usr/bin/crun"
runtime_type = "oci"

[crio.runtime.runtimes.runc]
runtime_path = "/usr/bin/runc"
runtime_type = "oci"
CNI 网络配置
CRI-O 从 [crio.network] 指定的目录读取网络配置并寻找 CNI 插件,字段定义见 CRI-O 网络配置:
network_dir:CNI 配置文件所在的目录。plugin_dirs:CNI 插件可执行文件所在的目录列表。
下面使用默认目录。节点需要已安装 CNI 插件,并在配置目录中提供对应的网络配置:
[crio.network]
network_dir = "/etc/cni/net.d/"
plugin_dirs = ["/opt/cni/bin/"]
cgroup 配置
[crio.runtime] 中的 cgroup_manager 指定 cgroup 管理方式,默认是 systemd,字段定义见 CRI-O 运行时配置。Kubelet 与 CRI-O 使用的 cgroup driver 应保持一致,配置要求见 Kubernetes cgroup driver 配置。下面显式使用 systemd:
[crio.runtime]
cgroup_manager = "systemd"
镜像仓库与认证配置
CRI-O 通过 /etc/containers/registries.conf 和 /etc/containers/registries.conf.d/*.conf 配置镜像仓库与 Mirror,语法和加载方式分别见镜像仓库配置和镜像仓库配置片段。
registry.prefix:匹配待拉取镜像的名称前缀,例如docker.io。registry.location:指定该前缀对应的实际仓库位置。registry.mirror.location:指定优先尝试的 Mirror 地址。registry.mirror.pull-from-mirror:限制使用 Mirror 的镜像引用类型,digest-only表示仅在按 digest 拉取时使用。
下面为 docker.io 配置 Mirror,使用时将文件放入 /etc/containers/registries.conf.d/,并把 mirror.example.com 替换为保留相同仓库路径的实际镜像源。示例仅对按 digest 拉取的镜像使用 Mirror;按 tag 拉取时仍访问 docker.io:
# 放入 /etc/containers/registries.conf.d/,并替换为实际 Mirror 地址。
[[registry]]
prefix = "docker.io"
location = "docker.io"

[[registry.mirror]]
location = "mirror.example.com"
pull-from-mirror = "digest-only"
私有仓库的节点级认证由 [crio.image] 中的 global_auth_file 配置,它指向保存镜像拉取凭据的文件,字段定义见 CRI-O 镜像配置。下面使用 /etc/crio/auth.json 作为自定义路径;启用前需要准备认证文件,并限制其访问权限。这个 CRI-O 配置片段应放入 /etc/crio/crio.conf.d/:
# 使用前准备此路径的认证文件,并限制其访问权限。
[crio.image]
global_auth_file = "/etc/crio/auth.json"
完整配置示例
上面介绍的配置也可以放在同一个 /etc/crio/crio.conf 文件中:
# 存储配置
[crio]
root = "/var/lib/containers/storage"
runroot = "/var/run/containers/storage"
storage_driver = "overlay"

# API 配置
[crio.api]
listen = "/var/run/crio/crio.sock"
stream_address = "127.0.0.1"
stream_port = "0"
stream_enable_tls = false

# Sandbox 镜像与认证配置
[crio.image]
pause_image = "registry.k8s.io/pause:3.10.1"

# 需要节点级镜像拉取凭据时,先准备认证文件,再启用此项
# global_auth_file = "/etc/crio/auth.json"

# 默认运行时与 cgroup 配置
[crio.runtime]
default_runtime = "crun"
cgroup_manager = "systemd"

# crun Runtime Handler
[crio.runtime.runtimes.crun]
runtime_path = "/usr/bin/crun"
runtime_type = "oci"

# runc Runtime Handler
[crio.runtime.runtimes.runc]
runtime_path = "/usr/bin/runc"
runtime_type = "oci"

# CNI 网络配置
[crio.network]
network_dir = "/etc/cni/net.d/"
plugin_dirs = ["/opt/cni/bin/"]
镜像仓库与 Mirror 规则使用独立的配置文件。下面的文件放入 /etc/containers/registries.conf.d/,并将 mirror.example.com 替换为保留相同仓库路径的实际镜像源;示例仅对按 digest 拉取的镜像使用 Mirror。
命令行工具
服务检查
在由 systemd 管理 CRI-O 的节点上,可以检查服务状态、版本和监听地址:
# 查看 CRI-O 服务状态
systemctl status crio --no-pager

# 查看 CRI-O 版本
crio --version

# 查看 CRI-O 的 Unix Socket 监听状态
ss --listening --unix | grep '/var/run/crio/crio.sock'
crictl
crictl 通过 CRI 查询运行时信息、Pod Sandbox、容器和镜像。下面的命令连接 CRI-O 默认的 Unix Socket:
# 查看运行时状态和信息
crictl --runtime-endpoint unix:///var/run/crio/crio.sock info

# 列出 Pod Sandbox
crictl --runtime-endpoint unix:///var/run/crio/crio.sock pods

# 列出所有容器,包括已停止的容器
crictl --runtime-endpoint unix:///var/run/crio/crio.sock ps --all

# 通过 Image Service 列出本地镜像
crictl --image-endpoint unix:///var/run/crio/crio.sock images
状态查询
CRI-O 还通过同一个 Unix Socket 提供 Status API。/info 返回存储驱动、存储目录和 cgroup 驱动等信息,/config 返回当前生效的 TOML 配置:
# 查询 CRI-O 的存储和 cgroup 信息
curl --unix-socket /var/run/crio/crio.sock \
  http://localhost/info

# 查询 CRI-O 当前生效的配置
curl --unix-socket /var/run/crio/crio.sock \
  http://localhost/config
安装、配置与运行步骤见 CRI-O 示例。
低级容器运行时
低级容器运行时接收上层准备好的文件系统和运行配置,负责创建执行环境、设置隔离与资源限制,并启动应用程序。
下表列出了常见低级容器运行时的隔离方式和典型工作负载:
| 运行时 | 隔离方式 | 典型工作负载 |
|---|---|---|
| runc、crun、Youki | 使用 Linux Namespace 隔离资源视图、cgroup 限制资源用量,容器共享宿主机内核 | 通用 Linux 容器应用 |
| gVisor(runsc) | 用户态内核处理应用系统调用,在应用与宿主机内核之间增加隔离层 | 不可信代码、需要加强隔离的 Linux 应用 |
| Kata Containers | 轻量虚拟机提供独立内核 | 需要虚拟机级隔离的多租户 Linux 工作负载 |
| Wasm(Wasmtime、WasmEdge) | WebAssembly 沙箱限制内存访问,并通过显式提供的接口访问外部能力 | 边缘计算、Serverless 等场景中的 Wasm 应用 |
OCI 规范
OCI(Open Container Initiative)制定容器相关的开放标准。容器运行和镜像格式分别由以下两项规范定义:
- OCI Runtime Specification:定义容器的运行配置、执行环境和生命周期,包括进程参数、文件系统挂载、资源限制、容器状态,以及
create、start、kill、delete等操作的行为。 - OCI Image Specification:定义容器镜像的格式,包括 Image Manifest、Image Index、Image Config 和文件系统 Layer,使构建工具和容器运行时能够按统一格式生成和读取镜像。
OCI Bundle
OCI Bundle 是 runc、crun 等低级容器运行时创建容器时读取的一组本地文件。对于普通 Linux 容器,Bundle 包含运行配置 config.json 和容器的根文件系统(rootfs):config.json 描述启动哪个进程、挂载哪些目录以及使用什么资源限制;rootfs 提供容器内的应用程序、依赖库和配置文件。
config.json 中的 root.path 指定 rootfs 的位置。下面的示例将它设置为 rootfs,指向 Bundle 目录下的 rootfs/:
容器镜像保存用于分发的文件系统层和默认启动信息,创建容器前需要将这些内容准备成 OCI Bundle。以 containerd 为例,它协调镜像 Layer 的解包,并通过 Snapshotter 准备容器使用的 rootfs,具体过程见 containerd Content Flow。上层运行时还会结合镜像的默认配置和用户指定的运行参数,生成 Bundle 中的 config.json,供低级容器运行时读取并创建容器。
镜像中的 Image Config 是一份 JSON 元数据,保存默认启动命令、环境变量和工作目录等信息。创建容器时,上层运行时以这些默认值为基础,结合用户指定的运行参数,按 OCI 运行配置转换规则生成 Bundle 的 config.json。这份配置描述本次容器实际使用的启动命令和运行环境,还包含挂载、资源限制和隔离设置等。
config.json
config.json 描述将要启动的进程及其运行环境。完整字段见 OCI Runtime Configuration,常用字段包括:
process:进程参数、环境变量、工作目录、用户、Capability 和资源限制。root:rootfs 路径以及是否只读。mounts:容器内的 Mount Point、文件系统类型和 Mount Option。linux.namespaces:需要创建或加入的 Linux Namespace。linux.resources:CPU、Memory、PIDs、Block I/O 等 cgroup 配置。linux.seccomp:允许、拒绝或审计的 System Call。hooks:在容器生命周期指定阶段运行的外部程序。annotations:传递给运行时的扩展元数据。
下面的配置用于通过 runc 启动 BusyBox。它为容器创建独立的 PID、Mount、Network、IPC、UTS 和 cgroup Namespace,并挂载 /proc、/dev、/sys 和 /sys/fs/cgroup 等文件系统,提供常见的 Linux 运行环境。
OCI Bundle 配置
{
  "ociVersion": "1.3.0",
  "process": {
    "terminal": false,
    "user": {
      "uid": 0,
      "gid": 0
    },
    "args": ["sh", "-c", "printf \"runtime=runc pid=%s message=%s\\n\" \"$$\" \"hello-from-oci-bundle\""],
    "env": ["PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin"],
    "cwd": "/"
  },
  "root": {
    "path": "rootfs",
    "readonly": false
  },
  "hostname": "oci-demo",
  "mounts": [
    {
      "destination": "/proc",
      "type": "proc",
      "source": "proc"
    },
    {
      "destination": "/dev",
      "type": "tmpfs",
      "source": "tmpfs",
      "options": ["nosuid", "strictatime", "mode=755", "size=65536k"]
    },
    {
      "destination": "/dev/pts",
      "type": "devpts",
      "source": "devpts",
      "options": ["nosuid", "noexec", "newinstance", "ptmxmode=0666", "mode=0620", "gid=5"]
    },
    {
      "destination": "/dev/shm",
      "type": "tmpfs",
      "source": "shm",
      "options": ["nosuid", "noexec", "nodev", "mode=1777", "size=65536k"]
    },
    {
      "destination": "/dev/mqueue",
      "type": "mqueue",
      "source": "mqueue",
      "options": ["nosuid", "noexec", "nodev"]
    },
    {
      "destination": "/sys",
      "type": "sysfs",
      "source": "sysfs",
      "options": ["nosuid", "noexec", "nodev", "ro"]
    },
    {
      "destination": "/sys/fs/cgroup",
      "type": "cgroup",
      "source": "cgroup",
      "options": ["nosuid", "noexec", "nodev", "relatime", "ro"]
    }
  ],
  "linux": {
    "resources": {
      "devices": [
        {
          "allow": false,
          "access": "rwm"
        }
      ]
    },
    "namespaces": [
      { "type": "pid" },
      { "type": "network" },
      { "type": "ipc" },
      { "type": "uts" },
      { "type": "mount" },
      { "type": "cgroup" }
    ],
    "maskedPaths": [
      "/proc/acpi",
      "/proc/asound",
      "/proc/kcore",
      "/proc/keys",
      "/proc/latency_stats",
      "/proc/timer_list",
      "/proc/timer_stats",
      "/proc/sched_debug",
      "/sys/firmware",
      "/proc/scsi"
    ],
    "readonlyPaths": [
      "/proc/bus",
      "/proc/fs",
      "/proc/irq",
      "/proc/sys",
      "/proc/sysrq-trigger"
    ]
  }
}
rootfs
rootfs 是容器进程看到的根文件系统,通常包含应用程序、依赖库和配置文件。OCI 的 root.path 指定它在节点上的位置,可以使用相对于 Bundle 的路径或绝对路径。例如设置为 rootfs 时,运行时使用 Bundle 目录下的 rootfs/ 作为容器的根文件系统;目录名也可以按需指定。
容器运行时根据镜像准备 rootfs,再结合容器的可写层和额外挂载,组成容器进程看到的目录树。
-
从镜像层到 rootfs:镜像 Layer 记录文件的新增、修改和删除,需要按顺序应用才能形成完整的文件系统。containerd 协调镜像层的解包,并通过 Snapshotter 保存每层处理后的文件系统快照。创建可写容器时,再基于最终的镜像快照准备该容器独立的可写快照,并取得挂载信息,供后续挂载为容器的 rootfs。具体过程见 containerd Content Flow。
-
容器中的文件读写:以 OverlayFS 为例,
lowerdir提供只读镜像内容,upperdir保存当前容器的修改,容器看到的是合并后的目录树。新增文件写入可写层;修改仅存在于只读层的文件时,OverlayFS 会先将文件复制到可写层,再修改副本,这个过程称为 copy-up。例如修改镜像中的/app/config.yaml时,改变的是当前容器的副本,原镜像文件保持不变。这是 OverlayFS 的实现方式,其他 Snapshotter 可以采用不同机制,例如native通过复制父快照目录准备容器的文件系统。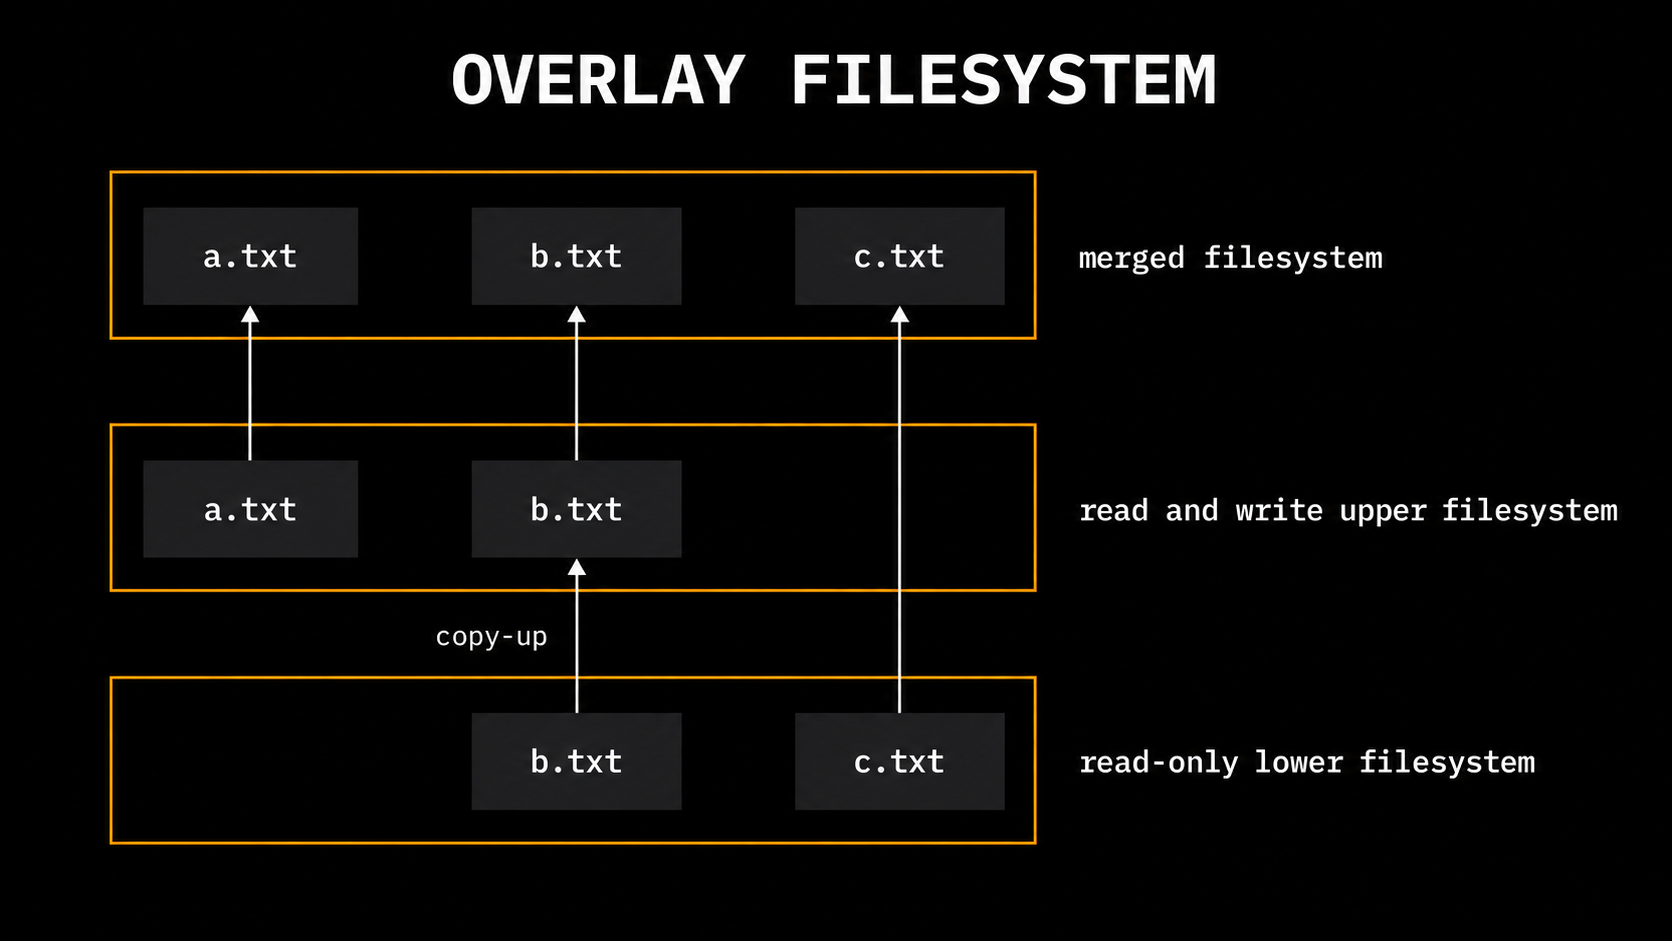
-
rootfs 与额外挂载:容器看到的目录树还可以包含额外挂载的文件系统。OCI 的
mounts指定这些挂载,例如为/proc、/dev准备的文件系统,或挂载到/data的数据卷。如果/data挂载了独立的数据卷,写入/data/result.txt的内容会保存在该卷中,而不是 rootfs 的可写层。
Linux 容器实现原理
runc、crun 创建的 Linux 容器与宿主机共享内核。运行时根据 OCI 配置,为容器进程设置 Namespace、cgroup 和安全策略,分别控制它能看到哪些系统资源、能够使用多少资源,以及允许执行哪些操作。
Namespace
Namespace 将系统资源划分到不同的命名空间中,使一组进程拥有自己的资源视图。Linux 按资源类型划分 Namespace,不同类型的 Namespace 分别隔离对应的系统资源。
下表列出了各类 Namespace 及其作用,容器使用哪些类型取决于运行配置:
| Namespace | 隔离的系统资源或视图 | 用途 |
|---|---|---|
| Mount | 挂载点及其组成的挂载树 | 为容器配置各自的文件系统挂载,例如在 /data 挂载不同的数据卷 |
| PID | 进程编号与进程可见范围 | 让容器拥有自己的进程编号和 PID 1 |
| Network | 网络设备、IP 地址、路由表、协议栈和端口空间 | 为容器或 Pod 配置独立网络,例如让不同 Network Namespace 中的应用同时使用相同的端口。 |
| IPC | System V IPC 对象与 POSIX 消息队列 | 为不同容器或 Pod 提供各自的进程间通信对象 |
| UTS | 主机名与 NIS 域名 | 为容器设置独立的主机名 |
| User | UID、GID 映射与 Capability 的作用范围 | 将容器内的用户映射到宿主机上的其他用户,例如将 root 映射为普通用户 |
| cgroup | 进程看到的 cgroup 路径与层级视图 | 让容器以自身的 cgroup 为层级起点,隐藏宿主机上的上级路径 |
| Time | 单调时钟与启动时间时钟的偏移,不包括 CLOCK_REALTIME |
调整容器看到的运行时长,例如通过时间偏移,让容器中的 uptime 从容器启动时开始计时 |
unshare 用于创建新的 Namespace,并在其中运行程序。
# Mount:创建独立的挂载视图,并查看挂载列表
sudo unshare --mount findmnt

# PID:创建独立的进程编号空间,并挂载对应的 /proc
sudo unshare --pid --fork --mount-proc ps -e -o pid,ppid,comm

# Network:创建独立的网络空间,并查看网络接口
sudo unshare --net ip -brief address

# IPC:创建独立的 IPC 空间,并查看 System V IPC 对象
sudo unshare --ipc ipcs

# UTS:在独立的 UTS Namespace 中设置并查看主机名
sudo unshare --uts sh -c 'hostname ns-demo; hostname'

# User:将当前用户映射为新 User Namespace 内的 root
unshare --user --map-root-user id

# cgroup:创建独立的 cgroup 路径视图
sudo unshare --cgroup cat /proc/self/cgroup

# Time:为启动时间时钟增加一小时偏移,并查看运行时长
sudo unshare --time --fork --boottime 3600 uptime -p
lsns 列出当前可见的 Namespace,/proc/<pid>/ns/ 则记录指定进程所属的 Namespace。
# 列出当前可见的 Namespace
$ sudo lsns
        NS TYPE   NPROCS     PID USER            COMMAND
4026531834 time     1627       1 root            /sbin/init
4026531835 cgroup   1510       1 root            /sbin/init
4026531836 pid      1510       1 root            /sbin/init
4026531837 user     1627       1 root            /sbin/init
4026531838 uts      1504       1 root            /sbin/init
...

# 查看当前 Shell 所属的 Namespace
$ lsns --task "$$"
        NS TYPE   NPROCS PID USER COMMAND
4026531834 time     1625   1 root /sbin/init
4026531835 cgroup   1508   1 root /sbin/init
4026531836 pid      1508   1 root /sbin/init
4026531837 user     1625   1 root /sbin/init
4026531838 uts      1502   1 root /sbin/init
4026531839 ipc      1508   1 root /sbin/init
4026531840 net      1506   1 root /sbin/init
4026531841 mnt      1495   1 root /sbin/init

# 只列出 Network Namespace,显示标识、代表进程 PID 和命令
$ sudo lsns --type net --output NS,PID,COMMAND
        NS     PID COMMAND
4026531840       1 /sbin/init
4026535754    6017 ├─/usr/libexec/accounts-daemon
4026537309  363539 └─/usr/libexec/rtkit-daemon
...

# 查看当前 Shell 的 Network Namespace 标识
# 输出形如 net:[4026531840],其中的数字对应 lsns 的 NS 列。
# 同一台主机上,同类型 Namespace 的标识相同,表示进程共享该 Namespace。
$ readlink /proc/$$/ns/net
net:[4026531840]
nsenter 用于在已有的 Namespace 中运行程序。--target 指定目标进程在宿主机上的 PID,--net、--mount、--uts 等参数选择要加入的 Namespace 类型。多个类型参数可以组合使用:
# Network:加入目标进程的 Network Namespace,查看网络接口
sudo nsenter --target "$PID" --net ip -brief address

# Mount:加入目标进程的 Mount Namespace,查看挂载列表
sudo nsenter --target "$PID" --mount findmnt

# UTS:加入目标进程的 UTS Namespace,查看主机名
sudo nsenter --target "$PID" --uts hostname

# IPC:加入目标进程的 IPC Namespace,查看 System V IPC 对象
sudo nsenter --target "$PID" --ipc ipcs

# PID:同时加入 PID 和 Mount Namespace,通过目标环境的 /proc 查看进程
# --root 切换到目标进程的根目录,使用其中的 ps 和 /proc
sudo nsenter --target "$PID" --pid --mount --root ps -e -o pid,ppid,comm

# 同时加入四类 Namespace,使用目标根目录,从 / 启动交互式 Bash
sudo nsenter --target "$PID" --uts --pid --net --mount --root --wdns=/ bash
Namespace 组合实验
这个实验组合 UTS、PID、Network 和 Mount Namespace,设置独立主机名、查看内部进程、挂载 tmpfs,并通过一对 veth 接口连接宿主机。
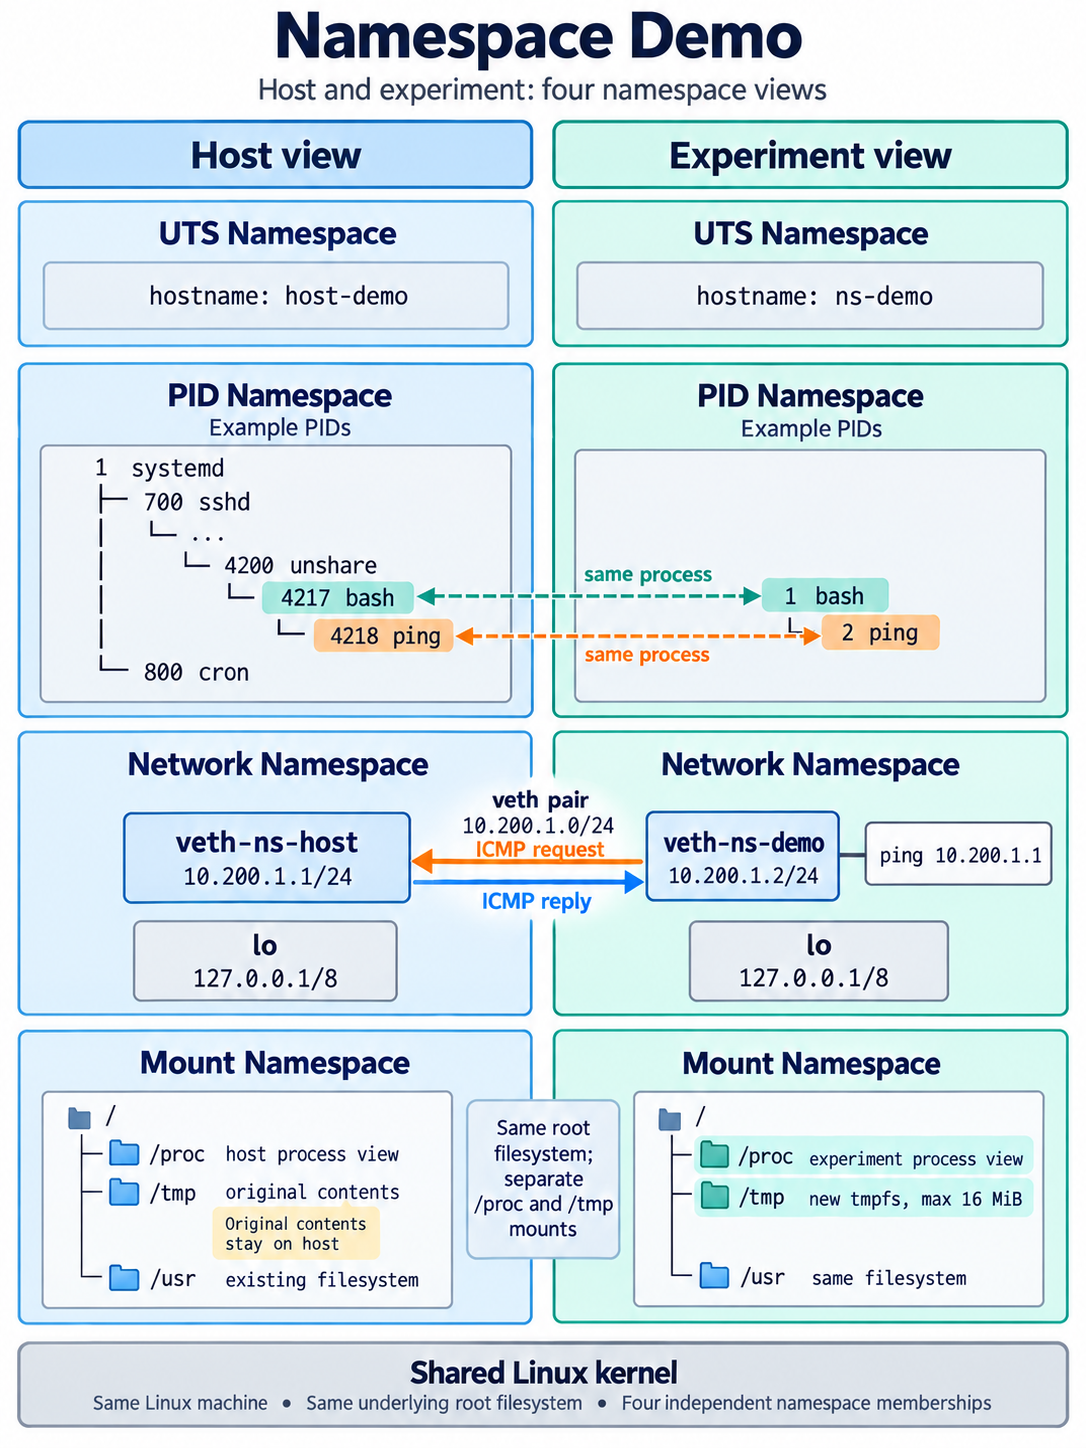
-
创建 Namespace
在终端 A 中创建 Namespace,并进入实验 Bash:
--fork:配合--pid创建子进程,让新 Bash 进入新的 PID Namespace,成为 PID 1。--mount-proc:在启动 Bash 前创建新的 Mount Namespace,并重新挂载/proc,使其中的进程信息与新的 PID Namespace 对应。
-
设置主机名并查看进程
在实验 Bash 中设置主机名,检查内部 PID 和进程列表:
# 设置当前 UTS Namespace 的主机名
hostname ns-demo

# 查看实验主机名
hostname

# 查看当前 Bash 的 PID
printf 'Shell PID: %s\n' "$$"

# 列出当前 PID Namespace 中的进程
ps -e -o pid,ppid,comm
输出:
-
挂载临时文件系统
在终端 A 的实验 Bash 中,为
/tmp挂载一个上限为 16 MiB 的 tmpfs。这个挂载只在新的 Mount Namespace 中可见,宿主机原有的/tmp保持不变。# 在实验内的 /tmp 上挂载 tmpfs mount -t tmpfs -o size=16m tmpfs /tmp # 查看 /tmp 的挂载信息 findmnt --mountpoint /tmp --output TARGET,SOURCE,FSTYPE,OPTIONS输出:
终端 B:对照宿主机的
/tmp。# 查看宿主机 /tmp 所属的文件系统 $ findmnt --target /tmp --output TARGET,SOURCE,FSTYPE TARGET SOURCE FSTYPE / /dev/nvme1n1p2 ext4--target查询路径所属的挂载。这里的TARGET为/,表示宿主机的/tmp属于 ext4 根文件系统;终端 A 的/tmp则使用新挂载的 tmpfs。 -
连接宿主机网络
veth 是成对的虚拟网络接口,一端发出的数据会到达另一端。在宿主机上创建一对 veth,将
veth-ns-demo移入实验 Network Namespace,veth-ns-host留在宿主机,再为两端配置同一子网中的地址。终端 A:查看实验 Network Namespace 的标识。
终端 B:在宿主机上定位 Namespace,并配置宿主端。 打开另一个终端,按终端 A 输出的标识匹配
NS列,后续命令中的$PID使用该行PID列的值。# 列出 Network Namespace 及其代表进程在宿主机上的 PID $ sudo lsns --type net --output NS,PID,COMMAND NS PID COMMAND ... 4026540272 3691398 unshare --uts --pid --fork --net --mount-proc bash ...# 在宿主机上创建一对 veth 接口 sudo ip link add veth-ns-host type veth peer name veth-ns-demo # 将实验端接口移入目标进程所在的 Network Namespace sudo ip link set veth-ns-demo netns "$PID" # 为宿主端配置 IP 地址 sudo ip address add 10.200.1.1/24 dev veth-ns-host # 启用宿主端接口 sudo ip link set veth-ns-host up终端 A:配置实验端。
-
验证网络连通性
在终端 A 中访问宿主端的
10.200.1.1。这里仅配置两端直连,不配置外网访问或 NAT。输出:
cgroup
cgroup(Control Group)将进程分组,由不同的 Controller 统计和控制 CPU、内存、任务数量和 I/O 等资源。内核通过虚拟文件系统提供管理接口:每个 cgroup 对应一个目录,目录中的文件用于查看进程、读取统计信息和设置资源限制。
cgroup v1 与 v2
cgroup v1 支持多棵层级树,CPU、内存等 Controller 可以分别挂载,也可以合并挂载。分别挂载时,各层级独立维护进程分组和资源设置,同一个进程可以在不同层级中属于不同的组。合并挂载时,多个 Controller 共用同一套分组结构和 cgroup.procs 进程列表。
cgroup v1 的使用方式
cgroup v1 的各 Controller 通常在系统启动时挂载到 /sys/fs/cgroup/ 下的子目录。通过 findmnt 查看实际挂载位置,再在对应目录中创建 demo 组。以下示例使用 cpu、memory、pids 和 blkio 目录。
两版示例中的 CPU 配额和权重适用于普通非实时调度任务。
# 查看 cgroup v1 的挂载点及其 Controller
findmnt --types cgroup --output TARGET,OPTIONS

# 在四棵层级树中分别创建 demo 组
sudo mkdir /sys/fs/cgroup/{cpu,memory,pids,blkio}/demo
-
CPU 时间配额:
cpu.cfs_period_us指定周期,cpu.cfs_quota_us指定组内任务每个周期可使用的累计 CPU 时间,单位均为微秒。以下设置相当于 0.5 个 CPU 的时间配额,不表示绑定到某个 CPU 核心,具体规则见 CFS Bandwidth Control。 -
CPU 竞争权重:
cpu.shares决定同一父组下各组竞争 CPU 时的相对份额,默认值为1024。设置为2048后,与权重为1024的兄弟组相比,竞争份额为 2:1;实际用量仍受 CPU 时间配额约束,见 CFS Scheduler。 -
内存上限:
memory.limit_in_bytes限制该组计入的内存用量,包括匿名内存和页缓存等。以下设置为 512 MiB;达到限制且无法回收足够内存时,默认会触发组内 OOM 处理,详见 Memory Resource Controller。 -
任务数量上限:
pids.max限制任务数量,线程也计入其中。达到上限后,继续创建进程或线程的fork()、clone()调用会失败,详见 Process Number Controller。 -
磁盘 I/O:
blkio.throttle.read_bps_device和blkio.throttle.write_bps_device分别限制指定块设备的读、写带宽,单位为字节/秒。以下设置为 读取 50 MiB/s、写入 10 MiB/s;8:0是示例设备的主、次设备号,应根据lsblk输出替换。限制每秒 I/O 次数时,使用对应的read_iops_device和write_iops_device,见 Block IO Controller。# 查看块设备及其主、次设备号 lsblk --output NAME,MAJ:MIN,MOUNTPOINTS # 将 8:0 替换为目标块设备的主、次设备号 DEVICE=8:0 # 将目标设备的读取带宽上限设为 50 MiB/s echo "$DEVICE 52428800" | sudo tee /sys/fs/cgroup/blkio/demo/blkio.throttle.read_bps_device # 将目标设备的写入带宽上限设为 10 MiB/s echo "$DEVICE 10485760" | sudo tee /sys/fs/cgroup/blkio/demo/blkio.throttle.write_bps_device这些限制作用于归入该组的块设备请求。普通缓存写入的后台写回不一定归入原进程的
blkio组,不能把上述上限直接等同于应用write()的速度,相关条件见内核的inode_cgwb_enabled()。
配置完成后,将目标进程分别加入四个组,才能应用相应限制。
# 将 1234 替换为目标进程的 PID
PID=1234

# 将进程加入 CPU 组
echo "$PID" | sudo tee /sys/fs/cgroup/cpu/demo/cgroup.procs

# 将进程加入内存组
echo "$PID" | sudo tee /sys/fs/cgroup/memory/demo/cgroup.procs

# 将进程加入任务数量限制组
echo "$PID" | sudo tee /sys/fs/cgroup/pids/demo/cgroup.procs

# 将进程加入块设备 I/O 组
echo "$PID" | sudo tee /sys/fs/cgroup/blkio/demo/cgroup.procs
cgroup v1 的局限
多层级需要重复管理
Controller 分别挂载时,创建分组、迁移进程等操作需要在各棵树中分别执行,各层级中的进程列表也可能不同。
假设 cpu/demo 已配置 0.5 个 CPU 的时间配额,memory/demo 已配置 512 MiB 的内存上限。要让 PID 为 1234 的进程同时受到这两项限制,需要分别将它加入两个组:
# 指定示例进程的 PID
PID=1234

# 将进程加入 CPU 组,应用该组的 CPU 限制
echo "$PID" | sudo tee /sys/fs/cgroup/cpu/demo/cgroup.procs

# 将同一个进程加入内存组,应用该组的内存限制
echo "$PID" | sudo tee /sys/fs/cgroup/memory/demo/cgroup.procs
也可以通过合并挂载,让 CPU 和内存 Controller 共用一棵层级树,只需写入一次 cgroup.procs,就能将进程加入两个 Controller 共同管理的组。在 CPU 和内存 Controller 尚未绑定其他层级的 cgroup v1 环境中,可以这样配置:
# 创建合并挂载的目录
sudo mkdir -p /sys/fs/cgroup/combined

# 将 CPU 和内存 Controller 挂载到同一棵层级树
sudo mount -t cgroup -o cpu,memory none /sys/fs/cgroup/combined

# 创建两个 Controller 共用的进程组
sudo mkdir /sys/fs/cgroup/combined/demo

# 指定目标进程的 PID
PID=1234

# 一次写入,将进程加入 CPU 和内存 Controller 共用的组
echo "$PID" | sudo tee /sys/fs/cgroup/combined/demo/cgroup.procs
合并后的控制粒度不够灵活
合并挂载减少了重复操作,但同一棵树上的 Controller 必须共享完整的分组结构,无法按资源类型选择细分到哪一层。
例如,一个应用需要统一限制总内存,同时为 frontend 和 backend 进程设置不同的 CPU 权重。v1 合并挂载 CPU 和内存 Controller 后,创建两个 CPU 子组,也会同时形成两个内存子组:
app/
├── memory.limit_in_bytes       # 整个应用的内存上限
├── frontend/
│   ├── cpu.shares              # frontend 的 CPU 权重
│   └── memory.limit_in_bytes   # 同时形成内存子组
└── backend/
    ├── cpu.shares              # backend 的 CPU 权重
    └── memory.limit_in_bytes   # 同时形成内存子组
v1 仍能通过 app 限制整个应用的总内存,但其内存分组也会继续细分到子组。在 v2 中,父组向 app 启用 CPU 和内存 Controller 后,可以在 app 的 cgroup.subtree_control 中只启用 cpu,让内存统一由 app 管理,子组仅细分 CPU 控制:
app/
├── memory.max                  # 1073741824,即 1 GiB
├── cgroup.subtree_control      # cpu
├── frontend/
│   └── cpu.weight              # 200
└── backend/
    └── cpu.weight              # 100
此时,子组中没有 memory.max,其中进程的内存仍计入 app。这种按层级选择 Controller 的方式见 cgroup v2 的 Controller 启用规则。
跨 Controller 协作困难
不同 Controller 可以采用不同的分组结构,内核在协调内存与 I/O 等资源时,需要处理不同层级之间的归属关系。
例如,两个进程的内存统一按应用管理,磁盘 I/O 却按用户分别管理:
memory/
└── app/
    └── cgroup.procs            # 包含 PID 1234 和 5678

blkio/
├── user-a/
│   └── cgroup.procs            # 包含 PID 1234
└── user-b/
    └── cgroup.procs            # 包含 PID 5678
两个进程写入文件时,数据可能先进入内存中的页缓存,稍后再写回磁盘。缓存都计入 memory/app,但两个进程对应不同的 I/O 组,仅凭内存分组无法确定应关联哪个 I/O 组。这类不同层级之间的协作问题见 cgroup v2 对多层级设计的分析;v2 的统一层级为内存与 I/O 协作提供了共同的分组结构,缓存写回控制还需要文件系统支持。
接口和资源分配规则不一致
不同 Controller 的文件命名、数值格式和默认行为缺少统一约定,管理工具需要分别适配。
例如,同样表示“本组不设置上限”,v1 的 CPU 时间配额使用 -1,而 任务数量限制使用 max:
# v1:取消本组的 CPU 时间配额
echo -1 | sudo tee /sys/fs/cgroup/cpu/demo/cpu.cfs_quota_us

# v1:取消本组的任务数量上限
echo max | sudo tee /sys/fs/cgroup/pids/demo/pids.max
v2 的接口约定统一使用 max 表示没有上限:
# v2:取消本组的 CPU 时间配额,周期设为 100000 微秒
echo 'max 100000' | sudo tee /sys/fs/cgroup/demo/cpu.max

# v2:取消本组的任务数量上限
echo max | sudo tee /sys/fs/cgroup/demo/pids.max
这些设置取消的是当前组自身的上限,组内进程仍受父组的限制。
cgroup v2 使用统一层级,不同 Controller 基于同一套进程分组进行资源统计和控制。各级 cgroup 通过 cgroup.subtree_control 选择向子组启用哪些 Controller,使不同资源可以按需在不同层级进行细分管理。
cgroup v2 的使用方式
cgroup v2 通常挂载在 /sys/fs/cgroup。通过 findmnt 查看实际挂载位置,并通过根组的 cgroup.controllers 查看可用的 Controller。以下示例为根组的直接子组启用 cpu、memory、pids 和 io,再创建 demo 组,具体规则见 Enabling and Disabling。
# 查看 cgroup v2 的挂载位置
findmnt --types cgroup2 --output TARGET,OPTIONS

# 查看根组可用的 Controller
cat /sys/fs/cgroup/cgroup.controllers

# 为根组的直接子组启用 CPU、内存、任务数量和 I/O 控制
echo '+cpu +memory +pids +io' | sudo tee /sys/fs/cgroup/cgroup.subtree_control

# 创建统一管理各类资源的 demo 组
sudo mkdir /sys/fs/cgroup/demo
-
CPU 时间配额:
cpu.max将配额和周期放在同一个文件中,格式为quota period,单位均为微秒。50000 100000同样表示 0.5 个 CPU 的时间配额,详见 CPU Interface Files。 -
CPU 竞争权重:
cpu.weight默认值为100,通常取值范围为1–10000。设置为200后,与权重为100的兄弟组相比,竞争份额为 2:1;权重控制相对份额,cpu.max控制用量上限。 -
内存上限:
memory.max设置内存硬上限。以下设置为 512 MiB;达到上限且无法回收足够内存时,会触发组内 OOM 处理。memory.current和memory.events分别用于查看当前用量和 OOM 等事件,详见 Memory Interface Files。 -
任务数量上限:仍使用
pids.max,同样统计进程和线程,见 PID Controller。 -
磁盘 I/O:
io.max在同一条记录中设置指定块设备的限制。rbps、wbps分别限制每秒读、写字节数,riops、wiops分别限制每秒读、写 I/O 次数,详见 IO Interface Files。# 查看块设备及其主、次设备号 lsblk --output NAME,MAJ:MIN,MOUNTPOINTS # 将 8:0 替换为目标块设备的主、次设备号 DEVICE=8:0 # 将读取和写入带宽上限分别设为 50 MiB/s 和 10 MiB/s echo "$DEVICE rbps=52428800 wbps=10485760" | sudo tee /sys/fs/cgroup/demo/io.max缓存命中的读取不会产生块设备 I/O;缓存写入先修改内存,随后才写回磁盘,因此应用读写速度不一定等于块设备带宽。按 cgroup 管理缓存写回还要求文件系统支持,详见 Writeback。
配置完成后,只需将目标进程加入这一个组:
下图以 CPU 和内存为例,对比 v1 的独立层级与 v2 的统一层级,并展示 app 父组、frontend 和 background 子组的进程归属与资源配置:
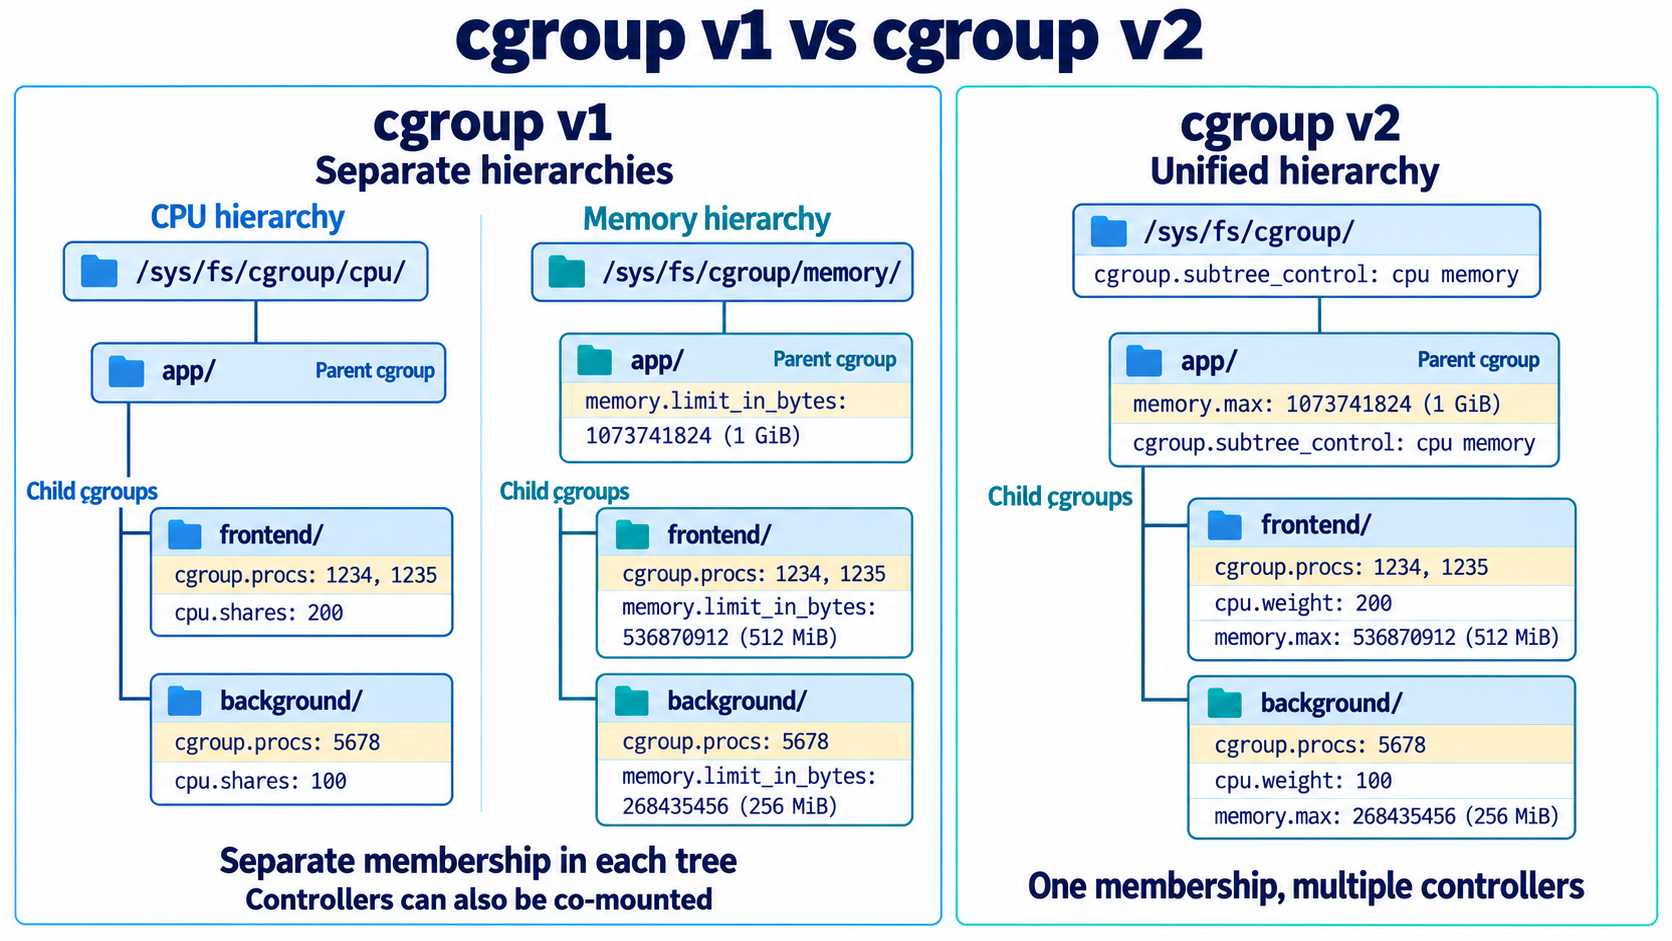
cgroup v1 目录结构
下面以 demo 为例列出主要文件,将 cpu 和 cpuacct 合并挂载,其余控制器分别挂载。
/sys/fs/cgroup/
├── cpu,cpuacct/                       # CPU 调度与用量统计
│   ├── cgroup.procs
│   ├── tasks
│   ├── ...
│   └── demo/
│       ├── cgroup.procs               # 当前组的进程 PID
│       ├── tasks                      # 当前组的线程 TID
│       ├── cpu.cfs_period_us           # CPU 配额周期
│       ├── cpu.cfs_quota_us            # 每个周期可使用的 CPU 时间
│       ├── cpu.shares                  # CPU 相对权重
│       ├── cpu.stat                    # CPU 限流统计
│       ├── cpuacct.usage               # 累计 CPU 使用时间
│       ├── cpuacct.usage_percpu        # 各 CPU 上的使用时间
│       └── cpuacct.stat                # 用户态、内核态 CPU 时间
│
├── memory/                            # 内存控制
│   ├── ...
│   └── demo/
│       ├── cgroup.procs
│       ├── tasks
│       ├── memory.limit_in_bytes      # 内存上限
│       ├── memory.usage_in_bytes       # 当前内存用量
│       ├── memory.max_usage_in_bytes   # 内存用量峰值
│       ├── memory.failcnt              # 触及内存限制的计数
│       └── memory.stat                 # 内存分类统计
│
├── cpuset/                            # CPU 与 NUMA 节点分配
│   ├── ...
│   └── demo/
│       ├── cgroup.procs
│       ├── tasks
│       ├── cpuset.cpus                 # 配置的 CPU 集合
│       ├── cpuset.mems                 # 配置的 NUMA 内存节点集合
│       ├── cpuset.effective_cpus       # 实际生效的 CPU 集合
│       └── cpuset.effective_mems       # 实际生效的 NUMA 节点集合
│
├── blkio/                             # 块设备 I/O 控制
│   ├── ...
│   └── demo/
│       ├── cgroup.procs
│       ├── tasks
│       ├── blkio.throttle.read_bps_device   # 各设备读取带宽上限
│       ├── blkio.throttle.write_bps_device  # 各设备写入带宽上限
│       ├── blkio.throttle.read_iops_device  # 各设备读取 IOPS 上限
│       └── blkio.throttle.write_iops_device # 各设备写入 IOPS 上限
│
├── pids/                              # 任务数量控制,线程也计数
│   ├── ...
│   └── demo/
│       ├── cgroup.procs
│       ├── tasks
│       ├── pids.current               # 当前任务数量
│       ├── pids.max                   # 任务数量上限
│       └── pids.events                # 达到限制等事件计数
│
├── devices/                           # 设备访问权限
│   ├── ...
│   └── demo/
│       ├── cgroup.procs
│       ├── tasks
│       ├── devices.allow              # 添加允许访问的设备规则
│       ├── devices.deny               # 撤销设备访问权限
│       └── devices.list               # 当前允许规则
│
└── freezer/                           # 冻结与恢复任务
    ├── ...
    └── demo/
        ├── cgroup.procs
        ├── tasks
        └── freezer.state              # 冻结状态与控制
cgroup v2 目录结构
父级通过 cgroup.subtree_control 为子级启用控制器后,demo/ 中会出现对应的资源文件。下面假设已启用 CPU、内存、cpuset、I/O 和 pids 控制器。
/sys/fs/cgroup/
├── cgroup.controllers                 # 根层级可用的控制器
├── cgroup.subtree_control              # 为直接子级启用的控制器
├── cgroup.procs                        # 根 cgroup 的进程 PID
├── ...
│
└── demo/
    ├── cgroup.type                    # 当前 cgroup 类型
    ├── cgroup.procs                   # 当前组的进程 PID
    ├── cgroup.threads                 # 当前组的线程 TID
    ├── cgroup.controllers             # 可继续向子级启用的控制器
    ├── cgroup.subtree_control         # 为直接子级启用的控制器
    ├── cgroup.events                  # 子树是否有进程、是否已冻结
    ├── cgroup.stat                    # 子孙 cgroup 等统计
    ├── cgroup.freeze                  # 冻结或恢复整个子树
    ├── cgroup.kill                    # 终止整个子树中的进程
    ├── cgroup.max.depth               # 子孙 cgroup 的最大深度
    ├── cgroup.max.descendants         # 子孙 cgroup 的数量上限
    │
    ├── cpu.max                        # CPU 配额与周期
    ├── cpu.weight                     # CPU 相对权重
    ├── cpu.stat                       # CPU 用量与限流统计
    ├── cpu.pressure                   # CPU 压力统计
    │
    ├── cpuset.cpus                    # 配置的 CPU 集合
    ├── cpuset.cpus.effective           # 实际生效的 CPU 集合
    ├── cpuset.mems                    # 配置的 NUMA 内存节点集合
    ├── cpuset.mems.effective           # 实际生效的 NUMA 节点集合
    │
    ├── memory.current                 # 当前内存用量,包含后代组
    ├── memory.min                     # 硬性内存回收保护
    ├── memory.low                     # 尽力而为的内存回收保护
    ├── memory.high                    # 触发节流与回收的阈值
    ├── memory.max                     # 内存硬上限
    ├── memory.swap.current            # 当前 Swap 用量
    ├── memory.swap.max                # Swap 用量上限
    ├── memory.stat                    # 内存分类统计
    ├── memory.events                  # 内存限制、OOM 等事件计数
    ├── memory.pressure                # 内存压力统计
    │
    ├── io.max                         # 各设备的带宽与 IOPS 上限
    ├── io.weight                      # I/O 相对权重
    ├── io.stat                        # I/O 用量统计
    ├── io.pressure                    # I/O 压力统计
    │
    ├── pids.current                   # 当前任务数量,包含后代组
    ├── pids.max                       # 任务数量上限,线程也计数
    └── pids.events                    # 达到限制等事件计数
Capability、seccomp 与 LSM
容器进程的操作受到多种权限检查约束:Capability 控制进程可执行的特权操作,seccomp 过滤系统调用,LSM 根据安全策略检查资源访问。运行时负责配置这些限制,内核在进程运行时执行检查。
Capability:细分特权
Linux Capabilities 将特权拆成独立能力。例如,修改网络接口需要 CAP_NET_ADMIN,运行时可以只授予应用这项能力。即使进程的 UID 为 0,缺少相应能力时,操作仍会被拒绝。
常见的 Capability 及其允许的典型操作如下:
| Capability | 允许的典型操作 |
|---|---|
CAP_NET_ADMIN |
配置网络接口、修改路由表和防火墙规则,例如调整网卡 MTU |
CAP_NET_RAW |
使用 RAW 和 PACKET 套接字,例如构造网络报文或抓包 |
CAP_NET_BIND_SERVICE |
绑定受系统限制的特权端口,例如在低端口受限的环境中监听 80 或 443 |
CAP_CHOWN |
修改文件的属主和属组 |
CAP_DAC_OVERRIDE |
绕过文件的传统读写权限检查,例如读取原本无权访问的文件 |
CAP_SETUID |
更改进程的用户 ID,例如初始化后切换运行用户 |
CAP_SETGID |
更改进程的组 ID 和补充组列表 |
CAP_SYS_PTRACE |
跟踪其他进程或访问其内存,例如调试进程 |
CAP_SYS_ADMIN |
执行挂载等多种系统管理操作,权限范围较广 |
Capability:修改容器内网卡的 MTU
Docker 的 --cap-drop=ALL 移除全部能力。以下命令尝试把容器内回环接口 lo 的 MTU 改为 1400:
缺少 CAP_NET_ADMIN,命令返回权限错误,退出码为 2:
只加回 NET_ADMIN,再执行相同修改,并查看 Effective Set 和接口状态:
docker run --rm --network=none --cap-drop=ALL --cap-add=NET_ADMIN \
  alpine:3.22 sh -c '
    grep "^CapEff:" /proc/self/status
    ip link set lo mtu 1400 && ip link show lo
  '
命令执行成功,退出码为 0。输出中的 0x1000 对应 CAP_NET_ADMIN,接口 MTU 已变成 1400:
seccomp:限制系统调用
seccomp Filter 使用 BPF 程序检查系统调用编号、架构和参数值,决定放行、返回错误或终止进程等。例如,可以让创建目录的 mkdir、mkdirat 系统调用直接返回 EPERM。
seccomp 的 BPF 过滤器可以检查系统调用参数的数值,但不能读取指针指向的内存内容。例如,它能检查 openat 的打开标志,却不能读取文件路径字符串。按路径控制文件访问,可以使用 AppArmor 等机制。
seccomp:禁止创建目录
创建文件 deny-mkdir.json,为 mkdir 和 mkdirat 设置错误返回值 1(EPERM):
{
  "defaultAction": "SCMP_ACT_ALLOW",
  "syscalls": [
    {
      "names": ["mkdir", "mkdirat"],
      "action": "SCMP_ACT_ERRNO",
      "errnoRet": 1
    }
  ]
}
先使用 Docker 默认策略创建目录:
目录创建成功,退出码为 0:
通过 --security-opt seccomp 指定该策略文件,再执行创建目录的命令:
docker run --rm --network=none \
  --security-opt seccomp=./deny-mkdir.json \
  alpine:3.22 mkdir /tmp/demo
系统调用被拒绝,命令退出码为 1:
这份教学规则按系统调用名称匹配,对任何路径的 mkdir、mkdirat 都生效。它放行其他系统调用,并替换 Docker 默认 seccomp 配置;生产配置应保留默认限制,再按应用需要收紧。配置方式见 Seccomp security profiles for Docker。
LSM:按安全策略约束资源访问
LSM(Linux Security Modules) 是内核执行安全策略检查的框架。SELinux 和 AppArmor 是基于 LSM 框架实现的安全模块。 SELinux 根据进程和对象的安全标签执行访问控制;AppArmor 根据进程的 Profile,按文件路径等条件限制访问。例如,可以配置 AppArmor,允许应用读取配置文件、写入临时目录,同时禁止修改配置文件。
AppArmor:允许读取配置,禁止修改配置
在启用 AppArmor 的 Linux Docker 宿主机上创建文件 demo-config-readonly,写入以下策略:
#include <tunables/global>

profile course-container-security-demo flags=(attach_disconnected,mediate_deleted) {
  #include <abstractions/base>

  file,
  signal,

  deny /etc/** w,
}
file, 允许一般文件操作,deny /etc/** w, 明确禁止写入 /etc 下的文件。以 root 权限加载策略,并确认容器使用 enforce 模式:
sudo apparmor_parser -a ./demo-config-readonly

docker run --rm --network=none \
  --security-opt apparmor=course-container-security-demo \
  alpine:3.22 cat /proc/self/attr/current
输出:
应用该策略后,分别读取配置、写入临时文件和修改配置:
docker run --rm --network=none \
  --security-opt apparmor=course-container-security-demo \
  alpine:3.22 cat /etc/alpine-release

docker run --rm --network=none \
  --security-opt apparmor=course-container-security-demo \
  alpine:3.22 sh -c 'touch /tmp/demo && echo "Created /tmp/demo"'

docker run --rm --network=none \
  --security-opt apparmor=course-container-security-demo \
  alpine:3.22 sh -c 'echo changed > /etc/alpine-release'
读取配置和创建临时文件均成功,退出码为 0;修改配置被拒绝,退出码为 1:
操作完成后卸载策略:
这份策略用于演示按路径限制文件访问,配置方式见 AppArmor security profiles for Docker。
runc
运行机制
runc 是 OCI Runtime Specification 的常用实现,也是 Docker Engine 和 containerd 默认 Linux 运行路径中的执行后端。它读取 config.json,通过 libcontainer 创建容器的隔离环境和初始进程,并管理容器的生命周期。
containerd 使用 io.containerd.runc.v2 时,长期驻留的是 containerd-shim-runc-v2 和容器进程。runc 在创建、启动或删除等操作期间执行,完成对应操作后退出。Shim 独立于 containerd 运行,负责维护容器的输入输出连接并记录退出状态。containerd 正常重启期间,Shim 和容器进程可以继续运行。
使用方式
runc 官方把它定位为供高级容器工具调用的低级 CLI。直接运行时,需要先准备 OCI Bundle。下面的命令使用 Docker 解出 BusyBox rootfs,再由 runc spec 生成基础配置。
# 设置 OCI Bundle 目录
BUNDLE=/tmp/runc-demo

# 创建临时 Docker 容器,用于导出 BusyBox 文件系统
CONTAINER_ID=$(docker create busybox:1.37)

# 创建存放容器根文件系统的目录
sudo mkdir -p "${BUNDLE}/rootfs"

# 导出临时容器的文件系统,并解包到 rootfs 目录
docker export "${CONTAINER_ID}" \
  | sudo tar -C "${BUNDLE}/rootfs" -xf -

# 删除用于导出文件系统的临时 Docker 容器
docker rm "${CONTAINER_ID}"

# 进入 OCI Bundle 目录
cd "${BUNDLE}"

# 在当前目录生成默认的 OCI 运行配置 config.json
sudo runc spec

# 根据 config.json 和 rootfs 创建并启动容器
sudo runc run runc-demo
crun
运行机制
crun 是使用 C 编写的低级容器运行时,实现 OCI Runtime Specification。它读取 OCI Bundle,创建容器的隔离环境和初始进程,并管理容器的生命周期。crun 比 runc 运行更快,内存占用也更低。
crun 可以作为 runc 的替代实现,接入 Docker、containerd、CRI-O 和 Podman。
使用方式
Docker Engine 默认使用 runc 作为低级容器运行时。可以在 /etc/docker/daemon.json 中注册 crun,再通过 docker run --runtime=crun 为容器选择它,配置方式见 Docker Alternative container runtimes。
下面假定 crun 已安装在 /usr/bin/crun。将示例中的 runtimes.crun 配置合并到 /etc/docker/daemon.json,保留文件中的其他配置:
{
  "runtimes": {
    "crun": {
      "path": "/usr/bin/crun"
    }
  }
}
在由 systemd 管理 Docker 的 Linux 主机上,重新加载配置后使用 crun 运行容器:
# 重新加载 Docker 配置,注册 crun 运行时
sudo systemctl reload docker

# 使用 crun 启动 BusyBox 容器,并输出内核信息
docker run --rm --runtime=crun busybox:1.37 uname -a
如果希望新建容器默认使用 crun,可以在同一配置文件的顶层增加 "default-runtime": "crun"。重新加载配置后,新建容器无需再指定 --runtime。详细配置见 Docker Configure the default container runtime。
crun 也可以直接运行前面准备好的 OCI Bundle:
# 进入已经包含 config.json 和 rootfs 的 OCI Bundle 目录
cd /tmp/runc-demo

# 使用 crun 创建并启动容器
sudo crun run crun-demo
Kata Containers
Kata Containers 是一个开源容器运行时,让每个容器或 Kubernetes Pod 运行在各自独立的轻量虚拟机(VM)中。它保留标准 Linux 容器的使用方式,通过硬件虚拟化提供更强的工作负载隔离。
运行架构
在 Kubernetes 中,一个 Pod Sandbox 对应一台 VM,同一 Pod 中的容器共享这台 VM 的 Guest Kernel。容器仍在 Guest 内使用 Namespace 和 cgroup 隔离与管理资源,应用的系统调用由 Guest Kernel 处理。
Kata Containers 可在多种处理器架构(如 x86_64、aarch64、ppc64le 和 s390x)上运行,并支持多种 Hypervisor(如 QEMU、Cloud Hypervisor、Firecracker、Dragonball 和 StratoVirt)。
创建 Kata Pod 时,containerd 或 CRI-O 将请求交给 Kata Shim,由 Shim 启动 Hypervisor 并引导轻量 VM。VM 内的 kata-agent 负责启动和管理容器。容器中的应用执行文件读写、网络通信等操作时,相关系统调用由 VM 内的 Linux 内核(Guest Kernel)处理。容器文件(包括镜像的 rootfs)通过 virtio-fs 共享到 Guest,通常由 Host 上的 virtiofsd 提供服务,也可以使用 nydusd 替代。Nydus Snapshotter 则是 Host 上的 containerd 快照插件,负责 Nydus 镜像层和快照管理,与 nydusd 配合实现镜像数据的按需加载,集成方式见 Kata Containers with virtio-fs-nydus。
flowchart TB
    subgraph host["Host"]
        containerd["containerd / CRI-O"]
        shim["Kata shim (containerd-shim-kata-v2)"]
        vmm["Hypervisor / VMM (QEMU, Cloud Hypervisor, ...)"]
        virtiofs["virtio-fs daemon (virtiofsd / nydusd)"]
        containerd -->|"1. create pod"| shim
        shim -->|"2. launch VM"| vmm
        shim -->|"2. start fs daemon"| virtiofs
    end

    subgraph vm["Lightweight VM (own guest kernel)"]
        agent["kata-agent"]
        workload["Container workload"]
        agent -->|"4. start & manage"| workload
    end

    vmm ==>|"3. boot guest"| vm
    shim <-.->|"control channel over VSOCK"| agent
    virtiofs ==>|"share host content (virtio-fs)"| workload
图:Kata Containers 的 Host 与 Guest 组件,以及控制连接和文件共享路径。来源:Kata Containers Quick Start Guide,Apache License 2.0。
Kata Containers 端到端运行流程
下图以 containerd、Kata runtime-rs 和 QEMU/KVM 为例,展示 Pod 的配置如何传递到运行时,以及容器如何在轻量 VM 中启动和执行。相关实现以 containerd v2.3.4 和 Kata Containers 4.2.0 为准。
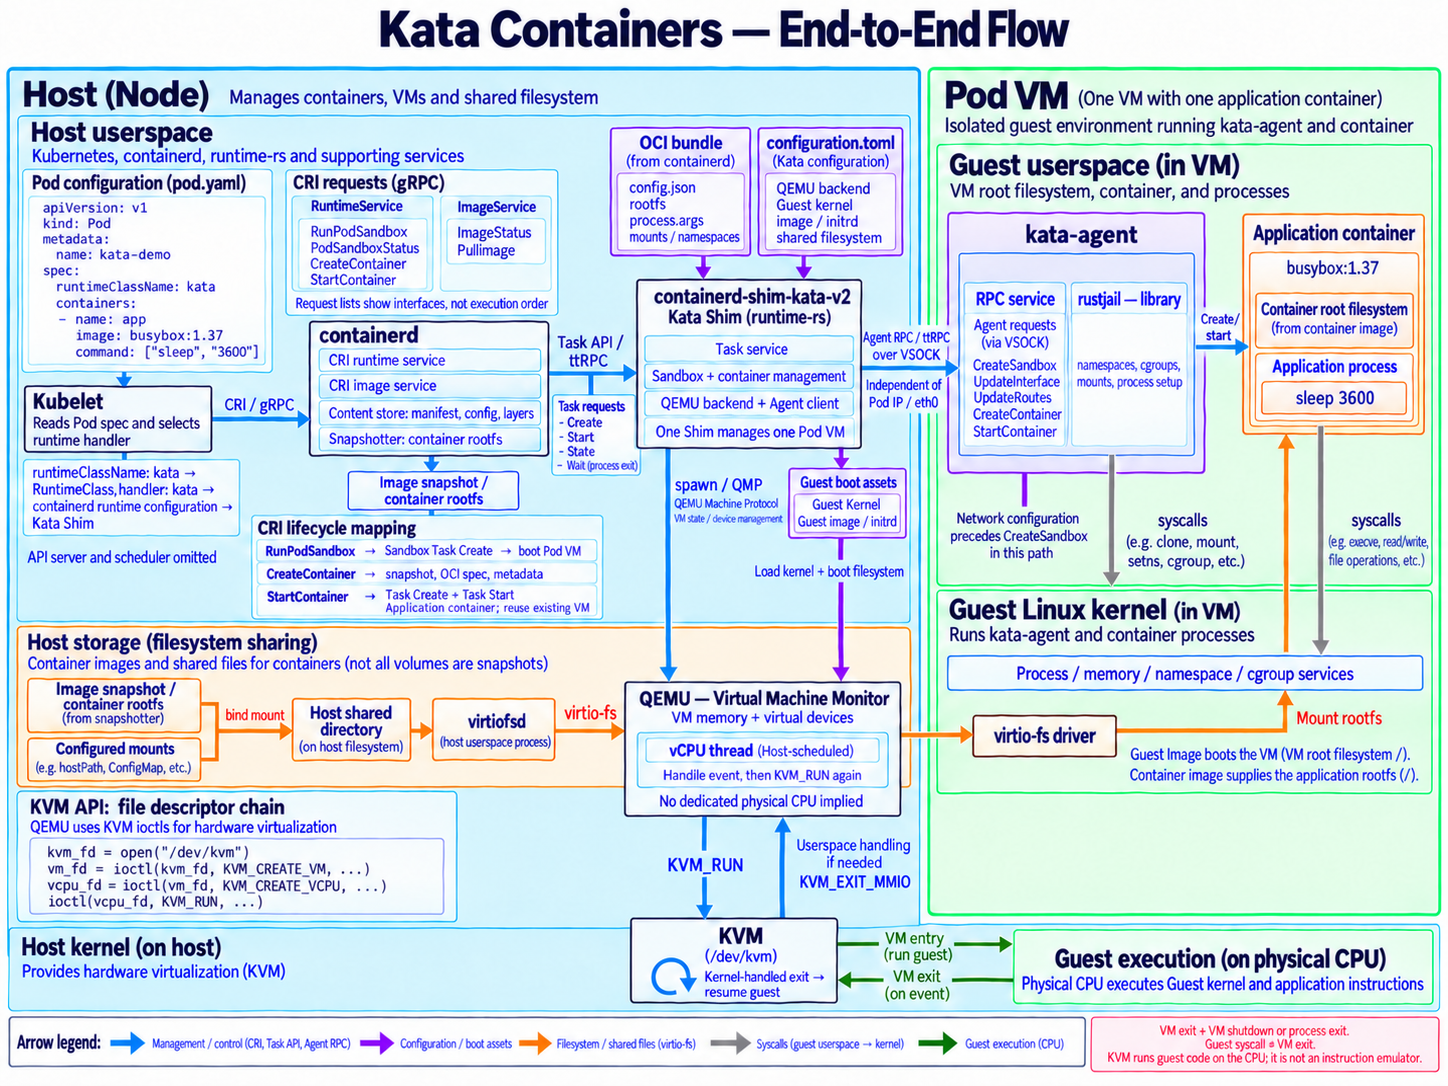
图:Kata Containers — End-to-End Flow。
Pod 配置与 Runtime 选择
Pod 中的 runtimeClassName: kata 指向名为 kata 的 RuntimeClass,其 handler 对应 containerd 中配置的 Kata Runtime。Pod 调度到节点后,Kubelet 根据这一选择,通过 CRI 请求 containerd 创建 Sandbox、准备镜像和启动容器。
例如,image: busybox:1.37 指定应用容器的镜像,command: ["sleep", "3600"] 指定启动命令。选择 Kata 后,这个程序会运行在 Pod 对应的 VM 内,由 VM 的 Linux 内核,即 Guest Kernel,提供进程管理、文件系统和网络等能力。
containerd 与 Kata Shim
containerd 的 CRI RuntimeService 负责管理 Pod 和容器:RunPodSandbox 创建 Pod 的运行环境,PodSandboxStatus 查询 Sandbox 的状态和网络信息,CreateContainer 准备容器配置、rootfs 和 I/O 等资源,StartContainer 启动容器。
CRI ImageService 负责镜像管理:ImageStatus 查询本地镜像信息,PullImage 拉取并解包镜像,供后续创建容器使用。镜像的 Manifest、Config 和 Layer 保存在 Content Store 中,Snapshotter 根据镜像层准备容器的文件系统视图。
需要创建和运行任务时,containerd 通过 Task API 与 Kata Shim 通信:Create 准备任务及其运行环境,Start 启动容器进程,State 查询任务状态,Wait 等待进程退出并返回退出结果。
同一 Pod 的容器由同一个 containerd-shim-kata-v2 管理,并共享一台 Sandbox VM。首次创建 Sandbox 时,Shim 启动 VM;后续容器复用这台 VM。
Shim 使用两类配置:OCI Bundle 描述容器,包括 rootfs、process.args、挂载和 Namespace;configuration.toml 描述 VM 及其后端,包括 Hypervisor、Guest Kernel、启动镜像和共享文件系统。
VM 启动与 Guest 管理
处理 RunPodSandbox 时,containerd 的 Sandbox Controller 创建 Sandbox Task,触发 Kata 的 VM 启动逻辑。runtime-rs 的 VirtSandbox::start() 负责协调 VM 启动、Agent 连接和 Guest 初始化。
QEMU 是运行在 Host 用户态的 VMM(Virtual Machine Monitor,虚拟机监控器),负责管理 VM 的内存、虚拟设备和运行状态。Kata 的 QEMU 后端通过 QemuInner::start_vm() 构建启动参数并启动 QEMU 进程。
QEMU 使用配置中的 Guest Kernel 和 Guest Image 或 initrd 引导 VM。Guest Image 或 initrd 提供 VM 的启动环境和 kata-agent,busybox:1.37 提供应用容器的 rootfs。两者分别由 Kata 配置和 Pod 配置指定。
VM 启动后,Shim 分别通过两条连接管理 VM 和 Guest 内的容器。QMP(QEMU Machine Protocol) 用于管理 QEMU 的运行状态和虚拟设备,例如暂停、恢复 VM 或热插拔设备;Shim 则通过 VSOCK 与 kata-agent 通信,请求它配置 Guest 网络、准备 Sandbox 和管理容器。
VSOCK 不依赖 Pod IP,因此 Shim 可以先连接 Agent,再让它配置 Guest 网络。在本文的 runtime-rs 路径中,网络配置通过 UpdateInterface 设置接口地址、MTU 等参数,通过 UpdateRoutes 设置路由。随后调用 Agent 的 CreateSandbox,初始化 Sandbox 的共享 Namespace、挂载所需存储并设置 DNS。
这里的 CRI RunPodSandbox 是 Kubelet 发给 containerd 的请求,Agent CreateSandbox 是 Shim 发给 Guest 的请求。后者执行时,VM 已经启动,负责完成的是 Guest 内部的 Sandbox 初始化。
容器创建与启动
Pod VM 就绪后,业务容器复用这台 VM。Kubelet 发出的 CRI CreateContainer 请求让 containerd 准备容器的 Snapshot、OCI 配置、I/O 和元数据,此时业务程序尚未运行。随后发出的 CRI StartContainer,才使容器进入实际运行阶段。
在 containerd 的 StartContainer() 实现中,NewTask() 向 Kata Shim 发起 Task Create,由 Shim 调用 Agent 的 CreateContainer,准备 Guest 内的容器环境。
containerd 接着调用 task.Wait(),建立接收容器主进程退出结果的通知通道,用于获取退出码等信息。等待的是容器主进程结束,本例中就是 sleep 进程退出。 这项等待在后台进行,不会阻塞后续启动;containerd 随后通过 task.Start() 发起 Task Start,由 Shim 调用 Agent 的 StartContainer,启动应用程序。
Agent 通过 do_create_container() 处理 CreateContainer 请求。它读取 OCI 配置,处理设备和挂载,并使用 rustjail 库准备 Namespace、cgroup 和初始进程。此时初始进程已经创建,但仍在等待启动通知,尚未执行应用程序。
收到 StartContainer 后,Agent 通过 do_start_container() 调用 rustjail 的 exec()。该函数向 FIFO(命名管道)写入启动通知,让等待中的进程继续执行,最终运行 OCI 配置中 process.args 指定的命令,本例为 sleep 3600。
应用运行后,文件读写、网络通信和进程管理等系统调用由 Guest Kernel 处理。例如,getpid() 返回 Guest 内的进程编号。Agent 继续负责容器生命周期管理,不参与应用每一次系统调用的处理。
容器文件系统共享
容器配置告诉 Agent 应该执行什么程序,但程序文件最初位于 Host 上。为了让 Guest 内的容器访问这些文件,Kata 还需要把 containerd 准备好的 rootfs 提供给 Guest。
在图中的 virtio-fs 配置下,runtime-rs 的 ShareFsRootfs::new() 准备容器 rootfs,再通过 share_rootfs() 将其组织到 Host 的共享目录。Host 上的 virtiofsd 提供文件访问服务,Guest Kernel 通过 virtio-fs 驱动访问共享内容。
Kata 将 Guest 内可访问的 rootfs 路径写入发送给 Agent 的 OCI 配置,由 Agent 将其设置为容器的根文件系统。于是,应用看到的 /bin、/etc 等目录来自容器镜像,而 kata-agent 仍运行在 VM 自身的启动环境中。
管理请求与文件访问使用不同的通道:Shim 与 Agent 通过 VSOCK 传递容器管理请求;应用对共享文件的访问由 Guest Kernel 处理,再通过 virtio-fs 到达 Host 文件系统。
QEMU 与 KVM 执行
QEMU 运行在 Host 用户态,KVM 是 Host Kernel 中的虚拟化子系统。QEMU 管理 VM 的内存、虚拟设备和运行状态,通过 KVM 提供的接口创建 VM、管理 vCPU 并进入 Guest 执行。
QEMU 打开 /dev/kvm 后获得 kvm_fd,随后通过 ioctl() 系统调用向 KVM 发出控制请求。KVM_CREATE_VM 在 kvm_fd 上创建 VM,返回 vm_fd;KVM_CREATE_VCPU 在 vm_fd 上创建 vCPU,返回 vcpu_fd;KVM_RUN 则作用于 vcpu_fd,运行这个 vCPU。
运行时,QEMU 通过 KVM_RUN 请求 KVM 运行 vCPU,由物理 CPU 执行 Guest Kernel 和应用指令。发生 VM exit 时,KVM 能处理的事件在内核中处理;需要用户态处理的事件才返回 QEMU,处理完成后可继续运行 Guest。
核心组件
-
Kata Shim:运行在 Host 上的
containerd-shim-kata-v2实现 containerd Runtime v2 接口,接收容器管理请求,并负责 VM、容器和资源的生命周期管理。在 Kubernetes 中,同一 Pod 的多个容器由一个 Kata Shim 进程管理。Kata Shim 的 Rust 实现源码位于runtime-rs,编译后生成的可执行程序就是containerd-shim-kata-v2。Kata Shim 的架构与实现演进
Shim v2 架构
下图对比了早期架构与 Shim v2 架构,变化主要在 Host 上的进程组织和容器管理请求的处理方式:
- 早期架构(图上):每个容器需要
containerd-shim和kata-shim,容器管理器通过 OCI 命令行多次执行kata-runtime,完成创建、启动等操作。未使用 VSOCK 的配置还需要独立的kata-proxy,连接 VM 内的kata-agent。反复启动运行时进程会增加开销,也需要在多次调用之间保存和恢复 VM 状态,具体说明见 History。 - Shim v2(图下):Kata 从 1.5.0 开始支持 Shim v2。containerd 通过 Runtime v2 接口向常驻的
containerd-shim-kata-v2发送请求,由同一进程管理一个 Pod 的 VM 和容器,并与kata-agent通信。原先分散在kata-runtime、kata-shim和kata-proxy中的管理职责合并到这个进程中,无需为每次容器操作重新启动运行时。
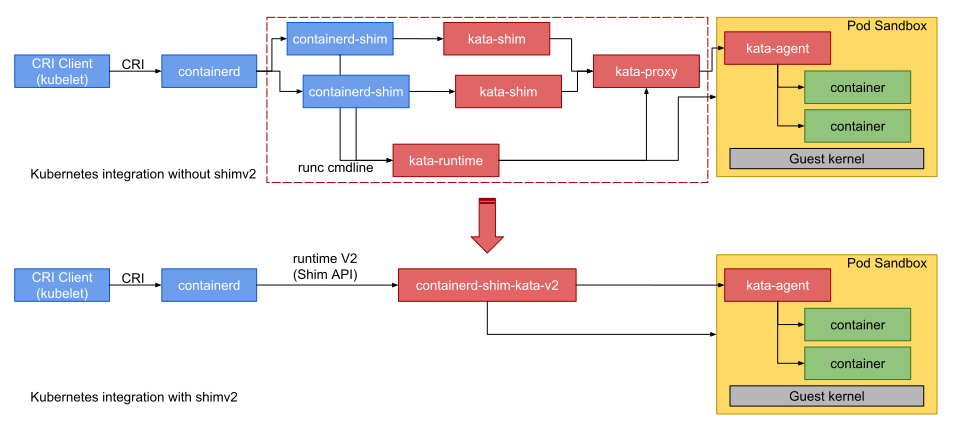
图:Kubernetes 集成 Kata Containers 时,Shim v2 引入前后的组件关系。来源:How to use Kata Containers and Containerd,Apache License 2.0。
Go 与 Rust Runtime
早期 Kata Runtime 使用 Go 实现,源码位于
src/runtime,其 Shim v2 实现同样生成containerd-shim-kata-v2。Kata Containers 3.0.0 引入 Rust 实现runtime-rs,此时 Rust Runtime 作为新增实现与 Go Runtime 并存。从 Kata Containers 4.0.0 起,
runtime-rs成为默认 Runtime。Go Runtime 被标记为弃用,不再接受新提出的功能,弃用期间仍接收关键 Bug 和 CVE 修复。Shim v2 指 containerd 的运行时接口版本,Go 和 Rust 则是实现该接口的语言。 Kata 4.2.0 官方预构建包中,两种实现的安装路径不同:Go Runtime 为
/opt/kata/bin/containerd-shim-kata-v2,Rust Runtime 为/opt/kata/runtime-rs/bin/containerd-shim-kata-v2,安装说明见 Installation。 - 早期架构(图上):每个容器需要
-
VMM:全称 Virtual Machine Monitor(虚拟机监控器),也称 Hypervisor,负责创建和运行 VM,管理 Guest 的 vCPU、内存和虚拟设备。Kata Shim 通过所选 VMM 启动 Guest Kernel,支持的 VMM 可以在这里找到 Hypervisors。
-
Guest Assets:VMM 启动 VM 所需的 Linux 内核和最小根文件系统镜像。
- Guest Kernel:传递给 VMM、用于启动 VM 的 Linux 内核,运行后为容器提供系统调用和资源管理功能。Kata 默认提供基于 Linux LTS 的内核,针对启动时间和内存占用进行优化,只保留容器工作负载所需的服务。
-
Guest Image:提供 VM 启动和运行
kata-agent所需的最小根文件系统。Kata 支持以下两种形式:- rootfs 镜像:将根文件系统制作为磁盘镜像,由 VMM 提供给 VM,Guest Kernel 挂载其中的文件系统作为 VM 的根目录
/。 - initrd:将根文件系统打包为压缩的
cpio归档,启动时加载到 VM 内存中,由 Guest Kernel 解包,形成内存中的根文件系统。
- rootfs 镜像:将根文件系统制作为磁盘镜像,由 VMM 提供给 VM,Guest Kernel 挂载其中的文件系统作为 VM 的根目录
Guest Image 与容器镜像
下图展示了一个使用 Kata Containers 运行的 Pod,其中的两个容器运行在同一台 VM 中。基于 Ubuntu 构建的 Guest Image 提供 VM 的启动文件和
kata-agent的运行环境。VM 启动后,kata-agent创建并管理两个容器,分别将alpine和debian镜像的 rootfs 设置为容器 A、B 的根目录。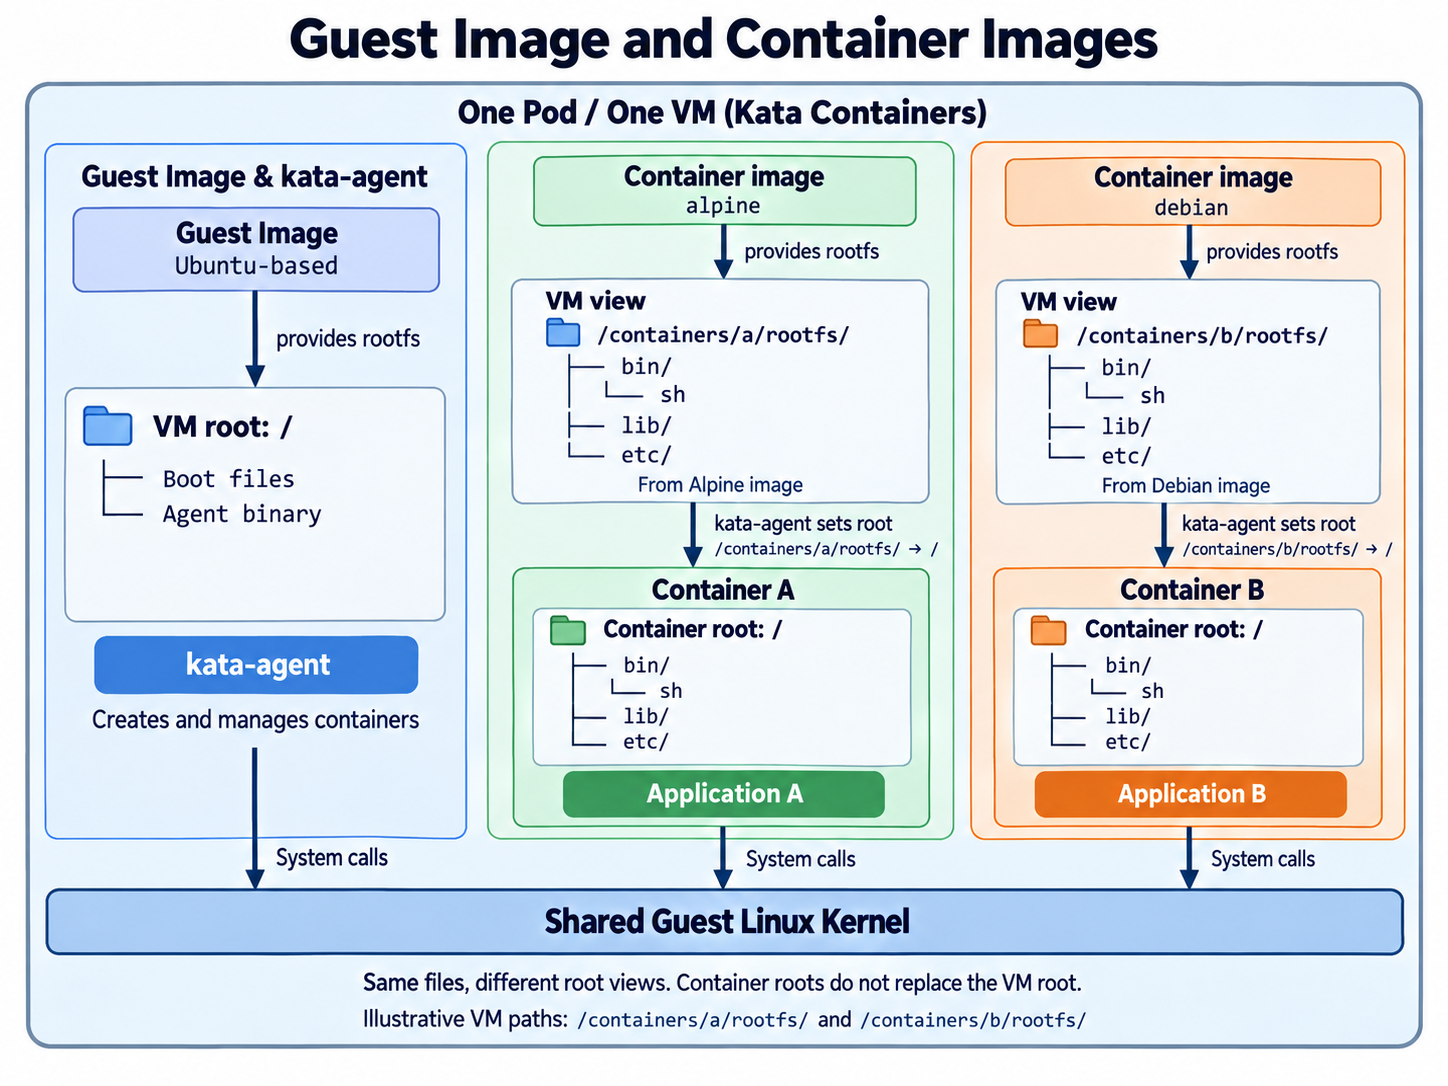
图:Guest Image 与容器镜像提供的根文件系统。
图中的三个
/表示不同运行环境中的根目录。容器 A 访问/bin/sh、/lib时,使用 Alpine 的文件;容器 B 使用 Debian 的文件;kata-agent则继续使用 Guest Image 提供的环境。容器的 rootfs 不会替换 VM 的根文件系统,三个环境中的进程都通过系统调用使用同一个 Guest Kernel。将 rootfs 设置为容器根目录,就是让容器中的程序把这棵文件树当作自己的
/,从这里开始查找文件。容器 A 的/bin/sh对应 VM 中的/containers/a/rootfs/bin/sh。容器 B 的/bin/sh则对应/containers/b/rootfs/bin/sh。容器内只需使用/bin/sh,无需填写 rootfs 前缀。VM 使用的 Guest Kernel 和 Guest Image 均由 Kata 配置指定。 -
kata-agent:运行在 VM 内的常驻进程,打包在用于启动 VM 的 Guest Image 中。Kata Shim 通过配置的 VMM 启动 VM 后,
kata-agent随之启动,负责创建 VM 内的容器并管理其生命周期。Kata Shim 通过轻量级 RPC(远程过程调用)框架 ttRPC 向它发送容器管理请求,接口定义见AgentService。 - virtio-fs daemon:运行在 Host 上的文件系统服务,通过 virtio-fs 将指定目录共享给 VM,处理 VM 对这些目录的文件访问请求。Kata 使用它向 VM 提供容器 rootfs 和挂载目录,通常使用
virtiofsd,也支持由nydusd提供 virtio-fs 服务。
容器创建与启动
以 containerd 调用 Kata 4.2.0 的 runtime-rs 为例,容器的创建与启动分为以下阶段:
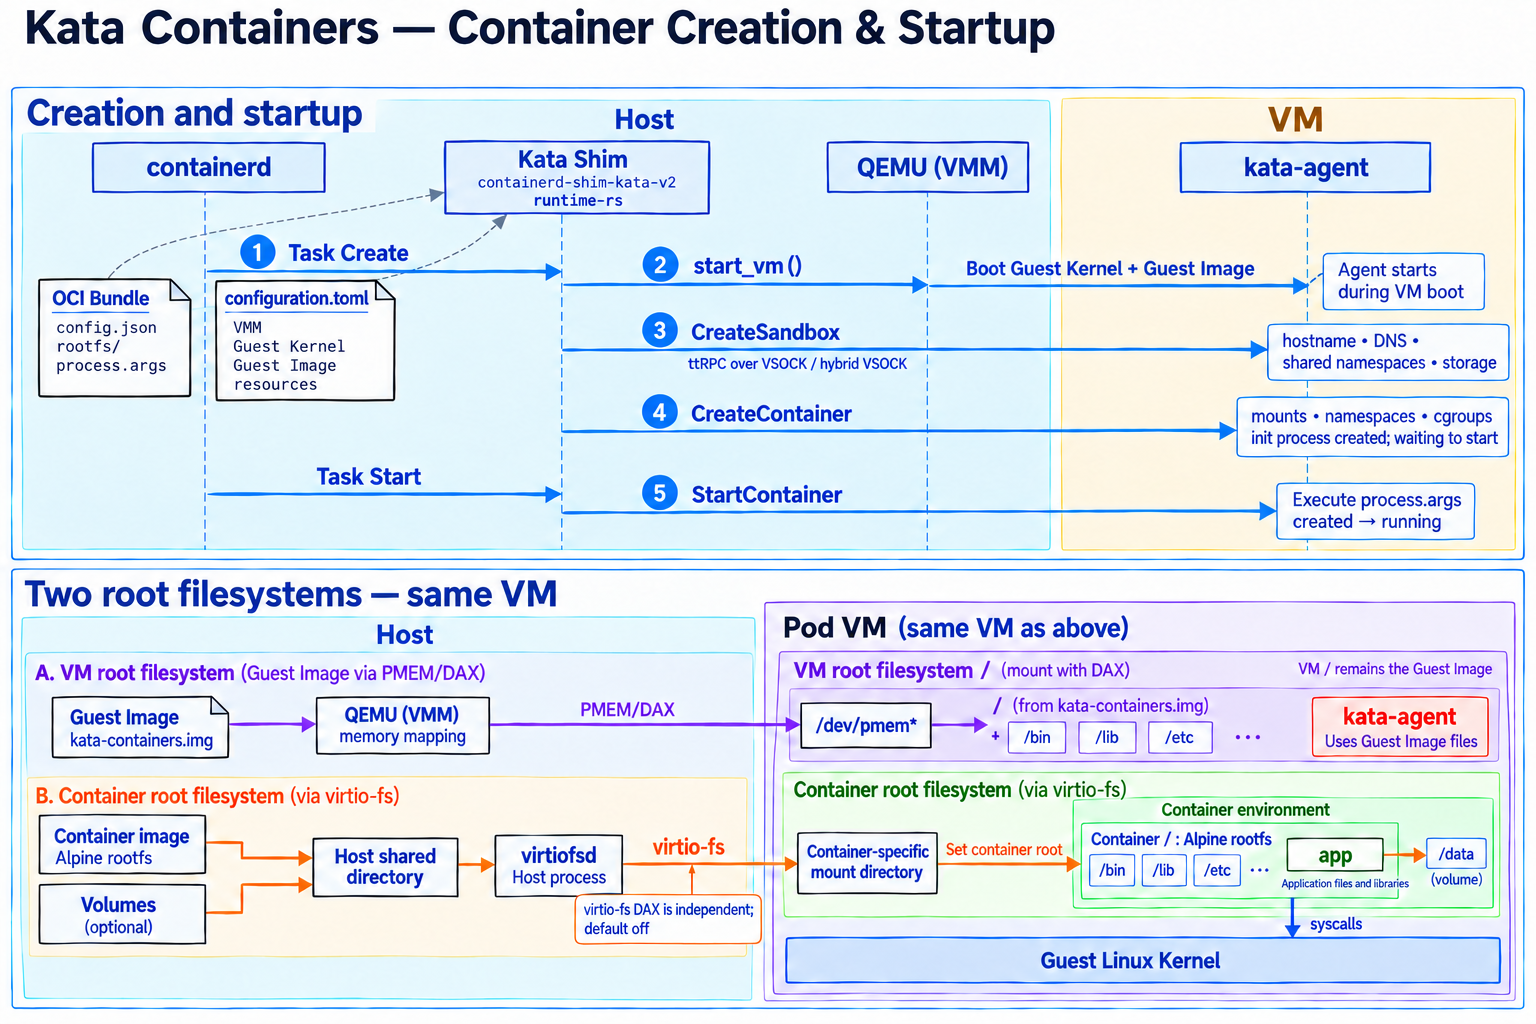
图:containerd 创建与启动 Kata 容器的流程。
- containerd 调用 Kata Shim:containerd 准备 OCI Bundle,启动
containerd-shim-kata-v2,通过 Runtime v2 的 Task 接口发送Create请求。Shim 读取 OCI 配置和 Kata 运行时配置,确定使用的 VMM、Guest Kernel、Guest Image 和资源配置。 - 启动 VM:Shim 准备 VM 所需的资源,通过
start_vm()启动作为 VMM(Virtual Machine Monitor,虚拟机监视器)的 QEMU。QEMU 通过宿主机的 KVM 接口创建 VM,并加载 Guest Kernel。Kata 利用 Linux 内核的 DAX 功能,将宿主机上的 Guest Image 映射到 VM 中,作为 VM 的根文件系统。Guest Kernel 从/dev/pmem*设备挂载这个文件系统,形成 VM 的根目录/,提供kata-agent及其运行所需的文件。 - 启动 Agent 并初始化 Sandbox:
kata-agent随 VM 启动。Shim 通过 VSOCK 或 hybrid VSOCK 与 Agent 建立 ttRPC 连接,再发送CreateSandbox请求,设置 VM 内 Sandbox 的主机名、DNS、共享 Namespace 和存储等。 - 创建容器环境:Shim 将容器 rootfs 和数据卷接入宿主机共享目录,由
virtiofsd通过 virtio-fs 向 VM 提供文件访问服务。Shim 发送CreateContainer请求后,Agent 根据 OCI 配置准备挂载、Namespace 和 cgroup,将共享的 rootfs 挂载到 VM 内为该容器准备的目录,再将其设置为 容器进程的根目录/。VM 自身仍使用 Guest Image 提供的根文件系统。Agent 同时创建等待启动的初始进程,此时尚未执行应用的启动命令。 - 启动应用:containerd 发送 Task
Start请求,Shim 调用 Agent 的StartContainer,让初始进程执行 OCI 配置中的启动命令。应用使用容器 rootfs 中的程序和库,系统调用由 VM 的 Guest Kernel 处理。
同一 Pod 后续创建的容器复用已有 VM 和 kata-agent,分别准备各自的 rootfs 和容器环境,无需再次启动 VM。
使用方式
Docker Engine 26 及以上版本可以直接通过 Kata Shim 启动容器。这里使用 runtime-rs 和 QEMU,主机需要可用的 /dev/kvm;Kata 安装步骤见 Kata Containers Installation。
安装到 /opt/kata/ 后,将以下 runtimes.kata 配置合并到 /etc/docker/daemon.json。runtimeType 指定 Kata Shim 的路径,ConfigPath 选择 QEMU 对应的 Runtime 配置:
{
  "runtimes": {
    "kata": {
      "runtimeType": "/opt/kata/runtime-rs/bin/containerd-shim-kata-v2",
      "options": {
        "ConfigPath": "/opt/kata/share/defaults/kata-containers/runtime-rs/configuration-qemu-runtime-rs.toml"
      }
    }
  }
}
QEMU 运行时配置
ConfigPath 指向的 /opt/kata/share/defaults/kata-containers/runtime-rs/configuration-qemu-runtime-rs.toml 决定 Kata 如何启动 VM、连接 Guest Agent,以及准备资源和文件共享。重点的配置参数如下:
# 摘录自 Kata Containers 4.2.0 amd64 发布包,不是完整配置。

[hypervisor.qemu]
# 宿主机上的 QEMU 可执行文件路径
path = "/opt/kata/bin/qemu-system-x86_64"
# 用于启动 VM 的 Guest Kernel 路径
kernel = "/opt/kata/share/kata-containers/vmlinux.container"
# Guest 根文件系统镜像,包含 kata-agent 及其运行环境,与应用容器镜像分开
image = "/opt/kata/share/kata-containers/kata-containers.img"
# VM 根文件系统驱动;省略后使用 virtio-blk-pci
vm_rootfs_driver = "virtio-pmem"

# VM 的默认内存容量,单位为 MiB;省略后为 128 MiB
default_memory = 2048

# 通过 virtio-fs 向 Guest 提供容器 rootfs 和挂载目录
shared_fs = "virtio-fs"
# 宿主机上提供文件访问服务的 virtiofsd 路径
virtio_fs_daemon = "/opt/kata/libexec/virtiofsd"

[agent.kata]
# 是否输出 Guest Agent 的调试日志
enable_debug = false

# 连接 Agent 失败后,两次重试之间的等待时间,单位为毫秒
dial_timeout_ms = 10

# 建立 Agent 连接的总时间预算,单位为毫秒,需不小于 dial_timeout_ms
reconnect_timeout_ms = 3000

# Agent 处理创建容器请求的超时时间,单位为秒
create_container_timeout = 30

# 在 Guest 内通过 modprobe 加载的内核模块及参数;空列表表示不额外加载
kernel_modules = []

[runtime]
# 选择上面的 QEMU 和 Kata Agent 配置
hypervisor_name = "qemu"
agent_name = "kata"

# 结合工作负载资源限制和 Guest 侧开销,在启动 VM 前确定 CPU、内存配置
# 显式开启静态资源管理;省略后为 false
static_sandbox_resource_mgmt = true
可以通过 --runtime=kata 指定使用 Kata 启动容器。以下示例运行 Ubuntu 容器并查看 Guest Kernel 版本:
# 重新加载 Runtime 配置,不重启 Docker
sudo systemctl reload docker

# 使用 Kata 启动容器,查看容器使用的 Guest Kernel 版本
docker run --rm --runtime=kata ubuntu:24.04 uname -r
gVisor
隔离架构
gVisor 是开源的工作负载隔离方案,用于运行不可信代码、容器和应用。其核心组件 Sentry 使用内存安全的 Go 语言编写,作为用户态 Application Kernel 实现应用所需的 Linux 系统接口。应用的系统调用由 Sentry 处理,从而减少应用直接访问宿主机内核的范围。
gVisor 提供实现 OCI Runtime 接口的 runsc,可以与 Docker、Kubernetes 等容器工具集成,也可以直接通过 runsc 创建和运行容器。
gVisor 的 Sentry 是 运行在用户态的 Application Kernel。对 Sandbox 中的应用来说,Sentry 承担内核职责;对宿主机内核来说,它仍是受限的用户态进程。
- 内核功能实现:Sentry 使用内存安全的 Go 语言重新实现应用所需的 Linux 内核功能,包括内存管理、文件系统、网络协议栈、进程管理等。图中上方的 Linux Userspace ABI 由 Sentry 提供。
- 系统调用处理:gVisor 将截获的应用系统调用和缺页异常交给 Sentry。Sentry 自行处理应用的系统调用,不将其直接透传给宿主机内核。例如,应用调用
getpid()时,Sentry 查询自己维护的 PID 表并返回编号,无需调用宿主机的getpid()。需要宿主机资源时,由 Sentry 在 Sandbox 配置允许的范围内发起受限的宿主机系统调用。 - Gofer 文件系统代理:Gofer 是独立的文件代理进程,负责向 Sandbox 提供配置中允许访问的文件系统。图中的 IPC 表示 Sentry 与 Gofer 之间的进程间通信,可用于文件操作请求和结果传递。当 Directfs 启用时,Gofer 进程会将所有容器挂载点的文件描述符传递给 Sandbox 进程。Sandbox 进程随后通过
openat(2)、fchownat(2)等基于文件描述符的系统调用,直接访问和操作文件。其访问范围限于 Gofer 暴露的文件系统树,无法访问范围之外的宿主机文件系统。 - 宿主机访问边界:Sentry 和 Gofer 通过图中下方的 Linux Userspace ABI 调用宿主机。seccomp 限制可用的系统调用,Namespace 和
pivot_root()等机制限制资源与文件系统视图。
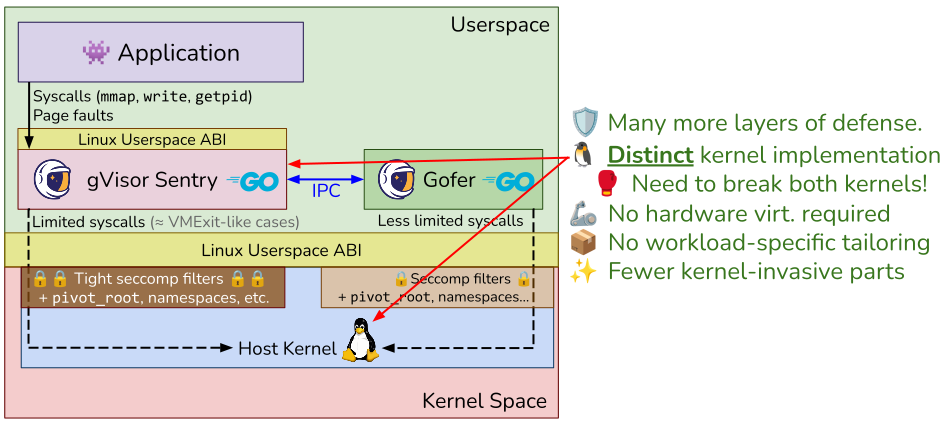
图:Sentry 实现应用的系统接口,Gofer 提供文件访问,两者分别受宿主机安全机制约束。来源:Introduction to gVisor security,Apache License 2.0。
Sentry 尚未实现的 Linux 内核功能,Sandbox 中的应用也无法使用。部分已实现功能也存在限制,具体兼容性见 Applications,例如:
- 块设备文件系统:gVisor 内核不原生支持
fat32、ext3、ext4等块设备文件系统,因此无法在 Sandbox 内挂载块设备。可以先在宿主机上挂载设备,再将已挂载的目录提供给 Sandbox。 - 网络规则:
iptables仅部分支持,主要目标是满足 Docker in gVisor 所需的功能;nftables规则也仅部分支持。 io_uring:默认禁用,启用后也仅支持基本的 I/O 操作。
下面对比共享内核隔离、虚拟机隔离和 gVisor 的区别。
共享内核隔离
应用直接使用 Host Kernel 提供的系统接口,seccomp、Namespace 和访问控制策略共同限制它能够执行的操作和访问的资源。
- 系统调用路径:应用发起系统调用后,Host Kernel 在相关检查点执行安全检查,通过检查的操作继续由宿主机内核处理。图中的 Linux Userspace ABI 是应用与宿主机内核之间的接口。
- seccomp Filter:根据系统调用编号、参数值等信息执行过滤,例如允许
read()、write(),拒绝mount()。规则决定调用是继续执行、返回错误,还是触发其他处理,具体行为见 Seccomp BPF。 - Namespace 与访问控制:Namespace 为进程提供独立的资源视图,例如进程列表、网络接口和挂载点;SELinux、AppArmor 则通过 Linux Security Modules 的安全检查点,判断进程能否访问文件、Socket 等资源。
- 隔离边界:这些机制缩小应用能够触达的内核功能范围,但被允许的操作仍由同一个 Host Kernel 执行。如果相关内核代码存在可利用的漏洞,应用仍可能通过这些操作攻击宿主机,因此过滤规则需要结合应用实际使用的接口配置。
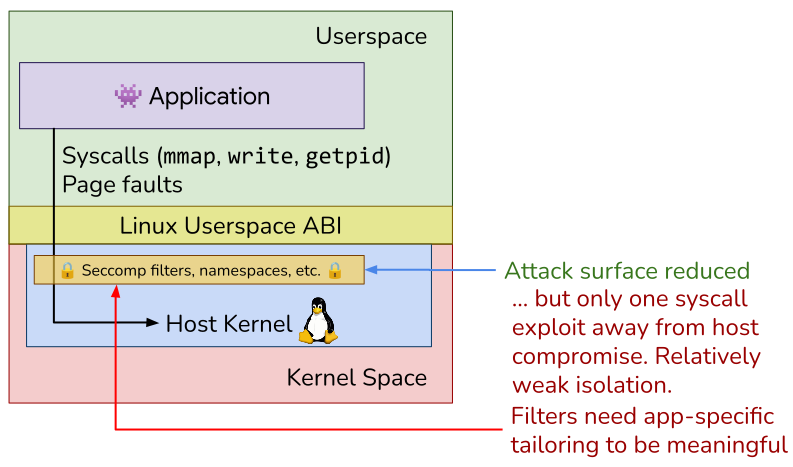
图:Linux 内核安全机制限制应用对 Host Kernel 的访问范围。来源:Introduction to gVisor security,Apache License 2.0。
虚拟机隔离
虚拟机内部运行独立的 Guest Kernel,由它处理应用的系统调用。需要访问虚拟磁盘、虚拟网卡等设备时,再通过虚拟化层使用宿主机提供的资源。
- Application 与 Guest Kernel:应用运行在 VM Userspace 中,通过 Linux Userspace ABI 调用虚拟机内核,也就是图中的 VM Kernel。
mmap()、write()、getpid()等系统调用由 Guest Kernel 处理,例如getpid()返回虚拟机内部的进程编号。 - Hypervisor 与 VM Exit:Hypervisor 管理虚拟 CPU、内存和设备。需要虚拟化层处理的事件可以触发 VM Exit,将控制权交给 Hypervisor。例如读取尚未缓存的磁盘数据,Guest Kernel 会通过磁盘驱动向虚拟磁盘提交请求。普通系统调用可以在 Guest Kernel 内完成,不需要每次都发生 VM Exit。
- Host Kernel:宿主机内核管理实际的 CPU、内存和设备,虚拟化层利用这些资源支撑虚拟机运行。图中将 Hypervisor 画在内核空间;实际实现也可以包含用户态 VMM,例如 QEMU。
- 隔离边界:硬件虚拟化限制 Guest 能访问的内存和设备。图中的 Guest Kernel 与 Host Kernel 都采用 Linux,但属于两个独立的内核运行实例,各自维护进程、内存等状态。
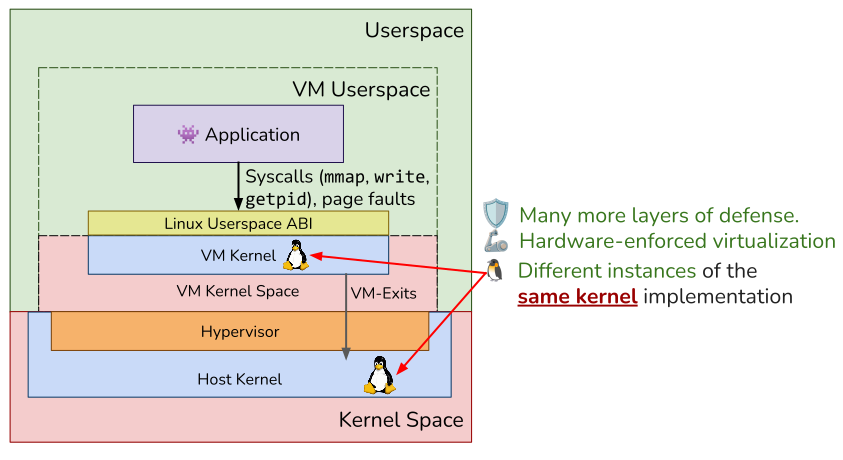
图:应用通过 Guest Kernel 使用虚拟机资源,Hypervisor 管理虚拟化边界。来源:Introduction to gVisor security,Apache License 2.0。
核心组件
gVisor 通过以下组件运行和管理 Sandbox:
-
Sentry:Sandbox 的用户态内核,在应用运行期间维护进程与线程、虚拟内存、文件描述符和信号等状态,并处理系统调用和缺页异常。同一个 Sandbox 中的多个容器共用一个 Sentry。
默认网络模式使用 Sentry 内部的用户态协议栈 netstack 实现 TCP/IP,并通过
AF_PACKETSocket 等链路接口收发数据包。应用的网络请求由 netstack 处理,数据包再与宿主机网络交换,具体路径见 Networking Guide。 -
Gofer:独立运行的文件系统代理进程,为容器提供 rootfs 和配置中允许访问的挂载目录。Sentry 与 Gofer 通过 LISAFS 协议交换文件操作请求和结果。
Directfs 默认启用,主要减少 Sentry 与 Gofer 之间的 RPC 往返,应用发起的系统调用次数不变。以打开挂载目录中的一个普通文件为例:
- 未启用 Directfs:应用调用一次
open(),Sentry 通过 LISAFS 向 Gofer 发送一次文件打开 RPC,由 Gofer 执行宿主机系统调用并返回结果。 - 启用 Directfs:应用仍调用一次
open(),Sentry 使用 Gofer 预先提供的目录文件描述符,直接执行宿主机openat(),省去这次 Gofer RPC 往返。文件访问范围仍限于 Gofer 提供的目录树。
- 未启用 Directfs:应用调用一次
-
Platform:负责截获应用的系统调用、切换执行上下文和管理内存映射。gVisor 通过不同的 Platform 实现适配宿主机环境,各实现的系统调用拦截方式和硬件要求不同,具体说明见 Platform Guide。
Platform 接口
Sentry 通过
Platform创建虚拟地址空间和线程执行上下文,分别由AddressSpace和Context表示。以下展示platform.go中的主要方法。创建地址空间与执行上下文
Platform.NewAddressSpace()创建应用使用的虚拟地址空间;Platform.NewContext()创建单个应用线程的执行上下文,供 Sentry 控制该线程的运行。type Platform interface { NewAddressSpace() (AddressSpace, error) NewContext(context.Context) Context }运行与中断应用线程
Context.Switch()恢复应用线程执行,并在发生系统调用或收到信号时将控制权交回 Sentry。例如,应用调用getpid()后,Sentry 查询进程编号并写入返回值,再通过Switch()恢复应用执行。Context.Interrupt()可主动中断应用执行,使Switch()返回ErrContextInterrupt。type Context interface { Switch(ctx context.Context, mm MemoryManager, ac *arch.Context64, cpu int32) (*linux.SignalInfo, hostarch.AccessType, error) Interrupt() }建立与解除内存映射
AddressSpace.MapFile()将内存后端f的指定区间fr映射到应用虚拟地址addr,由at指定读、写、执行权限。AddressSpace.Unmap()解除指定地址区间的映射。Platform 实现
gVisor 的 Platform 实现包括:
- KVM:使用宿主机内核的 KVM 功能,实现地址空间隔离与切换,并截获应用的系统调用和缺页异常。Sentry 同时承担两种职责:作为 Guest OS,实现应用所需的系统调用、内存管理等内核功能;作为 VMM(Virtual Machine Monitor,虚拟机监控器),通过 KVM API 管理虚拟 CPU、内存映射和执行状态。
- systrap:通过 seccomp 的
SECCOMP_RET_TRAP截获系统调用,使内核向触发调用的线程发送SIGSYS,再交给 gVisor 处理。它不依赖硬件虚拟化,适合虚拟机或没有可用 KVM 的环境,也可以在裸机上使用。systrap从 2023 年中开始替代ptrace,成为默认 Platform。 - ptrace(历史实现):使用
PTRACE_SYSEMU在执行应用代码时拦截系统调用,交由 Sentry 处理。它的上下文切换开销较高,频繁调用系统接口的应用更容易受到影响。ptrace已停止支持,通常应使用systrap。
下图展示了两类部署环境:左侧的 gVisor 直接运行在宿主机上,可以选择 KVM 或
systrap;右侧的 gVisor 运行在虚拟机内部,使用systrap可避免嵌套虚拟化开销。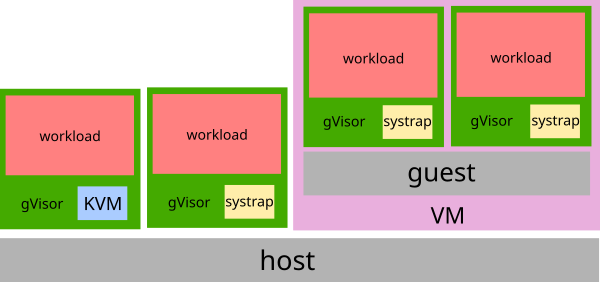
图:gVisor 在裸机和虚拟机中的 Platform 选择。来源:Platform Guide。
-
runsc:gVisor 提供的 OCI Runtime 可执行程序,读取 OCI Bundle 中的
config.json,根据根文件系统、挂载和进程等配置创建容器运行环境。创建新的 Sandbox 时,它启动 Sentry 和需要的 Gofer 进程;向已有 Sandbox 添加容器时,复用该 Sandbox,具体创建逻辑见container.New。
性能
与原生容器相比,gVisor 需要额外的 CPU 时间和内存,可能增加延迟、降低吞吐量或容器部署密度。Performance Guide 介绍了这些开销的来源及其对不同工作负载的影响。
应用的普通计算指令仍由 CPU 直接执行,gVisor 不做指令模拟,因此纯计算本身没有额外开销。 主要开销来自以下方面:
- 系统调用:应用的系统调用需要经过 Platform 截获、Sentry 处理,再恢复应用执行,增加了调用延迟。应用自身计算越少、系统调用越频繁,这部分开销越明显。
- 内存占用:Sentry 自身需要内存,还要保存进程、文件、Socket 等状态;容器打开的文件和 Socket 越多,需要维护的状态也越多。
- 网络处理:Sentry 使用用户态网络协议栈处理数据,其实现效率会影响 CPU 用量和网络吞吐。每个请求的业务计算越少,网络处理和系统调用开销的占比越高。
- 文件操作:Sentry 的虚拟文件系统(VFS)需要处理应用的文件操作;交给 Gofer 执行的操作还会增加进程间通信开销。
使用方式
gVisor 可以与 Docker、Kubernetes 集成,也可以通过 runsc 直接运行 OCI Bundle。这里介绍 Docker 的使用方式,具体步骤参考 gVisor Docker Quick Start。
安装 runsc 后,将它注册为 Docker Runtime,重启 Docker,再通过 --runtime=runsc 运行容器:
# 将 runsc 注册为 Docker Runtime
sudo runsc install

# 重启 Docker,使运行时配置生效
sudo systemctl restart docker

# 使用 runsc 运行 hello-world 容器
docker run --rm --runtime=runsc hello-world
在容器中执行 dmesg,可以查看 gVisor 提供的启动信息:
# 使用 runsc 运行 Ubuntu 容器,并查看启动信息
$ docker run --rm --runtime=runsc ubuntu:24.04 dmesg
[    0.000000] Starting gVisor...
[    0.354495] Daemonizing children...
[    0.564053] Constructing home...
[    0.976710] Preparing for the zombie uprising...
[    1.299083] Creating process schedule...
[    1.479987] Committing treasure map to memory...
[    1.704109] Searching for socket adapter...
[    1.748935] Generating random numbers by fair dice roll...
[    2.059747] Digging up root...
[    2.259327] Checking naughty and nice process list...
[    2.610538] Rewriting operating system in Javascript...
[    2.613217] Ready!
WebAssembly
WebAssembly(Wasm) 是一种通用字节码技术,它允许用 Go、Rust 和 C/C++ 等各种语言编写的程序编译成字节码,并可以直接在网页浏览器和服务器中执行。
WebAssembly 从一开始就旨在解决 JavaScript 的性能问题。借助 WebAssembly,开发者可以将代码编译成低级二进制格式,现代网页浏览器能够以接近原生的速度执行它。
图:Wasm 的编译与执行环境。
2019 年 3 月,Mozilla 发布了 WebAssembly 系统接口(WASI),这是一个 API 规范,定义了 WebAssembly 模块与其宿主环境之间的标准接口。WASI 允许 Wasm 模块安全地访问系统资源,包括网络、文件系统等。这极大地扩展了 WebAssembly 的潜力,使其不仅能在浏览器中运行,还能在服务器上运行。
优势
与传统容器相比,WebAssembly 具有以下优势:
- 快速:Wasm 模块通常能在毫秒内启动,明显快于传统容器。这对 Serverless 函数等需要快速启动的工作负载尤为重要。
- 轻量:与容器镜像相比,Wasm 模块通常体积更小,对 CPU 和内存资源的需求也更少。
- 安全:Wasm 模块运行在严格的沙箱环境中,与底层宿主操作系统隔离,减少潜在的安全风险。
- 可移植:Wasm 模块可以在不同平台和 CPU 架构上无缝运行,无需为不同操作系统和 CPU 组合维护多个容器镜像。
WebAssembly 与容器的详细比较见 WebAssembly vs Linux Container。
核心概念
Core WebAssembly(核心 WebAssembly)
Core WebAssembly 定义 WebAssembly 的类型、指令、模块以及校验和执行规则。其中,Module、Memory、Table 和 Instance 描述模块的代码及其运行时状态,在 WebAssembly JavaScript API 中都有对应的对象,定义参考 WebAssembly key concepts。
-
Module(模块) 是 WebAssembly 的代码组织单元。在 JavaScript API 中,
WebAssembly.Module表示浏览器对 WebAssembly 二进制代码编译后得到的可复用对象。它保存编译后的代码和 Import(导入)、Export(导出)等声明,不保存程序执行时产生的内存数据等运行时状态。同一个 Module 可以用于创建多个 Instance。 -
Memory(内存) 是可增长的连续字节存储空间,Wasm 程序通过字节偏移量读写其中的数据。JavaScript 可以通过其
buffer属性创建视图,访问同一块内存。 -
Table(表) 是可增长、带有元素类型的引用数组,用于保存函数等引用。Wasm 可以通过表项索引查找函数,并执行间接调用。
-
Instance(实例) 是 Module 实例化后得到的运行时对象,将模块代码与 Memory、Table、全局变量和导入值等状态关联起来。JavaScript 可以通过实例的
exports属性访问模块导出的函数、内存和表等对象。
WebAssembly 核心概念示例
这个例子通过一个整数乘法串联 Module、Instance、Memory 和 Table:JavaScript 向 Memory 写入 21,调用导出函数 myRun;myRun 读取这个值,通过 Table 找到函数 myDouble,计算后向 JavaScript 返回 42。
图:WebAssembly 核心概念与函数调用过程。
完整的 WAT 源码
WAT 是 WebAssembly 的文本格式,可以直接阅读模块中的声明和指令。下面的模块定义了一块 Memory、一张 Table 和两个函数,并导出三个对象供 JavaScript 使用:
myMemory(线性内存):保存输入数据,JavaScript 向其中写入整数21。myTable(函数引用表):第0项保存函数myDouble的引用,供myRun查找并调用。myRun(函数):供 JavaScript 调用,从myMemory读取输入,通过myTable调用myDouble,并返回计算结果。
将这段源码保存为 my-example.wat:
(module                                      ;; 定义一个 WebAssembly 模块
  (type $myUnary                              ;; 定义名为 $myUnary 的函数类型
    (func (param i32) (result i32)))          ;; 该类型接收一个 i32 参数,返回一个 i32 结果

  (memory (export "myMemory") 1)              ;; 声明初始大小为 1 页(64 KiB)的内存,导出名为 myMemory
  (table (export "myTable") 1 funcref)        ;; 声明初始含 1 个函数引用表项的表,导出名为 myTable

  (func $myDouble (type $myUnary)             ;; 定义函数 myDouble,采用 $myUnary 的参数和返回值类型
    (param $myValue i32) (result i32)         ;; 参数名为 $myValue,参数和返回值均为 i32
    local.get $myValue                       ;; 读取参数值并压入操作数栈,例如压入 21
    i32.const 2                              ;; 将 i32 常量 2 压入栈,此时栈为 [21, 2]
    i32.mul                                  ;; 弹出两个 i32 值相乘,再将结果 42 压入栈
  )                                          ;; 函数结束,将栈中的 i32 结果返回给调用方

  (elem (i32.const 0) $myDouble)              ;; 实例化时,将 myDouble 的函数引用写入 Table 的第 0 项

  (func (export "myRun") (result i32)        ;; 定义并导出函数 myRun,无参数,返回一个 i32
    ;; JavaScript 用 myView.setInt32(0, 21, true) 将整数 21 写入 Memory 的字节偏移量 0
    i32.const 0                              ;; 将这个字节偏移量压入栈,栈为 [0]
    i32.load                                 ;; 从该位置读取 4 字节,得到整数 21,栈变为 [21]

    ;; (elem (i32.const 0) $myDouble) 在实例化时,将 myDouble 的函数引用放入 Table 第 0 项
    i32.const 0                              ;; 将这个表项索引压入栈,栈变为 [21, 0]:21 是函数参数,0 是表项索引
    call_indirect (type $myUnary)             ;; 按索引取出函数引用,校验类型后以读取的值为参数调用
  )                                          ;; 函数结束,将 myDouble 的返回值交给调用方
)                                            ;; 模块定义结束
源码中的以下关键字属于 WAT 语法:
module:定义一个 WebAssembly 模块,包含函数、内存、表以及导入、导出等声明。func:定义函数,指定参数、返回值和函数体;在type声明中则用于描述函数的参数和返回值类型。memory:声明线性内存,供程序按字节位置读写数据,并指定内存的初始大小和可选的最大大小。export:将函数、内存或表等对象以指定名称导出,供外部代码访问。例如,(export "myRun")指定 JavaScript 通过myInstance.exports.myRun()调用这个函数。
文本格式的语法与示例见 Understanding WebAssembly text format。
模块与函数类型
最外层的 (module ...) 定义整个模块,Memory、Table、函数及其类型声明都写在其中。
(type $myUnary (func (param i32) (result i32))) 定义一个名为 $myUnary 的函数类型:接收一个 i32 参数,返回一个 i32 结果。i32 表示 32 位整数。这个声明描述函数的参数和返回值类型,具体计算由后面的函数实现。
函数 myDouble 使用 (type $myUnary) 引用这个类型;call_indirect 也引用它,要求从 Table 中取出的函数具有相同的参数和返回值类型。
Memory 的声明与导出
(memory (export "myMemory") 1) 声明一块初始大小为一页的线性内存,每页为 65,536 字节,即 64 KiB。实例化时创建这块内存,本例没有设置初始数据,因此其中的字节初始为 0。
(export "myMemory") 将这块内存以 myMemory 为名导出。JavaScript 可以通过 myInstance.exports.myMemory 取得对应的 WebAssembly.Memory 对象,再通过它的 buffer 属性读写内存中的字节。
Memory 按字节寻址。例如,一个 i32 占四个字节,存放在偏移量 0 时,会使用偏移量 0、1、2、3 这四个位置。内存声明和初始化规则见 WebAssembly Core Specification — Memories 与 WebAssembly Core Specification — Allocation。
Table 的声明与初始化
(table (export "myTable") 1 funcref) 声明一张初始包含一个表项的 Table,并以 myTable 为名导出。这里的 1 表示表项数量,funcref 表示表项用于保存函数引用。
(elem (i32.const 0) $myDouble) 在实例化时将函数 myDouble 的引用放入 Table 的第 0 项。elem 定义用于初始化表项的元素段,(i32.const 0) 指定起始表项索引。因此,初始化后 myTable 的第 0 项指向函数 myDouble,后续代码可以通过这个索引找到并调用它。元素段的定义见 WebAssembly Core Specification — Element Segments。
函数 myDouble 与运算指令
函数 myDouble 接收一个 32 位整数参数,将它乘以 2 后返回。func 表示定义函数,$myDouble 是自定义函数名,(param $myValue i32) 声明参数的名称和类型,(result i32) 声明返回值类型。函数体包含三条指令:
WebAssembly 使用操作数栈暂存参与计算的值。指令可以向栈顶放入值,也可以取出栈顶的值完成计算,再将结果放回。下面用方括号表示栈中的值,最右侧是栈顶。
local.get $myValue 读取参数 $myValue 的值,将它放到栈顶。local.get 用于读取函数参数或局部变量;本例传入 21 时,执行后栈中是 [21]。
i32.const 2 将常量 2 作为一个 32 位整数放到栈顶。const 表示常量,执行后栈中是 [21, 2]。
i32.mul 取出栈顶的两个 i32 值,相乘后将结果放回栈顶。mul 表示乘法,因此这里计算 21 × 2,执行后栈中是 [42]。函数执行到末尾时,这个 i32 值成为返回值。
函数 myRun 与间接调用
函数 myRun 从 Memory 读取输入,通过 Table 调用 myDouble,并返回计算结果。(export "myRun") 指定它的导出名称,(result i32) 声明返回一个 32 位整数。它的函数体为:
第一条 i32.const 0 将 0 放到栈顶,作为随后读取 Memory 的字节偏移量。i32.load 取出这个偏移量,从 Memory 的对应位置读取四个字节,将它们解释为一个 i32,再把读取的值放到栈顶。JavaScript 已在这个位置写入 21 时,栈中就得到 [21]。
第二条 i32.const 0 再将 0 放到栈顶,这次表示 Table 的表项索引。此时栈中是 [21, 0]:21 是准备传给函数的参数,0 是用于查找函数的索引。
call_indirect (type $myUnary) 根据栈顶的索引 0 查找 Table 中的函数引用,检查它是否符合 $myUnary 声明的类型,再将 21 作为参数调用函数 myDouble。myDouble 返回 42 后,myRun 将这个值返回给调用方。
这里两个 0 分别指向 Memory 的字节位置和 Table 的表项位置。call_indirect 的索引越界、表项为空或函数类型不匹配时,会触发 Trap。指令的执行规则见 WebAssembly Core Specification — Instructions。
从 WAT 转换为 Wasm
wat2wasm 是 WebAssembly Binary Toolkit 提供的命令行工具,用于将 .wat 文本转换为 .wasm 二进制文件。安装该工具后,在 my-example.wat 所在目录执行:
生成的 my-example.wasm 包含模块的类型、Memory、Table、函数和导出等信息,供 WebAssembly Runtime 加载。这个转换步骤生成的是 Wasm 二进制格式;后续由浏览器编译为可执行代码。
使用 Rust 开发时,编译器可以直接输出 .wasm,不需要先生成 .wat 文件。这里手写 WAT 是为了展示指令和声明,Rust 编译器的目标与产物说明见 wasm32-unknown-unknown — The rustc book。
Module 编译与 Instance 创建
浏览器读取 .wasm 文件后,通过 WebAssembly.compile() 得到 Module,再通过 WebAssembly.instantiate() 创建 Instance。下面的代码放在浏览器的 JavaScript 模块中运行,例如 HTML 的 <script type="module"> 内;my-example.wasm 与页面通过同一个 HTTP 服务提供:
const myResponse = await fetch("./my-example.wasm");
if (!myResponse.ok) {
  throw new Error(`Failed to fetch Wasm: ${myResponse.status}`);
}
const myBytes = await myResponse.arrayBuffer();

const myModule = await WebAssembly.compile(myBytes);
const myInstance = await WebAssembly.instantiate(myModule);
fetch() 获取文件,arrayBuffer() 取得其中的二进制字节。WebAssembly.compile(myBytes) 校验并编译这些字节,返回 Module 对象 myModule。
WebAssembly.instantiate(myModule) 根据模块声明创建实例 myInstance。本例会创建 Memory 和 Table,并根据 elem 声明将函数 myDouble 的引用写入 Table 的第 0 项。模块没有声明导入,因此这里无需传入导入对象;函数 myRun 在后续 JavaScript 调用时才执行。
同一个 Module 可以多次实例化。本例的 Memory 和 Table 由模块内部定义,因此每次实例化都会创建各自的内存和表。编译与实例化的 API 行为见 WebAssembly.compile() 和 WebAssembly.instantiate()。
JavaScript 写入 Memory
实例创建后,JavaScript 通过导出对象取得 Memory,并使用 DataView 按指定格式写入数据。下面的代码接在实例化代码之后:
const myView = new DataView(
  myInstance.exports.myMemory.buffer
);
myView.setInt32(0, 21, true);
myInstance.exports 包含模块导出的对象,其中 myMemory 对应 WAT 中的 (export "myMemory")。DataView 是这块内存的读写视图,JavaScript 通过它修改的字节,就是 Wasm 指令随后读取的字节。
setInt32(0, 21, true) 的三个参数分别指定字节偏移量 0、要写入的整数 21,以及使用小端字节序。WebAssembly 的内存读写采用小端字节序,因此写入后前四个字节为十六进制的 15 00 00 00。i32.load 从偏移量 0 读取它们时,得到整数 21。读写视图的用法见 DataView.prototype.setInt32()。
JavaScript 调用与返回结果
数据写入后,通过导出名 myRun 调用函数,并将返回值保存到变量 myResult:
const myResult = myInstance.exports.myRun();

console.log(myResult);                // 42
console.log(myView.getInt32(0, true)); // 21
这次调用依次完成读取 Memory、查找 Table、调用函数 myDouble 和返回结果。42 经 myDouble 返回给 myRun,再返回给 JavaScript;函数只读取了输入,因此 Memory 中保存的仍是 21。
除了调用 myRun(),JavaScript 还可以从 Table 中取出函数引用并直接调用。Table 以 myTable 为名导出,其中第 0 项保存函数 myDouble 的引用。JavaScript 通过 get(0) 取得这个引用,赋给变量 myFunction,再通过它调用 myDouble:
// 取得 myDouble 的函数引用,此时尚未执行函数
const myFunction = myInstance.exports.myTable.get(0);

// 调用 myDouble,传入 21,返回 42
console.log(myFunction(21)); // 42
这里的参数 21 由 JavaScript 直接传入,调用不经过 myRun,也不读取 Memory。图中的主流程则由 myRun 从 Memory 读取参数,再通过 Table 间接调用 myDouble。JavaScript 访问表项的接口见 WebAssembly.Table.prototype.get()。
文本与二进制格式
WebAssembly 提供二进制格式和文本格式,分别用于程序加载和人工阅读、编写与调试。两种格式的定义见 WebAssembly 规范中的 Binary Format 和 Text Format。
-
Wasm 二进制格式:通常使用
.wasm扩展名,包含模块的类型、函数、内存、表以及导入、导出等信息,供 WebAssembly Runtime 加载和执行。 -
WAT(WebAssembly Text Format):通常使用
.wat扩展名,通过(module …)、(func …)等语法描述模块结构和指令。WAT 的语法与示例见 Understanding WebAssembly text format。
可以使用 WebAssembly Binary Toolkit 中的 wat2wasm 将 .wat 转换为 .wasm,也可以使用 wasm2wat 将二进制文件转换为文本,查看模块结构和指令。使用 Rust、C/C++ 等语言开发时,通常由相应的编译工具链直接生成 .wasm 二进制文件,.wat 不是必需的中间产物。
组件模型与 WASI
Component Model(组件模型) 建立在 Core WebAssembly 之上,定义组件的封装、接口和组合方式。WIT 描述组件的接口,WASI 则提供标准化的接口集合。
-
Component(组件):可以封装 Core Module 和其他组件,通过带类型的导入、导出接口与宿主或其他组件交互。组件接口支持字符串、列表、记录等类型,便于不同语言编写的组件相互调用。
-
WIT(Wasm Interface Type):Component Model 使用的接口描述语言,通常使用
.wit扩展名。它声明函数、参数、返回值和数据类型,不包含函数的实现代码。其中,interface将相关的类型和函数组织在一起,world描述组件需要导入什么、对外导出什么。语法见 The WIT text format。 -
WASI(WebAssembly System Interface):一组面向 WebAssembly 应用的标准接口,涵盖文件系统、时钟、随机数、网络和 HTTP 等能力,具体范围取决于版本。应用通过这些接口使用宿主授予的资源,由运行时或宿主程序提供相应实现。WASI 0.2 基于 Component Model,使用 WIT 描述接口;应用也可以使用 WIT 定义自己的接口。接口范围与版本说明见 WASI Releases。
Wasm 组件示例
Rust 组件读取 /data/input.txt,按空白字符拆分单词,通过 WIT 接口返回单词列表与数量。Wasmtime 宿主将本地 data/ 以只读权限提供给组件,再调用 my-analyze。文件内容为 hello wasm world 时,组件返回三个单词和 count = 3。
图:Core WebAssembly、Component、WIT 与 WASI,以及宿主调用文件统计组件的流程。
WIT 接口
my-analyzer 接口包含返回类型 my-report 和函数 my-analyze。my-app world 声明导出这个接口。
package example:my-tools;

interface my-analyzer {
    record my-report {
        words: list<string>,
        count: u64,
    }

    my-analyze: func(path: string) -> result<my-report, string>;
}

world my-app {
    export my-analyzer;
}
package example:my-tools定义接口所在的包,组件导出的完整接口名为example:my-tools/my-analyzer。record my-report定义返回记录,words是字符串列表,count是 64 位无符号整数。my-analyze接收字符串路径;成功时返回my-report,读取失败时返回错误字符串。world my-app定义组件的接口契约。源码在这里声明自定义业务导出。Rust 标准库通过 WASI 接口读取文件,工具链会在组件中自动添加相应的导入声明。
生成 Rust 绑定
执行 cargo build 时,组件和宿主分别通过 Rust 宏读取同一份 WIT,生成各自使用的接口代码。
从仓库根目录进入示例目录,编译 Wasm 组件和宿主程序:
cd examples/chapter-01/07-container-runtime/09-wasm/component-wit-wasi

# 编译 Wasm 组件
cargo build --locked --release \
  --package my-component \
  --target wasm32-wasip2 \
  --target-dir target

# 编译当前平台的宿主程序
host_target="$(rustc -vV | sed -n 's/^host: //p')"
cargo build --locked --release \
  --package my-host \
  --target "$host_target" \
  --target-dir target
编译组件时,wit_bindgen::generate! 生成 Guest trait、MyReport 类型和导出代码。这些绑定与手写的 Guest::my_analyze 业务实现一起编译为 target/wasm32-wasip2/release/my_component.wasm,供宿主加载。
编译宿主时,wasmtime::component::bindgen! 生成 MyApp、MyReport 类型以及 call_my_analyze 等调用方法。这些绑定与宿主代码一起编译为当前平台的原生可执行文件 target/$host_target/release/my-host,用于加载并调用组件。
上述 Rust 绑定在编译时自动生成,本例不需要单独执行 WIT 编译命令。WIT 定义与两侧 Rust 绑定的名称对应关系如下:
| WIT 定义 | 组件侧 Rust 绑定 | 宿主侧 Rust 绑定 |
|---|---|---|
record my-report |
MyReport 结构体,供组件构造返回结果 |
MyReport 结构体,供宿主接收返回结果 |
my-analyzer 接口 |
my_analyzer 模块,组织该接口的类型与函数声明 |
my_analyzer 模块,组织该接口的类型与调用方法 |
包 example:my-tools 中的 export my-analyzer |
my_analyzer::Guest trait,声明组件需要实现的接口函数 |
example_my_tools_my_analyzer() 方法,取得这个导出接口的绑定 |
my-analyze 函数 |
Guest::my_analyze,由组件编写业务实现 |
call_my_analyze,由宿主调用组件中的业务函数 |
结构体名采用大驼峰,函数名和模块名采用小写单词加下划线。example_my_tools_my_analyzer() 由 Wasmtime 根据完整接口名 example:my-tools/my-analyzer 生成:example 是包命名空间,my-tools 是包名,my-analyzer 是接口名。三部分转为下划线形式后,组成这个接口访问方法的名称。
宿主先通过 instance.example_my_tools_my_analyzer() 取得接口绑定,再通过其 call_my_analyze(...) 方法调用组件函数。call_ 前缀由 Wasmtime 的绑定工具添加,表示这是宿主侧的调用方法。两侧根据 WIT 中的接口名和函数名建立对应关系,组件实现方法 my_analyze 与宿主调用方法 call_my_analyze 的 Rust 名称可以不同。
Rust 组件
wit-bindgen 为导出的 my-analyzer 接口生成名为 Guest 的 trait,其中声明 my_analyze 函数。Guest 是工具统一使用的名称,不同接口通过模块路径区分,本例位于 my_analyzer 模块。
MyComponent 通过 impl Guest for MyComponent 实现 my_analyze,再由 export!(MyComponent) 将实现连接到组件的导出接口。生成规则见 Exports: Multiple Interfaces。
下面是组件的完整业务实现:
mod bindings {
    // 根据 WIT 生成 Rust 类型、Guest trait 和组件导出绑定。
    wit_bindgen::generate!({
        path: "../wit",
        world: "my-app",
    });

    use super::MyComponent;
    export!(MyComponent);
}

use bindings::exports::example::my_tools::my_analyzer::{Guest, MyReport};

struct MyComponent;

impl Guest for MyComponent {
    fn my_analyze(path: String) -> Result<MyReport, String> {
        // 路径属于组件的文件系统视图,由宿主通过 WASI 授予访问权限。
        let contents = std::fs::read_to_string(&path)
            .map_err(|error| format!("Failed to read {path}: {error}"))?;
        Ok(analyze_contents(&contents))
    }
}

fn analyze_contents(contents: &str) -> MyReport {
    // 使用 Unicode 空白字符分词,保留原有顺序和重复单词。
    let words: Vec<String> = contents.split_whitespace().map(str::to_owned).collect();
    MyReport {
        count: words.len() as u64,
        words,
    }
}
MyComponent 实现 Guest::my_analyze。每次调用时,std::fs::read_to_string 读取指定路径的 UTF-8 文本;文件不存在、目录未授权或内容不是 UTF-8 时,通过 Result 返回错误字符串。
split_whitespace 按 Unicode 空白字符拆分文本,保留单词顺序和重复项,再构造 MyReport。WIT 中的 list<string> 在 Rust 中对应 Vec<String>,u64 对应 Rust 的 u64。
宿主授权与接口调用
宿主将 Wasmtime 作为 Rust 库嵌入自己的进程。下面的完整 main 函数读取命令行参数、加载组件、配置 WASI 资源,再调用组件的文件统计接口并打印结果:
fn main() -> Result<()> {
    let args: Vec<_> = std::env::args_os().skip(1).collect();
    let [component_path, host_data_dir, guest_path] = args.as_slice() else {
        wasmtime::bail!("Usage: my-host <component.wasm> <host-data-dir> <guest-path>");
    };
    let guest_path = guest_path
        .to_str()
        .ok_or_else(|| wasmtime::format_err!("Guest path must be valid UTF-8"))?;

    let engine = Engine::default();
    let component = Component::from_file(&engine, Path::new(component_path))?;
    let mut wasi = WasiCtxBuilder::new();
    wasi.inherit_stderr();
    // 仅把指定宿主目录映射为组件中的 /data,并授予只读权限。
    wasi.preopened_dir(Path::new(host_data_dir), "/data", FsPerms::ReadOnly)?;

    let (mut store, instance) = instantiate(&engine, &component, wasi.build())?;
    let report = instance
        .example_my_tools_my_analyzer()
        .call_my_analyze(&mut store, guest_path)?
        .map_err(|message| wasmtime::format_err!("{message}"))?;
    println!("words = {:?}", report.words);
    println!("count = {}", report.count);
    Ok(())
}
读取命令行参数
args_os().skip(1) 跳过程序名,收集后面的参数。切片解构要求传入三个参数,数量不符时通过 wasmtime::bail! 返回用法错误:
component_path:组件二进制文件的路径,例如target/wasm32-wasip2/release/my_component.wasm。host_data_dir:允许组件访问的宿主目录,例如./data。guest_path:传给组件的文件路径,例如/data/input.txt。
WIT 中的 path 参数是字符串,因此 guest_path.to_str() 将组件内路径转换为 UTF-8 字符串引用;转换失败时返回错误。组件文件和宿主目录仍通过 Path::new 作为操作系统路径使用。
加载组件与配置 WASI
Engine::default() 创建使用默认配置的 Wasmtime 引擎,Component::from_file 读取并编译 component_path 指定的组件。WasiCtxBuilder::new() 创建 WASI 上下文构建器,随后配置组件可以使用的资源:
inherit_stderr():让组件使用宿主的标准错误输出,便于输出错误信息。preopened_dir(host_data_dir, "/data", FsPerms::ReadOnly):将指定的宿主目录以/data提供给组件,并授予只读访问权限。宿主目录为./data时,组件读取/data/input.txt,访问的是宿主的./data/input.txt。目录授权的 API 说明见 WasiCtxBuilder::preopened_dir。
创建组件实例
wasi.build() 根据上述配置创建 WASI 上下文。instantiate 是本例定义的辅助函数:它通过 wasmtime_wasi::p2::add_to_linker_sync 注册 WASI 0.2 的宿主实现,创建 Store,再调用绑定工具生成的 MyApp::instantiate 创建组件实例。注册接口实现与授予目录权限分别决定宿主提供哪些能力、组件可以访问哪些目录。
返回的 store 保存执行状态和 WASI 上下文等宿主状态;instance 是生成的 MyApp 类型的绑定对象,提供组件导出接口的访问方法。
调用组件接口
let report = instance... 通过接口绑定调用组件函数,并处理调用结果:
example_my_tools_my_analyzer():根据 WIT 包名example:my-tools和接口名my-analyzer生成的访问方法,取得这个导出接口的绑定。call_my_analyze(&mut store, guest_path):Wasmtime 自动生成的调用方法,通过store执行组件函数,并将guest_path传给组件侧实现的my_analyze。call_my_analyze(...)后的?:处理外层Result,在发生 Trap 等运行时错误时返回;调用正常完成后,得到 WIT 定义的Result<MyReport, String>。.map_err(...)?:将内层的业务错误字符串转换为宿主错误并返回;成功时取出MyReport,赋给report。
输出结果
两个 println! 由宿主打印 report.words 和 report.count。main 返回 Result<()>,Ok(()) 表示正常结束;前面任一步通过 ? 返回错误时,程序会提前结束。
运行
在示例目录中运行宿主程序,加载组件并读取 /data/input.txt。
"./target/$host_target/release/my-host":要执行的原生宿主程序,负责通过内嵌的 Wasmtime 加载并调用组件。target/wasm32-wasip2/release/my_component.wasm:第一个参数,对应component_path,指定宿主需要加载的 Wasm 组件文件。./data:第二个参数,对应host_data_dir,指定宿主上的数据目录。宿主将其以只读权限映射为组件中的/data。/data/input.txt:第三个参数,对应guest_path,是传给组件函数my_analyze的文件路径。组件读取此路径时,实际访问宿主的./data/input.txt。
host_target="$(rustc -vV | sed -n 's/^host: //p')"
"./target/$host_target/release/my-host" \
  target/wasm32-wasip2/release/my_component.wasm ./data /data/input.txt
输出:
查看组件结构
完成组件构建后,inspect.sh 从构建产物生成完整 WIT 与文本表示,分别保存为 generated/component.wit 和 generated/component.wat,并打印组件的导入和导出。WAT 去掉了 DWARF 调试信息,保留完整的函数体、数据段和接口结构。安装工具并生成文件:
本例固定工具链生成的文件系统和数据流接口版本为 0.2.6。完整组件还包含 Rust 标准库引入的 CLI、终端、I/O 轮询与时钟类型等依赖;导入列表表示组件需要宿主提供的接口,不表示一次 my-analyze 调用会使用其中的全部功能。
在 component.wat 中搜索 table、call_indirect、$imports,可以查看函数引用表、间接调用和辅助模块的连接;搜索 canon lift、canon lower 可以看到 Canonical ABI 的接口转换。完整源码、导入列表和自动检查命令见 Rust Component、WIT 与 WASI。
Wasm 运行时
Wasm 运行时负责加载和执行 Wasm 程序,常见实现包括:
-
Wasmtime:由 Bytecode Alliance 开发,是支持 WebAssembly、WASI 和 Component Model 的独立运行时。它在浏览器之外运行 WebAssembly 程序,既可作为命令行工具使用,也可作为库嵌入其他应用。
-
WasmEdge:面向云原生和边缘计算的运行时,是 CNCF 沙箱项目。可以独立运行 Wasm,也可以嵌入 Rust、C/C++、Go 等语言编写的宿主程序。提供 Socket、数据库访问和 AI 推理等扩展。
-
Wasmer:提供命令行工具和可嵌入其他程序的 WebAssembly 运行时库。可在服务器或浏览器中运行 Wasm,并控制文件、网络和环境变量访问。支持 WASIX 扩展,为程序提供线程、Socket 和进程相关接口。
-
WAMR(WebAssembly Micro Runtime):面向嵌入式设备、物联网和边缘计算等场景的轻量级运行时。支持解释执行、提前编译(AOT)和即时编译(JIT)。
Wasm 应用开发
开发 WebAssembly 应用的常见方式有以下几种:
-
C/C++:使用 Emscripten 工具链,通过 Clang 和 LLVM 将源码编译为 Wasm。面向浏览器时,Emscripten 还会生成配套的 JavaScript 代码,用于加载模块、连接浏览器 API,并为编译后的程序提供运行支持。
-
Rust:通过 Rust 编译器支持的 WebAssembly 目标生成 Wasm。面向浏览器时,可以使用
wasm-pack构建,并通过wasm-bindgen生成 Rust 与 JavaScript 交互所需的绑定,具体步骤见 Compiling from Rust to WebAssembly。面向服务器等环境时,Rust 也支持通过 WASI 编译目标生成 Wasm,并由 Wasmtime 等支持 WASI 的运行时加载和执行。 -
AssemblyScript:使用接近 TypeScript 的语法编写代码,再通过
asc编译器生成 Wasm。它提供与 WebAssembly 对应的数值类型,并对语言特性作出限制,不能直接编译任意 TypeScript 项目。语言与编译方式见 AssemblyScript Introduction。 -
直接编写 WAT:使用 WebAssembly 文本格式描述函数、内存、导入和导出,再通过 WABT 中的
wat2wasm等工具转换为.wasm二进制文件。这种方式适合学习指令、编写小型模块或开发编译工具,转换步骤见 Converting WebAssembly text format to binary。
这里以 Rust HTTP 服务为例,将程序编译为 WebAssembly 组件,并使用 Wasmtime 运行。程序使用 WASI 0.2 的 wasi:http 接口,编译目标为 wasm32-wasip2。Wasmtime 接收 HTTP 请求后调用组件,组件返回一段 Hello 文本。
Wasmtime 是 Bytecode Alliance 开发的 WebAssembly 运行时,可以在浏览器之外加载和执行 Wasm,并提供 WASI 接口,使程序能够使用文件、网络等宿主能力。
Rust 编译时需要指定目标,决定生成的程序面向哪种运行环境。这里使用 wasm32-wasip2:wasm32 表示采用 32 位指针的 WebAssembly 目标,wasip2 表示面向 WASI Preview 2,也就是 WASI 0.2。
相比 WASI 0.1,WASI 0.2 基于 Component Model(组件模型),使用 WIT 描述接口,支持不同语言编写的组件相互调用和组合。它还扩展了网络接口,通过 wasi:sockets 提供 TCP、UDP 和域名解析,通过 wasi:http 提供 HTTP 请求与响应处理能力。具体介绍见 WASI 0.2。
HTTP 请求处理函数
示例使用 wstd 编写基于 WASI 0.2 的异步 HTTP 服务。wstd 提供请求、响应和正文流的 Rust API。
在 Cargo.toml 中配置构建方式和依赖,使用 wstd 0.6.8:
[package]
name = "sample-wasi-http-rust" # 包名
version = "0.0.0"              # 包版本
edition = "2021"               # 使用 Rust 2021 Edition
publish = false               # 禁止通过 cargo publish 发布

[lib]
# 以 cdylib 形式构建,配合 wasm32-wasip2 目标生成 Wasm 组件
crate-type = ["cdylib"]

[dependencies]
# 提供 WASI 0.2 的 Rust API,包括异步 HTTP 接口
wstd = "0.6.8"
main 接收 Request<Body>,并直接返回包含 Hello 文本的 Response<Body>。参数 _req 表示收到的请求,名称前的下划线表示这里未使用这个参数:
use wstd::http::{Body, Request, Response, Result};

// 生成 wasi:http 请求处理入口,由 Wasmtime 调用。
#[wstd::http_server]
async fn main(_req: Request<Body>) -> Result<Response<Body>> {
    // 将字符串作为响应体返回。
    Ok(Response::new("Hello, wasi:http/proxy world!\n".into()))
}
#[wstd::http_server] 是 Rust 属性宏,要求被标注的函数名为 main。它在编译时为函数生成适配代码,使组件导出 wasi:http/incoming-handler 接口。这个接口由 WASI HTTP 标准定义,供宿主调用组件来处理收到的 HTTP 请求。
运行时,wasmtime serve 监听服务端口,收到请求后调用该接口的 handle 函数。wstd 将 WASI 请求转换为 Rust 的 Request<Body>,交给 main 处理,再将函数返回的 Response<Body> 转换为 WASI 响应,由 Wasmtime 发回客户端。
编译与运行
Cargo 调用 rustc 及 LLVM 后端,将 Rust 源码和依赖编译为 Wasm。wasm32-wasip2 目标直接生成 Component,文件名以 .wasm 结尾;目标的接口与平台要求见 wasm32-wasip2。
图:Rust HTTP 组件的编译与运行。Cargo 编译应用,Wasmtime 加载组件并提供 WASI HTTP 宿主接口。
以下命令使用 Rust 1.94.0 和 Wasmtime 49.0.1。Rust 工具链由示例目录中的 rust-toolchain.toml 指定,Wasmtime 的安装方式见 Installation。
cd examples/chapter-01/07-container-runtime/09-wasm/http-wasmtime
rustup target add wasm32-wasip2
cargo build --release --target wasm32-wasip2
产物位于 target/wasm32-wasip2/release/sample_wasi_http_rust.wasm。使用 wasmtime serve 加载这个组件,并监听本机的 18081 端口。命令中的两个 WASI 参数含义如下:
-Scli:为组件提供通用 WASI 接口。本例的编译产物导入了wasi:cli/environment,需要此参数提供对应实现。-Shttp:启用 WASI HTTP 接口。Wasmtime49.0.1的serve默认启用这些接口,这里也可以省略此参数。
wasmtime serve --addr 127.0.0.1:18081 -Scli -Shttp \
  target/wasm32-wasip2/release/sample_wasi_http_rust.wasm
启动后输出监听地址:
HTTP 请求路径
客户端发送的 HTTP 字节先由宿主操作系统的 TCP/IP 协议栈交给 Wasmtime。Wasmtime 进程中的 Tokio 接收连接,Hyper 解析 HTTP/1 请求,再通过 wasi:http/incoming-handler 调用组件。监听与连接处理见 Wasmtime HTTP Server。
图:Wasmtime 的 HTTP 请求路径。宿主 HTTP Server 与组件运行在同一个 Wasmtime 进程中。
组件中的 main 函数构造包含 Hello 文本的 Response<Body>。wstd 将状态码和响应头写入 WASI 的响应对象,通过 response-outparam 提交响应,再发送正文流。Wasmtime 将这些内容交给 Hyper 编码为 HTTP 响应,经 Socket 返回客户端。响应转换过程见 wstd HTTP response handling。
请求与响应
保持服务运行,在另一个终端访问首页:
Wasm 的容器化运行
Wasm 应用有三种常见的容器化运行方式:
- 普通 Linux 容器:将 Wasm Runtime 和模块一起打包进容器镜像,按普通 Linux 容器启动 Runtime 进程。Runtime 再加载并执行模块,例如将
wasmtime run /hello.wasm设为容器入口。 - 支持 Wasm 的 OCI Runtime:由 OCI Runtime 集成的 Wasm 引擎执行模块,例如在构建 Youki 时集成 Wasmtime。应用镜像只需提供模块和数据,执行引擎随 Youki 安装在节点上。
- 支持 Wasm 的 containerd Shim:例如,containerd 通过
containerd-shim-wasmtime-v1启动和管理 Wasm 任务,由 Shim 内置的 Wasmtime 引擎加载并执行镜像中的模块。
性能差异
Runwasi Benchmarks 使用相同的 Wasm 工作负载,分别通过普通 Linux 容器(runc + Wasmtime)和 Wasmtime Shim 执行 1000 个任务。测试中,Wasmtime Shim 的任务吞吐量约为普通容器方式的 3.9 倍。
| 运行方式 | 总耗时 | 任务吞吐量 |
|---|---|---|
普通 Linux 容器:runc distroless wasmtime |
约 11.795 s | 84.78 tasks/s |
支持 Wasm 的 containerd Shim:runwasi wasmtime |
约 3.032 s | 329.85 tasks/s |
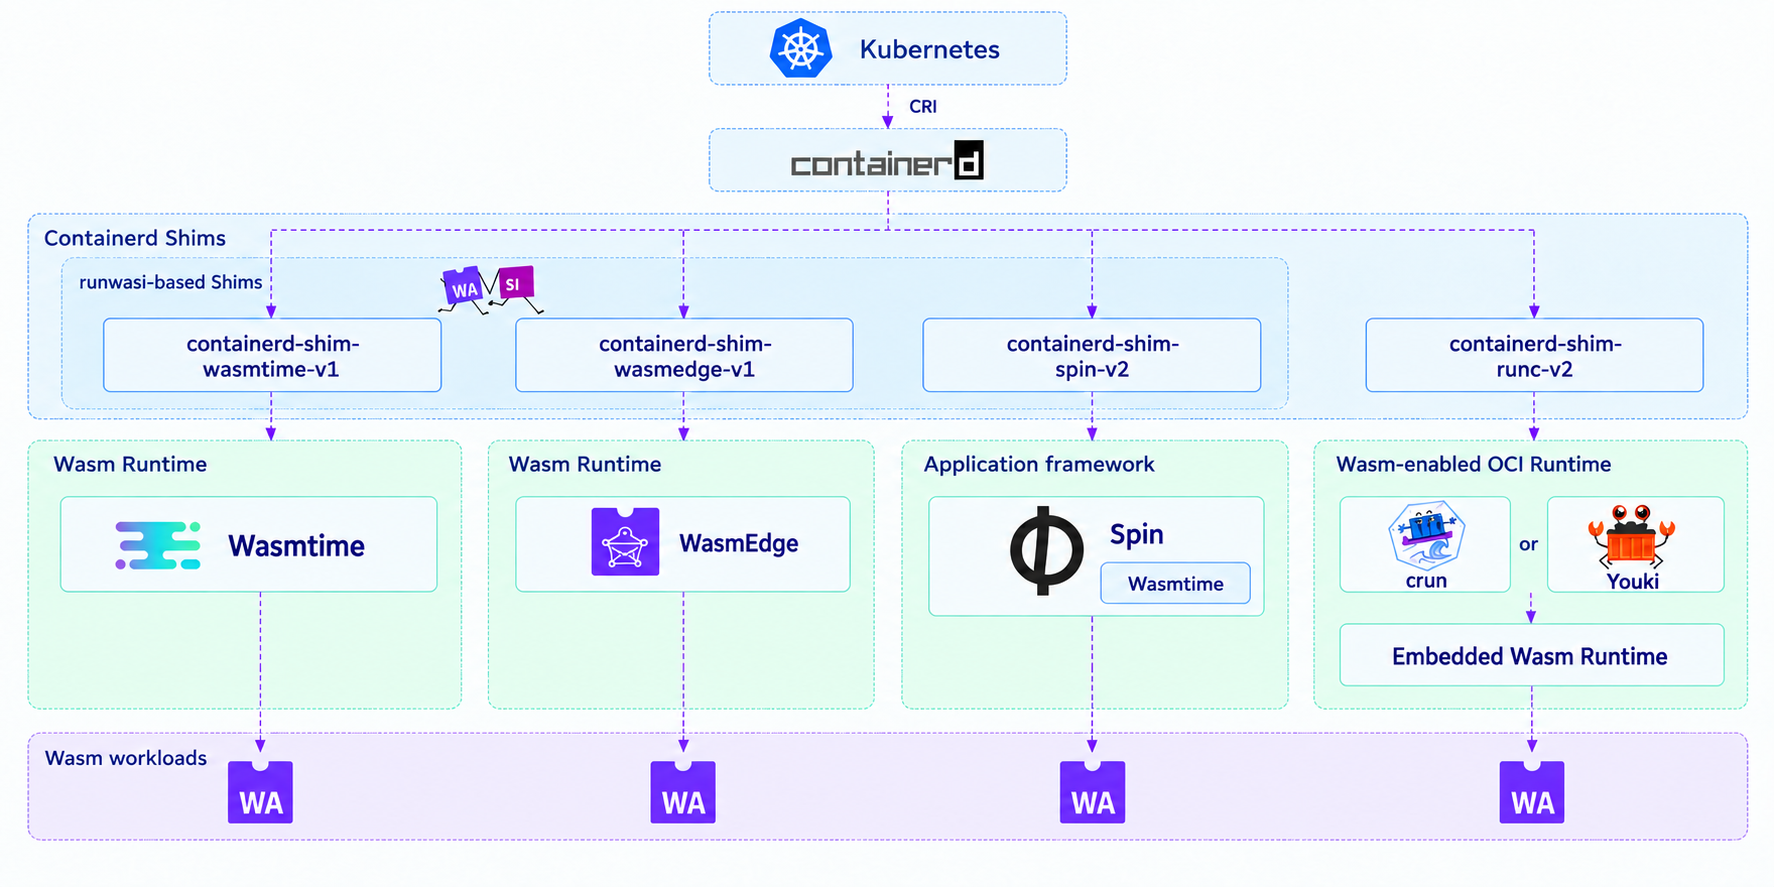
图:containerd 通过专用 Wasm Shim 或支持 Wasm 的 OCI Runtime 执行模块。
接下来使用一个简单的 Rust 程序 hello.rs,展示三种 Wasm 容器化运行方式:
fn main() {
    println!("Hello from Wasm!");
}
编译 Wasm 模块
将 hello.rs 编译为 WASI Preview 1 模块 hello.wasm,供三种运行方式复用。工具链安装见 Wasm 镜像构建。以下模块编译和镜像构建命令均在 examples/chapter-01/07-container-runtime/09-wasm/containers/ 目录执行:
mkdir -p shared/artifacts
rustc +1.89.0 --target wasm32-wasip1 \
  shared/hello.rs -o shared/artifacts/hello.wasm
普通 Linux 容器
将 Wasmtime CLI、Wasm 模块及所需依赖打包进 Linux 容器镜像,容器启动时由 Wasmtime 加载并执行 Wasm 模块。
普通 Linux 容器示例
将 Wasmtime 编译为静态程序,再与 Wasm 模块一起放入 scratch 镜像:
FROM rust:1.96 AS build

RUN rustup target add x86_64-unknown-linux-musl
RUN apt-get update && apt-get install -y musl-tools

RUN cargo install wasmtime-cli --version 49.0.1 \
    --target x86_64-unknown-linux-musl \
    --profile fastest-runtime

FROM scratch
COPY --from=build /usr/local/cargo/bin/wasmtime /wasmtime
COPY shared/artifacts/hello.wasm /hello.wasm
ENTRYPOINT ["/wasmtime", "run", "/hello.wasm"]
构建镜像并通过 runc 启动容器:
sudo docker build --platform linux/amd64 \
  -f linux-container/Dockerfile -t wasm-hello-runtime:v1 .
sudo docker run --rm --runtime runc wasm-hello-runtime:v1
输出结果为:
支持 Wasm 的 OCI Runtime
Youki 可以在构建时通过 wasm-wasmtime 功能集成 Wasmtime。Docker 将容器交给 Youki 后,Youki 根据 OCI 注解 run.oci.handler=wasm 选择 Wasm executor,加载镜像中的模块。构建 Youki 时集成 Wasmtime 引擎,应用镜像只需包含 Wasm 模块和所需数据。
构建 Wasm OCI 镜像
使用已编译的 hello.wasm 构建 OCI 镜像 wasm-hello:v1,供支持 Wasm 的 OCI Runtime 和 containerd Shim 运行。Dockerfile 将模块放在 /hello.wasm 并设为入口:
FROM scratch
COPY shared/artifacts/hello.wasm /hello.wasm
WORKDIR /
ENTRYPOINT ["/hello.wasm"]
构建一次镜像,后续两种运行方式直接使用它:
sudo docker buildx build --platform linux/amd64 --provenance=false --load \
  -f shared/Dockerfile -t wasm-hello:v1 .
命令以 containers/ 为构建上下文,使用 Buildx 将镜像加载到本机 Docker。镜像采用普通容器文件系统层,平台为 linux/amd64;其中的模块仍为 wasm32-wasip1。构建和运行命令需连接同一个 Docker daemon。
支持 Wasm 的 OCI Runtime 示例
本例以 Youki 为例,通过其内置的 Wasmtime 执行 Wasm OCI 镜像中的模块。
前置准备
在 Docker daemon 所在主机准备 Rust 工具链和系统依赖,具体要求见 Youki 内置 Wasmtime。
编译 Youki
下载 Youki 源码,编译时启用 wasm-wasmtime,将 Wasmtime 引擎集成到 Youki 中。
git clone --depth 1 --branch v0.7.0 https://github.com/youki-dev/youki.git
cd youki
cargo +1.96.0 build --release --package youki \
  --target x86_64-unknown-linux-gnu \
  --features wasm-wasmtime,systemd,seccomp,cgroupsv2_devices
编译产物位于 target/x86_64-unknown-linux-gnu/release/youki。
安装并配置 Docker
将编译好的 Youki 安装到 Docker 配置使用的路径:
将以下 runtimes.youki 配置合并到 /etc/docker/daemon.json,保留已有内容。Docker 通过 containerd-shim-runc-v2 调用指定的 Youki 程序,配置方式见 Alternative container runtimes。
{
  "runtimes": {
    "youki": {
      "path": "/usr/local/bin/youki"
    }
  }
}
检查配置并重新加载 Docker:
使用已构建的共用镜像,通过 OCI 注解选择 Wasm executor:
sudo docker run --rm --pull never --platform linux/amd64 --runtime youki \
  --annotation run.oci.handler=wasm --workdir / wasm-hello:v1
输出结果为 Hello from Wasm!。
支持 Wasm 的 containerd Shim
runwasi 提供开发 Wasm Shim 的库及参考实现。这里使用 containerd-shim-wasmtime-v1:containerd 通过 Runtime v2 接口将任务交给 Shim,由其中集成的 Wasmtime 加载模块,镜像只需包含模块和应用数据。任务管理与执行引擎的关系见 Architecture Overview。
Wasmtime Shim 示例
Docker 运行 Wasmtime Shim 需要启用 containerd image store,配置方法见 containerd image store with Docker Engine。启用后,按 构建 Wasm OCI 镜像 准备镜像;若切换存储后原有镜像不可见,在当前存储中重新构建即可。
下载并校验 Shim,然后安装到 /usr/local/bin。若已有同名程序,先确认是否替换。安装要求见 Wasmtime Shim 运行 Wasm。
cd examples/chapter-01/07-container-runtime/09-wasm/containers/wasmtime-shim
mkdir -p artifacts
curl -fL \
  'https://github.com/containerd/runwasi/releases/download/containerd-shim-wasmtime%2Fv0.6.1/containerd-shim-wasmtime-x86_64-linux-musl.tar.gz' \
  -o artifacts/shim.tar.gz
echo 'a9b1215ee670f11414c8fd8e970b52679085929c8ec73a0fe6ed9cf215cf9ba1  artifacts/shim.tar.gz' | sha256sum --check && \
tar -xzf artifacts/shim.tar.gz -C artifacts ./containerd-shim-wasmtime-v1 && \
sudo install -m 0755 artifacts/containerd-shim-wasmtime-v1 /usr/local/bin/containerd-shim-wasmtime-v1
/usr/local/bin 需要位于 Docker daemon 及其 containerd 进程可见的 PATH 中。Shim 内置 Wasmtime,Docker 通过 io.containerd.wasmtime.v1 选择它,集成方式见 Alternative container runtimes。
通过 --runtime io.containerd.wasmtime.v1 运行同一个共用镜像:
sudo docker run --rm --pull never --platform linux/amd64 \
  --runtime io.containerd.wasmtime.v1 wasm-hello:v1
预期输出:
Kubernetes 中运行容器
RuntimeClass
RuntimeClass 是 Kubernetes 中用于选择容器运行时配置的集群级资源,不属于任何 Namespace。Pod 通过 spec.runtimeClassName 引用它,从而选择运行该 Pod 的运行时及其配置,例如使用 crun 运行普通 Linux 容器,或使用 Kata Containers 在 VM 内运行容器。
RuntimeClass 的关键字段包括:
metadata.name:RuntimeClass 的名称,供 Pod 的spec.runtimeClassName引用。handler:节点上已注册的运行时配置名称。Kubelet 将它传给 CRI Runtime,由后者选择对应配置;它可以与metadata.name不同。scheduling:可选的调度约束。nodeSelector将 Pod 限定到支持该运行时的节点,tolerations为 Pod 添加对应的污点容忍。只在部分节点安装运行时时,可用这个字段匹配已准备好的节点。overhead:可选的 Pod 固定资源开销。通过podFixed声明运行时额外需要的 CPU、内存等资源,使 Kubernetes 在调度和资源管理时计入这些开销,字段定义见 RuntimeClass API。
Pod 未设置 runtimeClassName 时,使用节点的默认 Runtime Handler。RuntimeClass 所引用的运行时程序和节点配置,需要由管理员预先安装和注册。
下图展示 Wasm 和 Kata 两种运行方式:Pod 引用对应的 RuntimeClass,scheduling.nodeSelector 按节点标签限定候选节点池,handler 则选择节点 containerd 中的运行时配置。
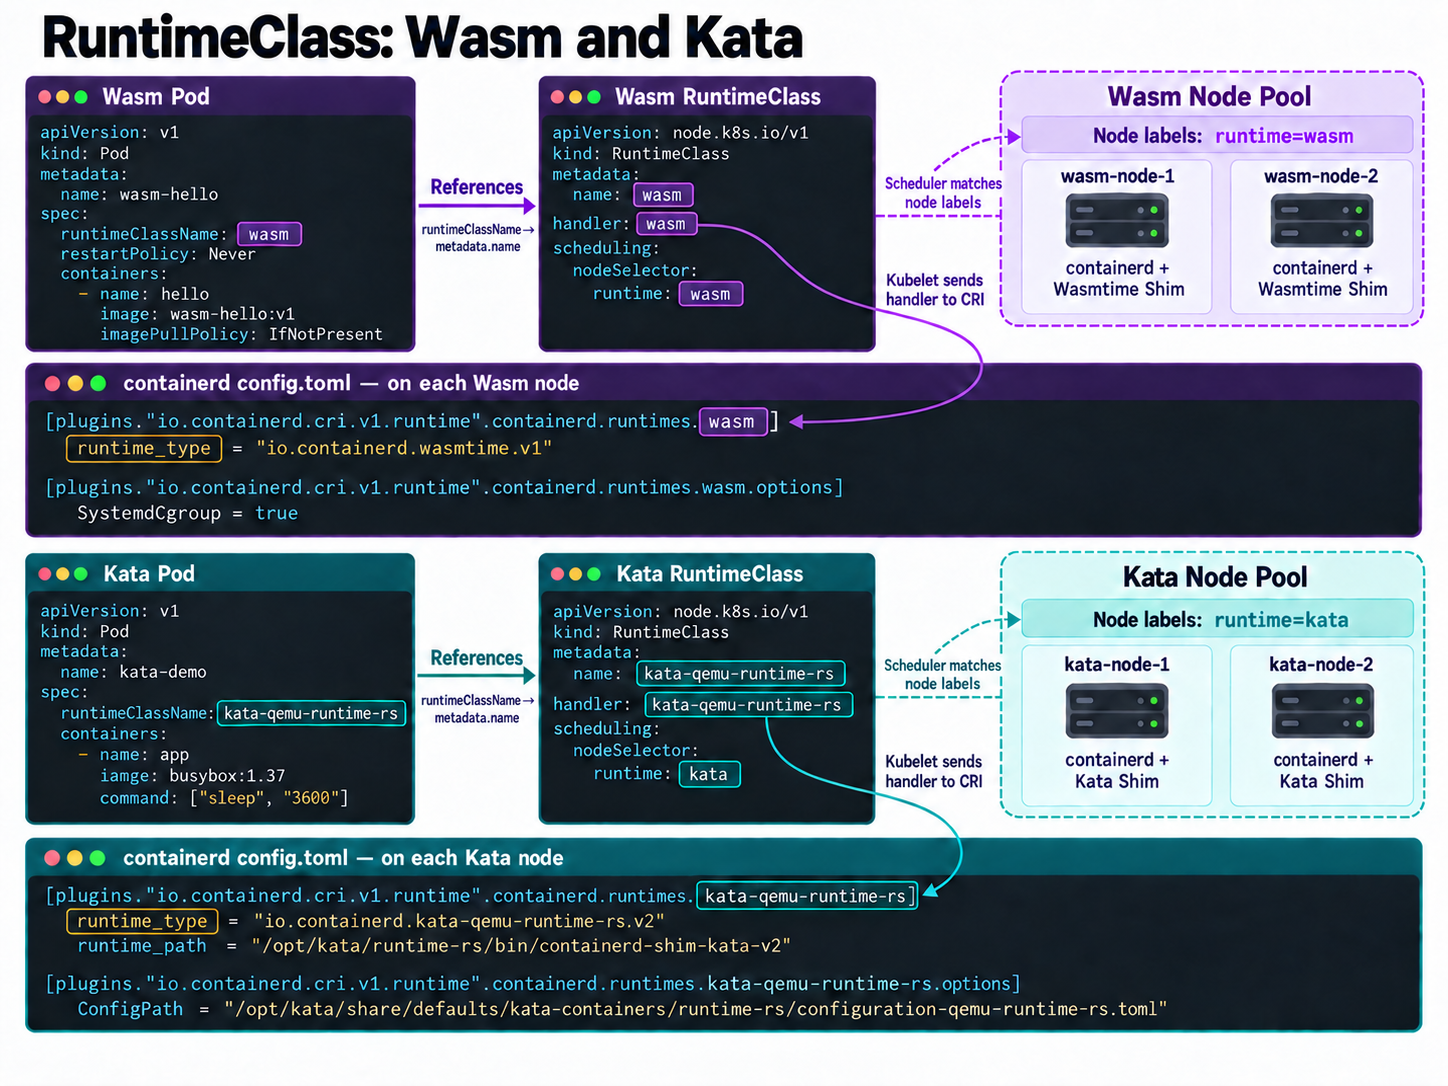
图:nodeSelector 匹配各节点的标签,handler 对应节点上的 containerd 运行时配置;配置框展示关键字段。
Runtime Handler
Runtime Handler 是 CRI 用于选择节点运行时配置的标识。containerd 和 CRI-O 都支持这一机制:Kubelet 将 RuntimeClass 的 handler 写入 CRI 请求的 runtime_handler,由节点运行时查找对应配置,确定使用的运行时及其参数。两者的配置入口见 Runtime Class。
以下以 containerd 为例,在节点的 /etc/containerd/config.toml 中配置不同运行时的 Handler。详细配置参考 CRI Plugin Config Guide:
# 默认 Runtime Handler
[plugins."io.containerd.cri.v1.runtime".containerd]
  default_runtime_name = "runc"

# runc
[plugins."io.containerd.cri.v1.runtime".containerd.runtimes.runc]
  runtime_type = "io.containerd.runc.v2"

# crun
[plugins."io.containerd.cri.v1.runtime".containerd.runtimes.crun]
  runtime_type = "io.containerd.runc.v2"
[plugins."io.containerd.cri.v1.runtime".containerd.runtimes.crun.options]
  BinaryName = "/usr/bin/crun"

# Kata Containers:Rust Shim 与 QEMU 配置
[plugins."io.containerd.cri.v1.runtime".containerd.runtimes.kata-qemu-runtime-rs]
  runtime_type = "io.containerd.kata-qemu-runtime-rs.v2"
  runtime_path = "/opt/kata/runtime-rs/bin/containerd-shim-kata-v2"
[plugins."io.containerd.cri.v1.runtime".containerd.runtimes.kata-qemu-runtime-rs.options]
  ConfigPath = "/opt/kata/share/defaults/kata-containers/runtime-rs/configuration-qemu-runtime-rs.toml"

# gVisor
[plugins."io.containerd.cri.v1.runtime".containerd.runtimes.runsc]
  runtime_type = "io.containerd.runsc.v1"

# Wasmtime Shim
[plugins."io.containerd.cri.v1.runtime".containerd.runtimes.wasm]
  runtime_type = "io.containerd.wasmtime.v1"
default_runtime_name:指定默认 Handler;Pod 未设置runtimeClassName时使用它,示例中为runc。runtimes.<名称>:注册 Handler 名称,与 RuntimeClass 的handler对应,例如runtimes.runsc对应handler: runsc。runtime_type:指定使用的 Shim 类型。runc 和 crun 共用io.containerd.runc.v2,其他运行时使用各自的 Shim。options.BinaryName:指定 runc v2 Shim 调用的 OCI Runtime 程序;默认使用runc,示例通过/usr/bin/crun改为使用 crun。-
runtime_path:显式指定 Shim 的可执行文件路径,示例中指向 Kata 的 Rust Shim。未设置时,containerd 会根据runtime_type自动推导 Shim 文件名,并在 containerd 服务的PATH中查找,例如: -
options.ConfigPath:指定运行时配置文件,示例中选择 Kata 的 QEMU 配置。
相关资料
- Kubernetes Container Runtime Interface
- What Is Container Runtime Interface (CRI)?
- containerd v2.3.4 documentation
- containerd: Project Update and Deep Dive — KubeCon Europe 2023 官方议程
- containerd: Project Update and Deep Dive — KubeCon Europe 2023 CNCF 视频
- CRI-O v1.36.4
- OCI Runtime Specification v1.3.0
- gVisor documentation
- Kata Containers 4.1 documentation
- runwasi documentation
- WebAssembly on Kubernetes: from containers to Wasm (part 01)
- WebAssembly on Kubernetes: the practice guide (part 02)
- Understanding Container Runtimes: Static vs Dynamic and Runtime Isolation