网络:通信与流量转发
Kubernetes 中的应用通常由多个可以独立调度和重建的 Pod 组成。Pod 可能运行在不同节点上,位置和地址也会随着重建、扩缩容发生变化。集群网络需要在这些变化中保持 Pod 之间的连通,为客户端提供稳定的访问入口,并隔离不应互通的流量。
Kubernetes 网络模型
Kubernetes 网络模型由五个部分组成:
- Pod:集群中的每个 Pod 都会在每个启用的 IP 地址族中获得一个集群范围内唯一的 IP 地址。
- 普通 Pod 拥有独立的 Network Namespace。Pod 内所有容器共享 IP、路由表和端口空间,并通过
localhost通信。
- 普通 Pod 拥有独立的 Network Namespace。Pod 内所有容器共享 IP、路由表和端口空间,并通过
- Pod 网络:Pod 网络也称为集群网络,负责处理 Pod 之间的通信。它确保(除非故意进行网络分段):
- 同一节点和不同节点上的 Pod 都可以直接使用 Pod IP 通信,不依赖代理,也不转换源、目的 Pod IP。
- Kubelet 和系统守护进程等节点 Agent 可以访问本节点上的所有 Pod。
- Service:Service API 为一组会变化的后端 Pod 提供稳定的 IP 地址或 DNS 名称。
- 对于带 selector 的 Service,Kubernetes 控制面自动创建和更新 EndpointSlice,记录当前后端的地址、端口和就绪状态。没有 selector 的 Service 由用户或控制器维护 EndpointSlice。
- Service proxy 监听 Service 和 EndpointSlice,并通过操作系统或云平台接口写入转发规则。kube-proxy 是默认实现,部分 Pod 网络实现提供替代方案。
- 集群入口:Gateway API 或其前身 Ingress 让集群外客户端可以访问 Service。
- Service
type: LoadBalancer提供配置更简单的入口。外部负载均衡器由云平台集成、MetalLB 或其他实现提供。
- Service
- NetworkPolicy:NetworkPolicy 控制 Pod 之间以及 Pod 与集群外部之间的入站和出站流量。
- Pod 网络实现负责执行策略。网络实现不支持或没有启用 NetworkPolicy 时,API 对象仍可创建,但不会产生隔离效果。
下图展示了这五个部分如何配合。实线表示数据包的传输路径,虚线表示组件根据 Kubernetes API 对象更新配置。kube-proxy 或其他 Service 实现负责生成转发规则,CNI 在 Pod 创建时完成网络接入。配置完成后,节点上的网络数据面负责转发数据包。
flowchart TB
    subgraph API["Kubernetes API 对象"]
        direction LR
        ENTRY["Gateway / Ingress<br/>LoadBalancer Service"]
        SVC["Service:稳定地址<br/>EndpointSlice:当前后端"]
        NP["NetworkPolicy<br/>允许的流量"]
    end

    subgraph IMPL["实现组件"]
        direction LR
        IN["集群入口<br/>Controller / 负载均衡器"]
        SD["Service 转发规则<br/>service proxy 负责维护"]
        PN["Pod 网络数据面<br/>Pod 网络实现"]
    end

    subgraph PODS["Pod 网络端点"]
        direction LR
        PA["调用方 Pod<br/>独立 Pod IP"]
        PB["后端 Pod<br/>独立 Pod IP"]
    end

    ENTRY -.->|"配置"| IN
    IN -->|"访问 Service"| SD
    IN -->|"直接选择 Endpoint"| PN
    PA -->|"访问 Service"| SD
    SVC -.->|"地址与后端集合"| SD
    SVC -.->|"后端状态"| IN
    SD -->|"选择 Pod IP"| PN
    PA -->|"直接访问 Pod IP"| PN
    NP -.->|"策略规则"| PN
    PN --> PB
图:根据 Kubernetes v1.36 的 Services, Load Balancing, and Networking 绘制。
CNI 与 Pod 网络
CNI 规定容器运行时和网络插件之间的执行协议。运行时负责选择网络配置、创建隔离域并执行插件;插件根据标准输入和环境变量修改网络,再返回结构化结果。CNI 不提供常驻 daemon,也不定义节点间路由协议,Calico、Cilium 等项目在 CNI 接口之外提供这些能力。
CNI 规范
CNI Specification 1.1.0定义五部分内容:网络配置格式、运行时执行协议、插件链的执行顺序、插件委托和返回结果。规范版本与 containernetworking/cni Go module、containernetworking/plugins 二进制集合的发布版本相互独立。
当前 Go library 使用 CNIFuncs 注册操作函数。VERSION 由 dispatcher 统一处理,插件实现其余回调;没有注册的操作会返回不支持错误。接口定义见 pkg/skel/skel.go。
type CNIFuncs struct {
    Add    func(*CmdArgs) error
    Del    func(*CmdArgs) error
    Check  func(*CmdArgs) error
    GC     func(*CmdArgs) error
    Status func(*CmdArgs) error
}
课程实验只注册已经实现的 ADD、DEL 和 CHECK,并声明支持 CNI 1.0.0。STATUS 与 GC 是 CNI 1.1.0 增加的操作,未实现这两个操作的插件不应声明完整支持 1.1.0。
执行协议
CNI runtime 在宿主机网络命名空间中执行插件二进制。每次调用由三部分组成:环境变量描述本次 attachment,标准输入提供 JSON 配置,标准输出返回 JSON Result 或 Error。插件使用退出码 0 表示成功,非零退出码表示失败。
环境变量
CNI_COMMAND:本次操作,取值为ADD、DEL、CHECK、STATUS、VERSION或GC。CNI_CONTAINERID:运行时为 Sandbox 分配的稳定标识。一个 attachment 由CNI_CONTAINERID与CNI_IFNAME共同确定。CNI_NETNS:Pod Sandbox 的隔离域引用。Linux 通常传入/proc/<pid>/ns/net或/run/netns/<name>。CNI_IFNAME:插件在 Pod 中创建或配置的接口名,Kubernetes 默认网络通常使用eth0。CNI_ARGS:分号分隔的附加键值对。Kubernetes runtime 可以在这里提供 Pod 名称、Namespace 和 UID。CNI_PATH:运行时查找插件二进制的目录列表。Kind 节点通常把二进制放在/opt/cni/bin。
STATUS 和 GC 面向整个网络,不对应某个 Pod,因此不要求 CNI_CONTAINERID、CNI_NETNS 和 CNI_IFNAME。VERSION 只要求 CNI_COMMAND。
Network Configuration
运行时从配置目录加载 .conflist、.conf 或 .json。Linux 上 containerd CRI 的默认配置目录是 /etc/cni/net.d;插件二进制目录由 containerd 配置提供,Kind 节点使用 /opt/cni/bin。
下面的配置定义一个只含 course-bridge 的插件链。type 对应二进制文件名,ipam.type 表示主插件将地址管理委托给 host-local。
{
  "cniVersion": "1.0.0",
  "name": "course-network",
  "plugins": [
    {
      "type": "course-bridge",
      "bridge": "course0",
      "isGateway": true,
      "mtu": 1500,
      "ipam": {
        "type": "host-local",
        "ranges": [[{
          "subnet": "10.244.0.0/24",
          "gateway": "10.244.0.1"
        }]],
        "routes": [{"dst": "0.0.0.0/0"}]
      }
    }
  ]
}
配置中的字段分别控制:
cniVersion:配置和 Result 使用的协议版本。插件必须声明支持该版本。name:节点内唯一的网络名称。runtime 用它关联配置、缓存结果和 attachment。plugins:按顺序执行的插件列表。ADD从前向后执行,DEL从后向前执行。type:在CNI_PATH中查找的可执行文件名。ipam:委托给地址管理插件的配置。host-local在节点本地记录地址分配状态。
Result 与 Error
ADD 成功时返回 Result,常用字段包括 interfaces、ips、routes 和 dns。ips[].interface 保存对应接口在 interfaces 数组中的索引;后续插件可以通过 prevResult 读取前一个插件的结果。
下面是网桥插件返回结果的精简示例。host 侧 veth 没有 sandbox,Pod 侧 eth0 记录了 network namespace 路径。
{
  "cniVersion": "1.0.0",
  "interfaces": [
    {"name": "course0", "mac": "02:42:6f:21:77:3e"},
    {"name": "veth2c23f13a", "mac": "9a:67:98:65:a4:4c"},
    {"name": "eth0", "mac": "c6:3c:74:1c:7d:e9", "sandbox": "/proc/3102/ns/net"}
  ],
  "ips": [
    {"address": "10.244.0.3/24", "gateway": "10.244.0.1", "interface": 2}
  ],
  "routes": [
    {"dst": "0.0.0.0/0"}
  ]
}
失败时,插件在标准输出返回包含 cniVersion、code、msg 和可选 details 的 Error JSON,并使用非零退出码。runtime 把错误附加到 Pod Sandbox 创建结果,Kubelet 再将其记录为 FailedCreatePodSandBox Event。
Plugin Delegation
一个 CNI 插件可以执行另一个插件,把 IPAM、防火墙或带宽控制拆成独立模块。课程插件调用 host-local 完成地址分配:
ADD调用ipam.ExecAdd,把 IPAM Result 合并进主插件 Result。CHECK调用ipam.ExecCheck,检查地址分配记录仍然有效。DEL调用ipam.ExecDel,释放本地地址记录。
插件链与委托并不相同。plugins 中的多个插件由 runtime 编排;course-bridge 与 host-local 之间的调用由主插件代码发起。
CNI 操作
CNI 1.1 定义 VERSION、STATUS、ADD、CHECK、DEL 和 GC。这些操作覆盖能力协商、网络就绪检查、attachment 生命周期与异常资源回收。
VERSION
VERSION 查询插件支持的 CNI 版本,不创建或修改网络资源。插件返回 supportedVersions,runtime 再从网络配置与插件共同支持的版本中选择协议版本。
课程插件的返回结果为:
cniVersion 表示 VERSION Result 使用的结构版本,supportedVersions 才是插件声明支持的配置与执行协议版本。
STATUS
STATUS 检查插件当前能否处理新的 ADD。依赖常驻 agent、控制面、地址池或硬件队列的插件,可以在这些依赖不可用时返回错误。STATUS 是状态探测,不会阻止 runtime 继续发送其他操作,插件也不能依赖 runtime 一定调用它。
使用委托插件时,主插件还应向依赖的插件发送 STATUS。CNI 1.1 为不可服务新的 attachment 定义错误码 50,为现有 attachment 也可能受影响定义错误码 51。
ADD
ADD 创建或调整一个 attachment。接口插件通常在 CNI_NETNS 中创建 CNI_IFNAME,配置地址和路由,再返回 Result。相同 (CNI_CONTAINERID, CNI_IFNAME) 在两次 ADD 之间应有一次 DEL。
插件链中的 ADD 按配置顺序执行。后一个插件从 prevResult 读取前一个插件的输出;任何一步失败时,runtime 按已执行插件的逆序调用 DEL,撤销已经创建的资源。
CHECK
CHECK 把 attachment 的实际状态与前一次 ADD Result 对比。runtime 必须在配置中传入 prevResult,插件检查自己创建的接口、地址、路由、防火墙规则、资源预留或外部依赖。
课程插件检查以下状态:
course0存在、类型是 Linux bridge,并处于UP。- host veth 仍然挂在
course0上。 - Pod
eth0与 host veth 保持 peer 关系,并处于UP。 prevResult中的 Pod IP 与路由仍然存在。host-local中的地址分配记录通过自己的CHECK。
DEL
DEL 删除 attachment 或撤销 ADD 的修改。runtime 可能在 CNI_NETNS 已经不存在后调用 DEL,也可能对同一 attachment 多次调用,因此清理操作必须保持幂等。
插件链中的 DEL 按反向顺序执行,并把最终的 ADD Result 作为 prevResult 传给各插件。课程插件删除 Pod 侧 veth;Linux 同时删除它的 host peer,然后调用 host-local 释放地址。
GC
GC 由 runtime 提供当前网络仍然有效的 attachment 集合,插件可以删除集合之外的地址预留、防火墙规则等遗留资源。有效集合位于 cni.dev/valid-attachments,每项包含 containerID 和 ifname。
GC 用于处理节点崩溃等异常留下的状态,不替代正常生命周期中的 DEL。runtime 执行 GC 时需要与 ADD、DEL 互斥,主插件还应把调用转发给委托插件。
Pod Sandbox 网络
Pod Sandbox 提供 Pod 内所有容器共享的 Linux network namespace。容器运行时先创建 Sandbox 与 network namespace,再通过 CNI 把它接入节点网络;业务容器随后加入同一个 namespace,因此 Pod 内容器都能看到 eth0、Pod IP 和同一份路由表。
Network Namespace
Linux network namespace 隔离网络设备、地址、路由、邻居表、netfilter 状态和端口。namespace 刚创建时只有 loopback;CNI 在 runtime 提供的 namespace 路径上执行 setns,配置 Pod 接口后返回宿主机 namespace。
network namespace 的生命周期由容器运行时管理。CNI 删除自己创建的接口和状态,runtime 在 Sandbox 清理阶段关闭 namespace 引用。
veth
veth 是成对出现的虚拟以太网设备。课程插件把一端留在 Pod namespace 并命名为 eth0,另一端留在节点 namespace 并接入 course0。报文写入一端后从另一端进入对方网络栈。
flowchart LR
    subgraph POD["Pod network namespace"]
        APP["container process"] --> E0["eth0<br/>10.244.0.3/24"]
    end
    E0 <-->|"veth pair"| VH["host veth"]
    subgraph NODE["Node network namespace"]
        VH --> BR["course0<br/>10.244.0.1/24"]
        BR --> RT["route / Service / policy"]
endIPAM
IPAM 负责选择、预留和释放 IP。host-local 根据配置中的 range 在节点本地分配地址,并把状态写入 /var/lib/cni/networks/<network-name>/。它适合每个节点拥有独立 Pod 子网的场景,不能自行协调多个节点共享一个地址池。
Calico IPAM、Cilium IPAM 和云厂商 VPC CNI 会结合集群或云网络状态管理地址。无论后端如何实现,主 CNI 插件都通过标准 Result 取得 IP、Gateway 和 Route。
Pod 网络创建过程
下图展示了 Kubelet 观察到已绑定 Pod 后,containerd 为 Pod Sandbox 配置网络的主路径。CNI 成功返回后,containerd 才把 Pod IP 写入 Sandbox 状态;Kubelet 随后创建业务容器。
sequenceDiagram
    participant K as Kubelet
    participant C as containerd CRI
    participant N as Pod netns
    participant B as course-bridge
    participant I as host-local

    K->>C: RunPodSandbox(PodSandboxConfig)
    C->>N: create network namespace
    C->>B: CNI ADD(containerID, netns, eth0)
    B->>N: create veth and attach host peer to bridge
    B->>I: delegated ADD
    I-->>B: IP, gateway, routes
    B->>N: configure eth0 and routes
    B-->>C: CNI Result
    C-->>K: PodSandboxID and PodIP
Pod 网络创建源码
源码边界与组件职责一致:Kubelet 只调用 CRI;containerd 创建 network namespace 并调用 CNI;CNI plugin 修改节点和 Pod namespace 中的网络状态。
Kubelet 与 CRI 的网络调用
Kubernetes v1.36.4 的 createPodSandbox 生成 PodSandboxConfig,解析 RuntimeClass 对应的 runtime handler,再调用 RuntimeService.RunPodSandbox。日志目录和错误包装已从下面的片段省略,完整实现见 kuberuntime_sandbox.go。
func (m *kubeGenericRuntimeManager) createPodSandbox(
    ctx context.Context,
    pod *v1.Pod,
    attempt uint32,
) (string, string, error) {
    config, err := m.generatePodSandboxConfig(ctx, pod, attempt)
    if err != nil {
        return "", "", err
    }

    runtimeHandler := ""
    if m.runtimeClassManager != nil {
        runtimeHandler, err = m.runtimeClassManager.LookupRuntimeHandler(
            pod.Spec.RuntimeClassName,
        )
        if err != nil {
            return "", "", err
        }
    }

    sandboxID, err := m.runtimeService.RunPodSandbox(
        ctx,
        config,
        runtimeHandler,
    )
    return sandboxID, "", err
}
CRI 的 RunPodSandbox 是 gRPC 调用。Kubelet 不读取 /etc/cni/net.d,也不执行 /opt/cni/bin 中的插件;这些路径属于 containerd 的实现和节点配置。
containerd 调用 CNI
containerd v2.3.4 创建 Sandbox 容器和 network namespace 后进入 setupPodNetwork。它根据 RuntimeClass 选择 CNI 配置,构造 Pod label、port mapping、DNS 等 runtime options,再调用 Setup。完整实现见 sandbox_run.go。
func (c *criService) setupPodNetwork(
    ctx context.Context,
    sandbox *sandboxstore.Sandbox,
) error {
    id := sandbox.ID
    path := sandbox.NetNSPath
    netPlugin := c.getNetworkPlugin(sandbox.RuntimeHandler)
    if netPlugin == nil {
        return errors.New("cni config not initialized")
    }

    opts, err := cniNamespaceOpts(id, sandbox.Config)
    if err != nil {
        return err
    }

    result, err := netPlugin.Setup(ctx, id, path, opts...)
    if err != nil {
        return err
    }
    sandbox.IP, sandbox.AdditionalIPs = selectPodIPs(
        ctx,
        result.Interfaces[defaultIfName].IPConfigs,
        c.config.IPPreference,
    )
    sandbox.CNIResult = result
    return nil
}
Setup 可以并行配置同一 Sandbox 的多个 attachment;配置 setup_serially = true 后改用 SetupSerially。单个 attachment 内的插件链仍按照 CNI 规范顺序执行。
CNI 配置加载
containerd CRI 在 Linux 上把 CNI 配置目录默认设为 /etc/cni/net.d,并监听配置变化。max_conf_num 默认只加载按文件名排序后的第一个有效网络配置;RuntimeClass 也可以指定独立配置目录和 binary 目录。配置字段定义见 internal/cri/config/config.go,Linux 默认值见 config_unix.go。
type CniConfig struct {
    NetworkPluginBinDirs       []string `toml:"bin_dirs"`
    NetworkPluginConfDir       string   `toml:"conf_dir"`
    NetworkPluginMaxConfNum    int      `toml:"max_conf_num"`
    NetworkPluginSetupSerially bool     `toml:"setup_serially"`
}
修改配置文件后,新建 Sandbox 使用新配置。已经存在的 attachment 在 DEL 时仍需要与 ADD 兼容的配置,因此升级 CNI 时应保留旧插件所需的清理能力,直到旧 Pod 完成替换。
同节点 Pod 通信
两个 Pod 的 host veth 接入同一个 Linux bridge 时,bridge 根据目标 MAC 转发二层帧。源 Pod 先通过 ARP 或 IPv6 Neighbor Discovery 得到目标 Pod 的 MAC,报文随后经过源 veth、bridge 和目标 veth。目标 IP 与源 IP 在同一子网时不经过默认网关。
实际网络实现可能使用路由而不是 bridge。Calico 的默认 Linux 数据路径通常为每个 workload veth 写 host route;Cilium 可以在 veth、netkit 或其他 hook 上执行 eBPF。Kubernetes 只要求通信结果符合网络模型。
跨节点网络
跨节点通信需要把目标 Pod IP 映射到目标 Node。网络实现可以让底层网络直接学习 Pod 路由,也可以把 Pod 报文封装进 Node IP 之间的隧道。两种方式都保持内层 Pod IP,不改变应用看到的端点地址。
直接路由与 Overlay
- 直接路由:节点路由表或底层路由器保存 Pod CIDR 的下一跳。报文不增加隧道头,要求底层网络能够路由 Pod 网段。
- Overlay:源节点把 Pod 报文封装成以 Node IP 为端点的外层报文,目标节点解封装后再路由到 Pod。底层网络只需路由 Node IP。
flowchart LR
    P1["Pod A<br/>10.244.1.8"] --> N1["Node A"]
    N1 -->|"direct route<br/>dst 10.244.2.0/24 via Node B"| N2["Node B"]
    N1 -->|"overlay<br/>outer dst Node B"| T["VXLAN / IP-in-IP / Geneve"]
    T --> N2
N2 --> P2["Pod B<br/>10.244.2.9"]VXLAN
VXLAN 把二层帧封装进 UDP,常用目标端口为 4789。VNI 标识逻辑二层网络,VTEP 在节点上完成封装和解封装。它可以跨越只提供三层 IP 可达性的底层网络,代价是增加 UDP、IP 和 VXLAN 头。
Calico 的 VXLAN 对所有跨节点流量封装,VXLANCrossSubnet 只在节点位于不同底层子网时封装。Flannel 的 vxlan backend 也使用每节点 Pod 子网和 VXLAN 设备建立跨节点路径。
IP-in-IP
IP-in-IP 直接把内层 IP packet 包在另一个 IP header 中,协议号为 4。它的头部比 VXLAN 简单,但中间网络和防火墙需要允许 IP protocol 4,也不提供 VXLAN 的二层语义。
Calico 支持 IPIP 和 IPIPCrossSubnet。这两种模式与 Calico 的 VXLAN 模式都是跨节点传输选择,NetworkPolicy 数据面仍由 Calico 的 Linux dataplane 执行。
Geneve
Geneve 使用 UDP 封装,并提供可扩展 option 字段。OVN 常用 Geneve 在 chassis 之间传递逻辑网络上下文;Cilium 也支持 Geneve tunnel mode。扩展字段增加了灵活性,也需要正确计算 MTU 和硬件 offload 能力。
BGP
BGP 发布 Pod CIDR 或更细粒度的 Pod route。Calico 节点可以相互建立 BGP session,也可以与 Top-of-Rack 路由器或 route reflector 交换路由。BGP 决定目的网段的下一跳,报文本身可以保持无封装,也可以与 IP-in-IP 等模式组合。
BGP route reflector 用于减少全互联 session 数,不转发实际数据包。路由收敛、过滤策略和底层网络对 Pod 网段的接受范围决定生产部署方式。
MTU 与分片
Overlay 在原始报文外增加 header,可用 MTU 必须小于底层接口 MTU。底层 MTU 为 1500 时,VXLAN IPv4 常见 Pod MTU 为 1450;Geneve option、IPv6、WireGuard 或云网络额外封装会继续减少可用空间。
MTU 配置错误常表现为小包正常、大包或 TLS 请求超时。排查时同时检查 Pod eth0、隧道设备和 Node 上行接口的 MTU,并使用带 DF 的 ping 或 tracepath 验证实际路径。
Pod 出站与 SNAT
Pod 访问集群外地址时,如果外部网络没有 Pod CIDR 的返回路由,节点需要把源 Pod IP 改写为 Node IP。Calico IPPool 的 natOutgoing: Enabled、Cilium 的 masquerading 配置或其他 CNI 的 ip-masq 规则实现这一步。
SNAT 只应覆盖无法路由 Pod CIDR 的目的网段。对集群内部地址或已经发布 Pod 路由的网络执行 SNAT,会丢失源 Pod 身份并增加排障难度。
Service 数据面
Service 把一组变化的 Pod Endpoint 映射成稳定的虚拟地址和端口。API Server 保存 Service,EndpointSlice Controller 根据 selector、Pod IP 与就绪状态维护 EndpointSlice;每个节点上的 Service 数据面再把访问虚拟地址的连接转发到一个可用 Endpoint。
Service 与 EndpointSlice
下面的 Service 选择 app: cni-server 的 Pod,并把 8080 端口映射到 Pod 的 8080。Service selector 变化、Pod IP 变化或 Pod readiness 变化都会反映到 EndpointSlice。
apiVersion: v1
kind: Service
metadata:
  name: cni-server
spec:
  selector:
    app: cni-server
  ports:
    - port: 8080
      targetPort: 8080
EndpointSlice 中的 endpoints[].addresses 保存 Pod IP,conditions.ready 表示该 Endpoint 是否可以接收普通 Service 流量。没有 selector 的 Service 需要由用户或控制器直接创建 EndpointSlice。
kube-proxy
kube-proxy 是 Kubernetes 的 Service proxy 参考实现。它在每个节点上监听 Service、EndpointSlice、Node 和 ServiceCIDR 等对象,把期望状态同步到 iptables、IPVS 或 nftables。数据包由 Linux 内核处理,不经过 kube-proxy 用户态进程转发。
ClusterIP
ClusterIP 从 Service CIDR 分配,供集群内客户端访问。kube-proxy 根据协议、ClusterIP 和端口匹配连接,选择一个 ready Endpoint,并执行 DNAT。conntrack 保存已建立连接的转换状态,因此同一连接的后续 packet 会继续使用已选 Endpoint。
sequenceDiagram
    participant C as Client Pod
    participant D as Node Service data plane
    participant E as Endpoint Pod

    C->>D: TCP 10.96.118.49:8080
    D->>D: match Service and select Endpoint
    D->>E: DNAT to 10.244.0.3:8080
    E-->>C: response through conntrack path
Headless Service 的 clusterIP: None 不创建 ClusterIP 转发规则。CoreDNS 直接返回 Endpoint 地址,客户端连接 Pod IP。
NodePort
NodePort 在每个符合条件的 Node IP 上暴露一个端口,并把连接转发到 Service Endpoint。externalTrafficPolicy: Cluster 可以选择集群内任意 ready Endpoint;Local 只使用当前节点上的 Endpoint,并可保留外部客户端源地址。
NodePort 能否从节点外访问还取决于主机防火墙、云安全组和 nodePortAddresses 配置。端口范围默认是 30000–32767。
LoadBalancer
type: LoadBalancer 由云控制器、MetalLB 或其他 load balancer 实现分配外部入口。外部负载均衡器把连接送到 NodePort、直接送到 Pod,或使用实现定义的路径;Service Status 中的 loadBalancer.ingress 只记录入口地址,不规定数据面。
conntrack
Linux conntrack 记录连接五元组、NAT 转换和状态。Service 后端发生变化后,新的连接使用新规则,已经建立的连接通常继续使用原 conntrack entry。UDP 也有基于超时的 conntrack 状态。
排查“Endpoint 已更新但连接仍到旧 Pod”时,需要区分新连接与复用连接,再检查 conntrack,而不是只查看当前 Service 规则。
Service DNS
CoreDNS 为普通 Service 生成 <service>.<namespace>.svc.<cluster-domain> A/AAAA 记录,记录值是 ClusterIP;Headless Service 返回 Endpoint 地址。DNS 成功只证明名称解析正常,不能证明 ClusterIP 规则或目标应用可访问。
kube-proxy 源码
Kubernetes v1.36.4 把模式选择、对象监听和规则同步分成三个层次:createProxier 创建具体实现,Run 注册 informer,具体 Proxier 的 syncProxyRules 把缓存状态写入节点数据面。
启动与代理模式选择
Linux 上的 ProxyServer.createProxier按 KubeProxyConfiguration.mode 创建 iptables、IPVS 或 nftables Proxier。下面只保留模式分支:
switch config.Mode {
case proxyconfigapi.ProxyModeIPTables:
    proxier, err = iptables.NewProxier(/* node and sync configuration */)
case proxyconfigapi.ProxyModeIPVS:
    proxier, err = ipvs.NewProxier(/* IPVS, ipset and iptables dependencies */)
case proxyconfigapi.ProxyModeNFTables:
    proxier, err = nftables.NewProxier(/* node and sync configuration */)
}
IPVS 分支在 v1.36.4 中记录弃用 Event,提示改用 nftables。未显式设置 mode 时仍使用平台默认值,nftables 稳定并不表示现有集群会自动切换。
Service 与 EndpointSlice 事件处理
ProxyServer.Run为 Service 和 EndpointSlice 创建 informer,把同一个 s.Proxier 注册为事件处理器,最后启动同步循环:
serviceConfig := config.NewServiceConfig(
    ctx,
    serviceInformerFactory.Core().V1().Services(),
    syncPeriod,
)
serviceConfig.RegisterEventHandler(s.Proxier)

endpointSliceConfig := config.NewEndpointSliceConfig(
    ctx,
    endpointSliceInformerFactory.Discovery().V1().EndpointSlices(),
    syncPeriod,
)
endpointSliceConfig.RegisterEventHandler(s.Proxier)

go serviceConfig.Run(ctx.Done())
go endpointSliceConfig.Run(ctx.Done())
go s.Proxier.SyncLoop()
Proxier 的 OnServiceAdd、OnServiceUpdate、OnEndpointSliceAdd 等方法先更新内存 tracker,再请求一次同步。informer 的初始 LIST 完成后,Proxier 才把完整状态写入数据面,避免用不完整对象集合生成规则。
Proxier 规则同步
三种 mode 都实现 proxy.Provider,但写入对象不同:
iptables.Proxier.syncProxyRules生成 netfilter chain 与 rule,再通过 restore 接口提交。ipvs.Proxier.syncProxyRules维护 IPVS virtual server、real server、ipset 和外围 iptables 规则。nftables.Proxier.syncProxyRules使用 nftables set、map、chain 和 transaction 更新 Service 状态。
同步函数处理的是 informer 缓存中的期望状态。内核中现有的规则、set 元素或 IPVS backend 与期望状态不一致时,Proxier 创建、更新或删除对应对象。
Service 数据面演进
iptables、IPVS 和 nftables 是 kube-proxy 在 Linux 上提供的三种 mode。eBPF 与 OVS/OVN 由网络项目提供,属于 kube-proxy replacement。比较这些实现时需要同时观察连接路径和规则更新路径,不能只比较数据结构名称。
iptables
iptables mode 使用 netfilter chain 表达 Service 和 Endpoint。每个 packet 按内核 netfilter hook 进入规则集,规则完成 Service 匹配、Endpoint 选择、DNAT 和必要的 SNAT。
Kubernetes 新版本能够跳过大部分未变化的 Service 和 Endpoint 处理,但提交规则时仍需要生成与完整规则集相关的数据。iptables 兼容范围广,也是 Kubernetes v1.36 没有显式选择其他 mode 时的默认实现。
IPVS
IPVS 在内核中维护 virtual service 和 real server,并提供 round-robin、least-connection 等调度算法。kube-proxy 仍需使用 ipset 与 iptables 补齐 NodePort、Masquerade、filter 等 Kubernetes Service 语义。
IPVS mode 从 Kubernetes v1.35 开始弃用,v1.36 仍保留实现。新集群应选择 nftables 或经过验证的 kube-proxy replacement;现有 IPVS 集群需要在删除时间线前验证迁移路径。具体状态见 Virtual IPs and Service Proxies。
nftables
nftables mode 在 Kubernetes v1.33 进入 Stable。它用 set 和 map 表达 Service、NodePort 与 Endpoint 关系,并通过原子 transaction 更新规则。查找和更新结构更适合 Service 与 Endpoint 数量较大的集群。
Kubernetes v1.36 使用 nftables mode 需要显式设置 mode: nftables,并要求 Linux kernel 5.13 或更新版本。迁移前还要确认节点发行版、CNI、主机防火墙和运维工具能够共同使用 nftables。设计和迁移边界见 NFTables mode for kube-proxy。
Kubernetes 官方博客使用 5,000、10,000 和 30,000 个 Service 的测试集群,对比 iptables 与 nftables 处理新连接首包的往返延迟。横轴的 p01、p50、p90 和 p99 是延迟分位数,纵轴单位为毫秒。图中 iptables 的延迟随 Service 数量和分位数明显增长,nftables 的结果在这组测试中保持在较低范围。
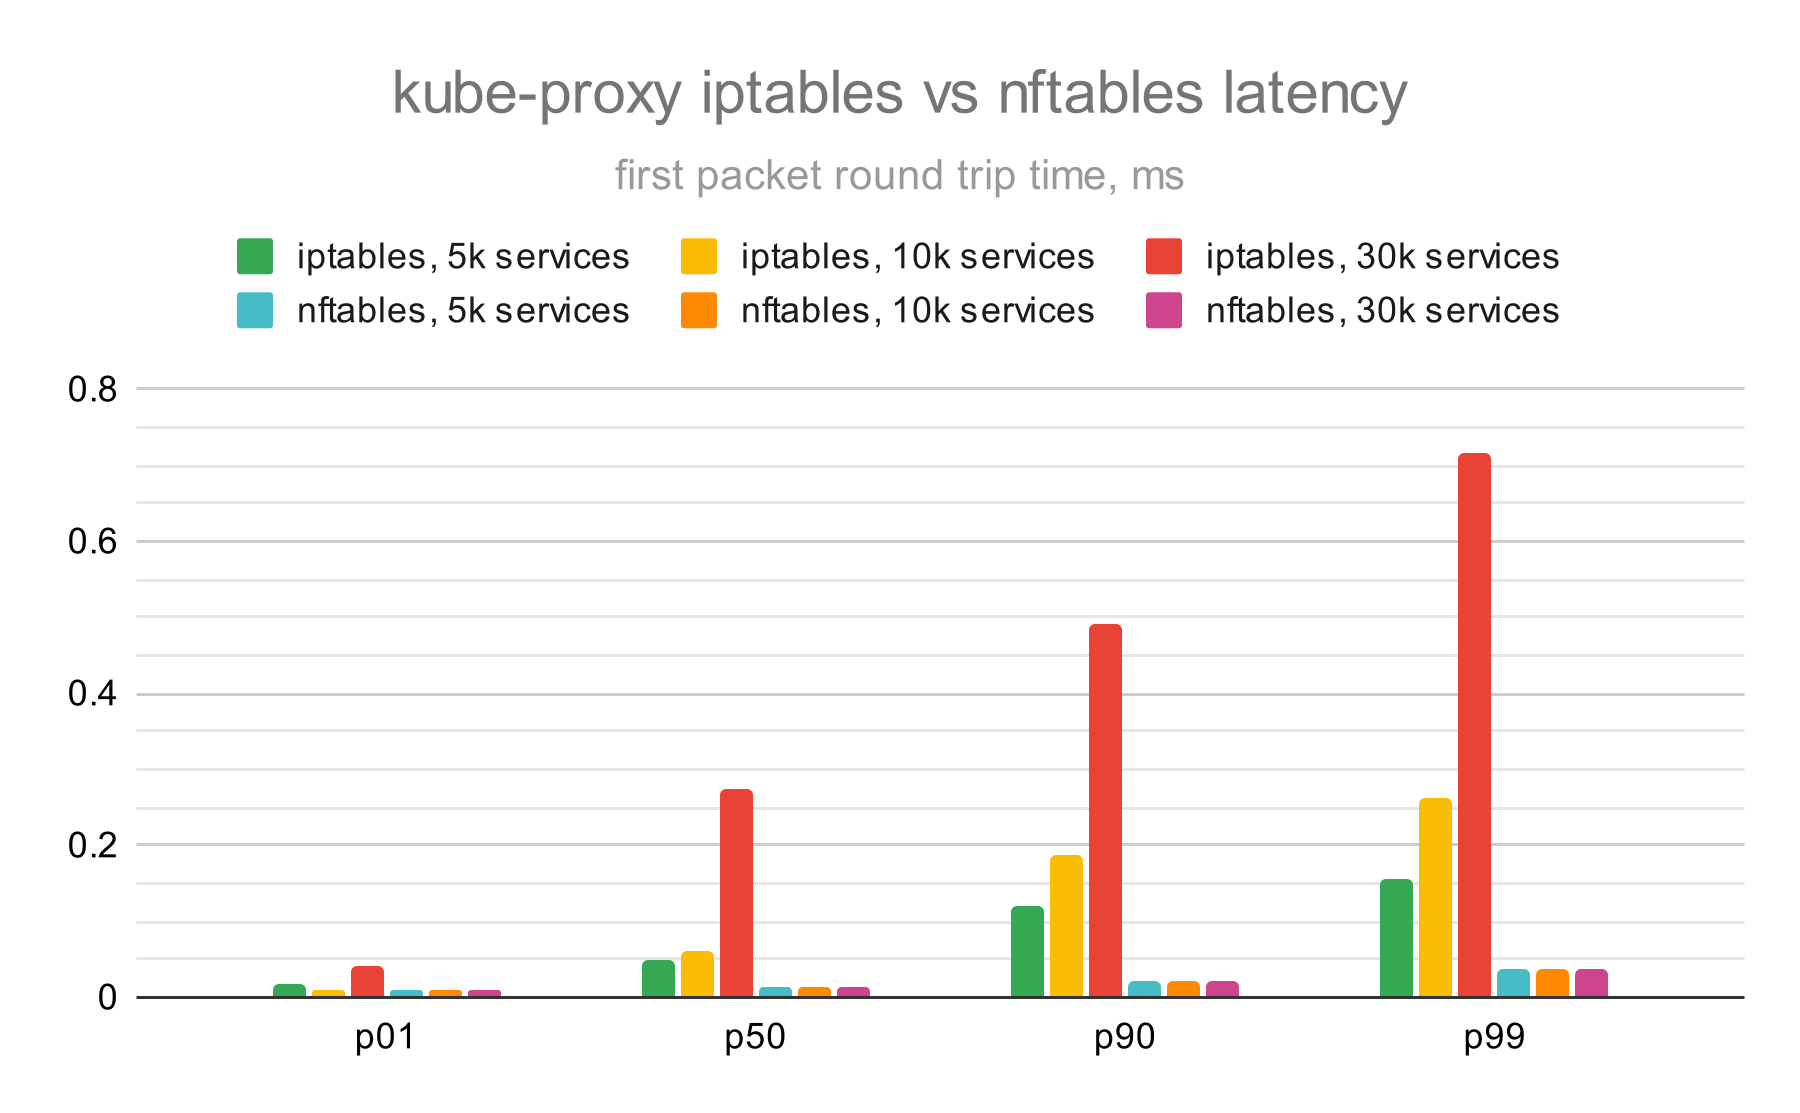
图:kube-proxy iptables 与 nftables 首包延迟。来源:Kubernetes 官方博客:NFTables mode for kube-proxy,CC BY 4.0。原始 SVG 转为 PNG,图表内容未修改。
图中的数值来自文章作者的测试环境,用于说明规则查找方式在大规模 Service 下的差异,不应当作为其他内核、CPU 或流量路径的固定延迟。课程实验只有少量 Service,无法复现图中的规模差异。
kube-proxy replacement
kube-proxy replacement 由 Cilium、Calico eBPF、AntreaProxy、Kube-OVN 等网络实现维护 Service 状态。替代实现需要同时覆盖 ClusterIP、NodePort、LoadBalancer、SessionAffinity、traffic policy、hairpin 和双栈等语义,不能只实现 ClusterIP DNAT。
eBPF
eBPF 数据面把程序挂载到 tc、socket、XDP 或 cgroup hook,并用 BPF map 保存 Service、Backend、Policy 和连接状态。它可以在更早的 hook 完成 Service lookup,也能把 Pod 网络、NetworkPolicy 和流量观测放在同一套节点状态中。
不同项目选择的 hook、路由模式、连接跟踪和加密实现并不相同。“使用 eBPF”不能直接推导出固定的数据路径或性能结果。
OVS 与 OVN
Open vSwitch 使用 flow table 和 pipeline 执行匹配、转发、NAT 与策略。AntreaProxy 把 Service 负载均衡写入 OVS pipeline;OVN 在 OVS 之上提供逻辑交换机、逻辑路由器、ACL 和分布式负载均衡,Kube-OVN 将这些对象映射到 Kubernetes 网络 API。
OVS/OVN 与 eBPF 都可以替代 kube-proxy,但观测入口不同:前者主要检查 OpenFlow/OVN logical flow,后者检查 BPF program、map 和 flow event。
性能比较
下表比较实现结构,不给脱离环境的绝对性能排名。
| 实现 | Service 状态 | 更新方式 | 主要排障入口 |
|---|---|---|---|
| iptables | netfilter chain 与 rule | 生成并 restore 规则集 | iptables-save、conntrack |
| IPVS | virtual service 与 real server,外加 ipset/iptables | 同步 IPVS、ipset 与外围规则 | ipvsadm、ipset、iptables |
| nftables | set、map、chain 与 rule | 原子 transaction,适合增量更新 | nft list ruleset、conntrack |
| eBPF | BPF map 与 program | 更新 map 或替换 program | bpftool、项目 CLI、flow log |
| OVS/OVN | OpenFlow、logical flow 与 connection tracking | 更新 pipeline 和 logical object | ovs-ofctl、ovn-*ctl、trace |
基准测试至少需要固定以下变量:
- 流量路径:同节点 Pod、跨节点 Pod、ClusterIP、NodePort 或外部 LoadBalancer。
- 工作阶段:首包、已建立连接、Service 更新或 Endpoint 扩缩容。
- 对象规模:Service、Endpoint、NetworkPolicy、Node 和 Pod 数量。
- 主机环境:内核版本、CPU、NIC、GRO/GSO/TSO、conntrack 和硬件 offload。
- 网络模式:直接路由、Overlay、加密以及 traffic policy。
NetworkPolicy
NetworkPolicy 选择一组 Pod,并定义允许进入或离开这些 Pod 的 L3/L4 流量。API Server 只保存策略对象;Calico、Cilium、Antrea 等实现读取策略和 Endpoint 状态,再把规则写入各自数据面。集群网络不支持 NetworkPolicy 时,创建对象不会改变流量路径。
Pod 隔离模型
一个方向上没有任何 NetworkPolicy 选择 Pod 时,该方向默认允许全部流量。至少一条策略选择 Pod 并包含 Ingress 或 Egress 后,Pod 在对应方向进入隔离状态,允许集合由所有选中策略的规则并集组成。
策略按 Pod 的接收方向和发送方向分别判断。源 Pod 的 Egress 与目标 Pod 的 Ingress 都需要允许,一条连接才能建立。
Ingress 与 Egress
下面的策略选择 app: cni-server 的 Pod,只允许带有 access: client label 的 Pod 访问 TCP 8080。空的 podSelector 在同一 Namespace 中匹配所有 Pod。
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-client
spec:
  podSelector:
    matchLabels:
      app: cni-server
  policyTypes:
    - Ingress
  ingress:
    - from:
        - podSelector:
            matchLabels:
              access: client
      ports:
        - protocol: TCP
          port: 8080
ingress: [] 表示没有允许的入站流量;省略 ingress 且 policyTypes 包含 Ingress 也会形成 default deny。规则中的多个 from 项是“或”关系,同一个 item 内组合 namespaceSelector 与 podSelector 时是“且”关系。
PodSelector 与 NamespaceSelector
spec.podSelector:确定策略保护哪些 Pod,作用域是策略所在 Namespace。from[].podSelector/to[].podSelector:匹配策略所在 Namespace 中的通信对端,除非同一 item 还指定namespaceSelector。namespaceSelector:按 Namespace label 匹配对端 Namespace。使用kubernetes.io/metadata.name可以明确选择某个 Namespace。ipBlock:按 CIDR 选择集群外或实现定义的地址。Pod 流量经过 NAT 时,策略看到转换前还是转换后的地址取决于数据面位置。
策略执行过程
下图展示 NetworkPolicy 从 API 对象进入节点数据面的过程。策略 controller/agent 还需要观察 Namespace label、Pod label、Pod IP 和端口,才能把 selector 转换为具体规则。
flowchart LR
    NP["NetworkPolicy"] --> A["network agent / controller"]
    NS["Namespace labels"] --> A
    P["Pod labels and IPs"] --> A
    A --> R["nftables / eBPF / OVS rules"]
    F["packet"] --> R
    R -->|"allow"| D["destination Pod"]
    R -->|"deny"| X["drop and counters"]
Pod 新建、label 更新和 IP 变化都会触发策略状态更新。策略生效速度取决于 API 事件传递、agent 处理和数据面提交时间;排障时需要同时查看 NetworkPolicy 对象与节点上已经安装的规则。
扩展策略 API
标准 networking.k8s.io/v1 NetworkPolicy 只提供 Namespace 范围的 L3/L4 allow 规则。Calico、Cilium 和 Antrea 分别提供 cluster-wide policy、tier、deny、FQDN 或 L7 等扩展 API,资源字段和执行语义不同。
Kubernetes SIG Network 的 Network Policy API通过 CRD 设计跨 Namespace 的 ClusterNetworkPolicy 等能力。它是独立项目,不是标准 NetworkPolicy 已经增加的字段;采用前应检查当前 API 版本和目标网络实现的支持情况。
网络方案
网络项目由控制面组件、节点 agent、CNI、IPAM 和数据面组合而成。选型时应分别确认 Pod 路由、Service、NetworkPolicy、多网络、Windows、加密和观测能力,不能只比较 CNI 二进制。
Flannel
Flannel 聚焦基础的 Pod 三层网络。每个节点运行 flanneld,获取一个 Pod 子网并配置 backend;CNI 插件把 Pod 接入节点子网。Service 通常仍由 kube-proxy处理,NetworkPolicy 需要搭配其他实现。
组件
flanneld:管理每节点 Pod subnet 和 backend 状态。- flannel CNI:调用 bridge、host-local 等插件完成 Pod attachment。
- subnet manager:使用 Kubernetes API 等后端协调 Node 与 Pod subnet。
VXLAN 与 host-gw
vxlan backend 把跨节点 packet 封装到 VXLAN。host-gw 为其他节点的 Pod subnet 写静态路由,下一跳是对方 Node IP,因此要求 Node 之间具有直接二层可达性。
适用场景
Flannel 适合只需要基础 Pod 连通性、Service 由 kube-proxy 提供、策略另行选择的集群。它的职责边界和 backend 配置见 Flannel README与 Flannel backends。
Calico
Calico 组合 CNI、IPAM、Linux 路由、BGP、Overlay 与 NetworkPolicy,并提供 Iptables、Nftables、eBPF 和 VPP 多种 Linux 数据面。课程实验集群使用 Calico Nftables data plane 与独立的 kube-proxy nftables mode。
组件
- Felix:运行在每个节点上,读取 workload、policy、route 和 host 状态,配置选择的数据面。
- BIRD 或 GoBGP 相关组件:在启用 BGP 时交换 Pod route。
- calico-kube-controllers:处理 Kubernetes 对象与 Calico 数据模型之间的集群级控制逻辑。
- CNI 与 IPAM:创建 workload interface,并从 Calico IPPool 分配 Pod IP。
Calico 组件关系和职责见 Component architecture。
CNI 与 IPAM
Calico CNI 创建 workload interface,并把配置请求交给 Calico IPAM。IPPool 控制可分配 CIDR、block size、封装与出站 NAT;节点通常按 block 获得一组地址,减少每次 Pod 创建时的全局协调。
BGP 与 Overlay
Calico 可以发布 Pod route,实现无封装网络;也可以选择 VXLAN 或 IP-in-IP。CrossSubnet 模式只对不同底层子网的节点封装,减少同子网路径的额外 header。
Iptables 数据面
Iptables data plane 由 Felix 写入 iptables、ipset 和路由。它执行 workload policy、host policy、NAT 和转发,Service 默认仍交给 kube-proxy。
Nftables 数据面
Nftables data plane 使用 nftables 实现 Calico policy 与相关转发。下面是课程集群的 Installation 片段:
spec:
  calicoNetwork:
    linuxDataplane: Nftables
    ipPools:
      - cidr: 10.244.0.0/16
        encapsulation: VXLANCrossSubnet
        natOutgoing: Enabled
linuxDataplane:选择 Felix 在节点上写入 Nftables 数据面。encapsulation:不同底层子网的节点之间使用 VXLAN,同子网使用直接路径。natOutgoing:Pod 访问所有 Calico IPPool 之外、且外部无法路由 Pod CIDR 的地址时执行 SNAT。
具体内核和 nftables 版本要求见 Calico Nftables data plane。
eBPF 数据面
Calico eBPF data plane 用 BPF program 和 map 实现 Pod 网络、策略、NAT 与 Service,并可以替代 kube-proxy。启用方式会改变 Service 观测与排障入口,不能与标准 kube-proxy nftables 规则混合判断。
VPP 数据面
Calico VPP data plane 使用 Vector Packet Processing 提供用户态 packet processing,并支持面向高吞吐场景的接口与转发能力。它与 Felix 的标准 Linux 数据面部署方式不同,采用前需要确认项目支持范围、NIC 和运行环境。
Cilium
Cilium 在节点上加载 eBPF program,管理 Pod 网络、Service、NetworkPolicy 和可观测状态。cilium-agent 负责节点数据面,cilium-operator 处理适合集群级执行的任务,cilium-cni 通过本地 agent API 配置 Pod attachment。组件职责见 Cilium Component Overview。
组件
- Cilium Agent:监听 Kubernetes 与 Cilium API,管理 endpoint、eBPF program 和 map。
- Cilium Operator:执行集群级 IPAM、身份和资源管理任务,不转发数据包。
- Cilium CNI:由 runtime 调用,再请求本节点 Agent 配置 endpoint。
- Hubble:从 Cilium 数据面取得 flow event,提供节点、集群和 UI 视图。
下图展示了 Cilium 用户态组件与内核数据面的关系:
- Plugins:连接 Kubernetes 等编排系统,把对象和配置交给 Cilium。
- Cilium Daemon:维护本节点 endpoint、policy 和数据面状态,并生成或加载 BPF bytecode。
- BPF Program:挂载到主机接口和容器相关 hook,在内核中执行转发、策略与观测逻辑。
- CLI 与 Monitor:通过 Daemon 查询配置、状态和流量事件。
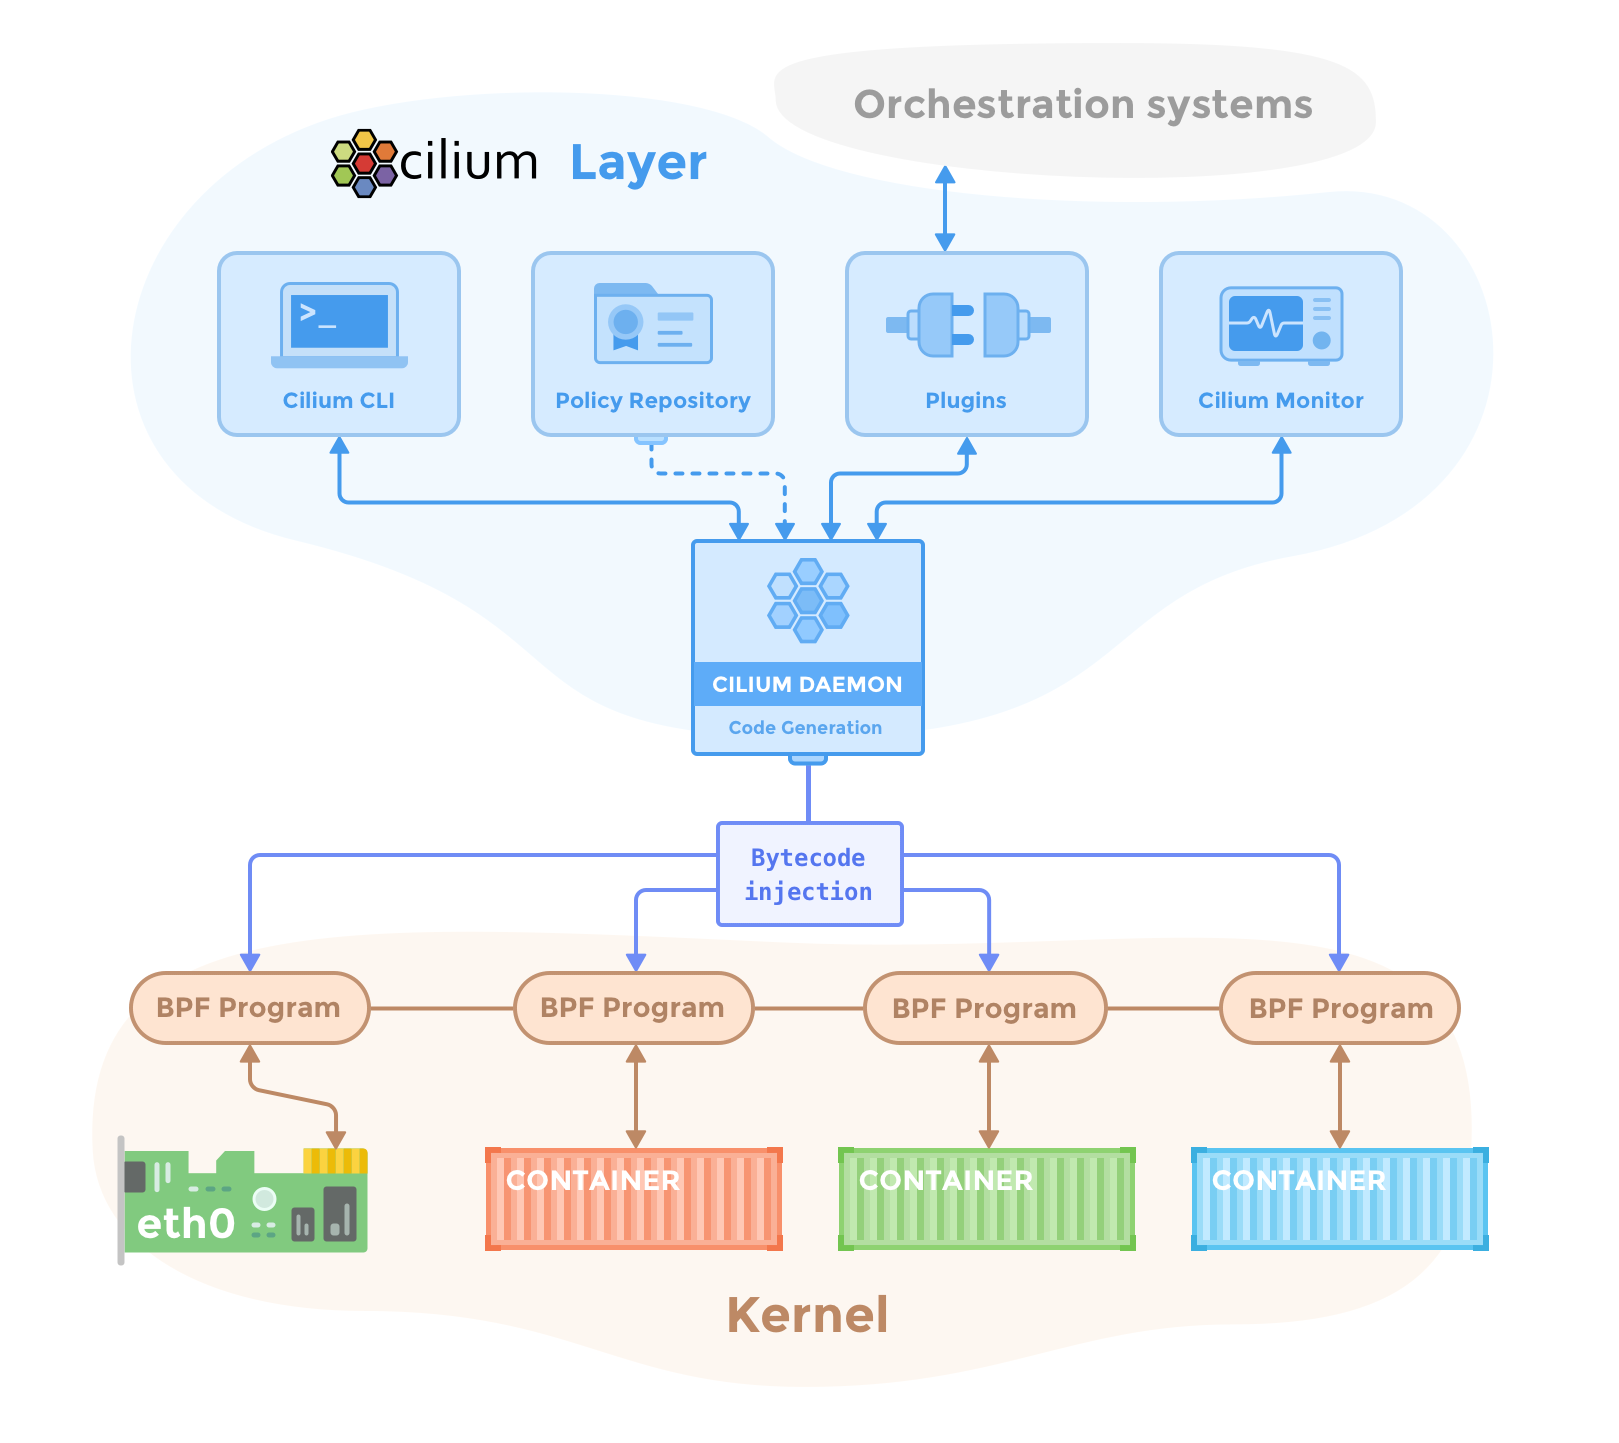
图:Cilium 组件与内核 BPF 数据面。来源:Cilium Component Overview,Apache-2.0。
eBPF 数据面
Cilium 把程序挂载到 endpoint、host、socket 或 XDP 等位置,并根据内核能力选择可用特性。路由可以使用 VXLAN、Geneve 或 native routing;NetworkPolicy 与 Service lookup 通过 BPF map 获取状态。
kube-proxy replacement
Cilium kube-proxy replacement 直接实现 ClusterIP、NodePort、LoadBalancer 和相关 Service 语义。安装前需要根据目标环境选择 replacement 模式,并确认 HostPort、external traffic policy、DSR 和云网络集成的配置。
Hubble
Hubble Server 嵌入每个 Cilium Agent,从 eBPF 数据面读取 flow event;Hubble Relay 聚合节点流,CLI 和 UI 提供查询。它能按 identity、Pod、Service、policy verdict 和 L7 信息筛选流量。
netkit
netkit 是 Linux 为容器网络提供的轻量设备类型。Cilium 在支持的内核上可以用 netkit 代替 veth,减少部分 host-side 设备处理,并在 netkit hook 运行 BPF。使用前需要检查 Cilium 与 Linux kernel 的版本要求,现有基于 veth 名称的排障脚本也要同步调整。
Antrea
Antrea 以 Open vSwitch 为主要数据面。Antrea Agent 在每个节点上管理 OVS bridge、Pod port、OpenFlow 和隧道;Antrea Controller 处理集群级策略和状态;Antrea CNI 把 Pod veth 接入 OVS。组件路径见 Antrea Architecture。
组件
- Antrea Controller:处理集群级资源和策略计算。
- Antrea Agent:管理节点 OVS bridge、OpenFlow 与 route。
- Antrea CNI:请求 Agent 创建 Pod port 并配置接口。
下图把 Antrea 的控制面和节点数据面放在同一张架构图中:
- Antrea Controller:监听 Kubernetes API 中的 Pod、Namespace、NetworkPolicy 和 Antrea CRD,计算需要下发的策略状态。
- Antrea CNI:接收 Kubelet 发起的 CNI 操作,再请求本节点 Antrea Agent 配置 Pod 网络。
- Antrea Agent:通过 OVSDB 管理 OVS 对象,通过 OpenFlow 写入 packet pipeline。
- OVS bridge:连接 Pod veth,并执行节点上的隧道、转发和策略规则。
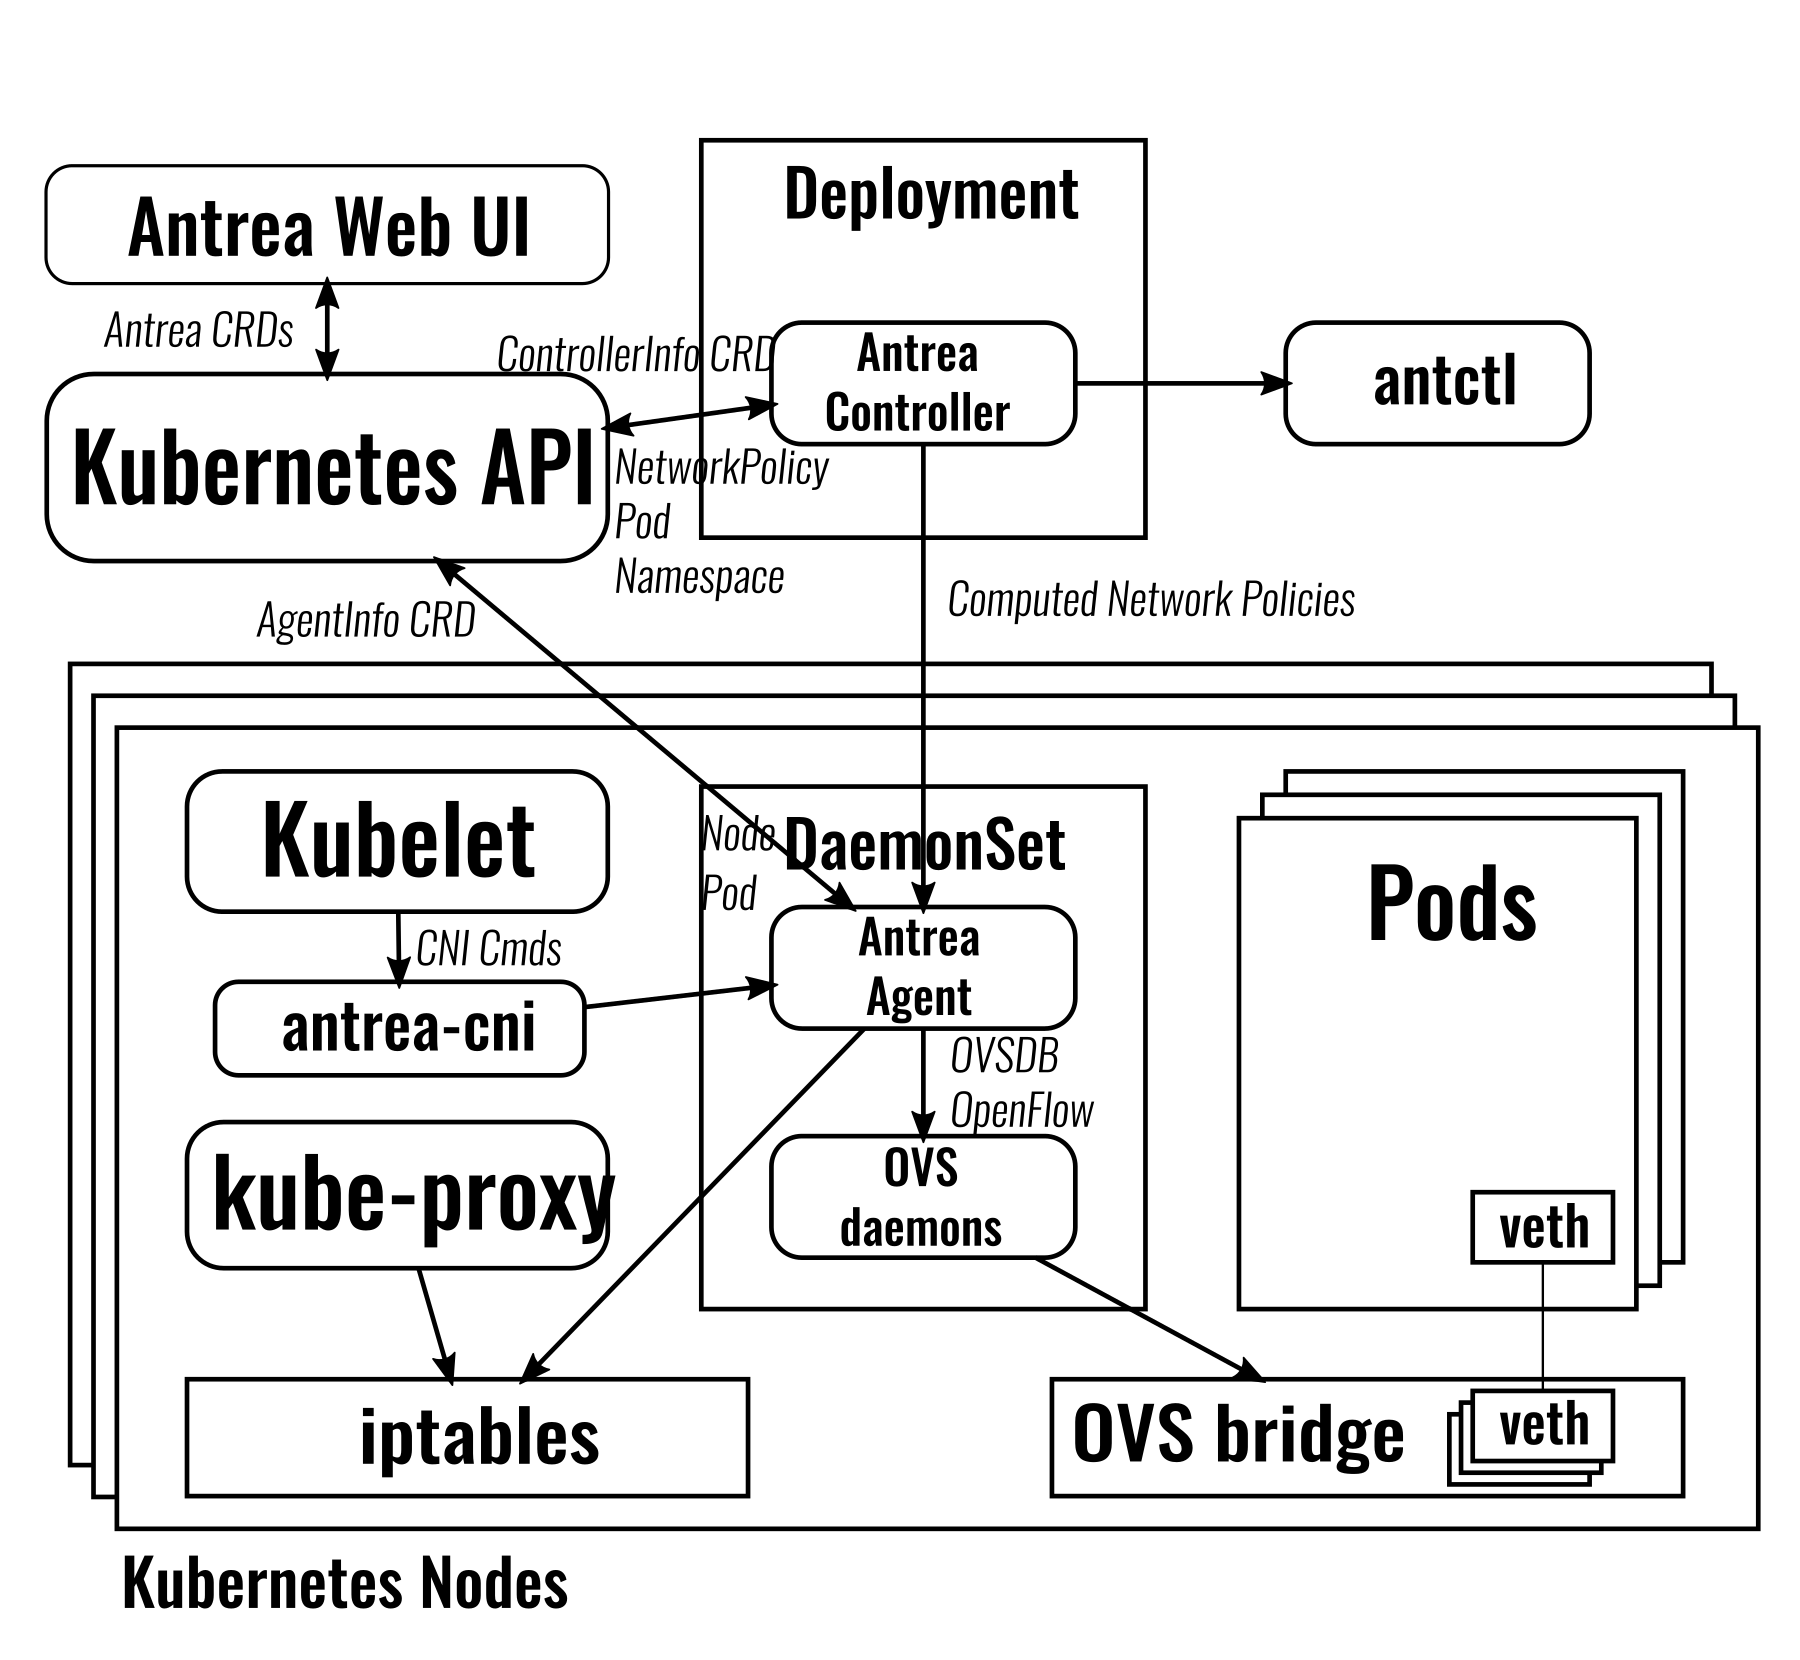
图:Antrea Controller、Agent、CNI 与 OVS 数据面。来源:Antrea Architecture,Apache-2.0。原始 SVG 转为 PNG,图中内容未修改。
OVS 数据面
OVS pipeline 执行隧道、路由、NetworkPolicy 和必要的连接跟踪。跨节点模式可以是 Encap、NoEncap 或 Hybrid,具体 flow 取决于 traffic path 和启用的功能。
AntreaProxy
AntreaProxy 在 OVS pipeline 中实现 Service 负载均衡。启用完整 replacement 时,kube-proxy 不再维护节点 Service 规则,运维检查需要转向 OVS flow 和 Antrea Agent 状态。
Traceflow
Traceflow 创建一个 Antrea CRD,请求 Agent 在 OVS pipeline 中跟踪真实或模拟 packet。结果记录 packet 在 Node、tunnel、policy 和 forwarding table 中的处理过程,适合定位跨节点或策略问题。
Kube-OVN
Kube-OVN 把 Kubernetes 网络映射到 OVN logical network。OVN Northbound DB 保存逻辑交换机、逻辑路由器、ACL 与 load balancer;ovn-controller 把 logical flow 转换成每个节点的 OVS flow。
OVN 与 OVS
OVN 负责分布式控制逻辑,OVS 执行节点 packet pipeline。Kube-OVN Controller 和 CNI 根据 Pod、Service、Subnet、VPC 等对象更新 OVN 状态。
VPC 与 Subnet
Kube-OVN 提供 VPC、Subnet、静态 IP、VLAN、NAT 和 QoS 等云网络语义。它适合需要多租户逻辑网络、KubeVirt 或精细地址规划的集群。
Service 与 NetworkPolicy
Service 和 NetworkPolicy 被转换为 OVN load balancer 与 ACL。排障需要沿 Kubernetes 对象、OVN logical object 和 OVS flow 三层检查。
云厂商原生 CNI
云厂商 CNI 把 Pod 接入 VPC/VNet,使 Pod 使用云网络可路由地址。地址容量、ENI/NIC 限制、路由表、安全组和云控制面 API 配额会直接影响可创建 Pod 数和网络收敛时间。
AWS VPC CNI
Amazon VPC CNI在节点上管理 ENI 和 VPC IP,并把地址分配给 Pod。prefix delegation、warm pool 与 Security Groups for Pods 会改变地址容量和数据路径。
Azure CNI
Azure CNI提供多种网络模式,把 Pod 地址、VNet route 和 Azure dataplane 组合起来。选型需要核对 overlay、Pod subnet、Network Policy 和节点池的支持范围。
Google Cloud 网络
GKE VPC-native 集群使用 alias IP ranges 为 Pod 与 Service 分配地址。GKE Dataplane V2使用 eBPF 实现网络策略和 Service 处理,部署边界由 GKE 版本与集群模式决定。
方案选择
下表列出主要定位,不能替代目标环境测试。
| 方案 | 主要数据面 | Service | 适合优先评估的场景 |
|---|---|---|---|
| Flannel | Linux route + VXLAN/host-gw | kube-proxy | 只需基础 Pod 网络,组件尽量少 |
| Calico | Linux route + iptables/nftables/eBPF/VPP | kube-proxy 或 eBPF replacement | BGP、NetworkPolicy、数据面渐进选择 |
| Cilium | eBPF | eBPF replacement | 网络、安全与流量观测一体化 |
| Antrea | OVS/OpenFlow | kube-proxy 或 AntreaProxy | OVS、Windows、Traceflow |
| Kube-OVN | OVN/OVS | OVN load balancer | VPC、Subnet、多租户、KubeVirt |
| 云厂商 CNI | VPC/VNet 原生接口与地址 | 云集成或集群数据面 | Pod 直接进入云网络与安全体系 |
评估顺序应从功能约束开始:云网络集成、路由模式、NetworkPolicy 语义、Windows、多集群、加密、多网卡和 RDMA。候选方案收敛后,再按目标规模测试吞吐、延迟、规则更新时间与故障恢复。
多网络与高速网络
默认 CNI 为 Pod 创建主接口 eth0。AI 训练、存储或电信工作负载可能还需要管理网络、RDMA 网络或独立数据平面;Multus 可以在默认网络之外执行附加 CNI 配置。
Multus
Multus 是 meta-plugin。runtime 调用 Multus 后,Multus 先执行默认网络,再根据 Pod annotation 或其他配置调用一个或多个附加 CNI。每个 attachment 拥有自己的接口名、Result 和清理流程。
NetworkAttachmentDefinition
NetworkAttachmentDefinition 是 Multus 使用的 CRD,spec.config 保存一个 CNI 配置或指向节点上的配置。Pod 通过 k8s.v1.cni.cncf.io/networks annotation 选择附加网络。
apiVersion: k8s.cni.cncf.io/v1
kind: NetworkAttachmentDefinition
metadata:
  name: storage-network
spec:
  config: |-
    {
      "cniVersion": "1.0.0",
      "type": "macvlan",
      "master": "ens6f0",
      "ipam": {"type": "whereabouts", "range": "192.0.2.0/24"}
    }
配置中的 master 必须在目标节点存在。附加网络地址管理可以使用 host-local、Whereabouts、DHCP 或具体厂商实现。
SR-IOV CNI
SR-IOV 把 NIC Virtual Function 直接交给 Pod。SR-IOV Device Plugin 向 Kubelet发布 VF 资源,Scheduler 根据资源请求选择节点,SR-IOV CNI 再把已分配 VF 配置到 Pod namespace。设备分配和网络 attachment 是相邻但不同的步骤。
RDMA 网络
RDMA 工作负载需要 RDMA device、驱动、device plugin、CNI、PFC/ECN 或 InfiniBand fabric 等多层配置。RoCE 使用以太网网络,InfiniBand 使用专用 fabric;Pod 获得接口并不自动证明 RDMA queue pair 和端到端 lossless 配置可用。
AI 工作负载的网络划分
AI 基础设施常把以下流量分开设计:
- 管理与控制流量:Kubernetes API、镜像拉取、监控和 SSH。
- Service 与推理流量:客户端请求、Gateway 和模型服务通信。
- 分布式训练流量:NCCL、RDMA、GPU Direct RDMA 等高带宽低延迟路径。
- 存储流量:模型、Checkpoint 和数据集读取。
网络划分可以使用独立 NIC、VLAN、VRF、Multus attachment 和路由策略。分开网络之前需要明确故障域、带宽保障和观测方式,避免只增加接口而没有隔离实际瓶颈。
网络观测与排障
排障应按 packet 实际经过的层次收集证据:Pod network namespace、host veth、节点路由或隧道、Service 规则、conntrack、NetworkPolicy 和远端 Endpoint。kubectl get pod 只提供 API 状态,不能说明节点数据面已经正确配置。
Pod 网络信息
先确认 Pod IP、所在节点、Sandbox Event 和容器状态:
kubectl get pod cni-server cni-client -o wide
kubectl describe pod cni-server
kubectl get events --field-selector involvedObject.name=cni-server \
  --sort-by=.lastTimestamp
FailedCreatePodSandBox 表示失败发生在业务容器启动前。Event 中的 CNI binary、配置、IPAM 或 route 错误是下一步定位入口。
Network Namespace
在 Kind 节点内取得 Sandbox PID,再进入其 network namespace:
sandbox_id="$(docker exec cni-demo-control-plane \
  crictl pods --name cni-client --state Ready --quiet | head -n1)"

docker exec cni-demo-control-plane \
  crictl inspectp --output json "$sandbox_id" \
  | jq '.info.pid'
取得 PID 后查看 Pod 看到的接口和路由:
docker exec cni-demo-control-plane \
  nsenter --target <sandbox-pid> --net ip address show

docker exec cni-demo-control-plane \
  nsenter --target <sandbox-pid> --net ip route show
路由与邻居表
节点路由决定 Pod CIDR 的下一跳,邻居表把同链路 IP 解析为 MAC:
docker exec cni-demo-control-plane ip route show
docker exec cni-demo-control-plane ip neighbor show
docker exec cni-demo-control-plane bridge fdb show
跨节点 Overlay 还要检查 vxlan.calico、flannel.1、genev_sys_6081 等隧道接口,以及对应的 FDB、route 和 tunnel endpoint。
nftables 规则
查看完整 ruleset,再按 Service ClusterIP 或 Pod IP 缩小范围:
service_ip="$(kubectl get service cni-server \
  --output jsonpath='{.spec.clusterIP}')"

docker exec cni-demo-control-plane \
  sh -c "nft list ruleset | grep -C 5 '$service_ip'"
kube-proxy nftables 与 Calico Nftables 使用不同 table 和 chain。先确认规则归属,再判断是 Service、Pod 网络还是策略路径。
conntrack
conntrack 显示已建立连接的原始与转换后 tuple:
节点镜像未安装 conntrack 时,可以使用临时 privileged debug Pod 或在节点容器中安装只用于实验的工具。生产节点应使用既有运维镜像,避免现场临时修改软件包。
Calico 状态
Calico 集群可以同时检查 API、节点 agent 和数据面:
kubectl get pods -n calico-system -o wide
kubectl logs -n calico-system daemonset/calico-node -c calico-node
kubectl get installation default \
  -o jsonpath='{.spec.calicoNetwork.linuxDataplane}{"\n"}'
使用 BGP 时继续检查 peer 与 route;使用 eBPF 时检查 BPF map 和 program;使用 Nftables 时检查 Felix 管理的 table。
抓包位置
同一连接至少可以在四个位置抓包:Pod eth0、host veth、Node 上行接口和远端节点接口。Overlay 路径还应在隧道设备或底层 NIC 上分别观察内层与外层报文。
抓包前先明确预期的源地址、目的地址和 NAT 阶段。只在任意接口使用 -i any 容易把同一个 packet 的多次观测误认为重传。
常见故障
| 现象 | 优先检查 |
|---|---|
Pod 长时间停在 ContainerCreating |
Pod Event、containerd、CNI 配置和 CNI ADD 错误 |
| Pod 有 IP,同节点 PodIP 不通 | network namespace、veth、bridge/route 和 NetworkPolicy |
| 同节点正常,跨节点不通 | Node route、VXLAN/IP-in-IP/Geneve、BGP、MTU 和主机防火墙 |
| PodIP 正常,ClusterIP 不通 | Service、EndpointSlice、kube-proxy mode、nftables 与 conntrack |
| ClusterIP 正常,Service DNS 不通 | Pod /etc/resolv.conf、CoreDNS Service、CoreDNS Pod 和 upstream DNS |
| 小包正常,大请求超时 | Pod/隧道/上行 MTU、PMTU discovery 和 ICMP 过滤 |
| NetworkPolicy 创建后没有效果 | 网络实现是否支持策略、selector、policyTypes 和节点规则是否更新 |
实验:编写一个网桥 CNI 插件
实验使用普通单节点 Kind 集群,关闭默认 CNI,并安装仓库中的 course-bridge。插件创建 Linux bridge 与 veth,把地址管理委托给 Kind 镜像自带的 host-local,实现 ADD、DEL 和 CHECK。
完整代码、脚本、输入和实测输出放在 examples/chapter-01/08-network。
实验目标
- 观察 CNI 配置如何映射到插件二进制和 IPAM。
- 实现 Pod attachment 的创建、检查和删除。
- 从 host bridge、host veth 和 Pod network namespace 验证实际状态。
- 验证 PodIP、ClusterIP 和 Service DNS 三条连接路径。
插件设计
下图展示插件 ADD 的资源创建顺序。错误回滚按相反顺序删除 veth 并释放 IP,避免 Pod Sandbox 创建失败后留下地址预留。
flowchart LR
    A["CNI ADD"] --> C["load network config"]
    C --> B["ensure course0 bridge"]
    B --> V["create veth pair"]
    V --> I["host-local ADD"]
    I --> P["configure Pod IP and routes"]
    P --> G["configure bridge gateway"]
    G --> R["print CNI Result"]
入口只注册已经实现的回调:
func main() {
    // 实验插件只声明已经实现并验证的 ADD、DEL 与 CHECK。
    skel.PluginMainFuncs(skel.CNIFuncs{
        Add:   plugin.CmdAdd,
        Del:   plugin.CmdDel,
        Check: plugin.CmdCheck,
    }, version.PluginSupports("1.0.0"), "course-bridge CNI plugin")
}
CNI 配置
Kind 的配置关闭默认 CNI,并显式选择 kube-proxy nftables mode:
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
networking:
  disableDefaultCNI: true
  podSubnet: 10.244.0.0/16
  serviceSubnet: 10.96.0.0/16
  kubeProxyMode: nftables
nodes:
  - role: control-plane
course-bridge 使用 10.244.0.0/24,与单节点 Kind 分配给 control-plane Node 的 PodCIDR 对齐。多节点集群需要按 Node 分配不同 subnet,或者改用能够跨节点协调地址的 IPAM。
ADD
CmdAdd 先确保 course0 存在,再进入 Pod network namespace 创建 veth。host-local 返回地址后,插件把 Pod 侧接口放入 Result 的第三个位置,并让每个 IP 的 interface 指向索引 2。
bridge, err := ensureBridge(conf.Bridge, conf.MTU)
if err != nil {
    return err
}

netns, err := ns.GetNS(args.Netns)
if err != nil {
    return err
}
defer netns.Close()

hostInterface, containerInterface, err := createVeth(
    netns,
    bridge,
    args.IfName,
    conf.MTU,
)
if err != nil {
    return err
}

ipamResult, err := ipam.ExecAdd(conf.IPAM.Type, args.StdinData)
if err != nil {
    return err
}
插件在失败路径调用 host-local DEL 并删除 Pod veth。成功返回前,它在 Pod namespace 中执行 ipam.ConfigureIface,写入地址、默认路由和接口状态。
DEL
CmdDel 允许 network namespace 或接口已经消失。存在 Pod eth0 时,删除一端会同时删除 host peer;随后 host-local 释放地址记录。
func CmdDel(args *skel.CmdArgs) error {
    conf, err := loadNetConf(args.StdinData)
    if err != nil {
        return err
    }
    linkErr := deleteContainerLink(args.Netns, args.IfName)
    ipamErr := ipam.ExecDel(conf.IPAM.Type, args.StdinData)
    return errors.Join(linkErr, ipamErr)
}
CHECK
CmdCheck 读取 runtime 缓存的 prevResult,检查 bridge、veth peer、Pod IP 和 route,再把调用转发给 host-local。任何资源与 Result 不一致都会返回错误。
func CmdCheck(args *skel.CmdArgs) error {
    conf, err := loadNetConf(args.StdinData)
    if err != nil {
        return err
    }
    if err := loadPrevResult(conf); err != nil {
        return err
    }
    if err := ipam.ExecCheck(conf.IPAM.Type, args.StdinData); err != nil {
        return err
    }

    bridge, err := validateBridge(conf.Bridge)
    if err != nil {
        return err
    }

    result, err := current.NewResultFromResult(conf.PrevResult)
    if err != nil {
        return fmt.Errorf("convert prevResult: %w", err)
    }
    var hostInterface *current.Interface
    for _, intf := range result.Interfaces {
        if intf.Sandbox == "" && intf.Name != conf.Bridge {
            hostInterface = intf
            break
        }
    }
    if hostInterface == nil {
        return fmt.Errorf("host veth is missing from prevResult")
    }
    hostVeth, err := netlink.LinkByName(hostInterface.Name)
    if err != nil {
        return fmt.Errorf("find host veth %q: %w", hostInterface.Name, err)
    }
    if hostVeth.Attrs().MasterIndex != bridge.Attrs().Index {
        return fmt.Errorf("host veth %q is not attached to bridge %q", hostInterface.Name, conf.Bridge)
    }
    if hostVeth.Attrs().Flags&net.FlagUp == 0 {
        return fmt.Errorf("host veth %q is down", hostInterface.Name)
    }
    _, hostPeerIndex, err := ip.GetVethPeerIfindex(hostInterface.Name)
    if err != nil {
        return fmt.Errorf("read peer index for %q: %w", hostInterface.Name, err)
    }

    return ns.WithNetNSPath(args.Netns, func(_ ns.NetNS) error {
        link, err := netlink.LinkByName(args.IfName)
        if err != nil {
            return fmt.Errorf("find container interface %q: %w", args.IfName, err)
        }
        if link.Attrs().Flags&net.FlagUp == 0 {
            return fmt.Errorf("container interface %q is down", args.IfName)
        }
        if link.Attrs().Index != hostPeerIndex {
            return fmt.Errorf("container interface %q is not the peer of %q", args.IfName, hostInterface.Name)
        }
        if err := ip.ValidateExpectedInterfaceIPs(args.IfName, result.IPs); err != nil {
            return err
        }
        return ip.ValidateExpectedRoute(result.Routes)
    })
}
编译插件
构建脚本根据 Docker daemon 架构生成 Linux 静态二进制:
输出示例:
x86-64 Docker host 的目标架构显示为 linux/amd64。
创建 Kind 集群
本地需要 Docker、Go、Kind、kubectl 和 jq。创建 Kubernetes v1.36.4 集群:
./examples/chapter-01/08-network/scripts/create-cluster.sh
kubectl --context kind-cni-demo get nodes
默认 CNI 已关闭,插件配置安装前 Node 显示 NotReady:
安装插件
安装脚本把二进制复制到 /opt/cni/bin/course-bridge,把配置复制到 /etc/cni/net.d/10-course-bridge.conflist。containerd 观察到有效 CNI 配置后,Kubelet 可以创建 CoreDNS 等 Pod Sandbox,Node 随后进入 Ready。
创建测试 Pod
测试清单创建一个 netcheck Server Pod、一个 Client Pod 和 ClusterIP Service。course/netcheck:v1 从 scratch 本地构建并加载到 Kind,不依赖节点访问外部镜像仓库:
kubectl --context kind-cni-demo apply \
  --filename examples/chapter-01/08-network/manifests/test-workloads.yaml

kubectl --context kind-cni-demo wait \
  --for=condition=Ready pod/cni-server pod/cni-client \
  --timeout=180s
检查 Network Namespace 与 veth
bridge 与 host veth 位于 Kind node 的 network namespace:
docker exec cni-demo-control-plane ip -details link show course0
docker exec cni-demo-control-plane bridge link show master course0
取得 Client Pod Sandbox PID 后,可以直接观察 Pod eth0 和路由:
docker exec cni-demo-control-plane \
  nsenter --target <sandbox-pid> --net ip address show eth0

docker exec cni-demo-control-plane \
  nsenter --target <sandbox-pid> --net ip route show
验证 Pod 通信
使用 Client Pod 中的 netcheck connect 建立到 Server PodIP 的 TCP 连接:
server_ip="$(kubectl --context kind-cni-demo get pod cni-server \
  --output jsonpath='{.status.podIP}')"

kubectl --context kind-cni-demo exec cni-client -- \
  /netcheck connect "${server_ip}:8080"
该连接只经过 Pod network namespace、veth 和 course0,不使用 Service DNAT。
验证 Service 访问
继续连接 ClusterIP 和 Service DNS:
service_ip="$(kubectl --context kind-cni-demo get service cni-server \
  --output jsonpath='{.spec.clusterIP}')"

kubectl --context kind-cni-demo exec cni-client -- \
  /netcheck connect "${service_ip}:8080"

kubectl --context kind-cni-demo exec cni-client -- \
  /netcheck connect \
  cni-server.default.svc.cluster.local:8080
PodIP 成功证明自定义 CNI 的同节点路径可用;ClusterIP 继续验证 kube-proxy nftables;Service DNS 还会经过 CoreDNS。
验证脚本还会读取 containerd 保存在 /var/lib/cni/results/ 中的 ADD Result,构造带有 prevResult 的输入,并对 Client Pod attachment 执行 CNI_COMMAND=CHECK。成功输出包含:
验证资源清理
清理验证脚本先从 containerd CNI cache 取得 Client Pod 的 host veth 和地址,再删除 Pod,确认接口与 host-local 地址记录都已消失:
输出中的 IP 和 veth 名称由本次 Sandbox 决定:
containerd 调用 DEL 时,插件删除 veth 并释放 host-local 地址。bridge 作为共享网络设备继续保留,供后续 Pod 使用。
常见错误
| 错误 | 原因与检查 |
|---|---|
cni plugin not initialized |
/etc/cni/net.d 没有有效配置,或配置 JSON 无法解析 |
failed to find plugin "course-bridge" |
二进制不在 containerd 配置的 CNI binary 目录,或没有执行权限 |
failed to find network info for sandbox |
插件 Result 没有为 eth0 返回 IP config,或 interface index 错误 |
Node 一直 NotReady |
查看 kubelet、containerd 日志和 CoreDNS Sandbox Event |
| PodIP 可连接,ClusterIP 超时 | 检查 kube-proxy mode、EndpointSlice 和 nftables ruleset |
| 删除 Pod 后地址没有释放 | 检查 DEL 错误和 /var/lib/cni/networks/course-network |
完成实验后删除 Kind 集群:
相关资料
- Kubernetes Services, Load Balancing, and Networking
- Cluster Networking
- Pods
- DNS for Services and Pods
- Container Network Interface Specification 1.1.0
- containerd CRI architecture
- Virtual IPs and Service Proxies
- Kubernetes NetworkPolicy
- Calico networking options
- Cilium Life of a Packet
- Antrea Architecture
- Multus CNI